Muse WonderとChatGPTの比較については、統合されたワークスペースが必要な場合はChatGPTを選び、コードの修正やソースベースの分析に適した本格的なモデルをお探しの場合は、Muse Wonderをお試しください。. Muse Wonderは、当社の実地テストにおいてその評価を獲得しました。選定された製品は、29項目の独立した検査に合格しました。これらの結果は、普遍的な品質ランキングというよりは、実用的な候補リストの選定を裏付けるものです。.
まず決めるべきは、何を購入するかです。Muse Wonderにはいくつかの利用方法があります。ChatGPTは、モデル、ツール、および利用許容量が対象領域やプランによって異なるアプリケーションです。 開発者にとって、モデルレベルでの比較として参考になるのは、WonderとGPT-6.1 Sol、あるいはGPT-6 Astraとの比較です。日常業務においては、モデルを基盤とするアプリケーションの機能も同様に重要になる場合があります。.
私たちは、当社の 『Muse Wonder』のレビュー, 、2026年10月14日にテストを実施。コード例は、明確な識別要件を盛り込んだ続編です。本記事では、公式の製品および価格情報を更新しましたが、ChatGPTの新たなベンチマークテストは実施していません。この比較結果は、Museのテストが完了したGlobalGPTによって公開されています。.
別のワークフローを確定する前に、モデルの応答を比較したい場合は、以下を開いてください。 GlobalGPT上の「Muse Wonder」 そして、答えを確認できる課題を持ってきてください。.
Muse Wonder 対 ChatGPT:簡単な比較
ワークスペースを選択してください
チャットGPTプロジェクト、ファイル、ツールが一体となり、計画に応じて利用可能になります。.
別のモデルを試してみてください
ミューズ・ワンダー選定した実用例における、コードおよびソースの取り扱いに関する有望な事例。.
API を使って構築する
IDを正確に照合するちなみに、GPT-6.1 SolとAstraでは、料金体系や利用方法が異なります。.
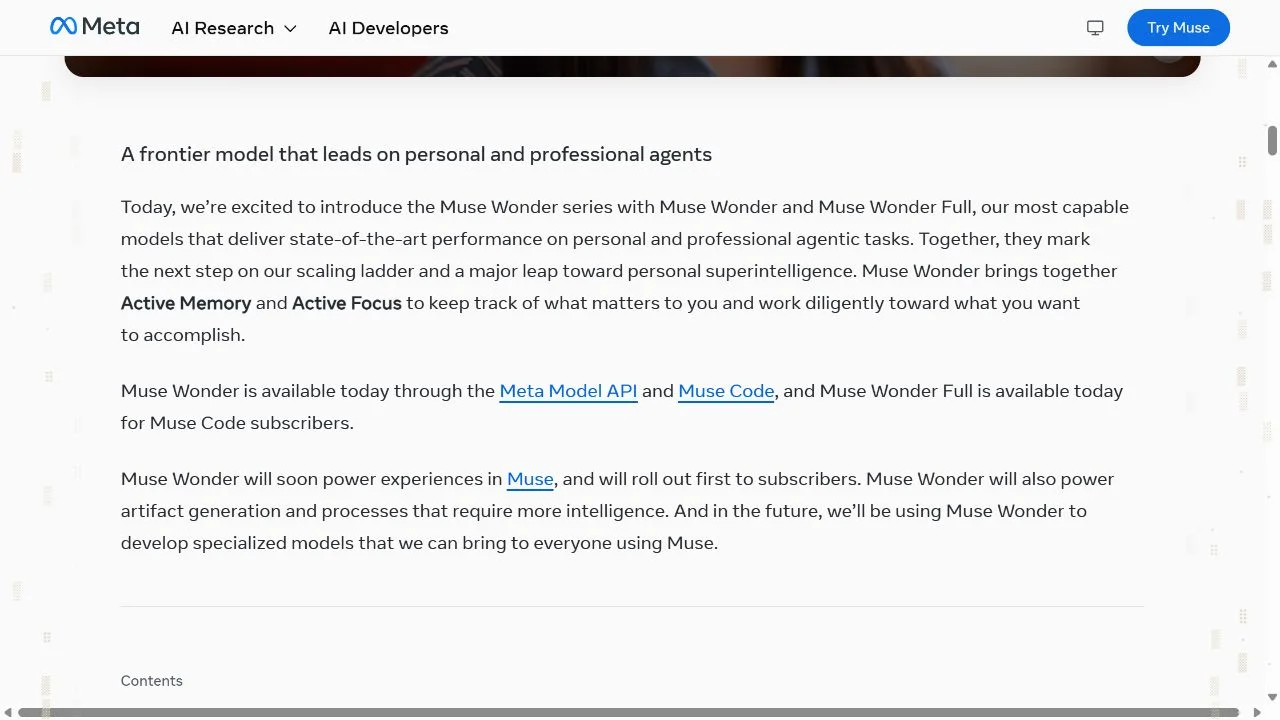
Metaの 「Muse Wonder」の発売発表 Meta Model API および Muse Code を通じて利用可能な標準版の「Wonder」と、Muse Code 加入者向けの「Wonder Full」を区別しています。また、一般ユーザー向けの Muse の展開については、まず加入者を対象に行われると説明されています。一方のルートへのアクセス権があるからといって、もう一方のルートで利用可能なすべての機能が利用できるとは限りません。.
OpenAIの 現在の ChatGPT モデルのドキュメント 複雑なコーディングやエージェント作業については、利用可能な場合はGPT-6.1 Solを、最も難易度の高いエンドツーエンドの作業についてはAstraを推奨している。GPT-6.1 Solは、ChatではなくWorkとCodexに明確に位置づけられている。したがって、「ChatGPT」というモデルラベルだけでは、再現性のある比較を行うには曖昧すぎる。.
重要なレイヤーを比較する
正確なモデル名、プロンプト、推論設定、および受け入れられた出力。.
ファイル、プロジェクト、連携機能、ツールの権限、そして完成した成果物。.
サブスクリプション料金またはAPI利用料に加え、再試行回数および人手による編集にかかる時間。.
GPTに関しては、当社の GPT-6.1 Sol と GPT-6 Astra の比較 この記事では、有用な基本ルールとして、「Solで価値を評価し、追加の機能に見合う価格を支払う場合はAstraを選ぶ」という指針を示しています。この記事では、仕様やコストのシナリオを比較していますが、Muse Wonderとの同一プロンプトでの出力比較結果は掲載されていません。.
コーディング:Muse Wonderの結果が示すもの
Museのテストは、0、false、およびIDが存在しない場合をすべて同じように扱うJavaScriptの重複排除関数から始まりました。選択されたフォローアップでは、Symbol、object、function、およびBigIntの同一性が明示されました。Muse Wonderは、文字列を小文字に変換し、その他の値をSet内で直接保持する、コンパクトな実装を返しました。.
同じ「uniqueById」タスクに対する、コード修正後のテストを実施してください。修正済みの実行可能なJavaScript関数、簡単な説明、および正確に5つのassert形式のテストを返してください。テストを実行したとは主張しないでください。

受け入れ要件:
- 入力の順序を維持し、重複するIDごとに最初のレコードを返してください。配列やレコードを一切変更しないでください。
- id が存在しない、null または undefined であるレコードは、常に保持すること。
- 文字列 ID の比較は、大文字小文字を区別しないこと。数値の 0、ブール値の false、および文字列 '0' は区別すること。
- JavaScript の ID の同一性を保持すること:2 つの異なる Symbol('x') 値は区別されたままであり、まったく同じ Symbol が繰り返される場合は重複を排除し、繰り返される Symbol.for('shared') 値も重複を排除する必要があります。
- ID として使用される異なるオブジェクトや関数は区別されたままであり、繰り返される参照は重複を排除します。BigInt 1n と数値 1 は区別されたままです。
- 元のサンプル [{id:0},{id:false},{id:'A'},{id:'a'},{name:'one'},{name:'two'}] を使用し、0、false、最初の A、および ID を持たない両方のレコードを保持する。

提供された5つのテストは、通常のサンプル、IDの欠落・null、Symbolの同一性、オブジェクト参照の同一性、およびBigIntとnumberのケースを網羅しているはずです。異なる同一性をテキストキーに統合するのではなく、値を保持する実装を使用してください。.
自動コピーがブロックされている場合は、テキストを選択して Ctrl/Cmd+C を押してください。.function uniqueById(records) {
const seen = new Set();
return records.filter((record) => {
// Absent, null, and undefined IDs are always kept.
if (record == null || record.id == null) {
return true;
}
const id = record.id;
// Normalize only strings for case-insensitive comparison.
// All other values are stored as-is, preserving their identity.
const key = typeof id === "string" ? id.toLowerCase() : id;
if (seen.has(key)) {
return false;
}
seen.add(key);
return true;
});
}自動コピーがブロックされている場合は、テキストを選択して Ctrl/Cmd+C を押してください。.独立したコード検証
13 / 13順序、IDの欠落、入力の保持、異なる型、および同一性。.
モデルによって提供されるアサーション
5が合格した別途実施。29件の独立したチェックには加算されない。.
テスト環境
グローバルGPTProduction Muse Wonderへの投稿、デフォルトのUI設定、10月14日。.
受け入れ基準が具体的であるため、この結果は有用です。同じ説明を持つ2つのシンボルは区別されたままとなり、同じシンボルを繰り返し使用すると重複が除去されます。オブジェクトと関数は参照同一性を保持し、 1n …とは依然として異なる 1. 。また、この関数はレコードの順序を維持し、入力データを変更しません。.
これらのチェックは、モデルが回答を返した後、当社の検証環境上で実行されました。モデルはリポジトリを編集したり、自らテストを実行したことを証明したりはしませんでした。本番環境のインターフェースには「」というラベルが付けられていました。 ミューズ・ワンダー, 、明示的な推論努力セレクタは存在せず、プロバイダのバックエンドの正確なバージョンは独立して確認されていなかった。.
コーディングを依頼する側にとって、この点から「Muse Wonder」は、限定的な修正作業を行う上で有力な候補となります。ただし、リポジトリの移行において「Wonder」が「Sol」や「Astra」を上回ることを示すものではありません。以下の コーディングに最適なAIモデルガイド 次に評価する競合モデルとタスクファミリーを決定するため。.
調査と計画:証拠の取り扱いについて判断する
このソース処理の例は、ChatGPTを研究目的で利用する場合に特に参考になります。私たちは、古い告知、最新の公式価格およびステータスページ、そしてサポート対象外であるとするコミュニティの主張を含む、架空の短いOrion Agentパケットを用意しました。出力では、これらの矛盾を解消しつつ、欠落している情報を保持する必要がありました。.
Muse Wonder レビューテスト 2:証拠の照合。
この架空のソースパケットのみを使用してください。keyとして launch_date、plan_monthly_usd、api_input_per_million_usd、region_status、unresolved、citations を含む有効な JSON のみを返してください。各事実値には、citations にそのソース ID が含まれている必要があります。 矛盾する情報を黙って平均化したり、欠落している事実をでっち上げたりしてはなりません。

[S1] 製品発表(2026年10月12日付):Orion Agentは10月12日にリリースされました。Proプランは月額$19です。米国およびEUで利用可能です。
[S2] 公式価格ページ(2026年10月14日更新):Proプランは$24/月、月次課金。API入力は100万トークンあたり$4。API出力は記載なし。
[S3] 公式ステータスページ(2026年10月14日更新):米国でのアクセスは稼働中。EUでの展開は一時停止中。再開日は未定。
[S4] コミュニティ投稿(2026年10月14日):あるユーザーによると、プランは$12で、EUでも利用可能とのこと。スクリーンショットやリンクはなし。

同じ項目については、より新しい公式情報を使用することを推奨します。未解決の情報がある場合は、明示的に記載してください。.
自動コピーがブロックされている場合は、テキストを選択して Ctrl/Cmd+C を押してください。.
{"launch_date": "2026-10-12", "plan_monthly_usd": 24, "api_input_per_million_usd": 4, "region_status": {"US": "稼働中", "EU": "停止中"}, "unresolved": ["APIの出力価格が情報源に記載されていない。", "EUでの展開再開日が指定されていない。", "矛盾する主張は、選択された値の根拠として使用されませんでした:S1ではProプランが$19/月、EUが利用可能と記載されていたのに対し、非公式かつサポート対象外のS4では$12/月とされ、EUが機能すると主張していました; その代わりに、より新しい公式情報であるS2およびS3が優先された。", "引用元": {"リリース日": ["S1"], "プラン月額(USD)": ["S2"], "api_input_per_million_usd": ["S2"], "region_status": ["S3"]}}この応答は、8つのチェックすべてに合格しました。最新の公式$24月次価格を選択し、当初のリリース日は維持し、EUでの展開を一時停止としてマークし、欠落していたAPI出力価格と再開日は未解決のままにしました。これらは架空のタスク値であり、WonderやChatGPTの価格ではありません。.
これは研究支援において良い手法です。つまり、情報源の識別子を保持し、同じ分野の日付を比較し、そのデータパックでは特定できない点を明記するということです。この課題では提供されたテキストが使用されたため、リアルタイムのウェブ検索の精度や、100万トークン規模の検索精度は測定されていません。ChatGPTの比較を行うには、同じデータパックと、同じ妥当性チェックが必要となります。.
ビジネス文書を作成する際は、モデルを選ぶのと同じくらい慎重にデータ経路を選択してください。当社の AIにおけるデータプライバシーの比較 ファイルをアップロードする前に確認すべきポリシー上の問題点について説明しています。適切なソースを選択しただけでは、いずれのサービスにおいてもプライバシーや保存期間に関する条件が確定するわけではありません。.
計画の結果:有用な計画であっても、実行が不可欠である
Muse Wonder レビューテスト 3:復旧計画(実際のツール実行ではない)。
ブラウザエージェントは、公開されている製品価格を収集し、比較案を作成しなければならない。公式の価格ページからは HTTP 500 が返される。あるマーケットプレイスでは、入力として $4/M、出力として $20/M が表示されている。 Redditの検索スニペットには「$1/M」と記載されている。ユーザーは証拠となるスクリーンショットと実機での実行結果を望んでいる。認証済みのAPIキーは利用できない。
番号付きのステップを正確に6つ記述し、総文字数は140語以内とする。 再試行の回数に上限を設け、失敗したページの記録を保持し、マーケットプレイスの価格情報を明記し、Redditのスニペットを検証済みとして扱わず、準備段階とモデルテストの完了を明確に区別してください。ログインを省略したり、スクリーンショットや出力を捏造したりしないでください。手順6の最後には、具体的な終了条件を明記してください。.
自動コピーがブロックされている場合は、テキストを選択して Ctrl/Cmd+C を押してください。.
1. 公式価格ページへのアクセスを、短い間隔を空けて最大3回まで再試行する。タイムスタンプ、URL、HTTP 500ステータス、および実際のエラーページのスクリーンショットを、失敗記録として保存する。
2. マーケットプレイスの掲載情報を「マーケットプレイス由来の価格」として記録する:入力値「$4/M」、出力値「$20/M」とし、出典URLおよび日付を明記する。公式価格として提示してはならない。
3. Redditのスニペットで主張されている「$1/M」については、未確認の情報としてのみ記録する。公式または信頼できる情報源によって裏付けられるまでは、検証済みの比較対象から除外する。
4. 検証済み、帰属済み、未確認のエントリを区分した比較表の草案を作成し、公式な確認が得られていない旨を明記する。
5. モデルテスト計画、プロンプト、および採点シートを準備する(実行はしない)。承認されたAPIキーがない場合は、ログインを省略したり、スクリーンショットや出力を偽造したりしてはならない。ステータスを「未テスト」と明記する。
6. 草案は準備段階のものとして報告し、完了したモデルテストとして扱わない。3回の再試行に失敗し、合意された期限までに承認されたキーが届かない場合は、作業を中止する。.
この計画は、ステップ番号を除いて6つのステップと126語を用いて、8つのチェックを通過しました。再試行の回数を制限し、市場レートを反映させ、準備段階と完了したテストを区別していました。これは計画作業であり、ブラウザの復旧や自律的な実行は行われませんでした。.
コードのフォローアップ · チェックに合格
ソースJSON · チェックに合格
復旧計画・確認事項はすべてクリア
3つのタスクタイプにわたる29件の選定された独立した検証結果。提供された5つのアサーションはこれとは別個のものだ。これは証拠の要約であり、競合他社のランキングではない。.
メモリ、ファイル、ツール:ワークフロー全体を比較する
ChatGPTを候補リストに残すべき最大の理由は、ワークスペースです。OpenAIの ChatGPT 機能仕様書 プロジェクト、長期にわたるチャット、ウェブ閲覧、ファイル、画像、プラグインを1か所にまとめます。「Work」と「Codex」の各画面は、さまざまな成果物や開発タスクに対応しています。実際に使用する画面を検討してください。.
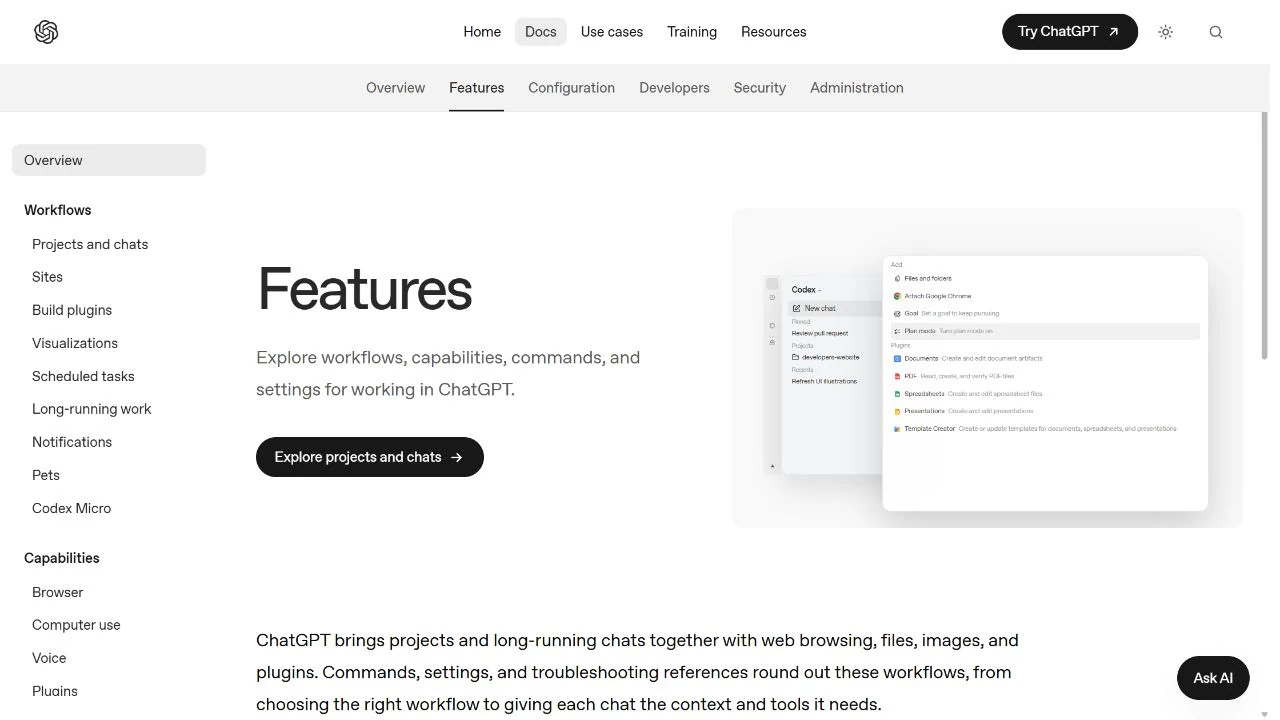
スプレッドシート、調査メモ、コードベースの間を行き来する人にとって、その統合性は、どのモデルが最も見栄えの良い最初の回答を生成するかということよりも重要になる場合があります。実際の要件が、ファイルやツールを1つのワークフロー内にまとめて管理された完成品であるならば、ChatGPTを最初に評価するのが適しています。 利用可能性や制御機能については、引き続きアカウント、クライアント、ワークスペースによって異なります。.
Metaは、「アクティブ・メモリ」を会話全体にわたって有用な文脈を保持・検索する機能として、「アクティブ・フォーカス」を困難な目標に向かって取り組みつつ、障害要因に適応する機能として説明しています。これらは、実際のワークフローに密接に関連するモデル開発者による主張です。 今回の短いテキストタスクでは、永続的なメモリ、長いコンテキスト、マルチモーダルファイル、あるいは実際のコンピュータ使用状況はテストされておらず、またGlobalGPTチャットの実行結果から、Museのネイティブ機能がすべて公開されているとは断定できません。.
メモリの比較を行う場合は、サポート対象の各アプリケーションに同じ無害な設定を指定し、個別のテストを実行した後、正確なリコール、設定の更新、および削除機能を確認してください。ツールに関する作業については、小規模な成果物を依頼し、実際のファイルやトレースを検証してください。書面による計画と完了した作業には、それぞれ異なる評価を与えるべきです。.
料金:サブスクリプションとAPIの利用料金は異なります
ChatGPTのプラン:申請料とその手当の支払い
について ChatGPTの「Work」および「Codex」の公式価格ページ 「Free」プランは$0、「Go」プランは$8/月、「Plus」プランは$20/月、そして「Pro」プランには$100、$200、または$500/月のオプションがあります。 これらは2026年10月14日時点で確認された米ドル建てのプラン価格です。GPT-6.1 Solのローンチアクセスには、「Plus」、「Pro」、「Business」、「Enterprise」、「Edu」が含まれます。「Free」および「Go」は、このローンチ展開の対象外となります。.
プラス
$20 / 月記載されているのはサブスクリプション料金です。使用量は、モデル、タスク、ツールによって異なります。.
プロ
$100/月より$100、$200、または$500のプランオプション。API利用量に上限のない定額プランではありません。.
ワンダー・アクセス
ルート固有の標準API、Muse Code、およびGlobalGPTのクレジットは、課金方法が異なります。.
ChatGPT WorkおよびCodexの共有利用量、ならびにAPIトークンの価格は、サブスクリプションに含まれる利用量とは別扱いとなります。$20サブスクリプションをAPIリクエスト単価で割って、保証されたタスク数を算出するようなことはしないでください。当社の どのAIにお金を払う価値があるのか 完成した作品が購読料に見合う価値があるかどうかという、より広範な問題に焦点を当てている。.
APIの料金:Wonderと各GPTモデルを直接比較
について OpenRouter Muse Wonder の商品ページ キャッシュされていない入力トークン100万個あたり$4、キャッシュされた入力トークン100万個あたり$0.20、出力トークン100万個あたり$20と記載されています。これらは、Muse Codeのチェックアウト価格や監査済みのGlobalGPT引き落とし額ではなく、マーケットプレイスに掲載されているWonderのレートです。.
OpenAIの GPT-6.1 Sol モデルページ 標準APIレートとして、入力$2/M、キャッシュ済み入力$0.10/M、出力$10/Mを記載しています。その GPT-6 Astra のドキュメント それぞれ$10/M、$1/M、$50/Mと記載されています。これらのレートはAPIの利用状況を示すものであり、ChatGPTメッセージの価格を示すものではありません。.
掲載されているAPIレート · 100万トークンあたりの米ドル
GPT-6.1 Sol
- キャッシュされていない入力
- $2
- キャッシュされた入力
- $0.10
- 出力
- $10
ミューズ・ワンダー
- キャッシュされていない入力
- $4
- キャッシュされた入力
- $0.20
- 出力
- $20
GPT-6 アストラ
- キャッシュされていない入力
- $10
- キャッシュされた入力
- $1
- 出力
- $50
Wonder:OpenRouterの掲載情報。GPTモデル:OpenAI 標準API料金。2026年10月14日確認。課金ルートが異なり、サブスクリプションと同等であるとの主張はない。.
キャッシュされていない入力トークン10,000個と出力トークン2,000個を用いた単純な推定では、Solは $0.04, 「ワンダー」とは $0.08 そして、アストラは $0.20. 。計算式は、入力トークン数 ÷ 1,000,000 × 入力レート + 出力トークン数 ÷ 1,000,000 × 出力レート となります。これにより、演算におけるトークン数が一定に保たれます。同じプロンプトでも、モデルによって異なるトークン数を使用することができます。.
キャッシュされていない入力トークン 10,000 個 + 出力トークン 2,000 個 · あくまで推定値
コストはバー単位であり、品質スコアではありません。キャッシュ書き込み、ツール、サービス階層の変更、税金、およびその他の適用される料金は含まれません。レビュータスクの引き落としについては監査が行われていません。.
これらのショートリクエストレートにおいて、Wonderはキャッシュされていない入力および出力の場合、Solの2倍、Astraの40%の性能を示しています。 AstraのSolに対するプレミアムは依然として5倍のままである。OpenAIは272K以上の入力トークンに対してより高いフルリクエストレートを適用するため、これらの例を100万トークン規模の推定値に拡大解釈すべきではない。 GPT-6 Astra 価格ガイド その大規模リクエストのコスト上限をカバーします。.
購入の判断基準は、承認された結果1件あたりのコストを測定することです。安価な回答であっても、大幅な編集が必要な場合は、実際にはより多くのコストがかかる可能性があります。これらの例は料金の違いを示すものであり、成果物の品質が同等であること、トークン化が同一であること、あるいは当社のMuseタスクの節約効果を示すものではありません。.
XとRedditが比較にどのような要素を加えるか
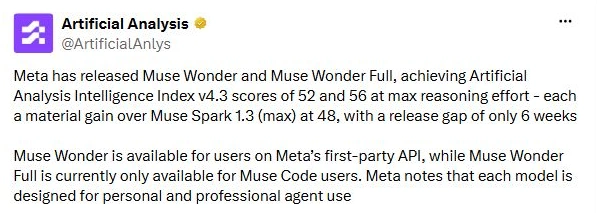
「Artificial Analysis」の 当初のX評価 Intelligence Index v4.3のスコアによると、最大推論負荷下での「Wonder」のスコアは52、「Wonder Full」は56となっています。これらは、当サイトのレビューから転載した第三者による結果です。これらは当サイト独自のGlobalGPT検証結果ではなく、この抜粋だけではChatGPTの勝者を決定づけるものではありません。.
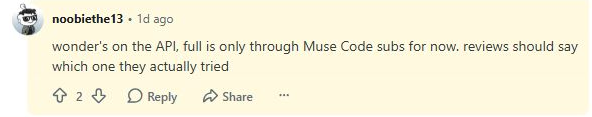
コミュニティにとってより実践的なポイントは、バージョンの明確さです。Redditでは、, u/noobiethe13 は次のように書きました: 「wonderはAPIで利用可能ですが、fullは現時点ではMuse Codeのサブスクリプション経由でのみ利用可能です。レビューでは、実際にどちらを試したかを明記すべきです」。LocalLLaMAの元の投稿は削除されましたが、このコメントは10月14日にキャプチャされた時点で閲覧可能でした。.
ChatGPTについても同様の基準を適用してください。チャット、ワーク、またはコーデックスを記録し、選択されたモデルと利用可能なツールを明記してください。「Wonder Full」に関するコメントと、標準の「Wonder」からの回答は、それぞれ異なる製品について記述している場合でも、どちらも事実として成立し得ます。これらの名指しされた情報源は文脈を補足するものであり、X全体やReddit全体でのコンセンサスを表すものではありません。.
自分のタスクと両者を比較する方法
すでに評価方法がわかっている最近のタスクを1つ使用してください。コードの場合は、許容される入力を定義し、同じチェックを実行してください。研究論文の場合は、同じ日付の資料一式を用意してください。ワークスペースのタスクの場合は、実際の文書、スプレッドシート、または変更されたファイルを提出させてください。以前のフィードバックによって特定のモデルが有利にならないよう、新たに議論を始めてください。.
01 · タスクを修正する
同じ入力プロンプト、ファイル、権限、および受け入れ基準は、すべて同じに保ってください。.
02 · 結果を保存する
実際の出力モデル、表面、設定、再試行回数、および手動による修正内容を記録してください。.
03 · 値に基づいて選択する
採択された作品正確性、実用的な成果物、所要時間、および総費用を比較する。.
応答速度を簡単に比較するには、以下を開いてください。 GlobalGPT上のGPT-6.1 Sol 「Muse Wonder」の検証済みエントリの横に配置し、上記のプロンプトを再利用します。これにより、インターフェースの使い勝手を維持しつつ、ChatGPT WorkおよびCodexのネイティブ機能については、別のアプリケーションテストとして残すことができます。.
について オールインワンAIモデルのワークフロー 1つのワークスペース内でモデルの反復試行を管理する方法について説明します。GlobalGPTはチャットの応答を比較するのに役立ちますが、リポジトリアジェントの代わりになるわけではなく、すべてのネイティブ機能を提供するわけでもなく、プラットフォームのラベルを独立したバックエンドバージョンの証明に変えるものでもありません。.
どちらを選べばいいでしょうか?
主に「一か所で作業できる統合環境」が必要な場合は、まずChatGPTを選択してください。. プロジェクト、ファイル操作、プラグイン、そして「Work」や「Codex」といったインターフェースは、このアプリケーションを評価する具体的な根拠となります。提供される成果物と、それによって節約できる編集時間を評価してください。特定のGPTモデルがどこでも利用可能だと決めつける前に、アカウントのモデルアクセス権限を確認してください。.
特定の、検証可能な業務に適した、もう1つの有力なモデルをお探しなら、Muse Wonderを試してみてください。. 再利用されたコード、JSON、および計画の例は、試用版として推奨されました。まずは小規模なコードの修正やソースパッケージから始め、その結果がご自身のチェック基準を満たしてから、段階的に範囲を広げていくことをお勧めします。.
API開発者の皆様は、GPT-6.1 Solとのコスト比較から始めてみてください。. 記載されているキャッシュ未使用時の入出力レートは、Wonderの半分です。Astraの追加機能がコストに見合うような、より負荷の高い作業については、評価対象に含めておくべきでしょう。現時点では、これら3つのうちどれがあなたの求める品質基準を満たすかを裏付ける確かな証拠はありません。.
Muse Wonder 対 ChatGPT については、次の段階としてタスクレベルの試験を行うのが賢明です。 ワークスペースの利用で時間の節約になる場合はChatGPTを維持し、Muse Wonderの出力が測定可能なワークフローの改善につながる場合は、それを追加してください。GlobalGPTでの応答を比較した上で、独立したネイティブアプリケーションやAPI統合への移行が価値があるかどうかを判断することができます。.
Muse Wonder 対 ChatGPT FAQ
Muse WonderはChatGPTより優れていますか?
Muse Wonderは、コーディングやソースコードベースの分析において試してみる価値があります。統合されたワークスペースを求める場合は、ChatGPTの方が適しています。再利用したMuseのテストは29項目のチェックに合格しましたが、品質面での優劣は明らかではありません。.
この比較では、どのChatGPTモデルが使用されていますか?
モデルに関する説明では、GPT-6.1 Sol および GPT-6 Astra を使用しています。OpenAI では、Sol に関する情報は ChatGPT の「Work」および「Codex」に記載されており、「Chat」には記載されていません。利用の可否は、プラン、クライアント、ロールアウト、およびワークスペースの設定によって異なります。.
プログラミングにはどちらが適していますか?
Muse Wonderのコード修正後の結果が、13件の独立したチェックと、提供された5件のアサーションに合格しました。GPT-6.1 Solは、最初に評価すべき低コストのGPTオプションです。コーディングのデフォルト設定を選択する前に、同じリポジトリのテストを実行してください。.
ChatGPTと比べて、Muse Wonderの価格はどれくらいですか?
OpenRouterでは、Wonderの入力トークンが$4/M、出力トークンが$20/Mと記載されています。ChatGPT Plusは$20/月、Proは$100/月からとなっています。 APIトークンの料金とサブスクリプションの割り当て量は、別々の課金システムとなっています。.
Muse Wonderは、GPT-6.1 SolやAstraよりも安いのでしょうか?
記載されているショートリクエストのAPI料金に基づくと、Wonderのコストは、キャッシュされていない入力および出力の場合、Solの2倍、Astraの40%となります。これらの比率はAPI料金を比較したものであり、ChatGPTのサブスクリプションや、承認された結果にかかるコストを比較したものではありません。.
GlobalGPTでMuse WonderとGPT-6.1 Solは使用できますか?
はい。GlobalGPTの製品エントリ2つについて、いずれも検証を行いました。再利用されたMuseのテストは、本番環境のMuse Wonderルートで実行されました。チャット応答の比較は、ChatGPTのネイティブ機能であるWorkやCodexのテストとは別に行われています。.
ここでテストされたのは『Muse Wonder Full』というバージョンですか?
いいえ。再利用された制作インターフェースには「Muse Wonder」という名称が付けられていました。Metaは、標準の「Wonder」と「Wonder Full」を区別しており、後者はローンチ発表によると、Muse Codeのサブスクライバーが利用できるようになっています。.
Muse WonderとChatGPTの新しいベンチマークを実行しましたか?
いいえ。この記事では、公開済みのMuse Wonderのテスト結果とGPT比較のコストフレームワークを、最新の公式情報に基づいて再利用しています。ChatGPTの出力との照合、パーシステントメモリを用いた試験、および実際のコンピュータ使用状況に基づく比較は実施されていません。.