はい。Grok 4.6は、2026年8月12日にリリースされた公式のxAIモデルであり、長文の調査資料の分析、コーディング、多段階の分析、あるいは画像に基づくタスクを扱う仕事をしているなら、真剣に検討する価値があります。. 50万トークンのコンテキストウィンドウと設定可能な推論機能により、このモデルは要求の厳しいプロジェクトにも対応できる能力を備えていますが、すべてのプロンプトにおいて自動的に最速あるいは最適な選択肢となるわけではありません。真の課題は、もはや「Grok 4.6が存在するか」ではなく、その強みが、実際に完了させる必要がある作業に合致しているかどうかです。.
ワークフロー全体を1つのプロバイダーに依存することなく、その質問に答えたいのであれば、, GlobalGPTは、始めるのに最適な場所です. ブラウザ上のワークスペースを利用すれば、Grok 4.6を他の主要モデルと併用し、同じリサーチ、ライティング、分析、コーディングのプロンプトを実行して、その結果を1か所で比較することができます。 これは、自分に合った設定やサブスクリプションを選択する前に、Grok 4.6が真に優れている点、あるいは他のモデルの方がタスクに適している点を、実用的かつ驚くほどシンプルな方法で確認できる方法です。.
「Grok 4.6」とは、具体的にはどのようなものなのでしょうか?
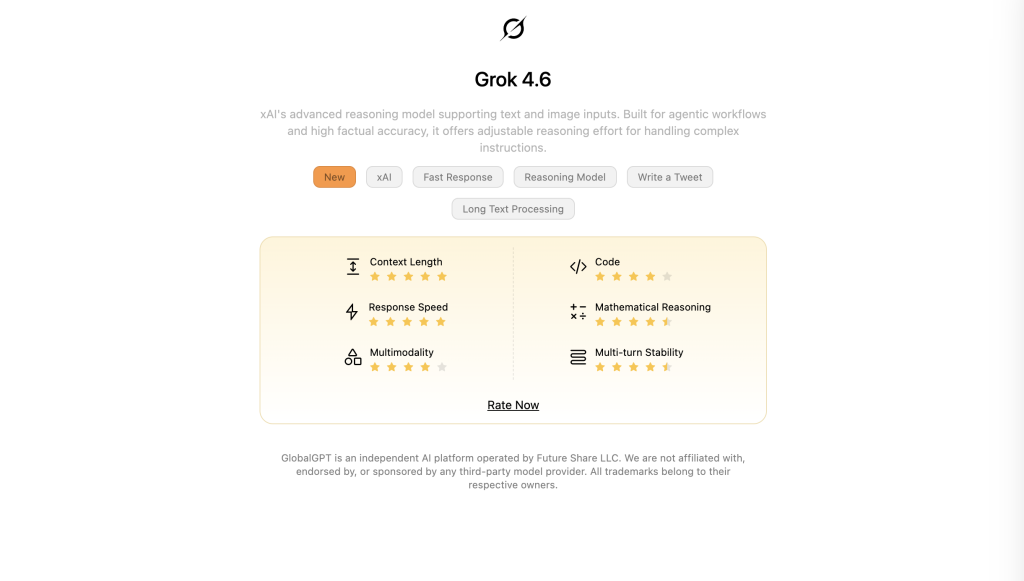
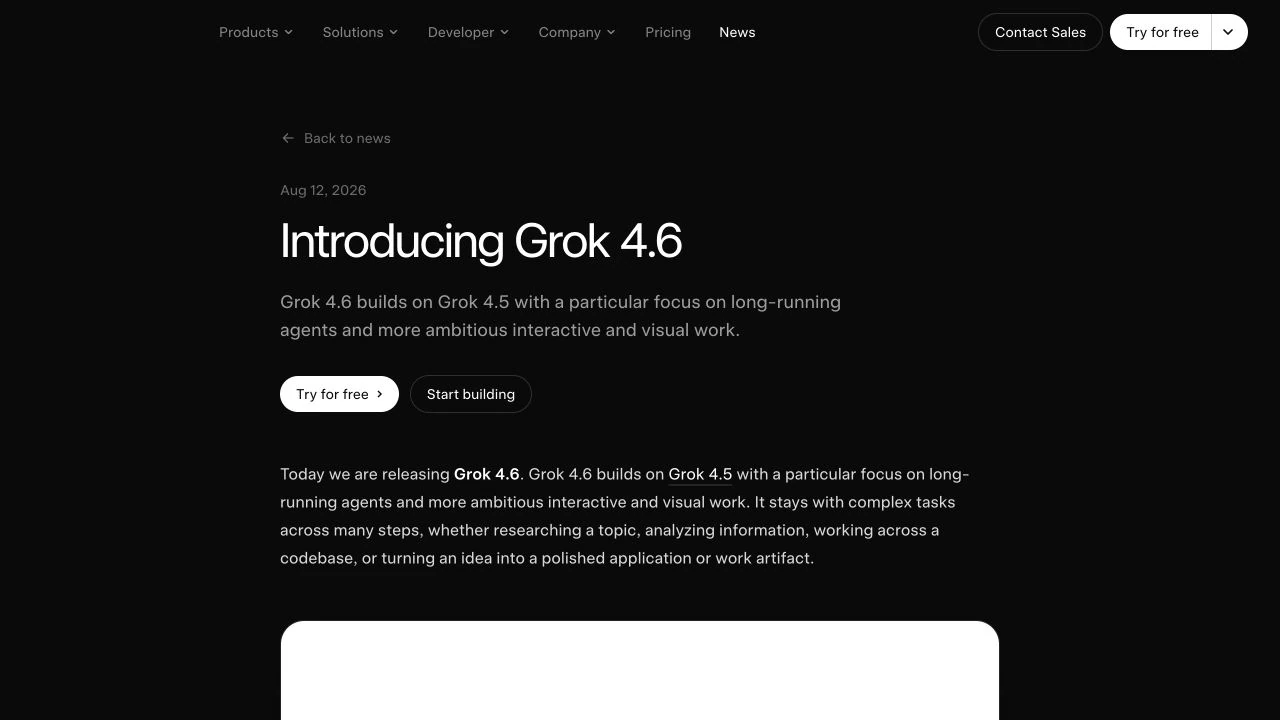
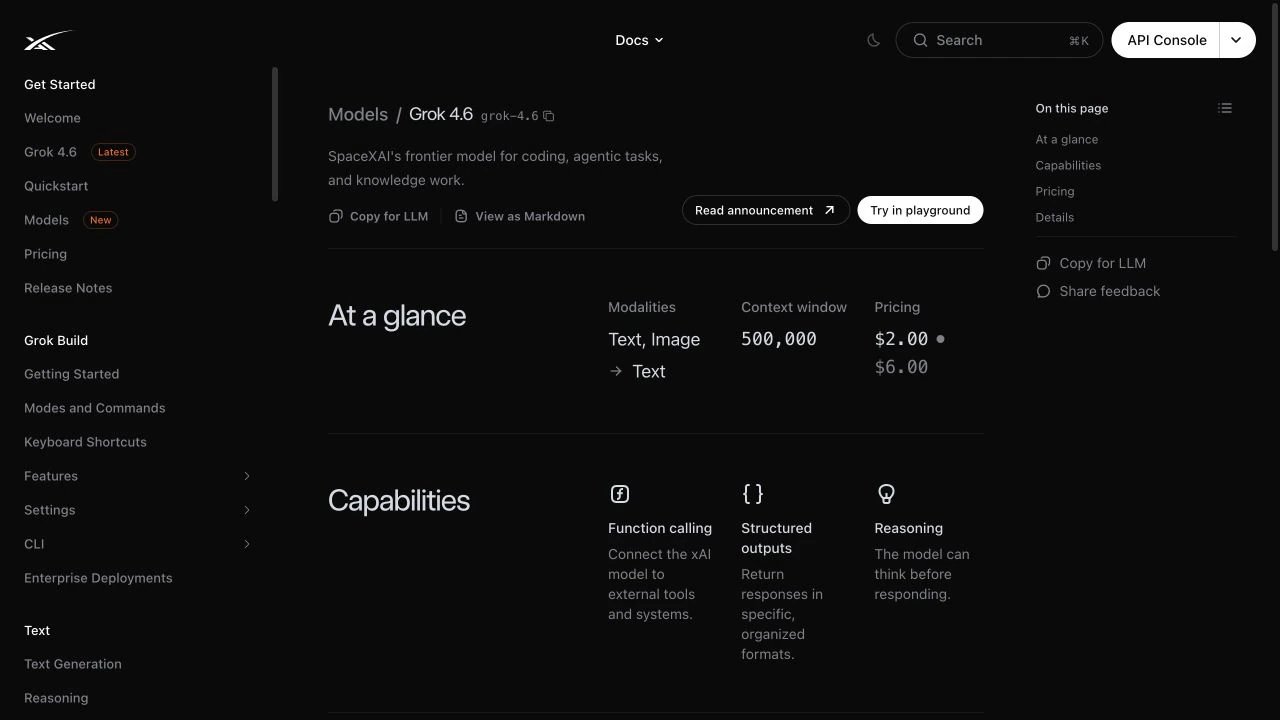
Grok 4.6は、xAIのGrokシリーズにおける2026年のフラッグシップモデルです。公式のモデルページには、テキストおよび画像の入力、テキスト出力、設定可能な推論機能、50万トークンのコンテキストウィンドウについて記載されています。API識別子は grok-4.6; これが、開発者がリクエストで指定すべき値です。.
xAI独自のリリース表記は次のように明確です:Grok 4.6では、以下の点に重点を置いています 長期稼働エージェント さらに、より野心的なインタラクティブ作品やビジュアル作品も含まれます。公式ドキュメントでは、このツールはコーディング、エージェント型タスク、知識労働向けに位置づけられており、ツールや予測可能な応答形式を必要とするワークフロー向けに、関数呼び出しや構造化された出力機能を備えています。.
モデルカードには、2026年1月をプレトレーニングの締め切り日として記載されています。この区別は重要です。50万のコンテキストウィンドウがあれば、非常に大規模なソースパケットを提供することは可能ですが、それだけでモデルが自動的にリアルタイム検索エンジンになるわけではありません。現在の価格、ニュース、または変更された製品ポリシーについては、情報源を確認し、回答の正確性を検証してください。.
Grok 4.6の公式仕様はどのようなものですか?
| 仕様 | 公式に記録された値 | なぜそれが重要なのか |
|---|---|---|
| 発売日 | 2026年8月12日 | これがxAIの正式リリースであることを確認します。. |
| APIモデルID | grok-4.6 | APIリクエストでは、このスラグをそのまま使用してください。. |
| コンテキストウィンドウ | 50万トークン | 長文のブリーフ、コードベース、およびソース資料を多用する調査に役立ちます。. |
| 入力/出力 | テキストおよび画像の入力;テキストの出力 | マルチモーダルなプロンプトに対応していますが、画像生成には対応していません。. |
| 推論 | 設定可能 | ワークフローにおいて、処理速度とより詳細な分析のどちらを優先するかを決定できるようにします。. |
| 関数の呼び出し | サポート対象 | モデルをツールや外部システムに接続します。. |
| 構造化出力 | サポート対象 | JSON、データ抽出、および予測可能なパイプラインに役立ちます。. |
| 事前トレーニングの締め切り | 2026年1月 | 基本モデルを、自動的に最新のものとして扱わないでください。. |
出典:xAIの発表、モデルドキュメント、およびGrok 4.6モデルカード。公式仕様は、独立した性能測定結果とは異なります。.
Grok 4.6にはどのような機能がありますか?
推論と構造化された分析
設定可能な推論機能により、Grok 4.6は、証拠の比較、決定表の作成、実装の計画、制約付き計算の検証など、意図的な回答が有効なタスクに適しています。すべての要求において、推論がより多く行われることが必ずしも良いとは限らないため、定型的な抽出や書き換えを行う場合は、適切な設定を使用する必要があります。.
調査や資料収集を多く必要とする作業
500Kのコンテキストウィンドウにより、モデルは大規模な報告書、議事録、政策文書、ソースパックなどを処理する余裕が生まれます。最も効果的なワークフローは、明確なロケーターと引用ルールに基づいた検索を行い、その後、検証のために元のソースを開くというものです。.
コーディングとデバッグ
公開されているソフトウェア工学の評価結果や、当社が実施した小規模なデバッグテストの結果から、本ツールがコードレビュー、バグ修正、および構造化されたエージェントタスクに有効であることが裏付けられています。ただし、開発者は引き続き、デプロイ前にローカルでテストを実行し、パッチを確認する必要があります。.
イメージ理解
xAIは、テキストおよび画像の入力を記録し、テキストを出力します。これにより、スクリーンショットの解釈、文書画像の分析、視覚的質問応答が可能になりますが、画像生成と混同しないようにしてください。.
長期間稼働しているエージェントとツールの使用
これは、xAIのローンチ時のポジショニングと最も密接に関連する機能です。関数呼び出し機能により、Grok 4.6は外部ツールと連携でき、構造化された出力により、結果を次のステップへ引き継ぎやすくなります。この組み合わせは、コンテキストを収集し、コードベースを処理し、ツールを呼び出し、結果を確認して、完成した成果物を返すようなエージェントに適しています。 なお、このモデルには依然として外部ランタイム、権限、および目的の確認が必要です。「エージェント型」であるからといって、ベースモデルが自律的に動作するわけではありません。.
インタラクティブで視覚的な作品
xAIでは、より野心的なインタラクティブ作品やビジュアル作品も注目されています。実用的なテスト例としては、スクリーンショットを多用した製品概要や、図表を基にしたレポートなどが挙げられ、モデルは視覚的な証拠と文章による推奨事項を結びつける必要があります。結果を最終的なものとみなす前に、ラベル、軸、単位、および省略された詳細を確認してください。.
Grok 4.6では、以前のGrokモデルと比べてどのような点が変更されましたか?
xAIは、より強力な推論能力、コーディングエージェントとしての機能、および長文コンテキストでの処理性能を重視しています。今回の実用的なアップグレードは、単一の派手な機能というものではなく、より広範な作業領域、調整可能な推論機能、そして複雑な多段階タスク向けに最適化されたモデルの組み合わせによるものです。.
それでもワークフローのテストが必要です。モデルはベンチマークでは高いスコアを出しても、あなたの執筆スタイルや引用要件、コードベースには不向きな場合があります。Grok 4.6は、単一のリーダーボードの数値ではなく、毎週繰り返しているタスクを用いて評価するのが最適です。.
Grok 4.6は、権威あるベンチマークではどのような評価を得ているのでしょうか?
以下の表では、xAI独自のモデルカードの結果と、独立した測定結果を分けて示しています。これは、2つのTerminal-Benchの数値が異なるバージョンであるため、直接的な比較結果として提示してはならないという点で、極めて重要です。.
| 評価者 | タスク/指標 | 報告された結果 | 証拠の分類と制限 |
|---|---|---|---|
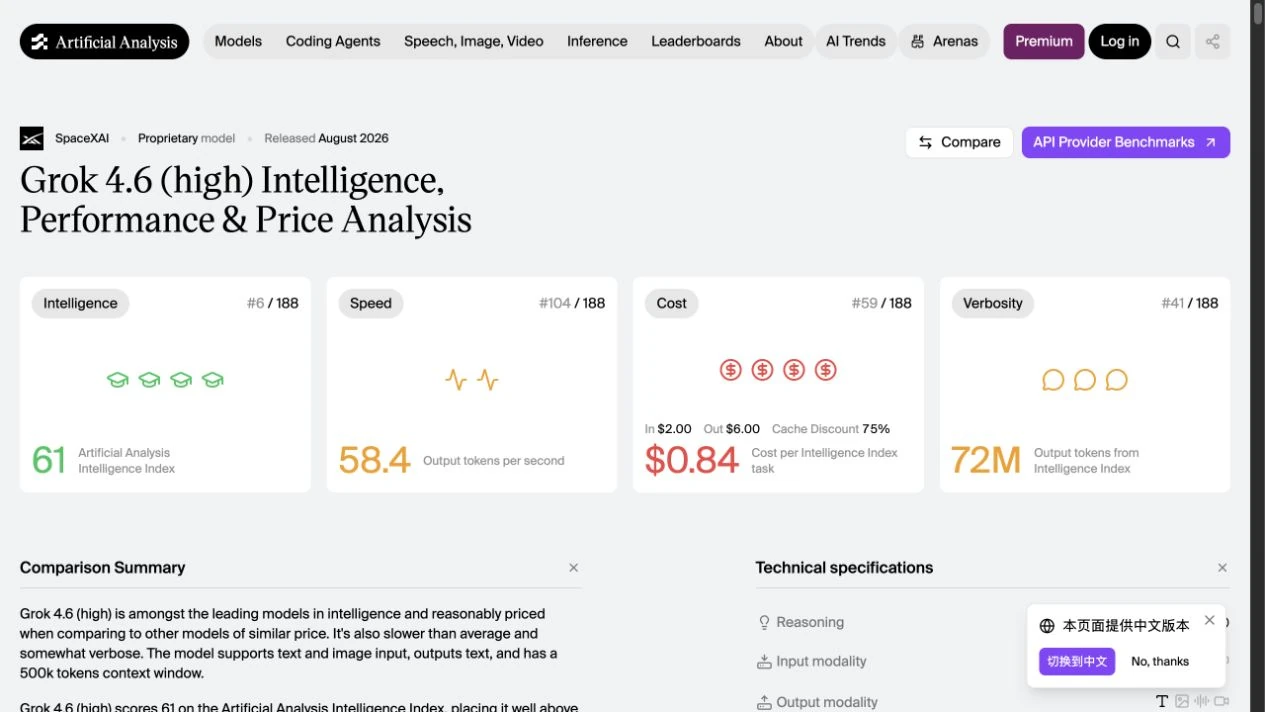
| 人工分析 | 知能指数 | 61(#6/撮影時188) | 独立した合成データ。AAの方法論と日付を使用すること。. |
| 人工分析 | 出力速度 | 58.4 トークン/秒 | 独立した速度測定結果。経路やハードウェアによって遅延は異なります。. |
| 人工分析 | 情報収集タスクあたりのコスト | $0.84 | AAが独自の業務構成に基づいて算出した見積もりであり、xAIの請求書ではありません。. |
| 人工分析 | GDPval-AA v2 | 1753 | 自主的な業務成果の評価。. |
| 人工分析 | AA-ブリーフケース | 1577 | 独立したナレッジワークのスタイル評価。. |
| 人工分析 | Terminal-Bench v2.1 | 88.4% | Independent v2.1 の結果。Terminal-Bench 3.0 とは比較できません。. |
| xAI モデルカード | Terminal-Bench 3.0 | 26% | 別のバージョンにおける公式モデルカードの結果。. |
| Mercor APEX-SWE | ソフトウェア工学 | 56.4% ± 6.2% | 200件のタスク。不確実性区間は保持すべきである。. |
| Mercor APEX-エージェント | エージェントのタスク | 57.5% ± 3.5% | 33の世界/480のタスク:特定のエージェントの評価。. |
| xAI モデルカード | DeepSearchQA | 81.6% | ベンダーが報告した研究の品質保証(QA)状況。. |
| xAI モデルカード | 事実に基づく幻覚の発生率 | 1.7% | モデルカードのテスト条件であり、普遍的なエラー率ではありません。. |
出典:Artificial Analysis、Mercor APEXのリーダーボード、およびxAI Model Card。異なるデータセット、バージョン、エフォート設定、または評価者間のスコアを合算しないでください。.
Grok 4.6は、Grok 4.5よりも優れていますか?
公式のモデルカードは、単純な「はい」という答えではなく、賛否両論の回答を示しています。Grok 4.6はDeepSearchQAの結果がはるかに高い一方、同じカードはGrok 4.5よりも高い事実誤認率を示しています。 真剣な検証においては、1つの優れたベンチマーク結果を根拠に、普遍的な信頼性を主張すべきではない。.
| 公式評価 | Grok 4.6 | Grok 4.5 | その解釈方法 |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | この検索重視の評価において、大幅な改善が見られた。. |
| 事実に基づく幻覚の発生率 | 1.7% | 0.98% | 数値は低いほど良い。この報告された状況では、Grok 4.5の方が望ましい。. |
出典:xAI Grok 4.6 モデルカード。これらの評価はそれぞれ異なる問いに対する回答であり、一概に「勝者」を決定づけるものではありません。.
Grok 4.6は、実際の作業において、どれほど高速で、信頼性が高く、高性能なのでしょうか?
公表されている証拠からは、高性能なモデルが示唆されていますが、「パフォーマンス」には、回答の質、応答遅延、コンテキストの保持、指示の順守、および障害復旧など、いくつかの要素があります。私たちの直接的なアプローチでは、レディネスプローブからHTTP 200が返され、 準備完了. 。他のタスクについては、最初の有効な出力が正常に返されましたが、1件の制約付き編集リクエストでは、クライアント側のインフラストラクチャで障害が発生しました。.
Artificial Analysisは、単なる見出しレベルの機能にとどまらず、現実的な検証を行う上で有用な情報を提供します。キャプチャされたページには、インテリジェンス指数61、出力速度58.4トークン/秒、およびインテリジェンスタスク1件あたりの推定コスト$0.84が表示されています。 この組み合わせは、高性能ではあるものの超高速ではないモデルであることを示しており、使い捨ての1行の返信よりも、有意義な作業に適していると言えます。.
この混合結果は参考になります。Grok 4.6は構造化された作業では高いパフォーマンスを発揮しますが、本番環境のユーザーは、すべてのルートが同じように動作すると想定するのではなく、再試行ルール、タイムアウト、およびフォールバックモデルを設定しておく必要があります。.
Grok 4.6は、どのような場面で最も役立つでしょうか?
長期にわたるコーディングおよび製品開発業務
xAIの起動例には、トピックの調査、情報の分析、コードベース全体にわたる作業、そしてアイデアを洗練されたアプリケーションや成果物へと仕上げるプロセスが含まれます。そのため、単一の機能を持つ「おもちゃのようなプロンプト」よりも、機能単位の作業の方が評価に適しています。モデルには、明確な目標、関連ファイル、テスト、および完了基準を提示してください。.
研究の統合と知識業務
500Kウィンドウ、構造化出力、そしてDeepSearchQAの優れた結果により、Grok 4.6は、ソースパックを要約に変換したり、意見の相違をマッピングしたり、決定表を抽出したりするのに最適な選択肢となっています。引用ルールが明示されている場合、ソースチェックテストはこの用途を裏付けています。.
大規模なレポートおよび複数文書の分析
年次報告書、成績証明書、ポリシーパック、プロジェクト履歴など、通常であれば多大な時間と労力を要する作業となる資料については、コンテキストウィンドウを活用してください。ページやセクションの参照情報を確認した上で、元の文書にある重要な数値を検証してください。.
画像に基づく分析
テキストと画像の同時入力は、スクリーンショットやグラフ、図表などを扱う際に役立ちます。これは、ダッシュボードを、書面によるビジネス上の背景情報と併せて確認するなど、視覚的な要素がより広範な推論タスクの一部となる場合に特に有用です。.
明確なゴールが定められた主体的なワークフロー
関数の呼び出しや構造化された出力により、「問題の調査」「ツールの起動」「計画の更新」「機械可読な結果の返却」といったワークフローがサポートされます。最も安全な出発点は、権限が制限され、明確な終了条件と客観的なチェック機能を備えたタスクです。.
| ワークフロー | Grok 4.6が適している理由 | おすすめの最初のタスク |
|---|---|---|
| コーディング | xAIのポジショニングに加え、APEX-SWEおよびCursorBenchによる実証データ | テストを伴う、真のバグ修正または機能レベルの変更 |
| リサーチ | 500Kコンテキスト、構造化出力、およびDeepSearchQA | ページ位置情報を含む、情報源に基づくブリーフィング |
| 長い文書 | 大きな公式コンテキストウィンドウ | 年次報告書、または複数の文書からなる方針資料一式 |
| 視覚的分析 | 画像入力とxAIによる視覚的作業位置決め | 図表を多用したレポートで、説明文も併記されている |
| 代理店 | 関数の呼び出しと構造化された出力 | 明確なチェッカーを用いた限定的な調査 |
Grok 4.6は、調査や事実確認に対応できますか?
ソースパケットテストでは、Grok 4.6に対し、6つの主張を分類し、承認済みのURLのみを引用し、2つの誘惑的な推論を排除するよう求めました。.
(1) 裏付けあり — xAIの発表日は2026年8月12日であり、同日に「Grok 4.6」をリリースすると記載されている。
(2) 裏付けあり — xAIの公式モデルドキュメントには、モデルIDとして「grok-4.6」が記載されている。
(3) 支持 — 公式ドキュメントには、コンテキストウィンドウが500kであると記載されている。
(5) 矛盾 — これらは異なるTerminal-Benchのバージョンであり、同じ指標ではない。
(6) 矛盾 — 当該ページにはワークスペースのエントリのみが表示されており、すべてのプランに含まれているわけではない。.
Grok 4.6の出力をすべて表示
| 主張 | 判定 | 一文での回答 | 出典URL | 厳密な制限 |
|---|---|---|---|---|
| (1) xAIは2026年8月12日にGrok 4.6を発表した | 支持 | xAIの発表日は2026年8月12日であり、同日にGrok 4.6をリリースすると述べている。 | https://x.ai/news/grok-4-6 | パケットには日付とリリースに関する一文のみが引用されており、投稿全文は含まれていない。 |
| (2) 公式のAPIモデルIDはgrok-4.6である | 支持 | xAIの公式モデルドキュメントには、モデルIDとしてgrok-4.6が記載されている。 | https://docs.x.ai/developers/models/grok-4.6 | Packetの要約には、別名やその他のIDは記載されていない。 |
| (3) 公式のコンテキストウィンドウは500kトークン | 対応 | 公式ドキュメントには、500kのコンテキストウィンドウと記載されている。 | https://docs.x.ai/developers/models/grok-4.6 | パケットには「500kコンテキスト」と記載されており、「トークン」という明示的な言及はない。 |
| (4) Artificial Analysisが独自に測定したインテリジェンス指数は61 | 対応 | AAはGrok 4.6のインテリジェンス指数として61を公表している。 | https://artificialanalysis.ai/models/grok-4-6 | パケットはAAのスコアを報告しているだけで、AAの手法に対する個別の監査結果ではない。 |
| (5) Terminal-Bench 3.0の26%とv2.1の88.4%は直接比較可能 | 矛盾 | これらは異なるTerminal-Benchのバージョンであり、同じ指標ではない。 | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | Packetは両方のスコアを提示しているが、同等性や対応表は示されていない。 |
| (6) GlobalGPT、Grok、4.6のページは、すべてのプランにこのモデルが含まれていることを証明している | 反論 | そのページにはワークスペースのエントリが表示されているだけで、すべてのプランに含まれているわけではない。 | https://www.glbgpt.com/home/grok-4-6 | Packet自体も、これはインターフェースのエントリであり、すべてのプランではないと述べている。 |
レビューの結論: 送信元パケットと応答形式が明示されている場合、このモデルは証拠の境界を適切に遵守しました。これは研究ワークフローにおいて有用ですが、モデルの応答はあくまで研究の補助手段であり、外部の証拠そのものではありません。.
テストの問題文を正確に表示する
添付された出典資料のみを使用してください。6つのクレームそれぞれについて、「支持される」「反証される」「立証されていない」のいずれかを、1文の回答、出典URL、および正確な限定事項とともに返答してください。.
Grok 4.6は、コーディングやデバッグに適していますか?
このJavaScriptの課題では、最小の差分(diff)、数値のソート、奇数・偶数の中央値の適切な処理、不変性、および2つの厳密なエラー条件が求められました。.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}Grok 4.6 によって返された説明を表示する
元の関数は引数を変更し、デフォルトの辞書順ソート()を使用していたため、slice()でコピーを取り、(a, b) => a - b によって数値順に並べ替えています。 TypeError で配列でないものを、Error("empty input") で空の配列を排除した後、結果の要素数が奇数の場合は中央の要素を1つ選び、偶数の場合は中央の2つの値の平均を算出します。これが一般的な中央値です。.主な用途: 中小規模のデバッグ、テスト作成、コードレビュー、および不慣れな関数の説明など。大規模なリポジトリの場合は、このモデルを独自のテストランナーと組み合わせて使用し、マージする前に差分を確認してください。.
テスト範囲を表示する
シグネチャを変更せずに median(values) を修正する。入力データを変更してはならない。配列でない場合は TypeError を、空の配列の場合は Error("empty input") をスローする。最小限の統一差分を返す。.50万語のコンテキストウィンドウは、長い文書を読む際に役立ちますか?
22万トークン以上の検索用データセットには、7つのフィールド、セクション/ページの位置情報、および2つの「Terminal-Bench」バージョンの説明が求められた。.
{
  "release_date": {"value": "2026年8月12日", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "context_window": {"value": "50万トークン", "locator": "p.2"},
  "long_context_input_price": {"value": "$4/100万トークン(20万トークンを超えるプロンプト)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88.4%"]
}Grok 4.6 の JSON 出力をすべて表示
{
  "release_date": {"value": "2026年8月12日", "section": "xAI リリース", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "APIモデル", "locator": "p.2"},
  "context_window": {"value": "500k tokens", "section": "APIモデル", "locator": "p.2"},
  "long_context_input_price": {"value": "100万トークンあたり$4(20万トークンを超えるプロンプト)", "section": "価格設定", "locator": "p.3"},
  "terminal_bench_version": [{"value": "3.0", "section": "ベンチマークカード", "locator": "p.4"},{"value": "v2.1", "section": "独立ベンチマーク", "locator": "p.5"}],
  "terminal_bench_score": [{"value": "26%", "section": "ベンチマークカード", "locator": "p.4"},{"value": "88.4%", "section": "独立ベンチマーク", "locator": "p.5"}],
  "evidence_limits": {"value": "2つのTerminal-Benchの結果は、ベンチマークのバージョンが異なるため比較できません。実稼働時の利用可能性については記載されていません。", "section": "独立ベンチマーク", "locator": "p.5"}
}
これが示すことは: このモデルは、厳格なスキーマに基づいて、ノイズの多い大容量のパケットから情報を抽出し、構造化することができます。. これが証明していないこと: 任意の顧客文書に対して、50万トークンごとのリクエストがすべて同等の速度、コスト、精度で処理されること。.
Grok 4.6は、厳格な指示に従い、透明性のある推論を行うことができますか?
制約付き割り当てパズルに対して、このアルゴリズムは唯一の解を返しました。それは、「研究 7 時間、コーディング 9 時間、QA 8 時間」というものです。.
{"R":7,"C":9,"Q":8,"total":24,"check":"これらの値は、C=R+2 および Q=R+1 を満たす R+C+Q=24 の条件を満たしています。"}正確なプロンプトを表示する
24時間を「調査(R)」「コーディング(C)」「品質保証(Q)」に配分してください。 整数のキー「R」、「C」、「Q」、「total」と、1文の検証文を含むJSONのみを返すこと。制約条件:R + C + Q = 24、C = R + 2、Q = R + 1。推論の過程は明示しないこと。.
個別の制約付き書き換えタスクについて、クライアントが2回試行したにもかかわらず、APIレスポンスが返されませんでした。これは品質スコアではなく、インフラストラクチャの異常として記録されています。このことから得られる教訓は、編集制作においてフェイルオーバーの手段を確保しておくべきだということです。.
Grok 4.6はいくらですか?
| オプション | 現在の公表価格 | 最適 | 重要な境界 |
|---|---|---|---|
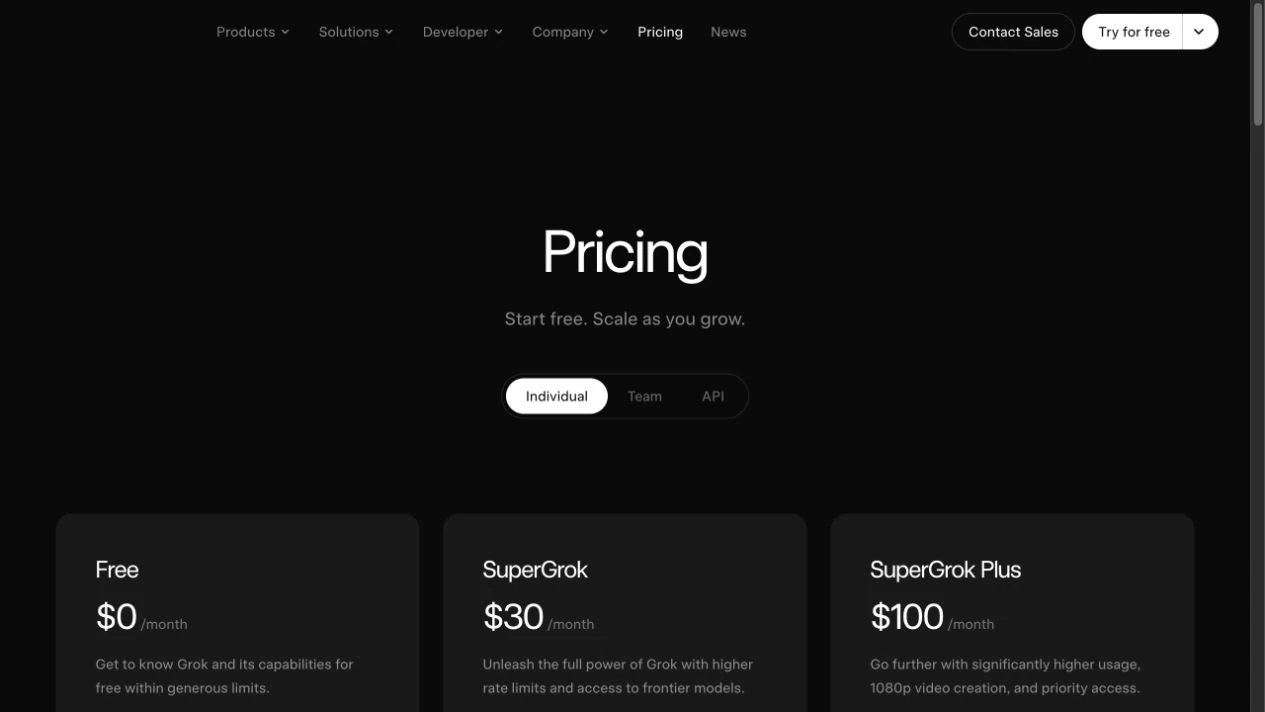
| xAI コンシューマー版(無料) | $0/月 | ネイティブのユーザー体験を試してみる。. | 無料プランのアクセス権限や利用制限は変更される場合があります。. |
| スーパーグロック | $30/月 | 一般消費者向け;現在のページには Grok 4.6 が記載されています。. | 公開する前に、現在の権限を確認してください。. |
| SuperGrok Plus | $100/月 | 消費量が非常に多い。現在のページには「Grok 4.6」と記載されている。. | 他のプランへのアクセス権があるとは推測しないでください。. |
| xAI API ベーシックプラン | $2/M 入力;$6/M 出力;$0.50/M キャッシュ付き入力 | 利用状況に応じた連携機能を構築する開発者。. | 工具は、該当する場合、別途請求されます。. |
| xAI API ロングコンテキスト・ティア | 200K以上:$4/M入力、$1/Mキャッシュ、$12/M出力 | 非常に大規模なプロンプトや文書。. | 20万以上のリクエストについては、基本価格を適用しないでください。. |
| グローバルGPT | 現在のGlobalGPTの計画をご覧ください | 1つのワークスペース内で、Grokと複数の主要モデルを比較する。. | すべてのプランに「Grok 4.6」が含まれているとは限りませんので、プランのページをご確認ください。. |
Grok 4.6 APIリクエストの費用はいくらになりますか?
| リクエストの例 | 計算 | モデル・トークンあたりの推定コスト |
|---|---|---|
| 入力50K + 出力5K | 50K × $2/M + 5K × $6/M | $0.13 |
| 入力100K + 出力10K | 100K × $2/M + 10K × $6/M | $0.26 |
| 入力250K + 出力10K | 250K × $4/M + 10K × $12/M | $1.12 |
| 入力400K + 出力20K | 400K × $4/M + 20K × $12/M | $1.84 |
xAIの定価を用いた計算例です。これには、キャッシュされた入力データに対する割引、税金、ツール利用料、およびサードパーティプロバイダーによる上乗せ分は含まれていません。.
「すべてのタスクを1つのAPIに割り当てるにはどうすればよいか」ではなく、「このタスクにはどのモデルが最適か」という判断を下す場合、GlobalGPTは非常に適しています。1つのワークスペース内で、執筆、調査、コーディング、分析のプロンプトを比較検討し、その後、 GlobalGPTの価格ページ ご利用状況に合ったサブスクリプションをお選びください。これは複数のモデルを組み合わせたサブスクリプションの推奨案であり、GlobalGPTクレジットをxAIトークンの価格に換算したものではありません。.
Grok 4.6にはどのようにアクセスすればよいですか?
消費者は、xAIの現在の「Grok」サブスクリプションプランから利用を開始できます。開発者は、xAIの公式APIドキュメントと正確なモデルIDを参照してください。 grok-4.6. 複数のAPIアカウントを設定せずにモデルを比較したい読者は、以下の グローバルGPT; プラットフォームのUIへのアクセスは、xAIのすべてのネイティブ機能と混同すべきではありません。.
Grok 4.6の主な制限事項は何ですか?
- 最新の情報には、依然として裏付けが必要です: 2026年1月の事前研修の締め切りは、実戦的な知識が確実に身につくことを保証するものではありません。.
- ベンチマークに関する見出しは誤解を招くことがある: スコアには、バージョン、評価者、推論の労力、およびデータセットが必ず添付されていなければなりません。.
- 文脈が長いとコストが高くなる: 200Kトークンを超えるプロンプトは、より高いレベルのロングコンテキストAPIティアを使用します。.
- ルートの信頼性はさまざまです: 他のタスクは正常に完了したにもかかわらず、制約付きの編集リクエストでインフラストラクチャの障害が発生しました。.
- プラットフォームへのアクセス方法は一律ではありません: GlobalGPT ワークスペースのエントリは、すべてのネイティブ xAI 機能やすべてのサブスクリプション権限を含むことを意味するものではありません。.
Grok 4.6と、他のAIモデルのどちらを選ぶべきでしょうか?
長文のコンテキスト、コーディング、構造化された推論が業務の中心となる場合は、Grok 4.6 を選択してください。 特定のツールエコシステム、予測可能な低コスト、特定のマルチモーダル出力、あるいはチームがすでに十分にサポートしているワークフローを最優先とする場合は、別のモデルを選択してください。最も公平な比較を行うには、モデルを問わず同じプロンプト、同じソースパケット、同じチェッカーを使用する必要があります。GlobalGPTを使えば、これを簡単に設定できます。.
Grok 4.6はどのような方に適していますか?
- 研究者およびアナリスト: ソースパケット、証拠表、および長文の弁論書。.
- 開発者: デバッグ、コードレビュー、および体系的な実装計画。.
- 制作・編集: 明確な指示書とスタイルガイドが提供されていれば、長文の起草作業はスムーズに進みます。.
- モデルを比較しているチーム: 1つのワークスペース内で、同じプロンプトを用いた評価を繰り返し実行できる。.
Grok 4.6について、読者からは普段どのような質問が寄せられますか?
Grok 4.6は正式にリリースされましたか?
はい。xAIのリリース発表日は2026年8月12日です。.
公式のAPIモデルIDは何ですか?
grok-4.6.
コンテキストウィンドウとは何ですか?
xAIは、50万トークンのコンテキストウィンドウを記録します。.
Grok 4.6は画像に対応していますか?
はい。公式のモデルドキュメントには、画像入力とテキスト出力が記載されています。.
Grok 4.6はいくらですか?
現在の消費者向けページには、「Free」プランが月額$0、「SuperGrok」プランが月額$30、「SuperGrok Plus」プランが月額$100と表示されています。 APIの料金体系は使用量ベースとなっており、20万トークンを超える場合は別途「ロングコンテキスト」料金帯が適用されます。.
Grok 4.6は、Grok 4.5よりも優れていますか?
これは比較的新しいもので、引用されたいくつかの評価では優れた性能を発揮していますが、対象となるタスクやベンチマークのバージョンが異なります。ご自身の定期的なワークフローでテストしてみてください。.
Grok 4.6をGlobalGPTで使用することはできますか?
GlobalGPT には、Grok 4.6 ワークスペースのエントリが反映されています。価格ページで現在のプランの権利内容をご確認ください。.
Grok 4.6は研究用途として信頼できるでしょうか?
制約付きソースパケットテストでは良好な結果を示しましたが、重要な主張については、常に引用元と照らし合わせて確認する必要があります。.
2026年にGrok 4.6を使う価値はあるでしょうか?
Grok 4.6は、信頼性の高い公式リリースモデルであり、50万文字という実用的なコンテキストウィンドウ、設定可能な推論機能、確固たる公開ベンチマーク結果、そして構造化された研究タスクや長文処理タスクにおける良好な初期評価結果を備えています。その弱点も同様に実用的なものです。すなわち、ベンチマーク数値にはバージョンラベルを慎重に付ける必要があり、ライブファクトには依然として情報源が必要であり、ルート信頼性にはばらつきが見られることがあります。.
ネイティブでの消費者向けアクセスやAPI開発については、まずxAIの最新ドキュメントをご覧ください。比較を重視したワークフローについては、, Grok 4.6をGlobalGPTで試してみてください 他の主要なモデルと併せて、ご自身の執筆、調査、分析、またはコーディングの作業量に合ったプランをお選びください。.
一次資料: xAIのリリース, xAIモデルのドキュメント, xAI APIの料金体系, xAIの一般消費者向け価格, 人工分析, Mercor APEX-SWE そして xAI モデルカード.