候補に挙げるべき最適なAIモデルは、完了させる必要がある作業によって異なります。テキスト、コーディング、推論については、現在のGPT、Claude、Gemini、Grok、DeepSeek、Qwenの各シリーズを比較検討してください。 画像処理については、GPT Image、Nano Banana、Midjourneyを検討してください。動画処理については、プロジェクトに必要な生成機能や編集機能から検討を始めましょう。また、研究アシスタントには、強力な言語モデルだけでなく、検索機能や信頼できる情報源も必要です。.
まず、最も困難な定常的なタスクから着手し、それを確実に完了できる最も安価なセットアップを選びましょう。説得力のある段落を作成できるモデルであっても、文書を誤読したり、引用をでっち上げたり、動作しないコードを生成したりする可能性があります。以下の推奨事項は、公式のモデルドキュメントと実用的な選定基準に基づいています。これらはタスクごとの候補リストであり、スコアのランキング表ではありません。.
グローバルGPT 複数のモデルファミリーとAI機能を1つのサブスクリプションに統合しているため、同じワークスペース内で、調査や執筆から画像や動画の制作へとスムーズに移行できます。1週間の業務でさまざまな種類の作業をこなす場合や、管理するサブスクリプションの数を減らしたい場合には、実用的でコストパフォーマンスに優れた選択肢となります。.
2026年9月15日時点で確認された公式のモデル一覧。過去の事例には、元のモデル名が記載されています。.
まずどのAIモデルを選べばよいでしょうか?
タスク別の実用的な候補リスト
| あなたの課題 | 比較対象の候補者 | 選択の決め手となるべきものは何か |
|---|---|---|
| 日常のテキストとコーディング | GPT-5.6 テラ; Claude Sonnet 5; Gemini 3.8 フラッシュ | 手順の順守、有用な出力、および必要な編集の量。. |
| 難解な推論や長文のコーディング | GPT-6 Astra;Claude Opus 5 または Fable 5.1;Qwen3.8 | 必要なツールと権限を活用して、困難な案件を自力で成功に導きましょう。. |
| 大容量の文書やさまざまな形式の入力データ | Gemini 3.1 Pro プレビュー;現行のGPTおよびClaudeモデル | ファイルの対応、正確な検索、出典の明記――単なる容量だけではありません。. |
| 最新の研究 | 検索機能付きアシスタント;Perplexity;検索ツールを備えたGrok | 情報源の信頼性、掲載日、および引用が回答を裏付けているかどうか。. |
| 大量のAPI処理 | GPT-5.6 Luna、DeepSeek V4.1 Flash、および適切な小型モデルであるQwen | 承認された結果1件あたりのコストに加え、レイテンシおよびデプロイメント要件。. |
| 画像の作成と編集 | GPT Image 2.5;Nano Banana ファミリー;Midjourney | テキストの正確性、参照画像の制御、視覚的なスタイル、および再現性。. |
| 映像制作 | Veo 3.1 および、必要な操作機能を備えた動画編集ツール | モーション、連続性、音声、編集可能なワークフロー、そして実用的なエクスポート機能。. |
まず、必要なスキルやツールを照らし合わせ、その後、確認可能な成果物に基づいて候補者を比較してください。.
あらゆる要求に対して、最も高性能なモデルを購入する必要はありません。日常的な情報抽出、短い文章の書き換え、書式設定などには、多くの場合、明確な「合格/不合格」の基準があります。より高性能な推論モデルは、安価なオプションではその基準を満たせない場合に備えて取っておくべきです。単発のタスクにおいては、APIコストのわずかな差よりも、最もシンプルで実用的なアプリを選ぶことの方が重要になる場合があります。.
AIモデル、アプリ、サブスクリプションはそれぞれ異なる選択肢です
AIモデルとは、入力に対して出力を生成するシステムのことです。アプリは、ファイルのアップロード、検索、会話履歴の保存、画像ツール、他のソフトウェアとの連携といった作業環境を提供します。 サブスクリプションは、その環境へのアクセス方法や利用制限を決定するものです。GPTはモデルファミリーであり、ChatGPTは製品であり、ChatGPTプランは購入の決定事項です。この区別は、ClaudeモデルとClaude Proにも同様に当てはまります。.
GlobalGPTはマルチモデルプラットフォームであるため、ワークフローやアクセスに関する議論の対象となります。一方、Perplexityは、この比較において主に研究向けの製品であり、そのAPIモデルや開発者向けサービスは別のレイヤーに位置づけられます。 これらすべての名称を単一の「ベストモデル」ランキングにまとめると、各製品が解決する課題が異なるため、購入の意思決定が難しくなります。.

- [選択] アプリ ファイルや会話、クリエイティブな作業のために、すぐに使えるインターフェースが必要なとき。.
- [選択] API ソフトウェアが自動的にリクエストを送信し、その結果を処理する必要がある場合。.
- [選択] オープンウェイト展開 要件として、モデルを自ら実行する必要がある場合。その判断にあたっては、ハードウェア、保守、およびセキュリティに関する作業も考慮に入れてください。.
画像を入力として受け付けるモデルであっても、必ずしも画像を出力するとは限りません。同様に、コンテキストウィンドウが大きいからといって、チャットアプリがどのようなサイズのファイルでも受け付けるわけではありません。価格を比較する前に、モデル、製品の機能、およびプランを照らし合わせて確認してください。.
最終選考に残すべき文章・コーディング・推論のモデル
OpenAI:GPT-6 Astra および GPT-5.6 シリーズ
OpenAIのモデルカタログ 複雑な推論やコーディングにはGPT-6 Astraを、性能とコストのバランスを重視する場合はGPT-5.6 Terraを、コスト重視で処理量が多い作業にはGPT-5.6 Lunaを推奨しています。また、複雑な専門業務にはGPT-5.6 Solも挙げられています。 これらは、同一シリーズ内における予算やタスクに応じた選択肢であり、単に最も高価なモデルを自動的に選ぶべきという理由ではありません。.
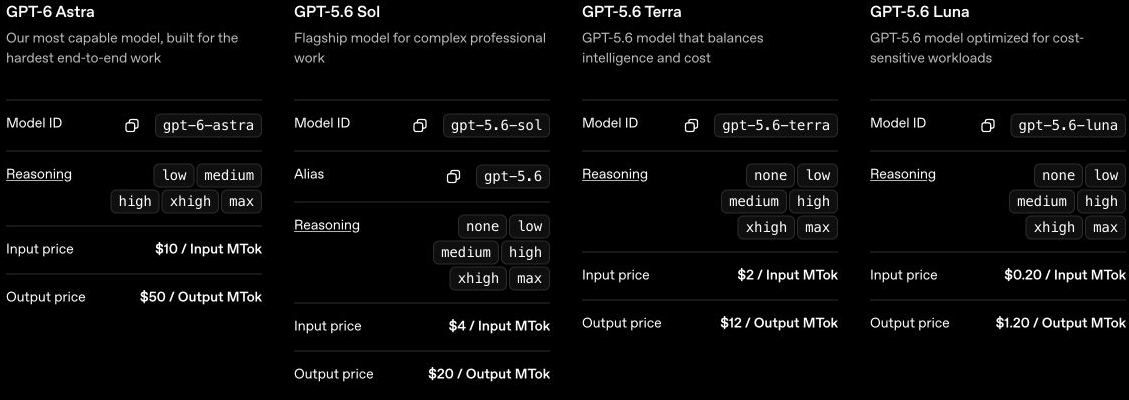
開発者にとっては、2人の候補者間で同じ失敗する関数、テストスイート、および受け入れ基準を比較することが有用です。アナリストの場合は、同じソース文書を使用し、両方のモデルに対して、各結論の根拠となる証拠を特定するよう求めます。コードが実行されない場合や、引用された文書に別の内容が記載されている場合、流暢な説明だけでは不十分です。.
- 以下の情報については、こちらからご覧ください: 文章、体系的な課題、論理的思考、およびコーディング課題が組み合わさったものです。.
- 比較: 日常的なワークロードにはTerraまたはLunaを、より負荷の高いケースで追加コストが見合う場合にはSolまたはAstraを使用します。.
- アクセス 以下のAPI料金は、開発者トークンの利用料です。これらは、ChatGPTのサブスクリプション料金やツールごとの利用料とは別です。.
Claude:Sonnet 5、作品5、およびFable 5.1
Anthropicの現在のラインナップ これには、Claude Sonnet 5、Opus 5、Fable 5.1、およびHaiku 4.5が含まれます。Anthropicは、ほとんどのワークロードではOpus 5を推奨し、Opusでの評価ではまだ不十分な場合、要求の厳しい推論や長期的なエージェント作業にはFable 5.1を推奨します。 これは有用なアップグレードのルールです。つまり、タスクを試す前にではなく、実際の失敗を確認した後に、より高度なモデルに投資するということです。.
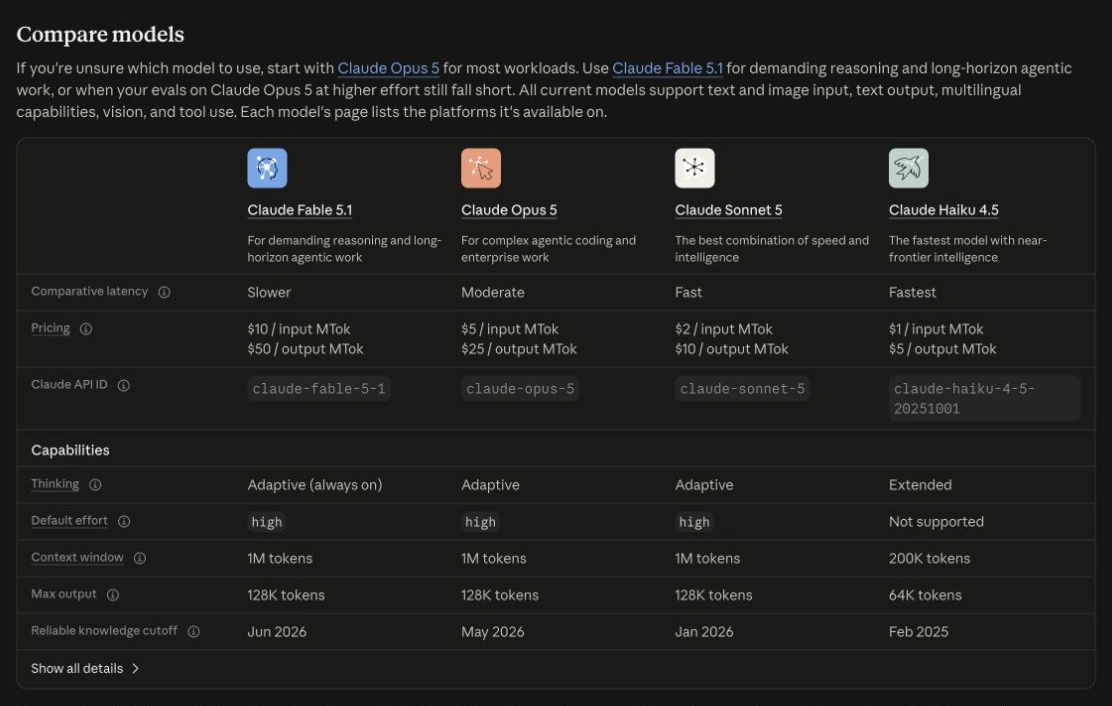
文章作成の場合は、数回の編集を経て、モデルが事実関係、文体、制約条件を適切に維持しているかどうかを判断してください。コーディングの場合は、モデルが生成した変更内容と、それが通過したテストを評価してください。長文の回答は印象的ですが、レビューに手間がかかります。最小限の完全な成果物――修正されたセクション、動作するパッチ、あるいは追跡可能な根拠に基づく決定――を求めるようにしましょう。.
- 以下の情報については、こちらからご覧ください: 長文の執筆、コードレビュー、および提供された資料を慎重に活用する必要があるプロジェクト。.
- 比較: 通常の作業にはSonnet 5を、負荷の高い作業にはOpus 5またはFable 5.1を使用してください。これは選択肢の順序を示すものであり、独立した品質ランキングではありません。.
- アクセス ClaudeのアプリサブスクリプションとAPIの課金は異なります。比較する Claudeの計画 そして APIと利用状況の内訳 ご購入予定の路線について。.
この2つのエコシステムのどちらを選ぶか迷っているなら、 Claude と ChatGPT の比較 ここでは、製品レベルの考慮事項について説明します。旧モデルのベンチマーク順位を、類似した名称の新リリースに引き継がないでください。.
Gemini:Flash 3.8 および Pro 3.1 プレビュー版
Googleのモデルディレクトリ Gemini 3.8 Flashを安定版モデルとして、Gemini 3.1 Proをプレビュー版として掲載しています。3.8 Flashについては、ソフトウェアエンジニアリング、自律エージェント、複雑なエンタープライズワークフローに関する説明がなされており、3.1 Proは引き続き複雑な問題解決の候補となっています。 「Flash」と「Pro」は製品ファミリーの名称であるため、ラベルそのものよりも、具体的なバージョンやリリース状況の方が重要です。.
レポートと画像、あるいは動画と文字起こしといった、複数の入力が混在するタスクでは、Geminiを候補リストに含める価値があります。回答が正しいページ、フレーム、または文章の箇所を参照しているかどうかを検証してください。これにより、モデルが資料を受け入れたものの、そこから誤った詳細情報を抽出ししてしまうという、長文コンテキスト処理におけるよくある失敗を検出できます。.

Googleの 元のベンチマーク表 上記の2つのバージョンの比較データを提供しています。これはベンチマークの条件を理解する上で役立ちます。ツールを使用している行と使用していない行では、それぞれ異なる疑問に答えています。また、「詳細な背景」のセクションでは、128Kの平均値と1Mの点ごとの結果が区別されています。 「より優れた推論」や「より長い記憶」といった主張を評価する際は、こうした区別を念頭に置いてください。“
購入や設定に関するご質問については、以下をご覧ください。 Geminiのサブスクリプションプラン そして Geminiのサブスクリプション設定. . Gemini 3.1 Pro と Claude Opus 4.6 の比較 これはバージョンごとの比較であり、新しいClaudeシリーズに関する証拠ではありません。.
Grok 4.6:モデルと実際の検索を分離する
Grokモデルのドキュメント コードや一般的なテキスト処理タスクについては、500KトークンのコンテキストウィンドウでGrok 4.6と記載されています。また、重要な制限として、検索ツールが有効になっていない限り、モデルは学習データ以外の時事問題については認識できないと明記されています。 最新情報を得るには、単に「Grok」という名称ではなく、「Web Search」や「X Search」を利用するのが実用的な選択肢となります。.

ニュースやトレンドのモニタリングワークフローにおいては、アシスタントが元の報道記事を見つけ出し、再投稿記事と日付を区別し、その主張を出典に紐付けられているかどうかを評価してください。検索機能は、最終的な解釈が正しいとは限らない状態で資料を抽出することがあります。 常時更新される記事の執筆やコード作成のタスクにおいては、ソーシャル検索との関連性から「Grok」が不適切であると決めつけるのではなく、出力結果を自身の受け入れ基準と照らし合わせて比較してください。.
DeepSeek:現在のAPIオプションとコスト管理
DeepSeekのAPI一覧表 地図 deepseek-flash DeepSeek V4.1 フラッシュおよび deepseek-v4-pro DeepSeek V4 Pro 0813 へ。同じ表によると、Flash はビジョンに対応しているが、記載されている Pro ルートは対応していない。したがって、名称がより大げさに聞こえるからといって、お使いの入力方式が必ずサポートされるとは限らない。.
DeepSeekは、コスト面を考慮したAPIの候補として有用ですが、請求条件をすべて比較してください。このAPIの料金表では、キャッシュヒットとキャッシュミス、およびピーク時間帯とオフピーク時間帯が区別されています。提示されている最低価格は、特定の期間におけるキャッシュされたリクエストの料金を表している可能性があり、通常のキャッシュされていないリクエストのコストとは異なる場合があります。.
- 以下の情報については、こちらからご覧ください: 価格とデプロイメントの互換性が重要な、定期的なAPIワークロード。.
- まず確認してください: 正確なモデルマッピング、画像入力のサポート、および出力要件。.
- 予算を適切に立てる: 保守的な初期推定値として、キャッシュされていない入出力レートを使用してください。キャッシュやタイミングの最適化による節約効果は、ワークロードが条件を満たす場合にのみ適用してください。.
Qwen:複数のサイズを備えたオープンモデルファミリー
Qwenの公式リポジトリ Qwen3.5オープンモデルシリーズを対象としており、3.6およびそれ以降のQwen3.8リリースも含まれます。 このリストにはQwen3.8-27BおよびQwen3.8-2.4T-A95Bが記載されており、それ以前の3.5サイズには0.8B、2B、4B、9Bが含まれます。 これらの名称は、それぞれまったく異なる導入要件を表しており、小型のローカルモデルと大型のフラッグシップモデルは互換性がありません。.

ローカルでの作業において有用な質問は、「自分のハードウェアで何がスムーズに動作するか?」です。モデルの重み、実行時のオーバーヘッド、および会話が長くなるにつれて消費されるメモリ量も考慮に入れてください。 量子化を行うことでモデルの実行が容易になる場合がありますが、そのタスクへの影響については評価の段階で検討する必要があります。リポジトリには、llama.cpp や MLX を含むローカルフレームワークのオプションが記載されています。デプロイを行う前に、該当するモデルカードとライセンスを必ず確認してください。.
研究を行う際には、情報源や検索ツールに加え、モデルも選択してください。
Perplexityは、回答と出典情報を組み合わせた検索・調査ツールです。一般ユーザー向けプランでは、検索ツール、モデル、アップロード機能へのアクセス権限が決まっていますが、「Sonar」および開発者向けAPIサービスは別途選択する必要があります。出典情報が豊富な回答は、リンクされた情報源がその回答の主要な主張を実際に裏付けている場合にのみ有用です。.
たまにリサーチをするだけなら、まずは「無料版」から始めてみましょう。基本的な検索、自動モデル選択、およびアップロードの制限があります。 公式計画の比較, 2026年9月15日時点の情報によると、無料プランでは1日あたり3回の「Pro Search」と1ヶ月あたり1回の「Research」クエリが利用可能ですが、高度なAIモデルや画像生成機能は含まれていません。 「Pro」プランでは、高度なモデル、拡張された「Pro Search」、およびアップロードと分析の上限引き上げが追加されます。「Pro Search」の利用枠には週単位の上限が、「Research」には月単位の上限が設定されていますが、一般向け料金表には「Pro」プランの正確な利用回数については記載されていません。.
当惑の 各商品の価格ページ, (2026年9月15日確認)によると、Freeプランは月額$0、Proプランは月額$20、Maxプランは月額$200となっています。これらは表示されている月額料金であり、年間料金や税込みの決済総額ではありません。 代表的な調査クエリで無料版をお試しいただき、高度なモデルや利用制限の緩和が継続的なニーズに応えるようであれば、有料プランのご利用をご検討ください。.
回答を受け入れる前に、簡単な情報源チェックリストを作成しましょう。重要な数値についてはその情報源を開き、一次報道であるかを確認し、公開日を確認し、直接引用と担当者の解釈を区別してください。価格や製品の入手可能性など、変化しうる事実については、総まとめ記事よりも、ベンダーの最新の資料の方が信頼性の高い参考資料となります。.
- 文献レビューを行う際は、原著論文を収集し、各論文が取り組んでいる研究課題を特定してください。.
- 購入を決定する際は、具体的なプラン、課金基準、および提示された条件の適用開始日を確認してください。.
- 最新のニュースについては、元の発表内容と、その後掲載された報道記事を照らし合わせてみてください。.
- 議論の分かれる問題については、資料間でどの部分で一致しており、どの部分が依然として不明確であるかを尋ねてください。.
用途 Perplexityのモデルとモード 利用可能な動作モードを理解し、そして 複雑な加入プラン 購入の意思決定において。より高価な推論モデルであっても、関連する文書をソースセットから除外してしまった場合、その欠点を補うことはできない。.
画像モデル:編集の制御、テキストの精度、または視覚的なスタイルを選択します
GPT画像:実用的な生成と編集
OpenAIの現在のカタログには、画像生成・編集用の「GPT Image 2.5 Sunburst」と、日常的な生成作業を高速化する「GPT Image 2.5 Flare」が掲載されています。同じ広告、図表、または製品画像の仕様書を基に、想定される修正を含めて、これら2つの製品を比較してみてください。.
ビジネス用画像を作成する際は、具体的なテキスト、レイアウト、必要なオブジェクトを明確に指定してください。その後、最終的な表示サイズで結果を確認してください。見栄えの良いインフォグラフィックであっても、ラベルのスペルミスや、一見妥当に見えても実際には誤った数値が含まれていることがあります。ビジュアルで事実を伝える場合は、画像の外観とは別に、その事実そのものを検証してください。.

Nano Banana:参照画像に基づく画像の作成と編集
Googleのディレクトリでは、「Nano Banana Pro」、「Nano Banana 2」、「Nano Banana 2 Lite」が区別されています。「Nano Banana Pro」は ジェミニ-3-プロイメージ; Nano Banana 2 から gemini-3.1-flash-image; そして Lite を gemini-3.1-flash-lite-image. 生成と編集の挙動を比較する際は、ニックネームを不変のモデルとして扱うのではなく、具体的なルートを選択するようにしてください。.

リファレンス編集は、単発の画像生成とは異なるレビューが必要です。依頼された変更は反映されましたか?背景、服装、顔、または商品の詳細が意図せず変更されていませんか?画像の他の部分はそのままに、わずかな編集を加える方が、大幅な作り直しよりも有用な場合があります。参照: Nano Banana Pro の使い始め, アクセスルート そして Nano Banana Proの価格 今後の手順について。.
Midjourney:ブリーフに基づいてスタイルを評価する
Midjourneyの 公式バージョンガイド, 2026年9月15日時点の情報によると、デフォルトバージョンは7月24日にリリースされたV8.2となっています。今回のアップデートでは、ビジュアル面とカスタマイズ機能に重点が置かれており、「Omni Reference」「Character Reference」「Retexture」に代わる「Edit Model」機能が導入されました。ムードボードやコンセプトアート、あるいは独創的なキャンペーン制作に活用してみてください。 コンセプトスケッチには説得力のあるスタイルが、説明付きの製品図には正確な内容が求められます。完成品や修正案を、その企画書の内容と照らし合わせて確認してください。.
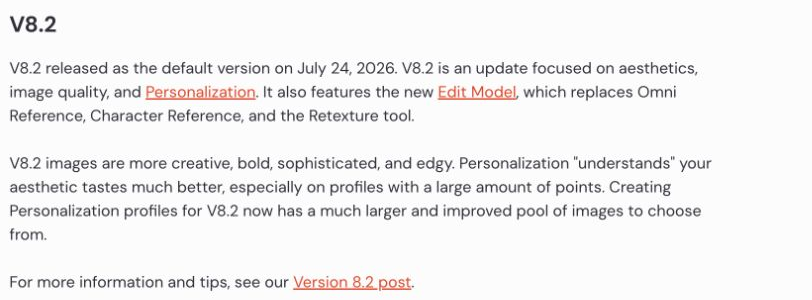

有意義なテストを行うためには、対象、必要な構成、およびエクスポート形式を統一してください。最初からやり直さずに、選択した方向性を修正できるかどうかをテストしてください。正確なテキストやアイデンティティの維持が不可欠な場合は、それらについて明確な合否チェックを行ってください。その Nano Banana ProとMidjourneyの比較 その決定を捉えるための別の視点を提供しています。.
動画モデル:魅力的な1コマではなく、クリップ全体を評価する
Veo 3.1 と制作ワークフロー
GoogleのVeoに関するドキュメント クリエイティブな制御機能と音声を備えた動画生成に関するVeo 3.1について解説しています。その例としては、参照画像、シーンの拡張、および最初・最後のフレームのワークフローなどが挙げられます。これらの制御機能は、単体のクリップではなく、複数のショットを同じストーリーに組み込む必要がある場合に重要となります。.
後で修正するのが最も難しい制作上の制約をテストしてみましょう。例えば、キャラクターの一貫性、形を保った製品、読みやすい看板、あるいはセリフのタイミングの合わせ方などです。クリップ全体を通常の速度で再生し、難しいカット転換を一つひとつ確認してください。モデルは冒頭の1フレームでは素晴らしいパフォーマンスを見せても、カメラが動くにつれて失敗してしまうことがあります。.
アクセス、使用、およびエクスポートは製品ルートによって異なるため、以下の内容を比較してください。 Veo 3.1 サブスクリプションおよび利用オプション クリエイティブの制御機能と併せて。1秒あたりのAPI呼び出し回数と月額プランを、含まれる利用量や出力形式を考慮せずに直接比較してはいけません。.
ソラ:発表されたサービス終了について説明する
OpenAIの 「ソラ」販売終了のお知らせ, 2026年9月11日に公開されたこの通知によると、Webおよびアプリでのサービスは4月26日に終了しており、APIの停止は2026年9月24日に予定されている。Soraについては、新しい動画ワークフローの出発点としてではなく、既存プロジェクトの移行課題として捉えるべきである。 通知を確認し、日程の変更や最新のエクスポート手順がないか確認してください。.

について Soraのストーリーボード作成ワークフロー, Sora 2 Pro 解説 そして バージョン別「ソラ」の持続時間ガイド 歴史的特徴を説明する。それらを用いて、既存のプロジェクトにおいて何を保存すべきかを特定し、比較する。 そらの代替案 それらの要件に照らして評価してください。プロンプト、参考資料、および出力結果の全文をまとめて保管し、同じ要件に基づいて代替案を評価できるようにしてください。.
同じワークロードにおけるAPIコストを比較する
APIの課金は、入力トークンと出力トークンに対して行われます。利用者はサブスクリプションを購入することで、プランに基づくアクセス権を取得します。 これらの予算は区別して管理してください。以下の計算では、100件のリクエストを想定しており、各リクエストにはキャッシュされていない入力トークンが10,000個、課金対象の出力トークンが1,000個含まれています。合計で100万個の入力トークンと10万個の出力トークンとなります。これはあくまで例示のためのワークロードであり、実際の請求額や品質ベンチマークを示すものではありません。.
米ドル、標準的なトークンレート(2026年9月15日時点)。指定されたショートリクエスト。キャッシュ割引、バッチ割引、優先ランク、税金、有料ツールは適用されません。出力許容量には、該当する場合、課金対象の推論トークンが含まれます。出典: OpenAI モデルカタログ, Anthropicモデルの概要, Grokのモデルと価格.
最低価格のトークン課金プランは、結果がチェック基準を満たす場合にのみ有用です。より安価なモデルで繰り返し試行が必要だったり、手動での大幅な修正が必要だったりする場合は、承認された結果1件あたりのコストを比較してください。明確で反復的なタスクについては、まず低コストの候補モデルから始め、最初の結果が失敗した場合は、より高性能なモデルに難しいケースを振り分けてください。.
計算の根拠となる料率
| モデル | 入力 / 100万トークン | 出力 / 100万トークン |
|---|---|---|
| GPT-5.6 Luna | $0.20 | $1.20 |
| クロード・ハイク 4.5 | $1.00 | $5.00 |
| Grok 4.6 | $2.00 | $6.00 |
| クロード・ソネット第5番 | $2.00 | $10.00 |
| GPT-5.6 Terra | $2.00 | $12.00 |
| GPT-5.6 Sol | $4.00 | $20.00 |
| Claude Opus 5 | $5.00 | $25.00 |
| GPT-6 アストラ | $10.00 | $50.00 |
| Claude Fable 5.1 | $10.00 | $50.00 |
これらはAPIの利用料金であり、月額利用料ではありません。上記のワークロードでは、入力サイズと課金対象となる出力サイズを一定に保っていますが、実際の出力長、精度、速度がこれと同じであるとは想定していません。.
DeepSeekでは、別の時間帯別料金体系が採用されています。 現在の V4.1 フラッシュテーブルによると、キャッシュされていない入力の料金は 100 万トークンあたり、オフピーク時が $0.15、ピーク時が $0.30 であり、出力の料金は 100 万トークンあたり、オフピーク時が $0.60、ピーク時が $1.20 となっています。 V4 Pro では、キャッシュされていない入力は $0.66/$1.32、出力は $1.98/$3.96 と記載されています。 文書化されているピーク時間帯は、月曜日から金曜日までのUTC 01:00~04:00 および 06:00~10:00 です。ジョブの実行時に適用されるレートを使用してください。キャッシュ付き入力の価格は、別途計算する必要があります。.
日常的な混合ワークフローにおいては、, GlobalGPTのマルチモデル・サブスクリプション 調査、草案作成、コーディング支援、クリエイティブ生成をまとめて扱う、よりシンプルな方法を提供します。その利便性と幅広い機能性を、複数のサブスクリプションを管理したり、APIワークフローを自作したりする場合と比較してみてください。APIの価格表には、サブスクリプションの価格や利用規約は記載されていません。.
オープンウェイトかホスト型か:管理の範囲を決定する
オープンウェイトを利用することで、自身が管理する環境でモデルを実行するという選択肢が得られます。ただし、それによってワークフロー全体が自動的に無料、非公開、または制限なしになるわけではありません。対象のモデルに付随するライセンス、実行に必要なハードウェア、および関連アプリケーションがファイルやログをどこに送信するかを必ず確認してください。.
- ホスト型アプリを選択する すぐに使い始めたい場合で、モデルを操作する必要がないとき。.
- ホスト型APIを選択する 推論用ハードウェアの保守を必要とせずに自動化を実現したい場合。.
- オンプレミスでの導入を検討する オフラインでの作業、インフラの管理、あるいは特定のデータ処理要件によって、その価値がある場合。.
- お使いのハードウェアで、より小型のモデルを比較する より多くのパラメータを持つフラッグシップモデルを採用することが現実的な選択であるとは、安易に決めつけるべきではない。.
ローカルモデルを採用すれば外部へのデータ転送を削減できますが、システムのその他の部分――検索機能、プラグイン、テレメトリ、保存された履歴、バックアップ――も依然として重要です。チームとしては、「オープン」という言葉から推測されるような約束ではなく、デプロイメントのレビューとして捉えるべきでしょう。その AIデータプライバシーガイド データ処理の要件を比較するための背景情報を提供します。.
AIモデルは1つ使うべきか、それとも複数使うべきか?
繰り返し行うタスクをうまく処理してくれるモデルが1つあれば十分です。特定の課題――情報源へのアクセス改善、必要な入力形式の対応、より制御しやすい画像編集、あるいは低コストなバッチ処理など――を解決できる場合は、別のモデルを追加しましょう。各モデルにタスクを割り当てずにサブスクリプションをまとめて管理すると、意思決定や引き継ぎの手間が増えます。.

成果物を軸にワークフローを構築する
| 仕事 | 役立つ手順 | 受入検査 |
|---|---|---|
| マーケティング | 調査資料 → 草案 → 図表の作成 → 主張内容の確認 | このキャンペーンの主張は裏付けられており、コピーとビジュアルは同じメッセージを伝えています。. |
| ソフトウェア開発 | 問題を把握する → コードを変更する → テストを実行する → 差分を確認する | この変更により、要件を満たしつつ、他の部分に予期せぬ影響を与えることはありません。. |
| コンテンツ制作 | 構成 → 脚本 → 参考画像 → 撮影 → 編集 | 登場人物、商品の詳細、物語の展開は一貫しています。. |
| スタートアップの運用 | 意見の要約 → 決定事項の抽出 → フォローアップ案の作成 | 決定には決定者および日付が明記され、根拠のない事実は記録に盛り込まれない。. |
| 企業向け業務 | 承認済みの環境を選択 → 許可されたデータを処理 → 出力を確認 | このワークフローは、組織のアクセス、データ、およびレビューに関する要件を満たしています。. |
まずは1つの完成した成果物から始めましょう。ツール間を移動させる際は、そのソースノートや受入検査記録を成果物と一緒に保管しておいてください。.
GlobalGPTは、モデルファミリーとクリエイティブ機能を1か所に集約することで、多段階のプロセスに対応します。タスクを切り替える際も、役立つソースノート、概要、および受け入れ基準を作業内容と一緒に管理できます。その オールインワンAIモデルの概要 特定の専門モデルではなく、ワークスペースの幅広さを重視して選択する場合、これは次に読むのに役立つ資料です。.
選び方:繰り返し行える5つのステップによる評価法
- 1つの成果物を定義してください。. 例えば、ページ番号の記載がある500語の要約、3つのテストに合格したパッチ、あるいは2つの正確なラベルが付いた製品画像などです。.
- 妥当な候補を2つ選んでください。. まず、必要な入力とツールを照らし合わせてください。検索機能を備えたアシスタントと、検索ツールが一切与えられていないモデルを比較し、その違いを「モデルの知能」と呼んではいけません。.
- 同じ要件と入力情報を使用してください。. モデル、製品、設定、日付を記録してください。最も見栄えのよいショットだけを選ぶのではなく、最初に完成した結果を保存してください。.
- スタイルよりも、まず正しさを確認してください。. 引用を確認し、関連するコードのテストを実行し、画像や動画の詳細を点検します。必要な手動による修正内容を記録します。.
- 難しい問題を繰り返し解いてください。. 選択が拮抗している場合や結果に一貫性がない場合は、それらのケースを繰り返し、追加の結果を別途管理してください。選定は、許容可能な出力、労力、および総コストに基づいて行います。.
執筆においては、提示された事実がすべて書き直し後も残っているかどうかを確認すると役立ちます。情報抽出においては、出力結果を簡単な解答例と比較してください。調査においては、引用されたページを開いて確認してください。動画については、クリップ全体を保存して視聴してください。その GlobalGPTモデル検証手法 比較を記録するための追加の背景情報を提供します。.
次の4つの近道を避けるべきです。人気を理由にモデルを選ぶこと、異なる価格単位を比較すること、単一のベンチマークを課題全体とみなすこと、そして出力生成にかかる時間を無視することです。これらの問題は、最新のモデル名を選んだだけでは解決しません。再現性のある評価の方が有用です。なぜなら、モデルが変更された際に再実行できるからです。.
よくある質問
現在、最も優れたAIモデルはどれですか?
絶対的な正解はありません。まずは、テキストやコード向けの現行モデルであるGPT、Claude、Gemini、Grok、DeepSeek、またはQwenの中から選んでみて、その後、タスクの内容、必要なツール、入力データ、予算に応じて選択肢を絞り込んでください。 成果物に必要とされる場合は、専用の画像モデルや動画モデルを使用してください。.
プログラミングには、どのAIモデルを試してみればいいでしょうか?
現在のGPT、Claude、Gemini、Qwenなどのモデルなど、開発ワークフローをサポートする候補を選択してください。同じ課題、コードベース、テストを用いてそれらを比較してください。レビューの負担が少なく、変更が承認されたケースは、自信に満ちた説明よりも優れた選定基準となります。.
コンテキストウィンドウは、大きければ大きいほど良いのでしょうか?
コンテキストウィンドウを大きくすれば、1回のリクエストで扱える資料量を増やすことはできますが、その資料全体にわたって正確な検索や推論が行われるとは限りません。モデルが、回答に必要な正確な箇所、ページ、またはフレームを特定できるかどうかをテストしてください。.
オープンウェイトのAIモデルは無料ですか?
重みデータはライセンスに基づいて利用可能である場合がありますが、その実行にはハードウェア、ホスティング、およびメンテナンスが必要となる場合があります。具体的なライセンス内容と導入コストを確認してください。また、オンプレミスでの導入には、関連するアプリケーションおよびそのデータ処理方法の見直しも必要となります。.
Grokは、ライブニュースを自動的に認識するのでしょうか?
いいえ。GrokのAPIドキュメントによると、最新情報を取得するには、Web SearchやX Searchなどの検索ツールが必要とされています。モデルの学習知識と、リクエストの際に取得される情報源とは別物です。.
APIの料金と、AIの月額サブスクリプションの料金を比較することはできますか?
ワークロードの内容や各ルートに含まれる要素を明確に定義してからでなければなりません。APIの利用料金は通常、トークン数やメディア出力量に応じて課金されますが、サブスクリプションでは、プランごとの利用規約に基づいてアクセスが可能になります。表面上の価格と同様に、想定しているワークフローの総コストを比較してください。.
最も人気のあるAIモデルが、私にとって最適なモデルである必要はあるのでしょうか?
いいえ。人気があるからといって、そのモデルがあなたのファイルを適切に処理できるか、制約条件を満たせるか、あるいは予算内に収まるかは分かりません。最新のドキュメントを参考にして候補を絞り込み、その後、検証可能なタスクに対して実際の出力を比較してください。.
次の作業を、回避可能な修正を最小限に抑えて完了できるモデルを選んでください。まずは小規模から始め、成功した事例を記録し、明確な問題を解決できる場合にのみ、別のモデルを追加してください。もしあなたの仕事が、研究、文章作成、クリエイティブな成果物の作成といった分野にまたがっている場合は、, GlobalGPTでそのワークフローを試してみてください そして、仕上がった結果を評価してください。.