
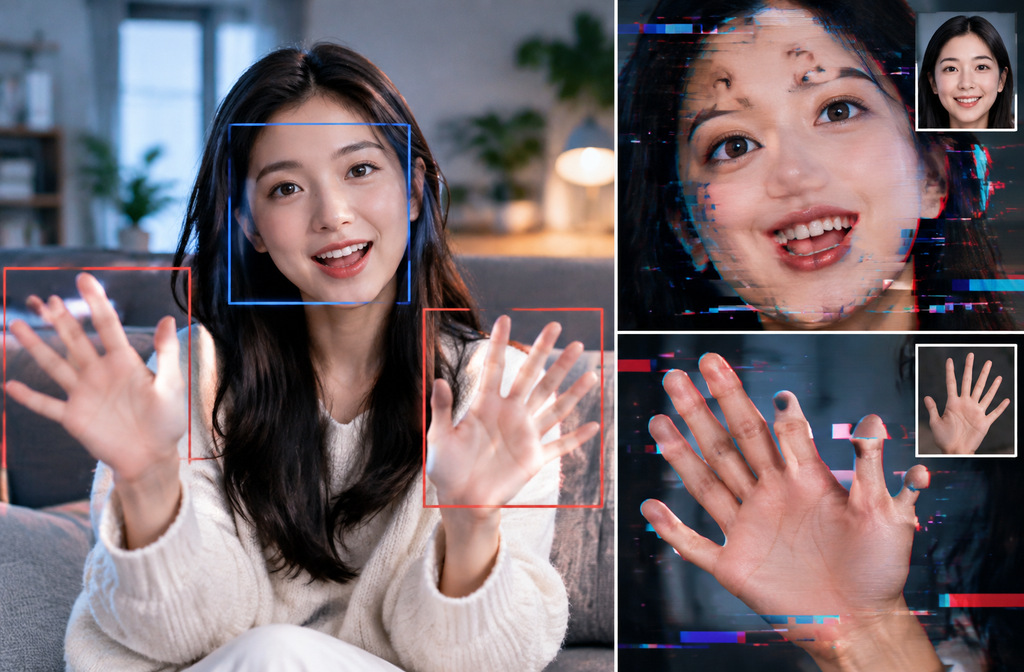
I video generati dall'IA che ritraggono mani e volti risultano poco realistici perché un modello deve garantire la coerenza dell'anatomia, dell'identità, dell'illuminazione, della posa e del movimento in molti fotogrammi, non limitandosi a disegnare una singola immagine convincente. Una mano che nel fotogramma 20 sembra accettabile può attraversare il viso nel fotogramma 24, modificare la distanza tra le dita nel fotogramma 26 e fondersi con i capelli nel fotogramma 28. Il modello deve quindi correggere diverse aree incerte contemporaneamente.
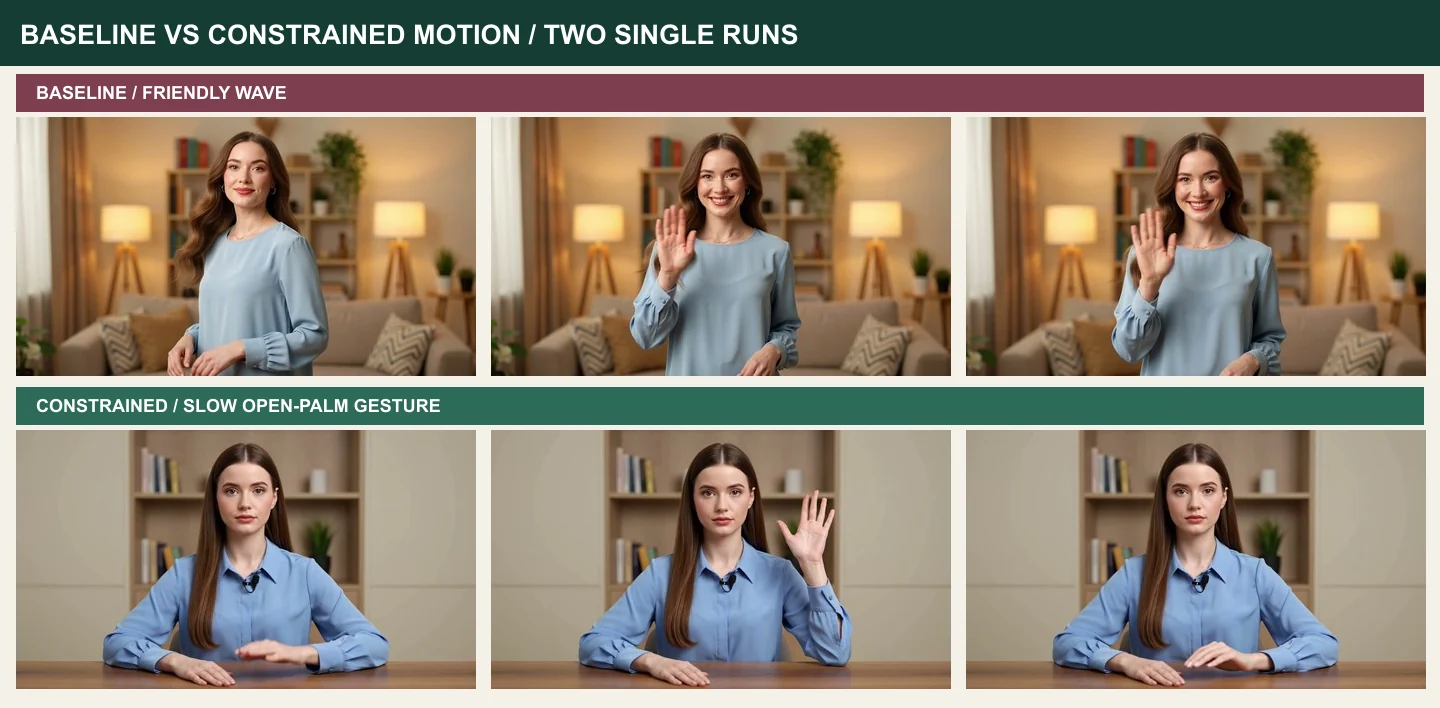
Abbiamo testato un prompt breve e informale ("friendly-wave") contrapponendolo a un prompt molto più vincolato ("open-palm") tramite la CLI di GlobalGPT. La versione con vincoli ha prodotto un movimento più fluido e una posa della mano più riconoscibile. Tuttavia, non ha preservato l’identità della persona originale, i suoi vestiti, il microfono o la stanza. Questo risultato misto è più utile di una demo perfetta perché mostra cosa i vincoli del prompt possono e non possono controllare.
Perché le mani perdono la loro funzionalità nel corso del tempo
Le mani sono oggetti articolati composti da numerose parti di piccole dimensioni, caratterizzati da frequenti auto-occlusioni e rapidi cambiamenti di sagoma. Una mano che saluta ruota su se stessa, le dita si sovrappongono, la sfocatura da movimento attenua i contorni e il palmo si sposta rispetto al viso. Il generatore deve dedurre una struttura 3D coerente da ogni nuova prospettiva, mantenendo al contempo il fotogramma precedente.
I problemi si manifestano sotto forma di dita in più, dita fuse, alterazioni nella posizione delle unghie, polsi flaccidi o una mano che cambia lato. Il quadro più ampio Diagnosi dei guasti nei video tramite intelligenza artificiale aiuta a distinguere gli errori anatomici da quelli relativi alla ripresa, alla fisica e alla continuità.
Perché le facce risultano sfocate anche quando un fotogramma sembra a posto
Il volto è sensibile alle minime variazioni nella distanza tra gli occhi, nella forma delle palpebre, negli angoli della bocca, nella larghezza del naso e nell’attaccatura dei capelli. Il linguaggio e le espressioni modificano continuamente questi punti di riferimento. Se il volto si rimpicciolisce, si distoglie, viene oscurato da un’ombra o è parzialmente coperto da una mano, il modello dispone di meno elementi di riferimento e potrebbe dover ridefinire l’identità.
Ecco perché Flusso di lavoro per la coerenza dei video generati dall'intelligenza artificiale considera la stabilità del personaggio come un problema di sequenza. Un primo fotogramma ben definito aiuta, ma anche il prompt, la telecamera, la durata e il movimento devono contribuire a preservare il segnale identitario.
Il nostro test di base e il test con vincoli
Entrambe le esecuzioni hanno utilizzato la stessa immagine di partenza e il percorso Grok Imagine a 1280×720 per circa cinque secondi. Nella condizione di riferimento è stato chiesto alla donna di voltarsi verso la telecamera e di salutare con la mano. Il prompt vincolante specificava la mano destra, richiedeva cinque dita ben distanziate, imponeva di tenere la mano accanto alla spalla, vietava l’occlusione del viso, limitava il movimento della testa e bloccava la telecamera.
Ogni attività è costata 500 crediti. Si tratta di un’osservazione A/B con una sola esecuzione per ogni prompt, non di un esperimento statisticamente controllato. Abbiamo campionato intervalli di tempo fissi e visionato i video a velocità normale.
Risultato di riferimento: movimento vivace, forte scostamento dall’identità
La sequenza di base ha generato un saluto amichevole e energico. La mano aperta è rimasta riconoscibile nei fotogrammi campionati, ma il risultato finale ha sostituito la protagonista originale con una donna dall’aspetto diverso, in una stanza diversa e con un abbigliamento diverso. La composizione è cambiata prima ancora che il saluto diventasse l’azione principale.
Questo risultato dimostra perché una presentazione visivamente accattivante non sia sufficiente. Se il lavoro richiede un presentatore ricorrente, l’identità e l’ambiente sono criteri di accettazione fondamentali. Il creare un personaggio coerente a partire da una sola foto tratta le scelte relative all'immagine di origine che possono migliorare il riferimento iniziale, ma i nostri risultati dimostrano che la sola immagine di origine non garantisce la continuità.
Risultato con vincoli: posa migliore, ma identità ancora persa
Il movimento controllato era più lento, la mano era tenuta accanto alla testa e assumeva una posizione più pulita, con il palmo aperto. La mano non scivolava sul viso. Queste differenze rendevano il gesto più facile da analizzare e avrebbero semplificato il montaggio.
Eppure la persona, gli abiti, il microfono e la stanza sono comunque cambiati in modo sostanziale. La richiesta prevedeva una riproduzione fedele, ma il modello non l’ha garantita. Possiamo affermare che l’esecuzione con vincoli abbia migliorato la leggibilità dei movimenti in questo caso specifico. Non possiamo però affermare che abbia corretto l’anatomia in modo generale né che abbia preservato l’identità.
Suggerimenti per la scrittura incentrati sulla visibilità e sul movimento
Un'indicazione utile per i gesti con le mani specifica un arto, un'azione, una posizione e una durata. “Alza la mano destra, mostra il palmo aperto accanto alla spalla, mantieni la posizione per un secondo, poi abbassala” è un'indicazione verificabile. “Fai gesti in modo naturale mentre parli con entusiasmo” lascia invece non specificate molte articolazioni, velocità e occlusioni.
Anche il linguaggio visivo è importante. Fissa la telecamera, mantieni l’intera mano all’interno dell’inquadratura ed evita zoom bruschi durante il gesto. Il comandi della fotocamera e dei segnali di movimento offre un vocabolario più ampio per quanto riguarda la gestione della telecamera e del controllo del movimento, mentre Tecniche di stimolo al movimento Veo aggiunge tecniche di prompt specifiche per Veo.
Proteggere il viso prima di migliorare le prestazioni
Assicurati che il volto sia abbastanza inquadrato da poter essere letto. Limita i movimenti della testa, le espressioni esagerate e l’incrocio delle mani nei momenti cruciali per l’identificazione del personaggio. Cerca di ottenere un battito di ciglia discreto e un leggero movimento delle labbra prima di combinare il dialogo, un oggetto di scena e una telecamera in movimento. Aggiungi complessità solo dopo aver verificato che la ripresa più semplice funzioni.
Per le sequenze lunghe, suddividere la performance in riprese con fotogrammi iniziali e finali stabili. Il Coerenza dei personaggi nei video lunghi spiega perché la continuità dei personaggi diventa più difficile man mano che i filmati si accumulano e in che modo i punti di riferimento aiutano a collegare le diverse sequenze.
Creare un frame sorgente migliore
Utilizza un'immagine nitida e uniformemente illuminata, in cui siano visibili entrambi gli occhi, la silhouette dei capelli sia ben definita e le mani siano o completamente visibili o del tutto fuori dall'inquadratura. Evita che le dita vengano tagliate dal bordo dell'inquadratura, filtri di bellezza troppo marcati, sfocature dovute al movimento troppo evidenti e sfondi a motivi che si intrecciano con il corpo.
L'inquadratura di riferimento dovrebbe inoltre corrispondere alla composizione video desiderata. Trasformare un primo piano ravvicinato in un'inquadratura a mezzo busto costringe il modello a inventare contemporaneamente braccia, mani, abiti e dettagli dell'ambiente circostante. È consigliabile creare o fotografare l'inquadratura necessaria prima di procedere con l'animazione.
Errori nel triage anziché riscrivere tutto da capo
- Se le dita si uniscono, rallenta il movimento e allontana la mano dal viso o dal corpo.
- Se l'identità subisce delle variazioni, ridurre la rotazione della testa, la gamma delle espressioni e la durata del clip.
- Se il polso si piega in modo anomalo, semplifica il percorso della mano ed elimina l’interazione con il supporto.
- Se lo sfondo cambia, blocca la telecamera e descrivi i punti di riferimento fissi della scena.
- Se si verificano più errori contemporaneamente, tornare a un fotogramma sorgente più pulito.
errori comuni nei video sull'intelligenza artificiale elenca gli errori comuni di pianificazione che spesso sono all’origine di questi insuccessi a catena.
Prompt di base copiabili e prompt con vincoli
Esegui prima il test di riferimento breve, in modo da poter vedere cosa sceglie il modello senza alcun aiuto. Quindi modifica solo i vincoli di movimento. Mantieni invariati il modello, la sorgente, la durata e le proporzioni. Ciò rende il confronto più facile da interpretare, anche se due singoli campioni non possono dimostrare un nesso di causalità.
Rivedi fotogramma per fotogramma, poi a velocità normale
La riproduzione a velocità normale rivela se il movimento appare naturale. L’analisi fotogramma per fotogramma evidenzia quando l’anatomia o l’identità iniziano a discostarsi. Controlla l’inizio, il gesto di massima intensità, il punto di occlusione e la posa finale. Osserva entrambe le mani, non solo quella che saluta, e confronta la forma degli occhi e gli angoli della bocca con quelli dell’originale.
Prendi nota del primo fotogramma difettoso. Questo ti aiuterà a capire se è necessario cambiare la fonte, accorciare la ripresa o limitare una determinata transizione. Un’osservazione vaga del tipo “sembra strano” è difficile da trasformare in un suggerimento più concreto.
Considerare l’occlusione come un rischio di produzione
L'occlusione si verifica quando un oggetto ne nasconde un altro: le dita attraversano il viso, i capelli coprono un occhio, un oggetto di scena nasconde il polso oppure il corpo si allontana dalla telecamera. La struttura nascosta deve comunque essere dedotta, e il modello potrebbe riprodurla con una forma diversa. I movimenti rapidi rendono più difficile tale deduzione, poiché i fotogrammi adiacenti forniscono indicazioni meno stabili.
Inquadra l’azione in modo che le parti anatomiche più importanti rimangano visibili. Posiziona la mano accanto al viso anziché davanti ad esso. Tieni gli oggetti di scena lontani dalle articolazioni delle dita. Se il contatto è indispensabile, suddividi l’azione in inquadrature di avvicinamento, contatto e rilascio, per poi montarle insieme. Ciò riduce il numero di transizioni brusche che un generatore deve elaborare.
Ripetere il test prima di trarre una conclusione definitiva
I nostri due filmati contengono osservazioni utili, ma un singolo seme può valorizzare o penalizzare un prompt. Per scegliere effettivamente un modello, ripeti ogni prompt diverse volte con la stessa fonte e le stesse impostazioni. Valuta separatamente la leggibilità manuale, l'identità, lo sfondo, la ripresa e il completamento dell'azione. Conserva i risultati scartati nel registro.
Ripetere il test può rivelare se il prompt vincolato aumenti la probabilità di ottenere una posa utilizzabile o se abbia semplicemente prodotto un singolo campione fortunato. Può inoltre evidenziare un compromesso: un controllo più rigoroso del movimento potrebbe ridurre l’espressività o rendere la performance più rigida. È preferibile scegliere l’equilibrio più adatto alla ripresa piuttosto che cercare di ottenere un singolo fotogramma perfetto.
Sapere quando modificare e quando rigenerare
Modifica il filmato per correggere un piccolo difetto quando l’identità, l’azione e la ripresa sono per il resto efficaci. Un breve stacco può nascondere un cedimento delle dita in due fotogrammi; un montaggio più serrato può eliminare una posa di ritorno non riuscita. Ricrea la scena quando il volto cambia in modo evidente, la mano sbagliata esegue l’azione, lo sfondo si trasforma o l’anatomia non è coerente in molti fotogrammi.
Non perdere un’ora a correggere una clip che non rispetta le linee guida fondamentali. Al contrario, non scartare una performance eccellente a causa di un problema insignificante che può essere nascosto con un normale montaggio. La lista di controllo per l’approvazione dovrebbe distinguere gli errori gravi dalle imperfezioni correggibili prima che inizi la revisione.
Utilizzare una lista di controllo per l'accettazione dei movimenti umani
Per ogni ripresa, valuta cinque aspetti in modo indipendente: identità, anatomia, azione, ripresa e scena. L’identità comprende le proporzioni del viso, i capelli e l’abbigliamento. L’anatomia comprende le dita, i polsi, i gomiti, i denti e il movimento degli occhi. L’azione verifica se il movimento richiesto ha inizio, raggiunge il culmine e termina correttamente. La ripresa comprende l’inquadratura e i movimenti indesiderati. La scena comprende gli oggetti di scena, lo sfondo e la continuità dell’illuminazione.
Contrassegnare ogni sequenza come “approvata”, “riparabile” o “scartata”. Un risultato “riparabile” potrebbe contenere un breve fotogramma difettoso che può essere tagliato senza alterarne il significato. Un risultato “scartato” presenta una deriva persistente dell’identità, ripetuti crolli della mano o un’azione mancante. Questa classificazione impedisce che una clip visivamente piacevole sfugga al controllo a causa di un errore di continuità irrimediabile.
Controllate l'audio separatamente anche quando l'articolo si concentra sui volti e sulle mani. Rumori imprevisti, difetti di riproduzione del parlato o una traccia mancante possono rendere inutilizzabile una ripresa visivamente accettabile. Il file definitivo è quello che soddisfa tutte le specifiche di consegna, non il fotogramma che appare migliore in un provino a contatto.
Il verdetto pratico
Il nostro prompt con vincoli ha prodotto un gesto della mano più tranquillo e leggibile rispetto a quello di riferimento, ma entrambi i risultati hanno modificato drasticamente l’identità. L’ingegneria dei prompt ha migliorato un aspetto senza risolvere il problema della continuità nel suo complesso.
Un metodo pronto per la produzione prevede una inquadratura ben definita, un'azione controllata, una telecamera stabile, riprese ripetute e una checklist scritta per l'approvazione. Quando il soggetto deve parlare o maneggiare un oggetto di scena, è necessario verificare tali comportamenti in brevi riprese separate prima di combinarli. La complessità deve essere conquistata attraverso prove riuscite.
Non giudicare i movimenti delle mani basandoti solo sul fotogramma finale. Osserva l’intero percorso del gesto, dall’inizio alla fine, quindi confronta l’espressione del viso con quella dell’originale. Un palmo ben definito non può compensare il fatto che si tratti di una persona diversa, e un’espressione del viso stabile non può compensare un polso che cede durante l’azione.
Confronta i percorsi video in GlobalGPT Quando uno scatto non riesce, modifica una variabile alla volta e prendi nota della fonte, delle impostazioni e del motivo del rifiuto. Per ottenere mani e volti migliori è necessario ridurre l’incertezza lungo tutta la sequenza, non aggiungere una “anatomia perfetta” a un prompt già sovraccarico.
Per il test successivo, ripetete entrambi i prompt più volte con la stessa fonte e valutate separatamente identità, anatomia, azione, ripresa e scena. Quel piccolo campione mostrerà se il prompt vincolato migliora il tasso di scatti validi o se ha semplicemente prodotto un risultato fortuito. Mantieni il movimento breve e visibile finché il gesto principale non è stabile. Quindi aggiungi il dialogo, gli oggetti di scena o il movimento della telecamera uno alla volta, conservando una versione pulita di ogni fase che ha superato la revisione.
Domande frequenti
Perché le mani nei video sull’intelligenza artificiale hanno delle dita in più?
L'articolazione rapida, l'auto-occlusione, la sfocatura da movimento e i cambiamenti di prospettiva rendono incerta la struttura delle dita da un fotogramma all'altro. Il modello potrebbe ridisegnare la mano in modo diverso man mano che questa si muove.
Perché il volto cambia durante un video generato dall'intelligenza artificiale?
I volti piccoli, i movimenti della testa, le espressioni, le ombre e l’occlusione attenuano gli indizi identificativi. Il generatore ricostruisce quindi i punti di riferimento facciali invece di conservarli esattamente come sono.
Un prompt migliore può risolvere i problemi dell'IA?
Un prompt con vincoli può ridurre il movimento e l’occlusione, il che ha migliorato la leggibilità nel nostro singolo test. Tuttavia, non può garantire la correttezza anatomica in ogni modello o esecuzione.
Un’immagine di riferimento garantisce la coerenza dell’identità?
No. Una fonte affidabile è utile, ma il modello video potrebbe comunque modificare la persona, l’abbigliamento, la stanza o la composizione dell’inquadratura durante il movimento.
Qual è il movimento della telecamera più sicuro per riprendere volti e mani?
Una ripresa fissa con inquadratura media o a mezzo busto è il punto di partenza più sicuro. Aggiungi panoramiche, zoom o movimenti orbitali solo dopo che il gesto semplice è terminato.
Posso cambiare modello quando uno scatto continua a non riuscire?
Sì. GlobalGPT ti permette di confrontare i percorsi video disponibili. Mantieni costanti la sorgente e i criteri di accettazione, in modo da poter valutare se la modifica al modello sia effettivamente utile.



