Muse Spark 1.3 è la versione più potente di Muse Spark rilasciata finora da Meta: il modello pubblico xhigh raggiunge un punteggio di 61 nell’Artificial Analysis Intelligence Index, mantiene una finestra di contesto di 1 milione di token e ha superato tutte e tre le attività di programmazione di media difficoltà nel nostro test API di prima risposta. È importante precisare che il grafico di riferimento principale di Meta utilizza la funzione "max reasoning", mentre, al momento della stesura di questa recensione, tale funzione era ancora in attesa di un rilascio più ampio, subordinato a ulteriori test di sicurezza.

Recensione di Muse Spark 1.3: giudizio a prima vista
Il nostro verdetto
Vale la pena provare Muse Spark 1.3 per la programmazione di agenti, il lavoro su contesti estesi e l’automazione sensibile ai costi. Il suo risultato pubblico “xhigh” è già competitivo rispetto ai migliori risultati disponibili, ma non citate i punteggi massimi di Meta come se ogni utente dell’API potesse riprodurli già oggi.
Meta ha rilasciato Muse Spark 1.3 il 2 settembre 2026, rendendolo adatto a flussi di lavoro agenziali a lungo termine, a un codice più pulito e a una collaborazione più affidabile. Ciò prosegue il passaggio verso Agenti di intelligenza artificiale basati su modelli di utilizzo degli strumenti. Meta afferma che il sistema pone domande di chiarimento quando i requisiti sono ambigui, segnala quando si blocca e richiede conferma prima di intraprendere azioni rilevanti. Nei confronti interni con la versione 1.2, gli ingegneri di Meta hanno osservato circa 20% di chiamate allo strumento in meno e 25% di token in meno. Si tratta di dati forniti dal provider, non di risultati dei nostri test.
Cosa è cambiato rispetto a Muse Spark 1.2?
Analisi artificiale: da 57 a 61 su xhigh.
Meta riporta 75,4 contro 55,0 su DeepSWE, ma mette a confronto 1,3 (max) con 1,2 (xhigh).
La finestra da 1 milione rimane; i punteggi MRCR della fascia alta registrano un forte aumento nel grafico di Meta.
I tassi dei token rimangono invariati, mentre AA ha registrato un valore di $0,55 rispetto a $0,40 per ogni attività valutata.
Benchmark di Muse Spark 1.3: "Max" e "Xhigh" non sono la stessa cosa
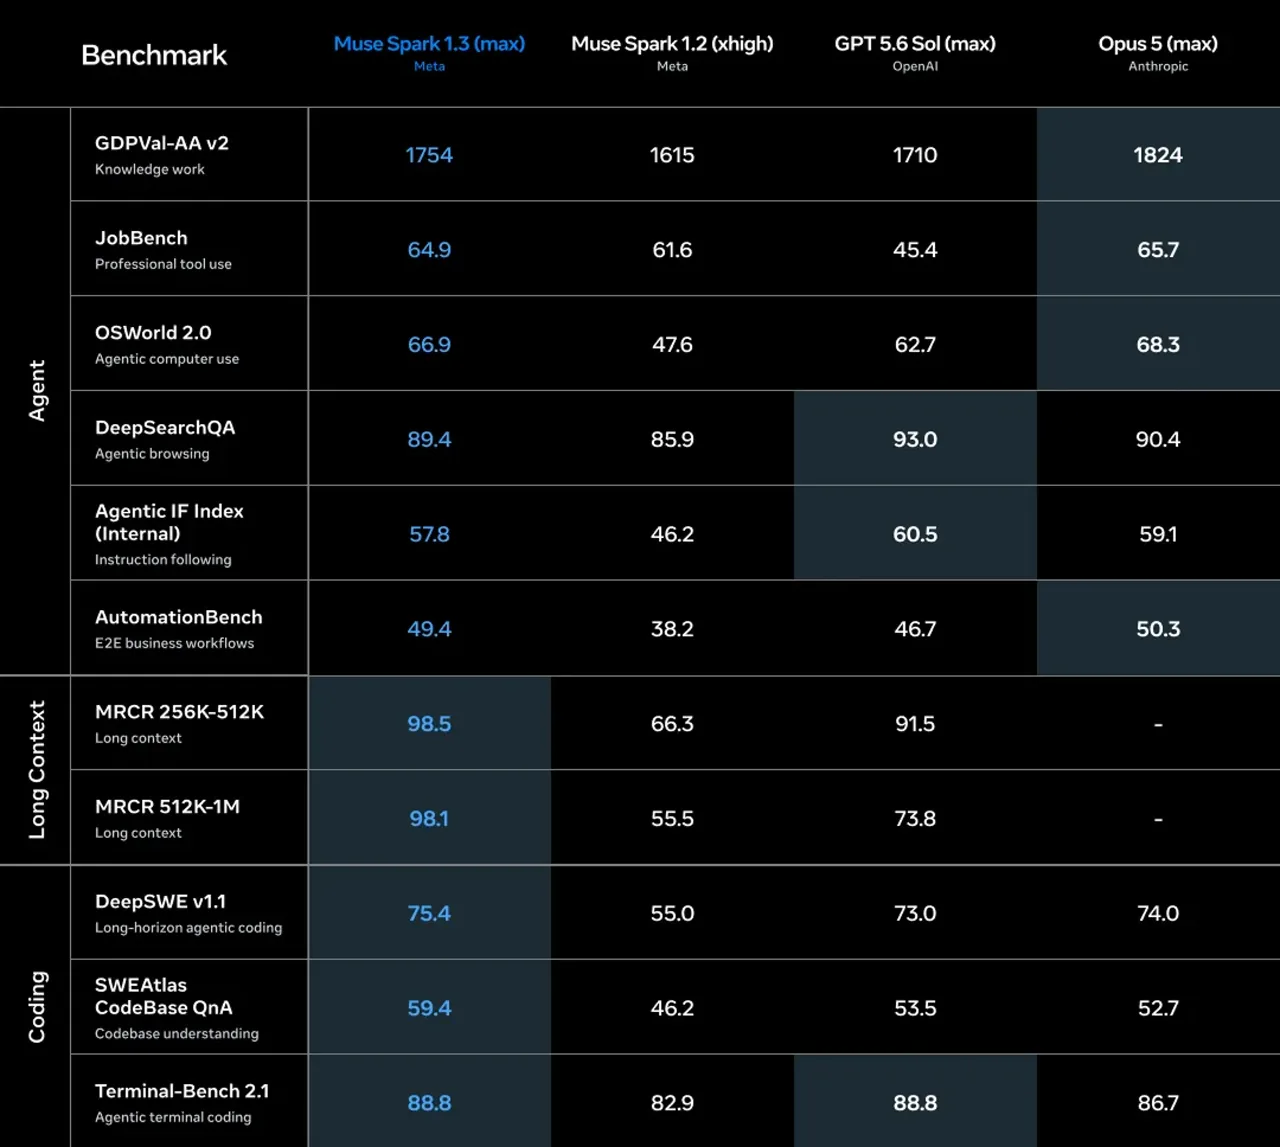
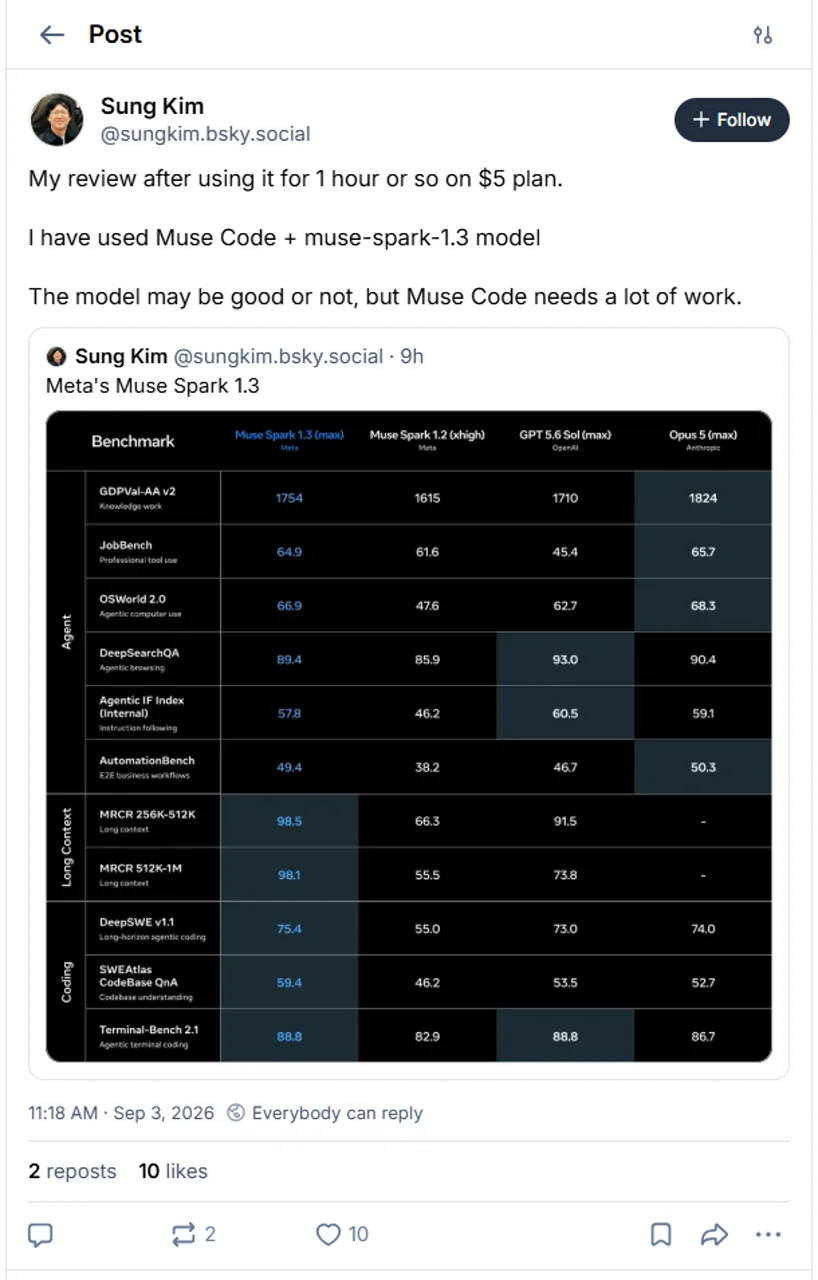
Classifica ufficiale di Meta È impressionante. Muse Spark 1.3 raggiunge un punteggio massimo di 88,8 su Terminal-Bench 2.1, 75,4 su DeepSWE v1.1, 98,1 su MRCR 512K-1M e 66,9 su OSWorld 2.0. Eguaglia il punteggio massimo di GPT-5.6 Sol su Terminal-Bench e supera i concorrenti indicati nelle due fasce MRCR a contesto lungo. Gli sviluppatori che desiderano confrontare il mercato in senso più ampio possono utilizzare il nostro Panoramica su Coding-Agent come ulteriore contesto.
META-RAPPORTATO, RAGIONAMENTO MASSIMO
| Punto di riferimento | 1,3 max | 1,2 x alto | GPT-5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE v1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | N/D |
Le diverse impostazioni di sforzo, le imbracature degli agenti e le versioni di OSWorld limitano la comparabilità diretta. Meta descrive inoltre l’Agentic IF Index come un indice composito interno.
Come leggere il grafico
1.3, GPT-5.6 Sol e Opus 5 utilizzano "max"; 1.2 utilizza "xhigh".
Gli agenti designati e i sistemi di fissaggio variano a seconda della valutazione.
Le esecuzioni 1.3 e 1.2 utilizzano versioni diverse dell'ambiente.
L'Agentic IF Index è un indice composito elaborato da Meta, non un singolo benchmark pubblico.
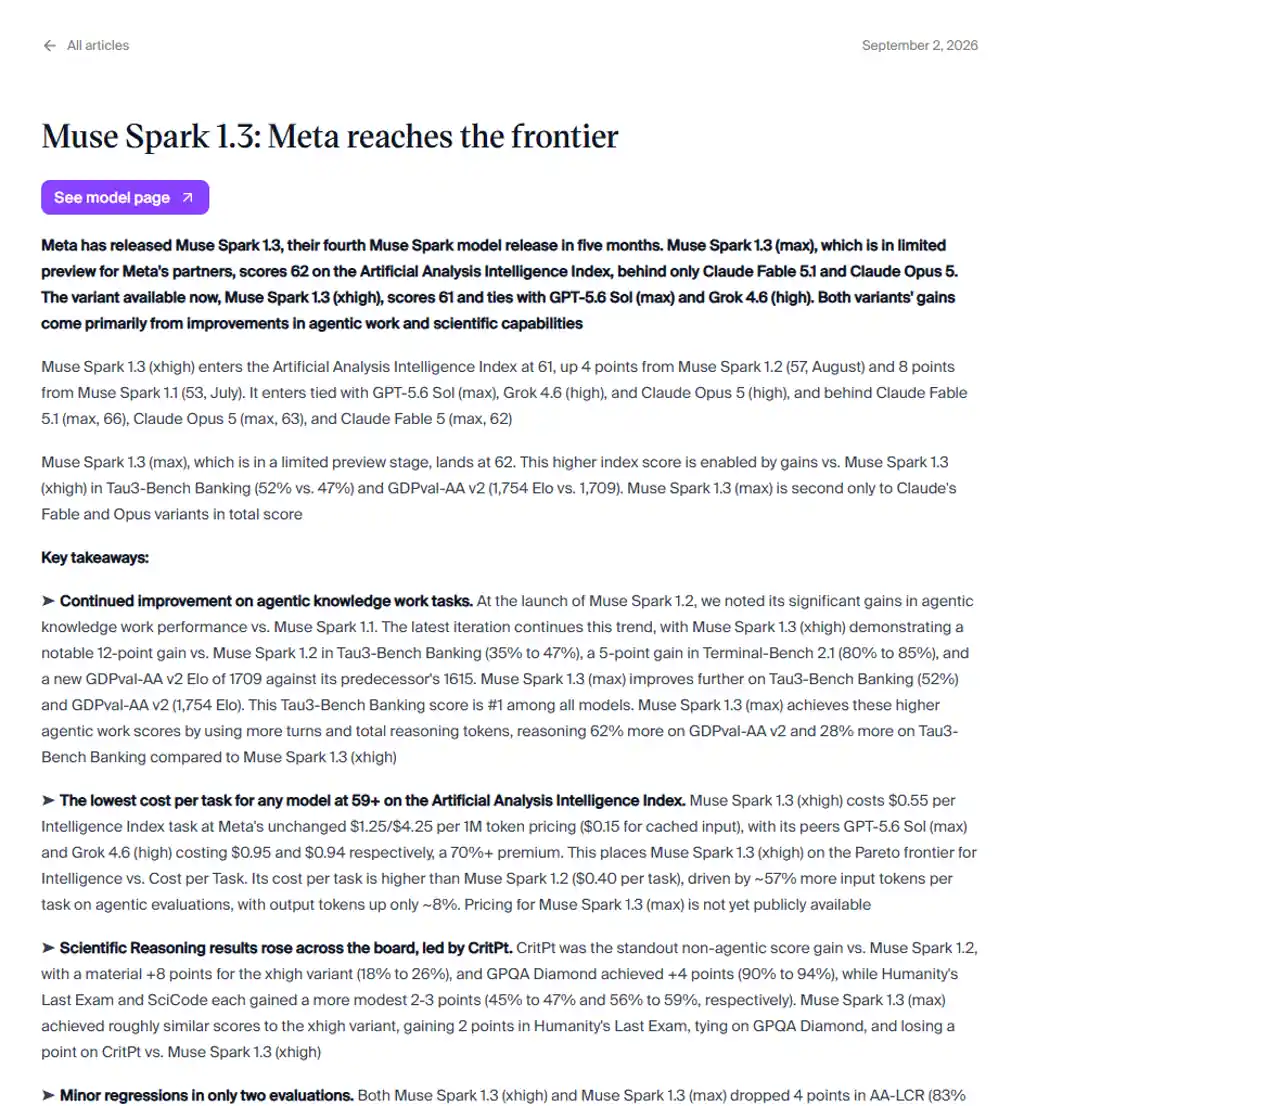
L'analisi artificiale offre una visione più chiara di ciò a cui gli utenti possono accedere attualmente. Muse Spark 1.3 xhigh raggiunge un punteggio di 61, in aumento rispetto ai 57 della versione 1.2. Il suo risultato su Terminal-Bench è 85%, su GDPval-AA v2 è 1709 Elo, mentre su Tau3-Bench Banking è 47%. La variante max in anteprima limitata raggiunge un punteggio complessivo di 62. Si registrano anche alcune regressioni: l’AA-LCR scende da 83% a 79%, mentre l’AA-Omniscience Accuracy passa da 45% a 42% su xhigh.
Prezzi di Muse Spark 1.3
Collaboratore
muse-spark-1.3-contributor
$0.10 in ingresso / $0.002 in cache / $0.20 in uscita per milione di gettoni.
I suggerimenti possono essere utilizzati per migliorare i prodotti Meta.
Standard
muse-spark-1.3
$1,25 in ingresso / $0,15 in cache / $4,25 in uscita per milione di gettoni.
Meta afferma che questo livello non viene utilizzato per migliorare i propri prodotti.
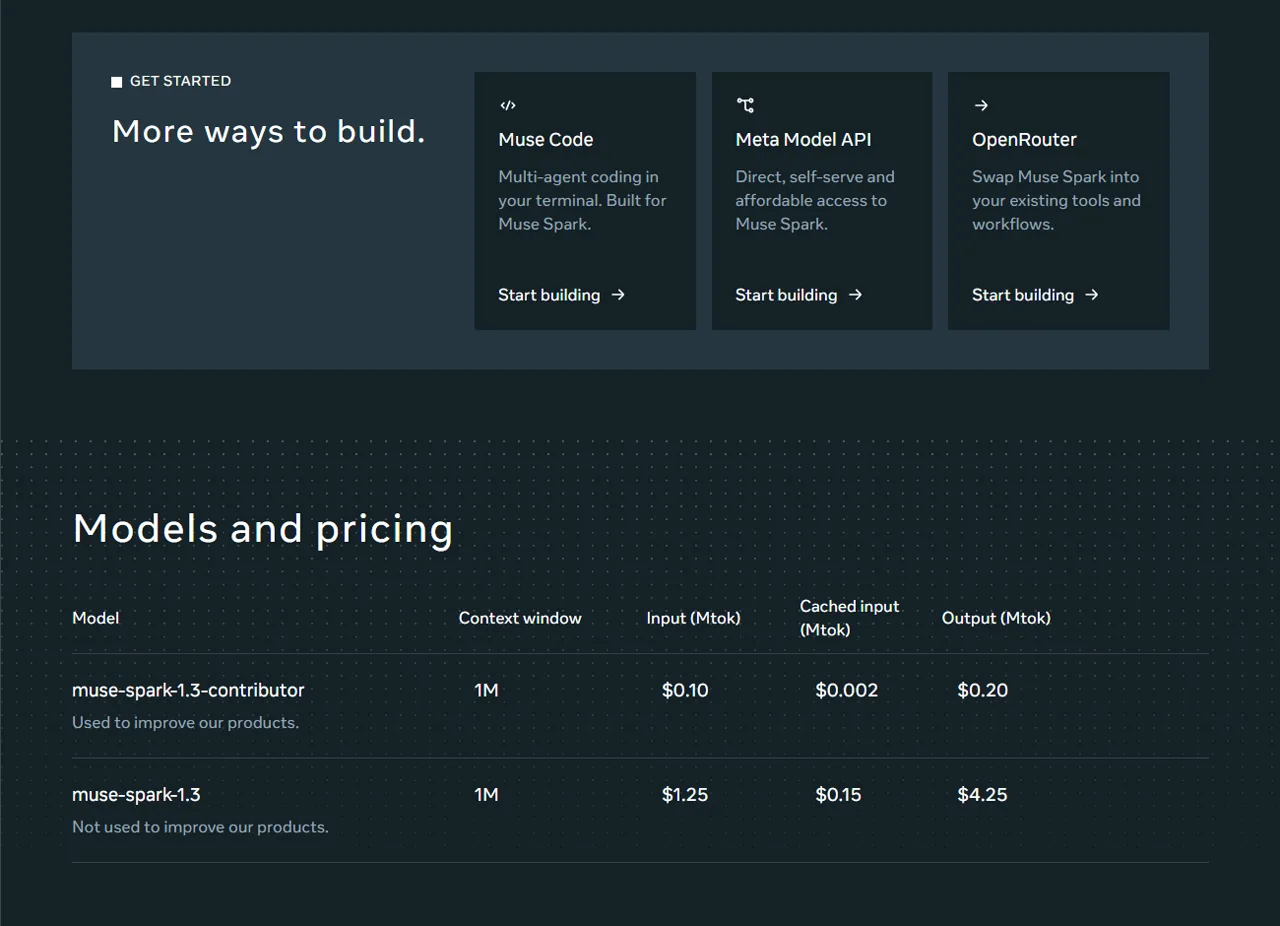
Il prezzi ufficiali dei token rimangono invariati rispetto alla versione 1.2, ma il costo per attività no. Il nostro Recensione della piattaforma AI "tutto in uno" spiega perché il prezzo di accesso e il costo del flusso di lavoro dovrebbero essere valutati separatamente. L’analisi artificiale ha rilevato un valore di $0,55 per attività dell’Intelligence Index per 1,3 xhigh rispetto a $0,40 per 1,2, determinato principalmente da circa 57% in più di token di input nelle valutazioni agentiche. Il livello «contributor» è eccezionalmente economico, ma la sua clausola sull’utilizzo dei dati rappresenta una vera e propria scelta di prodotto piuttosto che una semplice nota a margine.
Accesso all'API di Muse Spark 1.3
Quelli di Meta ricettario ufficiale ora utilizza muse-spark-1.3 come impostazione predefinita e prevede una finestra di contesto di 1.048.576 token. L'API è compatibile con l'SDK OpenAI. Muse Code e Meta Model API sono le vie di accesso attualmente confermate. La pagina del modello di Meta mostra anche OpenRouter, sebbene il relativo pulsante, una volta selezionato, rimandasse ancora a un URL della versione 1.2; si raccomanda quindi di verificare il percorso prima della distribuzione. Per ulteriori informazioni sull’interoperabilità degli agenti, consultare la nostra guida a MCP e strumenti di intelligenza artificiale.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "Controlla questa patch per eventuali regressioni."}],
)

print(response.choices[0].message.content)
Test pratici di programmazione: 3 su 3 superati
Abbiamo testato tre operazioni su repository di media difficoltà tramite un'API a temperatura zero, utilizzando una risposta per ogni operazione. Ogni risposta doveva restituire file completi in formato JSON strutturato. Abbiamo quindi inserito tali file in directory temporanee ed eseguito controlli sia pubblici che nascosti. Si tratta di piccoli test controllati, che non sostituiscono Terminal-Bench né una prova su un repository di produzione.
5 test su 5; 18,4 s; 2.473 token; $0,00905. Il modello ha individuato l'insieme di ID elaborati non utilizzati, ha aggiunto un controllo precoce dei duplicati e ha scritto un test di regressione.
Superati il controllo dei tipi e due controlli in fase di esecuzione; 47,6 s; 4.945 token; $0,01661. La convalida, la persistenza e la registrazione di audit sono state separate senza violare i confini della transazione.
9 test su 9; 20,3 s; 3.789 token; $0,01446. Compatibilità CSV, errori con numerazione delle righe, output atomico, sicurezza in modalità dry-run, guida e documentazione: tutti superati.
Totale: 11.207 token e $0.04013. I tempi indicati si riferiscono alla durata complessiva della richiesta, non alla latenza nativa dell'API Meta né al TTFT.
Il risultato è stato migliore di quanto possa far supporre un semplice “3/3”: tutte e tre le prime risposte erano verificabili e tenevano conto dei vincoli. La stessa attenzione ai dati è importante quando si leggono i nostri Recensione di GPT-5. Tuttavia, il campione non tiene conto dell’affidabilità delle chiamate ripetute agli strumenti, della navigazione in repository di grandi dimensioni né del livello di orchestrazione di Muse Code. I lettori che stanno valutando alternative più economiche potrebbero inoltre trovare interessante il nostro Confronto tra modelli di codifica di bilancio utile.
Le prime reazioni degli sviluppatori
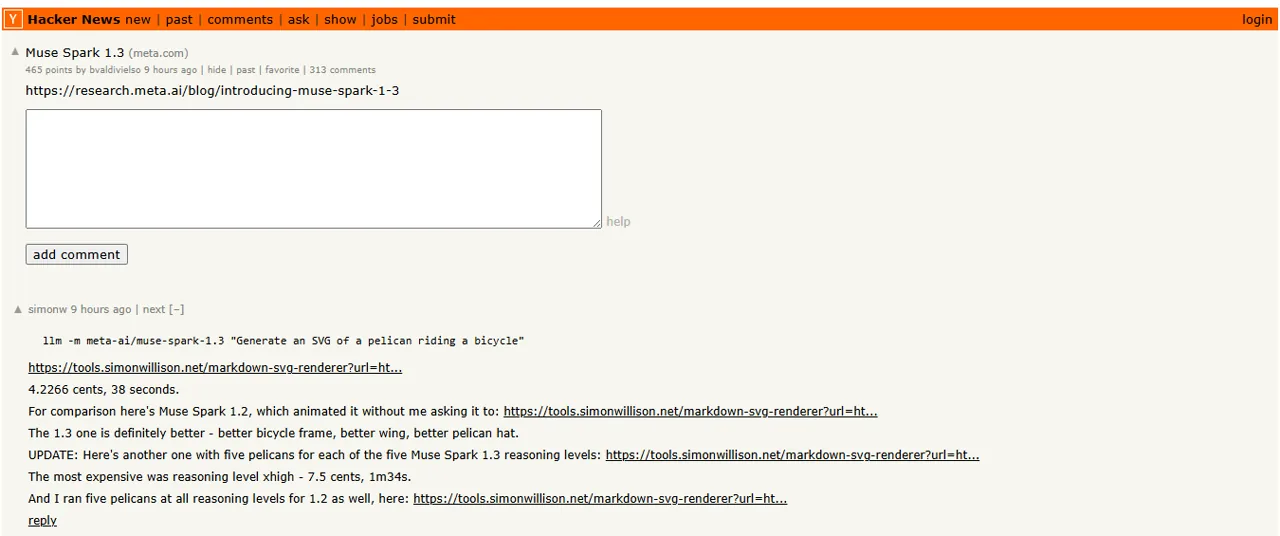
Le prime reazioni sono contrastanti e troppo sporadiche per poter parlare di consenso. In un Test su Hacker News, Simon Willison ha registrato un tempo di 38 secondi e 4,2266 cent in SVG e ha giudicato il risultato della versione 1.3 “decisamente migliore” rispetto a quello della versione 1.2 con cui l’ha confrontata. Dax ha descritto il lancio come ricordo di quanto gli mancassero le modelle formose. Sung Kim, dopo circa un’ora trascorsa con Muse Code, ha affermato che il modello potrebbe essere valido, ma che il prodotto Muse Code “richiede ancora molto lavoro”. Quest’ultimo commento riguarda l’esperienza dell’agente, non un test puro e semplice sul solo modello.
Pro e contro
Cosa ha funzionato
- Punteggio pubblico elevato
- Finestra di contesto del token 1M
- API compatibile con OpenAI
- Tutte e tre le attività di codifica hanno superato la prima valutazione
- Tassi dei token molto bassi per i livelli di contribuzione più bassi
Cosa guardare
- I risultati "Headline max" non costituiscono l'esperienza pubblica predefinita
- Il costo delle attività indipendenti è aumentato rispetto a 1,2
- Due metriche indipendenti sottoposte a regressione
- I dati forniti dagli utenti potrebbero migliorare i prodotti Meta
- Le prime reazioni a "Muse Code" sono contrastanti
A chi è destinato Muse Spark 1.3?
UTILIZZALO PER
Valutazioni degli agenti di codifica, attività relative a repository con contesti estesi, automazione basata su strumenti ed esperimenti attenti ai costi in cui la politica sui dati è accettabile.
SALTA O ASPETTA QUANDO
Hai bisogno di una comprovata affidabilità produttiva a lungo termine, hai bisogno del massimo oggi stesso, oppure non puoi accettare un utilizzo dei dati di livello “contributor” e ritieni che i prezzi standard non siano competitivi.
Verdetto della recensione di Muse Spark 1.3
Muse Spark 1.3 merita di essere preso in considerazione per una valutazione. Coniuga prestazioni pubbliche all’avanguardia, ottimi risultati in contesti estesi, un’interfaccia API intuitiva e un prezzo competitivo. Le nostre tre attività di codifica di primo intervento confermano la sua capacità di rispettare i vincoli relativi a più file e di generare patch verificabili.
Scegliere il livello standard per il codice sensibile. Per un altro confronto tra le diverse frontiere, consultare GPT-5 vs Claude 4. Considerare i risultati massimi dei benchmark come prove preliminari fino a quando quel livello di ragionamento non sarà ampiamente disponibile. Inoltre, valutare Muse Code separatamente dall’API del modello: l’esperienza utente (UX) di un agente, il ciclo degli strumenti e il controllo del repository possono avere esito positivo o negativo indipendentemente dal modello di base.
Domande frequenti su Muse Spark 1.3
Che cos’è Muse Spark 1.3?
Muse Spark 1.3 è il modello di Meta per la programmazione e i flussi di lavoro agentici, rilasciato il 2 settembre 2026, dotato di una finestra di contesto da 1 milione di token e di capacità native di percezione di immagini, video e documenti.
Quanto costa Muse Spark 1.3?
Il modello standard costa $1,25 per milione di token in ingresso, $0,15 per gli input memorizzati nella cache e $4,25 per gli output. Il modello "contributor" costa rispettivamente $0,10, $0,002 e $0,20, ma i suoi dati possono essere utilizzati per migliorare i prodotti Meta.
È disponibile il ragionamento max?
Meta ha dichiarato che le modalità di ragionamento esistenti erano disponibili al momento del lancio e che "max" sarebbe stata resa disponibile in seguito a ulteriori test di sicurezza. Si prega di consultare la documentazione API aggiornata prima di dare per scontata la disponibilità generale.
Muse Spark 1.3 ha superato i test di codifica?
Sì. Le sue prime risposte hanno superato tutti i controlli di eseguibilità nei nostri test relativi alla correzione dei bug in Python, alla rifattorizzazione in TypeScript e alle funzionalità JSONL. L'esempio contiene solo tre attività controllate e non rappresenta un indice di affidabilità generale.
Muse Spark 1.3 è migliore della versione 1.2?
In linea di massima, sulla base delle prove disponibili. L’intelligenza pubblica xhigh è passata da 57 a 61 e Meta segnala notevoli miglioramenti in termini di capacità di azione e di gestione dei contesti lunghi, ma Artificial Analysis ha riscontrato anche un aumento del costo delle attività e lievi regressioni nel recupero di contesti lunghi e nella calibrazione dei fatti.
È meglio utilizzare il modello “contributor” o quello standard?
Utilizza lo standard per i prompt sensibili o proprietari, poiché Meta afferma che tali dati non vengono utilizzati per migliorare i propri prodotti. Contributor è molto più economico, ma i suoi prompt potrebbero essere utilizzati per il miglioramento dei prodotti.