
Claude Sonnet 5.5 vs Opus 5.5: prezzo, benchmark e test reali
Sonnet 5.5 e Opus 5.5 appartengono entrambi alla generazione Claude 5.5, ma hanno prezzi e posizionamenti diversi. Questo confronto sottopone entrambi i prodotti alle stesse cinque richieste e riporta i risultati effettivamente restituiti dal sistema.
La differenza riscontrata riguarda principalmente i costi e la velocità. In questo pacchetto di cinque prompt, Sonnet 5.5 ha completato l'elaborazione più rapidamente, ha utilizzato un numero inferiore di token di output e ha prodotto la stima più bassa del costo aritmetico della richiesta. Opus 5.5 ha impiegato più token e più tempo, mentre le sue risposte erano spesso più estese. Le schede delle attività mostrano in quali casi quel testo aggiuntivo abbia modificato il risultato utile e in quali casi entrambi i modelli abbiano semplicemente superato il test.
I prompt, il limite massimo delle richieste, l’impostazione dello sforzo, l’endpoint e la struttura “una esecuzione per modello” sono stati mantenuti in linea con la versione precedente Recensione del Claude Opus 5.5.
Risposta rapida
- Velocità in questa prova di confronto: Sonnet 5.5 ha completato cinque richieste consecutive in 31,930 secondi in locale; Opus 5.5 ha impiegato 47,725 secondi.
- Token di output segnalati dal percorso: Sonnet 5.5 ne ha utilizzati 2.686; Opus 5.5 ne ha utilizzati 3.952. I campi di riflessione erano rispettivamente 987 e 2.214.
- Stima aritmetica del prezzo di listino: le cinque richieste relative a Sonnet ammontavano a circa $0.02826; le cinque richieste relative a Opus ammontavano a circa $0.08184, utilizzando le tariffe standard ufficiali per i token ed escludendo cache, crediti, tasse e ricarico.
- Risultato dell'attività: Entrambi i modelli hanno superato i test relativi all’estrazione, al JSON e alla matematica. Sonnet ha rispettato in modo più accurato il formato richiesto di due paragrafi in cinese; i risultati relativi alla programmazione erano entrambi utilizzabili, ma differivano per profondità e spiegazione dei casi limite.
- Migrazione delle API: Il pensiero non può essere disattivato; la scelta forzata degli strumenti viene respinta e i budget simbolici includono il pensiero. Controlla il avvertenze relative alla migrazione prima di cambiare.
- Confine decisionale: Si tratta di un'esecuzione per ogni attività tramite un percorso di terze parti. Misura le risposte osservate ai prompt, il tempo di esecuzione locale e l'utilizzo riportato dal percorso; non si tratta di un punteggio universale delle prestazioni.
Prezzo ufficiale e specifiche tecniche del modello
Le schede tecniche attuali di Anthropic riportano entrambi i modelli con una finestra di contesto di 1 milione di token e un output massimo di 128K. Il modello Sonnet 5.5 è indicato come Veloce con un elevato livello di sforzo predefinito; Opus 5.5 è contrassegnato come Moderato con uno sforzo predefinito medio. I tassi standard dei token fanno sì che Sonnet 5.5 corrisponda alla metà del prezzo di acquisto e di vendita di Opus 5.5.
| Modello | ID API | Etichetta ufficiale relativa alla latenza | Entrata / uscita | Contesto / potenza massima | Impegno predefinito | Lettura dalla cache |
|---|---|---|---|---|---|---|
| Claude Sonnet 5,5 | claude-sonetto-5-5 | Attivo · Veloce | $2 / $10 per MTok | 1M / 128K | Alto | $0.20 / MTok |
| Claude Opus 5,5 | claude-opus-5-5 | Attivo · Moderato | $4 / $20 per MTok | 1M / 128K | Medio | $0.20 / MTok |
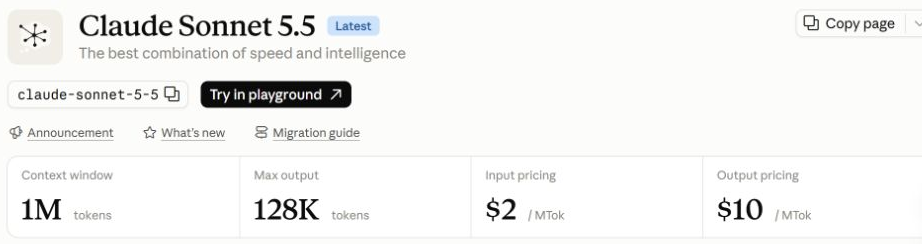
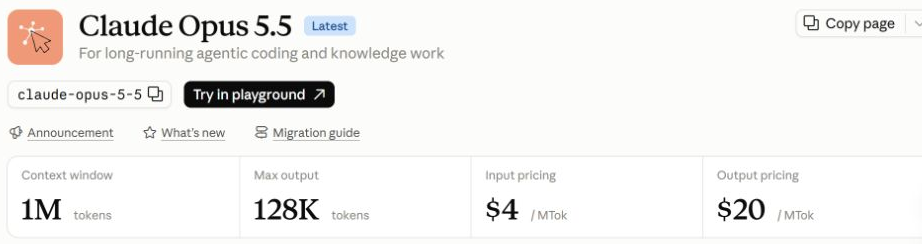
Per un semplice esempio senza cache con 100.000 token in ingresso più 20.000 token in uscita, le tariffe per token indicate ammontano a circa $0,40 su Sonnet 5,5 e a $0,80 su Opus 5,5. Vedi il Guida ai prezzi e ai limiti di Claude per il contesto del piano.
Contesto ufficiale di riferimento
Anthropic Annuncio Sonnet 5.5 riunisce entrambi i modelli in un’unica tabella compilata dal fornitore. La struttura delle righe varia a seconda del benchmark e dell’impostazione dello sforzo.
| Benchmark riportato da Anthropic | Sonnet 5.5 | Opus 5.5 | Misura |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66,4%¹ | Codifica terminale agenziale |
| FrontierCode v1.1 (Versione principale) | 46,21 TP40T Max² / 52,11 TP40T Xhigh | 54.4% | Se le modifiche al codice verrebbero integrate |
| CursorBench 4.0 | 55.5% | 57.8% | Compiti ambigui di codifica di più file |
| GDPval-AA v2.1 | 1844 | 1846 | Il lavoro intellettuale nelle diverse professioni |
| L'ultimo esame dell'umanità | 64.5% con utensili | 67,71 TP40T con utensili | Ragionamento multidisciplinare |
| OSWorld 2.1 | 80.1% parziale | 81,81 TP40T parziale | Attività che prevedono l'uso del computer |
| Cartografia | 61,61 TP40T senza utensili | 64,41 TP40T senza utensili | Riconoscimento visivo dei grafici |
¹ Opus 5.5 Terminal-Bench utilizza lo sforzo “xhigh”; ² Sonnet 5.5 FrontierCode è pari a 46,2% al massimo e a 52,1% con sforzo “xhigh”. I valori di OSWorld sono contrassegnati come parziali. Si tratta di dati relativi al contesto del provider, non di una rielaborazione indipendente a sforzo uguale.
Metodo API con lo stesso prompt
A ciascun modello sono state fornite le stesse cinque istruzioni tramite POST https://anywhere.broly.ai/v1/messages. Il client ha inviato un messaggio a un utente, max_tokens: 8192, output_config.effort: alto, e senza strumenti. Ogni richiesta ha restituito un codice HTTP 200 e fine_turno.
L'approccio ai test si inserisce nel più ampio contesto Flusso di lavoro per il test del modello GlobalGPT. Un altro Guida all'API Claude tratta la configurazione delle richieste e la gestione dei token.
Tempo, gettoni e costo stimato
| Percorso | Ora locale delle cinque | Token di input | Token di output | Pensiero riportato | Costo stimato della richiesta* |
|---|---|---|---|---|---|
| Claude Sonnet 5,5 | 31,930 s | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5,5 | 47,725 s | 700 | 3,952 | 2,214 | $0.08184 |
* Stima basata sui token segnalati lungo il percorso e sulle tariffe standard ufficiali. In questo gruppo, il Sonnet 5.5 ha registrato un valore inferiore di 33,1% in termini di tempo trascorso a livello locale e di 32,0% in termini di conteggio dei token in uscita.
Cinque schede attività abbinate
Ogni scheda riporta l'attività, l'osservazione, l'ora locale, i token relativi al percorso segnalati, lo stato e i confini.
I modelli sono in grado di correggere una funzione di deduplicazione di tipo misto?
Configurazione dell'attività: Il prompt esatto è stato copiato dal precedente Recensione del Claude Opus 5.5 confezione di prova.
| Modello | Tempo / utilizzo del percorso | Etichetta sintetica del risultato |
|---|---|---|
| Claude Sonnet 5,5 | 8,679 s 145 in entrata / 830 in uscita 0 riflessioni HTTP 200 · fine turno | Funzione corretta più due esercizi; spiegazione più breve. |
| Claude Opus 5,5 | 15,844 s 145 in entrata / 1478 in uscita 700 riflessioni HTTP 200 · fine turno | Funzione corretta più due test; ulteriori approfondimenti sui casi limite. |
Confronto osservato: Entrambi hanno restituito una funzione corretta e due test. Sonnet 5.5 utilizzava chiavi con tag di tipo, casefold(), e un elenco di ripiego in una risposta più breve; Opus 5.5 ha impiegato più token di output per spiegare ulteriori casi limite. Nessuna delle due esecuzioni permette di individuare un vincitore generale in termini di codice.
Confine: Una singola piccola correzione in Python verifica casi limite specifici, non l'affidabilità a livello di repository o la codifica basata su strumenti.
I modelli sono in grado di conservare i cinque fatti forniti senza aggiungere ulteriori affermazioni?
Configurazione dell'attività: Il prompt esatto è stato copiato dal precedente Recensione del Claude Opus 5.5 confezione di prova.
| Modello | Tempo / utilizzo del percorso | Etichetta sintetica del risultato |
|---|---|---|
| Claude Sonnet 5,5 | 3,569 s 210 in entrata / 209 in uscita 0 riflessioni HTTP 200 · fine turno | Cinque punti numerati; i dati forniti sono stati mantenuti. |
| Claude Opus 5,5 | 4,374 s 210 in entrata / 312 in uscita 101 modi di pensare HTTP 200 · fine turno | Cinque punti numerati; i dati forniti sono stati mantenuti. |
Confronto osservato: Entrambi hanno restituito esattamente cinque elenchi numerati, attenendosi ai dati forniti. Sonnet 5.5 ha utilizzato 209 token di output contro i 312 di Opus 5.5, ma il prompt era una breve nota piuttosto che un input con un contesto ampio.
Confine: Si tratta di un test di estrazione e formattazione basato su dati reali; non costituisce una prova delle prestazioni in contesti con milioni di token.
I modelli sono in grado di restituire esattamente la struttura richiesta?
Configurazione dell'attività: Il prompt esatto è stato copiato dal precedente Recensione del Claude Opus 5.5 confezione di prova.
| Modello | Tempo / utilizzo del percorso | Etichetta sintetica del risultato |
|---|---|---|
| Claude Sonnet 5,5 | 5,052 s 128 ingressi / 260 uscite 0 riflessioni HTTP 200 · fine turno | JSON analizzabile; chiavi richieste e numero di elementi. |
| Claude Opus 5,5 | 8,276 s 128 ingressi / 622 uscite 390 riflessioni HTTP 200 · fine turno | JSON analizzabile; chiavi richieste e numero di elementi. |
Confronto osservato: Entrambe hanno restituito un JSON analizzabile contenente le chiavi richieste e due pro e due contro. Sonnet 5.5 era più conciso, con 260 token in output; le stringhe descrivono una situazione di recensione fittizia e non rappresentano dati relativi al prodotto.
Confine: L'esecuzione di questo schema una sola volta non consente di valutare l'affidabilità dell'output strutturato nel contesto delle richieste agli strumenti o delle conversazioni di lunga durata.
I modelli sono in grado di applicare la sequenza arrotondata dei lotti fino al risultato finale?
Configurazione dell'attività: Il prompt esatto è stato copiato dal precedente Recensione del Claude Opus 5.5 confezione di prova.
| Modello | Tempo / utilizzo del percorso | Etichetta sintetica del risultato |
|---|---|---|
| Claude Sonnet 5,5 | 2,947 s 89 ingressi / 163 uscite 0 riflessioni HTTP 200 · fine turno | Risultato corretto: 67; risposta finale su una riga a sé stante. |
| Claude Opus 5,5 | 3,830 s 89 in entrata / 257 in uscita 74 riflessioni HTTP 200 · fine turno | Risultato corretto: 67; risposta finale su una riga a sé stante. |
Confronto osservato: Entrambi hanno calcolato 67 e hanno inserito la risposta finale su una riga a sé stante. Sonnet 5.5 ha utilizzato 163 token in uscita contro i 257 di Opus 5.5, senza che si riscontrasse alcuna differenza in termini di correttezza su questo prompt.
Confine: Una sequenza aritmetica non è sufficiente per valutare l’affidabilità del ragionamento generale.
È possibile mantenere la struttura richiesta, composta da due paragrafi?
Configurazione dell'attività: Il prompt esatto è stato copiato dal precedente Recensione del Claude Opus 5.5 confezione di prova.
| Modello | Tempo / utilizzo del percorso | Etichetta sintetica del risultato |
|---|---|---|
| Claude Sonnet 5,5 | 11,683 s 128 ingressi / 1224 uscite 987 riflessioni HTTP 200 · fine turno | Due paragrafi in cinese; senza alcuna struttura aggiuntiva. |
| Claude Opus 5,5 | 15,401 s 128 ingressi / 1283 uscite 949 riflessioni HTTP 200 · fine turno | Ho trattato i punti; ho aggiunto il Markdown e una nota in inglese. |
Confronto osservato: Sonnet 5.5 ha restituito i due paragrafi in cinese richiesti senza formattazione aggiuntiva. Anche Opus 5.5 ha trattato i punti richiesti, ma ha aggiunto la formattazione Markdown e una nota in inglese. Questo documento riporta il formato ottenuto in un unico ciclo di elaborazione, non la qualità complessiva del testo in cinese.
Confine: La richiesta prevede un'introduzione sull'Opus 5.5, quindi il testo in sé non costituisce un punto di riferimento per un linguaggio neutro.
Avvertenze relative alle API e alla migrazione
Sonnet 5.5 esegue il pensiero adattivo per impostazione predefinita; l'opzione "thinking: disabled" restituisce un errore 400, mentre max_tokens copre sia il pensiero che il testo della risposta. La scelta forzata di "any/tool" per tool_choice viene rifiutata. Analizzare i blocchi di contenuto in base al tipo e ridefinire i budget dei token prima di effettuare il cambio.
Cosa emerge dai dati disponibili
Giudizio a livello di attività
Sonnet 5.5: costi e tempi inferiori rispetto a questa rotta, con piena conformità al formato richiesto per l'attività cinese.
Opus 5.5: qui è più costoso e più oneroso; i benchmark ufficiali continuano a registrare risultati migliori in diverse attività a tempo indeterminato.
Utilizza i dati relativi alle attività per scegliere un punto di partenza, quindi verifica il carico di lavoro che ti interessa.
Per il contesto correlato, si veda il Confronto tra i modelli della famiglia Claude, Recensione di Opus 5, e Recensione di Fable 5.1.
FAQ
Quale modello si è dimostrato più veloce nel test comparativo?
Sonnet 5.5 ha registrato il tempo totale locale più basso: 31,930 secondi contro i 47,725 secondi di Opus 5.5 su cinque richieste consecutive. Questo dato include il percorso e il tracciato di rete utilizzati in questo caso, quindi non si tratta di latenza lato provider.
Quale modello ha utilizzato un numero minore di token in uscita?
Sonnet 5.5 ha utilizzato 2.686 token di output riportati dal percorso nelle cinque attività, rispetto ai 3.952 di Opus 5.5. Il numero di token da solo non è indicativo della qualità delle risposte.
Quale modello è risultato più economico in questa serie di test?
Utilizzando le tariffe API standard ufficiali e i conteggi di input/output restituiti, le cinque richieste Sonnet 5.5 danno un risultato stimato di $0.02826, contro $0.08184 per Opus 5.5. Il calcolo esclude i costi relativi alla cache, i crediti della piattaforma, le imposte e il ricarico.
Il Sonnet 5.5 supera l'Opus 5.5 in tutti i benchmark?
La tabella relativa al modello Anthropic presenta risultati eterogenei a seconda del benchmark e delle impostazioni di carico: Sonnet 5.5 ottiene punteggi più alti su Terminal-Bench 4.0, mentre Opus 5.5 ottiene punteggi più alti su FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld e Chartography. Si tratta di risultati forniti dai produttori, non di una ripetizione indipendente dei test.
Sonnet 5.5 è un sostituto diretto dell'API?
No. La guida alla migrazione indica che la funzione “thinking” è attiva per impostazione predefinita; l’opzione “thinking: disabled” restituisce un errore 400; la scelta forzata dello strumento “any/tool” viene rifiutata; inoltre, i client devono analizzare i blocchi di contenuto in base al tipo. Prima di effettuare il passaggio, è necessario ridefinire i budget dei token e i cicli degli strumenti.
Si trattava di un benchmark a lungo termine?
No. La richiesta di estrazione contiene un breve brano. Verifica la fondatezza dei fatti e la formattazione esatta; non valuta il comportamento in prossimità della finestra di contesto documentata di 1 milione di token.



