
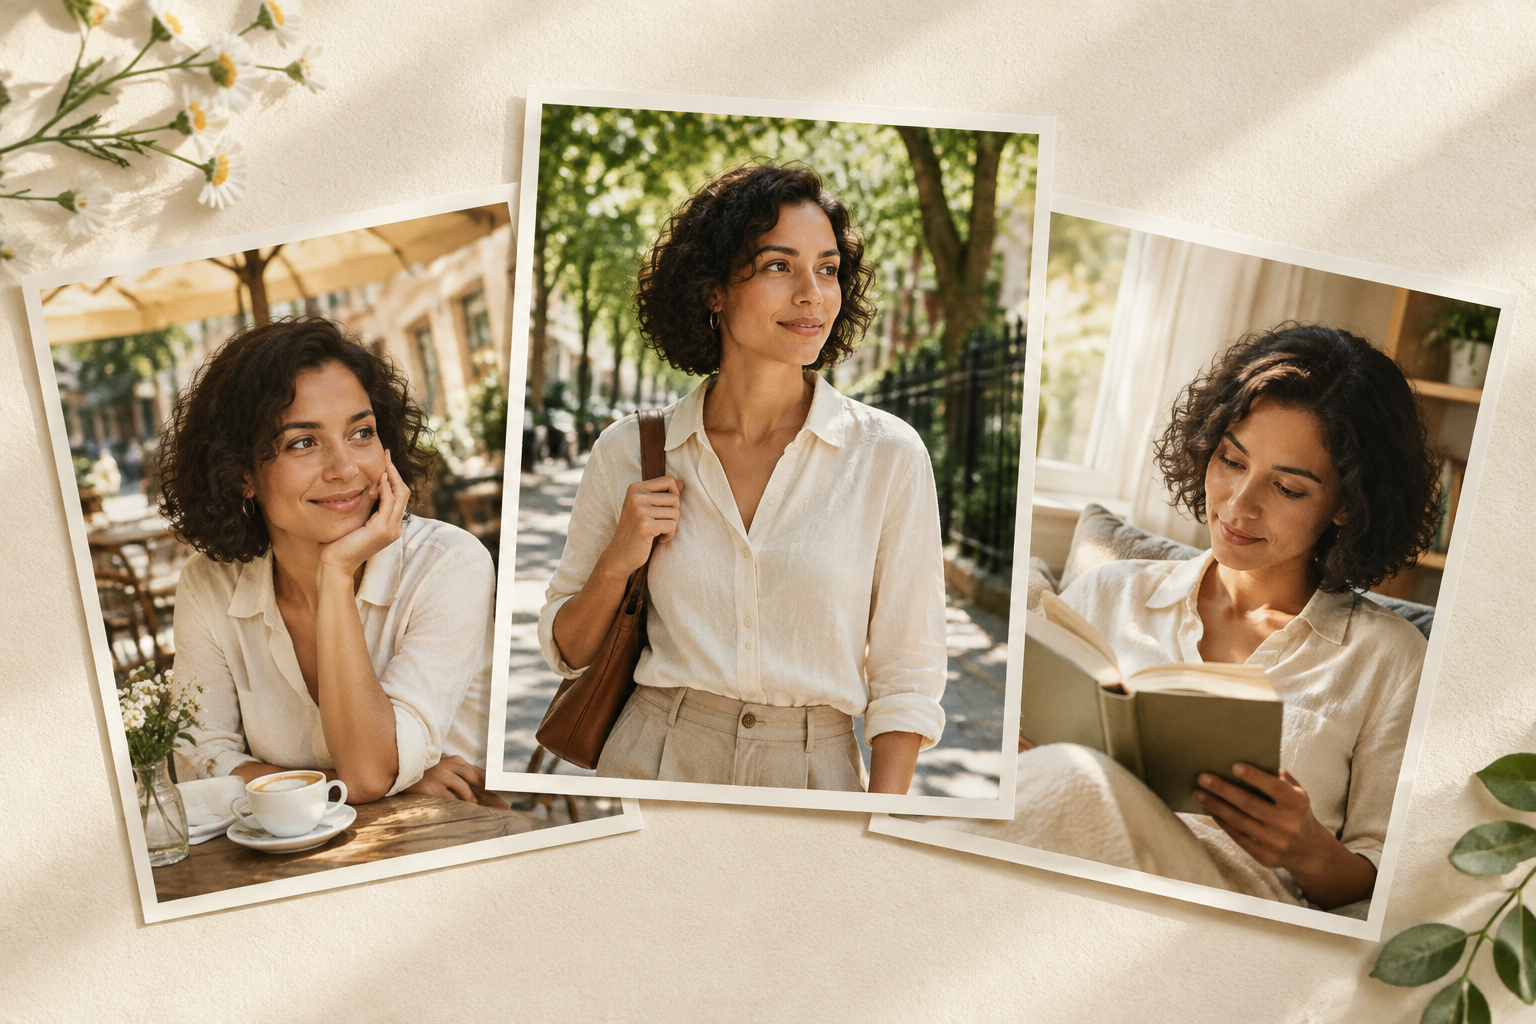
I servizi fotografici “photodump” basati sull’intelligenza artificiale funzionano quando le immagini sembrano momenti tratti dalla vita di una persona, non sei ritratti senza alcun nesso tra loro. Il modo più sicuro per ottenere questo risultato è definire innanzitutto un piccolo “pacchetto identitario”, per poi modificare una sola variabile principale alla volta: la location, la posa, l’abbigliamento o l’inquadratura.
GlobalGPT è utile per questo flusso di lavoro perché l'area di lavoro delle immagini consente di partire da un'immagine di riferimento e di passare da un modello all'altro man mano che il lavoro evolve. È possibile crea una serie fotografica con Nano Banana 2, quindi mantieni gli stessi suggerimenti e riferimenti mentre esamini ogni fotogramma.
Cosa serve per un servizio fotografico “photodump” basato sull’intelligenza artificiale
Un "photodump" è una serie coordinata di immagini pubblicate sui social. Può includere un ritratto curato, una scena dall'aspetto spontaneo, un primo piano e un'inquadratura più ampia che ritragga l'ambiente circostante. La serie non deve necessariamente avere un numero prestabilito di immagini. Deve invece presentare un soggetto riconoscibile, una variazione voluta e un ritmo visivo coerente.
La definizione utile
Un "photodump" generato dall'IA è una breve storia raccontata attraverso diverse immagini dello stesso soggetto, con una varietà sufficiente a dare un'impressione di autenticità e una continuità tale da far percepire un intento preciso.
Verifica ogni insieme generato in base a quattro criteri di riferimento:
- Identità: forma del viso, capelli, carnagione, colore degli occhi, proporzioni del corpo e uno o due piccoli segni distintivi.
- Guardaroba: ciò che rimane immutabile per l’ancora identitaria e ciò che invece viene deliberatamente lasciato libero di cambiare.
- Scena e luce: Il luogo, l'ora del giorno e la direzione della luce dovrebbero risultare evidenti in ogni fotogramma.
- Contesto sociale: il ritaglio dovrebbe apparire come un post utilizzabile, con spazio sufficiente per la piattaforma che intendi utilizzare.
Perché la stessa persona compare in diverse foto generate dall'intelligenza artificiale
I modelli di immagine risolvono diversi problemi visivi contemporaneamente. Quando un prompt modifica contemporaneamente la persona, l’abbigliamento, l’ambientazione, la posa, l’angolazione della fotocamera e l’illuminazione, il modello ha maggiori possibilità di sostituire un dettaglio identificativo con un altro. Un nuovo abito può modificare la silhouette; un profilo laterale può alterare l’aspetto del naso e della mascella; un’inquadratura ravvicinata allo specchio può far scomparire un piccolo segno sul viso.
Questo non significa che dovresti mantenere tutte le immagini identiche. Significa che dovresti separare le variabili. Per prima cosa, crea un’immagine di riferimento affidabile. Poi varia la scena mantenendo invariati il soggetto e l’abbigliamento. Successivamente, varia il guardaroba mantenendo invariata l’identità. Infine, prova un’inquadratura ravvicinata o un riflesso, dove i piccoli difetti sono più facili da individuare.
Le linee guida di Google sulla generazione di immagini seguono la stessa logica pratica: indicare ciò che deve rimanere coerente, utilizzare immagini di riferimento e apportare modifiche quando un dettaglio importante si discosta da quanto previsto. Per un flusso di lavoro più approfondito basato sulle foto di riferimento, consulta questa guida su mantenere lo stesso carattere nelle diverse scene.
Prima di procedere alla generazione, crea un piccolo pacchetto di riferimento
Non è necessario disporre di un set di addestramento di grandi dimensioni per testare il flusso di lavoro. Inizia con un personaggio adulto immaginario ben definito e un'immagine di riferimento che mostri il viso, i capelli, la pelle e le proporzioni della parte superiore del corpo senza filtri troppo pesanti. Utilizza l'immagine di una persona reale solo se disponi dell'autorizzazione e di una motivazione chiara per farlo.
- Crea un punto di riferimento identitario. Utilizza un'illuminazione uniforme, uno sfondo semplice, un'espressione neutra e un'inquadratura che mostri chiaramente il viso e i capelli.
- Annota il pacchetto di identità. Descrivi con parole semplici il tipo di capelli, il tono della pelle, il colore degli occhi, eventuali segni distintivi, gli orecchini e le proporzioni del corpo.
- Scegli la prima modifica controllata. È più facile individuare una nuova tendenza nei caffè che una nuova tendenza, un nuovo look, una nuova età e una nuova acconciatura tutti insieme.
- Controlla prima di costruire un set. Se il primo risultato modifica il volto o introduce un accessorio che distrae l'attenzione, correggi quella variabile prima di realizzare altri fotogrammi.
Il percorso delle immagini di riferimento in GlobalGPT è uno strumento pratico per trasferire questo pacchetto da un'immagine all'altra. Se il lavoro prevede un uso intensivo di immagini in formato verticale, questa guida di accompagnamento può esservi d'aiuto scrivere prompt migliori per la fotografia ritrattistica con l'IA per la luce, la composizione e i dettagli del viso.
Utilizza la domanda “Cosa rimane / cosa cambia?”
Modello di prompt copiabile
Inizia con gli elementi chiave dell'identità. Indica poi l'unica modifica. Concludi con i vincoli relativi alla telecamera e alla qualità.
Mostra lo schema completo
Utilizzando l’immagine di riferimento allegata, crea una foto realistica in formato quadrato per i social della stessa donna adulta immaginaria. Mantieni il suo viso, il caschetto castano scuro lungo fino alle spalle, la carnagione olivastra, gli occhi marroni, il neo sotto l’occhio sinistro, le proporzioni del corpo, gli orecchini a cerchio argentati e [il guardaroba prestabilito]. Modifica solo [una variabile principale]. Scena: [luogo], [posa], [luce], [inquadratura]. Texture naturale della pelle, composizione adatta al ritaglio, nessun testo, nessun logo.L'espressione “solo modifica” non è una formula magica, ma rende più chiaro il test di accettazione. In questo modo è possibile verificare se il modello ha effettivamente modificato la scena, anziché modificare silenziosamente anche la persona.
Cosa ha evidenziato il test di primo output
Ho utilizzato un personaggio adulto sintetico e gli stessi tre prompt con GPT Image 2.5 e Nano Banana 2 in GlobalGPT. Ciascun modello ha ricevuto la stessa immagine di riferimento e ha prodotto un primo risultato per tre compiti: un caffè sotto la pioggia con l’abbigliamento prestabilito, un tetto all’ora dorata con un cambio d’abito e un ritaglio dello specchio del bagno di un hotel. Non è stata utilizzata alcuna selezione “best-of-N” né alcuna ripetizione per garantire la stabilità.
Configurazione del test
- Riferimento: un ritratto sintetico di una donna adulta immaginaria, delle dimensioni di 1024×1024.
- Modelli: GPT Image 2.5 e Nano Banana 2.
- Compiti: caffè, cambio d’abiti sul tetto e selfie allo specchio del bagno.
- Regola: conservare il primo risultato valido; registrare i difetti invece di ripetere il lancio per ottenere un fotogramma più bello.
Compito 1: abbigliamento prestabilito, caffetteria sotto la pioggia
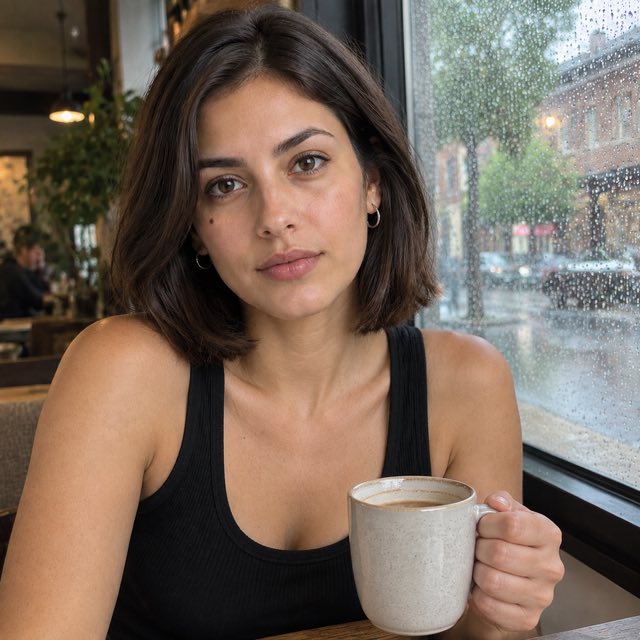
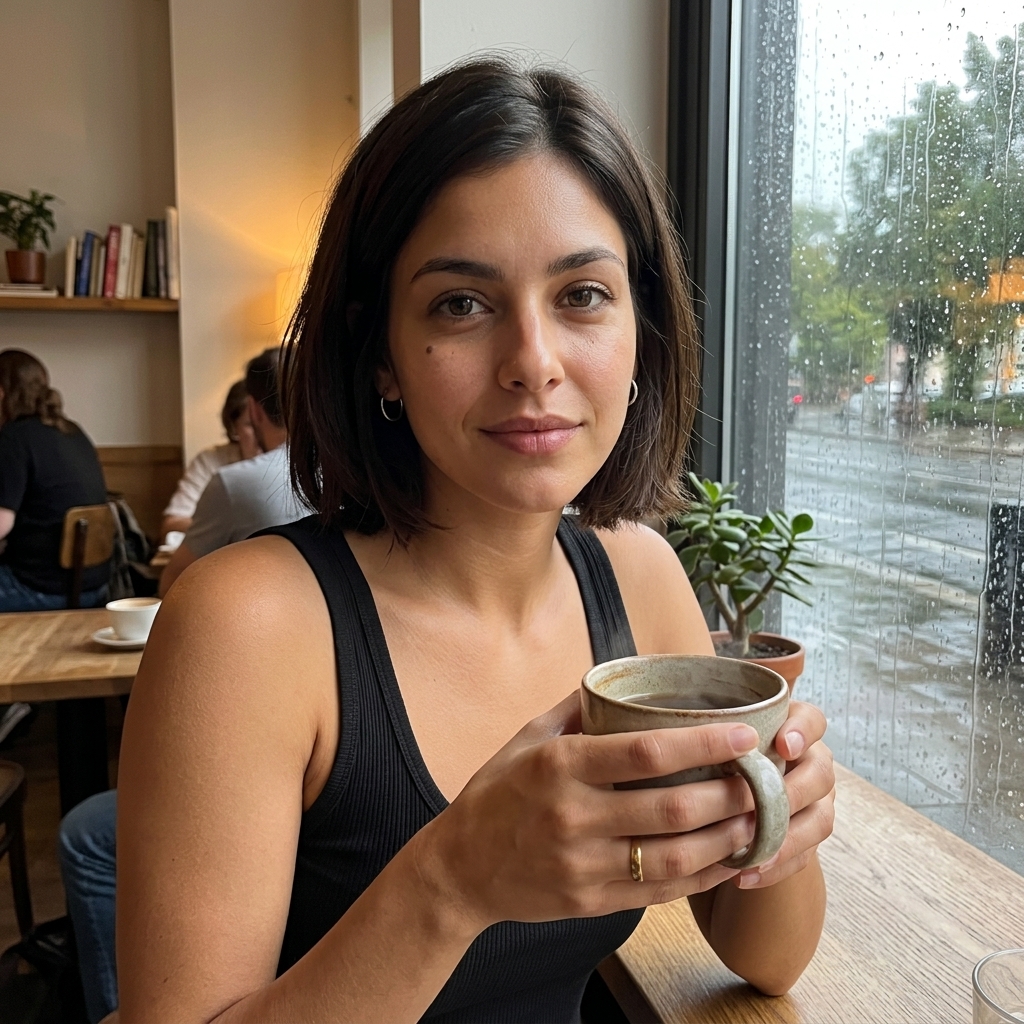
L'esercizio del bar richiedeva a entrambi i modelli di mantenere la canotta nera a costine e di cambiare solo l'ambientazione e la posa. Entrambi i risultati hanno mantenuto il viso, il taglio di capelli a caschetto, la carnagione olivastra e il neo. GPT Image 2.5 ha utilizzato un'inquadratura più stretta e spontanea, con una mano che stringe la tazza. Nano Banana 2 ha creato una scena credibile in un bar con la finestra bagnata dalla pioggia, ma il soggetto teneva la tazza con entrambe le mani.
Giudizio pratico
Entrambi i modelli hanno realizzato un primo fotogramma utilizzabile. Se la posa esatta è importante, controlla la posizione delle mani e il contatto con gli oggetti prima di aggiungere l'immagine a un carosello. Una semplice istruzione del tipo “con una mano sola” può trasformarsi in una composizione a due mani.
Visualizza il prompt esatto
Utilizzando l’immagine di riferimento allegata, crea una foto realistica di formato quadrato per i social media raffigurante la stessa donna adulta immaginaria. Mantieni il suo volto, il caschetto castano scuro lungo fino alle spalle, la carnagione olivastra, gli occhi marroni, il neo sotto l’occhio sinistro, le proporzioni del corpo, gli orecchini a cerchio argentati e la canotta nera a costine. Modifica solo l’ambientazione e la posa: un caffè di quartiere piovoso vicino a una finestra, vista di tre quarti da seduta, una mano che stringe una tazza di ceramica, inquadratura spontanea con smartphone, luce soffusa e diffusa dalla finestra, texture naturale della pelle, nessun testo, nessun logo.Compito 2: cambio d'abito, sul tetto all'ora d'oro
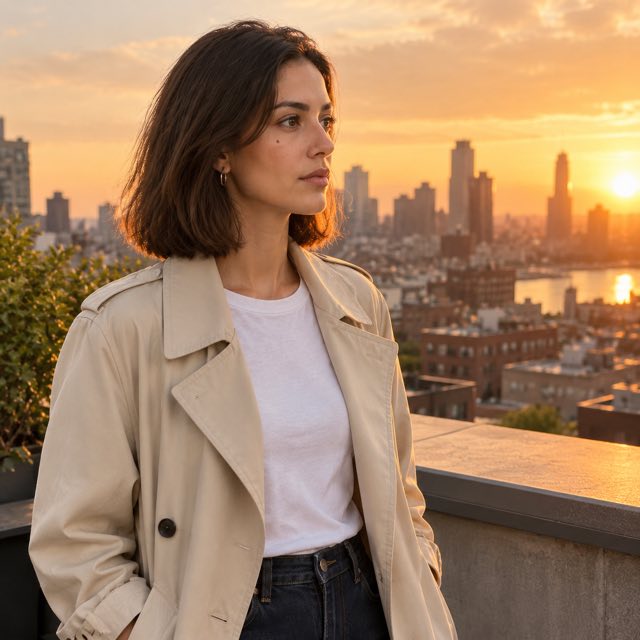
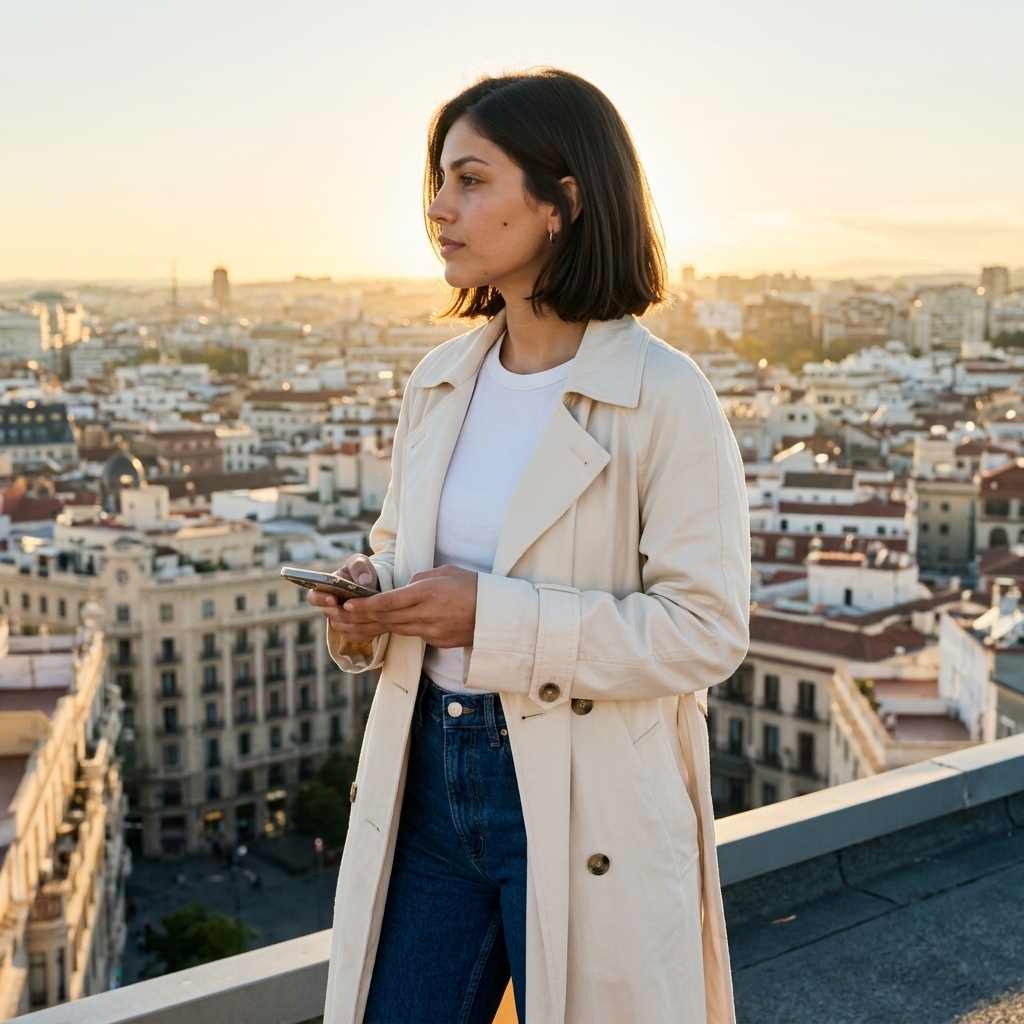
Per lo scatto sul tetto, il guardaroba è stato modificato con un trench color crema, una maglietta bianca e jeans scuri a gamba dritta, mantenendo invariati il soggetto e l’acconciatura. Entrambe le immagini hanno conservato il neo e l’identità complessiva. Il tetto, la città, il profilo laterale e la calda luce di controluce erano chiaramente visibili in entrambi i risultati. Nano Banana 2 ha aggiunto un telefono nelle mani del soggetto; ciò non ha compromesso la scena, ma ci ricorda che possono comparire oggetti di scena aggiuntivi anche quando non sono stati richiesti.
Giudizio pratico
Il cambio d'abito è plausibile quando gli elementi che definiscono l'identità si ripetono. Verificate insieme il profilo, l'attaccatura dei capelli e i piccoli segni distintivi del viso; una singola caratteristica corrispondente non è sufficiente a dimostrare che si tratti della stessa persona.
Visualizza il prompt esatto
Utilizzando l’immagine di riferimento allegata, crea una foto realistica in formato quadrato per i social della stessa donna adulta immaginaria. Mantieni il suo viso, il caschetto castano scuro lungo fino alle spalle, la carnagione olivastra, gli occhi marroni, il neo sotto l’occhio sinistro e le proporzioni del corpo. Cambia l’abbigliamento con un trench color crema indossato sopra una maglietta bianca e jeans scuri a gamba dritta; non modificare la sua identità né la sua acconciatura. Ambientazione: tetto all’ora dorata, in piedi di profilo mentre guarda verso la città, foto da telefono in stile editoriale ma naturale, controluce caldo, inquadratura che non richieda ritagli, senza testo né logo.Compito 3: primo piano, specchio del bagno di un hotel
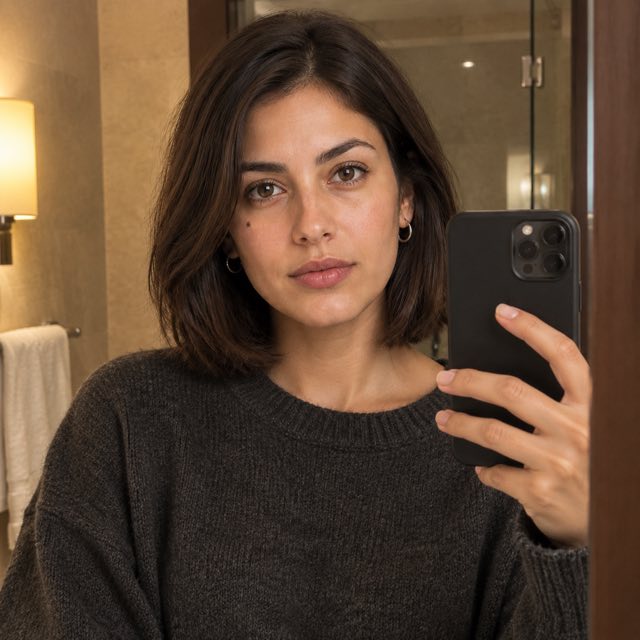
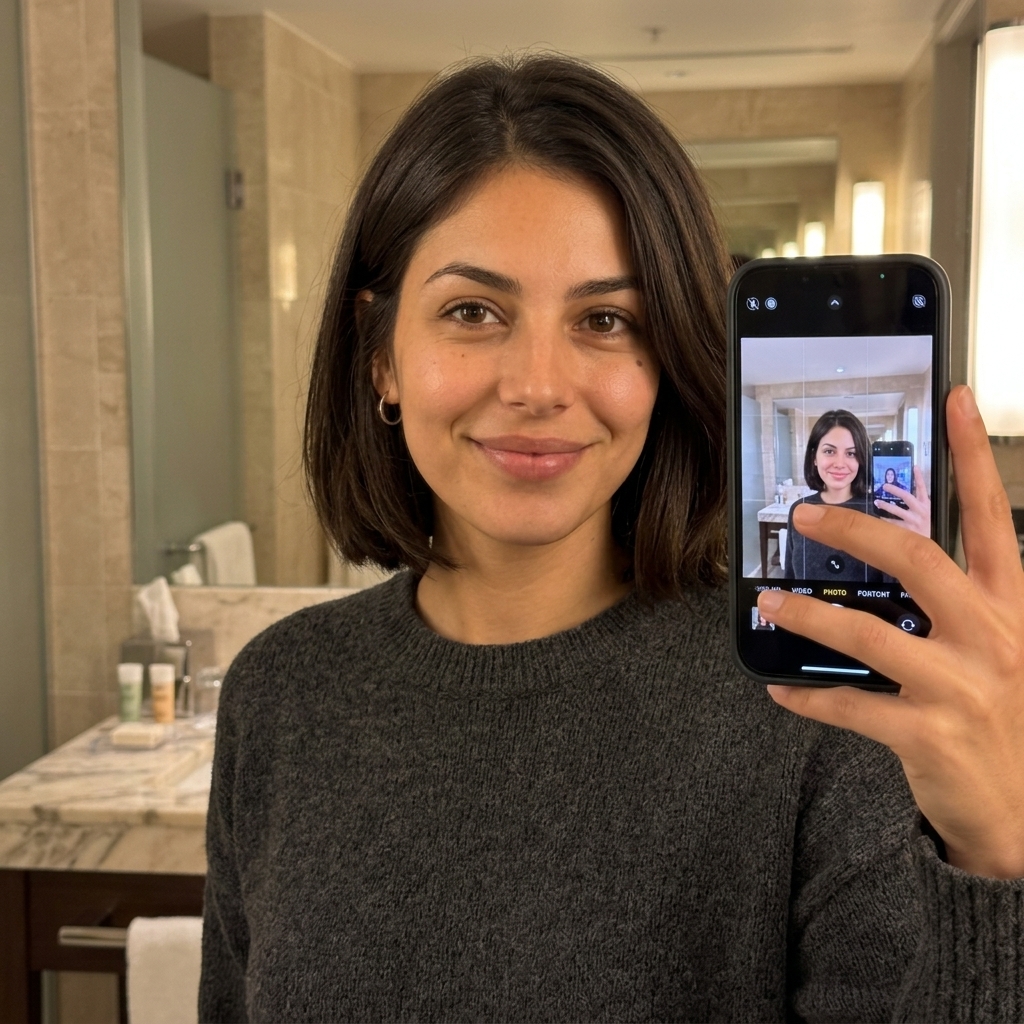
L’attività in bagno ha rappresentato il contesto sociale più complesso, poiché lo specchio e il telefono introducono un secondo sistema visivo. GPT Image 2.5 ha prodotto un selfie pulito a mezzo busto con il telefono che copriva parzialmente il lato destro. Nano Banana 2 ha mantenuto l’identità e il maglione, ma ha reso il telefono più dominante e ha mostrato un selfie ricorsivo sullo schermo. Tale risultato è comunque riconoscibile come un selfie in bagno, ma il riflesso e il contenuto dello schermo meritano un controllo più approfondito da parte di una persona prima della pubblicazione.
Giudizio pratico
È proprio nei primi piani che devi essere più rigoroso. Ingrandisci le mani, i bordi del telefono, i contorni dello specchio e qualsiasi dettaglio simile a del testo. Mantieni un fotogramma solo se il difetto non distrae dalla storia che vuoi che il carosello racconti.
Visualizza il prompt esatto
Utilizzando l’immagine di riferimento allegata, crea una foto realistica in formato quadrato per i social della stessa donna adulta immaginaria. Mantieni il suo viso, il caschetto castano scuro lungo fino alle spalle, la carnagione olivastra, gli occhi marroni, il neo sotto l’occhio sinistro e le proporzioni del corpo. Abbigliamento: maglione in maglia color antracite. Ambiente: specchio di un accogliente bagno d’albergo; selfie rilassato a mezzo busto con il telefono parzialmente visibile; luce soffusa al tungsteno; inquadratura leggermente imperfetta; riflessi realistici; texture naturale della pelle; nessun testo, nessun logo.Cosa si può trarre da questo confronto
I primi sei risultati supportano una conclusione sul flusso di lavoro piuttosto che una classificazione definitiva dei modelli. Entrambi i modelli hanno mantenuto gli elementi identificativi centrali in un bar, su un tetto e in un bagno. Le differenze sono emerse nei piccoli dettagli: Nano Banana 2 ha utilizzato entrambe le mani nel bar e ha dato maggiore risalto al telefono nel bagno; GPT Image 2.5 ha fornito per le attività relative al bar e allo specchio una corrispondenza leggermente più precisa con l’inquadratura richiesta.
| Dimensione decisionale | Cosa suggerisce questa serie di risultati | Cosa controllare da soli |
|---|---|---|
| Identità | In entrambe le versioni sono stati mantenuti il viso, il taglio di capelli a caschetto, il tono della pelle e il neo nelle tre scene. | Confronta il viso e l'attaccatura dei capelli considerando l'intera serie di immagini, non una alla volta. |
| Guardaroba | Entrambe le linee hanno seguito la tendenza della canotta e del cambio d'abito con trench color crema. | Cerca accessori extra e oggetti di scena inaspettati. |
| Pose e oggetti | Anche le piccole istruzioni possono essere interpretate in modo diverso: Nano Banana 2 ha usato entrambe le mani per tenere la tazza. | Controllare le mani, il contatto con gli oggetti e il numero di dita visibili. |
| Inquadratura ravvicinata | Entrambi sono riusciti a scattare un selfie decente in bagno; il telefono e lo schermo ricorsivo di Nano, invece, distraggono di più. | Controlla gli specchi, i telefoni, i riflessi e gli artefatti simili a testo a grandezza naturale. |
Cura il carosello finale
La creazione delle immagini è solo metà del lavoro. Una buona galleria di immagini deve avere un ritmo visivo, quindi evita di mettere tre primi piani quasi identici uno accanto all’altro.
- Inizia con l’elemento di riferimento identitario più chiaro o con il contesto più forte.
- Segue poi un’inquadratura media che cambia l’ambientazione o l’abbigliamento.
- Dopo aver verificato l'anatomia, aggiungi un oggetto spontaneo o un dettaglio della mano, come la tazza.
- Utilizza un'inquadratura ravvicinata per creare un'atmosfera intima, ma eliminala se il telefono, lo specchio o l'inquadratura stessa risultano fastidiosi.
- Controlla la sequenza nella sezione di ritaglio della piattaforma prima di esportare il set definitivo.
Lascia che il numero finale sia flessibile. Una serie più ristretta di inquadrature coerenti è più convincente di una quota fissa riempita con variazioni poco efficaci.
Il ruolo di GlobalGPT
GlobalGPT si adatta a questo flusso di lavoro come spazio di lavoro multimodello per le immagini. È possibile mantenere insieme il pacchetto di riferimento e quello di identità mentre si testa un percorso di elaborazione dell'immagine per una scena, un cambio di costume o un ritaglio ravvicinato. Ciò risulta utile quando si desidera confrontare i risultati pratici senza dover passare da uno strumento di elaborazione delle immagini all'altro per ogni esperimento.

La pagina pubblica Nano Banana 2 rappresenta un punto di partenza naturale per il lavoro sulle immagini basato su immagini di riferimento. Utilizzate il modello più adatto al lavoro da svolgere, specificate chiaramente nel prompt cosa deve rimanere invariato e cosa deve essere modificato, e valutate l’intera serie prima di procedere con la creazione di un carosello.
Prova il flusso di lavoro fotografico "reference-first" con Nano Banana 2.
FAQ
Che cos’è un “photodump” generato dall’IA?
Un "photodump" generato dall'IA è un insieme coordinato di immagini create artificialmente per i social media che ritraggono lo stesso soggetto in momenti, luoghi, inquadrature o abiti diversi.
Come faccio a mantenere lo stesso volto nelle foto generate dall'IA?
Inizia con un'immagine di riferimento chiara, ripeti gli elementi chiave dell'identità in ogni prompt e modifica una sola variabile principale alla volta. Controlla il viso, l'attaccatura dei capelli, il tono della pelle e i segni distintivi in tutta la serie.
È possibile cambiare l'abbigliamento pur mantenendo riconoscibile la persona?
Sì. Indica i nuovi capi di abbigliamento separatamente dal pacchetto di identità e mantieni invariati l’acconciatura, il viso, il tono della pelle e le proporzioni del corpo. Quindi controlla il risultato per verificare che non vi siano accessori aggiuntivi o modifiche alla silhouette.
Quante immagini devo creare per un carosello?
Non esiste un numero prestabilito. Crea un numero sufficiente di scatti per ottenere un ritmo alternato tra inquadrature ampie, medie, spontanee e ravvicinate, quindi conserva solo le immagini coerenti e utilizzabili.
Dovrei rifare il lancio se la prima immagine è scadente?
Per prima cosa, individua la variabile che non funziona. Se l'immagine è valida ma presenta una mano poco convincente, un ritaglio o un riflesso, consideralo come un feedback sul prompt e sul flusso di lavoro. Non nascondere il difetto partendo dal presupposto che ogni nuovo tentativo sarà migliore.









