
Recensione Claude Opus 5.5: prezzo, benchmark e test API reali
Claude Opus 5.5 combina una finestra di contesto da 1 milione di token con un costo API di $4 / $20 per milione di token. Questa recensione distingue tra le affermazioni pubblicate da Anthropic, le istantanee dei benchmark indipendenti e cinque esecuzioni dirette di attività tramite l’API Messages.
Il risultato della misurazione è specifico. Tre attività hanno fornito risultati chiari e utilizzabili; l’attività di codifica ha fornito una risposta utile ma ha raggiunto il limite massimo di 1.024 token; l’esecuzione relativa alla scrittura in cinese ha prodotto un testo illeggibile lungo il percorso testato. Il campione mostra comportamenti concreti e limiti del percorso, non un tasso di successo universale.
Risposta rapida
- Prestazioni: Anthropic riporta prestazioni di livello Fable 5.1 nella maggior parte dei compiti, mentre Artificial Analysis ha registrato un punteggio di 58 nell’Indice di Intelligenza al massimo sforzo. I dati più limitati relativi alle capacità di giudizio raccolti da METR non hanno mostrato un miglioramento significativo rispetto a Fable 5.1.
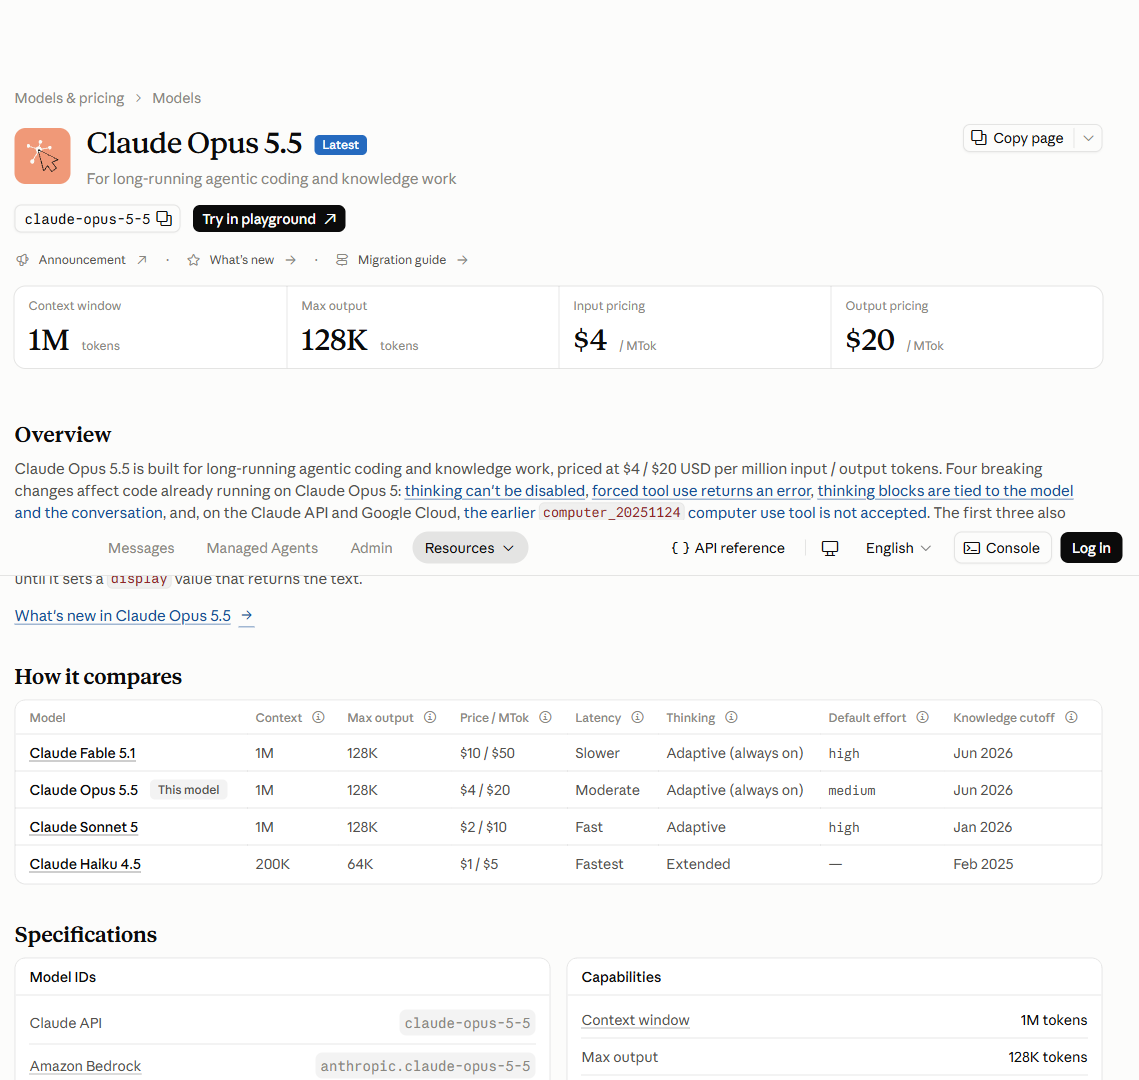
- Prezzo: il tasso ufficiale dell'API è $4 per ogni milione di token in ingresso e $20 per ogni milione di token in uscita. Le letture dalla cache hanno un costo di $0,20 per milione; le scritture nella cache ogni 5 minuti hanno un costo di $5 per milione.
- Risultato pratico: L'estrazione di testi lunghi, il JSON rigoroso e il ragionamento aritmetico hanno superato i test nelle esecuzioni registrate. La codifica si è rivelata utile, ma è stata troncata al limite massimo iniziale. Il risultato relativo al cinese è stato registrato come un problema di percorso/codifica, non come un verdetto linguistico a livello di modello.
- Avviso API: il pensiero non può essere disattivato, l'uso forzato degli strumenti genera un errore, i blocchi di pensiero sono legati al modello e alla conversazione, e il vecchio
computer_20251124Lo strumento non è supportato dall'API Claude e dal percorso Google Cloud.

Cosa dicono i documenti ufficiali
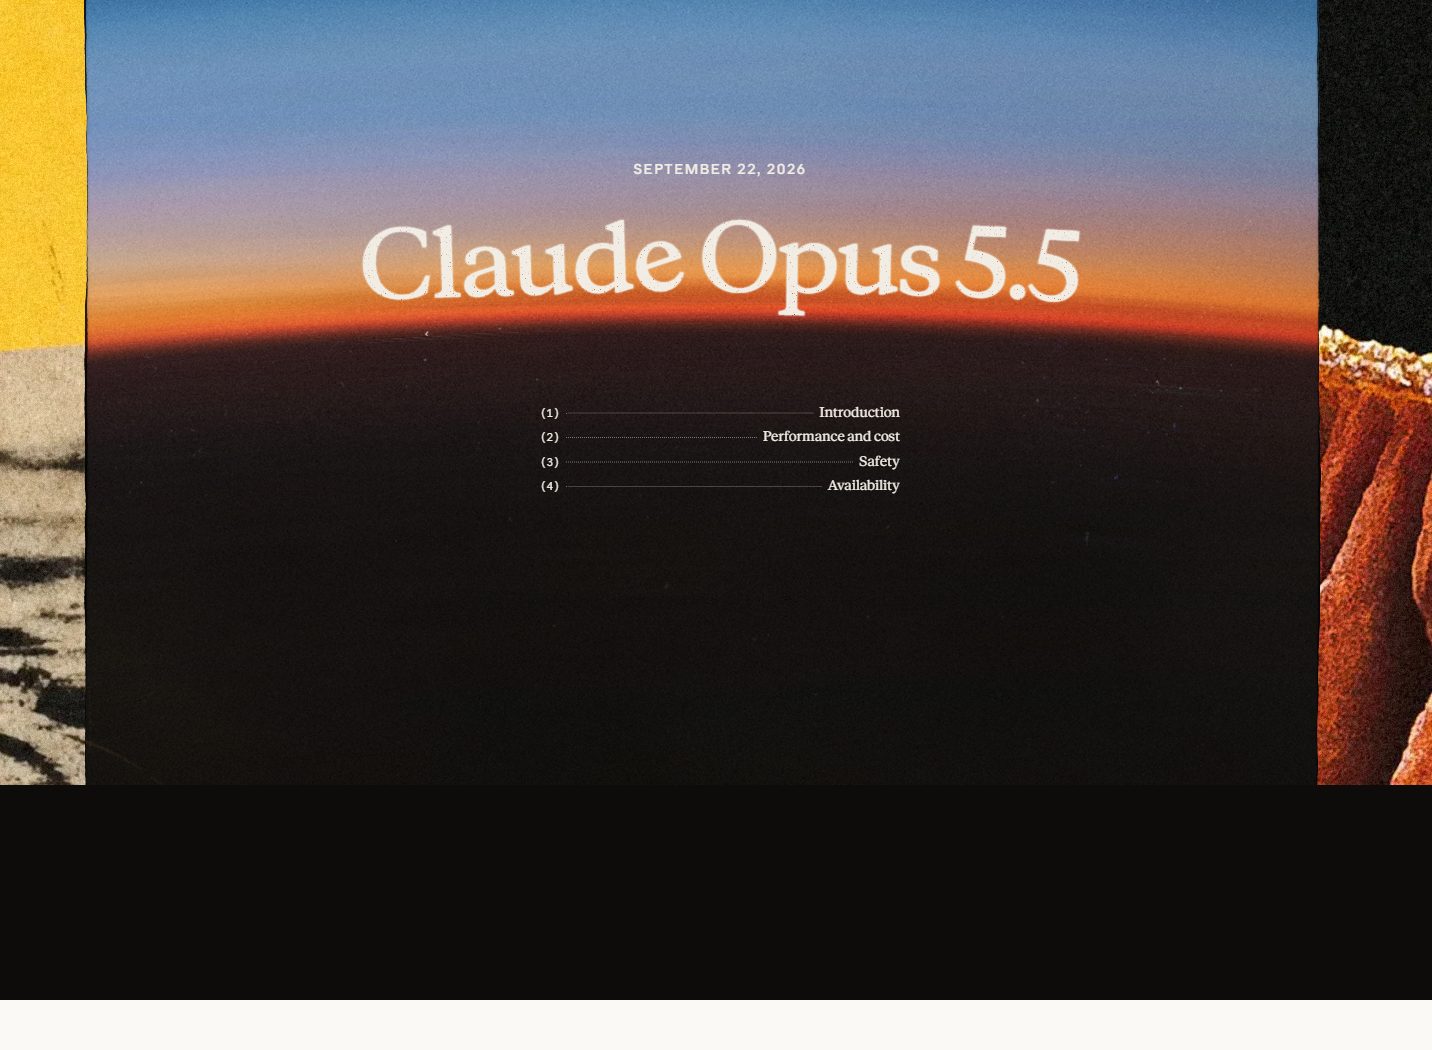
La pagina di presentazione di Anthropic indica che Claude Opus 5.5 sarà disponibile a partire dal 22 settembre 2026 e lo descrive come il primo modello della famiglia Claude 5.5. L’annuncio afferma che le prestazioni sono al livello del Claude Fable 5.1 nella maggior parte dei carichi di lavoro, con un costo tipico per carico di lavoro inferiore di 40% rispetto a Opus 5 e una velocità di elaborazione superiore di oltre 30% rispetto a Opus 5. Si tratta di affermazioni del fornitore, pertanto sono riportate separatamente dalle prove indipendenti e pratiche riportate di seguito.
Il Documentazione della piattaforma Claude indicare l'ID del modello API come claude-opus-5-5, una finestra di contesto da 1 milione di token, un output massimo di 128K e un sistema di ragionamento adattivo sempre attivo. La documentazione elenca inoltre le modifiche che interessano le integrazioni esistenti di Opus 5, trattate nella sezione dedicata alla migrazione riportata di seguito.
Dati relativi alle prestazioni
In questo caso non esiste un unico dato relativo alle “prestazioni”. Le tre fonti pubbliche misurano aspetti diversi, pertanto per ogni scheda vengono riportati in modo chiaro i parametri di riferimento e i limiti dei dati.
Annuncio Anthropic
Segnale pubblicato: Anthropic afferma che Opus 5.5 offre prestazioni pari a quelle di Claude Fable 5.1 nella maggior parte dei casi, costa 40% in meno rispetto a Opus 5 con carichi di lavoro tipici e produce risultati con una velocità superiore di oltre 30%.
Confine: Esempi di posizionamento e test pubblicati dal fornitore, non un benchmark indipendente.
Analisi artificiale
Segnale pubblicato: Lo snapshot "max-effort" riporta 59,61 TP40T su Terminal-Bench 4.0, 61,41 TP40T su Humanity’s Last Exam e 66,91 TP40T su SciCode.
Confine: I punteggi dipendono dall’impegno, dal modello, dalla data e dalla definizione dei parametri. Non consentono di prevedere ogni prompt dell’API.
Valutazione pre-implementazione del METR
Segnale pubblicato: METR afferma che i dati raccolti non hanno evidenziato un miglioramento significativo rispetto a Fable 5.1 nelle capacità di valutazione esaminate, pur prevedendo comunque un’accelerazione significativa per alcune attività di ricerca e sviluppo.
Confine: Si tratta di una valutazione più circoscritta relativa alla rapidità di giudizio e di esecuzione dei compiti, non di una classifica completa della qualità.
Nel loro insieme, i dati suggeriscono una conclusione limitata: l’Opus 5.5 risulta il modello migliore in diverse valutazioni pubbliche ormai datate, ma l’entità del vantaggio varia a seconda del compito, del livello di sforzo richiesto e della struttura della valutazione. I dati non indicano un risultato univoco che lo definisca il “miglior modello” in assoluto.
Claude Opus 5.5: unità di prezzo e di fatturazione
Il prezzo dell'API e il prezzo dell'abbonamento per gli utenti sono prodotti diversi. I dati relativi all'API riportati di seguito sono i prezzi unitari utilizzati per la gestione del budget dei token; i dati relativi agli utenti sono le schede dei piani visibili nell'area del browser catturata.
Prezzi ufficiali dell'API
Stima approssimativa: 10.000 token in ingresso più 2.000 token in uscita corrispondono a circa $0,08 alle tariffe standard, al lordo di cache, batch, tasse o ricarichi della piattaforma.
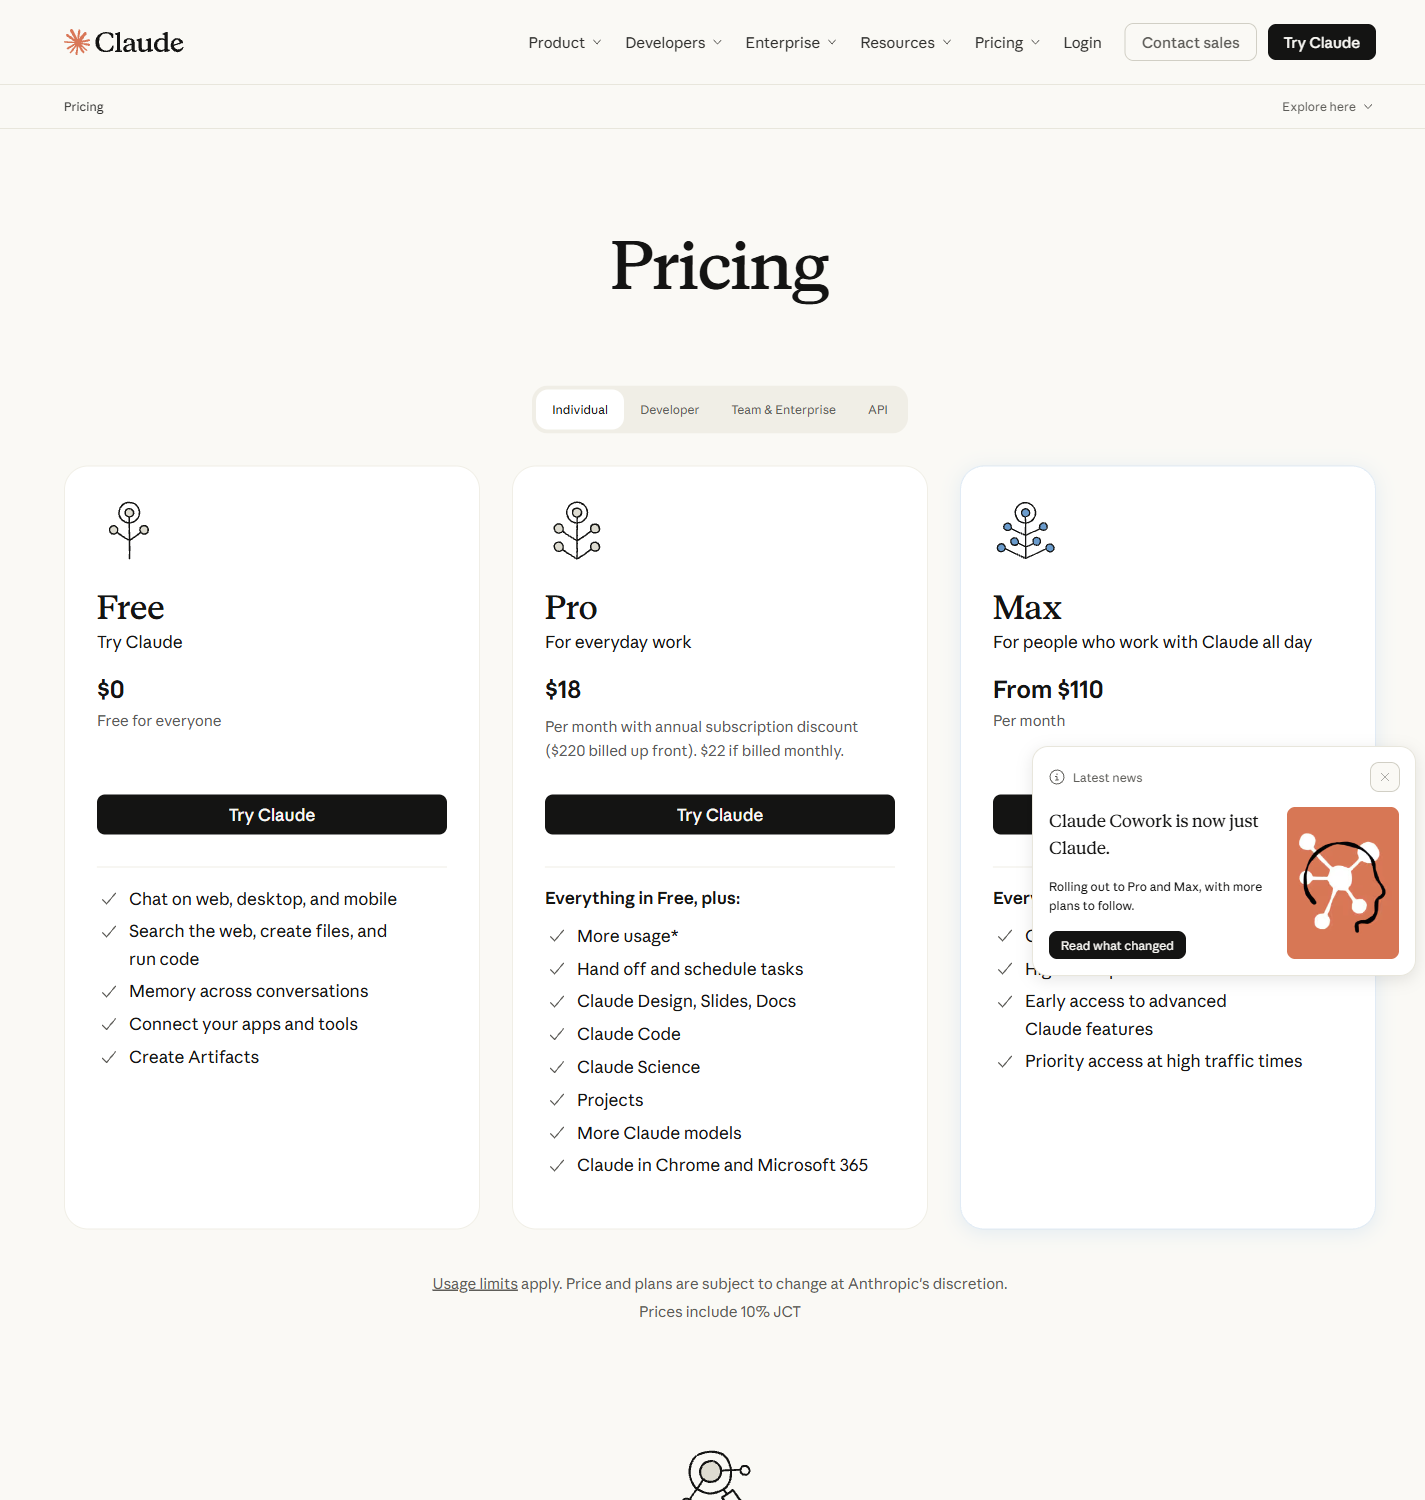
Screenshot del piano per i consumatori
La pagina acquisita mostra anche una nota JCT 10%. Si tratta di valori visualizzati che variano a seconda della regione, non di una promessa di prezzo valida a livello globale.
Per una spiegazione dettagliata della fatturazione a token e del costo della finestra di contesto, consultare il Guida ai prezzi e al contesto di GPT-5.5. Nel vostro bilancio, la tariffa API del fornitore, il costo dell’abbonamento ed eventuali saldi a credito sulla piattaforma multimodello dovrebbero essere indicati separatamente.
Prova pratica: cinque schede dei risultati delle attività
Il 23 settembre 2026 abbiamo inviato cinque richieste indipendenti attraverso lo stesso percorso controllato dell'API Messages con l'ID del modello claude-opus-5-5. Nel primo passaggio è stato utilizzato max_tokens: 1024. Abbiamo registrato il tempo trascorso a livello locale, i token di input/output, il motivo dell’interruzione, la correttezza e la conformità al formato letterale. L’attività di scrittura in cinese è stata rieseguita con un limite massimo di 4.096 token dopo che il primo passaggio aveva evidenziato il problema nell’output del percorso. Si tratta di un campione di cinque attività, non di una stima di affidabilità.
È in grado di ripristinare una funzione di deduplicazione di tipo misto?
Configurazione dell'attività
Trova l'errore in un codice Python deduplicazione funzione, gestire i valori non di tipo stringa e non hashabili, mantenere la prima variante ortografica e fornire dei test.
La risposta ha individuato il .lower() errore con valori non di tipo stringa, ho sostituito le stringhe con casefold(), ha aggiunto una soluzione alternativa non hashabile e ha restituito il codice corretto insieme ai casi di test.
La risposta si è fermata al limite massimo di 1.024 token. La soluzione è stata utile, ma la configurazione era troppo limitata per una revisione completa del codice.
Giudizio sulla carta: È stata restituita una risposta tecnicamente valida; questa esecuzione non può confermare alcuna affermazione relativa alla latenza o alla completezza, poiché il limite massimo dei token ne ha interrotto l'esecuzione.
È in grado di preservare i fatti e i limiti dei test?
Configurazione dell'attività
Estrai cinque risultati numerati da una breve nota di valutazione, indicando il metodo utilizzato e ciò che non è stato misurato nella fase successiva.
Ha restituito esattamente cinque punti numerati. Ha mantenuto i confronti tra gli assistenti, il metodo dei 20 suggerimenti e le lacune relative alla fidelizzazione a lungo termine e alla conversione dei clienti.
Si trattava di un pacchetto di dati di origine di piccole dimensioni, quindi non verifica la finestra di contesto da 1M.
Giudizio sulla carta: estrazione pulita con il numero richiesto e il confine delle prove del promemoria di origine preservato.
È in grado di restituire un output leggibile dal computer senza necessità di elaborazione aggiuntiva?
Configurazione dell'attività
Restituisci un oggetto JSON fisso contenente un titolo, un pubblico di riferimento, due aspetti positivi, due aspetti negativi e un verdetto. Non era consentito l'uso del tag Markdown.
Ha restituito un JSON analizzabile contenente le chiavi richieste, due vantaggi, due svantaggi e una raccomandazione concisa. Non era presente alcun wrapper Markdown.
Una risposta valida non dimostra l'affidabilità dello schema nel caso di oggetti più grandi o annidati.
Giudizio sulla carta: In questa esecuzione è stata verificata la conformità letterale allo standard JSON.
È in grado di applicare correttamente una regola di arrotondamento ripetuta?
Configurazione dell'attività
Inizia con 12 articoli, moltiplica ogni lotto successivo per 1,25, arrotonda per difetto dopo ogni lotto e riporta il totale dei quattro lotti.
Ha restituito 12, 15, 18 e 22, poi li ha sommati per ottenere 67. L'aritmetica intermedia era evidente.
Il compito è deterministico e di portata limitata; non riflette le capacità di ragionamento in senso lato.
Giudizio sulla carta: risultato corretto e passaggi intermedi trasparenti.
Il percorso testato ha restituito un testo in cinese utilizzabile?
Configurazione dell'attività
Redigi un'introduzione per una recensione in cinese che distingua tra affermazioni ufficiali, prezzo, dati di riferimento e test pratici.
La struttura della risposta era presente, ma nel risultato salvato i caratteri cinesi venivano visualizzati in modo distorto attraverso il percorso testato.
I dati non distinguono la qualità della lingua del modello dal comportamento relativo al percorso o alla codifica. Non viene assegnato alcun punteggio relativo alla qualità del cinese.
Giudizio sulla carta: Il testo restituito su questo percorso è inutilizzabile; rieseguire l'operazione utilizzando un percorso UTF-8 verificato prima di esprimere giudizi sulla qualità della traduzione.
Nelle quattro esecuzioni in lingua neutra o in inglese, la media locale è stata di 6,24 secondi. Tale valore si riferisce a cinque richieste consecutive su un unico percorso e non rappresenta la latenza lato provider. I comportamenti più evidenti osservati sono stati l’estrazione concisa, la conformità letterale allo standard JSON e la correttezza aritmetica; i due problemi irrisolti sono stati la pressione sul budget di output relativa alla codifica e l’output in cinese illeggibile sul percorso testato.
Avvertenze relative alle API e alla migrazione
La risposta sintetica li include perché possono alterare un’integrazione anche quando la qualità del testo del modello sembra buona.
- Il pensiero non si ferma mai. Utilizza il parametro di sforzo documentato per controllare la profondità, la latenza e il costo; non è previsto un interruttore di spegnimento.
- L'uso forzato dello strumento genera un errore. Il codice esistente che richiede la selezione forzata degli strumenti necessita di un test di migrazione separato.
- I blocchi di pensiero sono strettamente legati al modello e alla conversazione. Non dare per scontato che un blocco logico possa essere riutilizzato dopo aver cambiato modello.
computer_20251124non è accettato sull'API Claude e sul percorso di Google Cloud indicato nella documentazione.- I limiti massimi di produzione sono importanti. La scheda di codifica mostra che una risposta utile può comunque essere interrotta da un piccolo
max_tokensvalore. - La modalità batch e quella veloce sono percorsi di fatturazione distinti. Tenere separati gli sconti o i supplementi dai prezzi standard dei gettoni.
Verdetto basato su prove scientifiche
Claude Opus 5.5 presenta solide prove di benchmark pubblici datati e un tasso API standard pubblicato inferiore rispetto ai dati relativi a Opus 5 riportati nell’annuncio di Anthropic. Nelle cinque esecuzioni registrate, ha prodotto un’estrazione pulita, un JSON rigoroso e operazioni aritmetiche; la risposta di codifica era utile ma troncata dal limite massimo iniziale; l’output in cinese non era utilizzabile attraverso il percorso testato.
La conclusione che si può trarre è quindi limitata: il modello ha dimostrato una forte capacità di apprendimento in diversi compiti di piccola entità, mentre il percorso e la configurazione hanno evidenziato limiti evidenti. Qualsiasi decisione in materia di migrazione dovrebbe ripetere gli stessi prompt con un budget di output adeguato, verificare le chiamate agli strumenti e mantenere separati i tassi ufficiali dei token dai crediti di abbonamento o della piattaforma.
Se vuoi un secondo percorso a titolo di confronto, il Formato di test DeepSeek V4 Pro vs Flash mostra come i verdetti a livello di compito possano rimanere distinti dalle affermazioni relative all'intero modello. Il Guida ai casi d'uso di GPT-5.5 aggiunge un punto di riferimento orientato alle attività, mentre Note sul benchmark Flash Gemini e il Guida al confronto tra modelli di intelligenza artificiale fornire il contesto del modello più vicino. Per l'accesso a più modelli, vedere Abbonamenti “tutto in uno” basati sull’intelligenza artificiale e il confronto tra piattaforme multimodello.
Domande frequenti
Quanto costa il modello Claude Opus 5.5?
Il tasso ufficiale dell'API è pari a $4 per milione di token in ingresso e a $20 per milione di token in uscita. Le letture dalla cache ammontano a $0,20 per milione di token, mentre le scritture nella cache ogni 5 minuti ammontano a $5 per milione di token.
Che cos’è la finestra di contesto Claude Opus 5.5?
La documentazione della piattaforma Claude indica una finestra di contesto di 1 milione di token e un output massimo di 128K token. Un percorso beta documentato separatamente supporta fino a 300K token di output per i batch di messaggi.
Il modello Claude Opus 5.5 è migliore dell’Opus 5?
Anthropic riporta un costo tipico del carico di lavoro inferiore e una produzione più rapida, mentre valutazioni indipendenti mostrano risultati eccellenti in diverse attività datate. L’entità del miglioramento della qualità dipende dal benchmark, dall’impostazione dello sforzo, dal prompt e dal percorso.
È possibile "spegnere" il pensiero?
No. La documentazione relativa al modello attuale indica che il pensiero adattivo è sempre attivo. Utilizza il parametro “effort” per controllare la profondità del pensiero, la latenza e il costo.
Le cinque attività API hanno dimostrato la loro affidabilità?
No. Le schede illustrano comportamenti concreti e limiti di configurazione, ma cinque attività non sono sufficienti per stimare un tasso di successo generale. I problemi relativi al “tetto di codifica” e al “percorso cinese” sono riportati separatamente.
Questa recensione ha dimostrato la qualità cinese?
No. Il percorso testato ha restituito un testo in cinese illeggibile, pertanto il risultato è stato registrato come un problema di codifica o di percorso, in attesa di una nuova esecuzione con codifica UTF-8 verificata.









