Tinjauan Berbasis Bukti · Agustus 2026
Sistem penimbangan terbuka, API yang dihosting, dan kesenjangan penamaan—dijelaskan dengan jelas.
Batas bukti: Tidak ada klaim mengenai skor pendengaran langsung untuk Qwen3-TTS.
Sebuah ulasan Qwen3-TTS yang bermanfaat harus menjawab pertanyaan yang lebih mendasar sebelum memberikan penilaian terhadap suara-suara tersebut: Qwen3-TTS mana yang sedang kita bicarakan? Pada tahun 2026, nama tersebut mencakup checkpoint 0,6B dan 1,7B yang dapat diunduh, API Qwen3-TTS yang dihosting di Alibaba Cloud, serta pasar di mana keluarga produk Qwen-Audio 3.0 TTS yang terpisah juga direkomendasikan. Memperlakukan produk-produk tersebut sebagai satu kesatuan akan menghasilkan klaim yang menyesatkan terkait kecepatan, bahasa, dan harga.
Jawaban singkatnya adalah bahwa Qwen3-TTS merupakan salah satu tumpukan suara terbuka paling fleksibel pada tahun 2026. Tumpukan ini menawarkan sepuluh bahasa, titik pemeriksaan khusus tugas, kloning suara dalam waktu sekitar tiga detik, desain suara berbasis bahasa alami, dukungan streaming, serta lisensi Apache-2.0. Namun, ulasan ini tidak menyertakan skor pemahaman: lingkungan pengujian yang tersedia tidak menyediakan titik akhir Qwen3-TTS yang sebenarnya, dan GPU lokal berkapasitas 2 GB tidak cocok untuk pengujian perbandingan yang representatif antara model 0,6 miliar versus 1,7 miliar.
Status Qwen3-TTS pada tahun 2026
Qwen merilis bobot Qwen3-TTS yang terbuka pada tanggal 22 Januari 2026. Hal tersebut repositori resmi Qwen3-TTS mencantumkan lima checkpoint 12Hz yang telah dirilis: 1,7 miliar VoiceDesign, 1,7 miliar CustomVoice, 1,7 miliar Base, 0,6 miliar CustomVoice, dan 0,6 miliar Base. Yang sesuai Koleksi Hugging Face juga mencakup tokenizer. Inilah model-model yang dapat diperiksa, diunduh, dan dijalankan oleh para pengembang berdasarkan lisensi yang diterbitkan.
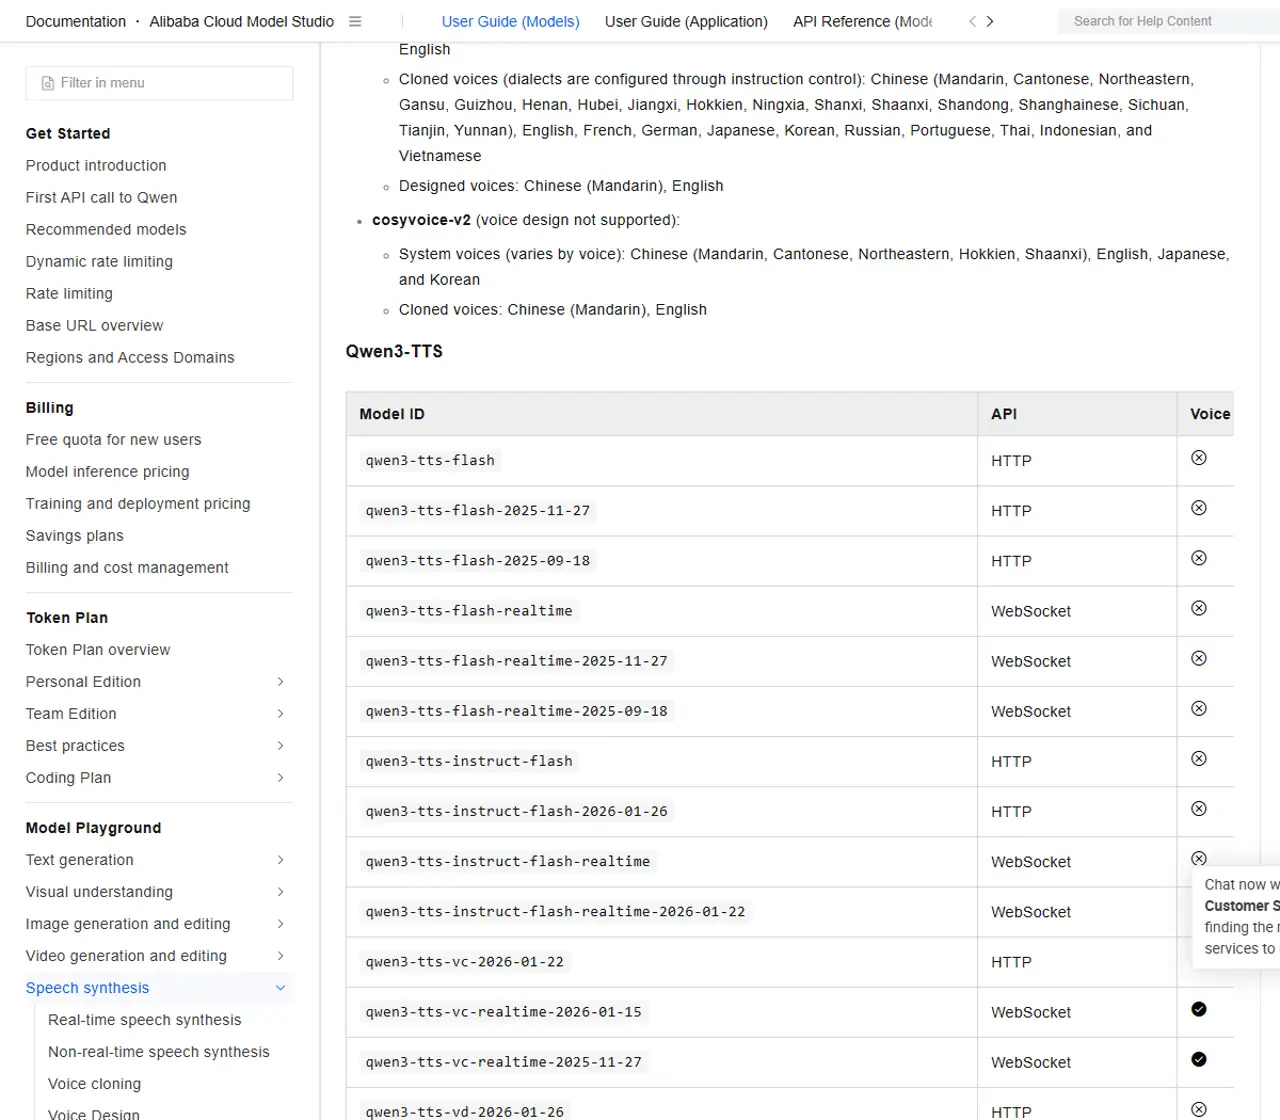
Alibaba Cloud secara terpisah menawarkan rangkaian layanan Qwen3-TTS Flash, Instruct, kloning suara, dan desain suara yang dihosting melalui antarmuka non-real-time dan real-time. Saat ini, katalog model sintesis ucapan harus dianggap sebagai sumber kebenaran untuk alias yang dihosting, wilayah, bahasa, dan antarmuka, karena detail-detail tersebut dapat berubah tanpa mengubah nama checkpoint terbuka.
Ada satu hal lagi yang perlu diperhatikan terkait penamaan. Panduan pemilihan model Alibaba Cloud tahun 2026 juga mengarahkan pengguna ke Qwen-Audio 3.0 TTS untuk beberapa tugas yang dihosting. Qwen-Audio 3.0 TTS bukanlah checkpoint Qwen3-TTS 0.6B atau 1.7B yang diganti namanya. Jika Anda sudah mengikuti keluarga Qwen yang lebih luas, panduan kami Qwen 3.8: Spesifikasi Maksimum dan Ulasan Akses menjelaskan mengapa penamaan model yang tepat sangat penting di seluruh produk Qwen.
Gunakan nama checkpoint terbuka untuk inferensi lokal, ID model Alibaba Cloud yang tepat untuk fungsi API, dan Qwen-Audio 3.0 TTS hanya sebagai alternatif terpisah. Hal ini memastikan bahwa setiap klaim terkait kualitas, latensi, dan harga tetap melekat pada produk yang menghasilkannya.
Kesimpulan singkat: kuat, terbuka, dan sensitif terhadap bukti
Kesimpulan singkat
Penerapan terbuka, penelitian, kloning, dan suara karakter.
Lima titik pemeriksaan khusus tugas yang tersebar di dua ukuran.
Kecepatan vendor bergantung pada lingkungan; kualitas belum dinilai di sini.
Rute Qwen3-TTS dan Qwen-Audio 3.0 yang dihosting merupakan rute yang terpisah.
Qwen3-TTS sangat menarik bagi tim yang menginginkan kendali dan fleksibilitas dalam penerapan. Fitur Base Checkpoints mendukung kloning, CustomVoice menyediakan preset suara dengan nama yang dilengkapi kontrol instruksi, dan VoiceDesign dapat menciptakan suara berdasarkan deskripsi tertulis. Dukungan untuk sepuluh bahasa membuat platform ini jauh lebih berguna dibandingkan demo terbuka yang hanya mendukung bahasa Inggris, sementara versi 0.6B memberikan titik awal yang lebih ringkas bagi para pengembang.
Hal yang perlu diperhatikan terutama adalah kualitas bukti. Qwen melaporkan hasil pengujian yang sangat baik dan latensi paket pertama yang rendah dalam lingkungan internal yang telah dioptimalkan. Angka-angka tersebut tidak mencakup proses cold start laptop, ruang kosong VRAM pada kontainer, atau pengucapan nama produk Anda. Janji “Universal 97 ms” tersebut tidak menyebutkan kondisi pengujian yang digunakan.
Untuk prototipe yang dihosting sendiri, Qwen3-TTS termasuk dalam daftar teratas. Untuk API produksi, bandingkan opsi Qwen3-TTS yang dihosting dengan rekomendasi Qwen-Audio yang lebih baru, dukungan operasional, ketersediaan regional, serta biaya pengelolaan suara kloning. Jika tujuan Anda melampaui suara hingga mencakup efek suara atau musik, cakupan yang lebih luas Uji coba suara, efek suara, dan musik Seed Audio 1.0 mencakup alur kerja audio yang berbeda dan lebih multimodal.
Kesimpulannya: Qwen3-TTS menunjukkan performa yang sangat baik dalam hal arsitektur, keterbukaan, dan cakupan fitur. Kualitas produksinya yang sesungguhnya masih bergantung pada titik pemeriksaan (checkpoint) atau titik akhir (endpoint) yang spesifik, perangkat keras yang Anda gunakan, bahasa pemrograman yang Anda pilih, serta suara referensi yang telah disetujui dan diuji dengan skrip Anda sendiri.
Apa itu Qwen3-TTS?
Qwen3-TTS adalah keluarga model pembangkit ucapan yang dibangun berdasarkan tokenizer ucapan diskrit yang beroperasi pada kecepatan 12,5 frame per detik. Menurut Laporan Teknis Qwen3-TTS, sistem ini dilatih menggunakan data lebih dari lima juta jam dalam sepuluh bahasa. Tingkat token yang rendah merupakan aspek kunci dalam desainnya: jumlah token akustik yang lebih sedikit dapat mengurangi beban pemrosesan dekoding dan membuat transmisi data secara streaming menjadi lebih praktis, sementara model tersebut tetap harus mempertahankan timbre, pengucapan, dan prosodi.
Tiga lapisan, tiga aturan pembuktian
0,6 miliar / 1,7 miliar
Base, CustomVoice, dan 1.7B VoiceDesign. Digunakan untuk klaim model lokal.
Flash / Panduan / VC / VD
Gunakan model API, antarmuka, wilayah, dan tanggal yang tepat.
Qwen-Audio 3.0 TTS
Sebuah alternatif yang saat ini dihosting, bukan Open Checkpoint yang berganti nama.
Lima titik pemeriksaan yang dirilis ini dirancang khusus untuk tugas tertentu, bukan sebagai hierarki di mana setiap model yang lebih besar mampu melakukan segala hal:
| Titik pemeriksaan telah dilepaskan | Ukuran | Lowongan kerja yang paling sesuai | Batas yang penting |
|---|---|---|---|
| Qwen3-TTS-12Hz-0,6B-Dasar | 0,6 miliar | Alur kerja kloning dan penelitian berskala lebih kecil | Tidak ada katalog CustomVoice yang telah ditetapkan sebelumnya |
| Qwen3-TTS-12Hz-1,7B-Dasar | 1,7 miliar | Pekerjaan kloning dan kelanjutan dengan kapasitas yang lebih besar | Membutuhkan lebih banyak memori dan daya komputasi |
| Qwen3-TTS-12Hz-0,6B-SuaraKustom | 0,6 miliar | Suara bawaan dengan kontrol instruksi | Menggunakan set speaker yang telah dirilis |
| Qwen3-TTS-12Hz-1,7B-Suara Khusus | 1,7 miliar | Sintesis suara prasetel berkapasitas lebih besar | Bukan titik pemeriksaan VoiceDesign |
| Qwen3-TTS-12Hz-1,7B-VoiceDesign | 1,7 miliar | Membuat timbre berdasarkan deskripsi teks | Belum ada versi 0.6B VoiceDesign peer yang dirilis |
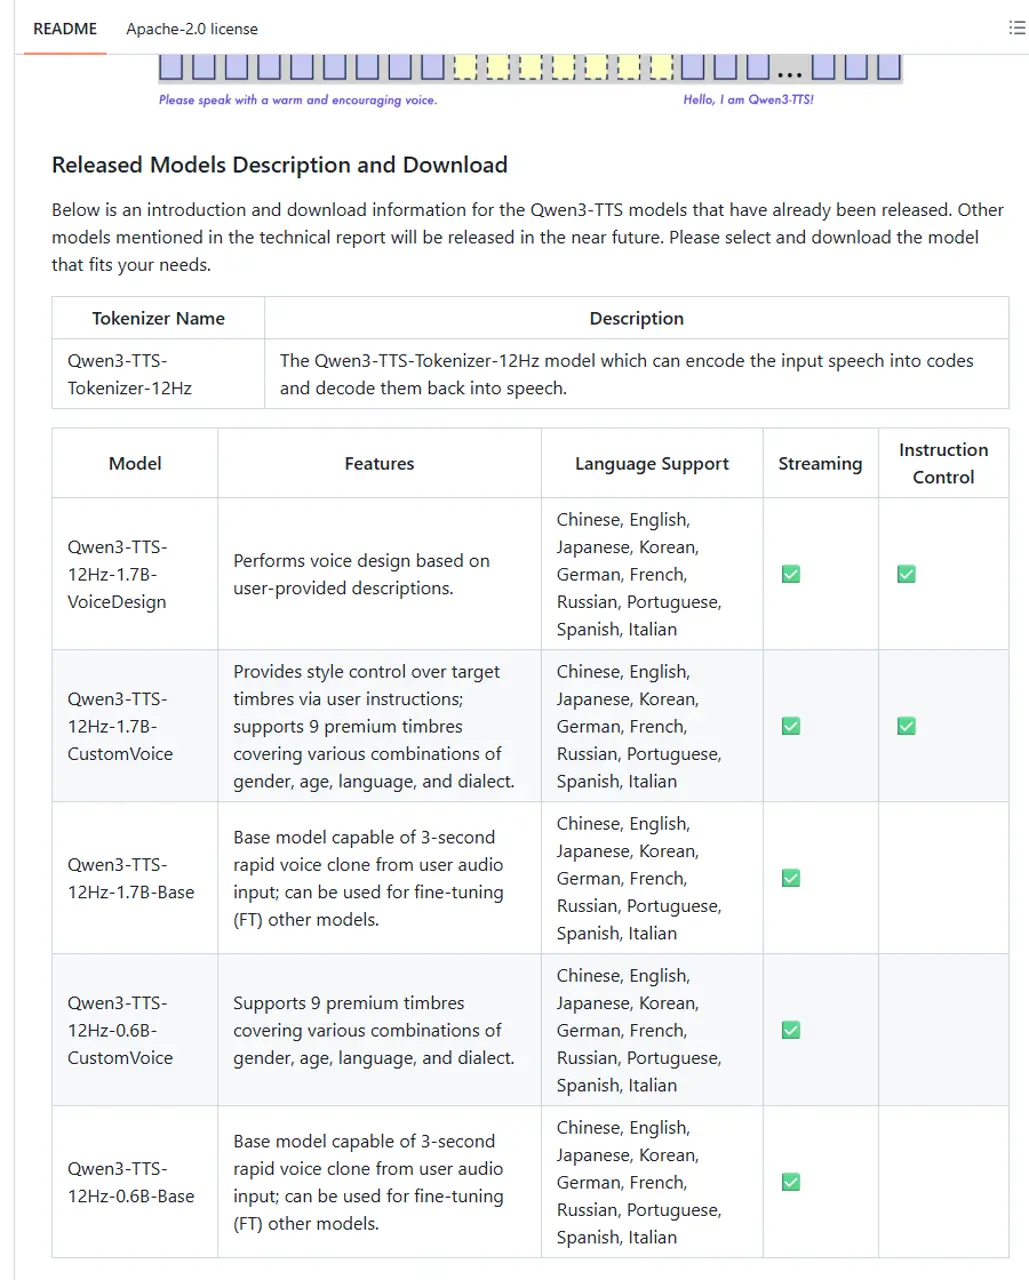
Base adalah pilihan yang tepat jika Anda memiliki speaker referensi dan izin untuk menggunakan suara tersebut. CustomVoice merupakan pilihan yang lebih mudah jika salah satu preset timbre yang dirilis oleh Qwen sesuai dengan proyek Anda. VoiceDesign ditujukan untuk deskripsi karakter seperti “narator yang tenang dan dewasa dengan register rendah yang lembut,” di mana rekaman referensi tidak diperlukan.
Tutorial produk tidak perlu menggunakan kloning jika narator bawaan sudah memadai, dan karakter fiksi mungkin tidak memerlukan rekaman suara orang sungguhan jika VoiceDesign mampu menciptakan identitas yang sesuai. Evaluasi setiap tugas dengan menggunakan titik pemeriksaan yang sesuai.
Bagaimana pengujian ulasan Qwen3-TTS ini dilakukan
Ulasan ini menggunakan empat lapisan bukti: dokumentasi resmi, laporan teknis Qwen, pemeriksaan perangkat keras di lapangan, dan uji terkontrol terhadap audio wrapper yang dihosting secara terpisah. Sumber-sumber resmi mendukung fakta produk dan hasil benchmark yang dilaporkan oleh vendor. Uji terkontrol terhadap wrapper tersebut hanya mendukung perilaku yang diamati, bukan skor kualitas suara Qwen3-TTS.
Daftar lingkungan tugas yang tersedia qwen-audio-3.0-tts-flash, bukan qwen3-tts-* model.
Buatlah rekaman suara berbahasa Inggris yang jelas dan lancar. Bacalah persis seperti ini: 'Saat matahari terbit, tim peneliti memeriksa setiap sinyal dua kali sebelum mengumumkan hasilnya.' Gunakan narator dewasa dengan suara hangat dan tenang, kecepatan bicara yang alami, pengucapan konsonan yang jelas, serta jeda singkat setelah kata 'matahari terbit'. Jangan tambahkan musik, efek suara, pengantar, atau kata-kata apa pun yang tidak terdapat dalam kalimat yang dikutip.Dalam pengujian kami, masukan ini menghasilkan file MP3 berdurasi 21,263673 detik dan membacakan petunjuk tersebut secara lisan. Hasil pengujian menunjukkan bahwa wrapper tersebut memperlakukan prompt lengkap tersebut sebagai teks ucapan.
Saat matahari terbit, tim peneliti memeriksa setiap sinyal dua kali sebelum mengumumkan hasilnya.Kami mengulangi pengujian kontrol dengan hanya menggunakan kalimat target. Dalam pengujian kami, hasilnya adalah file MP3 berdurasi 6,086531 detik dengan frekuensi 22.050 Hz, bitrate 128 kbps, dan format mono. File tersebut sesuai persis dengan kalimat target kata demi kata dan tidak menyertakan instruksi apa pun.
Pengguna tersebut telah mendengarkan kedua berkas tersebut dan mengonfirmasi penilaian di bawah ini. Ini merupakan pemeriksaan praktis oleh satu pendengar, bukan studi MOS atau panel pendengaran.
| Dimensi mendengarkan | Kontrol yang dilengkapi instruksi | Kontrol teks biasa |
|---|---|---|
| Kealamian | 4/5 | 5/5 |
| Kejelasan | 5/5 | 5/5 |
| Pengucapan | 5/5 | 5/5 |
| Prosodi | 4/5 | 5/5 |
| Ketepatan teks | 1/5 | 5/5 |
| Kepatuhan terhadap gaya | Belum diberi nilai | 5/5 |
| Tidak adanya artefak | 5/5 | 5/5 |
| Kegunaan dalam produksi | 1/5 | 5/5 |
Contoh yang berisi petunjuk terdengar jelas dan sebagian besar terdengar alami, tetapi pembacaan petunjuk tersebut merusak keakuratan teks dan kegunaan dalam produksi. Contoh teks biasa terdengar alami, mengikuti kalimat dengan tepat, dan tidak memerlukan penyempurnaan isi. Skor-skor ini hanya menggambarkan kedua qwen-audio-3.0-tts-flash kontrol pembungkus; hal tersebut bukanlah penilaian kualitas suara pada titik pemeriksaan Qwen3-TTS.
Jangan pernah menganggap bahwa petunjuk gaya dan narasi berada dalam bidang yang sama. Panduan kami mengenai membuat ucapan yang ditulis oleh AI terdengar lebih seperti manusia Hal ini memperbaiki skrip, tetapi kolom titik akhir yang menentukan apakah perintah arah akan mengendalikan suara atau memulai perekaman.
Pemeriksaan lokal menemukan kartu grafis NVIDIA GeForce MX450 dengan VRAM 2 GB dan memori sistem sekitar 16,9 GB. Platform tersebut tidak memadai untuk matriks 0,6B versus 1,7B yang direncanakan. Pengalihan beban kerja ke CPU mungkin hanya menunjukkan kecepatan saat peluncuran, bukan kecepatan yang representatif. Oleh karena itu, kualitas suara Qwen3-TTS, RTF lokal, kemiripan kloning, dan konsistensi lintas bahasa tetap tidak dinilai.
Kualitas suara Qwen3-TTS: apa yang dapat dibuktikan oleh bukti-bukti
Laporan resmi tersebut menunjukkan hasil yang memuaskan dari model Qwen3-TTS dalam hal kejelasan, kemiripan pembicara, kemampuan mengikuti instruksi, pembangkitan teks multibahasa, ucapan berdurasi panjang, dan streaming. Hasil-hasil tersebut merupakan acuan perbandingan yang berguna, namun tetap merupakan tolok ukur yang dilaporkan oleh Qwen, bukan rekaman yang dihasilkan di sini.
Uji suara produksi harus mencakup pengucapan, gangguan suara, kecepatan bicara, ekspresi emosional, konsistensi, beban pengeditan, singkatan, tanggal, mata uang, URL, nama, peralihan kode bahasa, dan kalimat panjang.
Padukan kegiatan mendengarkan dengan transkrip dan metadata; Alur kerja transkripsi audio ChatGPT membuat proses pemeriksaan teks dapat diulang.
Qwen3-TTS tampak menjanjikan, namun ulasan ini tidak menyertakan skor uji coba langsung. Sebelum mengirimkan produk, lakukan pengujian berulang kali menggunakan pendengar asli, headphone, dan speaker ponsel.
Hal-hal yang menjadi fokus para pengulas eksternal
Demo sosial Qwen menonjolkan beragam timbre, bahasa, dan dialek. Pencipta independen Bijan Bowen berfokus pada implementasi lokal dan kloning suara; Jeff Geerling menggambarkan peluncuran ini sebagai pesaing open-source yang tangguh bagi platform TTS yang dikelola. Hal-hal ini merupakan sudut pandang para pengulas, bukan hasil pengujian perbandingan atau bukti adanya konsensus di seluruh pasar.
Kecepatan dan latensi Qwen3-TTS
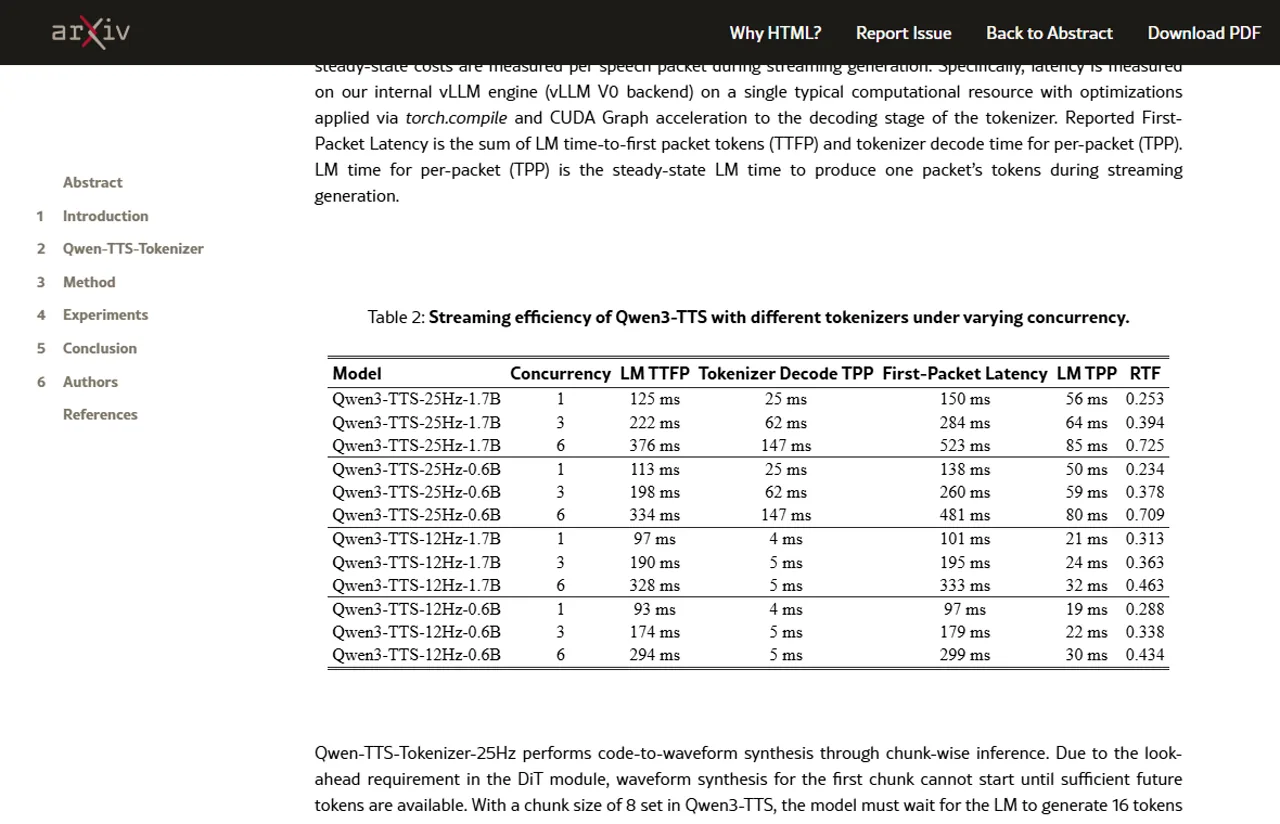
Latensi paket pertama
0.288 / 0.313
0,6 miliar / 1,7 miliar pada tingkat koncurrency 1.
Lingkungan vLLM internal yang telah dioptimalkan—bukan jaminan kinerja laptop.
Angka kecepatan utama yang tercatat adalah latensi paket pertama sebesar 97 ms untuk model 0,6B 12Hz. Tabel dalam laporan teknis yang sama mencantumkan angka 101 ms untuk model 1,7B 12Hz pada tingkat koncurrency 1. Faktor waktu nyata (RTF) yang dilaporkan masing-masing adalah 0,288 dan 0,313. Dengan kata lain, nilai RTF di bawah 1 berarti proses sintesis berjalan lebih cepat daripada durasi audio yang dihasilkan dalam lingkungan tersebut.
Hasil-hasil tersebut diperoleh dari konfigurasi vLLM internal yang telah dioptimalkan pada Qwen. Hasil tersebut bukanlah perkiraan waktu hingga audio pertama yang berlaku umum untuk laptop Windows, kontainer serverless yang belum dipanaskan, atau wilayah API bersama. Laporan tersebut juga menunjukkan bahwa koncurrency memengaruhi latensi. Pemuatan model, pemrosesan audio referensi, transmisi jaringan, antrian, pengemasan audio, dan pemutaran klien semuanya dapat berada di luar angka decoder inti.
Catatan tolok ukur yang adil seharusnya mencakup:
- Perangkat keras, presisi, revisi model, dan bagian belakang sistem.
- Keadaan dingin atau hangat, koncurrency, waktu audio pertama, waktu total, penggunaan VRAM puncak, durasi keluaran, dan RTF.
- Untuk sebuah API: wilayah, jenis koneksi, ID permintaan, antrian, dan upaya ulang.
Model 0,6B seharusnya menjadi pilihan yang lebih aman ketika memori dan koncurrency lebih diutamakan daripada kapasitas maksimum. Model 1,7B merupakan pilihan yang lebih masuk akal dari segi kualitas jika mesin memiliki ruang cadangan. Namun, tanpa menggunakan prompt, speaker, pengaturan sampling, dan kondisi warm state yang sama, ukuran model saja tidak dapat menunjukkan perbedaan latensi yang sebenarnya.
Qwen3-TTS: Bahasa dan Pengucapan
Titik pemeriksaan terbuka Qwen3-TTS mendukung sepuluh bahasa: Mandarin, Inggris, Jepang, Korea, Jerman, Prancis, Rusia, Portugis, Spanyol, dan Italia. Daftar ini diambil dari repositori terkini dan materi model yang telah dirilis. Jangan menambahkan bahasa Thailand, Indonesia, Melayu, atau Vietnam secara diam-diam karena produk audio Qwen lainnya sudah mendukung bahasa-bahasa tersebut.
| Bahasa | Dukungan resmi yang terbuka | Prioritas tinjauan produksi |
|---|---|---|
| Bahasa Mandarin | Ya. | Nada, nama, cara membaca angka, gaya penulisan khas daerah |
| Bahasa Inggris | Ya. | Stres, singkatan, nama merek, kalimat panjang |
| Bahasa Jepang | Ya. | Aksen nada, partikel, nama, teks campuran bahasa Latin |
| Korea | Ya. | Spasi, kata serapan, akhir kalimat |
| Bahasa Jerman | Ya. | Gabungan huruf, angka, dan gugus konsonan |
| Bahasa Prancis | Ya. | Hubungan, singkatan, nama yang dipinjam |
| Rusia | Ya. | Stres, nama, angka, sisipan bahasa Latin |
| Bahasa Portugis | Ya. | Pastikan aksen daerah dan ejaan yang dimaksud |
| Bahasa Spanyol | Ya. | Pastikan aksen daerah dan nama-nama khusus |
| Italia | Ya. | Stres, geminasi, nama asing |
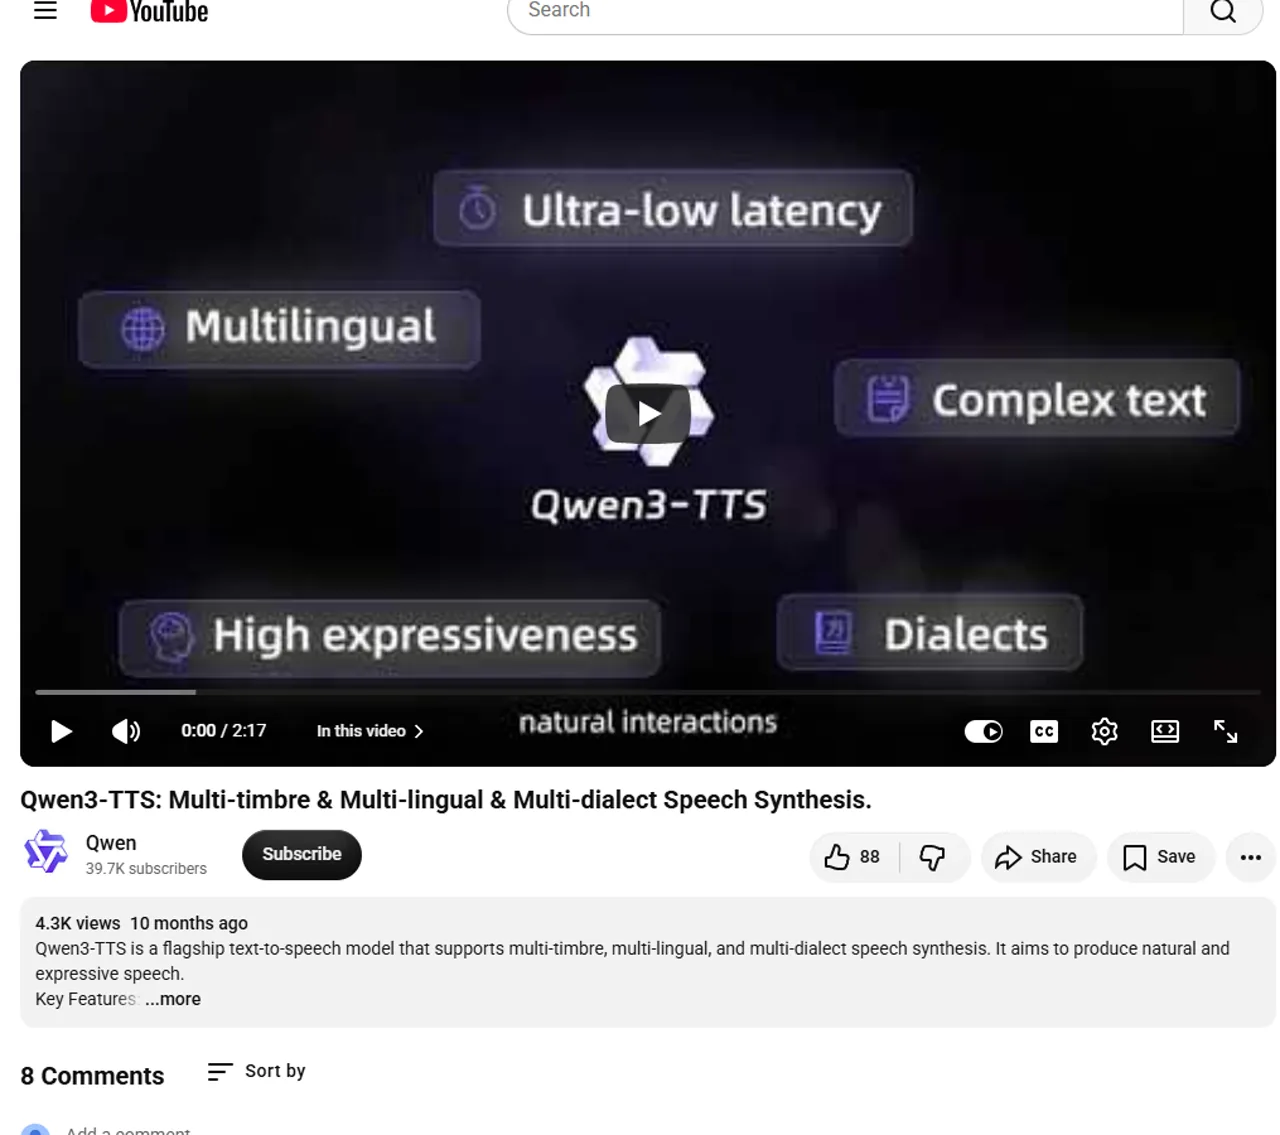
“Mendukung” berarti model tersebut mampu mensintesis bahasa tersebut; hal ini tidak berarti setiap suara terdengar sama alami seperti penutur asli di setiap wilayah. Bahasa Portugis dan Spanyol saja sudah memiliki variasi regional yang signifikan. Dalam penerapan komersial, perlu ditentukan wilayah sasaran, merekrut peninjau penutur asli, serta menyusun kumpulan data regresi pengucapan untuk nama, satuan pengukuran, alamat, dan frasa hukum.
Perpindahan kode bahasa memerlukan tes tersendiri. Kalimat seperti “Buka API Qwen3-TTS di São Paulo pada pukul 09.30 pagi” menggabungkan kerangka kalimat dalam bahasa Inggris, nama model, pengucapan dalam bahasa Portugis, tanda baca, dan waktu. Hal itu jauh lebih mendekati teks aplikasi yang sebenarnya daripada kalimat demo monolingual yang sederhana. Untuk sulih suara video, pengucapan juga harus sesuai dengan waktu; kami Veo 3.1 alur kerja dialog, audio, dan sinkronisasi bibir membahas masalah sinkronisasi yang terkait.
Kloning suara, CustomVoice, dan VoiceDesign
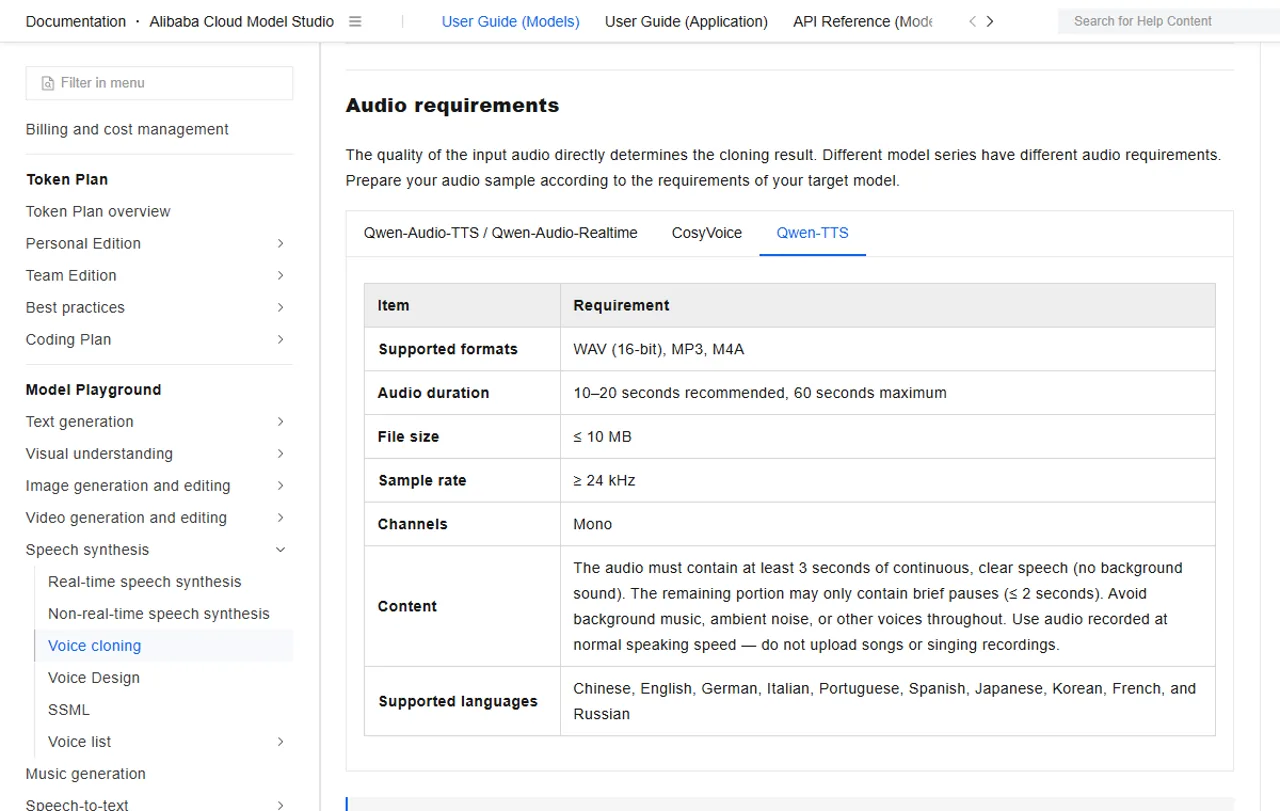
Titik pemeriksaan Base mendukung kloning suara secara cepat hanya dengan rekaman audio referensi berdurasi sekitar tiga detik. Hal itu merupakan batas kemampuan minimum yang mengesankan, bukan jaminan bahwa rekaman berdurasi tiga detik selalu menjadi sampel produksi terbaik. Referensi yang singkat dapat melewatkan rentang nada, tempo, cakupan vokal, emosi, dan konsistensi mikrofon.
Panduan pendaftaran yang disediakan oleh Alibaba Cloud lebih konservatif: panduan ini mensyaratkan setidaknya tiga detik ucapan yang jelas dan tanpa gangguan secara terus-menerus, memperbolehkan sampel yang lebih panjang, serta merekomendasikan rekaman yang lebih jelas dan lebih panjang untuk kloning yang praktis. Ikuti panduan saat ini dokumentasi kloning suara untuk aturan terkait format, laju sampel, saluran, durasi, dan wilayah, alih-alih menganggap demonstrasi selama tiga detik dalam makalah tersebut sebagai spesifikasi pengunggahan.
CustomVoice menghindari peniruan suara orang sungguhan. Rilis terbuka ini mencakup sembilan jenis suara premium untuk berbagai bahasa atau gaya, sehingga menjadi pilihan yang menarik ketika identitas bawaan dan kontrol instruksi sudah cukup.
VoiceDesign menghasilkan timbre berdasarkan deskripsi dalam bahasa alami. Layanan berbasis cloud ini Dokumentasi Desain Suara menunjukkan alur kerja pembuatan yang terpisah. Alur kerja ini cocok untuk karakter fiksi dan suara merek sintetis, namun deskripsi-deskripsi tersebut tetap perlu diuji terkait persepsi usia, aksen, dan bias budaya.
Matriks risiko identitas suara
Catat nama pembicara, ruang lingkup, masa jabatan, dan jalur pengunduran diri.
Enkripsi referensi dan hapus suara turunan bersama dengan sumbernya.
Blokir klaim identitas yang merugikan dan tambahkan fitur pelaporan.
Berikan label pada ucapan sintetis jika pendengar mungkin mengira ucapan tersebut berasal dari manusia.
Kloning memerlukan hak yang tegas dan persetujuan yang didasarkan pada informasi yang memadai. Simpan catatan persetujuan asli, tentukan penggunaan yang diizinkan, cegah pendaftaran ulang di tahap selanjutnya, dan sediakan proses penghapusan. Risikonya bukanlah sekadar teori; analisis privasi dan persetujuan terkait pengenalan wajah ke suara menjelaskan mengapa aspek identitas, data biometrik, dan langkah-langkah pengamanan terhadap peniruan identitas harus menjadi bagian dari desain produk, bukan sekadar catatan kaki.
Qwen3-TTS 0,6B vs 1,7B: mana yang sebaiknya Anda jalankan?
Pilih 0.6B jika pertimbangan utama Anda adalah implementasi. Ukuran ini lebih cocok untuk GPU berkapasitas lebih kecil, tingkat koncurrency yang lebih tinggi, eksperimen yang lebih cepat, serta self-hosting yang mengutamakan efisiensi biaya. Baik model Base maupun CustomVoice tersedia dalam ukuran ini, sehingga Anda dapat mengevaluasi kloning atau preset speaker tanpa harus memulai dari checkpoint terbesar.
Pilih 1,7B jika ruang gerak kualitas dan cakupan fitur menjadi prioritas utama. Ini adalah satu-satunya ukuran yang telah dirilis dengan VoiceDesign, dan merupakan pilihan yang lebih masuk akal bagi tim yang bersedia mengorbankan memori dan throughput demi kapasitas. Angka-angka pada laporan teknis untuk skenario concurrency-1 menunjukkan perbedaan kecil pada waktu paket pertama dan RTF dalam konfigurasi yang dioptimalkan pada Qwen, namun perangkat keras Anda sendiri mungkin memperbesar atau memperkecil selisih tersebut.
| Faktor penentu | Mulailah dengan 0,6B | Mulailah dengan 1,7 miliar |
|---|---|---|
| Memori GPU sedang terbatas | Kenyamanan yang lebih baik | Risiko yang lebih tinggi terkait pembebanan atau tingkat koncurrency yang rendah |
| Butuh VoiceDesign | Tidak tersedia dalam set yang telah dirilis | Diperlukan |
| Perlu kloning basis | Tersedia | Tersedia dengan kapasitas yang lebih besar |
| Butuh CustomVoice | Tersedia | Tersedia dengan kapasitas yang lebih besar |
| Butuh uji kelayakan yang cepat | Titik awal yang terbaik | Gunakan setelah pekerjaan pipa selesai |
| Perlu keputusan akhir mengenai produksi | Lakukan pengujian perbandingan terhadap keduanya | Lakukan pengujian perbandingan terhadap keduanya |
Jumlah parameter bukanlah satu-satunya faktor penentu kebutuhan VRAM. Presisi, implementasi perhatian, cache, panjang referensi, ukuran batch, dan beban tambahan kerangka kerja—semuanya berperan penting. Model yang hanya bisa dimuat dengan susah payah bukanlah layanan produksi yang andal.
Untuk MX450 2 GB yang diuji dalam ulasan ini, tidak ada satu pun dari kedua konfigurasi tersebut yang memberikan hasil pengujian GPU yang representatif. Langkah praktis selanjutnya adalah menggunakan stack CUDA yang lebih baru serta GPU yang sesuai atau titik akhir (endpoint) resmi yang dihosting. Ungkapan “berjalan dengan CPU offload” sebaiknya dianggap sebagai catatan kompatibilitas, bukan penilaian kecepatan yang bermakna.
API Qwen3-TTS: HTTP, streaming, dan ID model
Pilih moda transportasi sesuai dengan kebutuhan pemutaran
Cara termudah untuk narasi berkelompok dan berkas lengkap.
Pengiriman bertahap; tetap periksa kapan audio dapat diputar.
Pilihan terbaik untuk percakapan dan pemutaran bertahap.
Alibaba Cloud menyediakan model HTTP non-real-time dan model WebSocket real-time. Gunakan sintesis non-real-time jika Anda dapat menunggu hasil yang lengkap dan menginginkan alur permintaan yang paling sederhana. Gunakan streaming WebSocket jika latensi percakapan atau pemutaran bertahap menjadi pertimbangan. Streaming HTTP atau server-sent events dapat mengembalikan data secara bertahap, tetapi hal ini tidak boleh disamakan dengan keluarga model real-time khusus yang memiliki latensi rendah.
Keluarga model yang saat ini tersedia meliputi Qwen3-TTS Flash untuk suara bawaan, Instruct Flash untuk pengendalian kinerja berbasis bahasa alami, VC untuk suara kloning, dan VD untuk suara yang dirancang khusus. ID model dan snapshot bertanggal berbeda antara rute non-real-time dan real-time, jadi salinlah dari dokumentasi terkini daripada membuat nama berdasarkan analogi.
Arus Dokumentasi API Qwen-TTS membatasi masukan hingga 512 token per permintaan. Itulah batasan yang berlaku untuk keluarga model ini; aturan terpisah yang menyebutkan 600 karakter—yang didokumentasikan untuk model TTS lainnya—tidak boleh disalin ke dalam integrasi Qwen3-TTS. URL audio lengkap tetap berlaku selama 24 jam, sehingga sistem produksi sebaiknya memindahkan berkas yang diperlukan ke penyimpanan yang tahan lama, bukan menggunakan URL respons sebagai media permanen.
import os
import dashscope

dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

response = dashscope.MultiModalConversation.call(
    model="qwen3-tts-flash",
    api_key=os.environ["DASHSCOPE_API_KEY"],
    text="Pesanan Anda sudah siap diambil pada pukul 16.30",
    voice="Cherry",
    language_type="English",
)

print(response)
Kunci API dan wilayah endpoint harus sama. Penyebaran di Beijing dan Singapura menggunakan kredensial dan URL dasar yang berbeda, sementara ketersediaan model dapat bervariasi tergantung wilayah. Jangan pernah menyematkan kunci tersebut di WordPress, JavaScript sisi klien, atau file biner seluler. Kirim permintaan sintesis melalui server yang Anda kendalikan, catat ID permintaan tanpa mencatat input sensitif, dan tetapkan kebijakan siklus hidup untuk audio yang dihasilkan.
Untuk dokumen yang panjang, bagi menjadi bagian-bagian berdasarkan batas-batas semantik, pertahankan konteks, normalisasikan angka, dan perhatikan setiap titik penggabungan. Klip yang valid tetap bisa terdengar seperti rekaman terpisah jika tempo atau energinya berubah di antara panggilan.
Harga Qwen3-TTS di wilayah internasional
Gambaran singkat penetapan harga di kawasan internasional
Flash
$0.10
per 10.000 karakter masukanInstruksi / VC / VD
$0.115
per 10.000 karakter masukanFlash / VC
$0.13
per 10.000 karakter masukanBerikan petunjuk
$0.143
per 10.000 karakter masukanVD
$0.143353
per 10.000 karakter masukanPembuatan suara: $0.01 per pendaftaran · $0.20 per suara yang dirancang.
Alibaba Cloud’s Halaman Harga Model Studio Berikut ini adalah daftar harga untuk wilayah internasional yang tercatat saat diperiksa pada 11 Agustus 2026. Untuk baris-baris ini, karakter yang dimasukkan akan dikenakan biaya, sedangkan karakter yang dihasilkan gratis. Harga, kuota gratis, alias, dan ketersediaan regional dapat berubah, jadi pastikan untuk memverifikasi penyebaran yang dipilih sebelum melakukan pengiriman dalam jumlah besar.
| Rute | Keluarga model | Harga per 10.000 karakter yang dimasukkan |
|---|---|---|
| Bukan waktu nyata | Qwen3-TTS Flash | $0.10 |
| Bukan waktu nyata | Instruct, VC, atau VD | $0.115 |
| Waktu nyata | Flash atau VC saat ini | $0.13 |
| Waktu nyata | Berikan petunjuk | $0.143 |
| Waktu nyata | VD | $0.143353 |
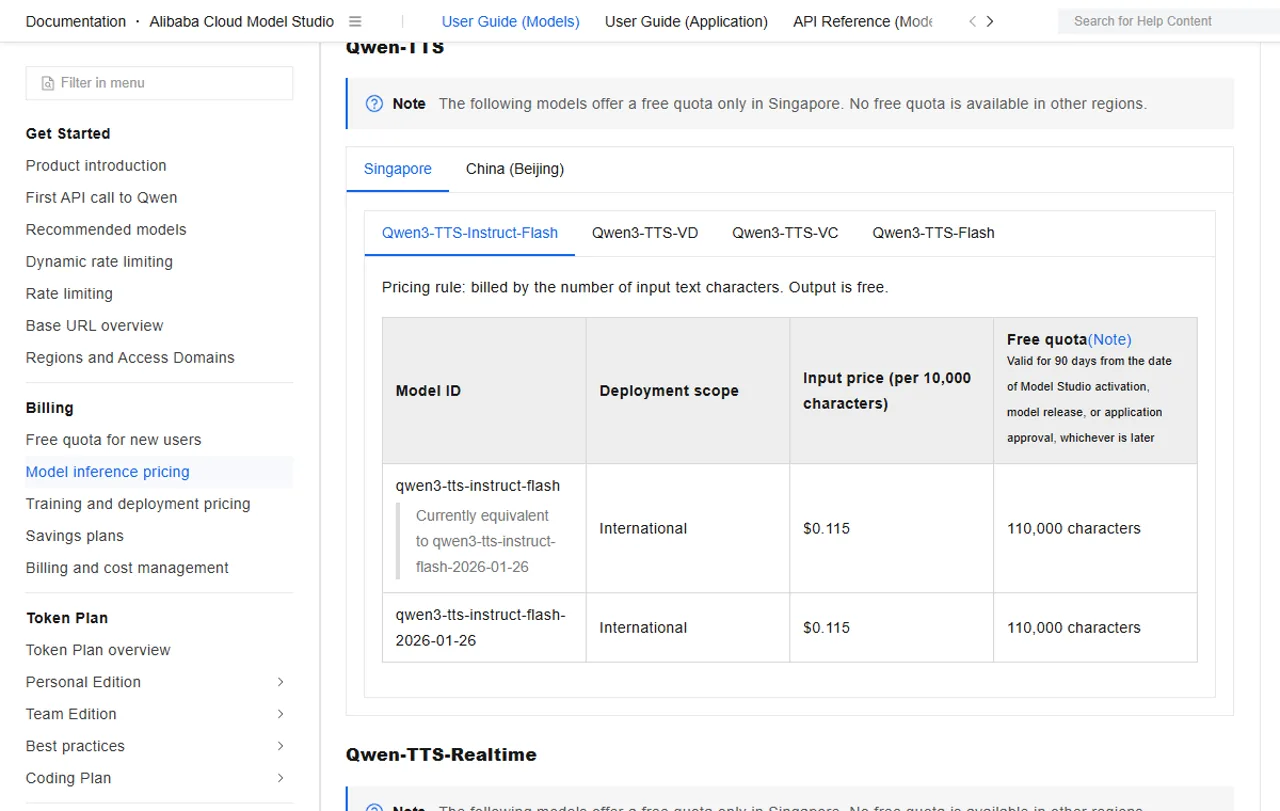
Pembuatan suara dikenakan biaya terpisah dari sintesis. Daftar harga internasional yang sama mencantumkan biaya pendaftaran suara Qwen sebesar $0,01 per klon dan biaya desain suara sebesar $0,20 per suara yang didesain. Identitas yang dikloning atau didesain tersebut kemudian dapat dikenakan biaya sintesis per karakter yang berlaku saat digunakan.
Anggarkan secara terpisah untuk pembuatan suara, sintesis karakter, infrastruktur, dan regenerasi. Waktu pengeditan dan frekuensi panggilan ulang sering kali menentukan biaya produksi yang sebenarnya.
Harga API tidak sama dengan biaya lokal. Checkpoint terbuka memang menghilangkan penagihan per karakter oleh penyedia layanan, tetapi hal ini menambah biaya terkait waktu penggunaan GPU, rekayasa penerapan, pemantauan, penyimpanan, penskalaan, dan penanganan insiden. Penggunaan self-hosting menjadi pilihan yang lebih menguntungkan jika kontrol, volume, lokalisasi data, atau penyesuaian khusus membenarkan beban operasional tersebut.
Alternatif dan rute audio GlobalGPT
Qwen3-TTS tidak selalu menjadi pilihan terbaik untuk setiap proyek audio. ElevenLabs adalah platform suara terkelola yang lebih matang bagi tim yang mengutamakan dasbor yang rapi, perangkat produksi yang lengkap, dan kebutuhan infrastruktur yang lebih sedikit. Model ucapan OpenAI mungkin cocok bagi pengembang yang sudah mengadopsi satu ekosistem API sebagai standar. Qwen-Audio 3.0 TTS adalah opsi Qwen berbasis hosting yang lebih baru yang perlu dipertimbangkan saat mengikuti rekomendasi terkini dari Alibaba Cloud.
Kebutuhan akan musik dan efek suara harus dievaluasi secara terpisah. Hal ini Perbandingan audio ElevenLabs, Lyria 3 Pro, dan Mureka Hal ini membantu membedakan alat penghasil suara bicara dari sistem pembuat musik secara utuh. Sebuah model teks-ke-suara tidak seharusnya dinilai kurang hanya karena gagal menghasilkan lagu yang sudah diproduksi secara profesional, dan sebuah model musik tidak seharusnya dipilih sebagai API narasi dengan latensi rendah.
GlobalGPT saat ini memiliki akun yang terverifikasi jalur generator audio yang mencantumkan qwen-audio-3.0-tts-flash dan Seed Audio 1.0. Halaman yang diperiksa tidak mencantumkan Qwen3-TTS. Hal itu menjadikan GlobalGPT sebagai ruang kerja audio terpisah yang praktis, bukan bukti bahwa titik pemeriksaan Qwen3-TTS yang terbuka tersedia di sana.
Jika hasil akhir Anda berupa video, tentukan apakah Anda memerlukan narator terpisah, dialog yang dihasilkan secara otomatis, efek suara, atau model yang menghasilkan suara bersamaan dengan visualnya. Jawaban kami atas apakah Veo 3.1 memiliki suara mendukung keputusan yang lebih luas tersebut. Pendekatan paling cerdas seringkali adalah menggunakan sejumlah kecil alat khusus, bukan memaksakan satu model untuk menangani setiap tugas audio.
Lisensi, persetujuan, privasi, dan penggunaan komersial
Repositori Qwen3-TTS dan kartu model yang telah dirilis menggunakan lisensi Apache-2.0. Lisensi ini mendukung pengembangan, modifikasi, dan distribusi komersial, namun tidak memberikan hak atas suara, penampilan, naskah, merek dagang, atau data pribadi milik pihak lain. Lisensi model dan hak atas konten merupakan dua hal yang terpisah.
Inferensi lokal memberi Anda kendali yang lebih besar serta tanggung jawab keamanan yang lebih besar. Enkripsi rekaman referensi, batasi akses, minimalkan masa penyimpanan, dokumentasikan hasil turunan, dan terapkan penghapusan ke suara yang terdaftar serta hasil yang tersimpan dalam cache.
Untuk sintesis berbasis layanan, periksa ketentuan layanan, kebijakan penanganan data regional, masa penyimpanan, dan kontrol perusahaan sebelum mengirimkan skrip rahasia atau sampel suara.
Setiap suara kloning yang ditujukan untuk publik harus memiliki pemilik, catatan persetujuan, kebijakan penggunaan yang diizinkan, dan prosedur penanggulangan penyalahgunaan. Tambahkan pernyataan pengungkapan apabila suara sintetis tersebut secara wajar dapat disalahartikan sebagai suara orang sungguhan. Cegah peniruan identitas individu biasa dan tokoh publik berisiko tinggi, serta sediakan sarana untuk melaporkan konten audio yang merugikan.
Siapa yang sebaiknya menggunakan Qwen3-TTS?
Rute mana yang cocok?
Tahan pipa, memori yang lebih padat, Base atau CustomVoice.
VoiceDesign atau perbandingan kualitas dan kapasitas dengan sisa kapasitas GPU.
Operasi yang lebih cepat jika wilayah, kebijakan privasi, dan harga sesuai.
Studio tanpa pengaturan awal, pasar berlisensi, atau dukungan dari vendor yang sudah ada.
Qwen3-TTS cocok untuk para peneliti, pengembang, tim game, dan kelompok lokalisasi yang membutuhkan bobot terbuka, pilihan penerapan, kloning, atau suara karakter yang dideskripsikan melalui teks.
Mulailah dengan 0,6 miliar jika Anda sedang menguji pipeline, mengelola memori yang terbatas, atau menguji apakah Base dan CustomVoice memenuhi kebutuhan produk. Mulailah dengan 1,7 miliar jika Anda memerlukan VoiceDesign atau memiliki perangkat keras yang memadai untuk membandingkan kualitas dan throughput secara tepat. Gunakan API yang dihosting jika infrastruktur menjadi kendala dan ketersediaan regional, kredensial, serta penanganan data sesuai dengan proyek.
Pilihlah opsi lain jika Anda membutuhkan studio pengeditan yang tidak memerlukan pengaturan apa pun, pasar suara berlisensi yang luas, atau dukungan perusahaan yang sudah tersedia dari penyedia layanan lain. Jangan pernah melakukan kloning tanpa persetujuan tertulis.
Gunakan lima skrip asli, tiga pengulangan, daftar nama yang sulit, satu paragraf panjang, dan satu uji pemulihan. Ukur latensi dan biaya, lalu tanyakan kepada pendengar asli apakah hasilnya sudah siap tanpa perlu diperbaiki. Pekerjaan penyuntingan dapat membatalkan kemenangan dalam uji perbandingan.
Pertanyaan Umum (FAQ) Qwen3-TTS
Apakah Qwen3-TTS gratis?
Checkpoint Qwen3-TTS yang telah dirilis tersedia di bawah lisensi Apache-2.0, sehingga Anda dapat mengunduh dan menjalankannya tanpa biaya model per karakter. Pengoperasian mandiri tetap memerlukan biaya komputasi, penyimpanan, pengembangan, dan pemantauan. API Qwen3-TTS yang dihosting oleh Alibaba Cloud merupakan layanan berbayar dengan harga dan kuota yang bervariasi sesuai wilayah.
Apakah Qwen3-TTS dapat digunakan untuk keperluan komersial?
Lisensi Apache-2.0 mengizinkan penggunaan komersial atas kode dan bobot model yang telah dirilis, namun lisensi ini tidak memberikan hak kepada Anda untuk meniru suara seseorang atau menggunakan skrip dan merek yang dilindungi hak cipta. Proyek komersial tetap memerlukan persetujuan pembicara, hak atas konten, pengaturan privasi, serta kepatuhan terhadap undang-undang setempat dan ketentuan platform.
Bahasa apa saja yang didukung oleh Qwen3-TTS?
Rilis terbuka Qwen3-TTS mendukung bahasa Mandarin, Inggris, Jepang, Korea, Jerman, Prancis, Rusia, Portugis, Spanyol, dan Italia. Cakupan bahasa pada model yang di-hosting dapat bervariasi tergantung pada endpoint dan suara yang digunakan, jadi pastikan untuk memeriksa ID model Alibaba Cloud dan wilayah yang tepat sebelum mengembangkan produk multibahasa.
Apakah Qwen3-TTS benar-benar mampu mencapai latensi 97 ms?
Qwen melaporkan latensi paket pertama sebesar 97 ms untuk model 0.6B 12Hz pada tingkat koncurrency 1 dalam lingkungan vLLM internal yang telah dioptimalkan. Ini merupakan tolok ukur resmi dari vendor, bukan jaminan kinerja universal untuk perangkat. Proses cold start, perangkat keras, presisi, transit jaringan, antrian, dan penyimpanan sementara klien dapat meningkatkan latensi yang teramati.
Berapa besar VRAM yang dibutuhkan oleh Qwen3-TTS?
Tidak ada angka VRAM yang pasti dan dapat diandalkan untuk setiap konfigurasi. Ukuran model, presisi, backend perhatian, ukuran batch, cache, panjang referensi, dan beban tambahan kerangka kerja—semuanya berperan penting. Kartu grafis MX450 2 GB yang diuji tidak cocok untuk pengujian benchmark yang representatif; uji titik pemeriksaan yang dipilih dengan tingkat koncurrency yang mirip dengan kondisi produksi dan sisakan ruang cadangan operasional.
Berapa banyak rekaman audio yang dibutuhkan untuk kloning suara Qwen3-TTS?
Contoh materi menunjukkan proses kloning yang cepat, mulai dari sekitar tiga detik, sementara panduan pendaftaran yang disediakan lebih mengutamakan ucapan yang jelas dan berkelanjutan serta memungkinkan penggunaan sampel yang lebih panjang. Anggaplah tiga detik sebagai batas kemampuan minimum, bukan target kualitas otomatis. Gunakan rekaman audio yang telah mendapat persetujuan dan bebas dari gangguan, yang mencakup rentang suara normal pembicara serta bahasa yang dimaksud.
Berapa batas masukan API Qwen3-TTS?
Dokumentasi API Qwen-TTS saat ini mencantumkan batas maksimum input sebesar 512 token untuk model Qwen-TTS. URL audio lengkap berlaku selama 24 jam. Pisahkan skrip yang panjang berdasarkan batas-batas semantik dan salin hasil yang diperlukan ke penyimpanan permanen, alih-alih menganggap URL yang dikembalikan sebagai layanan hosting permanen.
Apakah saya bisa menggunakan Qwen3-TTS pada GlobalGPT?
Generator audio GlobalGPT yang telah dicentang tersebut tercantum qwen-audio-3.0-tts-flash dan Seed Audio 1.0, bukan Qwen3-TTS. Anda dapat menggunakan jalur tersebut sebagai alur kerja audio terpisah, tetapi hal itu tidak boleh dijelaskan sebagai akses ke titik pemeriksaan Qwen3-TTS versi 0.6B atau 1.7B yang terbuka.
Keputusan akhir
Ulasan mengenai Qwen3-TTS ini menyoroti cakupan yang luar biasa: titik pemeriksaan terbuka 0,6B dan 1,7B, sepuluh bahasa, suara bawaan, kloning cepat, VoiceDesign, arsitektur streaming, lisensi yang fleksibel, serta API yang dihosting.
Keterbatasan yang jujur ini sama pentingnya. Audio Qwen3-TTS yang sebenarnya tidak dihasilkan dalam lingkungan tugas yang tersedia, dan GPU berkapasitas 2 GB yang diuji tidak mampu mendukung perbandingan lokal yang representatif. Oleh karena itu, artikel ini tidak memberikan skor kualitas suara maupun mengklaim kinerja universal sebesar 97 ms.
Jika Anda mengutamakan fleksibilitas dan kontrol, uji terlebih dahulu checkpoint 0.6B, lalu bandingkan dengan 1.7B menggunakan skrip dan perangkat keras yang sama. Jika Anda mengutamakan kecepatan dalam implementasi produksi, uji rute Alibaba Cloud yang tepat yang Anda rencanakan untuk dibeli dan bandingkan dengan keluarga TTS Qwen-Audio 3.0 yang diposisikan secara terpisah. Cantumkan nama model, titik akhir, wilayah, catatan persetujuan, latensi, dan total biaya pengeditan dalam lembar keputusan yang sama.
Qwen3-TTS layak dicoba. Tidak ada gunanya berpura-pura bahwa dokumentasi saja sudah cukup untuk mewakili suara Anda. Pilihan yang tepat adalah yang mampu bertahan melewati berbagai nama, bahasa, perangkat keras, persyaratan privasi, dan tenggat waktu produksi Anda.