
Ulasan Claude Opus 5.5: Harga, Uji Kinerja, dan Uji API Nyata
Claude Opus 5.5 menggabungkan jendela konteks 1 juta token dengan tarif API sebesar $4 / $20 per juta token. Ulasan ini memisahkan klaim yang dipublikasikan oleh Anthropic, cuplikan benchmark independen, dan lima eksekusi tugas langsung melalui rute Messages API.
Hasil pengukuran tersebut bersifat spesifik. Tiga tugas menghasilkan jawaban yang jelas dan dapat digunakan; tugas pemrograman menghasilkan jawaban yang bermanfaat namun mencapai batas maksimum 1.024 token; proses penulisan dalam bahasa Mandarin menghasilkan teks yang kacau pada rute yang diuji. Contoh ini menunjukkan perilaku konkret dan batasan rute, bukan tingkat keberhasilan yang universal.
Jawaban singkat
- Kinerja: Anthropic melaporkan kinerja setara Fable 5.1 pada sebagian besar tugas, sementara Analisis Buatan mencatat skor Indeks Kecerdasan sebesar 58 saat berusaha semaksimal mungkin. Bukti kemampuan penilaian METR yang lebih terbatas tidak menunjukkan peningkatan yang signifikan dibandingkan dengan Fable 5.1.
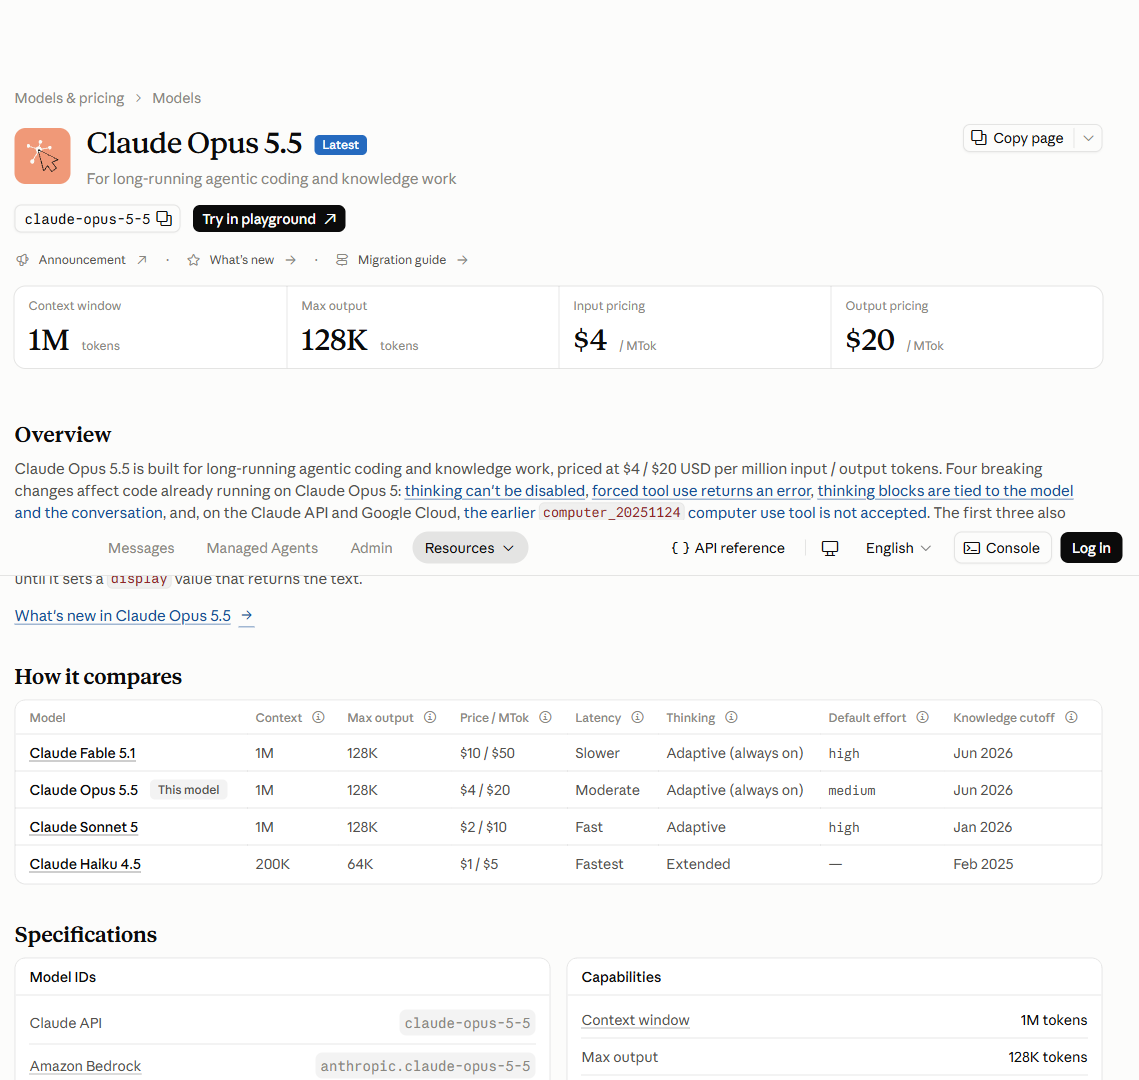
- Harga: kurs resmi API adalah $4 per juta token masukan dan $20 per juta token keluaran. Biaya pembacaan cache sebesar $0,20 per juta; biaya penulisan cache selama 5 menit sebesar $5 per juta.
- Hasil praktik langsung: Ekstraksi teks panjang, JSON ketat, dan penalaran aritmatika berhasil dilalui dalam uji coba yang terekam. Pemrograman terbukti bermanfaat, namun terhenti pada batas atas awal. Hasil untuk bahasa Mandarin dicatat sebagai masalah rute/pengkodean, bukan penilaian bahasa pada tingkat model.
- Peringatan API: Fungsi berpikir tidak dapat dinonaktifkan, upaya memaksa penggunaan alat akan menimbulkan kesalahan, blok berpikir terikat pada model dan percakapan, dan versi yang lebih lama
komputer_20251124Alat ini tidak didukung pada API Claude dan jalur Google Cloud.

Apa yang disebutkan dalam dokumen resmi
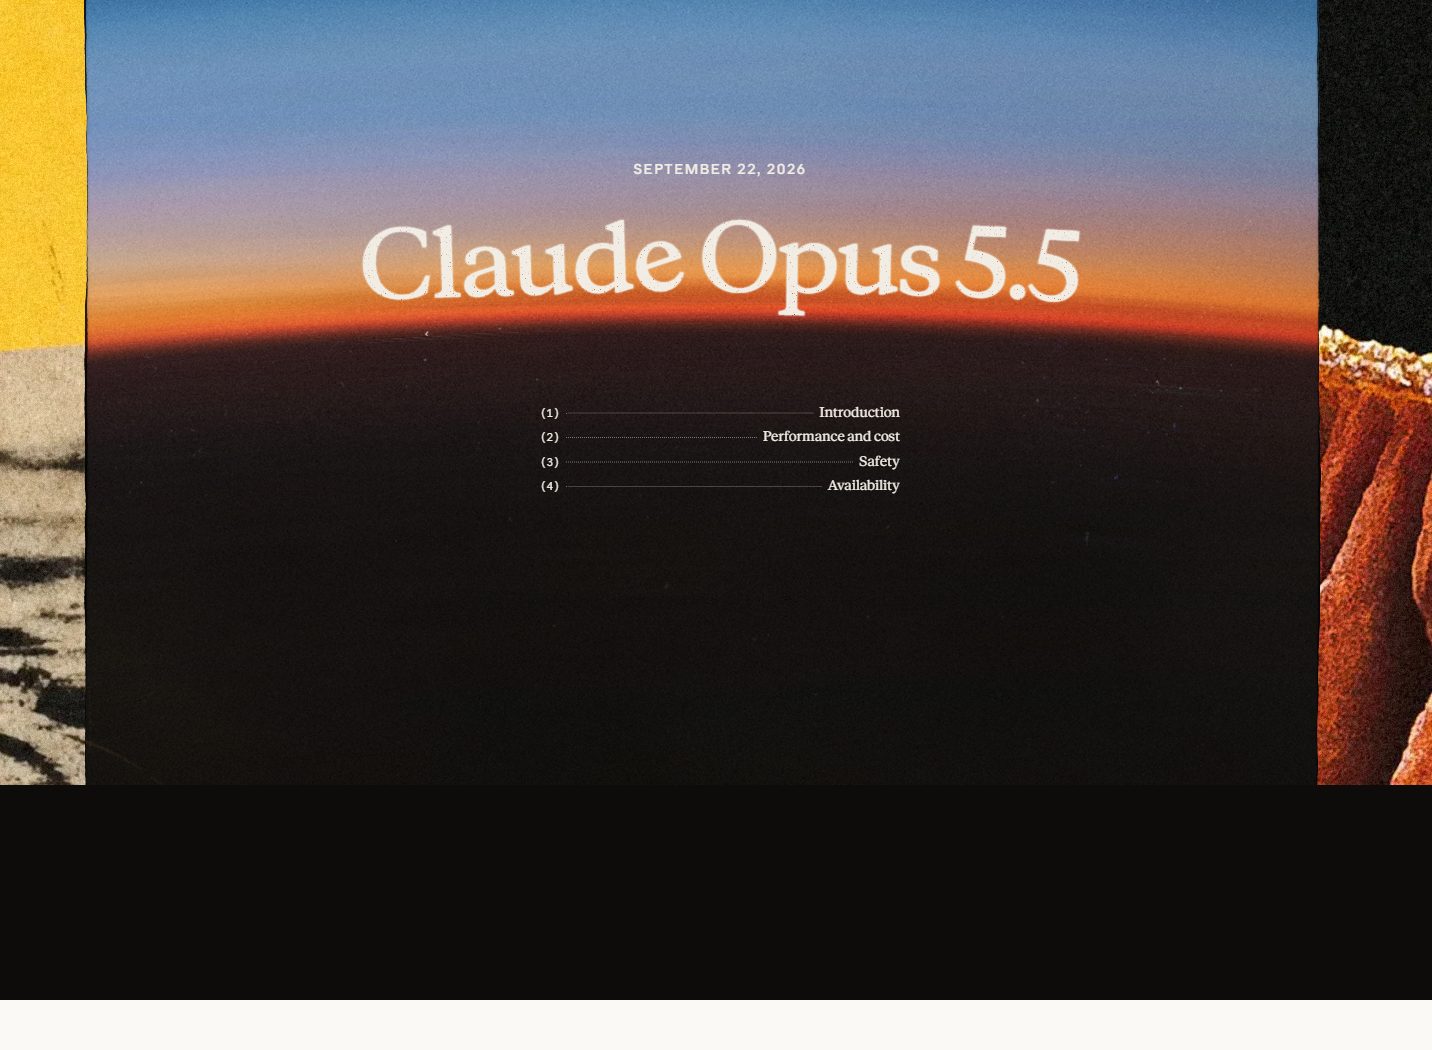
Halaman rilis Anthropic menyebutkan bahwa Claude Opus 5.5 akan diluncurkan pada 22 September 2026 dan menggambarkannya sebagai model pertama dalam keluarga Claude 5.5. Pengumuman tersebut mengklaim kinerja setara dengan Claude Fable 5.1 pada sebagian besar pekerjaan, biaya beban kerja tipikal yang lebih rendah sebesar 40% dibandingkan Opus 5, serta kecepatan output lebih dari 30% lebih cepat daripada Opus 5. Hal-hal tersebut merupakan klaim dari penyedia, sehingga disajikan secara terpisah dari bukti independen dan hasil uji langsung yang tercantum di bawah ini.
The Dokumentasi Platform Claude cantumkan ID model API sebagai claude-opus-5-5, jendela konteks sebesar 1 juta token, batas keluaran maksimum 128 ribu, dan fitur pemikiran adaptif yang selalu aktif. Dokumen tersebut juga mencantumkan perubahan-perubahan yang memengaruhi integrasi Opus 5 yang sudah ada, yang dibahas dalam bagian migrasi di bawah ini.
Bukti kinerja
Tidak ada satu angka “kinerja” pun di sini. Ketiga sumber publik tersebut mengukur hal-hal yang berbeda, sehingga setiap kartu tetap menampilkan metrik dan batasan bukti masing-masing secara jelas.
Pengumuman Anthropic
Sinyal yang dipublikasikan: Anthropic menyatakan bahwa Opus 5.5 memiliki kinerja setara dengan Claude Fable 5.1 pada sebagian besar pekerjaan, biayanya 40% lebih murah daripada Opus 5 pada beban kerja umum, dan menghasilkan keluaran lebih dari 30% lebih cepat.
Batas: Contoh penempatan dan penguji yang dipublikasikan oleh penyedia, bukan uji kinerja independen.
Analisis Buatan
Sinyal yang dipublikasikan: Laporan snapshot dengan upaya maksimal menunjukkan skor 59,61 TP40T pada Terminal-Bench 4.0, 61,41 TP40T pada Humanity’s Last Exam, dan 66,91 TP40T pada SciCode.
Batas: Skor bergantung pada upaya, harness, tanggal, dan definisi metrik. Skor tersebut tidak dapat memprediksi setiap prompt API.
Evaluasi prapenempatan METR
Sinyal yang dipublikasikan: METR menyatakan bahwa bukti yang dimilikinya tidak menunjukkan peningkatan yang signifikan dibandingkan dengan Fable 5.1 dalam hal kemampuan penilaian yang diteliti, meskipun pihak METR tetap mengharapkan percepatan yang berarti dalam beberapa pekerjaan penelitian dan pengembangan.
Batas: Ini merupakan penilaian yang lebih terfokus pada pengambilan keputusan dan percepatan pelaksanaan tugas, bukan peringkat kualitas yang menyeluruh.
Jika dibaca secara keseluruhan, data-data tersebut mendukung kesimpulan yang terbatas: Opus 5.5 merupakan model terdepan berdasarkan beberapa evaluasi publik yang sudah usang, namun besarnya keunggulan tersebut bervariasi tergantung pada tugas, tingkat kesulitan, dan desain evaluasi. Data-data tersebut tidak menunjukkan hasil yang secara universal dapat disebut sebagai “model terbaik”.
Claude Opus 5.5: Satuan harga dan penagihan
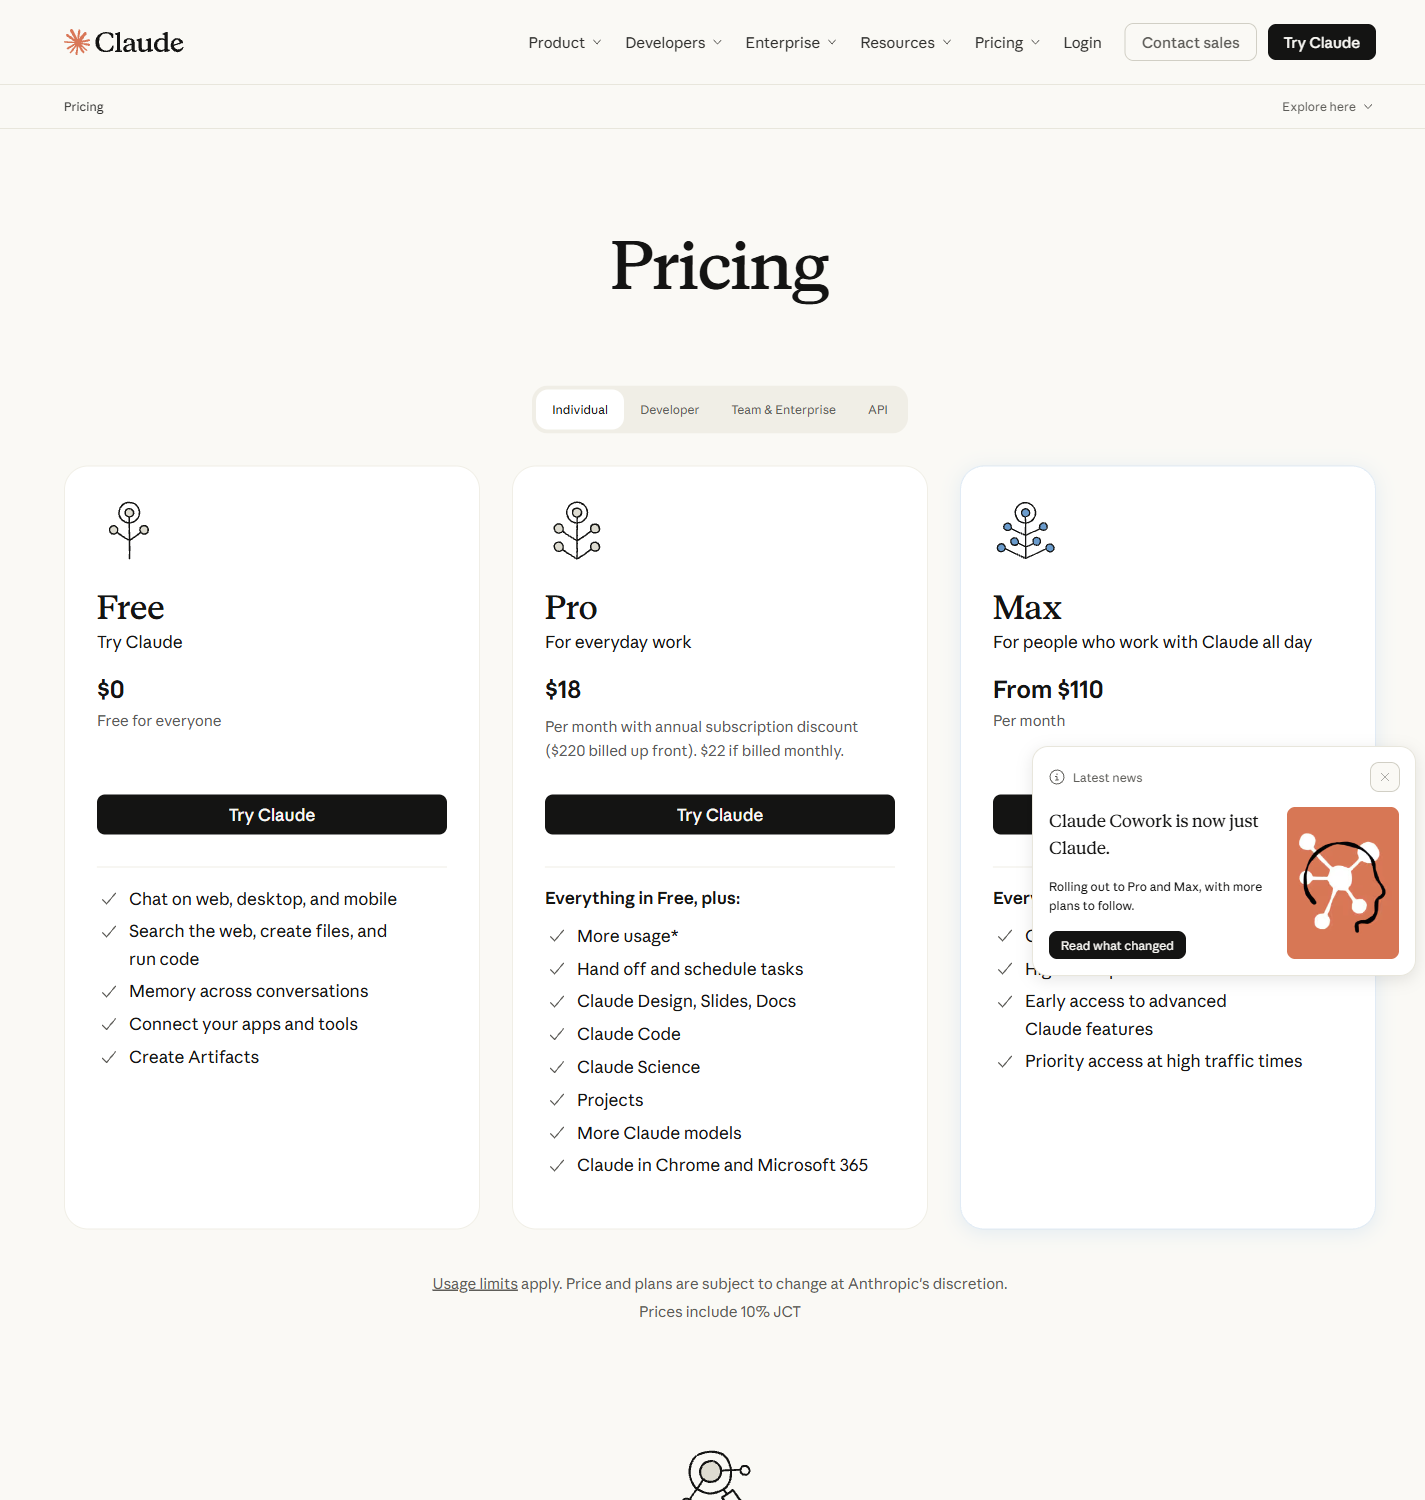
Harga API dan harga langganan konsumen merupakan produk yang berbeda. Angka-angka API di bawah ini adalah harga satuan yang digunakan untuk penganggaran token; sedangkan angka-angka konsumen adalah kartu paket yang terlihat di area browser yang ditangkap.
Harga API resmi
Perkiraan sederhana: 10.000 token masukan ditambah 2.000 token keluaran setara dengan sekitar $0,08 berdasarkan tarif standar, sebelum diperhitungkan biaya cache, batch, pajak, atau mark-up platform.
Tangkapan layar paket konsumen
Halaman yang ditangkap juga menampilkan catatan 10% JCT. Nilai-nilai yang ditampilkan ini bersifat regional, bukan jaminan harga global.
Untuk penjelasan terpisah mengenai penagihan token dan biaya jendela konteks, lihat Panduan Harga dan Konteks GPT-5.5. Biaya API penyedia layanan, biaya langganan, dan saldo kredit platform multi-model apa pun harus tetap dicantumkan secara terpisah dalam anggaran Anda.
Uji coba langsung: lima kartu hasil tugas
Kami mengirimkan lima perintah independen melalui rute API Pesan yang sama dan terkendali pada tanggal 23 September 2026 dengan ID model claude-opus-5-5. Tahap pertama yang digunakan max_tokens: 1024. Kami mencatat waktu yang dihabiskan secara lokal, jumlah token masukan/keluaran, alasan penghentian, keakuratan, dan kepatuhan terhadap format literal. Tugas penulisan bahasa Mandarin dijalankan kembali dengan batas maksimal 4.096 token setelah putaran pertama mengungkap masalah pada keluaran rute tersebut. Ini merupakan sampel yang terdiri dari lima tugas, bukan perkiraan reliabilitas.
Apakah sistem ini dapat memperbaiki fungsi deduplikasi tipe campuran?
Pengaturan tugas
Temukan bug dalam kode Python dedupe fungsi, menangani nilai-nilai non-string dan yang tidak dapat di-hash, mempertahankan ejaan pertama, serta menyediakan uji coba.
Tanggapan tersebut mengidentifikasi .lower() gagal pada nilai non-string, lalu mengganti string menjadi casefold(), menambahkan opsi cadangan yang tidak dapat di-hash, dan mengirimkan kembali kode yang telah diperbaiki beserta kasus uji.
Jawaban tersebut terhenti pada batas maksimal 1.024 token. Solusi tersebut memang berguna, tetapi konfigurasinya terlalu kecil untuk melakukan tinjauan kode secara menyeluruh.
Kesimpulan mengenai kartu: Jawaban yang berguna secara teknis telah diperoleh; eksekusi ini tidak dapat mendukung klaim mengenai latensi atau kelengkapan karena batas atas token telah memotong hasilnya.
Apakah sistem ini mampu mempertahankan fakta dan menguji batasan-batasan?
Pengaturan tugas
Sebutkan lima temuan yang diberi nomor dari sebuah memo evaluasi singkat, termasuk metode yang digunakan dan hal-hal yang tidak diukur pada putaran berikutnya.
Hasilnya mencakup tepat lima poin bernomor. Laporan tersebut tetap mempertahankan perbandingan asisten, metode 20 pertanyaan, serta celah-celah terkait retensi jangka panjang dan konversi pelanggan.
Ini adalah paket sumber yang singkat, sehingga tidak menguji jendela konteks 1M.
Kesimpulan mengenai kartu: ekstraksi yang bersih dengan jumlah yang diminta serta batas bukti dari memo sumber tetap dipertahankan.
Apakah fungsi tersebut dapat menghasilkan keluaran yang dapat dibaca mesin tanpa perlu dibersihkan terlebih dahulu?
Pengaturan tugas
Kembalikan objek JSON tetap yang berisi judul, target audiens, dua kelebihan, dua kekurangan, dan kesimpulan. Penggunaan pagar Markdown tidak diperbolehkan.
Mengembalikan JSON yang dapat diparsing dengan kunci-kunci yang diminta, dua kelebihan, dua kekurangan, dan rekomendasi yang ringkas. Tidak terdapat pembungkus Markdown.
Satu respons yang valid tidak membuktikan keandalan skema pada objek yang lebih besar atau bersarang.
Kesimpulan mengenai kartu: Kepatuhan terhadap format JSON literal telah terpenuhi pada eksekusi kali ini.
Apakah sistem ini dapat menerapkan aturan pembulatan berulang dengan benar?
Pengaturan tugas
Mulailah dengan 12 item, kalikan setiap kelompok berikutnya dengan 1,25, bulatkan ke bawah setelah setiap kelompok, dan laporkan jumlah total dari keempat kelompok tersebut.
Mengembalikan angka 12, 15, 18, dan 22, lalu menjumlahkannya menjadi 67. Operasi aritmatika tingkat menengah itu terlihat jelas.
Tugas ini bersifat deterministik dan sederhana; tugas ini tidak mencerminkan kemampuan penalaran yang luas.
Kesimpulan mengenai kartu: hasil yang benar dan langkah-langkah perantara yang transparan.
Apakah rute yang diuji menghasilkan teks bahasa Mandarin yang dapat digunakan?
Pengaturan tugas
Buatlah draf pembuka ulasan dalam bahasa Mandarin yang memisahkan klaim resmi, harga, bukti acuan, dan pengujian langsung.
Struktur respons memang ada, tetapi karakter Tionghoa yang ditampilkan dalam hasil yang disimpan tampak kacau melalui jalur yang diuji.
Bukti tersebut tidak membedakan kualitas bahasa model dari rute atau perilaku pengkodean. Tidak ada skor kualitas bahasa Mandarin yang diberikan.
Kesimpulan mengenai kartu: Teks yang dikembalikan pada rute ini tidak dapat digunakan; jalankan kembali dengan jalur UTF-8 yang telah diverifikasi sebelum membuat klaim mengenai kualitas bahasa.
Pada keempat uji coba yang netral bahasa atau menggunakan bahasa Inggris, rata-rata lokalnya adalah 6,24 detik. Angka tersebut menggambarkan lima permintaan berurutan pada satu rute dan bukan merupakan latensi di sisi penyedia layanan. Perilaku yang paling menonjol yang diamati adalah ekstraksi yang ringkas, kepatuhan terhadap format JSON yang literal, dan perhitungan aritmatika yang benar; dua masalah yang belum terselesaikan adalah tekanan anggaran keluaran pada proses pengkodean dan keluaran bahasa Mandarin yang kacau pada rute yang diuji.
Hal-hal yang perlu diperhatikan terkait API dan migrasi
Jawaban singkatnya mencakup hal-hal tersebut karena hal-hal itu dapat mengubah hasil integrasi meskipun kualitas teks modelnya tampak baik.
- Pikiran selalu aktif. Gunakan parameter upaya yang telah didokumentasikan untuk mengontrol kedalaman, latensi, dan biaya; tidak ada tombol matikan.
- Penggunaan alat secara paksa menghasilkan kesalahan. Kode yang sudah ada yang mengharuskan pemilihan alat secara paksa memerlukan pengujian migrasi tersendiri.
- Blok pemikiran pasti terkait dengan model dan percakapan. Jangan berasumsi bahwa blok pemikiran dapat digunakan kembali setelah model diubah.
komputer_20251124tidak diterima tentang API Claude dan jalur Google Cloud yang tercantum dalam dokumentasi.- Batas atas produksi itu penting. Kartu kode tersebut menunjukkan bahwa respons yang bermanfaat tetap bisa terputus oleh hal kecil
max_tokennilai. - Mode batch dan mode cepat merupakan jalur penagihan yang terpisah. Pisahkan diskon atau biaya tambahan mereka dari harga token standar.
Putusan yang didasarkan pada bukti
Claude Opus 5.5 memiliki bukti tolok ukur publik yang kuat dan sudah usang, serta tingkat API standar yang dipublikasikan lebih rendah daripada angka-angka Opus 5 yang ditampilkan dalam pengumuman Anthropic. Dalam lima kali eksekusi tugas yang tercatat, sistem ini menghasilkan ekstraksi data yang bersih, format JSON yang ketat, dan perhitungan aritmatika; jawaban kode yang dihasilkan berguna namun terpotong oleh batas atas awal; dan keluaran dalam bahasa Mandarin tidak dapat digunakan melalui rute yang diuji.
Oleh karena itu, kesimpulan yang dapat dipertanggungjawabkan ini bersifat terbatas: model tersebut menunjukkan kemampuan mengikuti instruksi yang baik pada beberapa tugas kecil, sementara rute dan konfigurasi yang digunakan menunjukkan batasan yang jelas. Setiap keputusan migrasi harus mengulangi prompt yang sama dengan anggaran keluaran yang sesuai, memverifikasi pemanggilan alat, serta memisahkan tarif token resmi dari kredit langganan atau platform.
Jika Anda ingin rute kedua sebagai perbandingan, maka Perbandingan DeepSeek V4 Pro vs Format Uji Flash menunjukkan bagaimana kesimpulan pada tingkat tugas dapat dipisahkan dari klaim yang mencakup seluruh model. Hal ini Panduan Kasus Penggunaan GPT-5.5 menambahkan titik acuan yang berorientasi pada tugas, sementara Catatan pengujian kinerja Flash Gemini dan Panduan perbandingan model AI menyediakan konteks model terdekat. Untuk akses multi-model, lihat langganan AI serba-dapat dan Perbandingan platform multi-model.
Pertanyaan yang Sering Diajukan
Berapa harga Claude Opus 5.5?
Tarif API resmi adalah $4 per juta token masukan dan $20 per juta token keluaran. Pembacaan cache sebesar $0,20 per juta token, sedangkan penulisan cache setiap 5 menit sebesar $5 per juta token.
Apa itu jendela konteks Claude Opus 5.5?
Dokumen Platform Claude mencantumkan jendela konteks sebesar 1 juta token dan keluaran maksimum sebesar 128 ribu token. Jalur beta terpisah yang didokumentasikan mendukung keluaran hingga 300 ribu token untuk Message Batches.
Apakah Claude Opus 5.5 lebih baik daripada Opus 5?
Anthropic melaporkan biaya beban kerja tipikal yang lebih rendah dan hasil yang lebih cepat, sementara evaluasi independen menunjukkan hasil yang memuaskan pada beberapa tugas lama. Besarnya peningkatan kualitas bergantung pada tolok ukur, pengaturan upaya, prompt, dan rute.
Apakah kemampuan berpikir bisa dimatikan?
Tidak. Dokumentasi model saat ini menyebutkan bahwa pemikiran adaptif selalu aktif. Gunakan parameter effort untuk mengontrol kedalaman pemikiran, latensi, dan biaya.
Apakah kelima tugas API tersebut telah membuktikan keandalannya?
Tidak. Kartu-kartu tersebut menunjukkan batasan perilaku dan konfigurasi yang konkret, tetapi lima tugas tersebut tidak cukup untuk memperkirakan tingkat keberhasilan secara umum. Masalah batas kemampuan pengkodean dan masalah rute Tiongkok dilaporkan secara terpisah.
Apakah ulasan ini membuktikan kualitas produk Tiongkok?
Tidak. Rute yang diuji menghasilkan teks bahasa Mandarin yang kacau, sehingga hasilnya dicatat sebagai masalah pengkodean atau rute, sambil menunggu pengujian ulang dengan UTF-8 yang telah diverifikasi.









