Revue fondée sur des données probantes · août 2026
Les poids ouverts, les API hébergées et le fossé en matière de nommage : une présentation claire.
Limite de preuve : Aucun résultat d'écoute direct du Qwen3-TTS n'est avancé.
Pour être utile, une analyse du service Qwen3-TTS doit répondre à une question fondamentale avant d’évaluer les voix : de quel service Qwen3-TTS s’agit-il exactement ? En 2026, ce nom désigne à la fois les checkpoints téléchargeables de 0,6B et 1,7B, les API Qwen3-TTS hébergées sur Alibaba Cloud, ainsi qu’un marché où la gamme distincte Qwen-Audio 3.0 TTS est également recommandée. Considérer ces produits comme un tout unique conduit à des affirmations trompeuses concernant la vitesse, les langues prises en charge et les tarifs.
En bref, Qwen3-TTS est l’une des piles vocales ouvertes les plus flexibles de 2026. Elle propose dix langues, des points de contrôle spécifiques à chaque tâche, un clonage vocal en environ trois secondes, la conception vocale en langage naturel, la prise en charge du streaming et une licence Apache 2.0. Cependant, cette analyse ne fournit pas de note d'écoute : l'environnement de test disponible ne mettait pas à disposition de véritable point de terminaison Qwen3-TTS, et le GPU local de 2 Go n'était pas adapté à un benchmark représentatif comparant les versions 0,6B et 1,7B.
Situation du projet Qwen3-TTS en 2026
Qwen a publié les coefficients de pondération Qwen3-TTS le 22 janvier 2026. Le dépôt officiel Qwen3-TTS énumère cinq versions de checkpoints 12Hz déjà publiées : 1,7 milliard pour VoiceDesign, 1,7 milliard pour CustomVoice, 1,7 milliard pour Base, 0,6 milliard pour CustomVoice et 0,6 milliard pour Base. Les correspondances Collection Hugging Face comprend également le tokeniseur. Il s'agit des modèles que les développeurs peuvent consulter, télécharger et exécuter conformément à la licence publiée.
Alibaba Cloud propose par ailleurs les gammes de services hébergés Qwen3-TTS Flash, Instruct, de clonage vocal et de conception vocale via des interfaces en temps réel et en différé. Son offre actuelle catalogue de modèles de synthèse vocale doit être considérée comme la source de référence pour les alias hébergés, les régions, les langues et les interfaces, car ces informations peuvent évoluer sans que les noms des points de contrôle ouverts ne changent.
Il y a un autre détail à prendre en compte concernant la nomenclature. Les recommandations d’Alibaba Cloud pour la sélection des modèles en 2026 orientent également les utilisateurs vers le modèle Qwen-Audio 3.0 TTS pour plusieurs tâches hébergées. Le modèle Qwen-Audio 3.0 TTS n’est pas une version renommée des points de contrôle 0.6B ou 1.7B de la gamme Qwen3-TTS. Si vous suivez déjà l’évolution de la famille Qwen au sens large, notre Qwen 3.8 : caractéristiques techniques maximales et analyse de l'accessibilité montre pourquoi il est important de mentionner le nom exact du modèle pour l'ensemble des produits Qwen.
Utilisez le nom du point de contrôle ouvert pour l'inférence locale, l'identifiant exact du modèle Alibaba Cloud pour les fonctionnalités via l'API, et Qwen-Audio 3.0 TTS uniquement comme alternative distincte. Cela permet de garantir que toutes les caractéristiques relatives à la qualité, à la latence et au prix restent associées au produit à l'origine de celles-ci.
Verdict rapide : puissant, ouvert et sensible aux données
Avis rapide
Déploiement ouvert, recherche, clonage et voix des personnages.
Cinq points de contrôle spécifiques à chaque tâche, répartis sur deux tailles.
La rapidité du fournisseur dépend de l'environnement ; la qualité n'est pas évaluée ici.
Les services hébergés Qwen3-TTS et Qwen-Audio 3.0 constituent des itinéraires distincts.
La solution Qwen3-TTS est particulièrement intéressante pour les équipes qui souhaitent disposer d’un contrôle total et d’une grande flexibilité de déploiement. Les points de contrôle Base prennent en charge le clonage, CustomVoice propose des haut-parleurs prédéfinis avec des noms et des commandes d’instructions, et VoiceDesign permet de créer une voix à partir d’une description écrite. La prise en charge de dix langues rend cette pile bien plus utile qu’une démo ouverte disponible uniquement en anglais, tandis que les versions 0.6B offrent aux développeurs un point de départ plus léger.
La principale mise en garde concerne la qualité des données. Qwen fait état de très bons résultats aux tests de performance et d’une faible latence du premier paquet dans un environnement interne optimisé. Ces chiffres ne tiennent pas compte des démarrages à froid des ordinateurs portables, de la marge disponible en VRAM des conteneurs, ni de la prononciation des noms de vos produits. Les promesses universelles de 97 ms omettent de préciser les conditions des tests de performance.
Pour un prototype auto-hébergé, Qwen3-TTS figure parmi les meilleures options. Pour une API de production, comparez la solution hébergée Qwen3-TTS avec les nouvelles recommandations Qwen-Audio, le support opérationnel, la disponibilité régionale et le coût de gestion des voix clonées. Si votre objectif va au-delà de la synthèse vocale pour inclure des effets sonores ou de la musique, la gamme plus étendue Tests de voix, d'effets sonores et de musique de Seed Audio 1.0 couvrir un flux de travail audio différent et davantage multimodal.
En résumé : Qwen3-TTS affiche d'excellentes performances en matière d'architecture, d'ouverture et de couverture des fonctionnalités. Son niveau de performance réel en production dépend toutefois du point de contrôle ou du terminal concerné, de votre matériel, de votre langage de programmation et d'une voix de référence validée, testée avec vos propres scripts.
Qu'est-ce que le Qwen3-TTS ?
Qwen3-TTS est une famille de modèles de génération de la parole s'appuyant sur un tokeniseur de parole discret fonctionnant à une cadence de 12,5 images par seconde. Selon le Rapport technique Qwen3-TTS, le système a été entraîné sur plus de cinq millions d'heures dans dix langues. Le faible nombre de tokens est au cœur de sa conception : un nombre réduit de tokens acoustiques permet de limiter le travail de décodage et de rendre la diffusion en continu plus pratique, tout en garantissant que le modèle préserve le timbre, la prononciation et la prosodie.
Trois niveaux, trois règles de preuve
0,6 milliard / 1,7 milliard
Base, CustomVoice et 1.7B VoiceDesign. À utiliser pour les requêtes sur les modèles locaux.
Flash / Instruct / VC / VD
Indiquez précisément le modèle d'API, l'interface, la région et la date.
Qwen-Audio 3.0 TTS
Une alternative hébergée actuelle, et non un « Open Checkpoint » rebaptisé.
Les cinq points de contrôle publiés correspondent à des tâches spécifiques, et non à une échelle dans laquelle chaque modèle plus grand serait capable de tout faire :
| Point de contrôle libéré | Taille | L'offre d'emploi la plus adaptée | Limite importante |
|---|---|---|---|
| Qwen3-TTS-12 Hz-0,6 B-Base | 0,6 milliard | Flux de travail de clonage et de recherche à plus petite échelle | Aucun catalogue CustomVoice prédéfini |
| Qwen3-TTS-12 Hz-1,7 B-Base | 1,7 milliard | Travaux de clonage et de poursuite à plus grande échelle | Il faut davantage de mémoire et de puissance de calcul |
| Qwen3-TTS-12 Hz-0,6 B-CustomVoice | 0,6 milliard | Voix préréglées avec commande par instructions | Utilise le kit d'enceintes commercialisé |
| Qwen3-TTS-12 Hz-1,7 B-CustomVoice | 1,7 milliard | Synthèse vocale préréglée à plus grande capacité | Ce n'est pas le point de contrôle VoiceDesign |
| Qwen3-TTS-12 Hz-1,7 B-VoiceDesign | 1,7 milliard | Création d'un timbre à partir d'une description textuelle | Pas de version 0.6B de VoiceDesign Peer disponible |
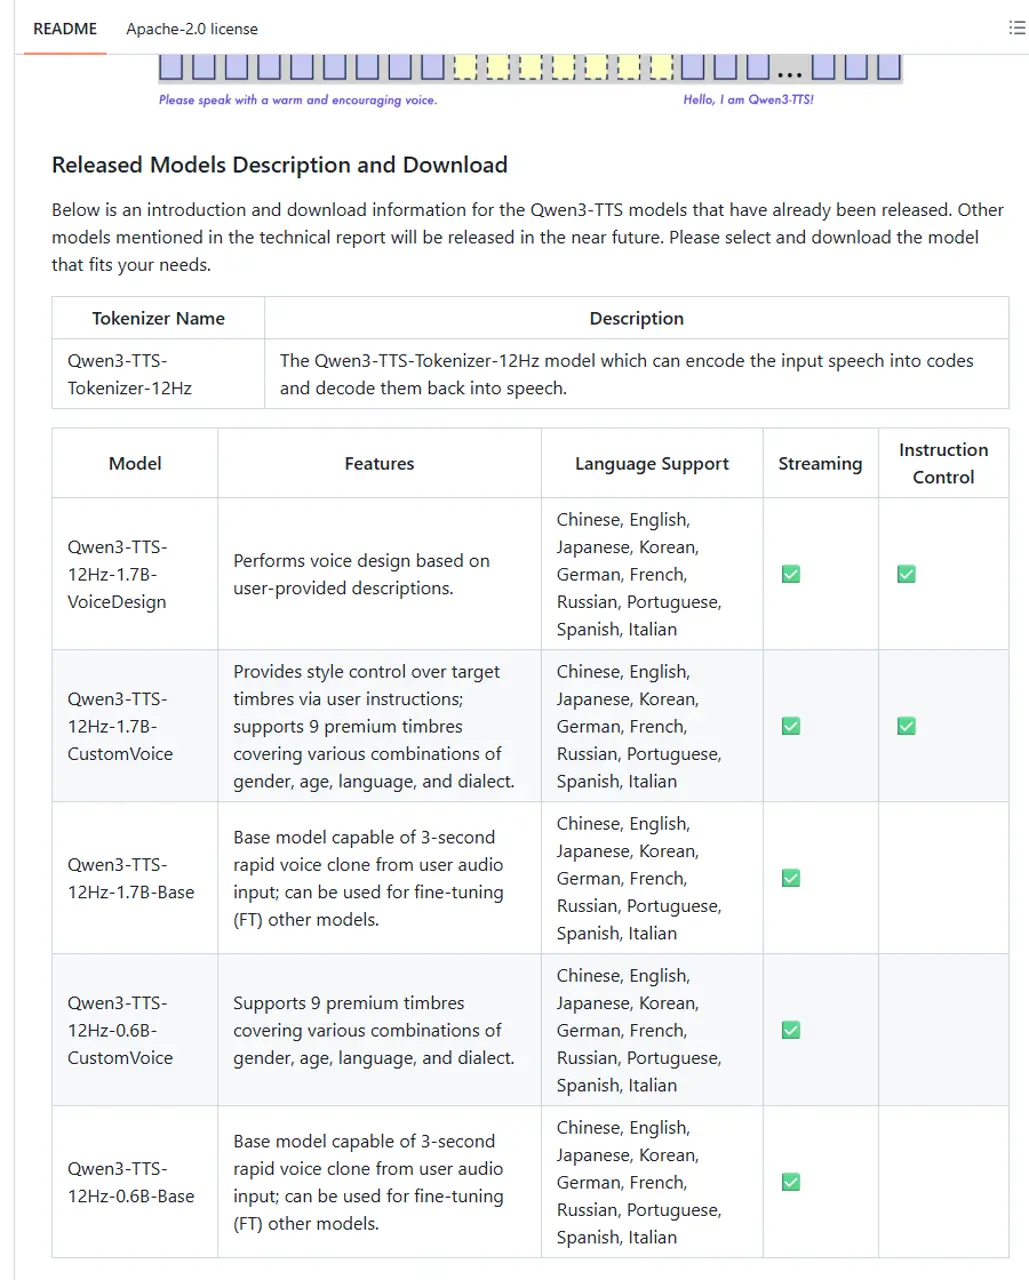
“ Base ” est la solution idéale lorsque vous disposez d’une voix de référence et que vous êtes autorisé à l’utiliser. « CustomVoice » est l’option la plus simple lorsqu’un des préréglages de timbres proposés par Qwen correspond au projet. « VoiceDesign » est destiné aux demandes de création de personnages spécifiques, telles que « un narrateur calme et mature, avec un registre grave et doux », pour lesquelles aucun enregistrement de référence n’est nécessaire.
Il n'est pas nécessaire de cloner un tutoriel de produit si un narrateur prédéfini convient, et un personnage fictif n'a pas forcément besoin de l'enregistrement d'une personne réelle si VoiceDesign parvient à lui donner une identité appropriée. Évaluez chaque tâche à l'aide du critère correspondant.
Comment ce test du Qwen3-TTS a été réalisé
Cette analyse s'appuie sur quatre niveaux de données : la documentation officielle, le rapport technique Qwen, l'inspection du matériel sur site et un test contrôlé d'un wrapper audio hébergé séparément. Les sources officielles corroborent les caractéristiques du produit et les résultats des tests de performance communiqués par le fournisseur. Le test contrôlé du wrapper ne confirme que son comportement observé, et non un score de qualité vocale Qwen3-TTS.
Liste des environnements de tâches disponibles qwen-audio-3.0-tts-flash, et non un qwen3-tts-* modèle.
Créez un enregistrement vocal en anglais parlé, d'une grande clarté. Lisez exactement : ' Au lever du soleil, l'équipe de recherche a vérifié chaque signal à deux reprises avant d'annoncer le résultat. ' Utilisez la voix d'un narrateur adulte, chaleureuse et calme, avec un rythme naturel, des consonnes bien articulées et une brève pause après ' au lever du soleil '. N’ajoutez pas de musique, d’effets sonores, d’introduction ni aucun mot ne figurant pas dans la phrase citée.Lors de notre test, cette entrée a généré un fichier MP3 d'une durée de 21,263673 secondes et a lu les instructions à voix haute. Le résultat du test a montré que le wrapper avait traité l'intégralité de la commande comme du texte vocal.
Au lever du soleil, l'équipe de recherche a vérifié deux fois chaque signal avant d'annoncer le résultat.Nous avons refait le test en utilisant uniquement la phrase cible. Dans notre essai, le résultat a donné un fichier MP3 d'une durée de 6,086531 secondes, à 22 050 Hz, 128 kbps et en mono. Il correspondait mot pour mot à la phrase cible et ne comportait aucune instruction supplémentaire.
L'utilisateur a écouté les deux fichiers et a confirmé les notes ci-dessous. Il s'agit d'un contrôle pratique effectué par un seul auditeur, et non d'une étude MOS ni d'un panel d'écoute.
| Dimension « écoute » | Commande par instruction | Contrôle du texte brut |
|---|---|---|
| Naturalité | 4/5 | 5/5 |
| Intelligibilité | 5/5 | 5/5 |
| Prononciation | 5/5 | 5/5 |
| Prosodie | 4/5 | 5/5 |
| Fidélité du texte | 1/5 | 5/5 |
| Respect des conventions stylistiques | Non noté | 5/5 |
| Absence d'artefact | 5/5 | 5/5 |
| Facilité d'utilisation en production | 1/5 | 5/5 |
L'exemple contenant des instructions semblait clair et globalement naturel, mais la lecture des instructions a nui à la fidélité du texte et à la facilité d'utilisation du système. L'exemple en texte brut semblait naturel, suivait exactement la phrase et ne nécessitait aucune correction du contenu. Ces notes ne concernent que les deux qwen-audio-3.0-tts-flash les contrôles « wrapper » ; il ne s'agit pas d'une évaluation de la qualité vocale des points de contrôle Qwen3-TTS.
Ne partez jamais du principe que les consignes stylistiques et la narration relèvent du même domaine. Notre guide sur rendre les discours rédigés par l'IA plus naturels améliore le script, mais ce sont les champs « endpoint » qui déterminent si les commandes vocales contrôlent la voix ou lancent l'enregistrement.
Une analyse locale a révélé la présence d’une carte graphique NVIDIA GeForce MX450 dotée de 2 Go de mémoire vidéo et d’environ 16,9 Go de mémoire système. Cette configuration n’est pas adaptée à la matrice prévue de 0,6B contre 1,7B. Le déchargement du processeur pourrait s’avérer être une vitesse de lancement, non représentative. La qualité vocale Qwen3-TTS, le RTF local, la similarité de clonage et la cohérence interlinguistique ne sont donc pas notés.
Qualité vocale du Qwen3-TTS : ce que les données permettent de démontrer
Le rapport officiel présente d'excellents résultats du modèle Qwen3-TTS en matière d'intelligibilité, de ressemblance avec la voix de l'orateur, de suivi des instructions, de génération multilingue, de discours de longue durée et de diffusion en continu. Il s'agit là d'indicateurs comparatifs utiles, mais il convient de noter qu'il s'agit de résultats de référence fournis par Qwen et non d'enregistrements générés dans le cadre de cette étude.
Un test vocal de production doit porter sur la prononciation, les artefacts, le rythme, l'émotion, la reproductibilité, la charge de montage, les abréviations, les dates, les devises, les URL, les noms, le changement de code linguistique et les phrases longues.
Associez l'écoute aux transcriptions et aux métadonnées ; le Processus de transcription audio ChatGPT permet de reproduire la vérification du texte.
Le modèle Qwen3-TTS semble prometteur, mais cette évaluation ne comporte aucun résultat de test de performance obtenu directement. Avant la mise en service, effectuez des tests répétés en utilisant des écouteurs, des casques et les haut-parleurs du téléphone.
Les points sur lesquels les critiques externes se sont concentrés
La démo sur les réseaux sociaux de Qwen met en avant une grande diversité de timbres, de langues et de dialectes. Le créateur indépendant Bijan Bowen s'est concentré sur l'exécution locale et le clonage de voix ; Jeff Geerling a présenté ce lancement comme une concurrence open source de taille pour les plateformes de synthèse vocale gérées. Il s'agit là des points de vue des critiques, et non de résultats de tests comparatifs ni d'une preuve d'un consensus à l'échelle du marché.
Vitesse et latence du Qwen3-TTS
Latence du premier paquet
0.288 / 0.313
0,6B / 1,7B avec un niveau de concurrence de 1.
Environnement vLLM interne optimisé — ne garantit pas le fonctionnement sur un ordinateur portable.
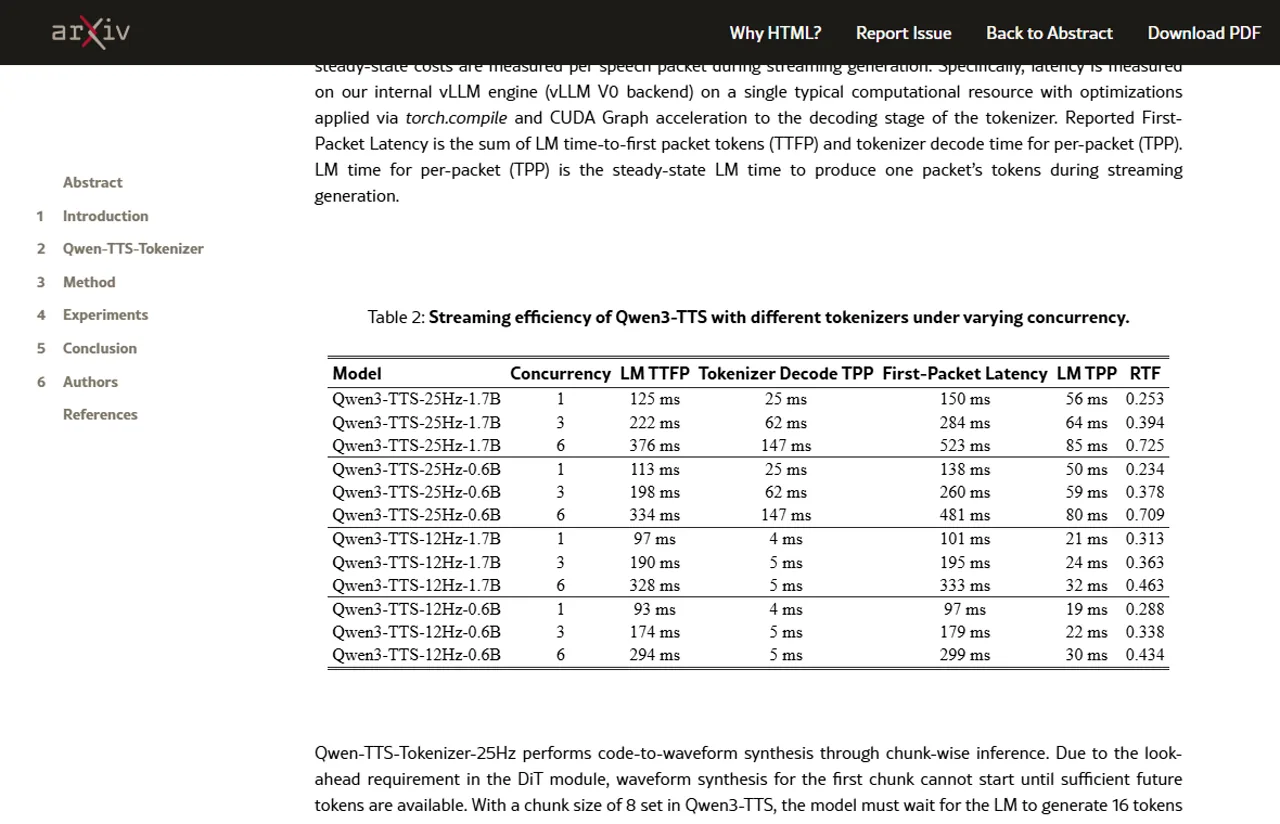
La valeur de référence en matière de vitesse est une latence du premier paquet de 97 ms pour le modèle 0,6B 12 Hz. Le même tableau du rapport technique indique 101 ms pour le modèle 1,7B 12 Hz avec un niveau de concurrence de 1. Les facteurs de temps réel (RTF) rapportés étaient respectivement de 0,288 et 0,313. En clair, un RTF inférieur à 1 signifie que la synthèse s'est déroulée plus rapidement que la durée de l'audio généré dans cet environnement.
Ces résultats proviennent de la configuration interne optimisée du vLLM de Qwen. Il ne s'agit pas d'estimations génériques du délai avant la première sortie audio pour un ordinateur portable sous Windows, un conteneur « à froid » sans serveur ou une région API partagée. Le rapport montre également que la concurrence influe sur la latence. Le chargement du modèle, le traitement de l’audio de référence, le transit réseau, la mise en file d’attente, le conditionnement audio et la lecture côté client peuvent tous se situer en dehors du nombre de décodeurs principaux.
Un rapport de référence objectif devrait inclure :
- Matériel, précision, révision du modèle et suivi.
- État froid ou chaud, concurrence, heure de la première lecture audio, durée totale, pic de VRAM, durée de sortie et RTF.
- Pour une API : région, type de connexion, ID de requête, mise en file d'attente et tentatives de reconnexion.
Le modèle 0.6B devrait constituer le choix le plus sûr lorsque la mémoire et la concurrence priment sur la capacité maximale. Le modèle 1.7B est le choix le plus judicieux en termes de qualité lorsque la machine dispose d’une marge de manœuvre suffisante. Cependant, sans utiliser la même invite, le même locuteur, les mêmes paramètres d’échantillonnage et le même état de préchauffage, la taille du modèle à elle seule ne permet pas de déterminer la différence réelle de latence.
Qwen3-TTS : langues et prononciation
Les points de contrôle ouverts Qwen3-TTS prennent en charge dix langues : le chinois, l'anglais, le japonais, le coréen, l'allemand, le français, le russe, le portugais, l'espagnol et l'italien. Cette liste provient du dépôt actuel et des ressources du modèle publié. N'ajoutez pas discrètement le thaï, l'indonésien, le malais ou le vietnamien, car un autre produit audio Qwen les prend déjà en charge.
| Langue | Assistance officielle ouverte à tous | Priorité de l'analyse de la production |
|---|---|---|
| Chinois | Oui | Tons, noms, lecture des chiffres, style rédactionnel régional |
| Anglais | Oui | Stress, abréviations, noms de marques, phrases longues |
| Japonais | Oui | Accent tonique, particules, noms, texte en latin mélangé |
| coréen | Oui | Espacement, mots d'emprunt, fins de phrases |
| Allemand | Oui | Composés, nombres, groupes de consonnes |
| Français | Oui | Liaison, abréviations, noms empruntés |
| Russe | Oui | Accents, noms, chiffres, insertions en latin |
| portugais | Oui | Vérifier l'accent régional et l'orthographe prévus |
| Espagnol | Oui | Vérifier l'accent régional et les noms propres |
| italien | Oui | Accent tonique, gémination, noms étrangers |
“Le terme ” prend en charge » signifie que le modèle est capable de synthétiser la langue ; cela ne signifie pas pour autant que toutes les voix reproduisent de manière identique la prononciation native dans chaque région. Le portugais et l’espagnol, à eux seuls, comportent d’importantes variations régionales. Dans le cadre d’un déploiement commercial, il convient de définir la locale cible, de faire appel à des relecteurs natifs et de constituer un ensemble de données de régression phonétique pour les noms, les mesures, les adresses et les expressions juridiques.
Le changement de code linguistique nécessite un test spécifique. Une phrase telle que “ Ouvrez l’API Qwen3-TTS à São Paulo à 9 h 30 ” combine une structure en anglais, un nom de modèle, une prononciation en portugais, de la ponctuation et une heure. Cela se rapproche bien davantage d’un texte d’application réel qu’une phrase de démonstration monolingue « propre ». Pour le doublage vidéo, la prononciation doit également s’adapter au timing ; notre Veo 3.1 : flux de travail pour les dialogues, l'audio et la synchronisation labiale traite du problème de synchronisation associé.
Clonage vocal, CustomVoice et VoiceDesign
Les points de contrôle « Base » permettent un clonage vocal rapide à partir d'un enregistrement audio de référence d'environ trois secondes. Il s'agit là d'un seuil de performance impressionnant, et non d'une garantie que trois secondes constituent toujours l'échantillon idéal pour la production. Les enregistrements de référence courts peuvent ne pas refléter correctement la gamme vocale, le rythme, la couverture des voyelles, l'émotion et la cohérence du micro.
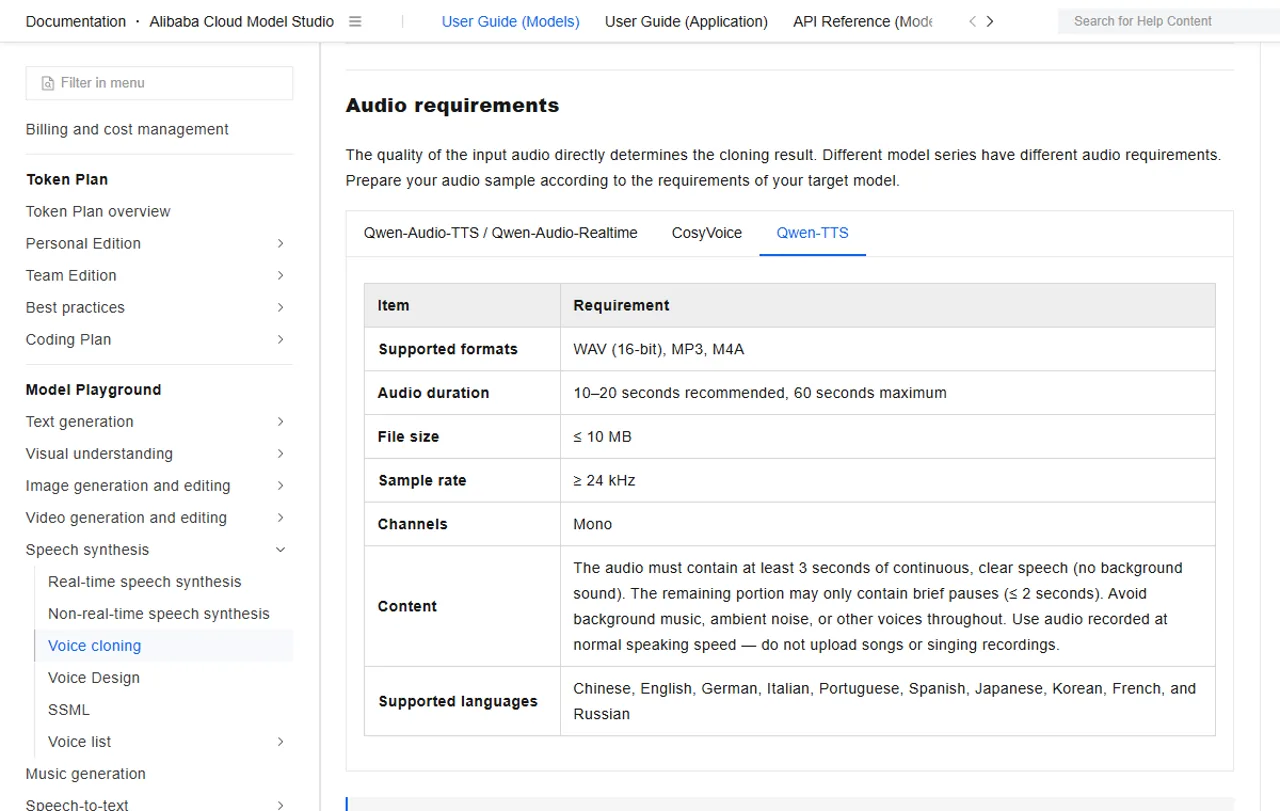
Les recommandations d'Alibaba Cloud concernant l'enregistrement hébergé sont plus prudentes : elles exigent au moins trois secondes de parole claire et ininterrompue, autorisent des échantillons plus longs et recommandent un enregistrement plus clair et plus long pour un clonage efficace. Suivez les instructions actuelles documentation sur le clonage de la voix en ce qui concerne le format, la fréquence d'échantillonnage, le nombre de canaux, la durée et les règles relatives à la région, plutôt que de considérer la démonstration de trois secondes présentée dans l'article comme une spécification de mise en ligne.
CustomVoice évite de reproduire à l'identique une personne réelle. La version ouverte propose neuf timbres haut de gamme adaptés à différentes langues ou styles, ce qui en fait une solution intéressante lorsque le choix d'une identité prédéfinie et le contrôle des instructions suffisent.
VoiceDesign génère un timbre à partir d'une description en langage naturel. Le service hébergé Documentation sur la conception vocale présente le processus de création distinct. Il convient aux personnages de fiction et aux voix de marque synthétiques, mais les descriptions doivent tout de même faire l'objet de tests pour évaluer l'âge perçu, l'accent et les préjugés culturels.
Matrice des risques liés à l'identité vocale
Indiquez le nom de l'intervenant, le champ d'application, la durée et la procédure de retrait.
Crypter les références et supprimer les voix dérivées en même temps que la source.
Bloquer les revendications d'identité malveillantes et ajouter une fonctionnalité de signalement.
Indiquez qu'il s'agit d'une voix synthétique lorsque les auditeurs risquent de la confondre avec celle d'une personne.
Le clonage nécessite des droits explicites et un consentement éclairé. Conservez le document original de consentement, définissez les utilisations autorisées, empêchez toute réinscription en aval et prévoyez une procédure de suppression. Les risques ne sont pas théoriques ; le Analyse de la confidentialité et du consentement dans le cadre de la reconnaissance faciale et vocale explique pourquoi les mesures de protection relatives à l'identité, aux données biométriques et à l'usurpation d'identité doivent être intégrées dès la conception du produit plutôt que de figurer dans une note de bas de page.
Qwen3-TTS 0,6B ou 1,7B : lequel choisir ?
Optez pour la taille 0.6B lorsque votre principale contrainte est le déploiement. C'est le meilleur choix pour les GPU de petite taille, une concurrence plus élevée, une expérimentation plus rapide et un auto-hébergement où le coût est un facteur déterminant. Les modèles « Base » et « CustomVoice » existent tous deux dans cette taille ; vous pouvez ainsi évaluer le clonage ou les voix prédéfinies sans devoir commencer par le point de contrôle le plus volumineux.
Optez pour la version 1.7B lorsque la marge de qualité et l’étendue des fonctionnalités sont prioritaires. Il s’agit de la seule version disponible intégrant VoiceDesign, et c’est le choix le plus judicieux pour les équipes prêtes à sacrifier de la mémoire et du débit au profit de la capacité. Les chiffres relatifs à la concurrence 1 présentés dans le rapport technique montrent une légère différence au niveau du premier paquet et du temps de réponse (RTF) dans la configuration optimisée de Qwen, mais votre propre matériel peut amplifier ou réduire cet écart.
| Facteur déterminant | Commencez par 0,6 B | Commencez par 1,7 milliard |
|---|---|---|
| La mémoire du GPU est insuffisante | Coupe plus ajustée | Risque accru de déchargement ou de faible concurrence |
| Besoin de VoiceDesign | Non disponible dans le coffret commercialisé | Exigée |
| Clonage de la base de données Need | Disponible | Disponible avec une plus grande capacité |
| Besoin de CustomVoice | Disponible | Disponible avec une plus grande capacité |
| Besoin d'une étude de faisabilité rapide | Le meilleur point de départ | À utiliser après les travaux sur la canalisation |
| Il faut prendre une décision définitive concernant la production | Comparer les deux | Comparer les deux |
Le nombre de paramètres ne correspond pas aux besoins en VRAM. La précision, la mise en œuvre de l'attention, le cache, la longueur de référence, la taille des lots et la surcharge du framework sont autant de facteurs qui entrent en ligne de compte. Un modèle qui peine à se charger ne constitue pas un service de production fiable.
Pour la MX450 de 2 Go testée dans le cadre de cette analyse, aucune des deux configurations ne permet d’obtenir un parcours de benchmark GPU représentatif. La prochaine étape concrète consiste à utiliser une pile CUDA plus récente et un GPU adapté ou un point de terminaison hébergé officiellement. La mention “ Elle a fonctionné avec un déchargement du processeur ” constituerait une remarque relative à la compatibilité, et non un verdict significatif sur les performances.
API Qwen3-TTS : HTTP, streaming et identifiants de modèles
Choisissez le mode de transport en fonction des besoins liés à la lecture
La méthode la plus simple pour la narration par lots et les fichiers complets.
Livraison progressive ; vérifiez tout de même à quel moment l'audio devient lisible.
Idéal pour les conversations et l'écoute en continu.
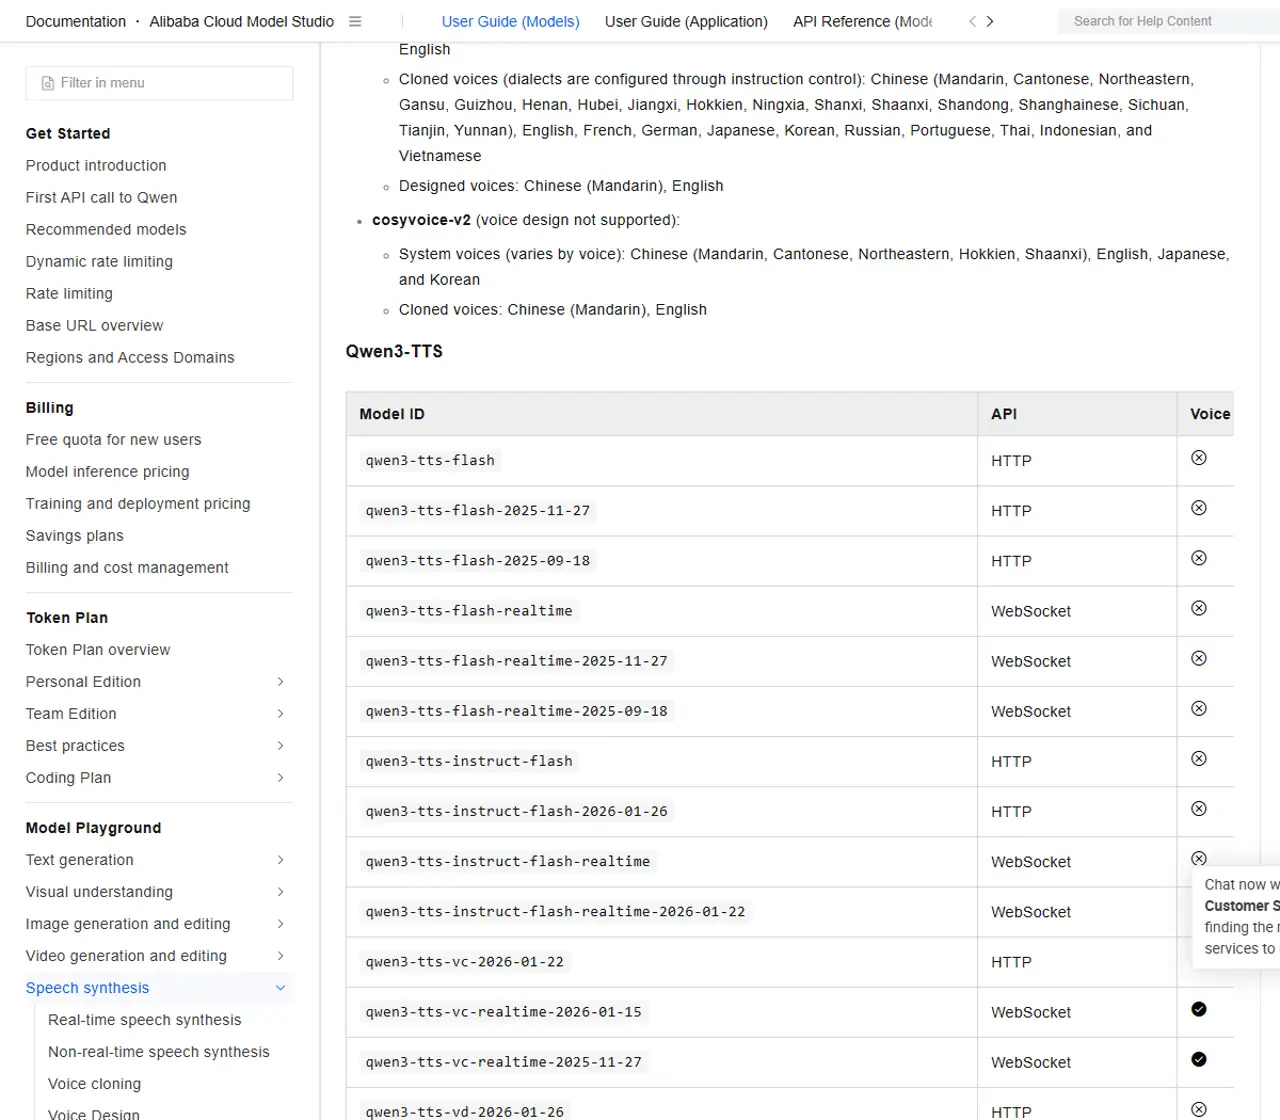
Alibaba Cloud propose des modèles de génération HTTP non en temps réel et des modèles WebSocket en temps réel. Optez pour la synthèse non en temps réel lorsque vous pouvez attendre un résultat complet et que vous souhaitez un flux de requêtes le plus simple possible. Utilisez le streaming WebSocket lorsque la latence conversationnelle ou la lecture progressive sont importantes. Le streaming HTTP ou les événements envoyés par le serveur peuvent renvoyer des données incrémentielles, mais il ne faut pas les confondre avec la famille de modèles dédiés en temps réel à faible latence.
Les familles actuellement hébergées comprennent Qwen3-TTS Flash pour les voix intégrées, Instruct Flash pour le contrôle des performances en langage naturel, VC pour les voix clonées et VD pour les voix conçues. Les identifiants de modèle et les instantanés datés diffèrent selon qu'il s'agit de routes en temps réel ou non ; il est donc préférable de les copier à partir de la documentation actuelle plutôt que de construire des noms par analogie.
Le courant Documentation de l'API Qwen-TTS limite la saisie à 512 tokens par requête. Il s'agit de la limite applicable à cette famille ; une règle distincte de 600 caractères documentée pour d'autres modèles TTS ne doit pas être reprise dans une intégration Qwen3-TTS. Les URL « Complete-audio » restent valides pendant 24 heures ; les systèmes de production doivent donc transférer les fichiers requis vers un stockage durable au lieu d'utiliser l'URL de réponse comme support permanent.
import os
import dashscope

dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

response = dashscope.MultiModalConversation.call(
    model="qwen3-tts-flash",
    api_key=os.environ["DASHSCOPE_API_KEY"],
    text="Votre commande est prête à être retirée à 16 h 30.",
    voice="Cherry",
    language_type="English",
)

print(response)
La clé API et la région du point de terminaison doivent correspondre. Les déploiements à Pékin et à Singapour utilisent des identifiants et des URL de base différents, tandis que la disponibilité des modèles peut varier selon la région. N’intégrez jamais la clé dans WordPress, dans du code JavaScript côté client ou dans un fichier binaire mobile. Envoyez les requêtes de synthèse via un serveur que vous contrôlez, enregistrez les identifiants des requêtes sans consigner les données sensibles saisies, et définissez une politique de cycle de vie pour les fichiers audio générés.
Pour les documents longs, divisez-les en segments au niveau des limites sémantiques, préservez le contexte, normalisez les chiffres et écoutez l'intégralité de chaque jointure. Les extraits valides peuvent tout de même donner l'impression d'être des prises distinctes lorsque le rythme ou l'énergie changent d'un appel à l'autre.
Tarifs du Qwen3-TTS sur le marché international
Aperçu des tarifs par région à l'international
Flash
$0.10
pour 10 000 caractères saisisInstruction / VC / VD
$0.115
pour 10 000 caractères saisisFlash / VC
$0.13
pour 10 000 caractères saisisInstruire
$0.143
pour 10 000 caractères saisisVD
$0.143353
pour 10 000 caractères saisisCréation de voix : $0.01 par inscription · $0.20 par ligne téléphonique prévue.
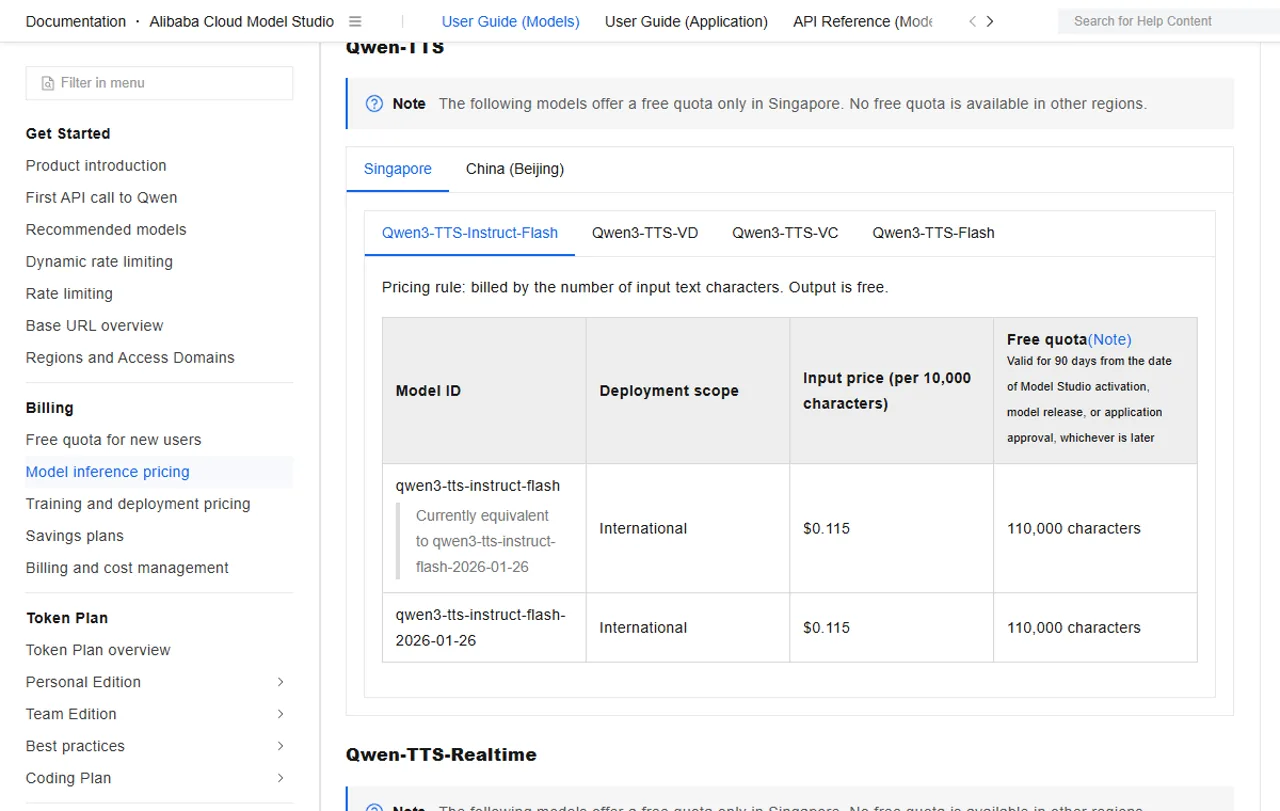
Alibaba Cloud’s Page des tarifs de Model Studio Les tarifs internationaux et régionaux suivants ont été répertoriés lors d'une consultation effectuée le 11 août 2026. Pour ces lignes, les données entrantes sont facturées tandis que les données sortantes sont gratuites. Les tarifs, les quotas gratuits, les alias et la disponibilité régionale sont susceptibles de changer ; veillez donc à valider le déploiement sélectionné avant d'effectuer un traitement par lots de grande envergure.
| Itinéraire | Famille modèle | Prix pour 10 000 caractères saisis |
|---|---|---|
| Non en temps réel | Qwen3-TTS Flash | $0.10 |
| Non en temps réel | Instruct, VC ou VD | $0.115 |
| En temps réel | Flash ou VC actuel | $0.13 |
| En temps réel | Instruire | $0.143 |
| En temps réel | VD | $0.143353 |
La création de voix fait l'objet d'une facturation distincte de celle de la synthèse. Ce même barème tarifaire international indique que l'enregistrement vocal Qwen est facturé à $0,01 par clone et que la conception vocale est facturée à $0,20 par voix conçue. Une identité clonée ou conçue peut ensuite donner lieu à la facturation des frais de synthèse par caractère correspondants lors de son utilisation.
Prévoir séparément le budget consacré à la création des voix, à la synthèse des personnages, à l'infrastructure et à la régénération. Le temps de montage et le nombre de prises souvent déterminent le coût réel de production.
Le tarif de l'API ne correspond pas au coût local. Les points de contrôle ouverts suppriment la facturation au caractère pratiquée par les fournisseurs, mais ils entraînent des coûts supplémentaires liés au temps d'utilisation des GPU, à l'ingénierie de déploiement, à la surveillance, au stockage, à la mise à l'échelle et à la gestion des incidents. L'auto-hébergement s'avère avantageux lorsque le contrôle, le volume, la localisation des données ou la personnalisation justifient cette charge opérationnelle.
Les alternatives et la voie audio GlobalGPT
Qwen3-TTS n'est pas forcément la meilleure option pour tous les projets audio. ElevenLabs est une plateforme vocale gérée plus aboutie, destinée aux équipes qui privilégient un tableau de bord soigné, une gamme étendue d'outils de production et une infrastructure allégée. Les modèles vocaux OpenAI peuvent convenir aux développeurs qui ont déjà adopté un écosystème d’API standardisé. Qwen-Audio 3.0 TTS est la nouvelle solution hébergée Qwen à prendre en compte lorsque l’on suit les recommandations actuelles d’Alibaba Cloud.
La musique et les effets sonores relèvent d'une autre comparaison. Le Comparaison audio entre le ElevenLabs, le Lyria 3 Pro et le Mureka Cela permet de distinguer les outils de synthèse vocale de ceux dédiés à la génération musicale complète. Un modèle de synthèse vocale ne devrait pas être pénalisé s’il ne parvient pas à produire une chanson finalisée, et un modèle musical ne devrait pas être choisi comme API de narration à faible latence.
GlobalGPT dispose actuellement d'un compte vérifié itinéraire du générateur audio qui répertorie qwen-audio-3.0-tts-flash et Seed Audio 1.0. La page consultée ne mentionnait pas le Qwen3-TTS. Cela fait du GlobalGPT un espace de travail audio distinct à part entière, mais ne prouve pas que les points de contrôle ouverts du Qwen3-TTS y soient disponibles.
Si votre produit final est une vidéo, déterminez si vous avez besoin d'un narrateur distinct, de dialogues générés, d'effets sonores ou d'un modèle capable de produire des sons en synchronisation avec les images. Notre réponse à si la version Veo 3.1 dispose d'une fonction audio cette décision s'inscrit dans une perspective plus large. La meilleure approche consiste souvent à utiliser un petit ensemble d'outils spécialisés plutôt que d'imposer à un seul modèle de réaliser toutes les tâches audio.
Licence, consentement, confidentialité et utilisation commerciale
Le référentiel Qwen3-TTS et les fiches de modèles publiées sont soumis à la licence Apache 2.0. Celle-ci est favorable au développement, à la modification et à la distribution à des fins commerciales, mais elle n'accorde aucun droit sur la voix, les prestations, les scripts, les marques déposées ou les données personnelles d'autrui. La licence des modèles et les droits sur le contenu constituent deux aspects distincts.
L'inférence locale vous offre davantage de contrôle et vous confère une plus grande responsabilité en matière de sécurité. Chiffrez les enregistrements de référence, limitez les accès, réduisez au minimum la durée de conservation, consignez les dérivés et étendez la suppression aux voix enregistrées et aux résultats mis en cache.
Dans le cas d'une synthèse hébergée, vérifiez les conditions d'utilisation du service, les modalités régionales de traitement des données, la durée de conservation et les contrôles mis en place par l'entreprise avant d'envoyer des scripts confidentiels ou des échantillons vocaux.
Toute voix clonée destinée au grand public doit avoir un propriétaire, un enregistrement du consentement, une politique d'utilisation autorisée et une procédure de réponse en cas d'abus. Il convient d'ajouter une mention d'avertissement lorsqu'une voix synthétique pourrait raisonnablement être confondue avec celle d'une personne réelle. Il faut empêcher l'usurpation d'identité de particuliers et de personnalités publiques à haut risque, et mettre en place un moyen de signaler les contenus audio préjudiciables.
À qui s'adresse le produit Qwen3-TTS ?
Quel itinéraire choisir ?
Compatible avec les pipelines, mémoire plus compacte, mode « Base » ou « CustomVoice ».
Comparaison entre VoiceDesign et la capacité en termes de qualité, en tenant compte de la marge de manœuvre du GPU.
Des opérations plus rapides lorsque la région, la confidentialité et les tarifs sont adaptés.
Studio ne nécessitant aucune configuration, place de marché sous licence ou prise en charge des fournisseurs existants.
Qwen3-TTS s'adresse aux chercheurs, aux développeurs, aux équipes de développement de jeux vidéo et aux groupes de localisation qui ont besoin de poids ouverts, d'un choix de déploiement, de la possibilité de cloner des modèles ou de voix de personnages décrites par du texte.
Commencez par 0,6 milliard si vous testez le pipeline, si vous disposez d'une mémoire limitée ou si vous vérifiez que Base et CustomVoice répondent aux besoins du produit. Commencez par 1,7B si vous avez besoin de VoiceDesign ou si vous disposez d’une infrastructure matérielle suffisante pour comparer correctement la qualité et le débit. Utilisez l’API hébergée si l’infrastructure constitue un goulot d’étranglement et si la disponibilité régionale, les identifiants d’accès et le traitement des données correspondent aux besoins du projet.
Optez pour une autre solution si vous avez besoin d'un studio de montage ne nécessitant aucune configuration, d'une vaste plateforme de voix sous licence ou d'un support entreprise déjà mis en place par un autre fournisseur. Ne procédez jamais à un clonage sans consentement écrit.
Utilisez cinq scripts réels, trois répétitions, une liste de noms complexes, un long paragraphe et un test de récupération. Mesurez la latence et le coût, puis demandez à des auditeurs natifs si le résultat est acceptable tel quel, sans correction. Le travail d'édition peut réduire à néant une victoire au benchmark.
FAQ Qwen3-TTS
Le modèle Qwen3-TTS est-il gratuit ?
Les points de contrôle Qwen3-TTS mis à disposition sont disponibles sous licence Apache-2.0 ; vous pouvez donc les télécharger et les exécuter sans frais liés au nombre de caractères traités. L'auto-hébergement engendre toutefois des coûts liés à la puissance de calcul, au stockage, à l'ingénierie et à la surveillance. Les API Qwen3-TTS hébergées par Alibaba Cloud sont des services payants dont les tarifs et les quotas varient selon les régions.
Le modèle Qwen3-TTS peut-il être utilisé à des fins commerciales ?
La licence Apache-2.0 autorise l'utilisation commerciale du code et des poids de modèles mis à disposition, mais elle ne vous donne pas le droit de cloner la voix d'une personne ni d'utiliser des scripts ou des marques protégés. Les projets commerciaux doivent toujours obtenir le consentement des locuteurs, disposer des droits sur le contenu, respecter les règles de confidentialité et se conformer à la législation locale ainsi qu'aux conditions d'utilisation des plateformes.
Quelles langues sont prises en charge par Qwen3-TTS ?
La version ouverte Qwen3-TTS prend en charge le chinois, l'anglais, le japonais, le coréen, l'allemand, le français, le russe, le portugais, l'espagnol et l'italien. La couverture linguistique des modèles hébergés peut varier selon le terminal et la voix ; veillez donc à vérifier l'identifiant exact du modèle Alibaba Cloud et la région avant de développer un produit multilingue.
Le modèle Qwen3-TTS est-il vraiment capable d'atteindre une latence de 97 ms ?
Qwen a fait état d'une latence du premier paquet de 97 ms pour le modèle 0,6B 12 Hz avec un niveau de concurrence de 1, dans un environnement vLLM interne optimisé. Il s'agit d'un benchmark valide fourni par le fabricant, et non d'une garantie universelle concernant les performances de l'appareil. Les démarrages à froid, le matériel, la précision, le transit réseau, la mise en file d’attente et la mise en mémoire tampon côté client peuvent augmenter la latence observée.
De combien de VRAM la carte Qwen3-TTS a-t-elle besoin ?
Il n'existe pas de valeur de VRAM unique et fiable valable pour toutes les configurations. La taille du modèle, la précision, le backend d'attention, la taille de lot, le cache, la longueur de référence et la surcharge du framework sont autant de facteurs qui entrent en ligne de compte. La carte MX450 de 2 Go testée ne se prêtait pas à une évaluation comparative représentative ; il convient de tester le point de contrôle choisi avec un niveau de concurrence similaire à celui d'un environnement de production et de prévoir une marge de manœuvre opérationnelle.
Quelle quantité d'enregistrements audio est nécessaire pour le clonage vocal avec Qwen3-TTS ?
Les exemples fournis montrent que le clonage peut s'effectuer rapidement, en trois secondes environ, tandis que les consignes d'enregistrement proposées par la plateforme privilégient un discours continu et clair, tout en autorisant des échantillons plus longs. Considérez ces trois secondes comme un seuil minimal de capacité, et non comme un objectif de qualité automatique. Utilisez des enregistrements audio pour lesquels vous disposez d'un consentement, exempts de bruit, couvrant la gamme vocale normale de l'orateur et la langue souhaitée.
Quelle est la limite d'entrée de l'API Qwen3-TTS ?
La documentation actuelle de l'API Qwen-TTS indique que la longueur maximale des entrées pour les modèles Qwen-TTS est de 512 tokens. Les URL « Complete-audio » sont valides pendant 24 heures. Il est recommandé de diviser les scripts longs en segments aux limites sémantiques et de copier les résultats requis sur un support de stockage durable, plutôt que de considérer l'URL renvoyée comme un hébergement permanent.
Puis-je utiliser le modèle Qwen3-TTS sur le modèle GlobalGPT ?
Le générateur audio GlobalGPT coché figurant dans la liste qwen-audio-3.0-tts-flash et Seed Audio 1.0, et non Qwen3-TTS. Vous pouvez utiliser cette méthode dans le cadre d'un flux de travail audio distinct, mais elle ne doit pas être présentée comme un accès aux points de contrôle ouverts 0.6B ou 1.7B de Qwen3-TTS.
Verdict final
Cette analyse du modèle Qwen3-TTS révèle une étendue inhabituelle : des points de contrôle ouverts à 0,6B et 1,7B, dix langues, des voix prédéfinies, le clonage rapide, VoiceDesign, une architecture de streaming, une licence permissive et des API hébergées.
Il convient également de souligner une limite objective. Aucun signal audio Qwen3-TTS n'a été généré dans l'environnement de test disponible, et la carte graphique de 2 Go testée n'était pas en mesure de prendre en charge une comparaison locale représentative. C'est pourquoi cet article n'attribue pas de note de qualité vocale et ne prétend pas offrir des performances universelles de 97 ms.
Si vous accordez de l'importance à la flexibilité en matière de poids et au contrôle, testez d'abord le point de contrôle 0,6B, puis comparez-le avec le 1,7B sur les mêmes scripts et le même matériel. Si vous privilégiez la rapidité de mise en production, testez l'offre Alibaba Cloud que vous envisagez d'acheter et comparez-la à la gamme Qwen-Audio 3.0 TTS, qui occupe une position distincte sur le marché. Consignez le nom du modèle, le point de terminaison, la région, l'enregistrement de consentement, la latence et le coût total de traitement dans la même fiche de décision.
Le modèle Qwen3-TTS mérite d'être testé. Il ne sert à rien de prétendre que la documentation à elle seule peut « entendre » une voix à votre place. La solution gagnante est celle qui s'adapte à vos noms, à votre langue, à votre matériel, à vos exigences en matière de confidentialité et à vos délais de production.