
Réponse rapide : GPT-6 Sol a mené à bien le cas pratique en cinq parties soumis à un test, dans la limite de 2 400 tokens ; Claude Opus 5.5 a fourni le diagnostic le plus précis lors de notre tâche de révision de code court. Aucun de ces résultats ne permet de désigner un vainqueur définitif.
Cette comparaison pertinente va au-delà d'un simple score. Claude Opus 5.5 et GPT-6 Sol se distinguent par leur approche de la rédaction, de la synthèse de recherches, de la révision de code, des réponses structurées, des voies d'accès et du flux de travail quotidien. Les résultats des tâches présentés ci-dessous montrent dans quels domaines ces différences sont déterminantes.
GlobalGPT vous offre ces deux modèles dans un abonnement multi-modèles abordable, aux côtés d'autres modèles et de fonctionnalités d'IA. Un seul tableau de bord permet de mener un projet de bout en bout, de la recherche et la rédaction jusqu'au codage, aux images et à la vidéo, tandis que son interface en ligne de commande (CLI) relie ce même contexte de travail aux outils de terminal et de production.
Réponse rapide
Choisissez GPT-6 Sol Tout d'abord, en ce qui concerne le processus de rédaction avec contraintes testé ici : il a réussi à remplir les cinq sections tout en respectant la limite commune de 2 400 tokens. Choisissez Claude Opus 5,5 lorsque le diagnostic, l'analyse explicite des risques et le format JSON strict revêtent une importance particulière. Utilisez les deux lorsque le travail évolue au fil de la journée.
Les points forts de chaque modèle
Claude Opus 5,5 convient aux tâches qui nécessitent une réflexion approfondie : examiner une modification du code, démêler un cahier des charges confus, identifier les risques et respecter un cahier des charges strict en matière de résultats. Anthropic l'articule autour du codage, de l'utilisation de l'ordinateur, du travail intellectuel, de la sécurité et d'une communication plus naturelle lors de longues sessions. Voir le Avis sur le Claude Opus 5.5 pour une approche distincte axée sur le modèle. C'est un choix qui s'impose naturellement lorsqu'une deuxième analyse minutieuse vaut mieux qu'une première réponse plus succincte.
GPT-6 Sol s'adapte à des volumes de travail soumis à des contraintes : un dossier volumineux, une note de décision, un plan structuré ou un projet devant comporter de nombreuses sections requises. OpenAI le décrit comme un modèle GPT-6 plus abordable destiné au travail professionnel, à la vérification des faits, au codage, à l'utilisation de l'informatique et à la collaboration. Le Avis sur le GPT-6 Sol traite le modèle en tant que tel ; dans l'exercice de type « long-form » présenté ici, il a rempli le contrat dès la première réponse, ce qui s'avère utile lorsque le coût d'une section manquante est élevé.
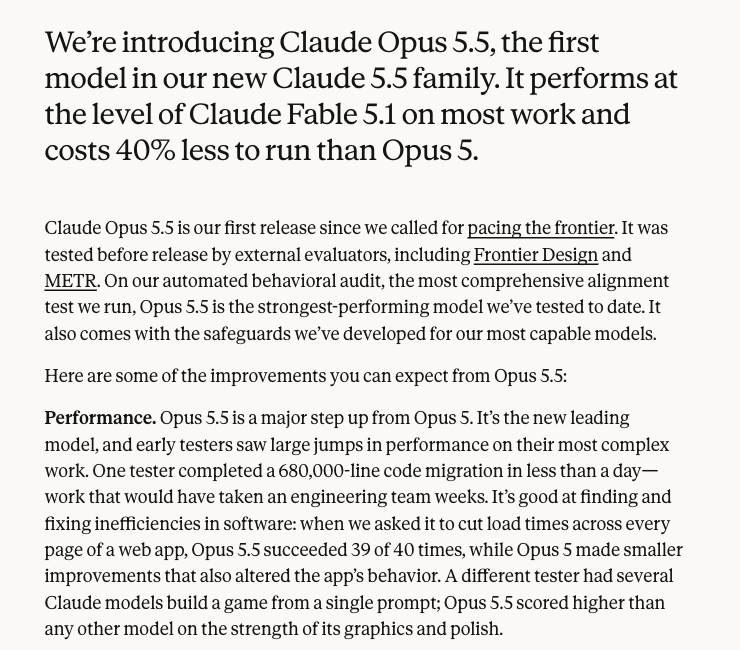
Il s'agit du compte-rendu de Anthropic concernant cette version, incluant des exemples fournis par les premiers testeurs. Ce compte-rendu corrobore l'orientation visée par le produit ; il n'établit toutefois pas de comparaison directe avec GPT-6 Sol. Nos invites appariées ci-dessous abordent la question plus précise de ce que chaque modèle a renvoyé lors de cette série de tests.
Comparaison des fonctionnalités et des capacités
Claude Opus 5.5 vs GPT-6 Sol : carte des capacités
| Domaine de décision | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Rédaction longue | Excelle dans la rédaction minutieuse et nuancée, ainsi que dans la formulation de mises en garde explicites | Capable de mener à bien, en une seule fois, un projet complexe comportant de nombreuses contraintes |
| Synthèse de recherche | Rapprochement détaillé et explication des risques | Une synthèse concise accompagnée d'une recommandation claire |
| Codage et révision | Diagnostic précis et rapport structuré sur les risques | Patches minimaux utiles ; validation des explications relatives aux cas limites |
| Sortie structurée | Un JSON rigoureux et fiable dans la tâche testée | JSON valide contenant toutes les clés requises dans la tâche testée |
| Multimodal et outils | Vérifiez l'itinéraire et le modèle d'accès pour la tâche en question | Vérifiez l'itinéraire et le modèle d'accès pour la tâche en question |
| Le meilleur mode de travail | Analyse réfléchie, raisonnement complexe et travail tenant compte des risques | Réalisation du brief soumis à des contraintes et testé, dans le respect du plafond de production fixé |
Comment lire ce texte : Il s'agit là de tendances en matière de flux de travail, et non d'un classement universel. Le choix qui s'impose dépend de ce qui compte le plus pour vous : une révision minutieuse ou la réalisation de ce brief dense dans les mêmes limites de volume de travail.
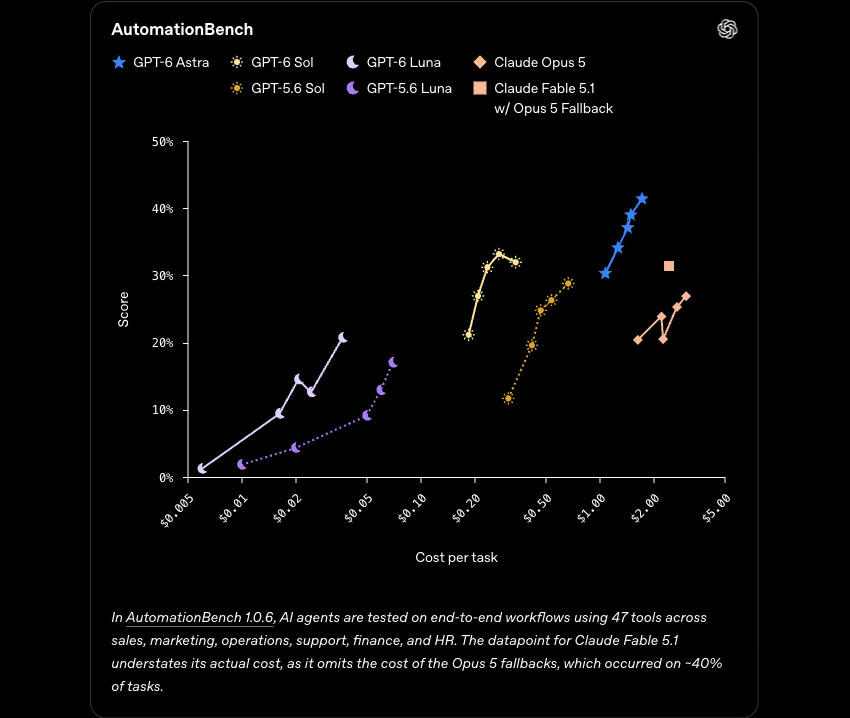
Interprétez les deux axes : une valeur croissante indique un score plus élevé, tandis qu'un déplacement vers la gauche indique un coût par tâche plus faible. La série Claude mentionnée ici est l'Opus 5, et non l'Opus 5.5. Ce graphique fourni par l'éditeur aide à comprendre le positionnement de Sol en termes de rapport coût-efficacité ; il ne permet toutefois pas de trancher la comparaison présentée dans cet article. La note de bas de page précise également que les données relatives à Fable omettent certains coûts de repli.
Rédaction, documents volumineux et synthèse de recherches
En matière de rédaction, ce test distingue la capacité à mener à bien une tâche dans le cadre d'une limite de volume fixe de la qualité de l'examen éditorial. GPT-6 Sol s'est montré plus performant sur le contrat de format long. Claude Opus 5.5 s'est montré plus performant lorsque la tâche consistait à diagnostiquer, qualifier et expliquer. En ce qui concerne les notes de recherche, les deux modèles sont parvenus à la même conclusion pratique ; la qualité des sources et du processus de révision reste donc plus importante que le choix d’un vainqueur.
- Utilisez GPT-6 Sol pour rédiger un premier jet comportant de nombreuses contraintes, une note de décision ou un plan de contenu structuré.
- Utilisez Claude Opus 5.5 pour remettre en question les hypothèses, mettre en évidence les risques et peaufiner un projet avant qu'il ne soit transmis à un client ou intégré dans un système de production.
- Lorsque l'exactitude des faits est primordiale, fournissez les données sources à l'un ou l'autre des modèles et veillez à conserver une étape de vérification humaine.
Codage, sortie structurée et travail prêt à être utilisé avec des outils
Les deux modèles ont renvoyé un JSON valide contenant toutes les clés demandées et le même correctif minimal. Claude a correctement décrit le filtre existant ; GPT-6 Sol a indiqué à tort qu'un élément « None » provoquerait une erreur. Cela confirme la supériorité de Claude pour le diagnostic dans cette tâche spécifique. Le type du champ « risk » n’étant pas spécifié dans la consigne, la chaîne de caractères « risk » fournie par Sol ne constitue pas une violation du contrat.
Pour les tâches prêtes à être automatisées, évaluez les critères de sortie dont vous avez réellement besoin : format JSON valide, champs complets, commandes reproductibles et un correctif pouvant être appliqué sans interprétation. Les deux modèles peuvent s’intégrer dans ce pipeline, en veillant à ce que les tests et la révision fassent partie intégrante du processus.
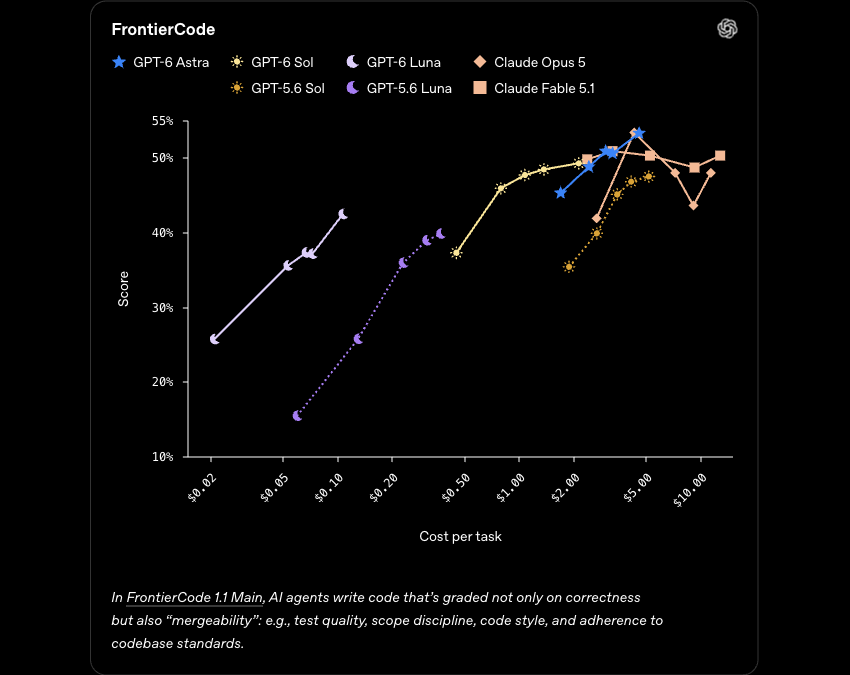
Ce test de référence porte sur un codage agentique plus large que notre brève consigne de révision de code. Son comparateur Claude est Opus 5 ; il sert donc à situer le codage de Sol dans son contexte plutôt qu’à démontrer que Sol surpasse Opus 5.5. Dans notre propre tâche, les deux correctifs étaient corrects ; la distinction utile résidait dans la précision du diagnostic.
Prix et accès
Prix et accès : comparez l'itinéraire, pas seulement le modèle
| Itinéraire | Ce pour quoi vous payez | Quand cela s'avère judicieux |
|---|---|---|
| Claude Opus 5.5 API | Sur sa page de présentation datée du 22 septembre 2026, Anthropic indique les valeurs suivantes : $4 par million de jetons d'entrée, $20 par million de jetons de sortie et $0,20 par million de jetons de lecture en cache. | Vous développez un produit ou un pipeline automatisé et souhaitez bénéficier d'une facturation directe par jeton |
| API GPT-6 Sol | OpenAI correspond à $2 par million de jetons d'entrée et à $10 par million de jetons de sortie, avec une réduction de 50% par rapport au tarif promotionnel de GPT-5.6 Sol ; les lectures en cache des jetons d'entrée bénéficient d'une remise de 90%. | Vous avez besoin d'un contrat API auprès d'un fournisseur direct et souhaitez bénéficier d'un coût à l'utilisation plus bas pour les tâches en continu |
| GlobalGPT | Un abonnement à prix abordable comprenant ces deux modèles, ainsi que de nombreux autres modèles et des fonctionnalités d'IA | Vous souhaitez regrouper la recherche, la rédaction, le développement, le traitement d'images et la vidéo dans un seul tableau de bord |
Ces chiffres correspondent aux tarifs des jetons API, et non aux prix des abonnements. OpenAI positionne GPT-6 Sol comme le modèle le plus économique de la gamme GPT-6 pour les tâches professionnelles, la vérification des faits, le codage, l’utilisation d’ordinateurs et la collaboration, tandis que Anthropic positionne Claude Opus 5.5 autour du codage, de l’utilisation d’ordinateurs, du travail intellectuel, de la sécurité et de la communication. GlobalGPT permet de disposer des deux modèles et du reste de la chaîne d’outils via un seul abonnement abordable, tandis que son interface CLI relie cet accès à un terminal, à un flux de travail de développement et aux outils de production existants.
Sources primaires : Page de présentation de la version Claude Opus 5.5 de Anthropic et Page de présentation des versions « Sol » et « Luna » de GPT-6 par OpenAI.
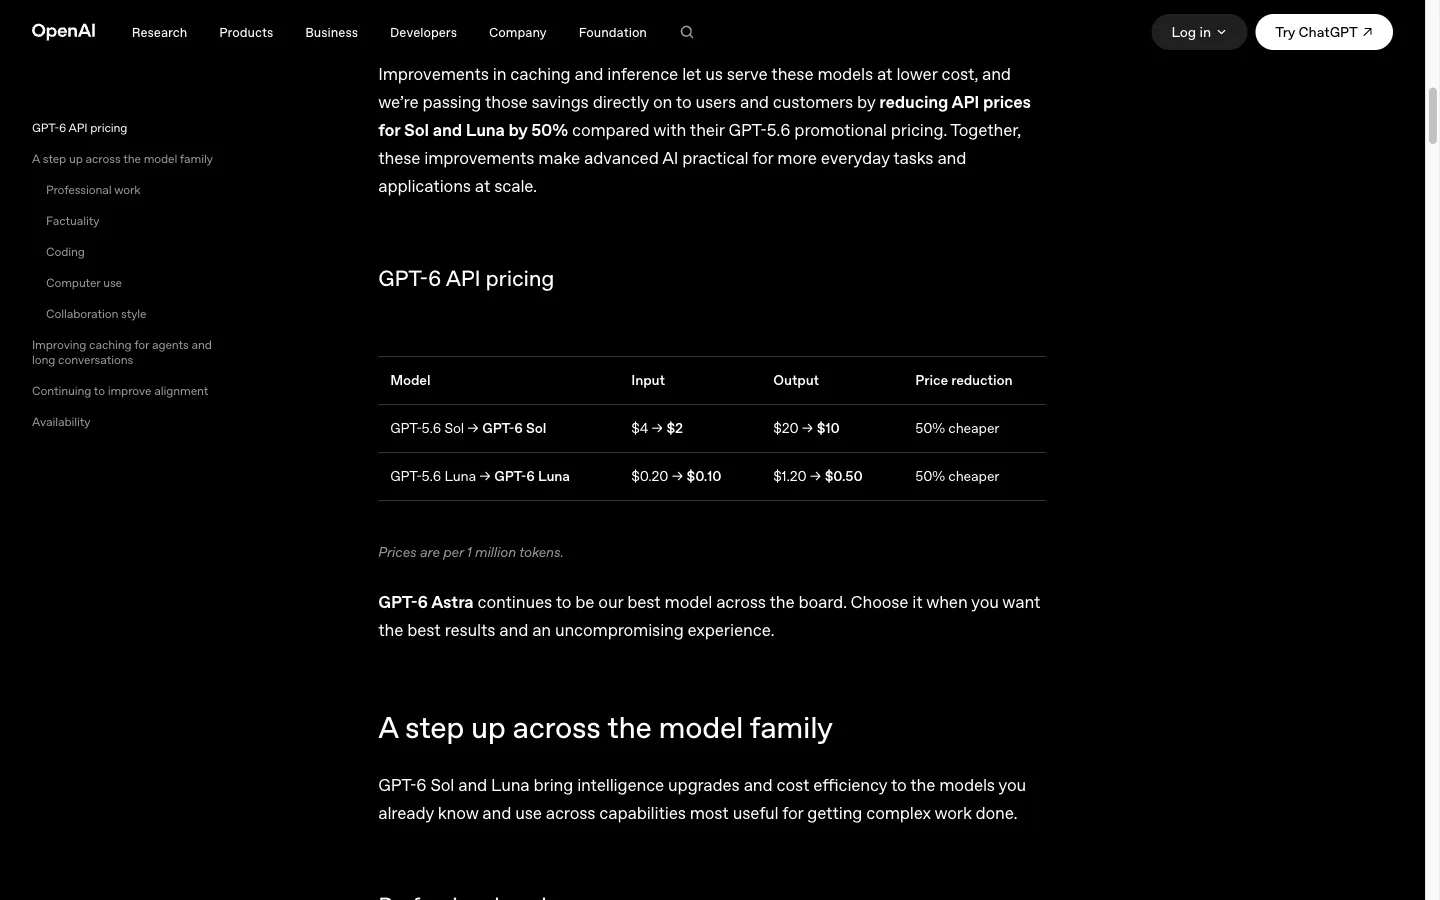
Ces tarifs s'appliquent aux jetons API. Ils ne concernent pas les abonnements mensuels grand public ni le forfait GlobalGPT.
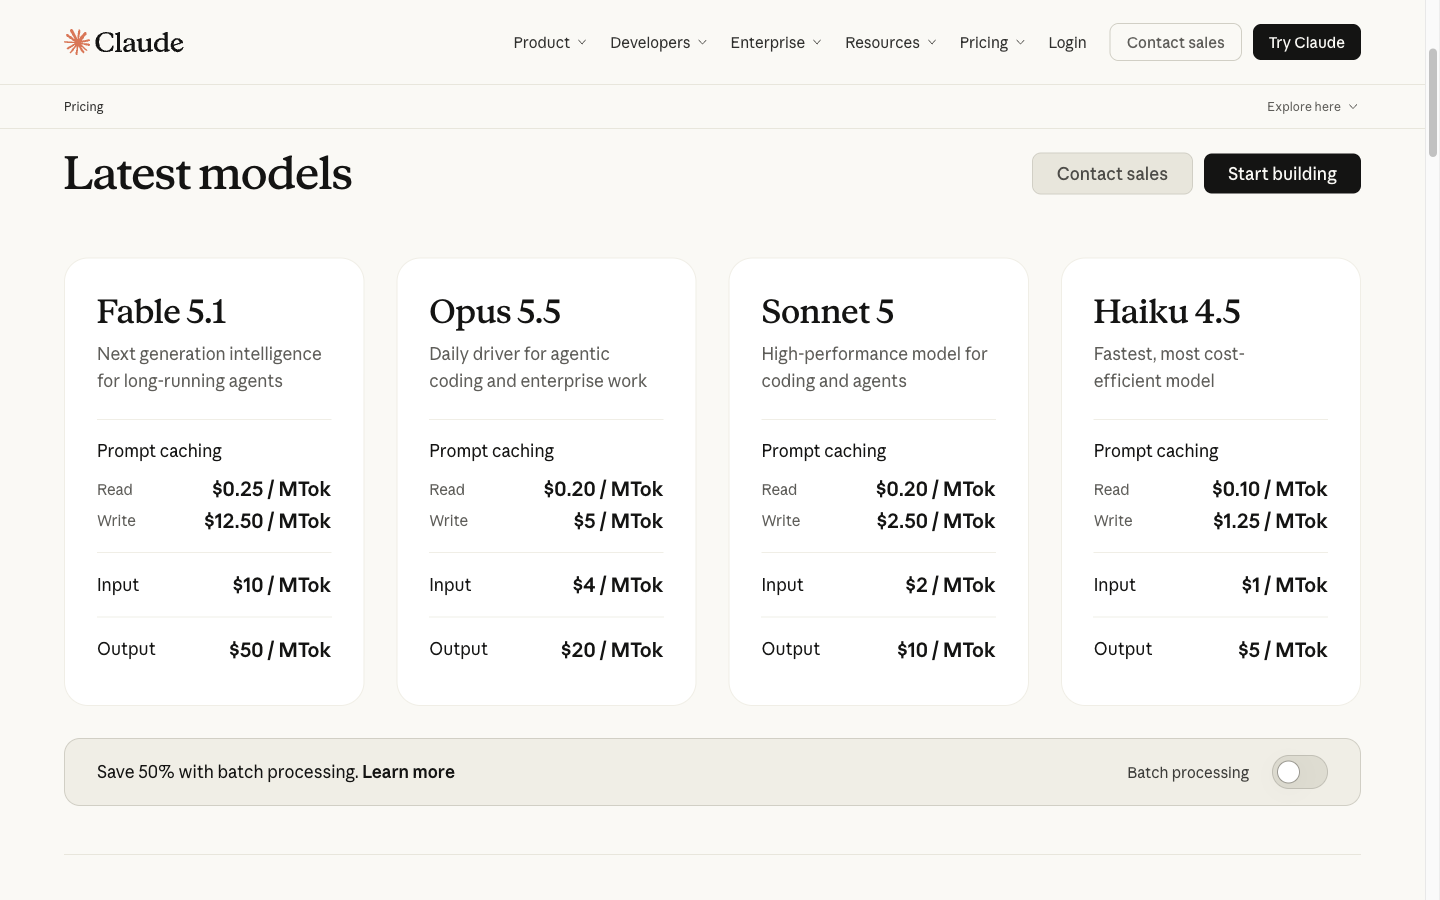
Les débits d'entrée et de sortie par défaut d'Opus 5.5 sont deux fois supérieurs à ceux de Sol, tandis que les débits de lecture en cache publiés pour les deux sont de $0,20/M. Un workflow faisant largement appel à la mise en cache peut donc présenter un écart de coût différent de celui d'un workflow sans mise en cache ; comparez la composition des jetons avant de faire votre choix en fonction du prix.
Ce que signifie la différence de débit pour une charge de travail identique
Exemple de calcul : 1 million de jetons d'entrée non mis en cache + 100 000 jetons de sortie, tarifs API standard. La couleur bleu sarcelle correspond au coût des intrants ; la couleur rouille, au coût des extrants.
Sol coûte deux fois moins cher pour cet ensemble identique de jetons. Il s'agit d'un calcul basé sur la grille tarifaire, et non d'une affirmation selon laquelle chaque tâche menée à bien coûte deux fois moins cher : les nouvelles tentatives, la longueur de la sortie, les accès au cache, les frais liés aux outils et les paramètres de raisonnement peuvent modifier le montant de la facture.
Sources : Tarification de l'API Anthropic et Tarifs de lancement de la version OpenAI, consulté le 25 septembre 2026.Estimer le coût direct de l'API
Calculateur de coûts API
Saisissez les jetons que vous prévoyez d'envoyer et de recevoir. L'estimation utilise les tarifs API vérifiés ci-dessus : Claude Opus 5,5 avec une entrée de $4/M et une sortie de $20/M ; GPT-6 Sol avec une entrée de $2/M et une sortie de $10/M.
| Modèle | Taux d'entrée | Débit de sortie | Coût estimé |
|---|---|---|---|
| Claude Opus 5,5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
Il s'agit d'une estimation de facturation par jeton pour une utilisation directe de l'API. Elle ne tient pas compte du prix d'un abonnement grand public ni de celui du forfait GlobalGPT, et exclut les remises liées au cache, les outils, les taxes et les autres frais spécifiques au fournisseur.
Qui doit choisir quel modèle ?
Quel modèle choisir ?
| Votre priorité | Choisis d'abord | Pourquoi |
|---|---|---|
| Une longue note de service soigneusement rédigée, soumise à de nombreuses contraintes | GPT-6 Sol | La tâche détaillée révisée a atteint la règle de décision demandée en un seul résultat |
| Diagnostic du code, JSON strict et risques explicites | Claude Opus 5,5 | Le travail de codage a permis d'établir un diagnostic plus précis et un inventaire des risques plus détaillé |
| Notes de recherche nécessitant une mise en concordance | Soit | L'épreuve de synthèse à source contrôlée s'est soldée par une égalité |
| Un flux de travail hebdomadaire mixte | GlobalGPT avec les deux | Regroupez le choix des modèles, la rédaction, le codage, les images et les vidéos dans un seul tableau de bord ; utilisez l'interface en ligne de commande (CLI) lorsque le travail se fait dans un terminal |
Utilisez les deux modèles dans un flux de travail complet
Un processus pratique pour le GlobalGPT
- Commencez par un cahier des charges et demandez à un modèle de mettre en évidence ses hypothèses.
- Transférez le dossier nettoyé vers l'autre modèle pour le réviser ou obtenir un deuxième avis.
- Utilisez la méthode de codage la plus rigoureuse pour la mise en œuvre, la révision et la production de résultats structurés.
- Conservez le résultat dans le même tableau de bord, puis utilisez la Flux de travail CLI GlobalGPT lorsqu'il doit être intégré à un terminal ou à un outil de production.
Ce flux de travail constitue le principal avantage de l'accès aux deux modèles : vous pouvez acheminer la tâche, plutôt que de devoir réécrire votre processus en fonction d'un seul modèle.

Comment la comparaison a été réalisée
Les deux modèles ont reçu le même message système, les mêmes données d'entrée et le même contenu source, sans utilisation d'outils ni de navigation. Chaque résultat correspond à la première réponse renvoyée, y compris en cas de troncature due à la limite de longueur de sortie. Il s'agit d'une comparaison pratique destinée à faciliter le choix d'un workflow, et non d'un classement universel de toutes les capacités.
Méthode de comparaison
Comment cette comparaison a été réalisée
| État | Règle de comparaison |
|---|---|
| Modèles | Claude Opus 5.5 et GPT-6 Sol : identifiants exacts confirmés dans le répertoire des modèles en ligne |
| Parité des invites | Même message système, même invite de tâche, même document source, pas d'outils ni de navigation |
| Tâches | Vérification des limites T01, comparaison explicite en format long T01R, synthèse de source T02, code/JSON T03 |
| Nouvelles tentatives | Uniquement les échecs liés au transport, à la capacité ou à une enveloppe vide ; les sorties faibles valides sont conservées |
| Marquage | 10 points par tâche validée : contrat objectif 4, traçabilité 3, utilité 2, format 1 |
Le premier test permet de vérifier si un modèle est capable de faire des prédictions lorsque des éléments contextuels clés font défaut ; il est donc réalisé indépendamment du calcul du gagnant. La comparaison directe oppose les deux modèles et leur soumet le même brief. Aucune nouvelle exécution de stabilité n'a été effectuée.
Pourquoi le premier appel à candidatures n'a pas permis de désigner un lauréat
Gestion du contexte
Pourquoi le premier appel à candidatures n'a pas permis de désigner un lauréat
Les deux modèles ont refusé de créer des identités de mannequins, car la consigne initiale ne les mentionnait pas. C'est la réponse appropriée face à un contexte manquant, mais cela ne permet pas de déterminer quel modèle est le plus performant pour cette tâche en soi.
Claude Opus 5,5 · entrée complète
Vous comparez deux modèles d’IA dans le cadre d’un guide d’achat pratique. En vous appuyant uniquement sur le dossier source ci-dessous, rédigez un texte de 700 à 900 mots en respectant strictement les titres suivants : Décision, Éléments probants, Mises en garde, Prochaine étape. Conservez exactement les faits suivants : le projet North a un délai de 12 semaines ; le budget de migration s’élève à $48 000 ; l’audit de sécurité n’est pas programmé. Si un fait n’est pas tranché, indiquez-le explicitement. N’inventez pas de prix, de benchmarks ou de fonctionnalités de produit.

DOCUMENTATION DE RÉFÉRENCE :
Le projet North est une migration d’une durée de 12 semaines pour une équipe de 40 personnes. Le budget de migration approuvé s’élève à $48 000. La date de l’audit de sécurité n’a pas encore été fixée. L’équipe souhaite une recommandation de modèle pour la recherche, la rédaction et la révision du code. Une note d’une partie prenante indique que le projet actuel est trop long, mais ne précise pas le nombre de mots.

Renvoyez uniquement le guide.
Claude Opus 5,5 · puissance maximale
## Décision

Le dossier fourni ne permet pas de formuler de recommandation entre les deux modèles. Il ne mentionne ni le nom d’un modèle, ni les prix, ni les résultats de tests comparatifs, ni les fonctionnalités des produits. Privilégier un modèle par rapport à l’autre à ce stade reviendrait à inventer les éléments probants sur lesquels ce guide est censé s’appuyer.

La décision pratique consiste à reporter le choix du modèle. Considérez la phase suivante comme une évaluation structurée régie par trois contraintes fixes :

- Le projet North a un délai de 12 semaines.
- Le budget de migration s’élève à $48 000.
- L’audit de sécurité n’est pas encore programmé.

Tout modèle retenu devra respecter le délai de 12 semaines et le budget de migration de $48 000. Il doit également passer avec succès un contrôle de sécurité, et ce contrôle n’est pas encore inscrit au calendrier. Tant que les deux modèles n’auront pas été identifiés et évalués au regard des trois utilisations énoncées par l’équipe (recherche, rédaction et révision de code), la sélection restera en suspens. Ce guide l’énonce clairement, plutôt que de proposer une préférence que les éléments disponibles ne permettent pas d’étayer.

## Données factuelles

Le dossier source contient les faits suivants, et seuls ces faits servent de base au présent guide :

- **Portée et calendrier :** le projet North est une migration d’une durée de 12 semaines.
- **Taille de l’équipe :** la migration concerne une équipe de 40 personnes.
- **Budget :** le budget approuvé pour la migration s’élève à $48 000.
- **Sécurité :** le calendrier de l’examen de sécurité n’a pas encore été fixé.
- **Cas d’utilisation :** l’équipe souhaite une recommandation de modèle pour la recherche, la rédaction et la révision du code.
- **Retour des parties prenantes :** Une note d’une partie prenante indique que le projet actuel est trop long, mais ne précise pas le nombre de mots.

Le dossier ne contient pas plusieurs éléments sur lesquels repose habituellement une comparaison. Il n’identifie pas les deux modèles comparés. Il ne précise pas les tarifs par poste, par jeton ou par abonnement pour l’une ou l’autre des options. Il ne fournit aucun score de benchmark ni aucun résultat issu de tests internes. Il ne décrit pas ce que chaque modèle peut ou ne peut pas faire en matière de recherche, de rédaction ou de révision de code. Il ne mentionne rien concernant les conditions de traitement des données, les options de déploiement ou les exigences d’intégration.

Comme aucun de ces éléments ne figure dans le dossier, le présent guide ne procède à aucune estimation à leur sujet. On ignore si l’un ou l’autre des modèles s’inscrit dans le budget de $48 000 prévu pour une équipe de 40 personnes. On ignore également si l’un ou l’autre des modèles offre de meilleures performances en matière de recherche, de rédaction ou de révision de code. Tout chiffre ou affirmation concernant les capacités ajouté ici serait inventé de toutes pièces.

## Mises en garde

Plusieurs questions en suspens ont une incidence sur la manière dont cette décision doit être interprétée.

**L’identité des modèles n’est pas précisée.** La comparaison porte sur deux modèles d’IA, mais le dossier ne précise pas lesquels. Tout jugement ultérieur dépend de la réponse à cette question préalable.

**La portée du budget n’est pas précisée.** Le dossier qualifie le chiffre de $48 000 de " budget de migration approuvé ". Il ne précise pas si ce montant est destiné à couvrir les frais de licence ou d’utilisation des modèles. Il pourrait au contraire ne couvrir que les travaux de migration, tels que le temps de travail du personnel, les outils ou les services. Si les coûts liés aux modèles doivent être prélevés sur ce même montant de $48 000, la marge de manœuvre financière pour l’un ou l’autre modèle est plus restreinte que ne le laisse supposer le chiffre annoncé. Cela doit être confirmé.

**Le calendrier de l’évaluation de sécurité n’est pas défini et constitue un risque pour le respect des délais.** L’évaluation de sécurité n’est pas programmée. Avec un délai de 12 semaines, l’absence de date fixée pour cette évaluation constitue un risque réel pour le calendrier. Le dossier ne précise pas la durée de l’évaluation ni si un échec obligerait à opter pour l’autre modèle. Ces deux scénarios pourraient mobiliser une part significative des 12 semaines. Aucun modèle ne doit être considéré comme approuvé tant que l’évaluation n’est pas terminée.

**La pondération des cas d’utilisation n’est pas définie.** L’équipe a identifié trois cas d’utilisation : la recherche, la rédaction et la révision de code. Le dossier ne précise pas si ces cas ont tous la même importance ou si l’un d’entre eux prédomine. Un modèle plus performant dans un domaine pourrait s’avérer moins performant dans un autre, et sans pondération, il n’existe aucune base permettant de trouver un compromis entre ces différents aspects.

**Le volume d’utilisation reste à déterminer.** L’équipe compte 40 personnes, mais le dossier ne précise pas combien d’entre elles utiliseront le modèle ni à quelle fréquence. Le volume d’utilisation pourrait fortement influer sur le coût selon certaines structures tarifaires. Cela ne peut être évalué sans données tarifaires ni estimations d’utilisation.

**La durée d’instruction con
GPT-6 Sol · entrée complète
Vous comparez deux modèles d’IA dans le cadre d’un guide d’achat pratique. En vous appuyant uniquement sur le dossier source ci-dessous, rédigez un texte de 700 à 900 mots en respectant strictement les titres suivants : Décision, Éléments probants, Mises en garde, Prochaine étape. Conservez exactement les faits suivants : le projet North a un délai de 12 semaines ; le budget de migration s’élève à $48 000 ; l’audit de sécurité n’est pas programmé. Si un fait n’est pas tranché, indiquez-le explicitement. N’inventez pas de prix, de benchmarks ou de fonctionnalités de produit.

DOCUMENTATION DE RÉFÉRENCE :
Le projet North est une migration d’une durée de 12 semaines pour une équipe de 40 personnes. Le budget de migration approuvé s’élève à $48 000. La date de l’audit de sécurité n’a pas encore été fixée. L’équipe souhaite une recommandation de modèle pour la recherche, la rédaction et la révision du code. Une note d’une partie prenante indique que le projet actuel est trop long, mais ne précise pas le nombre de mots.

Renvoyez uniquement le guide.
GPT-6 Sol · sortie complète
## Décision

Ne désignez pas encore de modèle gagnant. Le paquet source demande une recommandation entre deux modèles d’IA, mais il n’identifie aucun des deux modèles et ne fournit pas de résultats issus de recherches, de documents écrits ou d’une revue de code. Affirmer que l’un est meilleur que l’autre serait donc sans fondement. La recommandation pratique consiste à comparer les deux candidats par rapport au travail de l’équipe avant de faire un choix.

Le projet North a un délai de 12 semaines. Le budget de migration s’élève à $48 000. L’audit de sécurité n’est pas programmé. Ces éléments rendent la décision urgente, mais ne justifient pas de se lancer dans des conjectures. Un choix judicieux doit tenir compte de la capacité du modèle à aider l’équipe de 40 personnes à accomplir ses tâches concrètes, de la manière dont son utilisation s’inscrit dans le budget approuvé, et des incertitudes qui subsistent tant que la date de l’évaluation de sécurité n’est pas connue.

Considérez la recommandation comme conditionnelle : choisissez le modèle qui offre les meilleures performances sur des tâches représentatives, qui peut être utilisé dans les limites du budget de migration approuvé et qui satisfait à toute évaluation requise pour l’usage prévu. Si aucun des candidats ne remplit ces conditions, le guide devrait indiquer qu’aucun des deux ne peut encore être recommandé. Les informations disponibles ne permettent pas d’établir que l’une ou l’autre de ces conditions a été remplie.

## Éléments probants

L’équipe souhaite une recommandation de modèle pour trois types de tâches : la recherche, la rédaction et la révision de code. Il s’agit là des catégories de comparaison appropriées, car elles découlent du besoin exprimé et non d’hypothèses sur les atouts du produit. Le dossier ne contient aucun exemple de résultat produit par l’un ou l’autre modèle, aucun résultat d’évaluation, ni aucune description de ce qu’offrent les deux candidats. Il ne contient pas non plus de prix ni de repères de performance. Par conséquent, il n’existe aucune base factuelle permettant de classer les modèles en fonction de leur précision, de leur rapidité, de leur qualité, de leur coût ou de leur adéquation.

Le contexte du projet fournit toutefois des critères de décision utiles. Le projet North consiste en une migration pour une équipe de 40 personnes ; une comparaison doit donc refléter les tâches que les membres de cette équipe seraient réellement amenés à effectuer. Le budget de migration approuvé s’élève à $48 000 ; toute proposition d’utilisation d’un modèle doit être évaluée par rapport à ce montant plutôt qu’à une enveloppe fictive allouée aux outils d’IA. L’examen de sécurité n’est pas programmé, ce qui laisse en suspens la question du calendrier de cet examen — et de son impact sur l’adoption.

Une partie prenante a déclaré que le projet actuel était trop long, mais n’a pas fourni de nombre de mots. Cela témoigne d’une préférence pour la concision, et non d’une limite mesurable pour la production du modèle. Lorsqu’ils comparent des échantillons de rédaction, les évaluateurs peuvent déterminer si chaque candidat respecte la consigne de concision et conserve les faits essentiels. Ils ne doivent pas prétendre qu’un modèle ou l’autre respecte une limite de mots spécifiée par les parties prenantes, car aucune n’a été fournie.

En matière de recherche, il serait utile de vérifier si chaque candidat distingue les faits fournis des questions ouvertes et évite les conclusions non étayées. En matière de rédaction, il s'agirait de déterminer si chaque candidat produit un projet clair et suffisamment concis sans pour autant négliger les contraintes. Pour la revue de code, il s'agirait de vérifier si chaque candidat identifie les problèmes dans un exemple fourni et les explique d’une manière permettant au réviseur de les vérifier. Il s’agit là de tests proposés, et non de conclusions concernant l’un ou l’autre des modèles.

## Mises en garde

La principale mise en garde est que les candidats eux-mêmes ne sont pas identifiés : le dossier ne les nomme pas. Il ne précise pas non plus comment l’équipe pourrait y accéder, quel en serait le coût, ni si l’un ou l’autre est disponible pour le travail envisagé. Il ne faut pas déduire de capacité produit de l’expression “ modèles d’IA ”. Même une comparaison bien conçue ne peut déboucher sur une recommandation de produit tant que les candidats et les éléments d’évaluation ne sont pas connus.

Le budget de migration est approuvé, mais le dossier n’en alloue aucune partie à l’utilisation ou aux tests des modèles. Ne considérez pas le montant de $48 000 comme un budget d’achat dédié à l’IA. De même, un délai de 12 semaines ne fixe pas de date à laquelle l’examen de sécurité aura lieu. L’examen de sécurité n’étant pas programmé, la question de savoir si et quand un candidat pourrait être utilisé conformément aux exigences de l’équipe reste en suspens.

Les trois utilisations demandées peuvent également produire des résultats différents. Un candidat pourrait être préférable pour une tâche et pas pour une autre ; le dossier ne fournit aucune base permettant de supposer qu’il y ait un seul gagnant pour la recherche, la rédaction et la révision du code. Une recommandation devrait mettre en évidence ce type de compromis plutôt que de le dissimuler sous une étiquette globale. Si l’équipe décide qu’une catégorie prime sur les autres, cette priorité devrait émaner des parties prenantes, et non de ce guide.

Enfin, la remarque selon laquelle le projet est trop long ne doit pas être confondue avec une preuve de la performance du modèle. Elle décrit les commentaires sur une ébauche actuelle, sans identifier son auteur ni indiquer de longueur cible. Elle peut éclairer la manière dont la recommandation finale sera présentée, mais elle ne peut pas trancher la comparaison.

## Étape suivante

Identifiez les deux candidats et demandez à l’équipe de leur attribuer des tâches représentatives en matière de recherche, de rédaction et de révision de code. Fournissez à chaque modèle les mêmes supports et instructions pour chaque tâche, y compris des consignes visant à signaler les incertitudes et à éviter d’ajouter des faits. Demandez aux évaluateurs de noter ce que chaque réponse a correctement identifié, ce qu’elle a omis et quelles affirmations nécessitent une vérification. Séparez les observations spécifiques à chaque tâche afin qu’un excellent échantillon de rédaction ne se substitue pas à des preuves concernant la révision de code.

Avant de faire votre choix, vérifiez que le coût de l’utilisation prévue respecte le budget de migration de $48 000 et déterminez quand l’évaluation de sécurité pourra avoir lieu. Aucune de ces réponses ne figure dans le dossier. Si ces questions ne peuvent être résolues à temps pour prendre une décision, signalez clairement cette contrainte plutôt que de présenter une préférence provisoire comme un choix approuvé.

La recommandation finale à l’acheteur peut alors être concise et vérifiable : citez les candidats, exposez les éléments probants pour chacune des trois utilisations, expliquez les éventuels compromis et identifiez les questions en suspens concernant l’approbation ou le budget. Tant que ces informations ne sont pas disponibles, la réponse honnête pour le projet North n’est ni “ Modèle A ” ni “ Modèle B ”. Elle est que la comparaison n’est pas encore étayée par des preuves.
Considérez cela comme une vérification du contexte, et non comme un classement de qualité.
Rédaction longue
Réalisation dans le respect du même plafond de production de 2 400 jetons
Ce même brief comportait cinq sections. Les deux modèles disposaient d'une limite de 2 400 tokens pour la sortie ; les métadonnées fournies expliquent la différence visible.
Claude a atteint le plafond de sortie configuré avant la règle de décision. Sol a terminé le résumé en respectant ce plafond. Cela vient étayer une recommandation relative à cette exécution sous contrainte, et non un classement général des capacités ou de la vitesse maximales de rédaction. Le texte complet renvoyé, y compris la réponse tronquée, est reproduit ci-dessous.
Exercice de longue durée
Rédaction de textes longs : GPT-6 Sol a rédigé le texte conformément au brief
Il s'agit de la première tâche de comparaison directe. La consigne mentionnait explicitement Claude Opus 5,5 et GPT-6 Sol, a remis à chacun d'eux le même dossier d'information sur le projet « Project North » et a exigé une note de décision conditionnelle.
| Mesure | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Longueur visible | 648 mots ; finish_reason=longueur | 1 065 mots ; finish_reason=stop |
| Champs obligatoires | 4 sur 5 ; règle de décision manquante après troncature | 5 sur 5 |
| Tableau de bord à quatre colonnes | Présent et symétrique | Présent et symétrique |
| Vérifications du pilote / condition d'arrêt | Commencé mais interrompu avant d'être achevé | Trois vérifications et une condition d'arrêt |
| Score | 7.0 / 10 | 10.0 / 10 |
À emporter : Avec le même plafond de sortie de 2 400 jetons, GPT-6 Sol a restitué les cinq sections, tandis que Claude Opus 5.5 a atteint ce plafond avant la règle « Decision ». Cela démontre que la tâche a été menée à bien dans cette configuration ; cela ne permet toutefois pas de déterminer la capacité maximale de rédaction ni la vitesse générale de l’un ou l’autre modèle.
Entrée complète partagée
Vous rédigez une note de décision destinée à une équipe devant choisir entre le Claude Opus 5.5 et le GPT-6 Sol. Les noms des modèles sont fixes et doivent apparaître exactement tels qu’ils sont écrits. En vous appuyant uniquement sur le dossier de données ci-dessous, rédigez un texte de 900 à 1 100 mots comprenant exactement les sections suivantes : Recommandation de la direction ; Ce que les données étayent ; Ce qui manque dans les données ; Projet pilote de 30 jours ; Règle de décision.

Exigences : (1) comparez le Claude Opus 5.5 et le GPT-6 Sol de manière symétrique ; (2) distinguez les données observées, les hypothèses et les inconnues ; (3) conservez les dates exactes, le budget, la taille de l’équipe et le statut de sécurité non résolu ; (4) incluez un tableau de bord concis de quatre lignes couvrant la synthèse de la recherche, la rédaction d’un texte détaillé, la révision du code et le JSON structuré ; (5) formulez une recommandation conditionnelle plutôt que de désigner un gagnant ; (6) énumérer trois vérifications pilotes mesurables et une condition d'arrêt ; (7) ne pas inventer de prix, de benchmarks, de limites contextuelles ou de capacités du produit.

DOSSIER DE PREUVES
- Le projet North est une migration de 12 semaines pour une équipe de 40 personnes.
- Le budget de migration approuvé s’élève à $48 000. Le dossier ne précise pas si l’utilisation du modèle est comprise dans ce budget.
- Le calendrier de l’examen de sécurité n’est pas défini.
- L’équipe a besoin d’une synthèse de recherche, de rédaction de textes longs, d’une révision de code et d’une extraction JSON structurée.
- Une partie prenante estime que la version préliminaire actuelle est trop longue, mais aucun nombre de mots cible n’a été approuvé.
- Aucun résultat contrôlé issu de Claude Opus 5.5 ou de GPT-6 Sol n’a encore été fourni.
- L’équipe souhaite un choix vérifiable et peut mener un projet pilote de 30 jours avec des invites identiques et une révision humaine.

Renvoyez uniquement la note de service. Ne prétendez pas que le dossier de preuves démontre que l’un des modèles est meilleur que l’autre.
Claude Opus 5,5 · sortie complète renvoyée
## Recommandation de la direction

Ne sélectionnez pas encore Claude Opus 5.5 ni GPT-6 Sol. Le dossier de référence ne contient aucun résultat contrôlé provenant de l’un ou l’autre de ces modèles. Il n’existe donc aucune base factuelle permettant de déclarer l’un meilleur que l’autre pour l’une quelconque des quatre charges de travail requises.

Cette recommandation est conditionnelle. Menez un projet pilote de 30 jours consistant à fournir des invites identiques aux deux modèles et à leur appliquer le même examen humain. Sélectionnez ensuite le modèle qui respecte les seuils convenus avant le début du projet pilote, à condition que les questions de sécurité et de budget ci-dessous soient d’abord résolues. Trois résultats sont possibles :

- **Un modèle franchit les seuils :** choisissez ce modèle.
- **Les deux les franchissent :** appliquez les critères de départage prévus dans la règle de décision.
- **Aucun ne les franchit :** n’en adoptez aucun.

Cette approche offre à l’équipe le choix vérifiable qu’elle a demandé.

Les données fixes du projet sont les suivantes :

- Le projet North est une migration de 12 semaines pour une équipe de 40 personnes.
- Le budget de migration approuvé est de $48 000. Le dossier ne précise pas si l’utilisation des modèles est comprise dans ce budget.
- Le calendrier de l’examen de sécurité n’est pas défini.
- Le dossier ne fournit aucune date (ni date de début, ni date de fin, ni période de pilote du projet) ; cette note n’en attribue donc aucune.

## Ce que les éléments probants confirment

**Éléments probants observés.** Il s’agit des faits directement mentionnés dans le dossier :

- Le projet North est une migration de 12 semaines pour une équipe de 40 personnes.
- Le budget de migration approuvé s’élève à $48 000, et il n’est pas précisé si l’utilisation du modèle est incluse dans ce budget.
- Le calendrier de l’examen de sécurité n’est pas fixé.
- Les charges de travail requises sont la synthèse de recherches, la rédaction de textes longs, la révision de code et l’extraction structurée de données JSON.
- Une partie prenante estime que le projet actuel est trop long, mais aucun nombre de mots cible n’a été approuvé.
- Aucun résultat contrôlé issu de Claude Opus 5.5 ou de GPT-6 Sol n’a été fourni.
- L’équipe souhaite un choix vérifiable et peut mener un projet pilote de 30 jours avec des invites identiques et une révision humaine.

**Ce que cela étaye.** Les éléments probants définissent ce qui doit être évalué et comment, mais pas quel modèle l’emporte. Ils justifient un projet pilote structuré et comparatif. Elles ne justifient aucune affirmation concernant la qualité, la vitesse, le coût, la gestion du contexte ou la disponibilité des fonctionnalités pour l’un ou l’autre des modèles.

**Tableau de bord (état actuel des données)**

| Charge de travail | Claude Opus 5.5 | GPT-6 Sol | Mesure du projet pilote |
|---|---|---|---|
| Synthèse de recherche | Aucun résultat de référence fourni | Aucun résultat de référence fourni | Note attribuée selon la grille d’évaluation par un évaluateur en aveugle |
| Rédaction longue | Aucun résultat de référence fourni | Aucun résultat de référence fourni | Note attribuée selon la grille d’évaluation et respect d’un objectif de longueur approuvé |
| Révision de code | Aucun résultat contrôlé fourni | Aucun résultat contrôlé fourni | Pourcentage de problèmes connus identifiés |
| JSON structuré | Aucun résultat contrôlé fourni | Aucun résultat contrôlé fourni | Taux de réussite à la validation du schéma |

Toutes les cellules des deux modèles sont identiques, car le dossier les traite de la même manière. Aucune ligne ne favorise actuellement l’un ou l’autre modèle.

## Où les éléments de preuve font défaut

**Incertitudes.** Le dossier ne fournit aucune précision sur les points suivants :

- Si les coûts d’utilisation des modèles s’inscrivent dans le budget de migration de $48 000 ou s’ils nécessitent un financement distinct.
- Quand aura lieu l’évaluation de sécurité, ce qu’elle couvrira et si l’un ou l’autre des modèles est acceptable dans ce cadre. Le statut de sécurité reste en suspens pour les deux modèles.
- Les dates de la migration de 12 semaines et de la phase pilote de 30 jours.
- Un nombre de mots cible approuvé pour la rédaction de textes longs. Sans cela, le commentaire " trop long " formulé par la partie prenante ne peut pas être évalué.
- La tarification, les résultats des tests comparatifs, les limites de contexte et les capacités des produits pour Claude Opus 5.5 et GPT-6 Sol. Aucune de ces informations n’est fournie, et la présente note n’émet aucune hypothèse à ce sujet.
- L’identité des réviseurs humains, leur nombre et la manière dont les désaccords entre eux seront résolus.
- Les données que le projet pilote pourra utiliser avant la fin de l’examen de sécurité.

**Hypothèses.** Il s’agit de propositions formulées dans cette note, et non de faits tirés du dossier, et chacune d’entre elles nécessite l’approbation de l’équipe :

- Le projet pilote peut utiliser des données non sensibles ou synthétiques jusqu’à ce que l’examen de sécurité autorise l’utilisation de données réelles.
- Les évaluateurs peuvent ne pas savoir quel modèle a produit chaque résultat.
- L’équipe peut constituer un ensemble fixe de prompts pour chaque charge de travail, représentant les tâches réelles du projet North.
- Les seuils de réussite proposés ci-dessous constituent des points de départ que l’équipe peut modifier avant le début du projet pilote, mais pas pendant celui-ci.

## Projet pilote de 30 jours

**Conception**

1.
GPT-6 Sol · sortie complète renvoyée
## Recommandation de la direction

Ne choisissez pas encore Claude Opus 5.5 ni GPT-6 Sol. Le projet North est une migration de 12 semaines pour une équipe de 40 personnes, et le dossier ne fournit aucun résultat validé pour aucun des deux modèles. Il s’agit donc d’un plan de comparaison, et non d’un verdict sur les performances. Réalisez le pilote de 30 jours disponible avec des invites identiques et une révision humaine, puis faites un choix justifiable par rapport aux critères convenus avant d’examiner les résultats. Ne choisissez l’un ou l’autre modèle que si son travail évalué répond aux besoins de l’équipe, si son utilisation s’inscrit dans le cadre de l’accord financier approuvé et si l’évaluation de sécurité en cours autorise son adoption. Si ces conditions ne sont pas remplies, reportez la sélection plutôt que de considérer une comparaison incomplète comme un succès.

Le budget de migration approuvé s’élève à $48 000. Le dossier ne précise pas si l’utilisation du modèle est comprise dans ce budget. Le calendrier de l’évaluation de sécurité n’est pas fixé. Il s’agit là de contraintes décisionnelles valables tant pour le Claude Opus 5.5 que pour le GPT-6 Sol, et non d’arguments en faveur de l’un ou de l’autre.

## Ce que les éléments probants confirment

**Constat :** L’équipe a besoin d’une synthèse de recherche, de rédaction de longs textes, d’une révision de code et d’une extraction JSON structurée. Elle souhaite un choix vérifiable et peut mener un projet pilote de 30 jours en utilisant des prompts identiques et une révision humaine. Une partie prenante estime que le projet actuel est trop long, mais aucun nombre de mots cible n’a été approuvé. Ce retour d’information identifie un point à tester concernant les résultats écrits ; il n’établit pas de modèle préféré ni de longueur acceptable.

Le tableau de bord actuel, qui présente les tâches une par une, n’est délibérément pas classé :

| Axe de travail | Claude Opus 5,5 | GPT-6 Sol | Données à collecter dans le cadre du projet pilote |
|---|---|---|---|
| Synthèse de recherche | Pas encore testé | Pas encore testé | Précision, couverture et traçabilité évaluées par les réviseurs |
| Rédaction longue | Pas encore testé | Pas encore testé | Utilité, clarté et concision évaluées par les évaluateurs |
| Révision de code | Pas encore testé | Pas encore testé | Conclusions vérifiées par les évaluateurs et affirmations non étayées |
| JSON structuré | Pas encore testé | Pas encore testé | Résultats valides et extraction correcte des champs |

**Hypothèse de planification, et non résultat observé :** Des échantillons de travail comparables et une grille d’évaluation commune peuvent révéler des différences pertinentes pour le projet North. Le projet pilote devrait tester cette hypothèse. Des consignes identiques ne suffiront pas à elles seules à rendre le choix vérifiable : l’équipe doit également conserver les données d’entrée, les deux résultats, les critères d’évaluation, les jugements des évaluateurs et les raisons de toute exclusion ou nouvelle exécution. L’évaluation humaine doit appliquer la même norme à chaque modèle.

Pour les textes longs, les évaluateurs doivent distinguer “ trop long ” de “ pas utile ”. Une réponse plus courte pourrait omettre des éléments nécessaires ; une réponse plus longue pourrait tout de même être claire et exploitable. Comme aucun nombre de mots cible n’est approuvé, le projet pilote peut enregistrer la longueur et les jugements des évaluateurs, mais ne doit pas déclarer rétroactivement qu’un nombre de mots arbitraire constitue la norme d’acceptation. La même rigueur s’applique aux autres tâches : consigner ce que les évaluateurs ont observé, plutôt que de transformer des préférences en affirmations sur les capacités générales du modèle.

## Manque de données probantes

**Inconnu :** Le dossier ne contient aucun résultat contrôlé provenant de Claude Opus 5.5 ou de GPT-6 Sol. Il n’établit aucune qualité relative, fiabilité ou adéquation pour aucun des quatre axes de travail. Il ne fournit pas non plus de prix, de contraintes contextuelles, de références comparatives ni d’informations sur les capacités du produit. Cette note ne permet donc pas d’estimer le coût d’utilisation ni de déterminer quel modèle serait le plus performant sur les données du projet North.

Les limites budgétaires doivent être clarifiées avant toute décision d’achat. Le montant de $48 000 correspond au budget de *migration* approuvé ; il n’est pas précisé si l’utilisation des modèles doit être financée par ce budget. Le considérer comme inclus ou comme supplémentaire entraînerait une hypothèse financière que le dossier ne justifie pas. L’équipe doit documenter la réponse et la procédure d’approbation applicable avant de s’engager dans une utilisation à long terme.

La question de la sécurité reste également en suspens pour les deux candidats. Aucun calendrier n’est prévu pour l’examen de sécurité, et le dossier ne fournit aucun résultat en la matière. Même un résultat de pilote très positif ne résoudrait pas ce problème. L’équipe doit identifier qui est habilité à planifier et à décider de cet examen, quelles informations le responsable de l’examen requiert, et si l’activité pilote elle-même est autorisée au regard des règles applicables ; le dossier ne répond pas à ces questions. Aucune date de début ou de fin n’est fournie pour la migration, le projet pilote ou l’examen de sécurité ; l’équipe ne doit donc pas laisser entendre qu’une décision en matière de sécurité sera prise au cours des 30 jours du projet pilote ou des 12 semaines de migration.

## Projet pilote de 30 jours

Avant la première comparaison, l’équipe doit sélectionner des requêtes représentatives pour les quatre axes de travail, définir la forme attendue de chaque réponse et s’accorder sur une grille d’évaluation par un examinateur humain. Les deux modèles doivent recevoir des requêtes identiques et les mêmes instructions d’évaluation. Les évaluateurs doivent fonder leurs jugements sur le travail lui-même plutôt que sur la réputation d’un modèle. Conserver la consigne, le résultat, l’évaluation et toute correction demandée afin qu’un lecteur ultérieur puisse reconstituer chaque jugement. Consigner les écarts par rapport au processus habituel au lieu d’écarter silencieusement les cas difficiles.

Utiliser trois critères d’évaluation mesurables :

1. **Qualité des tâches évaluées :** pour la synthèse de recherche, la rédaction de textes longs et la révision de code, calculez la proportion de résultats que les évaluateurs acceptent pour la tâche définie. Consignez également séparément les motifs de rejet — par exemple, une couverture insuffisante, un texte peu clair ou un constat de révision de code non vérifié. Présentez les résultats par axe de travail et par modèle, et non sous la forme d’un simple score global.
2. **Fiabilité du JSON structuré :** Comptez les résultats qui correspondent à la structure convenue et ceux dont les champs extraits sont validés comme corrects par un réviseur. Rendez compte des deux taux pour Claude Opus 5.5 et GPT-6 Sol ; une réponse structurellement valide ne doit pas être considérée comme exacte uniquement parce qu’elle est analysable.
3. **Effort de révision et traçabilité :** Enregistrez le temps de travail nécessaire pour vérifier et, le cas échéant, corriger chaque résultat. Comptez les cas pour lesquels les preuves conservées sont insuffisantes pour justifier la décision du réviseur. Comparez ces mesures sur le même ensemble de prompts, y compris les cas où aucun des deux résultats n’est acceptable.

Convenir des critères d’acceptation et de la manière dont les ex aequo seront traités avant de consulter les résultats du projet pilote ; le dossier ne fournit aucun repère permettant de définir des seuils numériques. À l’issue des 30 jours, publier la grille d’évaluation, les chiffres, les justifications des évaluateurs et les questions en suspens. **Condition d’arrêt :** suspendre l’adoption si les exigences de sécurité pour le projet pilote ou l’utilisation ultérieure ne peuvent être satisfaites, ou si l’équipe ne parvient pas à établir un budget valable et un processus d’approbation. Ne pas substituer des scores de qualité favorables à l’une ou l’autre de ces autorisations.

## Règle de décision

Sélectionnez Claude Opus 5.5 si les résultats de son projet pilote répondent aux normes convenues au préalable, s’ils sont nettement plus performants sur les axes de travail prioritaires de l’équipe et si ses conditions de sécurité et financières sont résolues. Appliquez exactement la même règle à GPT-6 Sol. Si les deux modèles répondent aux normes sans différence significative et pertinente, prenez votre décision en vous appuyant sur les priorités documentées du projet et les contraintes résolues, plutôt que de désigner un gagnant sur la base des performances. Si aucun des deux n’est éligible — ou si les limites budgétaires ou le statut de sécurité restent en suspens —, ne procédez pas encore à la sélection du modèle. Ce résultat permet de conserver une décision vérifiable pour l’équipe de 40 personnes sans aller au-delà de ce que les preuves peuvent étayer.
Métadonnées : Claude — HTTP 200 · 25,98 s · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27,763 s · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
Synthèse par source
Mission de recherche
Synthèse par source : match nul
Les deux modèles ont résolu le conflit concernant la date en retenant le 15 octobre, ont maintenu le budget convenu de $12 000 et ont considéré l'affirmation selon laquelle les données étaient “ toujours exactes ” comme une allégation non étayée de la part du responsable. Il en résulte une égalité pour cette tâche.
| Mesure | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Score | 9.5 / 10 | 9.5 / 10 |
| Gestion des conflits | S2 gère la date limite | S2 gère la date limite |
| Allégation non étayée | Marqué comme « non pris en charge » | Marqué comme « non pris en charge » |
| Différence concrète | Explication plus détaillée des risques | Une recommandation plus concise |
Entrée complète partagée
Réconciliez les notes sources ci-dessous. Renvoyez (1) un tableau au format Markdown comportant les colonnes “ Allégation ”, « Source de référence », « Statut » et « Motif », ainsi que (2) une recommandation d'environ 250 mots. Utilisez uniquement la note de politique la plus récente comme référence pour le conflit de date limite. Indiquez comme « non étayées » les allégations non étayées. N'ajoutez aucun fait.

[S1 01/09/2026] Le projet pilote prend fin le 30 septembre. Le budget est de $12 000.
[S2 03/09/2026] Le projet pilote prend fin le 15 octobre. Le budget reste de $12 000.
[S3 01/09/2026] Le service juridique n’a pas approuvé le partage de données externes.
[S4 04/09/2026] Un responsable affirme que le modèle est « toujours précis » ; aucune preuve issue de tests n’est jointe.
[S5 04/09/2026] L’équipe du projet pilote compte 8 membres.
[S6 05/09/2026] La note de décision doit énumérer les risques non résolus.

Ne renvoyez que le tableau et la recommandation.
Claude Opus 5,5 · production totale
| Revendication | Source prévalente | Statut | Motif |
|---|---|---|---|
| Fin de la phase pilote le 30 septembre | S2 (03/09/2026) | Remplacée | Conflit avec S2. La note datée la plus récemment prévaut en cas de conflit de date limite. |
| Le projet pilote prend fin le 15 octobre | S2 (03/09/2026) | Confirmée (prévalente) | Il s'agit de la note la plus récente concernant le conflit de date limite ; elle prévaut donc sur S1. |
| Le budget est de $12 000 | S1 et S2 | Confirmé | Les deux sources concordent, et S2 précise que le budget " reste " de $12 000. Il n’y a pas de conflit. |
| Le service juridique n’a pas approuvé le partage de données externes | S3 | Confirmé | Affirmation directe non contredite par aucune autre source. |
| Le modèle est " toujours précis " | S4 | Non confirmé | Il s’agit d’une affirmation d’un responsable non étayée par des éléments probants. |
| L'équipe pilote compte 8 membres | S5 | Confirmé | Affirmation directe non contredite. Elle provient d'une seule source. |
| La note de décision doit énumérer les risques non résolus | S6 | Confirmé | Il s'agit d'une exigence explicitement formulée pour la note, qui n'est pas contredite. |

**Recommandation**

La note de décision devrait indiquer le 15 octobre comme date de fin du projet pilote. S2 est la note la plus récente et prévaut en cas de conflit de dates, remplaçant ainsi la date du 30 septembre mentionnée dans S1. La règle de la date la plus récente ne s’applique qu’à ce conflit. Les autres affirmations ont été évaluées en fonction de leurs propres justifications.

Le budget doit être enregistré sous la référence $12 000. Les notes S1 et S2 s’accordent sur ce chiffre ; aucun rapprochement n’est donc nécessaire. L’effectif de l’équipe, composé de huit membres, peut également être inclus. Cette information repose uniquement sur la note S5, mais aucune source ne la contredit.

Le document S6 exige que la note de service énumère les risques non résolus, et les notes en corroborent au moins deux.

- **Partage de données externes :** le service juridique ne l’a pas approuvé (S3). La note de service doit l’indiquer clairement. Elle ne doit pas laisser entendre que le partage de données externes est autorisé pendant la phase pilote.
- **Précision du modèle :** L’affirmation selon laquelle le modèle est " toujours précis " n’est pas étayée. Le document S4 note qu’aucune preuve de test n’est jointe et consigne cette affirmation uniquement comme une déclaration de la direction. La note de service ne devrait pas la présenter comme une conclusion ni s’y appuyer pour justifier des décisions. Elle devrait indiquer que la précision du modèle n’est pas vérifiée tant que des preuves à l’appui n’ont pas été fournies.

Enfin, la note de service devrait brièvement indiquer que la date de fin du projet pilote a changé entre S1 et S2. Les lecteurs pourraient tomber ailleurs sur l’ancienne date du 30 septembre, et cette mention expliquerait pourquoi c’est le 15 octobre qui est retenu. La note de service ne devrait pas ajouter d’explications concernant ce changement, ni de résultats de tests, ni de mises à jour sur le statut juridique, car aucun de ces éléments ne figure dans les notes sources.
GPT-6 Sol · sortie complète
| Affirmation | Source de référence | Statut | Motif |
|---|---|---|---|
| Le projet pilote prend fin le 30 septembre. | S2 (03/09/2026) | Remplacée | La note datée plus tardivement l'emporte en cas de conflit de date limite et fixe celle-ci au 15 octobre. |
| Le projet pilote prend fin le 15 octobre. | S2 (03/09/2026) | Confirmée | La note S2 fournit la date limite faisant foi. |
| Le budget s’élève à $12 000. | S1 et S2 | Confirmée | Les deux notes indiquent le même montant. |
| Le service juridique n’a pas approuvé le partage de données externes. | S3 | Confirmé | S3 l’indique clairement ; aucune note ultérieure ne traite de cette approbation. |
| Le modèle est “ toujours précis ”. | S4 | Non confirmé | Un responsable fait cette affirmation, mais aucune preuve de test n’est jointe. |
| L’équipe du projet pilote compte 8 membres. | S5 | Justifié | S5 précise la taille de l’équipe. |
| La note de décision doit énumérer les risques non résolus. | S6 | Justifié | S6 énonce cette exigence. |

**Recommandation :** Indiquez le 15 octobre comme date de fin du projet pilote dans la note de décision. S2 est postérieure à S1 et résout leur conflit de date limite. Maintenez le budget à $12 000 : les notes s’accordent sur ce montant, le changement de date limite ne justifie donc pas de le modifier. Indiquez que l’équipe du projet pilote compte 8 membres, comme indiqué dans S5.

Énumérez explicitement les risques non résolus, comme l’exige S6. La note doit préciser que le service juridique n’a pas approuvé le partage de données externes, sans laisser entendre que cette approbation a été accordée depuis ou que le partage est autorisé. Elle doit également distinguer la déclaration du responsable concernant l’exactitude d’une conclusion établie. Le S4 consigne la déclaration selon laquelle le modèle est “ toujours précis ”, mais ne fournit aucune preuve issue de tests. Ne présentez pas cette déclaration comme un résultat vérifié.

Limitez le périmètre du rapprochement. Le S2 traite des dates de fin contradictoires ; il ne remplace pas les notes distinctes concernant le service juridique, la précision, la taille de l’équipe ou les exigences relatives à la note de service. Lorsque les notes n’établissent pas de conclusion, laissez la question en suspens plutôt que de formuler une hypothèse. En particulier, le dossier ne corrobore ni l’affirmation selon laquelle le partage de données externes a été approuvé, ni celle selon laquelle l’exactitude du modèle a été démontrée.

La note qui en résulte peut donc utiliser la date limite du 15 octobre et le budget $12 000 tout en identifiant les deux lacunes evidentes dans ces notes : l’absence d’approbation juridique pour le partage de données externes et l’absence de preuves issues de tests pour l’affirmation relative à la précision.
Métadonnées : Claude — HTTP 200 · 12,846 s · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12,322 s · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
Codage et sortie structurée
La différence de codage résidait dans l'explication
Condition de filtrage d'origine : si t
Un élément « None » est considéré comme faux, ce filtre l'ignore donc déjà.
Les deux modèles ont renvoyé un JSON valide contenant les quatre clés demandées et le même correctif minimal. Claude a correctement décrit le filtre existant ; GPT-6 Sol a indiqué à tort qu’un élément « None » provoquerait une erreur. Cette erreur de diagnostic a son importance lorsque le réviseur doit déterminer si un correctif résout bien le problème réel.
Claude a fourni une liste de risques et Sol a fourni une brève description des risques. La consigne n’imposait pas de type particulier pour ce champ ; cette différence ne constitue donc pas une violation du contrat. Le score de Sol pour cette tâche est de 9,0/10 après correction de la déduction d’un demi-point précédemment jugée injustifiée ; la déduction liée à l’exactitude des faits est maintenue.
Tâche de codage
Codage et présentation structurée : la version Claude Opus 5.5 était plus précise
Les deux modèles ont renvoyé un JSON valide contenant les clés demandées et le même correctif minimal. Claude a correctement expliqué que le filtre d'origine ignorait déjà un Aucun élément. GPT-6 Sol a indiqué à tort qu'un Aucun Cet élément provoquerait une erreur. L'invite n'exigeait pas de type particulier pour le champ « risques ».
| Mesure | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Score | 10.0 / 10 | 9.0 / 10 |
| Correctif | Correct et minimaliste | Correct et minimaliste |
| Diagnostic | Permet d'isoler correctement les deux défauts | Exagère l'erreur liée à l'élément « None » |
| Contrat JSON demandé | JSON valide ; les quatre clés sont présentes | JSON valide ; les quatre clés sont présentes |
Entrée complète partagée
Renvoyez uniquement un JSON strict contenant les clés ' diagnosis ', ' patch ', ' tests ' et ' risks '. Analysez cette fonction Python et appliquez-lui un correctif minimal afin que les trois cas soient réussis. Le correctif doit conserver la signature de la fonction.

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

Cas :
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

N'exécutez pas de code et n'incluez pas de balises Markdown ni de texte hors du JSON.
Claude Opus 5,5 · production totale
{"diagnostic" : "Deux défauts, détectés lors de la lecture du code (non exécuté). (a) Cas n° 2 : lorsque `tags` est `None`, le générateur itère sur `None` et lève une exception `TypeError` au lieu de renvoyer `''`. (b) Cas n° 3 : le filtre `if t` s'exécute avant le dépouillement. La balise composée uniquement d’espaces ' ' est considérée comme vraie ; elle passe donc le filtrage et devient ' '. Le résultat est ' sorted(['', 'seo']) ', qui est concaténé à ' ,seo ' au lieu de ' seo '. L’élément None du cas 3 est déjà éliminé par ' if t '. Le cas 1 fonctionne déjà : ' AI ', ' ai ' et ' Code ' sont normalisés en {'ai', 'code'}, ce qui donne ' ai,code '.",,"patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":["assert normalize_tags([' AI ', 'ai', 'Code']) == 'ai,code' # tracé : {'ai','code'} -> 'ai,code'","assert normalize_tags(None) == '' # tracé : (None or []) -> [] -> ''","assert normalize_tags([' ', None, 'SEO']) == 'seo' # tracé : ' ' échoue à t.strip(), None échoue à t, 'SEO' -> 'seo'"],"risques":["Les éléments non-chaînes de caractères, tels que 123, lèveront une erreur AttributeError lors de l'appel à .strip(). Ce comportement reste inchangé par rapport à la version d'origine.","'tags ou []' traite toute entrée considérée comme fausse (par exemple '' ou un tuple vide) comme vide. Cela est cohérent avec le comportement requis None -> ''.","Si une seule chaîne de caractères est passée au lieu d’un itérable de balises, elle est parcourue caractère par caractère. Cela reste inchangé par rapport au comportement d’origine.","Les espaces internes ne sont pas supprimés ; ainsi, ' machine learning ' et ' machine learning ' restent des balises distinctes.","Les tests ont été dérivés uniquement par traçage manuel et n’ont pas été exécutés, conformément aux instructions."]}GPT-6 Sol · sortie complète
{"diagnosis":"La fonction génère une erreur lorsque `tags` est `None` ou contient `None`, et elle conserve les entrées qui deviennent vides après le retrait des espaces.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI " , "ai", "Code" ","expected":"ai,code"},{"input":null,"expected":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"Non exécuté. Les entrées non nulles sont considérées comme des chaînes de caractères."}Métadonnées : Claude — HTTP 200 · 10,832 s · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7,71 s · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
Verdict final
Un choix pratique
Quel modèle correspond le mieux à votre activité ?
GPT-6 Sol arrive en tête de ce premier ensemble de résultats, car il a réussi à compléter le contrat long-form révisé, tandis que Claude Opus 5.5 a atteint le plafond commun de 2 400 jetons. Claude Opus 5.5 arrive en tête de la tâche « code/JSON » en termes de précision diagnostique. Pour la synthèse de code, les deux modèles sont à égalité.
Choisir GPT-6 Sol lorsque la priorité immédiate est de finaliser en une seule fois un long document décisionnel comportant de multiples contraintes. Choisissez Claude Opus 5,5 lorsqu'une analyse de code ou de sortie structurée gagne à bénéficier d'un diagnostic et d'un inventaire des risques plus explicites. Si votre travail combine les deux, attribuez chaque tâche au modèle qui lui convient le mieux, plutôt que d'imposer une solution unique.
GlobalGPT vous offre un moyen pratique de regrouper à la fois vos modèles et le reste de votre flux de travail d'IA au sein d'un seul tableau de bord. La recherche, la rédaction, le codage, les images, la vidéo et les tâches de production via l'interface en ligne de commande peuvent ainsi être regroupés dans un même environnement de travail.
Foire aux questions
Quel modèle est sorti vainqueur de ce comparatif ?
GPT-6 Sol s'est hissé en tête du premier ensemble de résultats, avec un score de 28,5 contre 26,5, après exclusion de la tâche initiale relative aux limites et correction de la déduction du contrat JSON. Cette avance provenait de la réalisation du contrat révisé en version longue dans la même limite de 2 400 tokens ; Claude Opus 5.5 a dominé la tâche de code et de sortie structurée, tandis que la synthèse de source s’est soldée par une égalité.
Pourquoi le premier test de longue durée a-t-il été écarté ?
La consigne initiale ne mentionnait aucun des deux modèles. Les deux modèles ont correctement refusé de deviner les identités manquantes ; cette réponse permet donc de vérifier si un modèle demande le contexte manquant plutôt que de faire semblant de le connaître.
Le modèle Claude Opus 5.5 est-il plus adapté au codage ?
Dans cet exercice portant sur le codage et le format JSON, la méthode Claude Opus 5.5 a permis d'établir un diagnostic plus précis et de dresser une liste structurée des risques. Un seul exercice ne suffit pas pour établir un classement universel en matière de codage.
Le GPT-6 Sol est-il plus adapté à la rédaction ?
GPT-6 Sol a rédigé la note détaillée révisée en respectant les limites demandées dès la première génération. Ce résultat vient étayer la recommandation relative au flux de travail pour ce test précis, et ne constitue pas une affirmation générale valable pour toutes les tâches de rédaction.
Puis-je tester les deux modèles sans changer de plateforme ?
GlobalGPT est un abonnement d'IA multimodèle qui regroupe plusieurs fonctions d'IA au sein d'un même tableau de bord. Il permet d'utiliser le même ensemble de prompts de recherche, de rédaction et de programmation sur différents modèles, tout en centralisant l'ensemble du flux de travail en un seul endroit.
GlobalGPT vous permet de regrouper vos modèles et l'ensemble de votre workflow d'IA en un seul et même endroit. Commencez par le modèle adapté à la tâche immédiate, puis passez par les différentes étapes de recherche, de rédaction, de programmation, de création d'images, de vidéo ou de production via l'interface en ligne de commande (CLI), sans avoir à ouvrir un service distinct pour chaque étape.









