
Le tarif actuel de l'API Gemini 3.1 Pro de Google est de $2 par million de tokens d'entrée et de $12 par million de tokens de sortie pour les prompts ne dépassant pas 200 000 tokens. Au-delà du seuil de 200 000 entrées, les tarifs publiés passent à $4 par million de jetons d'entrée et à $18 par million de jetons de sortie. Les données d'entrée mises en cache sont facturées à 1 TP41T0,20/M ou 1 TP41T0,40/M, plus 1 TP41T4,50 par million de jetons mis en cache par heure pour le stockage.
La page du modèle identifie le point de terminaison comme suit : gemini-3.1-pro-preview, avec une limite d’entrée de 1 048 576 tokens et une limite de sortie de 65 536 tokens. Il prend en charge la réflexion, l’appel de fonctions, l’ancrage de recherche, le contexte URL, l’exécution de code, l’API Batch, Flex et les options de priorité. Ces fonctionnalités expliquent pourquoi ce projet de loi nécessite plusieurs chiffres phares.
Si votre travail est interactif — étudier un cahier des charges, comparer des modèles, écrire du code, puis transmettre le résultat à un agent —GlobalGPT vous offre un espace de travail par abonnement couvrant l'ensemble des modèles et des fonctions d'IA. Les développeurs peuvent également se tourner vers l'API, l'interface de ligne de commande (CLI), la console MCP et l'agent Yukie lorsque le travail doit passer d'un chat à un workflow reproductible. Le tarif de l'API indiqué ci-dessous correspond à la tarification à l'utilisation pratiquée par Google.
- Qu'est-ce que Gemini 3.1 Pro et que signifie la limite de contexte ?
- Tarifs de l'API Gemini 3.1 Pro par million de jetons
- Exemples de coûts de l'API Worked Gemini 3.1 Pro
- En quoi la mise en cache contextuelle modifie la facture
- Les forfaits grand public diffèrent de la facturation par API
- Quand l'API, l'interface de ligne de commande (CLI), le MCP ou un espace de travail multimodèle constituent la solution la plus adaptée
- Les formules pour particuliers et la facturation via API répondent à des besoins différents
- Transformez la grille tarifaire en un véritable devis
- Ce qu'un contexte plus large change concrètement
- Quand un espace de travail vaut mieux qu'un simple registre symbolique
- FAQ
Qu'est-ce que Gemini 3.1 Pro et que signifie la limite de contexte ?
La page de présentation actuelle de Google décrit le modèle « Gemini 3.1 Pro Preview » comme un modèle optimisé pour un raisonnement plus poussé, l'ingénierie logicielle, l'utilisation précise d'outils et les flux de travail en plusieurs étapes impliquant des agents. Ce modèle accepte des données sous forme de texte, d'images, de vidéos, de fichiers audio et de PDF, puis génère une sortie textuelle.
| Détails du modèle | Valeur publiée | Pourquoi est-ce important en termes de coût ? |
|---|---|---|
| Référence du modèle | gemini-3.1-pro-preview | Utilisez l'identifiant exact lors de la mise en correspondance d'une facture ou d'une configuration SDK. |
| Limite de saisie | 1 048 576 jetons | Un contexte étendu est possible, mais les tokens comptent toujours comme données d'entrée. |
| Limite de sortie | 65 536 jetons | Les résultats volumineux peuvent représenter la majeure partie du coût d'une requête. |
| Outils | Réflexion, appel de fonction, ancrage de recherche, contexte URL, exécution de code, mise en cache | L'utilisation d'outils peut entraîner des requêtes ou une consommation de jetons allant au-delà d'une simple invite. |
Tarifs de l'API Gemini 3.1 Pro par million de jetons
La page des tarifs de Google distingue les modes Standard, Batch, Flex, Priority et Contributor. Le tableau ci-dessous reprend le niveau tarifaire standard actuel indiqué pour Gemini 3 Pro Preview, dont le lien vers le modèle identifie gemini-3.1-pro-preview.
| Formule payante standard | Invite ≤ 200 000 jetons | Consigne > 200 000 jetons |
|---|---|---|
| Jetons d'entrée | $2.00 / 1M | $4.00 / 1M |
| Jetons de sortie, y compris la réflexion | $12,00 / 1M | $18,00 / 1M |
| Entrée mise en cache | $0.20 / 1M | $0,40 / 1M |
| Stockage en cache | $4,50 / 1 million de jetons par heure | |
| Recherche Google mise à la terre | 5 000 requêtes/mois réparties entre les modèles Gemini 3 et plus récents ; puis $14 par tranche de 1 000 requêtes | |
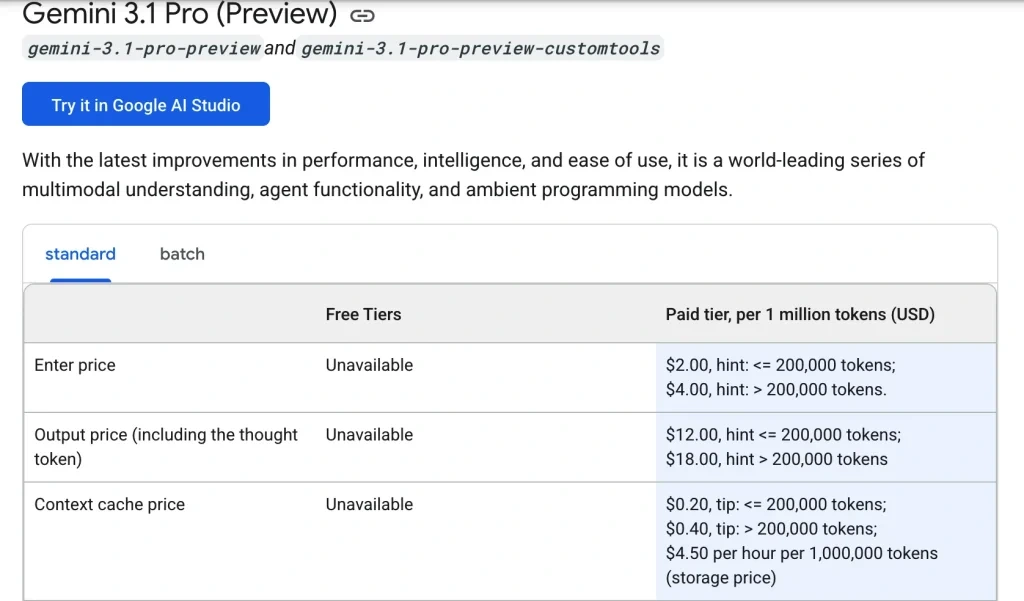
Deux détails peuvent facilement passer inaperçus. Premièrement, le terme “ output ” inclut les jetons de réflexion dans le tableau publié. Deuxièmement, une requête déclenchant l'ancrage dans Google Search peut entraîner des frais de recherche une fois le quota mensuel partagé épuisé. Une réponse type ne constitue pas à elle seule une facture complète.
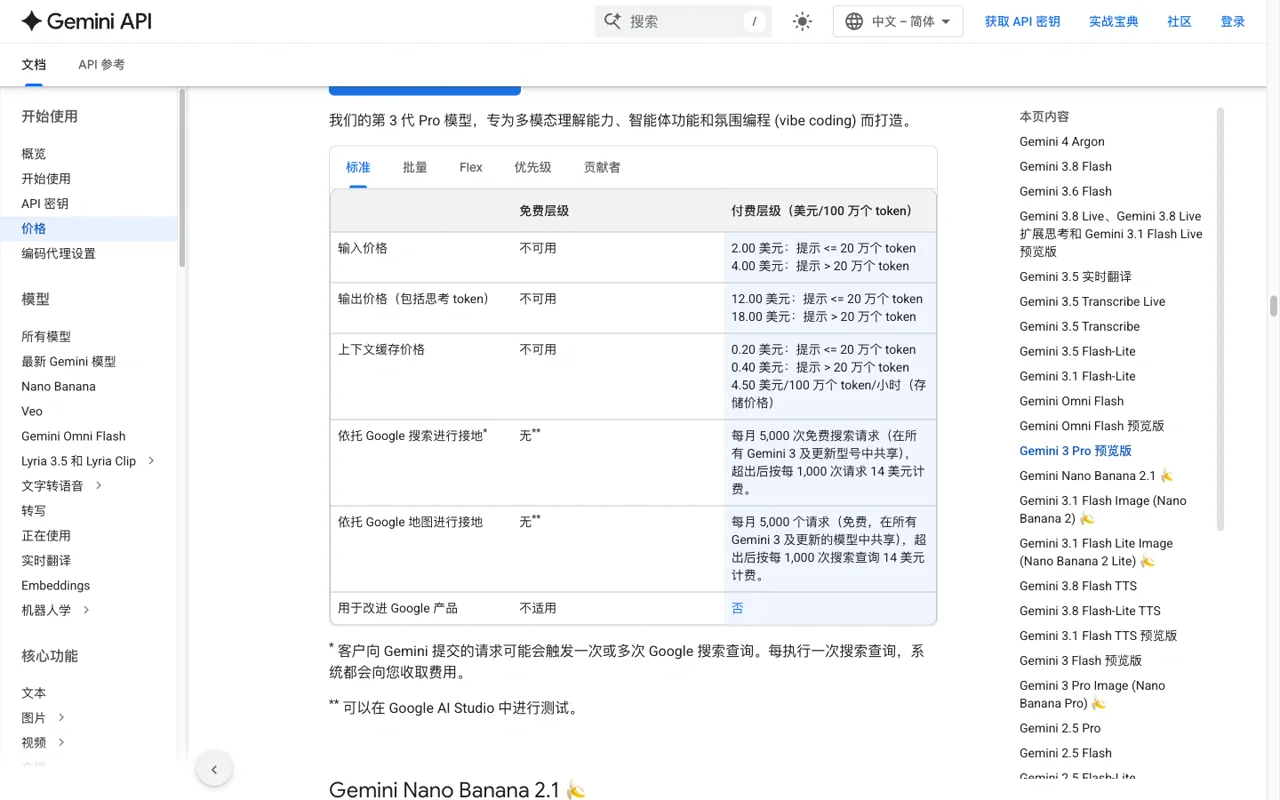
C'est cette limite qui fait qu'une estimation approximative se transforme en une facture différente. Si une requête porte sur une base de code volumineuse ou un contexte récurrent, évaluez la taille de la prompt avant de choisir le modèle ou la stratégie de mise en cache.
Exemples de coûts de l'API Worked Gemini 3.1 Pro
Utilisez le nombre de jetons divisé par 1 000 000, multiplié par le tarif applicable. Les exemples ci-dessous ne tiennent pas compte des taxes, des crédits et des frais spécifiques à l'outil.
| Scénario | Entrée | Sortie | Coût estimé du jeton |
|---|---|---|---|
| Vente à découvert | 50 000 × $2/M = $0,10 | 8 000 × $12/M = $0,096 | $0.196 |
| Consigne d'ingénierie longue | 250 000 × $4/M = $1,00 | 20 000 × $18/M = $0,36 | $1.36 |
| Contexte : 1 million de jetons, résultat : 50 000 | 1 000 000 × $4/M = $4,00 | 50 000 × $18/M = $0,90 | $4.90 |
coût estimé = (jetons d'entrée ÷ 1 000 000 × taux d'entrée) + (jetons de sortie ÷ 1 000 000 × taux de sortie) + frais liés aux outils/recherches éligibles
L'exemple à 250 000 franchit le seuil des 200 000 ; la demande est donc soumise aux tarifs les plus élevés. Si l'application envoie un préfixe volumineux de manière répétée, la mise en cache peut modifier la partie « entrée » de la facture, mais uniquement pour les jetons qui remplissent effectivement les conditions requises pour être considérés comme des entrées mises en cache.
En quoi la mise en cache contextuelle modifie la facture
La mise en cache est utile lorsque les mêmes instructions longues, le même contexte de base de code ou les mêmes données de référence sont envoyés de manière répétée. Pour le niveau standard présenté ci-dessus, les données mises en cache coûtent $0,20/M en dessous de la limite des 200 000 et $0,40/M au-delà, tandis que les jetons stockés en cache coûtent $4,50/M jetons par heure.
Il s'agit d'une option prévue dans la grille tarifaire, et non d'une remise garantie pour chaque demande répétée. Suivez l'utilisation des jetons mis en cache dans les données de facturation du fournisseur et incluez la durée de stockage dans le devis.
Les forfaits grand public diffèrent de la facturation par API
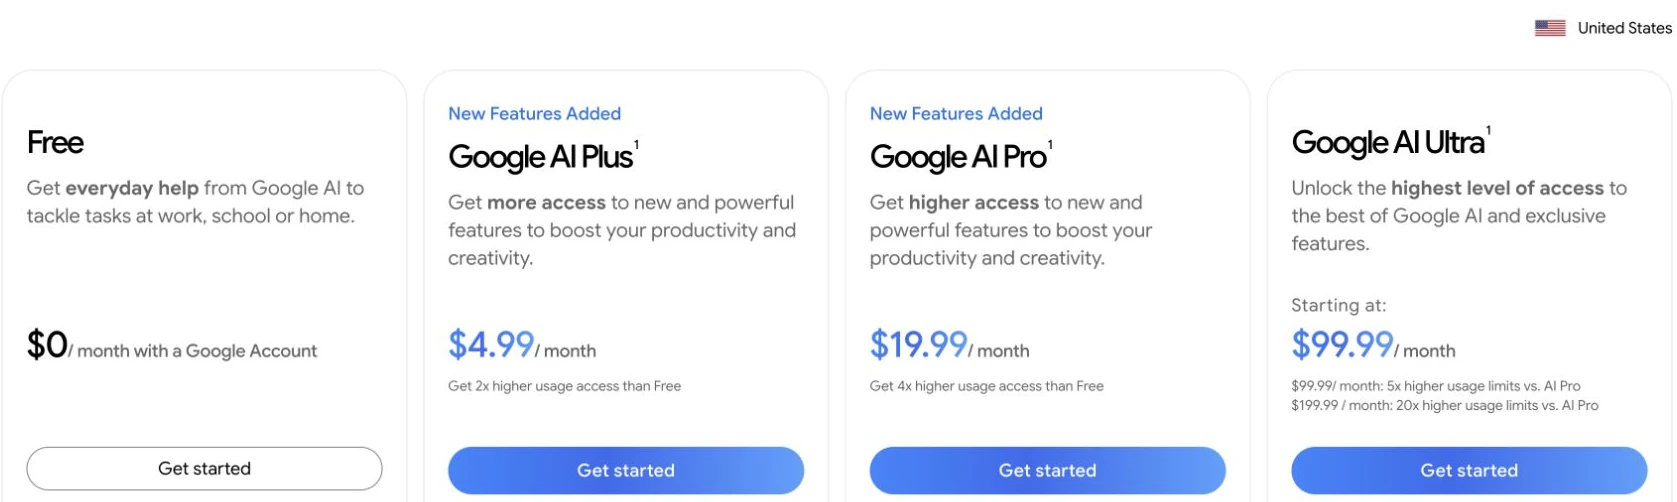
Un abonnement Google AI Pro ou Ultra est une formule grand public comprenant des fonctionnalités d'application et des règles d'accès. La facturation de l'API Gemini est calculée en fonction des jetons et des outils utilisés. Un abonnement grand public ne se transforme pas automatiquement en crédit API, et un projet API ne bénéficie pas automatiquement des avantages réservés aux applications grand public.
Quand l'API, l'interface de ligne de commande (CLI), le MCP ou un espace de travail multimodèle constituent la solution la plus adaptée
Optez pour l'API lorsque votre logiciel nécessite des appels prévisibles et comptabilisés, une clé de fournisseur et une facture que vous pouvez calculer à partir des journaux de jetons. Choisissez une solution CLI ou MCP lorsque le modèle doit fonctionner en parallèle d'un terminal, d'un référentiel ou d'un serveur d'outils existant. Une solution via un agent Yukie est utile lorsque la tâche comporte plusieurs étapes nécessitant une planification et des transferts, plutôt qu’une exécution isolée.
GlobalGPT correspond à l'aspect interactif de cette décision : comparer des modèles, créer des ébauches, examiner les résultats et passer au codage ou à d'autres fonctions d'IA depuis un seul tableau de bord. Son prix et les conditions de ses formules relèvent d'une décision produit distincte ; la grille tarifaire de Google ci-dessus reste la référence pour le coût de l'API Gemini.

Les formules pour particuliers et la facturation via API répondent à des besoins différents
Gemini 3.1 Pro peut apparaître à la fois dans un forfait d'application grand public et dans un flux de travail API pour développeurs, mais il ne s'agit pas de la même facture. Un forfait grand public donne accès à une application et aux limites qui y sont associées. L'API facture les jetons, le stockage en cache et toute utilisation d'outils ou d'infrastructure dans le cadre d'un projet de développement.
| Si vous avez besoin de… | Utilisez l'itinéraire correspondant | Budget d'environ |
|---|---|---|
| Accès à l'application interactive | Offre grand public | Prix du forfait, accès inclus et limites d'utilisation actuelles. |
| Intégration d'un script ou d'un produit | API Gemini | Coûts liés aux intrants, aux extrants, aux intrants mis en cache, au stockage et aux outils. |
| Travail sur le référentiel à côté d'un terminal | Une interface en ligne de commande (CLI) ou un outil connecté à une API | Les appels de modèle ainsi que le flux de travail qui les déclenche. |
| Un processus en plusieurs étapes, de la recherche à la production | MCP ou un agent Yukie | Utilisation du modèle, outils approuvés et nombre de transferts. |
Ne présentez pas un abonnement grand public comme un « crédit API » et n'utilisez pas les tarifs des jetons API pour promettre l'accès à une fonctionnalité de l'application.
Transformez la grille tarifaire en un véritable devis
Commencez par la taille de la requête, et non par le nom du modèle. Comptez les tokens d'entrée, vérifiez si la requête dépasse la limite des 200 000 tokens, estimez le volume de sortie en incluant les tokens de réflexion lorsque la grille tarifaire les prend en compte, puis ajoutez les éventuels frais de recherche ou d'ancrage.
- Demande succincte : jetons saisis ÷ 1 000 000 × le taux d'entrée le plus bas.
- Demande longue : appliquer les débits d'entrée et de sortie les plus élevés à la demande qui dépasse le seuil.
- Contexte répété : ne compter que les tokens pouvant être considérés comme des entrées mises en cache et inclure la durée de stockage en cache.
- Recherche de base : ajouter les frais publiés par demande après le forfait partagé, le cas échéant.
- Prévisions de production : ajouter les tentatives de réessai et les appels d'outils au lieu de multiplier uniquement la première réponse.
Un calculateur de jetons est utile lorsque les données saisies sont visibles. Indiquez la zone, l'unité de facturation et la date à côté du résultat afin qu'un futur lecteur puisse comprendre la signification de ce chiffre.
Ce qu'un contexte plus large change concrètement
Une limite d'entrée d'un million de jetons ne signifie pas que chaque requête doive inclure l'intégralité du référentiel. Les requêtes volumineuses augmentent les coûts et peuvent compliquer l'identification du fichier pertinent. Commencez par un index, envoyez la plus petite partie pertinente, puis n'ajoutez le fichier suivant que si la première réponse montre qu'il est nécessaire.
- Créez un petit schéma du dépôt avant d'envoyer les fichiers sources.
- Dissocier les instructions stables du changement de contexte de tâche.
- Ne mettre en cache un préfixe répété que lorsque le rapport d'utilisation confirme une correspondance.
- Demandez les noms des fichiers et les numéros de ligne afin de pouvoir vérifier le résultat.
- Prévoyez une deuxième étape pour les tests ou les cas limites plutôt que de demander une réécriture sans limites.
C'est là que l'API, l'interface en ligne de commande (CLI) et le MCP s'avèrent utiles : le modèle peut fonctionner en parallèle du projet, tandis que le flux de travail détermine quel contexte est transmis et quel outil est appelé.
Quand un espace de travail vaut mieux qu'un simple registre symbolique
Utilisez l'API lorsque vous avez besoin d'appels d'application prévisibles et d'un suivi au niveau des jetons. Utilisez l'interface en ligne de commande (CLI) lorsque le développement s'effectue dans un terminal. Utilisez MCP lorsque la tâche nécessite des outils externes approuvés. Utilisez un agent Yukie lorsque la tâche englobe la planification, l'utilisation d'outils et les transferts de responsabilité.
Pour les œuvres interactives et les œuvres multimédias, Espace de travail Gemini 3.1 Pro de GlobalGPT vous permet de comparer un modèle, d'écrire du code et de passer aux étapes suivantes : image, vidéo, audio ou agent. L'avantage financier réside dans le fait qu'un seul abonnement couvre une plus grande partie du flux de travail ; le tarif de l'API Google reste facturé séparément par le fournisseur.
FAQ
Combien coûte le Gemini 3.1 Pro par million de jetons ?
Pour le niveau payant standard, Google indique un débit d'entrée de $2/M et un débit de sortie de $12/M lorsque la requête ne dépasse pas 200 000 tokens. Au-delà de 200 000, les taux sont de $4/M en entrée et de $18/M en sortie.
Existe-t-il un niveau d'accès gratuit à l'API Gemini 3.1 Pro ?
La page des tarifs de Google indique une formule gratuite dont l'accès est limité à certains modèles. Vérifiez la ligne correspondant au modèle en question avant de supposer que le modèle Gemini 3.1 Pro bénéficie d'un accès gratuit à l'API.
L'API facture-t-elle l'utilisation de Google Search ?
La page actuelle consacrée aux tarifs indique un quota de 5 000 requêtes de recherche gratuites par mois, réparties entre les modèles Gemini 3 et plus récents, puis un tarif de $14 par tranche de 1 000 requêtes. Chaque requête de recherche peut être facturée séparément une fois ce quota épuisé.
L'abonnement à Google AI Pro inclut-il un crédit API ?
Il ne faut pas en tirer cette conclusion. La tarification des forfaits grand public et la facturation des jetons API sont deux processus distincts et doivent être vérifiés sur leurs pages officielles respectives.
Quel est le moyen le moins cher d'utiliser le Gemini 3.1 Pro ?
Pour les appels de production programmables, comparez l'estimation du nombre de jetons, la mise en cache et les options « batch » ou « Flex » que vous pouvez réellement utiliser. Pour les tâches interactives impliquant plusieurs modèles et fonctions, comparez séparément un forfait d'espace de travail actuel plutôt que de le considérer comme un crédit API.
Utilisez la grille tarifaire comme un outil de calcul, et non comme un slogan : identifier l'ID exact du modèle, vérifier la limite des 200 000, compter les jetons « thinking » générés et séparer les forfaits des consommateurs des dépenses liées à l'API.





