
Claude Sonnet 5.5 est un modèle performant pour le travail quotidien : suffisamment puissant pour corriger un bug complexe ou traiter un document dense, tout en offrant un coût par token inférieur à celui d’Opus 5.5. Son intérêt est particulièrement évident lorsqu'on est en mesure de définir à quoi ressemble une bonne réponse. Qu'il s'agisse d'une stratégie ouverte ou d'un problème inédit comportant de nombreux éléments, Opus mérite tout de même sa place dans votre processus de travail.
Lors de nos tests GlobalGPT, Sonnet 5.5 a rédigé des e-mails destinés aux clients, corrigé une fonction d’allocation de fonds ayant passé 43 contrôles, et effectué le rapprochement correct d’un ensemble de 13 078 mots de factures. L’e-mail a également introduit une petite hypothèse de processus qui devait être vérifiée. La question la plus intéressante est de savoir à quel moment sa rapidité et son prix se traduisent par une meilleure journée de travail — et à quel moment le raisonnement supplémentaire commence à coûter plus cher que ce qu’il permet d’économiser.
Vous pouvez utiliser Claude Sonnet 5,5 sur GlobalGPT aux côtés d'autres modèles de référence dans les domaines de la rédaction, du codage, de la recherche, de l'image et de la vidéo. Un seul abonnement multimodèle vous offre un moyen abordable de mener à bien un projet, de la première ébauche jusqu'aux ressources finales, sans avoir à gérer un abonnement distinct pour chaque étape.
Claude Sonnet 5.5 : le verdict en bref
Une solution par défaut pratique pour des tâches clairement définies
Commencez par Sonnet pour un brief, un bug, un document ou une première implémentation. Fournissez-lui les données de base, les contraintes et les critères d'acceptation. Passez à Opus lorsque le plus difficile est de déterminer en quoi consiste réellement le problème.
Ce qui nous a impressionnés : une mise en forme contrôlée, un code robuste et un rapprochement correct des documents.
À ne pas manquer : De petites hypothèses peuvent se glisser dans un texte soigné ; le raisonnement engendre des coûts supplémentaires ; un contexte détaillé ne garantit pas la mémorisation.
Il s'agit ici d'une analyse d'un modèle récemment commercialisé, et non d'une étude de production s'étalant sur plusieurs mois. Nous combinons les spécifications de Anthropic, les évaluations publiées et trois tâches pratiques réalisées le 1er octobre 2026. La tâche de rédaction a été répétée deux fois ; les tâches de code et de document ont chacune été exécutées une fois. Les résultats ci-dessous tiennent compte de cet échantillon restreint.
Quelles sont les nouveautés de la version 5.5 de Claude Sonnet ?
Le 28 septembre 2026, Anthropic a lancé la version Sonnet 5.5, conçue pour être une alternative plus rapide et moins coûteuse à Opus 5.5. Ses atouts déclarés sont la gestion efficace des tâches quotidiennes, la correction de bogues et la production de documents, de diapositives et de feuilles de calcul soignés. Ce positionnement est important : vous n’avez pas besoin du modèle le plus cher pour chaque modification, réponse d’assistance ou tâche de mise en œuvre.
Quelles sont les nouveautés de la version 5.5 de Claude Sonnet ?
| Fonctionnalité | Sonnet 5.5 | Ce que cela signifie concrètement |
|---|---|---|
| Entrées et sorties | Texte et images à insérer ; texte à supprimer | Demandez un graphique ou une capture d'écran, puis transformez la réponse en ébauche ou en plan. |
| Fenêtre de contexte de l'API | 1 million de jetons | Prévoyez suffisamment d'espace pour les nombreuses sources ; classez-les et étiquetez-les soigneusement. |
| Débit maximal de l'API standard | 128K jetons | Il s'agit d'une limite indicative, et non d'une longueur recommandée pour chaque réponse. |
| Raisonnement | Pensée adaptative | L'effort fourni peut influer à la fois sur le temps nécessaire pour terminer la tâche et sur la consommation totale de jetons. |
| Critères d'évaluation des connaissances | Juin 2026 | Utilisez des sources d'actualité ou des outils de recherche pour vérifier les faits. |
Ces limites de contexte et de sortie décrivent l'API Claude. La quantité de données que vous pouvez télécharger ou recevoir dans une application donnée dépend également de l'interface de ce produit. De même, un modèle capable d'analyser une image n'est pas un générateur d'images. Sonnet peut analyser un visuel ou rédiger un brief de production ; un modèle d'image ou de vidéo, quant à lui, crée le contenu multimédia fini.
L'avantage de cette amélioration réside dans la combinaison d'une exécution plus efficace des tâches et d'itérations plus rapides. Vous pouvez demander une première ébauche, examiner les points faibles et demander une révision ciblée. Une bonne consigne lui donne un objectif précis : “ Conservez tous les chiffres tels quels, réduisez le texte à 200 mots et énumérez tout ce que le texte source ne précise pas. ”
Tarification Claude Sonnet 5.5 : tarifs des jetons et coût réel
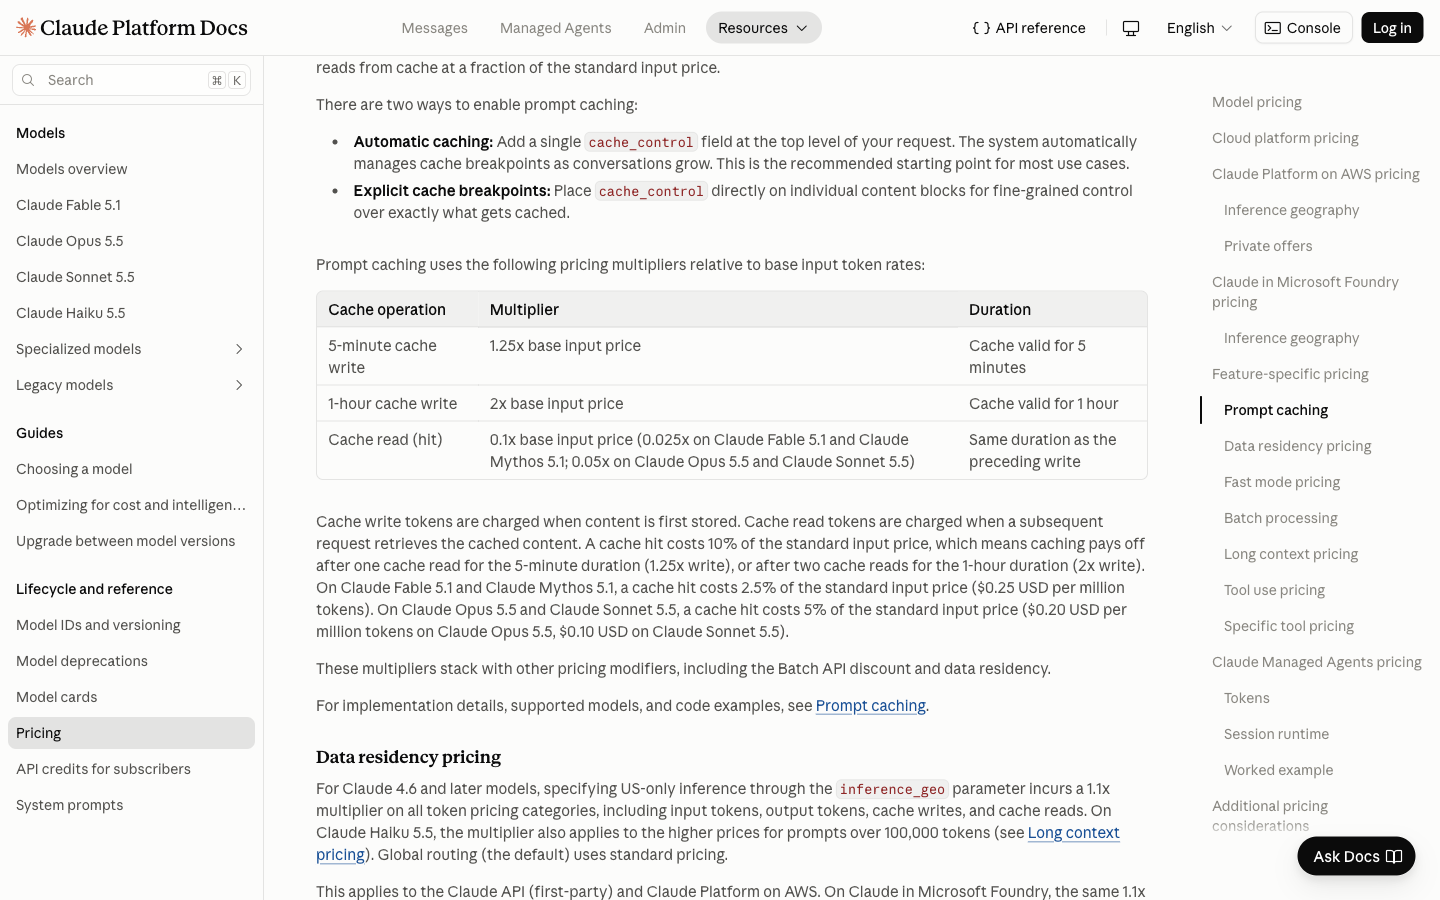
Coûts Sonnet 5.5 $2 par million de jetons d'entrée et $10 par million de jetons de sortie aux tarifs API standard de Anthropic. Ces prix unitaires sont identiques à ceux de Sonnet 5. Par rapport aux tarifs d’Opus 5.5 ($4 en entrée et $20 en sortie), Sonnet coûte deux fois moins cher par jeton d’entrée ou de sortie — mais une tâche terminée peut consommer un nombre différent de jetons.
Tarification Claude Sonnet 5.5 : tarifs des jetons et coût réel
| Catégorie de facturation API | Prix par million de jetons |
|---|---|
| Données non mises en cache | $2.00 |
| Production, y compris les jetons de réflexion facturés | $10.00 |
| Lecture / actualisation du cache | $0.10 |
| Écriture dans le cache, 5 minutes | $2.50 |
| Écriture dans le cache, 1 heure | $4.00 |
Pour une requête non mise en cache, multipliez le nombre de jetons d’entrée par $2 par million et le nombre de jetons de sortie par $10 par million. Une entrée de 10 000 jetons générant 2 000 jetons de sortie coûte $0,04. Une entrée de 100 000 jetons avec 10 000 jetons en sortie coûte $0,30. Il s'agit d'exemples d'API concrets, et non d'une facture GlobalGPT ; les outils, les opérations de mise en cache, les niveaux de service et d'autres facteurs influant sur la tarification peuvent modifier le montant total.
Combien peut coûter une demande ?
Exemples de coûts standard de l'API par requête. Uniquement pour les données d'entrée et de sortie non mises en cache.
Formule : (jetons d'entrée × $2 + jetons de sortie × $10) ÷ 1 000 000. Le temps de réflexion facturé est pris en compte dans le calcul des jetons de sortie. Il s'agit d'exemples, et non de tarifs d'abonnement ni de factures réelles.
L'affirmation de Anthropic selon laquelle “ chaque tâche coûte jusqu'à 30% de moins ” repose sur le fait que certaines tâches sont réalisées avec moins de jetons. Il ne s'agit pas d'une baisse de prix de 30%. À l'autre extrême, Évaluation du lancement d’Artificial Analysis a atteint environ $7,60 par tâche de l'indice d'intelligence à effort maximal, soit environ 50% de plus que Sonnet 5 lors de ce test. Ces tâches de référence exigeantes ne sont pas de simples messages de discussion, mais elles montrent pourquoi le fait de pousser le raisonnement à son maximum peut réduire à néant un avantage apparent.
La facturation par API, les abonnements Claude et GlobalGPT constituent différentes options
Les formules grand public de Claude fonctionnent selon un modèle d'abonnement : la formule gratuite est $0, la formule Pro est $20 par mois ou $200 facturée annuellement, et la formule Max commence à $100 par mois, hors taxes. L'utilisation de l'application est soumise à des limites propres à chaque formule. Anthropic indique également $100 ou $200 de crédits API mensuels pour les niveaux Max correspondants ; les formules Free et Pro n'incluent pas de crédits API mensuels. Comparez séparément l’accès aux applications et les quotas d’API lorsque vous choisissez une formule. Une plateforme multi-modèles convient aux personnes dont le travail fait régulièrement appel à différentes familles de modèles et différents types de médias.
Si votre journée consiste à rédiger une page de lancement, à relire du code et à créer des visuels pour une campagne, GlobalGPT rassemble tous ces outils. Son intérêt réside dans la diversité des fonctionnalités offertes par un seul abonnement, ce qui vous évite d'avoir à payer plusieurs produits distincts simplement pour mener à bien un seul projet. Choisissez la formule en fonction du travail que vous effectuez réellement.
Performances : proches de celles d'Opus pour certaines tâches, mais pas pour toutes
Les résultats du lancement montrent une avancée considérable par rapport à Sonnet 5. Ils démontrent également pourquoi un seul score phare ne suffit pas à déterminer le choix d’un modèle. Sonnet 5.5 arrive en tête de la comparaison Terminal-Bench présentée, tandis qu’Opus 5.5 conserve son avance sur FrontierCode et CursorBench. Des notes quasi identiques en matière de travail intellectuel sont prometteuses, mais elles ne rendent pas pour autant ces modèles interchangeables.
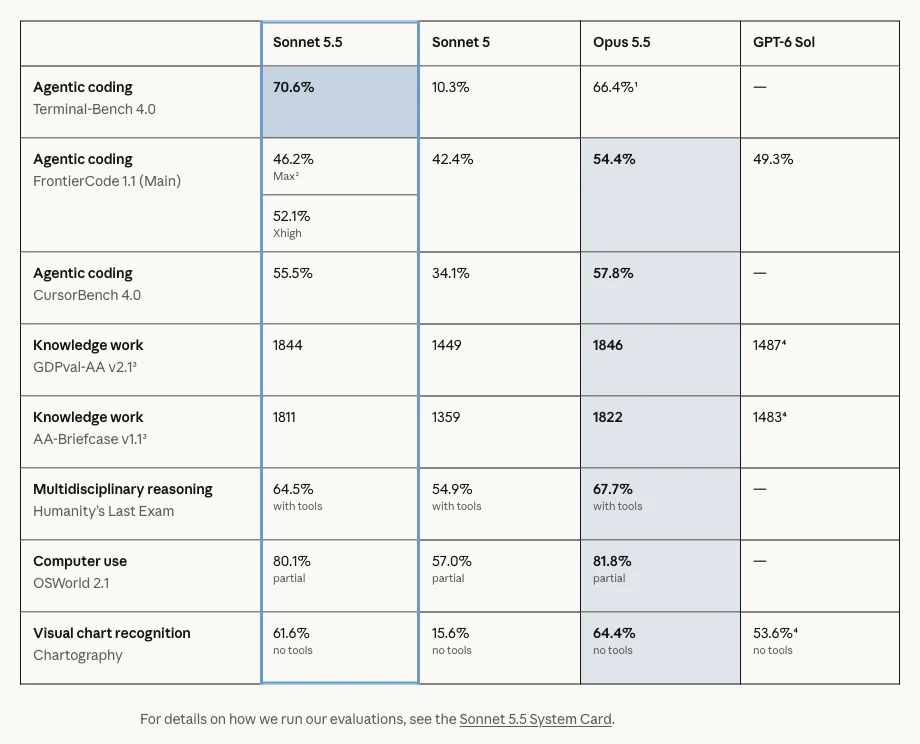
Performances : proches de celles d'Opus pour certaines tâches, mais pas pour toutes
| Évaluation dans le tableau de lancement de Anthropic | Sonnet 5.5 | Sonnet n° 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66,41 TP40T (Xhigh) | - |
| FrontierCode 1.1 - Accueil | 52,11 TP40T (Xhigh) ; 46,21 TP40T (Max) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA v2.1 | 1844 Elo | 1 449 Elo | 1846 Elo | 1487 |
| AA-Briefcase v1.1 | 1811 Elo | 1 359 Elo | 1822 Elo | 1483 |
| Le dernier examen de l'humanité | 64.5% avec outillage | 54,91 TP40T avec outillage | 67,71 TP40T avec outillage | - |
| OSWorld 2.1 | 80.1% partiel | 57.0% partiel | 81,81 TP40T partiel | - |
| Cartographie | 61,61 TP40T sans outils | 15,61 TP40T sans outils | 64,41 TP40T sans outils | 53,61 TP40T sans outils |
Il s’agit de résultats de tests de référence publiés, distincts de nos tests GlobalGPT. Les évaluations utilisent des environnements et des paramètres d’effort différents ; les cotes Elo ne correspondent pas à un pourcentage de précision. Les valeurs « GPT-6 Sol » figurent dans le tableau comparatif publié par Anthropic, et un tiret signifie que la page n’a pas renseigné de valeur pour cette évaluation. Anthropic précise également que les exécutions GDPval-AA et AA-Briefcase lancées lors du lancement utilisaient un déploiement préliminaire comportant un bug de sortie structurée qui a été corrigé par la suite. Considérez ce tableau comme un aperçu de ces évaluations, et non comme une garantie concernant votre charge de travail.
Le résultat de FrontierCode est particulièrement utile : Sonnet a obtenu de meilleurs résultats avec le paramètre « Xhigh » qu’avec « Max ». Anthropic attribue cette baisse de performance avec « Max » à des cycles de révision supplémentaires, à des délais d’expiration et à des modifications hors du périmètre demandé. Réfléchir davantage peut se traduire par plus de travail sans pour autant aboutir à une meilleure réponse. Commencez par définir clairement la tâche et intensifiez vos efforts uniquement lorsque vous avez une raison précise de le faire.
Des résultats indépendants apportent un éclairage supplémentaire. Artificial Analysis a fait état d'un score de 56 à l'indice d'intelligence dans sa configuration maximale/par défaut, ainsi que d'une utilisation inhabituellement importante de jetons de sortie. A Évaluation du pipeline de révision de CodeRabbit 6 cas de signaux complexes sur 13 ont été détectés par Sonnet 5.5, contre 4 sur 13 par Sonnet 5, avec un temps d'exécution moyen plus court. Il s’agit d’une étude menée à petite échelle par un éditeur de logiciels, qui ne prouve pas que chaque révision de code s’améliorera, mais c’est un exemple utile pour évaluer une tâche dans son ensemble plutôt qu’un simple score.
Quelle est la vitesse du Claude Sonnet 5,5 ?
Selon les rapports, le modèle Anthropic génère des résultats plus de 30% plus rapidement que le modèle Sonnet 5. La génération des résultats ne représente qu'une partie du temps d'attente d'une réponse : le traitement des entrées, le raisonnement, le temps de réseau et la charge du service jouent également un rôle. Un modèle peut écrire rapidement une fois qu'il a démarré, mais peut néanmoins passer du temps à traiter la requête avant que la réponse finale n'arrive.
Nos trois exécutions de la même requête d'e-mail client ont été effectuées en 11,60, 12,16 et 11,78 secondes, soit une médiane de 11,78 secondes. La tâche de traitement du code a pris 19,08 secondes et celle du document, 16,42 secondes. Nous avons chronométré la réponse complète, y compris les temps de service et les temps de latence réseau. Nous n’avons pas mesuré la latence du premier token ni effectué de test de contrôle Sonnet 5 ; ces chronométrages ne permettent donc pas d’établir une amélioration de 30%.
Au quotidien, ce modèle vaut donc la peine d’être testé pour les tâches que vous révisez à intervalles réguliers. Demandez d’abord le résultat final, limitez le périmètre de la tâche et évitez de solliciter une explication trop détaillée lorsque vous n’avez besoin que d’une fonction corrigée ou d’une réponse succincte. Lorsque les paramètres de réglage sont disponibles, testez d’abord les réglages les moins gourmands en ressources avant de choisir par défaut le niveau « Max ».
Performances en conditions réelles : trois tests GlobalGPT
Nous avons utilisé des exercices pratiques dont nous pouvions vérifier les réponses. Toutes les requêtes ont utilisé Claude Sonnet 5.5 avec le même plafond de sortie de 6 000 tokens et sans outils externes. Nous avons laissé les paramètres d’échantillonnage et de raisonnement sur leurs valeurs par défaut. Nous avons conservé la première sortie complète pour chaque tâche ; les deux cycles d’écriture supplémentaires constituent un contrôle de cohérence distinct. Les cinq appels se sont tous déroulés sans réessai.
Rédaction : une réponse au client où les engagements sont bien maîtrisés
Le cahier des charges demandait de rédiger un e-mail de 90 à 120 mots adressé à Maya concernant un retard de livraison d’une lampe bleue, comprenant exactement trois points, avec une date limite d’envoi fixée au 4 octobre, et la possibilité de répondre “ remboursement ” pour obtenir un remboursement intégral sur le mode de paiement d’origine. Il interdisait explicitement toute mention d’une cause inventée, d’une garantie de livraison, d’une remise ou d’une promesse de remboursement immédiat.
La première réponse comptait 110 mots et comportait exactement trois puces ; elle respectait le délai d’expédition et les conditions de remboursement. Elle n’a pas inventé de date de livraison, de motif de retard ni d’avantage supplémentaire. En revanche, elle ajoutait la mention “ vous n’avez pas besoin de répondre ” à l’intention des clients qui conservaient leur commande — un détail de procédure qui ne figurait pas dans le brief. Cela en fait un projet utile, mais qui ne répond pas parfaitement à l’exigence stricte de s’en tenir uniquement aux faits.
Les réponses 101 et 97 mots respectaient elles aussi les règles de mise en forme, mais reprenaient toutes deux la même hypothèse de “ ne rien faire ”. La troisième réponse utilisait en outre deux puces pour présenter essentiellement la même option : « conserver la commande et attendre ». Avant d'envoyer une réponse destinée au client, vérifiez les détails opérationnels et supprimez les redondances.
Test d'écriture : format validé, hypothèse d'un seul processus
Première réponse : 110 mots, 3 puces, 11,60 secondes. Les conditions d'expédition et de remboursement étaient correctes. L'instruction de conserver la commande sans y répondre ne figurait pas dans le dossier et doit être confirmée. Répétitions : 101 et 97 mots ; les deux reprenaient cette hypothèse.
Claude Sonnet 5,5 · GlobalGPT · 1er octobre 2026 · plafond de sortie de 6 000 jetons · aucun outil · échantillonnage et effort laissés aux paramètres par défaut du service. Le temps correspond à la réponse complète, et non au premier jeton.
Consignes relatives à la tâche
Rédigez un e-mail en anglais destiné à Maya, dans le cadre du service client, concernant la commande R-418, une lampe bleue dont l'expédition a été retardée. L'e-mail complet doit compter entre 90 et 120 mots inclus et comporter exactement trois puces. Présentez vos excuses, expliquez clairement la marche à suivre et ne mentionnez que les faits suivants : la lampe sera expédiée d’ici le 4 octobre ; Maya peut également répondre “ remboursement ” pour demander un remboursement intégral sur le mode de paiement initial. Ne promettez pas de date de livraison ou d’arrivée, de remboursement immédiat, de réduction, d’indemnisation ou tout autre avantage non prévu. N’inventez pas de raison pour justifier ce retard. La date limite concerne l’expédition, et non la livraison. Ajoutez une formule de politesse en début et en fin de message. Renvoyez uniquement l’e-mail. Pour cette tâche, un mot correspond à un élément séparé par un espace, à l’exclusion des marqueurs de puces isolés.
Première sortie complète
Objet : Mise à jour concernant votre commande R-418

Bonjour Maya,

Je suis désolé que l'expédition de votre lampe bleue, commande R-418, ait pris du retard. Je comprends que cela soit frustrant et je vous présente mes excuses pour ce désagrément.

Voici où en est votre commande et ce que vous pouvez faire à présent :

- Votre lampe sera expédiée d'ici le 4 octobre.
- Si vous souhaitez conserver votre commande, vous n'avez pas besoin de répondre.
- Si vous préférez ne pas attendre, répondez " remboursement " à cet e-mail, et nous procéderons à un remboursement intégral via votre mode de paiement initial.

Merci de votre patience et de votre compréhension. N'hésitez pas à nous répondre si vous avez des questions concernant votre commande.

Cordialement,
L'équipe du service client
Écriture répétée 2 · sortie complète
Chère Maya,

Je suis désolé que l'expédition de votre commande R-418, la lampe bleue, ait pris du retard. Je comprends que cela soit frustrant et je vous présente mes excuses pour ce désagrément.

Voici la marche à suivre :

- Votre lampe bleue sera expédiée d'ici le 4 octobre.
- Si vous souhaitez patienter, vous n'avez rien à faire.
- Si vous préférez ne pas attendre, répondez " remboursement " à cet e-mail pour demander un remboursement intégral via votre mode de paiement initial.

Veuillez noter que le 4 octobre est notre date limite d’expédition, et non une date de livraison.

Merci de votre patience et de votre compréhension.

Cordialement,
L’équipe du service client
Écriture répétée 3 · sortie complète
Objet : Mise à jour concernant votre commande R-418

Bonjour Maya,

Je suis désolé que l'expédition de votre lampe bleue, commande R-418, ait pris du retard. Je vous présente mes excuses pour ce désagrément et vous remercie de votre patience.

Voici les options qui s'offrent à vous :

- Attendre l'expédition : votre lampe sera expédiée d'ici le 4 octobre.
- Demander un remboursement : répondez en indiquant le mot " remboursement " et nous procéderons à un remboursement intégral via votre mode de paiement d'origine.
- Conserver la commande : si vous acceptez d'attendre, aucune autre démarche n'est nécessaire.

Veuillez noter que le 4 octobre est notre date limite d'expédition, et non une date de livraison.

Cordialement,
L'équipe du service client
Votre lampe sera expédiée d'ici le 4 octobre. … Si vous préférez ne pas attendre, répondez “ remboursement ” à cet e-mail et nous procéderons à un remboursement intégral via votre mode de paiement initial.
Extrait de la première épreuve écrite du GlobalGPT ; une puce intermédiaire a été omise.
Voici une méthode utile pour la communication avec les clients et la rédaction professionnelle : présentez les faits validés, définissez le ton à adopter et précisez quelles promesses ne doivent pas figurer dans le texte. Sonnet pourra alors vous aider à trouver la formulation adéquate sans que vous ayez à lui demander d'élaborer votre politique à sa place.
Programmation : corriger la logique d'arrondi, puis vérifier les totaux
Notre fonction Python défaillante répartissait les sommes d'argent à l'aide de nombres à virgule flottante et arrondissait chaque part indépendamment. Cela pouvait entraîner un gain ou une perte de quelques centimes. Nous avons demandé à Sonnet de la remplacer par un algorithme de répartition par le plus grand reste basé sur Decimal, de préserver le total, de départager les ex aequo selon l'index d'origine et de rejeter les entrées non valides.
La première fonction renvoyée a été transmise 43 vérifications sur 43, couvrant les montants nuls, les poids fractionnaires, les ex aequo déterministes, les entrées mal formées, les grandes valeurs et les limites de précision. Il analysait les chaînes décimales, les convertissait en quantités entières exactes, puis attribuait les centimes restants selon un ordre stable. Le résultat utile ne se limitait pas à un code d’apparence plausible : les parts s’additionnaient bel et bien.
Cela justifie l'utilisation de Sonnet pour une mise en œuvre ciblée, avec des critères d'acceptation explicites. Il s'agissait d'un test fonctionnel isolé, et non d'une réparation autonome du référentiel ni d'un audit de sécurité. Pour le code de production, ajoutez vos propres tests d'intégration et vérifiez la gestion des erreurs dans l'application environnante.
Test de codage : 43 vérifications réussies
Première réponse : 19,08 secondes. A satisfait aux 43 critères de vérification concernant l'allocation correcte, la stabilité des liens, la validation des entrées et la précision. Évaluée en tant que fonction autonome, et non en tant que réparation autonome d'un référentiel.
Claude Sonnet 5,5 · GlobalGPT · 1er octobre 2026 · plafond de sortie de 6 000 jetons · aucun outil · échantillonnage et effort laissés aux paramètres par défaut du service. Le temps correspond à la réponse complète, et non au premier jeton.
Consignes relatives à la tâche
Remplacez la fonction Python défectueuse ci-dessous par une implémentation correcte de `allocate_cents(total: str, weights: list[str]) -> list[int]`. Ne fournissez que du code source Python exécutable, sans balises Markdown ni explications.

Exigences :
1. total est un montant en USD fini et non négatif, représenté sous forme de chaîne de caractères, comportant zéro, un ou deux chiffres décimaux, par exemple " 0 ", " 12,3 " ou " 12,34 ". Seuls les chiffres décimaux ASCII sont autorisés, avec un point décimal unique facultatif. Rejetez les signes, la notation exponentielle, les espaces, les valeurs NaN/Infinity, une chaîne vide, un point décimal en fin de chaîne, un point décimal en début de chaîne et plus de deux chiffres décimaux, y compris " 1.000 ". Les zéros non significatifs sont autorisés. Rejetez les entrées non textuelles en levant une exception ValueError.
2. weights est une liste non vide de chaînes de caractères. Chaque chaîne utilise des chiffres décimaux ASCII, éventuellement suivis d’un point décimal et d’un ou plusieurs chiffres. Exige des valeurs finies non négatives, avec au moins un poids strictement positif. Rejetez les chaînes invalides, les signes, la notation en exposant, les espaces, les entrées non sous forme de chaîne ou une entrée « weights » qui n’est pas une liste en levant une exception ValueError. Les zéros non significatifs sont autorisés.
3. Utilisez Decimal pour analyser et conserver exactement les montants décimaux fournis. Convertissez les dollars en cents entiers. Répartissez les cents entiers proportionnellement aux poids, en utilisant la méthode du plus grand reste : prenez la partie entière de chaque quota exact, puis attribuez les cents restants aux plus grands restes fractionnaires. En cas d’égalité, privilégiez l’index d’origine le plus bas. La liste renvoyée doit conserver l’ordre d’entrée et totaliser exactement le nombre total de cents.
4. Ne perdez pas de précision de manière silencieuse pour les valeurs valides longues ou les poids très inégaux. Ne modifiez pas les poids. N’importez que depuis `decimal` ou `math` si des importations sont nécessaires. Aucune opération sur les fichiers, le réseau, l’environnement, les processus ou les entrées/sorties.

Implémentation incorrecte :
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
Première sortie complète
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac) :
    if not isinstance(s, str) or not s :
        return False
        parts = s.split(".")
        if len(parts) > 2 :
            return False
 if not parts[0] or not all(c in DIGITS for c in parts[0]):
 return False
 if len(parts) == 2:
 frac = parts[1]
 if not frac or not all(c in DIGITS for c in frac):
                return False
 if max_frac is not None and len(frac) > max_frac:
 return False
 return True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s) :
 # renvoie (mantisse entière, exposant) avec value = mantisse * 10**exposant
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("total invalide")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("poids invalides")
    for w in poids :
    if not valid(w, None) :
        raise ValueError("poids invalide")

    mant, exp = to_scaled(total)
        if exp >= -2 :
            cents = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # inaccessible pour une entrée validée

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    si W <= 0 :
        raise ValueError("au moins un poids doit être positif")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
Documents : retrouver les bons dossiers après les corrections et les doublons
La troisième tâche consistait à traiter un ensemble de factures synthétiques comprenant 13 078 mots : 120 enregistrements de base, huit corrections et quatre copies d'archive. Sonnet devait sélectionner uniquement les factures Atlas approuvées datées de septembre 2026, utiliser la version la plus récente de chaque enregistrement et renvoyer un format JSON strict contenant le total ainsi que trois contrôles de suivi pertinents.
Elle a sélectionné tous les 16 numéros de facture valides, a renvoyé la valeur exacte $15,305.66 au total, tout en respectant la structure JSON. Les étapes suivantes ont porté sur le rapprochement des comptes, les pièces justificatives des corrections, ainsi que les contrôles de doublons et de dates limites. Le système n'a pas considéré une ancienne copie archivée comme une nouvelle facture.
C'est le genre de détail qui compte dans le traitement des documents : la correction la plus récente doit prévaloir, même lorsqu'une version antérieure apparaît plus loin dans le dossier. Le résultat est prometteur pour l'extraction de documents délimités. Il ne s'agit toutefois encore que d'un exercice synthétique, bien plus modeste que la fenêtre de contexte d'un million de tokens annoncée ; les travaux financiers importants nécessitent un calcul indépendant.
Test du document : 16 enregistrements, total exact
Première réponse : 16,42 secondes. Les 16 numéros de facture ainsi que le montant total de $15 305,66 correspondaient à la référence indépendante ; le format JSON strict et les trois vérifications complémentaires étaient également corrects.
Claude Sonnet 5,5 · GlobalGPT · 1er octobre 2026 · plafond de sortie de 6 000 jetons · aucun outil · échantillonnage et effort laissés aux paramètres par défaut du service. Le temps correspond à la réponse complète, et non au premier jeton.
Le dossier synthétique fourni contenait 120 enregistrements de base, huit corrections et quatre copies d'archive (13 078 mots). Les champs étaient les suivants : ID, version, projet, date, statut, montant et notes explicatives. Les instructions ci-dessous sont complètes ; le dossier source, assez volumineux, est résumé ici.
Consignes relatives à la tâche
Vérifiez les enregistrements de factures de projet synthétiques ci-dessous. Pour chaque identifiant, n’utilisez que la version la plus récente ; les enregistrements en double identiques ne génèrent pas de factures supplémentaires. La version la plus récente peut apparaître avant une copie d’archive plus ancienne. Sélectionnez uniquement les enregistrements dont le projet final est " Atlas ", dont le statut final est " approuvé " et dont la date finale se situe en septembre 2026. Les montants sont exprimés en USD. Renvoyez un JSON strict contenant exactement les clés suivantes : " ids " (les identifiants sélectionnés, uniques et triés par ordre croissant), « total_usd » (une chaîne de caractères comportant exactement deux décimales) et « action_items » (exactement trois chaînes de caractères concises indiquant les prochaines vérifications comptables pertinentes). N’ajoutez pas de balises Markdown ni de texte explicatif. Ignorez les notes descriptives pour le filtrage ; tous les champs comptables sont structurés. Ne prenez pas en compte les enregistrements d’autres mois, les brouillons, les enregistrements Orion, les anciennes versions ou les doublons.
Première sortie complète
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056", "INV-062", "INV-068", "INV-074", "INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15 305,66","action_items":["Rapprocher les 16 factures sélectionnées et le montant total de 15 305,66 USD avec le grand livre Atlas et le livre auxiliaire des dettes fournisseurs de septembre 2026.","Vérifier les écritures modifiées par des corrections (INV-003, INV-008, INV-020, INV-050, ainsi que les factures exclues INV-002, INV-014 et INV-026) afin de s’assurer de la présence des preuves d’approbation et des pièces justificatives.","Vérifiez qu’aucune copie d’archive en double n’a été comptabilisée en tant que facture distincte, et vérifiez qu’il n’y a pas de problèmes de régularisation ou de coupure comptable sur les factures corrigées datées à proximité de la fin du mois."]}Sonnet 5.5 ou Opus 5.5 : lequel choisir ?
Faites votre choix en fonction de la nature de la tâche. Sonnet constitue un premier choix judicieux lorsque les instructions et l'objectif final sont clairs. Opus est quant à lui le point de départ le plus adapté lorsque la tâche nécessite un jugement continu, la mise en évidence d'hypothèses manquantes ou la coordination d'une longue chaîne de décisions. Lisez notre Avis sur le Claude Opus 5.5 pour découvrir ce modèle plus en détail.
Sonnet 5.5 ou Opus 5.5 : lequel choisir ?
| Votre mission | Point de départ recommandé | Pourquoi |
|---|---|---|
| Réécrire un brief, rédiger un premier jet de texte destiné aux clients, extraire des données | Sonnet 5.5 | Des contraintes claires facilitent la vérification de la qualité. |
| Corriger un bug identifié ou implémenter une fonction spécifiée | Sonnet 5.5 | Excellente exécution des tâches à un taux de jetons d'entrée/sortie plus faible. |
| Définir l'architecture avec des exigences incomplètes | Opus 5.5 | Le plus difficile, c'est de faire preuve d'un jugement constant, et pas seulement de mettre les choses en œuvre. |
| Réalisez une campagne à l'aide de textes, d'images et de vidéos | Flux de travail multimodèle GlobalGPT | Utilisez Sonnet pour les modèles succincts et spécialisés relatifs aux actifs. |
Une méthode efficace consiste à demander à un modèle de raisonnement plus puissant d'analyser un plan complexe, puis à fournir à Sonnet le cahier des charges validé et les vérifications concrètes. Le choix du modèle peut varier d'une étape à l'autre. Il n'est pas nécessaire de transformer chaque petite modification en une tâche de raisonnement particulièrement coûteuse.
Utilisez le modèle Sonnet 5.5 pour le modèle GlobalGPT
GlobalGPT permet d'intégrer ce modèle dans un environnement de travail plus large. Ouvrez Claude Sonnet 5.5 pour la phase de rédaction ou d'analyse, puis passez à un autre modèle lorsque le projet nécessite une approche différente. Vous pouvez élaborer un brief de campagne, peaufiner le texte, créer des visuels et produire des vidéos sans avoir à reconfigurer le flux de travail entre plusieurs abonnements.
Pour obtenir un premier résultat de meilleure qualité, envoyez à la fois le document source et une brève liste de règles d'acceptation. Pour les textes, précisez le public cible, la longueur, le ton et les éléments qui ne doivent pas être modifiés. Pour le code, fournissez l'exemple qui ne fonctionne pas et le comportement attendu. Pour les documents, identifiez les sections sources et indiquez comment gérer les versions contradictoires. Ces suggestions pour l'écriture, la recherche et la programmation vous proposer des points de départ réutilisables.
Les développeurs peuvent également intégrer leur flux de travail sur terminal via CLI GlobalGPT avec code Claude. Utilisez le site web dédié au projet dans son ensemble et l'interface en ligne de commande (CLI) lorsque cela s'inscrit dans le processus de développement. L'intérêt réside dans un ensemble d'outils interconnectés, le choix du modèle dépendant de la tâche suivante.
Restrictions et informations utiles concernant les mises à niveau
Un engagement total est un choix, pas une garantie de qualité. Sonnet peut se concentrer excessivement sur un problème trop restreint ou aller au-delà des modifications demandées. Demandez-lui de respecter le périmètre défini, d'effectuer les vérifications nécessaires et de s'arrêter dès que les critères d'acceptation sont remplis. Si le produit dispose de contrôles des efforts, comparez la qualité et le coût des tâches achevées avant de les augmenter.
Même les faits d'actualité doivent s'appuyer sur des sources récentes. La date limite de mise à jour des données du modèle, fixée à juin 2026, ne garantit pas que toutes les informations relatives aux prix, aux politiques ou aux lancements soient à jour. Veuillez fournir le document actuel ou utiliser un workflow intégrant des outils de recherche. Pour les informations sensibles, vérifiez les conditions de confidentialité et de conservation du service et du compte que vous utilisez effectivement ; le nom du modèle ne détermine pas ces paramètres.
Les migrations d'API ne se limitent pas à un simple changement de nom de modèle. La version Sonnet 5.5 modifie certains anciens modèles de requêtes. L’API directe Claude rejette les paramètres de température, top_p et top_k non par défaut ; les anciennes logiques ou configurations d’outils forcées peuvent donc nécessiter une mise à jour. La réflexion adaptative est le comportement par défaut ; le mode « between_tools », tel que documenté, supprime la réflexion initiale lorsque l’effort est élevé ou inférieur. La présentation actuelle précise également que l’utilisation forcée d’outils renvoie une erreur, que les anciens outils informatiques ne sont pas acceptés sur l’API Claude et Google Cloud, et que le texte entre les appels d’outils peut apparaître dans des blocs de réflexion. Consultez le guide officiel de la migration avant de déplacer une application. Notre Guide de l'API Claude aborde les concepts généraux liés à la configuration et à la facturation.
Anthropic applique également des mesures de sécurité aux demandes présentant un risque accru en matière de cybersécurité et de biologie. Le développement logiciel courant fait toujours partie de l'utilisation prévue du modèle. Si une tâche est légitime mais sensible, décrivez clairement son champ d'application et les autorisations requises, plutôt que de supposer que chaque refus est dû à une limitation générale en matière de programmation.
Verdict final : un bon modèle à intégrer à votre routine quotidienne
Sonnet 5.5 s'impose grâce à un travail concret et vérifiable. Ses principaux atouts résident dans une capacité de codage bien ciblée et une gestion efficace des documents, le tout à un coût par jeton API inférieur à celui d'Opus. Il est également très utile pour la rédaction, avec une vérification finale des détails plausibles qui ne figuraient pas dans le cahier des charges. Notre petit ensemble de tests confirme ce positionnement axé sur le travail quotidien ; il ne permet toutefois pas de conclure à une supériorité universelle en matière de vitesse, de coût ou de raisonnement complexe.
Commencez par une tâche concrète dont vous pouvez évaluer le résultat. Précisez clairement les contraintes, vérifiez les détails importants et passez à un autre modèle lorsque le problème évolue. Essayez Sonnet 5.5 sur GlobalGPT pour intégrer la rédaction, le codage, l'analyse et l'étape créative suivante au sein d'un flux de travail multimodèle unique.
Foire aux questions
Qu'est-ce que le Claude Sonnet 5.5 ?
Claude Sonnet 5.5 est un modèle Anthropic lancé le 28 septembre 2026. Il prend en charge la saisie de texte et d'images avec une sortie textuelle, et est conçu pour faciliter le codage quotidien, la rédaction, le traitement de documents et les flux de travail assistés par des outils.
Combien coûte le modèle Claude Sonnet 5.5 ?
Le tarif standard de l'API de Anthropic est de $2 par million de jetons d'entrée et de $10 par million de jetons de sortie. Les lectures en cache coûtent $0,10 par million de jetons. Les abonnements aux applications à Claude et les forfaits à GlobalGPT ne sont pas compris dans ces tarifs d'API.
Le Claude Sonnet 5,5 est-il plus rapide que le Sonnet 5 ?
Le Anthropic affiche une génération de résultats plus rapide de plus de 30% par rapport au Sonnet 5. Lors de notre test de rédaction sur le GlobalGPT, trois réponses complètes ont pris entre 11,60 et 12,16 secondes. Nous n’avons pas utilisé le Sonnet 5 comme référence, notre test ne permet donc pas de mesurer l’amélioration de la vitesse d’une génération à l’autre.
Le Sonnet 5.5 est-il meilleur que l'Opus 5.5 ?
Optez pour Sonnet 5.5 pour les tâches bien définies et un coût par jeton d'entrée/sortie plus faible. Opus 5.5 constitue le meilleur point de départ pour les tâches complexes et ouvertes nécessitant un jugement continu. Sonnet arrive en tête de certaines évaluations publiées, mais il n'y a pas de vainqueur incontestable.
Le Claude Sonnet 5.5 est-il capable de traiter des documents volumineux ?
L'API Claude spécifie une fenêtre de contexte d'un million de tokens. Lors de notre test réalisé sur un document synthétique plus court, comptant 13 078 mots, Sonnet a sélectionné les 16 enregistrements éligibles et a calculé le total correct. Ce résultat ne permet toutefois pas de garantir la précision sur l'ensemble de la fenêtre de contexte annoncée.
Puis-je utiliser la version 5.5 de Claude Sonnet sur GlobalGPT ?
Oui. GlobalGPT propose Claude Sonnet 5.5 ainsi que d'autres modèles d'IA, ce qui vous permet de rédiger, de coder, d'analyser des documents et de passer ensuite au traitement d'images ou de vidéos, le tout sur une seule et même plateforme.
Sources et notes de test
Les caractéristiques techniques et les prix à la sortie ont été vérifiés le 13 octobre 2026 ; les tests pratiques présentés ci-dessous ont été réalisés le 1er octobre 2026. Sources principales : Annonce du lancement de Anthropic, Référence du modèle Sonnet 5.5, Prix de l'API, et Prix de l'abonnement Claude. Les informations contextuelles indépendantes proviennent d'Artificial Analysis et de l'étude CodeRabbit mentionnée ci-dessus.
Les tests GlobalGPT ont utilisé la première réponse complète pour trois tâches, ainsi que deux répétitions d'écriture. Aucun outil externe n’a été activé. Les temps mesurés couvrent les réponses complètes, y compris les temps de latence liés au réseau et aux services ; aucune valeur d’effort de raisonnement n’a été sélectionnée. Le dossier de facturation était synthétique et ne contenait aucune donnée client. L’illustration de l’en-tête a été générée pour cette évaluation ; les autres images sont des captures d’écran des sites web cités.









