Muse Spark 1.3 es la versión más potente de Muse Spark lanzada por Meta hasta la fecha: el modelo público «xhigh» alcanza una puntuación de 61 en el Índice de Inteligencia de Análisis Artificial, mantiene una ventana de contexto de 1 millón de tokens y ha superado las tres tareas de programación de dificultad media en nuestra prueba de API de primera respuesta. Hay que tener en cuenta que el gráfico de referencia principal de Meta utiliza «max reasoning», aunque, en el momento de redactar esta reseña, «max» aún estaba a la espera de un lanzamiento más amplio tras someterse a pruebas de seguridad adicionales.

Reseña de Muse Spark 1.3: Veredicto rápido
Nuestro veredicto
Vale la pena probar Muse Spark 1.3 para la programación de agentes, el trabajo con contextos largos y la automatización en la que el coste es un factor importante. Su resultado público «xhigh» ya es competitivo a nivel de vanguardia, pero no cites las puntuaciones máximas de Meta como si todos los usuarios de la API pudieran reproducirlas hoy mismo.
Meta lanzó Muse Spark 1.3 el 2 de septiembre de 2026, lo que lo prepara para flujos de trabajo agentivos a largo plazo, un código más limpio y una colaboración más fiable. Esto supone una continuación del cambio hacia Agentes de IA basados en modelos de uso de herramientas. Meta afirma que plantea preguntas aclaratorias cuando los requisitos son ambiguos, avisa cuando se queda atascado y confirma antes de llevar a cabo acciones con consecuencias importantes. En comparaciones internas con la versión 1.2, los ingenieros de Meta observaron unas 20% menos de llamadas a la herramienta y 25% menos de tokens. Se trata de afirmaciones del proveedor, no de resultados de nuestra prueba.
¿Qué ha cambiado con respecto a Muse Spark 1.2?
Análisis artificial: del 57 al 61 en xhigh.
Meta indica 75,4 frente a 55,0 en DeepSWE, pero compara 1,3 (máximo) con 1,2 (xhigh).
La ventana de 1M se mantiene; las puntuaciones MRCR de banda alta suben bruscamente en el gráfico de Meta.
Las tasas de tokens se mantienen estables, mientras que AA registró un valor de $0,55 frente a $0,40 por tarea evaluada.
Pruebas de rendimiento de Muse Spark 1.3: «Max» y «Xhigh» no son lo mismo
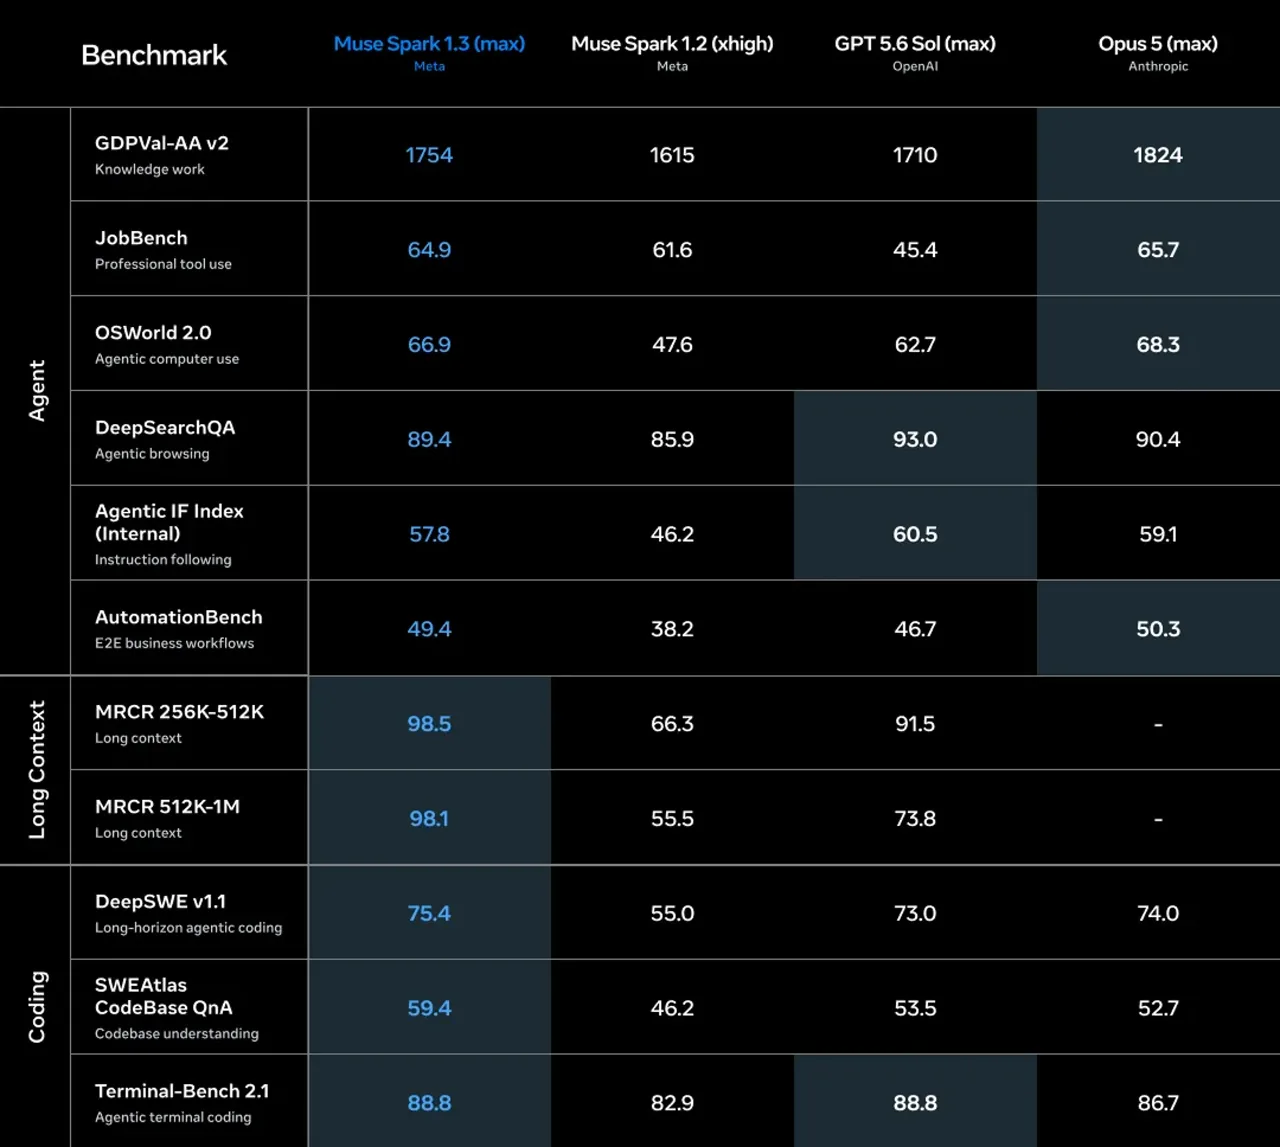
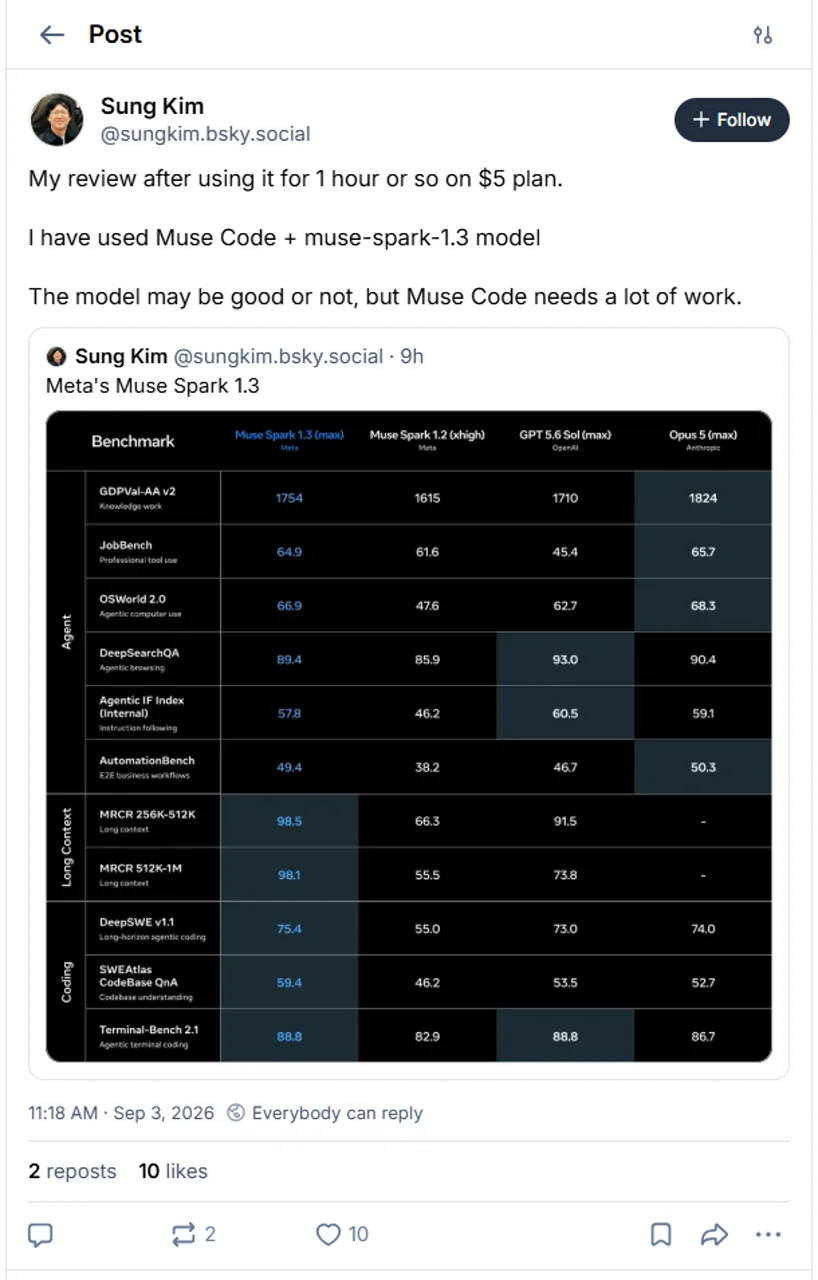
La tabla oficial de Meta Es impresionante. Muse Spark 1.3 alcanza una puntuación máxima de 88,8 en Terminal-Bench 2.1, 75,4 en DeepSWE v1.1, 98,1 en MRCR 512K-1M y 66,9 en OSWorld 2.0. Empata con la puntuación máxima de GPT-5.6 Sol en Terminal-Bench y supera a los competidores mencionados en las dos bandas MRCR de contexto largo. Los desarrolladores que deseen comparar el mercado en general pueden utilizar nuestro Descripción general de Coding-Agent como contexto adicional.
INFORME METÁLICO, RAZONAMIENTO MÁXIMO
| Punto de referencia | 1,3 como máximo | 1,2 x alto | GPT-5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE v1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | N/A |
Las diferentes configuraciones de esfuerzo, los arneses de los agentes y las versiones de OSWorld limitan la comparabilidad directa. Meta también describe el «Agentic IF Index» como un índice compuesto interno.
Cómo leer el gráfico
1.3, GPT-5.6 Sol y Opus 5 utilizan «max»; 1.2 utiliza «xhigh».
Los agentes designados y los arneses fijos varían según la evaluación.
Las ejecuciones 1.3 y 1.2 utilizan versiones diferentes del entorno.
El índice «Agentic IF» es un índice compuesto de Meta, no un único índice de referencia público.
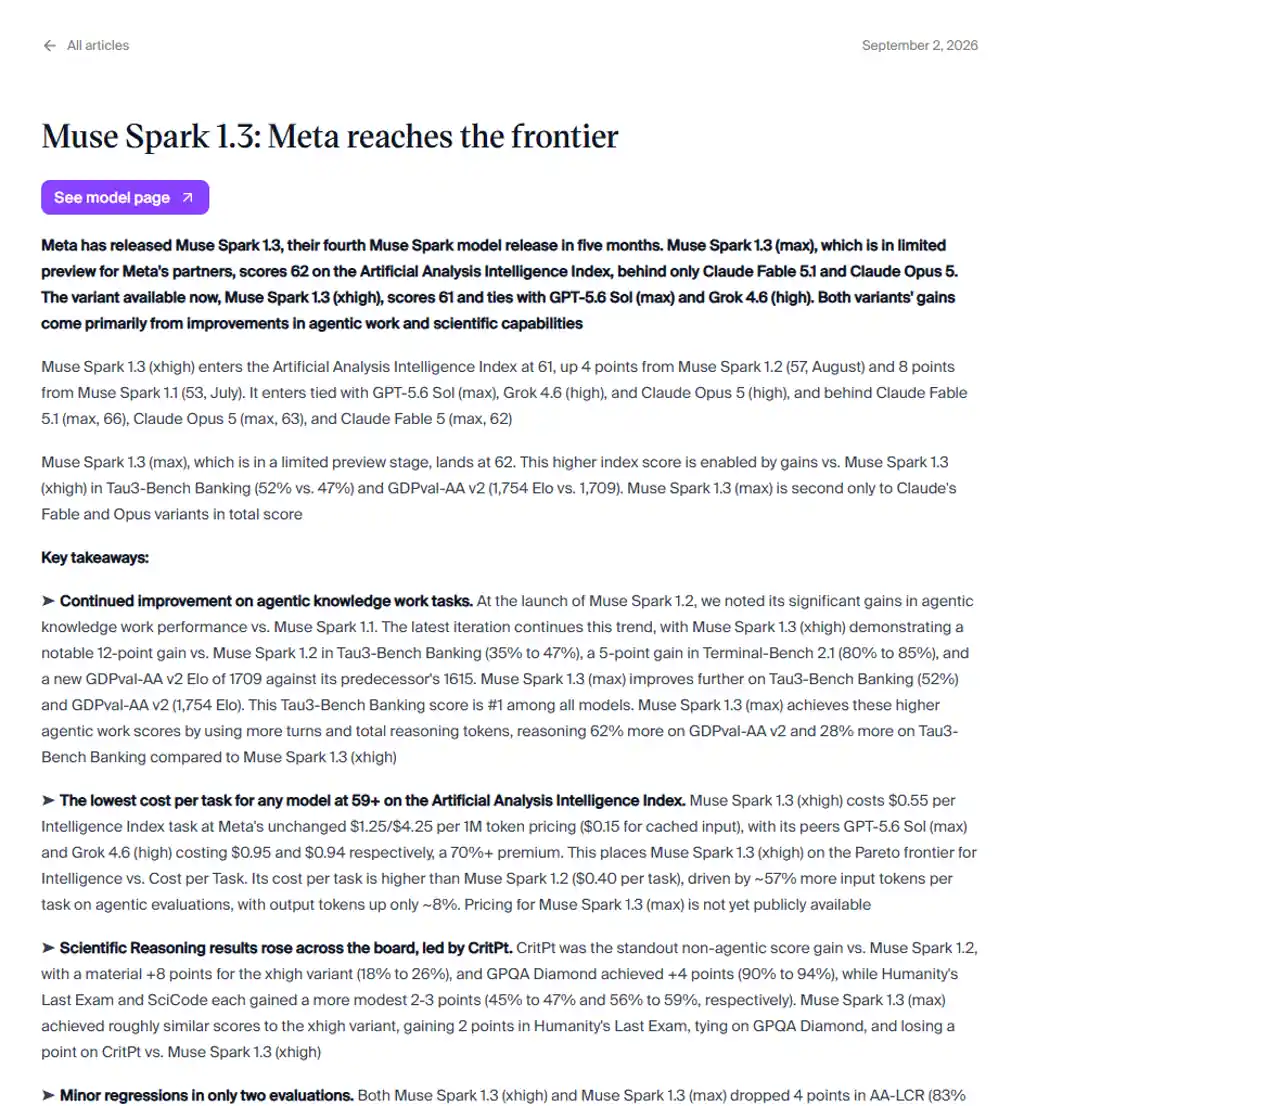
El análisis artificial ofrece una visión más clara de lo que los usuarios pueden acceder ahora. Muse Spark 1.3 xhigh obtiene una puntuación de 61, frente a los 57 de la versión 1.2. Su resultado en Terminal-Bench es de 85%, en GDPval-AA v2 alcanza los 1709 Elo y en Tau3-Bench Banking es de 47%. La variante «max» de la versión de vista previa limitada alcanza un 62 en total. También hay retrocesos: el AA-LCR cae de 83% a 79%, mientras que la precisión del AA-Omniscience pasa de 45% a 42% en xhigh.
Precios de Muse Spark 1.3
Colaborador
muse-spark-1.3-colaborador
$0.10 de entrada / $0.002 en caché / $0.20 de salida por millón de fichas.
Las sugerencias pueden utilizarse para mejorar los productos de Meta.
Estándar
muse-spark-1.3
$1,25 de entrada / $0,15 en caché / $4,25 de salida por millón de fichas.
Meta afirma que este nivel no se utiliza para mejorar sus productos.
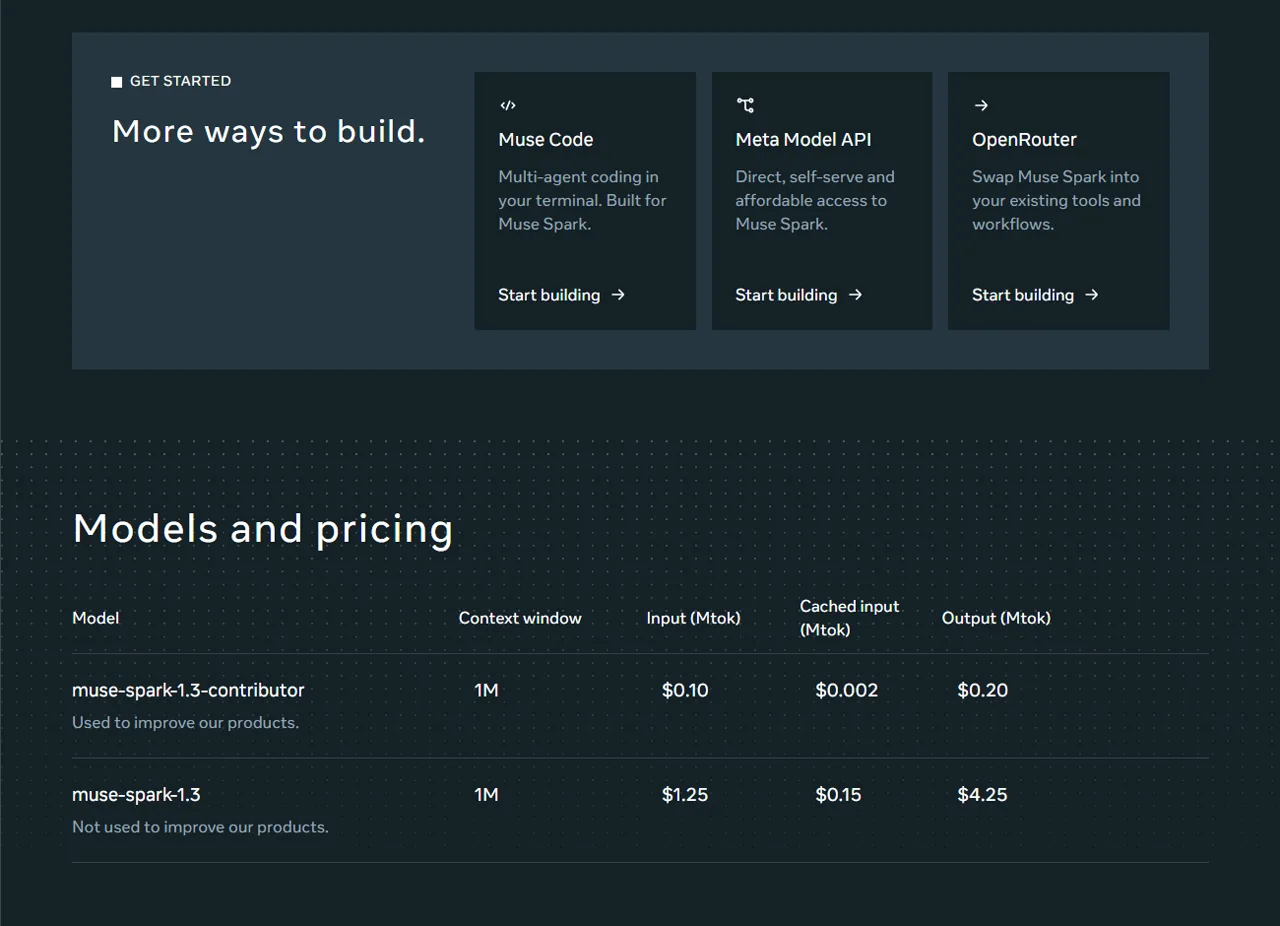
En precios oficiales de los tokens no han variado con respecto a la versión 1.2, pero el coste por tarea sí. Nuestro Reseña de una plataforma de IA «todo en uno» explica por qué el precio de acceso y el coste del flujo de trabajo deben evaluarse por separado. Artificial Analysis calculó $0,55 por tarea del Índice de Inteligencia para 1,3 xhigh, frente a $0,40 para 1,2, debido principalmente a unos 57% más de tokens de entrada en las evaluaciones de agencia. El nivel «contributor» es excepcionalmente económico, pero su cláusula de uso de datos es una elección real del producto, más que una simple nota al pie.
Acceso a la API de Muse Spark 1.3
Meta’s libro de recetas oficial ahora utiliza muse-spark-1.3 como valor predeterminado y define una ventana de contexto de 1 048 576 tokens. La API es compatible con el SDK OpenAI. Muse Code y la API de Meta Model son las vías de acceso actuales confirmadas. La página de modelos de Meta también muestra OpenRouter, aunque su botón seguía apuntando a una URL de la versión 1.2 al hacer clic en él, por lo que conviene verificar la ruta antes de la implementación. Para obtener información sobre la interoperabilidad de los agentes, consulta nuestra guía sobre MCP y herramientas de IA.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "Revisa este parche en busca de regresiones."}],
)

print(response.choices[0].message.content)
Pruebas prácticas de programación: 3/3 superadas
Hemos probado tres tareas de repositorio de dificultad media a través de una API a temperatura cero, utilizando una respuesta por tarea. Cada respuesta debía devolver archivos completos en formato JSON estructurado. A continuación, hemos aplicado esos archivos en directorios desechables y hemos realizado comprobaciones públicas y ocultas. Se trata de pequeñas pruebas controladas, que no sustituyen a Terminal-Bench ni a una prueba en un repositorio de producción.
5 de 5 pruebas; 18,4 s; 2.473 tokens; $0,00905. El modelo detectó el conjunto de identificadores procesados no utilizados, añadió una comprobación temprana de duplicados y escribió una prueba de regresión.
Se han superado la comprobación de tipos y dos comprobaciones en tiempo de ejecución; 47,6 s; 4.945 tokens; $0,01661. La validación, la persistencia y el registro de auditoría se han separado sin romper el límite de la transacción.
9 de 9 pruebas; 20,3 s; 3.789 tokens; $0,01446. Se han superado todas las pruebas de compatibilidad con CSV, errores con numeración de líneas, salida atómica, seguridad en la ejecución en modo de prueba, ayuda y documentación.
Total: 11 207 tokens y $0,04013. Los tiempos corresponden a los tiempos de solicitud de extremo a extremo, no a la latencia nativa de la API de Meta ni al TTFT.
El resultado fue mejor de lo que sugiere un simple “3/3”: las tres primeras respuestas eran revisables y tenían en cuenta las restricciones. Esa misma rigurosidad a la hora de presentar las pruebas es importante a la hora de leer nuestro Reseña de GPT-5. No obstante, la muestra no evalúa la fiabilidad de las llamadas repetidas a herramientas, la navegación por repositorios de gran tamaño ni la capa de orquestación de Muse Code. Los lectores que estén valorando alternativas más económicas también pueden consultar nuestro Comparación de modelos de codificación presupuestaria útil.
Primeras reacciones de los desarrolladores
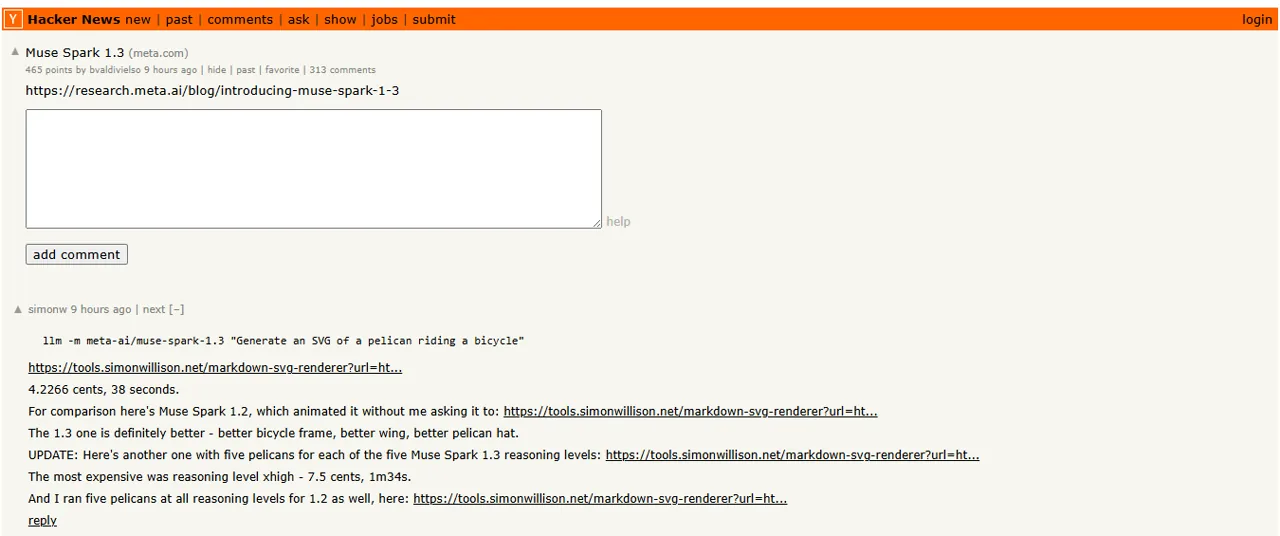
Las primeras reacciones son dispares y demasiado escasas como para hablar de consenso. En un Prueba de Hacker News, Simon Willison registró un tiempo de 38 segundos y 4,2266 céntimos en SVG y consideró que el resultado de la versión 1.3 era “sin duda mejor” que el de la versión 1.2 con la que lo comparó. Dax describió el lanzamiento como recuerdo de lo mucho que echaba de menos a las modelos de carreras. Sung Kim, tras pasar aproximadamente una hora con Muse Code, afirmó que el modelo podría ser bueno, pero que el producto de Muse Code “necesita mucho trabajo”. Ese último comentario se refiere a la experiencia del agente, no a una prueba aislada del modelo.
Ventajas e inconvenientes
Lo que funcionó
- Gran acogida por parte del público | Puntuación máxima
- Ventana de contexto de 1 millón de tokens
- API compatible con OpenAI
- Las tres tareas de programación superaron la primera respuesta
- Tasas de tokens muy bajas para los niveles de colaborador
Qué ver
- Los resultados de «Headline max» no son la experiencia pública predeterminada.
- El coste de las tareas independientes aumentó con respecto a 1,2
- Se han realizado regresiones de dos métricas independientes
- Los datos de los colaboradores pueden mejorar los productos de Meta
- Las primeras opiniones sobre Muse Code son dispares
¿Quién debería utilizar Muse Spark 1.3?
ÚSALO PARA
Evaluaciones de agentes de programación, trabajo con repositorios de contexto amplio, automatización basada en herramientas y experimentos en los que se tiene en cuenta el coste y la política de datos es aceptable.
SALTAR O ESPERAR CUANDO
Necesitas una fiabilidad de producción demostrada a largo plazo, necesitas la máxima capacidad hoy mismo o no puedes aceptar el uso de datos del nivel «colaborador» y consideras que los precios estándar no son competitivos.
Veredicto de la reseña de Muse Spark 1.3
Muse Spark 1.3 merece una recomendación para su evaluación. Combina un rendimiento público de vanguardia, excelentes resultados en contextos largos, una API ergonómica y familiar, y un precio muy competitivo. Nuestras tres tareas de programación de primera respuesta refuerzan la idea de que es capaz de seguir restricciones que abarcan varios archivos y generar parches que se pueden probar.
Elige el nivel estándar para el código sensible. Para otra comparación de Frontier, consulta GPT-5 frente a Claude 4. Considera los resultados máximos de las pruebas de rendimiento como indicios preliminares hasta que ese nivel de razonamiento esté ampliamente disponible. Y evalúa Muse Code por separado de la API del modelo: la experiencia de usuario, el ciclo de herramientas y el control del repositorio de un agente pueden tener éxito o fracasar independientemente del modelo base.
Preguntas frecuentes sobre Muse Spark 1.3
¿Qué es Muse Spark 1.3?
Muse Spark 1.3 es el modelo de programación y flujos de trabajo agenticos de Meta, lanzado el 2 de septiembre de 2026, con una ventana de contexto de 1 millón de tokens y percepción nativa de imágenes, vídeos y documentos.
¿Cuánto cuesta Muse Spark 1.3?
El modelo estándar cuesta $1,25 por cada millón de tokens de entrada, $0,15 para entradas almacenadas en caché y $4,25 para salidas. El modelo de colaborador cuesta $0,10; $0,002 y $0,20 respectivamente, pero sus datos pueden utilizarse para mejorar los productos de Meta.
¿Está disponible la función «max reasoning»?
Meta ha indicado que los modos de razonamiento existentes estaban disponibles en el momento del lanzamiento y que «max» se incorporaría tras realizar pruebas de seguridad adicionales. Consulta la documentación actual de la API antes de dar por hecho que ya está disponible de forma generalizada.
¿Ha superado Muse Spark 1.3 las pruebas de codificación?
Sí. Sus primeras respuestas superaron todas las comprobaciones de ejecutabilidad en nuestras pruebas de corrección de errores de Python, refactorización de TypeScript y pruebas de funcionalidades de JSONL. La muestra contiene únicamente tres tareas controladas y no representa una tasa de fiabilidad general.
¿Es Muse Spark 1.3 mejor que la versión 1.2?
En general, según los datos disponibles. La inteligencia pública xhigh pasó de 57 a 61 y Meta informa de importantes avances en la capacidad de agencia y en el contexto largo, pero Artificial Analysis también detectó un mayor coste de las tareas y ligeras regresiones en la recuperación de contexto largo y en la calibración de hechos.
¿Debería utilizar el modelo de colaborador o el estándar?
Utiliza la opción «estándar» para las indicaciones confidenciales o exclusivas, ya que Meta afirma que esos datos no se utilizan para mejorar sus productos. La opción «colaborador» es mucho más económica, pero sus indicaciones pueden utilizarse para mejorar los productos.