
Claude Sonnet 5.5 frente a Opus 5.5: precio, pruebas de rendimiento y pruebas reales
El Sonnet 5.5 y el Opus 5.5 pertenecen a la misma generación, la Claude 5.5, pero tienen precios y posicionamientos diferentes. En esta comparación se somete a ambos a las mismas cinco indicaciones y se recoge lo que la ruta ha devuelto realmente.
La diferencia que se aprecia se debe principalmente al coste y a la rapidez. En este paquete de cinco indicaciones, Sonnet 5.5 terminó antes, utilizó menos tokens de salida y arrojó la estimación más baja del coste aritmético de la solicitud. Opus 5.5 utilizó más tokens y más tiempo, mientras que sus respuestas solían ser más extensas. Las fichas de tareas muestran en qué casos ese texto adicional modificó el resultado útil y en qué casos ambos modelos simplemente superaron la prueba.
Las instrucciones, el límite máximo de solicitudes, la configuración del esfuerzo, el punto final y el diseño de una sola ejecución por modelo se mantuvieron en consonancia con el anterior Reseña del Claude Opus 5.5.
Respuesta rápida
- Velocidad en esta carrera por parejas: Sonnet 5.5 completó cinco solicitudes consecutivas en 31,930 segundos de forma local; Opus 5.5 tardó 47,725 segundos.
- Tokens de salida notificados por la ruta: Sonnet 5.5 utilizó 2.686; Opus 5.5 utilizó 3.952. Los campos de reflexión fueron 987 y 2.214, respectivamente.
- Cálculo aritmético del precio de catálogo: Las cinco solicitudes de Sonnet ascendieron a aproximadamente $0,02826; las cinco solicitudes de Opus ascendieron a aproximadamente $0,08184, utilizando las tarifas oficiales estándar por token y excluyendo la caché, los créditos, los impuestos y el margen comercial.
- Resultado de la tarea: Ambos modelos superaron las pruebas de extracción, JSON y matemáticas. Sonnet mantuvo de forma más clara el formato solicitado de dos párrafos en chino; los resultados de programación eran ambos útiles, pero diferían en cuanto a profundidad y explicación de casos extremos.
- Migración de la API: El razonamiento no se puede desactivar; se rechaza la elección forzada de herramientas, y los presupuestos simbólicos incluyen el razonamiento. Consulta el advertencias sobre la migración antes de cambiar.
- Límite de decisión: Se trata de una ejecución por tarea a través de una ruta de terceros. Mide las respuestas observadas a las solicitudes, el tiempo real local y el uso registrado por la ruta; no es una puntuación global de rendimiento.
Precio oficial y especificaciones del modelo
Las fichas de modelos actuales de Anthropic incluyen tanto modelos con una ventana de contexto de 1 millón de tokens como una salida máxima de 128 K. El modelo Sonnet 5.5 se denomina Rápido con un alto nivel de esfuerzo por defecto; Opus 5.5 está etiquetado como Moderado con un esfuerzo predeterminado medio. Las tasas estándar de los tokens hacen que Sonnet 5.5 sea la mitad del precio de entrada y salida de Opus 5.5.
| Modelo | ID de API | Etiqueta oficial de latencia | Entrada / salida | Contexto / potencia máxima | Esfuerzo por defecto | Lectura de caché |
|---|---|---|---|---|---|---|
| Claude Sonnet 5,5 | claude-soneto-5-5 | Activo · Rápido | $2 / $10 por MTok | 1 M / 128 K | Alta | $0.20 / MTok |
| Claude Opus 5,5 | claude-opus-5-5 | Activo · Moderado | $4 / $20 por MTok | 1 M / 128 K | Medio | $0.20 / MTok |
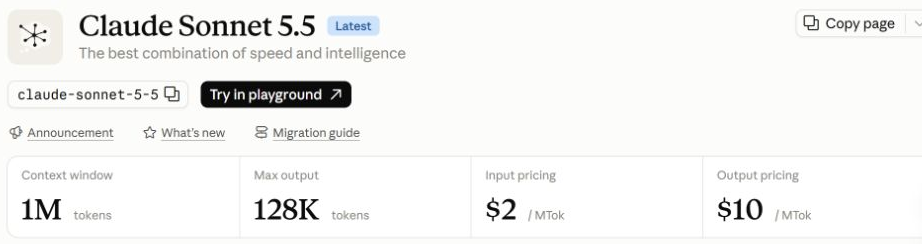
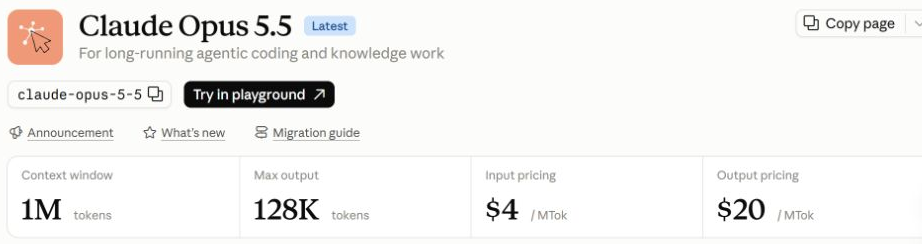
En un ejemplo sencillo sin caché de 100.000 tokens de entrada más 20.000 tokens de salida, las tasas de tokens indicadas ascienden a aproximadamente $0,40 en Sonnet 5,5 y a $0,80 en Opus 5,5. Consulte el Guía de precios y límites de Claude para el contexto del plan.
Contexto oficial de la prueba de referencia
Anthropic’s Anuncio sobre Sonnet 5.5 reúne ambos modelos en una tabla facilitada por el proveedor. La estructura de las filas varía según el punto de referencia y el nivel de esfuerzo.
| Índice de referencia publicado por Anthropic | Sonnet 5.5 | Opus 5.5 | Medida |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66,41 TP40T¹ | Codificación de terminales agenticos |
| FrontierCode v1.1 (Principal) | 46,21 TP40T Max² / 52,11 TP40T Xhigh | 54.4% | Si se fusionarían los cambios en el código |
| CursorBench 4.0 | 55.5% | 57.8% | Tareas ambiguas de codificación de varios archivos |
| GDPval-AA v2.1 | 1844 | 1846 | El trabajo intelectual en las distintas profesiones |
| El último examen de la humanidad | 64,51 TP40T con herramientas | 67,71 TP40T con herramientas | Razonamiento multidisciplinar |
| OSWorld 2.1 | 80.1% parcial | 81,81 TP40T parcial | Tareas relacionadas con el uso del ordenador |
| Cartografía | 61,61 TP40T sin herramientas | 64,41 TP40T sin herramientas | Reconocimiento de gráficos visuales |
¹ Opus 5.5 Terminal-Bench utiliza el nivel de esfuerzo «xhigh»; ² Sonnet 5.5 FrontierCode es de 46,2% en «Max» y de 52,1% en el nivel de esfuerzo «xhigh». Los valores de OSWorld se indican como «parciales». Se trata de datos del contexto del proveedor, no de una repetición independiente con el mismo nivel de esfuerzo.
Método de la API con el mismo prompt
Cada modelo recibió las mismas cinco indicaciones a través de PUBLICACIÓN https://anywhere.broly.ai/v1/messages. El cliente envió un mensaje de usuario, max_tokens: 8192, output_config.effort: alto, y sin herramientas. Todas las solicitudes devolvieron un código HTTP 200 y fin de turno.
El enfoque de las pruebas se inscribe en el marco más amplio de Flujo de trabajo para la validación del modelo GlobalGPT. Un otro Guía de la API Claude abarca la configuración de las solicitudes y la gestión de tokens.
Tiempo, fichas y coste estimado
| Ruta | Las cinco en hora local | Tokens de entrada | Tokens de salida | Pensamiento expresado | Coste estimado de la solicitud* |
|---|---|---|---|---|---|
| Claude Sonnet 5,5 | 31,930 s | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5,5 | 47,725 s | 700 | 3,952 | 2,214 | $0.08184 |
* Estimación basada en los tokens registrados por la ruta y las tarifas estándar oficiales. El Sonnet 5.5 registró un valor 33,11 TP40T inferior en cuanto al tiempo transcurrido local y 32,01 TP40T inferior en cuanto al recuento de tokens de salida en este grupo.
Cinco tarjetas de tareas a juego
Cada ficha recoge la tarea, la observación, la hora local, las fichas de ruta registradas, el estado y los límites.
¿Pueden los modelos reparar una función de deduplicación de tipo mixto?
Configuración de la tarea: La indicación exacta se copió de la anterior Reseña del Claude Opus 5.5 paquete de prueba.
| Modelo | Tiempo / uso de la ruta | Etiqueta de resultado breve |
|---|---|---|
| Claude Sonnet 5,5 | 8,679 s 145 de entrada / 830 de salida 0 reflexiones HTTP 200 · fin de turno | Función corregida más dos ejercicios; explicación más breve. |
| Claude Opus 5,5 | 15,844 s 145 de entrada / 1478 de salida 700 reflexiones HTTP 200 · fin de turno | Se ha corregido la función y se han añadido dos pruebas; se ha ampliado el análisis de los casos extremos. |
Comparación observada: Ambos devolvieron una función corregida y dos pruebas. Sonnet 5.5 utilizó claves etiquetadas por tipo, casefold(), y una alternativa en forma de lista en una respuesta más breve; Opus 5.5 dedicó más tokens de salida a explicar casos extremos adicionales. Ninguna de las dos ejecuciones permite determinar un ganador general en cuanto a la codificación.
Límite: Una única y sencilla corrección en Python comprueba casos extremos concretos, pero no garantiza la fiabilidad en todos los repositorios ni en la programación basada en herramientas.
¿Pueden los modelos conservar los cinco datos proporcionados sin añadir afirmaciones?
Configuración de la tarea: La indicación exacta se copió de la anterior Reseña del Claude Opus 5.5 paquete de prueba.
| Modelo | Tiempo / uso de la ruta | Etiqueta de resultado breve |
|---|---|---|
| Claude Sonnet 5,5 | 3,569 s 210 de entrada / 209 de salida 0 reflexiones HTTP 200 · fin de turno | Cinco viñetas numeradas; se han conservado los datos facilitados. |
| Claude Opus 5,5 | 4,374 s 210 de entrada / 312 de salida 101 formas de pensar HTTP 200 · fin de turno | Cinco viñetas numeradas; se han conservado los datos facilitados. |
Comparación observada: Ambos devolvieron exactamente cinco viñetas numeradas y se ciñeron a los datos proporcionados. Sonnet 5.5 utilizó 209 tokens de salida frente a los 312 de Opus 5.5, pero la indicación era una nota breve en lugar de una entrada con un contexto amplio.
Límite: Se trata de una comprobación de extracción y formateo basada en datos reales; no constituye una prueba del rendimiento en contextos de un millón de tokens.
¿Pueden los modelos devolver la estructura exacta solicitada?
Configuración de la tarea: La indicación exacta se copió de la anterior Reseña del Claude Opus 5.5 paquete de prueba.
| Modelo | Tiempo / uso de la ruta | Etiqueta de resultado breve |
|---|---|---|
| Claude Sonnet 5,5 | 5,052 s 128 de entrada / 260 de salida 0 reflexiones HTTP 200 · fin de turno | JSON analizable; claves solicitadas y recuentos de elementos. |
| Claude Opus 5,5 | 8,276 s 128 de entrada / 622 de salida 390 reflexiones HTTP 200 · fin de turno | JSON analizable; claves solicitadas y recuentos de elementos. |
Comparación observada: Ambos devolvieron un JSON analizable con las claves solicitadas y dos ventajas y dos inconvenientes. Sonnet 5.5 fue más conciso, con 260 tokens de salida; las cadenas describen una situación ficticia de reseña y no son datos del producto.
Límite: El hecho de superar esta prueba una sola vez no permite evaluar la fiabilidad de la salida estructurada en el marco de llamadas a herramientas o conversaciones prolongadas.
¿Pueden los modelos aplicar la secuencia de lotes redondeada hasta llegar a la respuesta final?
Configuración de la tarea: La indicación exacta se copió de la anterior Reseña del Claude Opus 5.5 paquete de prueba.
| Modelo | Tiempo / uso de la ruta | Etiqueta de resultado breve |
|---|---|---|
| Claude Sonnet 5,5 | 2,947 s 89 de entrada / 163 de salida 0 reflexiones HTTP 200 · fin de turno | Resultado correcto: 67; la respuesta final debe figurar en una línea aparte. |
| Claude Opus 5,5 | 3,830 s 89 de entrada / 257 de salida 74 reflexiones HTTP 200 · fin de turno | Resultado correcto: 67; la respuesta final debe figurar en una línea aparte. |
Comparación observada: Ambos calcularon 67 y colocaron la respuesta final en una línea aparte. Sonnet 5.5 utilizó 163 tokens de salida frente a los 257 de Opus 5.5, sin que se observara ninguna diferencia en cuanto a la corrección en esta indicación.
Límite: Una sucesión aritmética no permite evaluar la fiabilidad del razonamiento general.
¿Se puede mantener en la ruta la estructura de dos párrafos solicitada?
Configuración de la tarea: La indicación exacta se copió de la anterior Reseña del Claude Opus 5.5 paquete de prueba.
| Modelo | Tiempo / uso de la ruta | Etiqueta de resultado breve |
|---|---|---|
| Claude Sonnet 5,5 | 11,683 s 128 de entrada / 1224 de salida 987 reflexiones HTTP 200 · fin de turno | Dos párrafos en chino; sin formato adicional. |
| Claude Opus 5,5 | 15,401 s 128 entradas / 1283 salidas 949 reflexiones HTTP 200 · fin de turno | He abordado los puntos; he añadido Markdown y una nota en inglés. |
Comparación observada: Sonnet 5.5 devolvió los dos párrafos en chino solicitados sin formato adicional. Opus 5.5 también cubrió los puntos solicitados, pero añadió formato Markdown y una nota en inglés. Este informe recoge el formato obtenido en una sola ejecución, no la calidad general del chino.
Límite: La consigna pide una introducción sobre Opus 5.5, por lo que el texto en sí mismo no es un referente de lenguaje neutro.
Consideraciones sobre la API y la migración
Sonnet 5.5 ejecuta el pensamiento adaptativo de forma predeterminada; la opción «thinking: disabled» devuelve un error 400, y «max_tokens» abarca tanto el pensamiento como el texto de la respuesta. Se rechaza la elección forzada de herramienta «any/tool». Analiza los bloques de contenido por tipo y vuelve a establecer los presupuestos de tokens antes de cambiar.
Lo que respaldan los datos
Veredicto a nivel de tarea
Sonnet 5.5: menor coste y menor tiempo registrados en esta ruta, con un cumplimiento riguroso de los requisitos de formato en la tarea china.
Opus 5.5: aquí es más caro y más amplio; las series de pruebas de rendimiento oficiales siguen por delante en varias tareas de duración indefinida.
Utiliza los datos a nivel de tarea para elegir un punto de partida y, a continuación, valida la carga de trabajo que te resulte relevante.
Para conocer el contexto adyacente, consulta el Comparación de la familia Claude, Reseña de Opus 5, y Reseña de Fable 5.1.
PREGUNTAS FRECUENTES
¿Qué modelo fue más rápido en la prueba comparativa?
Sonnet 5.5 registró el tiempo total local más bajo: 31,930 segundos frente a los 47,725 segundos de Opus 5.5 en cinco solicitudes consecutivas. Esto incluye la ruta y el trazado de red utilizados en este caso, por lo que no se trata de latencia por parte del proveedor.
¿Qué modelo utilizó menos tokens de salida?
Sonnet 5.5 utilizó 2.686 tokens de salida generados por la ruta en las cinco tareas, frente a los 3.952 de Opus 5.5. El recuento de tokens por sí solo no demuestra la calidad de las respuestas.
¿Qué modelo ha resultado más barato en esta serie?
Utilizando las tarifas oficiales estándar de la API y los recuentos de entradas y salidas obtenidos, las cinco solicitudes de Sonnet 5.5 dan un resultado estimado de $0,02826, frente a los $0,08184 de Opus 5.5. El cálculo excluye los cargos por caché, los créditos de la plataforma, los impuestos y el margen comercial.
¿Supera el Sonnet 5.5 al Opus 5.5 en todas las pruebas de rendimiento?
La tabla del Anthropic presenta resultados dispares según la prueba de rendimiento y la configuración de esfuerzo: Sonnet 5.5 obtiene mejores resultados en Terminal-Bench 4.0, mientras que Opus 5.5 obtiene mejores resultados en FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld y Chartography. Se trata de resultados facilitados por los propios proveedores, no de una repetición independiente de las pruebas.
¿Es Sonnet 5.5 un sustituto directo de la API?
No. La guía de migración indica que «thinking» se ejecuta de forma predeterminada; «thinking: disabled» devuelve un error 400; la selección forzada de herramientas «any/tool» se rechaza; y los clientes deben analizar los bloques de contenido por tipo. Vuelve a establecer los presupuestos de tokens y los bucles de herramientas antes de realizar el cambio.
¿Se trataba de una prueba de rendimiento con un contexto extenso?
No. La indicación de extracción contiene un breve fragmento. Comprueba la veracidad de los datos y el formato exacto; no evalúa el comportamiento en las proximidades de la ventana de contexto documentada de 1 millón de tokens.









