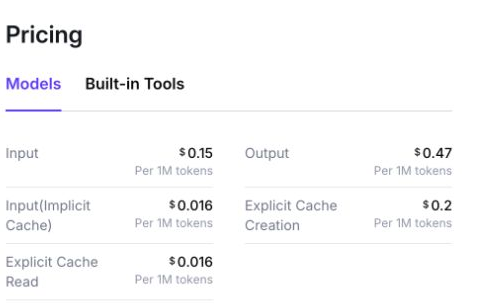
Überprüft am 27. August 2026. Qwen3.8 Flash ist das verwaltete Produktionsmodell von Qwen mit der API-ID qwen3.8-flash. Es unterscheidet sich vom Open-Weight-Artefakt „Qwen3.8-Flash-Next“. Qwen Cloud gibt Basisraten von $0,15 pro Million Eingabetoken und $0,47 pro Million Ausgabetoken an. Kurz gesagt: Es lohnt sich, das Modell in einem kontrollierten Test zu erproben, wenn Sie kostengünstige multimodale Verarbeitung und ein großes angegebenes Kontextfenster benötigen; Sie sollten jedoch die Routenbeschränkungen und die Qualität der Evidenz überprüfen, bevor Sie es in der Produktion einsetzen.
Der praktische Nutzen liegt auf der Hand: ein Kontextfenster mit einer Kapazität von 1 Million Token, die Eingabe von Text, Bildern und Videos, Funktionen für strukturierte Ausgaben und Werkzeuge sowie niedrige Grundtarife pro Token. Es eignet sich hervorragend für die Synthese langer Dokumente, multimodale Analysen und strukturierte operative Aufgaben; bei einem Workflow mit hohem Einsatz sollten Sie mit einer repräsentativen Aufgabe beginnen und anhand der Ausgabe entscheiden, was Sie tatsächlich nutzen können.
GlobalGPT ist eine unabhängige Arbeitsumgebung für mehrere Modelle—kein offizieller Kanal von Alibaba oder Qwen—aber es ist nützlich, wenn Ihre Arbeit nicht in ein bestimmtes Modell passt. Auf einer einzigen Seite können Sie Qwen3.8 Flash mit weit verbreiteten Modellfamilien wie ChatGPT, Claude, Gemini und Grok vergleichen und anschließend Recherche, Entwurf, Hilfe beim Programmieren, Dokumentenanalyse und Prompt-Tests im selben Arbeitsablauf zusammenfassen. Das ist besonders praktisch, wenn eine Aufgabe die Stärken von Qwen im Umgang mit langen Kontexten oder multimodalen Inhalten erfordert, während eine andere Aufgabe vom Schreib-, Argumentations- oder Programmierstil eines anderen Modells profitiert.
Was ist Qwen3.8 Flash?
Qwen3.8 Flash ist ein von Qwen Cloud bereitgestelltes, gehostetes multimodales Modell für schnelle Aufgaben mit hohem Datenaufkommen. Auf der offiziellen Seite werden Text, Bilder und Videos als Eingaben sowie Text als Ausgabe aufgeführt. Außerdem werden Funktionsaufrufe, strukturierte Ausgaben, Prompt-Caching, Stapelverarbeitung, Websuche und Feinabstimmung genannt. Dies sind die offiziellen Funktionen des Dienstes; eine Schnittstelle eines Drittanbieters stellt möglicherweise nur einen Teil dieser Funktionen bereit.
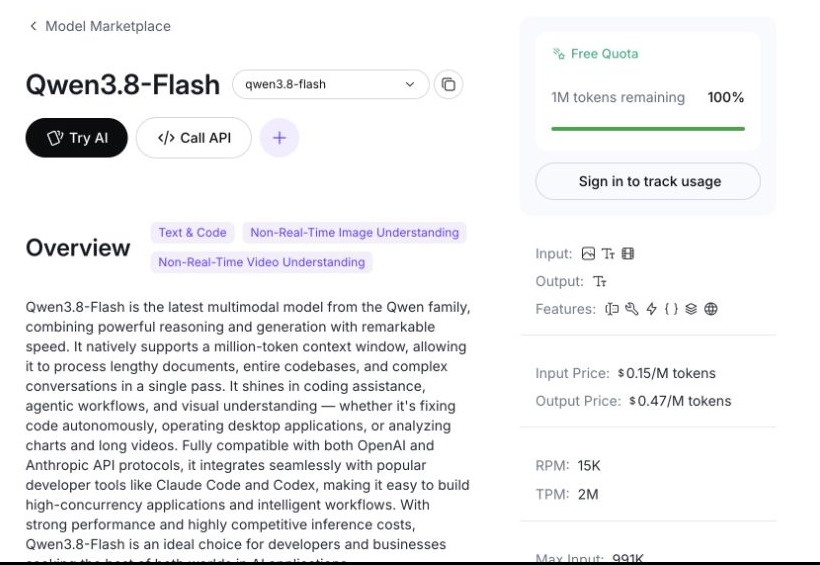
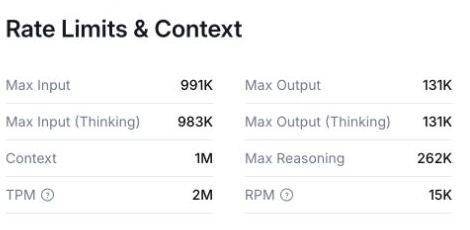
Das angezeigte Kontextfenster umfasst 1 Mio. Token. Qwen Cloud zeigt zudem routenspezifische Grenzwerte anstelle eines einzigen unbegrenzten Speichers an: Der Standardpfad listet eine maximale Eingabe von 991.000 und eine maximale Ausgabe von 131.000 auf, während der „Thinking“-Modus über ein eigenes Eingabelimite verfügt. Ein großes Kontextfenster ist nur dann hilfreich, wenn die Route die Datei akzeptiert, die Abrufstruktur einwandfrei ist und das Modell die relevanten Belege nachverfolgen kann.
- Behandeln Sie die genaue API-ID als Teil der Reproduzierbarkeit.
- Unterscheiden Sie die dokumentierten Funktionen des Basismodells von den Werkzeugen, die von der von Ihnen gewählten Plattform bereitgestellt werden.
- Verwenden Sie bei Arbeiten mit umfangreichem Belegmaterial einen langen Kontext, verlangen Sie jedoch Quellenangaben oder strukturierte Überprüfungen, anstatt sich allein auf einen umfangreichen Upload zu verlassen.
Qwen3.8 Flash vs. Qwen3.8 Flash-Next
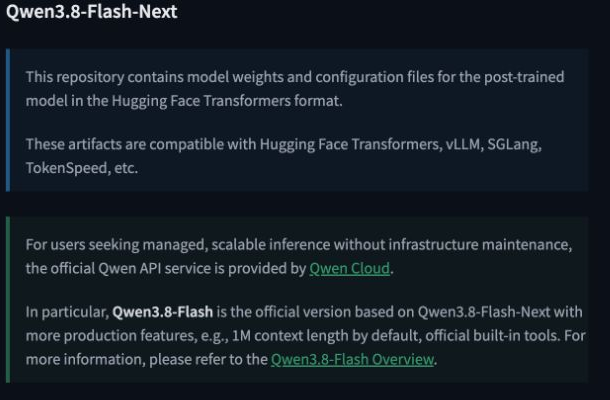
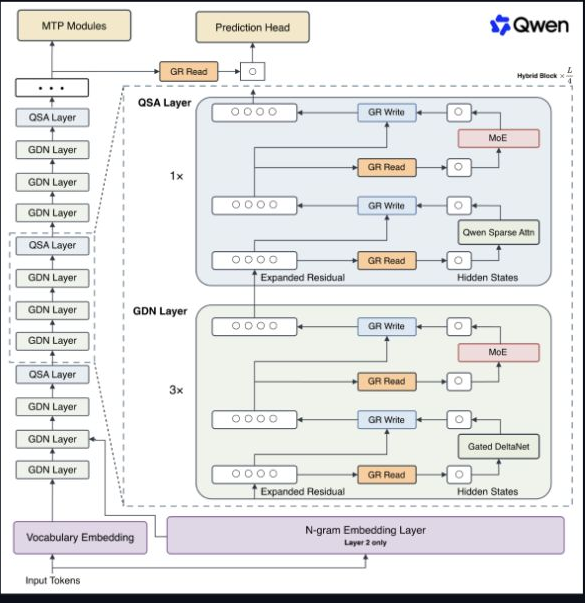
Die Bezeichnungen lassen sich zwar leicht zu einem einzigen Produkt zusammenfassen, doch die Unterscheidung ist wichtig. In der offiziellen Modellkarte von Qwen wird Qwen3.8-Flash als die auf Qwen3.8-Flash-Next basierende Produktionsversion beschrieben. Flash-Next ist das Artefakt mit offenem Gewicht, dessen Architekturdetails und Gewichte öffentlich zugänglich sind; Flash ist der verwaltete Produktionsdienst mit offiziellen integrierten Tools und einem Standard-Kontextfenster von 1M.
| Frage | Qwen3.8 Flash | Qwen3.8 Flash-Next |
|---|---|---|
| Was ist das? | Verwaltetes Produktionsmodell und API | Veröffentlichung von Artefakten und technischen Informationen in allen Gewichtsklassen |
| Eindeutige Kennung | qwen3.8-flash | Qwen3.8-Flash-Next |
| Gewichte | Auf der Produktseite nicht als herunterladbare Gewichtsangaben aufgeführt | Öffentliches Modellartefakt |
| Integrierte Tools | Eingetragen von Qwen Cloud; abhängig von der Route | Nicht gleichbedeutend mit einem gehosteten Tool-Stack |
| Benchmark-Ergebnisse | Es wurde keine verifizierte, unabhängige Rangliste mit exakten Produktionszahlen gefunden. | Vom Hersteller angegebene Tabellen auf der Modellkarte |
Das bedeutet, dass ein „Flash-Next“-Ergebnis zwar die technische Ausrichtung des Qwen verdeutlichen kann, jedoch nicht als eigenständiges Ergebnis eines Serienmodells umgedeutet werden sollte. Der Testort, der Kabelbaum und die genaue Modellbezeichnung müssen neben jeder Zahl angegeben werden.
Wo kann man den Qwen3.8-Blitz einsetzen?
In diesem Projekt gibt es drei verifizierte Routen, die unterschiedliche Aufgaben erfüllen. Nur „Qwen Cloud“ ist die offizielle Qwen-API-Route. „GlobalGPT“ ist eine unabhängige Multi-Modell-Abonnementplattform. „Anywhere“ war die API-Route, die für die Bereitschaftsprüfung und die praktischen Übungen verwendet wurde; sie dient als Nachweis für die getestete Verfügbarkeit, ist jedoch kein offizielles Ziel für Verbraucher.
| Route | Status | Was wurde überprüft? | Wichtige Grenze |
|---|---|---|---|
| Qwen Cloud | Offiziell | Modellseite, API-ID, Preise, Kontext und Funktionsübersicht | Es gelten weiterhin die Bedingungen des jeweiligen Dienstes und die regionale Verfügbarkeit. |
| GlobalGPT | Unabhängige Plattform | Seite zum Modell „Visible Qwen3.8 Flash“ und Preise für Jahresabonnements | Die genaue Zuordnung von Plan zu Modell steht noch aus |
| Überall | Getestete API-Route | Die genaue Modell-ID wurde angegeben und erfolgreiche Antworten wurden erhalten | Die Semantik der öffentlichen Dollar-Kosten und der Nutzungsobergrenzen ist nach wie vor nicht verifiziert |
GlobalGPT ist vor allem für diejenigen sinnvoll, die innerhalb eines Arbeitsbereichs zwischen Modellen wechseln möchten, anstatt separate API-Konten zu nutzen. Verwenden Sie die Aktuelle Preisliste für GlobalGPT um das Live-Paket vor der Zahlung zu bestätigen; auf der Seite wurden während der Recherche die Preise für Jahresabonnements angezeigt, aber in der sichtbaren Liste der Tarife wurde „Qwen3.8 Flash“ nicht ausdrücklich einer bestimmten Tarifstufe zugeordnet.
Qwen3.8 Flash – Preis und Nutzen
Auf der offiziellen Seite von Qwen Cloud sind als Basissätze $0,15 pro Million Eingabetoken und $0,47 pro Million Ausgabetoken angegeben. Außerdem sind niedrigere Cache-Lese-Sätze sowie separate Preise für die explizite Cache-Erstellung aufgeführt. Kostenschätzungen sollten daher angeben, welcher Tarif zugrunde gelegt wird, und nicht den Eindruck erwecken, dass Gebühren für Tools, Websuchen oder andere Plattformen bereits enthalten sind.
Was die Basistoken-Sätze bedeuten
100.000 Eingänge + 10.000 Ausgänge zu den angegebenen Basisraten.
1 Mio. Eingänge + 100.000 Ausgänge bei den angegebenen Basisraten.
Die Berechnungsbeispiele berücksichtigen keine Tools, Caching-Optionen, Plattformgebühren und etwaige routenspezifische Gebühren.
Das erste Beispiel ist eine Anfrage zur Analyse eines umfangreichen Dokuments: 100.000 Eingabetoken kosten $0,015 und 10.000 Ausgabetoken kosten $0,0047, was nach den angegebenen Basispreisen insgesamt $0,0197 ergibt. Das zweite Beispiel umfasst 1 Mio. Eingabe- und 100.000 Ausgabetoken: $0,15 plus $0,047, also insgesamt $0,197. Hierbei handelt es sich um rechnerische Beispiele, nicht um Rechnungen oder Zusagen bezüglich einer Route eines Drittanbieters.
Der Token-Preis ist nur ein Teil des Werts. Ein niedriger Preis ist vor allem dann entscheidend, wenn die Ausgabe zuverlässig genug ist, um die Überprüfungszeit zu verkürzen, und wenn Caching oder Batching zur Arbeitslast passen. Bei einer Extraktionspipeline sollten Sie neben den Token auch die Kosten für Wiederholungsversuche, Validierung und manuelle Korrekturen berechnen. Bei einem interaktiven Team sollten Sie das monatliche Abonnement mit der Zeitersparnis vergleichen, die dadurch entsteht, dass mehrere Modelle in einem Arbeitsbereich verwaltet werden. Der aussagekräftige Entscheidungsmaßstab sind die Kosten pro akzeptiertem Ergebnis, nicht die Kosten pro generiertem Token. Da im Rahmen dieser Überprüfung weder eine Produktionslast getestet noch die öffentliche Dollar-Semantik von Anywhere verifiziert wurde, wird kein allgemeingültiger Kostensieger ermittelt.
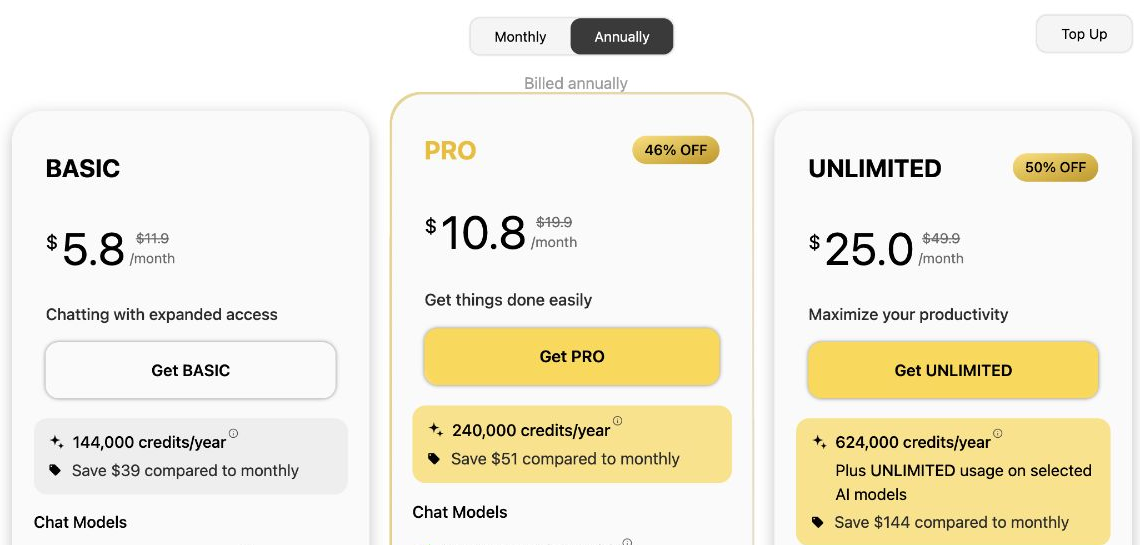
GlobalGPT nutzt ein Abonnementmodell anstelle einer direkten Abrechnung pro Token. In der Jahresübersicht vom 27. August 2026 wurden die Preise für „Basic“ mit $5,8 pro Monat, für „Pro“ mit $10,8 und für „Unlimited“ mit $25 angegeben. Ein Abonnement lässt sich leichter budgetieren, wenn man zwischen mehreren Modellen wechselt, ist jedoch nicht direkt mit den Preisen für API-Token vergleichbar, da sich Guthaben, Modellzugriff und Plattformsteuerung unterscheiden.
- Wählen Sie die Token-Abrechnung, wenn Sie programmatische Volumensteuerung, Protokolle und native API-Steuerungsfunktionen benötigen.
- Entscheiden Sie sich für ein Multi-Modell-Abonnement, wenn der Hauptnutzen im interaktiven Zugriff und im Modellwechsel liegt.
- Berechnen Sie den „Anywhere“-Dollar-Kostenwert nicht anhand undokumentierter Preisverhältnisse; die öffentliche Dollar-Semantik wurde nicht überprüft.
Fähigkeiten, die in der Praxis zählen
Umfangreiche Dokumente und Codebasen
Eine Listung von 1M-Token macht Qwen3.8 Flash interessant für Repository-Prüfungen, Dokumentensammlungen und lange Transkripte. Die entscheidende Frage ist nicht, ob eine große Datei passt, sondern ob das Modell Konflikte erkennen, Unbekanntes beibehalten und auf die Quelle verweisen kann. Die 15-seitige Rückverfolgbarkeitsaufgabe weiter unten in diesem Test prüft dieses spezifischere Verhalten und nicht das maximale Fenster.
Programmierung und Agenten-Workflows
Qwen positioniert das Modell für Codierungs- und agentische Aufgaben, und die Flash-Next-Karte liefert überzeugende Ergebnisse bei verschiedenen Codierungs-Testsuiten. Diese Ergebnisse sind nützliche Anhaltspunkte dafür, was als Nächstes getestet werden sollte, ersetzen jedoch nicht die Durchführung eigener Repository-, Tool- und Abnahmetests. Eine umfassendere Entscheidungsgrundlage finden Sie in unserem Leitfaden zu den beste AI-Modelle für die Codierung.
Multimodale Analyse
Der offizielle Dienst akzeptiert Bild- und Videodaten. In der Praxis kann dies die Überprüfung von Krankenakten, die Auswertung von Bildschirmaufnahmen, Dokumentbilder und Fragen mit langen Videoclips unterstützen. Dateigröße, Dauer, Extraktionsqualität und plattformspezifische Einschränkungen der Benutzeroberfläche spielen weiterhin eine Rolle. Unsere kleine Bildaufgabe überprüft eine Krankenakte mit einem absichtlich eingebauten Konflikt in der Befundung; sie sagt nichts über die allgemeine Qualität des visuellen Schlussfolgerns aus.
Werkzeuge und strukturierte Ausgabe
Funktionsaufrufe und strukturierte Ausgabe sind besonders für den Produktivbetrieb relevant, da sie der Anwendung testbare Elemente liefern. Cache- und Batch-Funktionen können die Wirtschaftlichkeit im großen Maßstab verändern. Die Websuche kann für Aktualität sorgen, aber gesuchte Fakten benötigen eine eigene Quellenangabe. Überprüfen Sie jede Funktion auf dem Weg, den Sie tatsächlich nutzen möchten.
Was die Benchmark-Ergebnisse wirklich zeigen
Der aussagekräftigste sichtbare Benchmark-Nachweis im aktuellen Quelldatensatz ist die eigene „Flash-Next“-Modellkarte von Qwen. Sie weist einen Wert von 58,7 bei DeepSWE 1.1, 62,5 bei SWE-bench Pro und 81,0 in der angezeigten Zeile zum mehrsprachigen Software-Engineering auf. Die Karte enthält außerdem Hinweise zu Testumgebungen und zum Kontext. Diese Details machen die Tabelle zwar nützlicher, machen die Angaben des Anbieters jedoch nicht zu einer unabhängigen Validierung.
Vom Anbieter gemeldete Ergebnisse der Flash-Next-Kodierung
Diese drei Werte stammen aus der Flash-Next-Modellkarte von Qwen. Es handelt sich dabei nicht um eigenständige Ergebnisse für das verwaltete Produktionsmodell.
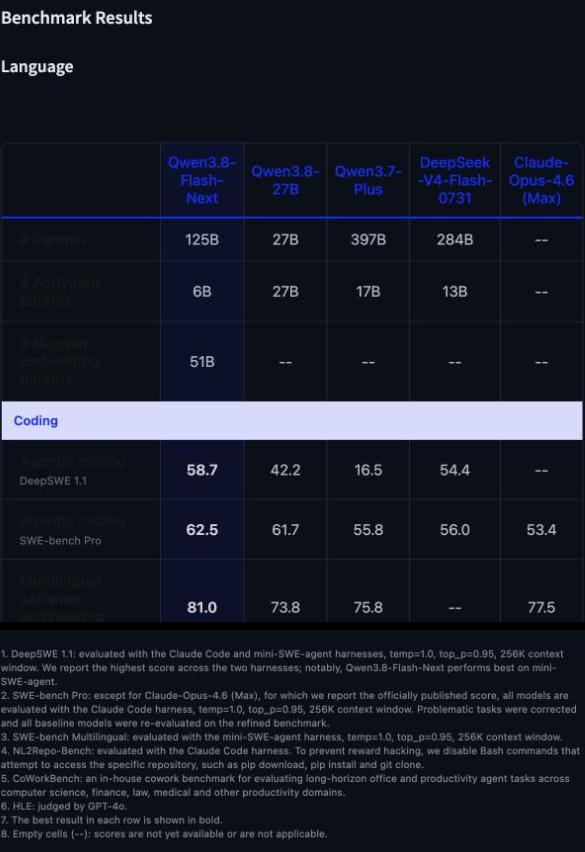
Am 27. August wurde kein fundierter, maßgeblicher Eintrag in der unabhängigen Rangliste für genau das Modell „Qwen3.8-Flash“ verifiziert. Diese Lücke dürfte weiterhin bestehen bleiben. Eine verantwortungsvolle Aktualisierung würde ein unabhängiges Ergebnis erst dann hinzufügen, wenn in der Rangliste das genaue Modell genannt und der Kabelbaum, das Datum sowie die Strecke offengelegt werden.
- Übertragen Sie keine Flash-Next-Scores ohne eine Äquivalenzerklärung in die Flash-Produktionsumgebung.
- Vergleichen Sie die Zahlen verschiedener Kabelbaumversionen nicht miteinander, als ob sie auf derselben Skala lägen.
- Wählen Sie mithilfe der Anbietertabelle Testfälle aus und validieren Sie diese anschließend anhand Ihrer eigenen Arbeitslast.
Unser kleiner Praxistest
Wie die Überprüfung durchgeführt wurde
- Genaues Modell:
qwen3.8-flashüber den bewährten Weg der Chat-Vervollständigungen von Anywhere. - Pro aktiver Aufgabe wird jeweils eine erste Ausgabe zurückgegeben; es finden keine Qualitätswiederholungen oder Stabilitätsläufe statt.
- Die automatischen strengen Prüfungen finden unabhängig von der Überprüfung der Anforderungen durch den Koordinator statt, die in den einzelnen Aufforderungen sichtbar sind.
- Die gemeldete Nutzung hat die angeforderten Ausgabegrenzen überschritten, sodass die Semantik der Nutzungsbegrenzung und die öffentlichen Kosten in Dollar weiterhin nicht verifiziert sind.
Die drei ersten Aufgaben beziehen sich auf strukturierte Prüfungen, die Beurteilung von Diagrammen und die Rückverfolgbarkeit. Sie dienen der gezielten Beobachtung und stellen keinen allgemeinen Maßstab dar.
Eine ausgesetzte JavaScript-Aufgabe ist zweimal abgelaufen, ohne dass ein HTTP-Status, Inhalt oder Nutzungsdaten vorlagen. Sie erhielt keine Bewertung und gilt nicht als Nachweis der Leistungsfähigkeit.
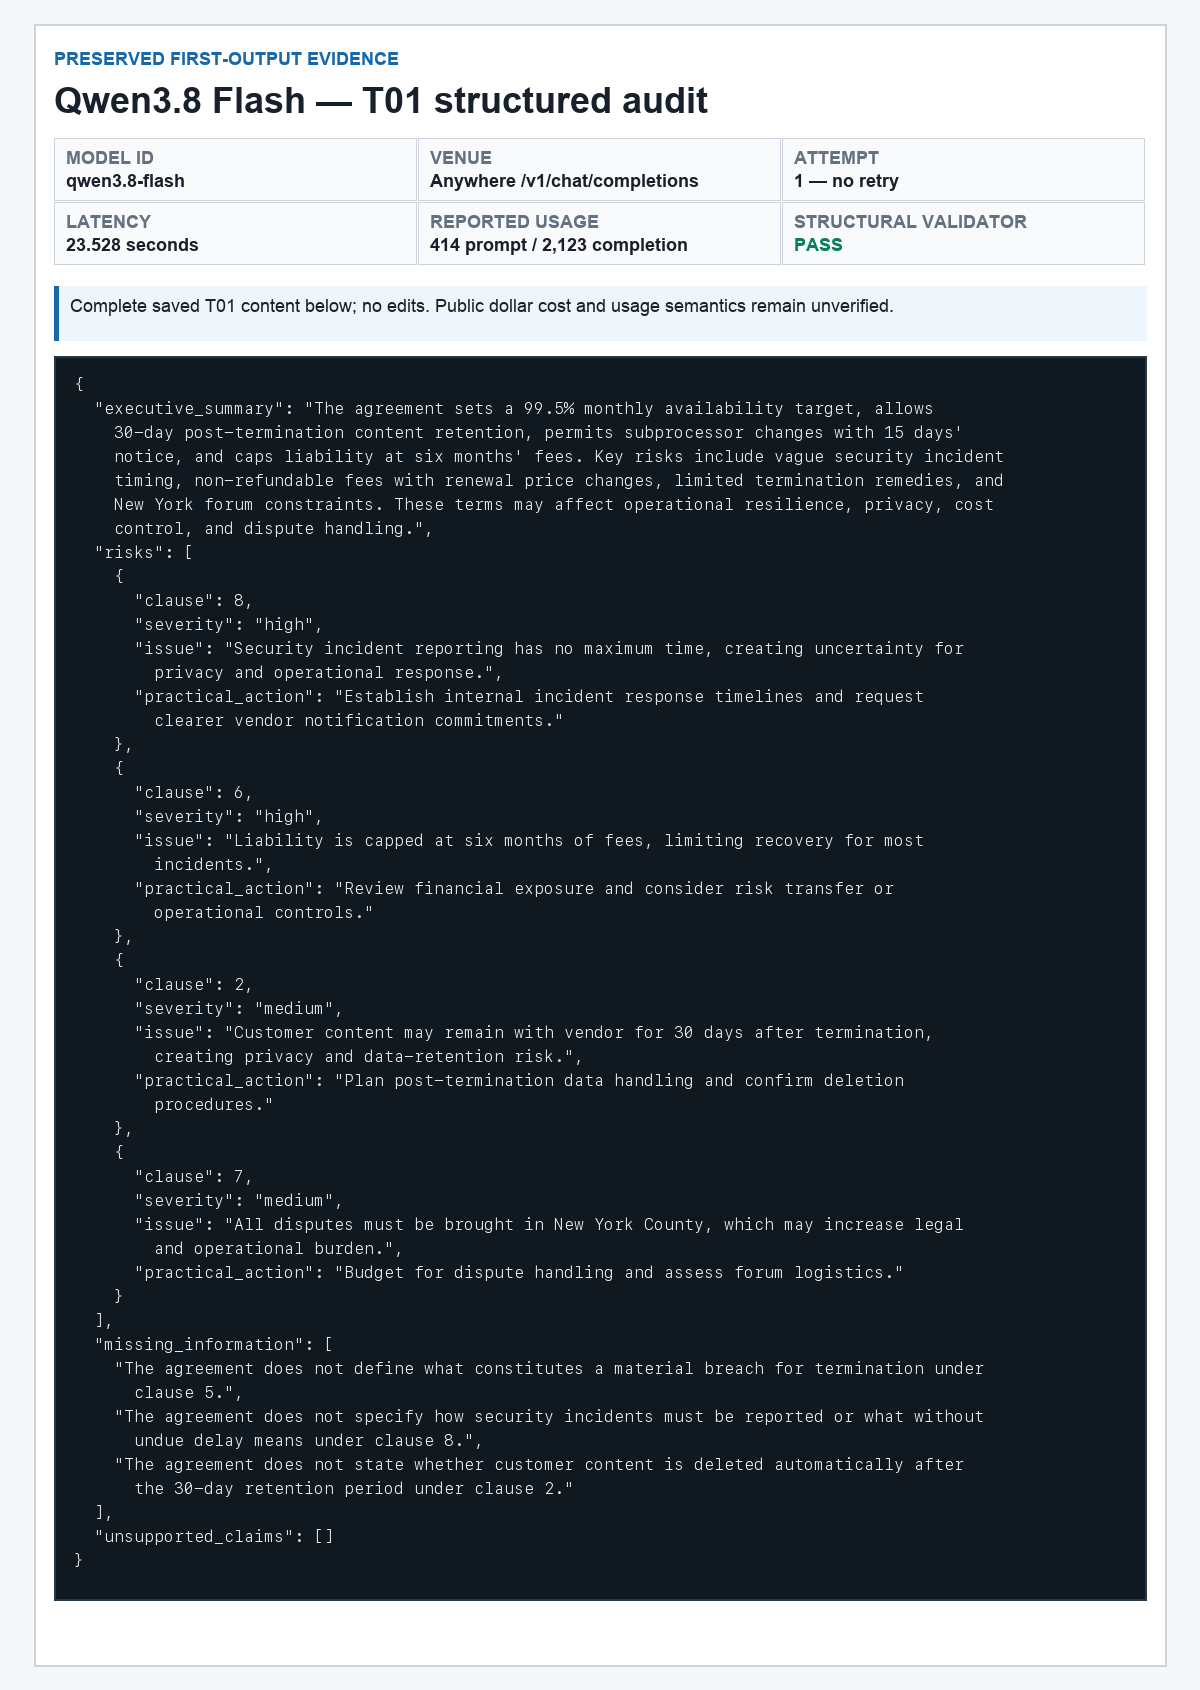
T01 · Strukturierte Vertrags- und Risikoprüfung
Es hat die Prüfung hinsichtlich des Risikos bei eingefrorenen Verträgen bestanden; dies ist keine allgemeine Qualitätsbewertung.
Automatischer Validator: PASS. Rückblick auf „Frozen-Task“: 10/10. Semantik der Nutzungsobergrenze und Dollar-Kosten: unbestätigt.
Genaue Eingabeaufforderung anzeigen
Sie prüfen einen fiktiven SaaS-Anbietervertrag. Verwenden Sie ausschließlich die unten aufgeführten nummerierten Klauseln. Fügen Sie keine zusätzlichen Fakten hinzu.

[1] Das Ziel für die Serviceverfügbarkeit beträgt 99,51 TP40T pro Kalendermonat. Geplante Wartungsarbeiten, die 48 Stunden im Voraus angekündigt werden, sind davon ausgenommen.
[2] Kundeninhalte dürfen nach Kündigung des Kontos für bis zu 30 Tage zur Wiederherstellung aus Backups aufbewahrt werden.
[3] Der Anbieter darf Unterauftragsverarbeiter einsetzen und wird wesentliche Änderungen bei den Unterauftragsverarbeitern mindestens 15 Tage vor deren Inkrafttreten bekannt geben.
[4] Gebühren sind nicht erstattungsfähig, sofern dies nicht gesetzlich vorgeschrieben ist. Der Anbieter kann die Preise für Vertragsverlängerungen mit einer Frist von 30 Tagen ändern.
[5] Jede Partei kann den Vertrag nach einer schriftlichen Kündigung mit einer Frist von 20 Tagen wegen eines nicht behobenen wesentlichen Vertragsverstoßes kündigen.
[6] Die Gesamthaftung des Anbieters ist auf die in den sechs Monaten vor dem Ereignis gezahlten Gebühren begrenzt, außer im Falle von Betrug oder vorsätzlichem Fehlverhalten.
[7] Die Vereinbarung unterliegt dem Recht des Staates New York. Streitigkeiten müssen vor den Staats- oder Bundesgerichten in New York County verhandelt werden.
[8] Sicherheitsvorfälle, die Kundeninhalte betreffen, müssen unverzüglich gemeldet werden; eine maximale Anzahl von Stunden ist jedoch nicht festgelegt.

Geben Sie ein gültiges JSON-Objekt mit genau diesen Schlüsseln zurück:
- executive_summary: Zeichenkette, maximal 70 Wörter
- risks: Array aus genau 4 Objekten, jeweils mit clause (Ganzzahl), severity ('high'|"medium"|"low"), issue (Zeichenkette), practical_action (Zeichenkette)
- missing_information: Array mit genau 3 Zeichenfolgen
- unsupported_claims: leeres Array

Priorisieren Sie konkrete geschäftliche, datenschutzrechtliche, betriebliche und rechtliche Risiken. Jedes Risiko muss eine der Klauselnummern angeben. Geben Sie keine Rechtsberatung und verwenden Sie kein Markdown.
Vollständigen, beibehaltenen JSON-Code anzeigen
{
  "executive_summary": "Die Vereinbarung legt ein monatliches Verfügbarkeitsziel von 99,51 TP40T fest, erlaubt die Aufbewahrung von Inhalten für 30 Tage nach Vertragsbeendigung, gestattet den Wechsel von Unterauftragsverarbeitern mit einer Frist von 15 Tagen und begrenzt die Haftung auf sechs Monatsgebühren. Zu den wesentlichen Risiken zählen unklare Fristen für die Meldung von Sicherheitsvorfällen, nicht erstattungsfähige Gebühren bei Preisänderungen bei Vertragsverlängerungen, begrenzte Rechtsbehelfe bei Kündigung sowie die Beschränkung auf New York als Gerichtsstand. Diese Bedingungen können sich auf die operative Ausfallsicherheit, den Datenschutz, die Kostenkontrolle und die Streitbeilegung auswirken.',
  'risks": [
    {
 "clause": 8,
 "severity": "high",
 "issue": "Für die Meldung von Sicherheitsvorfällen gibt es keine maximale Frist, was zu Unsicherheiten hinsichtlich des Datenschutzes und der betrieblichen Reaktion führt.",
      "practical_action": "Legen Sie interne Zeitpläne für die Reaktion auf Vorfälle fest und fordern Sie klarere Verpflichtungen des Anbieters zur Benachrichtigung ein."
    },
    {
 "Klausel": 6,
 "Schweregrad": "hoch",
 "Problem": "Die Haftung ist auf sechs Monatsgebühren begrenzt, was die Entschädigungsmöglichkeiten bei den meisten Vorfällen einschränkt.",
      "practical_action": "Überprüfen Sie das finanzielle Risiko und erwägen Sie eine Risikoverlagerung oder operative Kontrollmaßnahmen."
    },
    {
 "clause": 2,
 "severity": "medium",
 "issue": "Kundeninhalte können nach Vertragsbeendigung noch 30 Tage beim Anbieter verbleiben, was Risiken für den Datenschutz und die Datenaufbewahrung mit sich bringt.",
      "practical_action": "Planen Sie den Umgang mit Daten nach Vertragsbeendigung und legen Sie Löschverfahren fest."
    },
    {
 "clause": 7,
 "severity": "mittel",
 "issue": "Alle Streitigkeiten müssen vor einem Gericht in New York County verhandelt werden, was den rechtlichen und betrieblichen Aufwand erhöhen kann.",
      "practical_action": "Planen Sie Mittel für die Streitbeilegung ein und prüfen Sie die logistischen Rahmenbedingungen des Gerichtsstands."
    }
  ],
  "missing_information": [
    "Der Vertrag definiert nicht, was gemäß Klausel 5 einen wesentlichen Vertragsbruch für eine Kündigung darstellt.",
    "In der Vereinbarung ist nicht festgelegt, wie Sicherheitsvorfälle gemeldet werden müssen oder was unter Klausel 8 unter "ohne unnötige Verzögerung" zu verstehen ist.",
    "In der Vereinbarung ist nicht geregelt, ob Kundeninhalte nach Ablauf der 30-tägigen Aufbewahrungsfrist gemäß Klausel 2 automatisch gelöscht werden."
  ],
  "unsupported_claims": []
}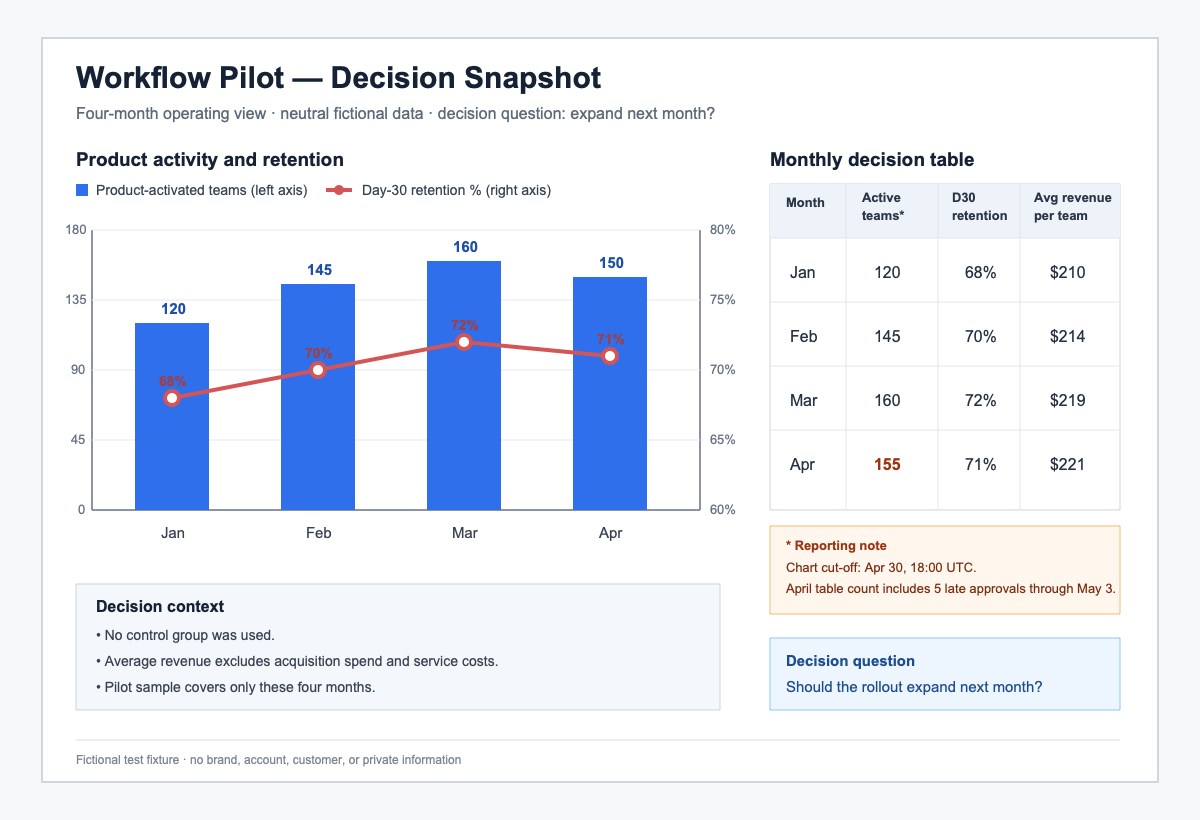
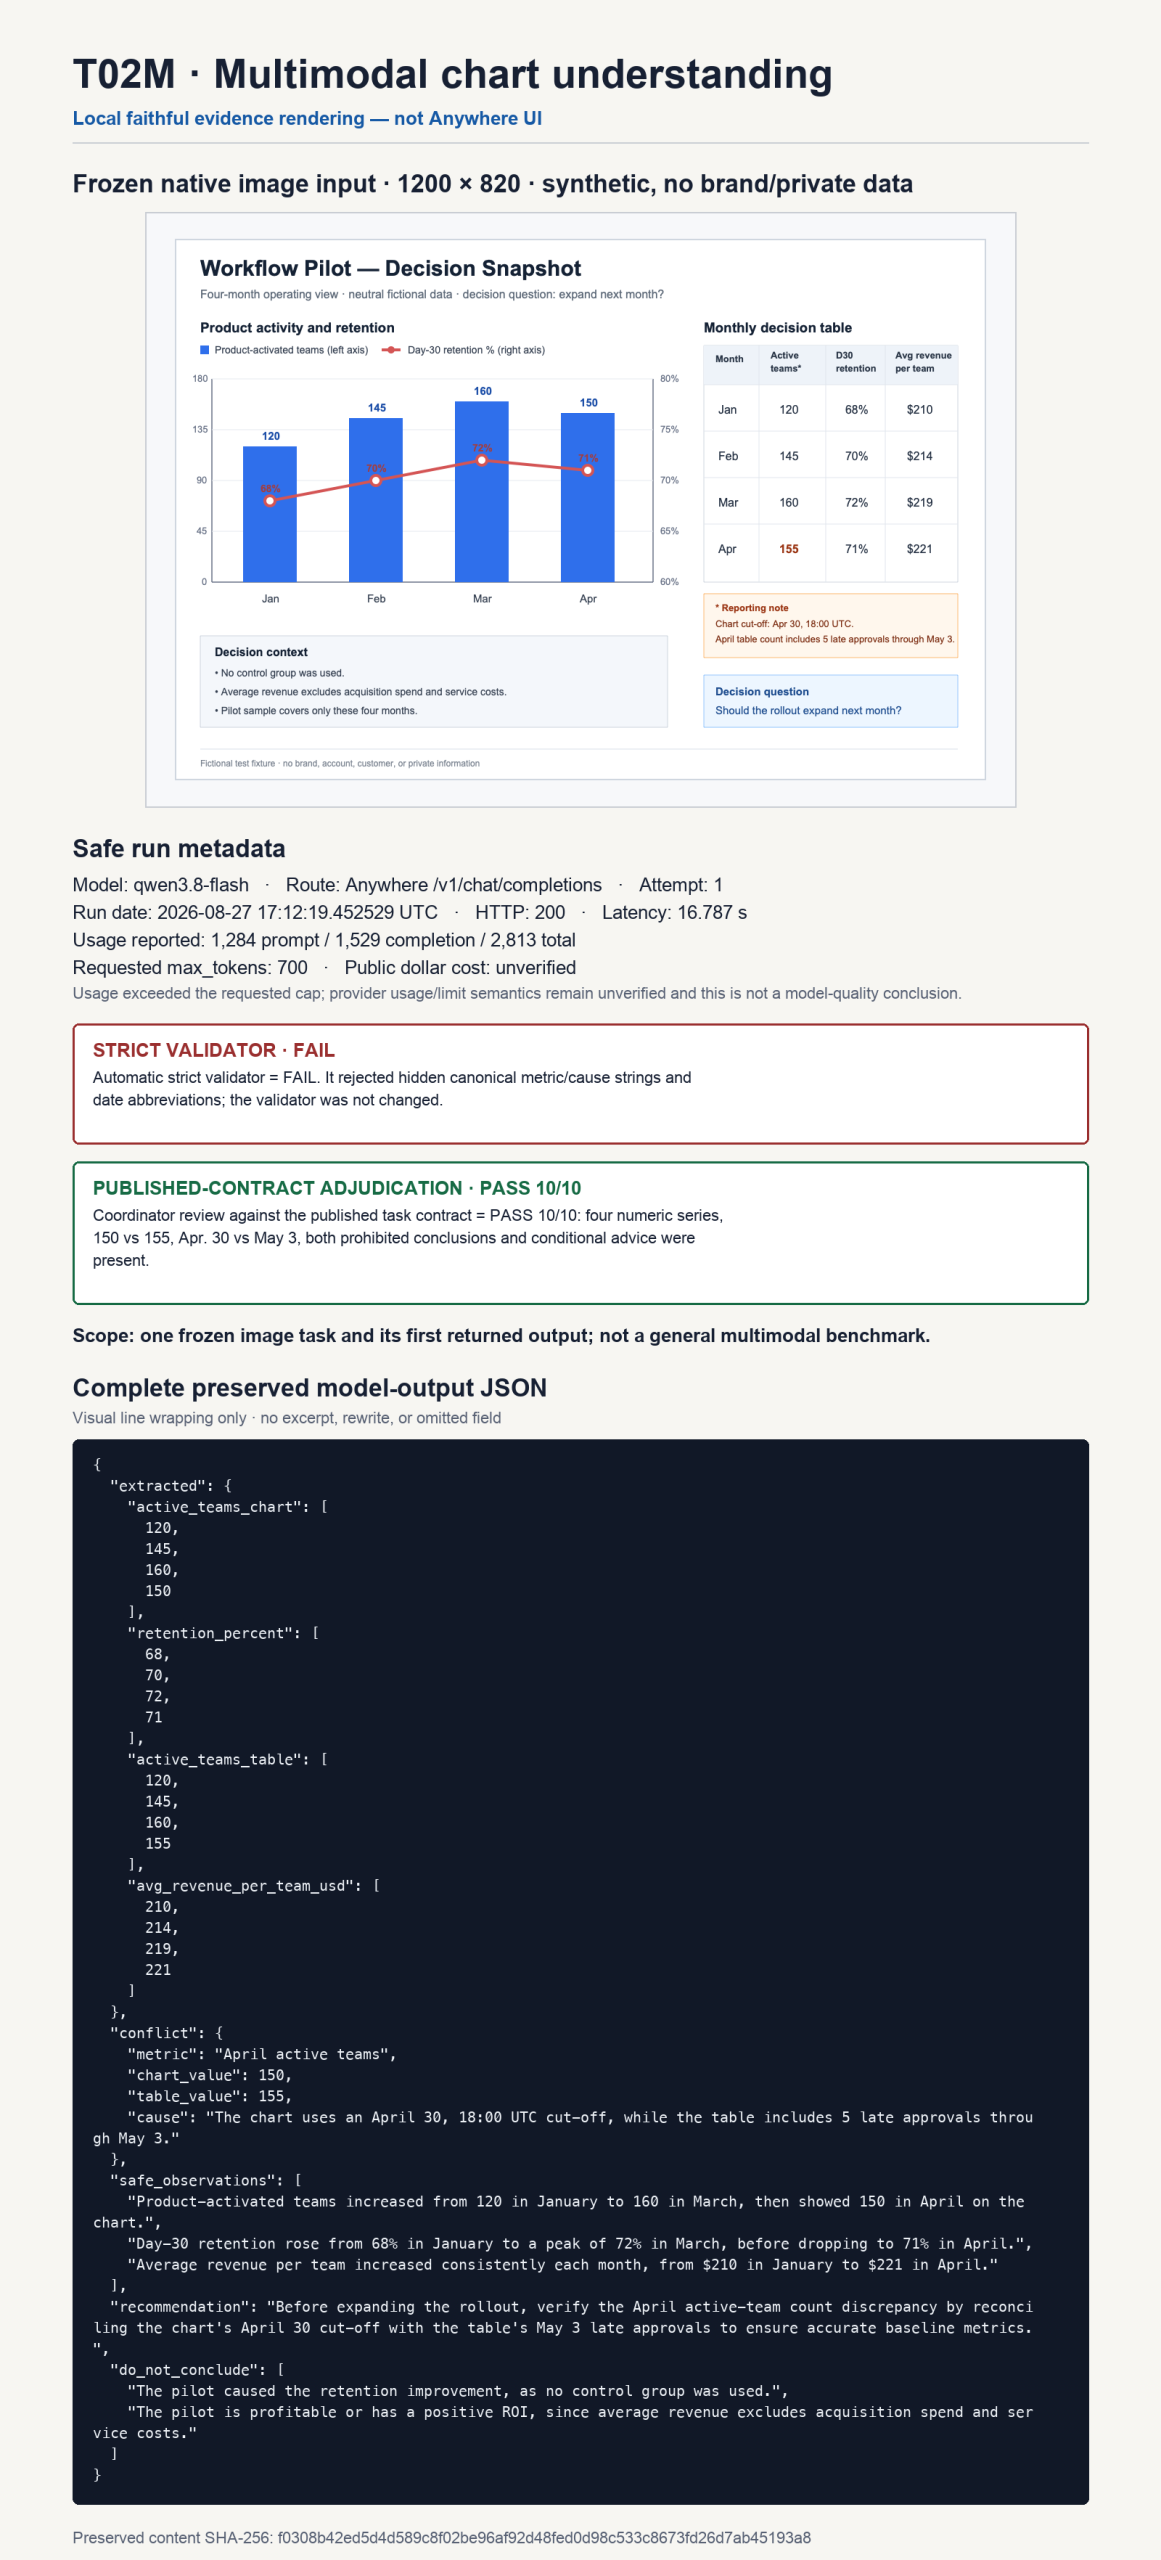
T02M · Diagrammauszug und begrenzte unternehmerische Ermessensausübung
Es wurden alle Serien sowie der Konflikt bezüglich der 150/155-Grenze ermittelt, und die Empfehlung wurde weiterhin an Bedingungen geknüpft.
Automatischer strenger Validator: FEHLER zu versteckten kanonischen Zeichenfolgen-/Datumseinstellungen. Überprüfung durch den Koordinator anhand des veröffentlichten Aufgabenvertrags: PASS 10/10. Das strikte Ergebnis wird nicht überschrieben.
Genaue Eingabeaufforderung anzeigen
Verwenden Sie ausschließlich das beigefügte Bild. Fügen Sie keine zusätzlichen Fakten hinzu. Das Bild enthält ein Balken-/Liniendiagramm für vier Monate, eine Entscheidungstabelle, einen Berichtshinweis und den Entscheidungskontext.

Geben Sie ein gültiges JSON-Objekt mit genau diesen Schlüsseln auf oberster Ebene zurück:
- extracted: Objekt mit genau den Schlüsseln „active_teams_chart“, „retention_percent“, „active_teams_table“ und „avg_revenue_per_team_usd“; jeder Wert ist ein Array mit genau vier Zahlen in der Reihenfolge Jan, Feb, März, Apr
- conflict: Objekt mit genau den Schlüsseln „metric“, „chart_value“, „table_value“ und „cause“
- safe_observations: Array mit genau 3 Zeichenketten
- recommendation: Zeichenkette, maximal 60 Wörter
- do_not_conclude: Array mit genau 2 Zeichenketten

Anforderungen:
1. Übertragen Sie jede Zahlenreihe genau wie angegeben.
2. Identifizieren Sie den Konflikt bei den aktiven Teams im April und erläutern Sie die beiden Berichtsstichtage.
3. Halten Sie die Beobachtungen beschreibend und stützen Sie sie auf das Bild.
4. Die Empfehlung muss angeben, was vor der Ausweitung der Einführung überprüft werden muss.
5. Die beiden „do_not_conclude“-Punkte müssen die Verbesserung der Kundenbindung und die Rentabilität/den ROI abdecken.
6. Geben Sie die Ausgabe ausschließlich im JSON-Format ohne Markdown aus. Die gesamte Antwort darf maximal 700 Ausgabe-Token umfassen.
Vollständigen, beibehaltenen JSON-Code anzeigen
{
  "extracted": {
    "active_teams_chart": [
 120,
 145,
 160,
 150
    ],
    "retention_percent": [
 68,
 70,
 72,
 71
    ],
    "active_teams_table": [
 120,
 145,
 160,
 155
    ],
    "avg_revenue_per_team_usd": [
 210,
 214,
 219,
 221
    ]
  },
  "conflict": {
    "metric": "Aktive Teams im April",
    "chart_value": 150,
    "table_value": 155,
    "cause": "Das Diagramm verwendet den Stichtag 30. April, 18:00 Uhr UTC, während die Tabelle 5 verspätete Genehmigungen bis zum 3. Mai enthält."
  },
  "safe_observations": [
    "Die Anzahl der produktaktivierten Teams stieg von 120 im Januar auf 160 im März und lag im Diagramm für April bei 150.",
    "Die 30-Tage-Kundenbindung stieg von 68% im Januar auf einen Höchstwert von 72% im März, bevor sie im April auf 71% zurückging.",
    "Der durchschnittliche Umsatz pro Team stieg jeden Monat kontinuierlich an, von $210 im Januar auf $221 im April."
  ],
  "Empfehlung": "Bevor die Einführung ausgeweitet wird, sollte die Diskrepanz bei der Anzahl der aktiven Teams im April überprüft werden, indem der Stichtag 30. April im Diagramm mit den nachträglichen Genehmigungen vom 3. Mai in der Tabelle abgeglichen wird, um genaue Basiskennzahlen zu gewährleisten.",
  "do_not_conclude": [
    "Das Pilotprojekt hat zu der Verbesserung der Kundenbindung geführt, da keine Kontrollgruppe verwendet wurde.",
    "Das Pilotprojekt ist rentabel oder weist einen positiven ROI auf, da der durchschnittliche Umsatz die Akquisitionskosten und Servicekosten nicht berücksichtigt."
  ]
}
Eingabepaket: 3 synthetische Dateien · 15 logische Seiten · 60 adressierbare Absatz-IDs
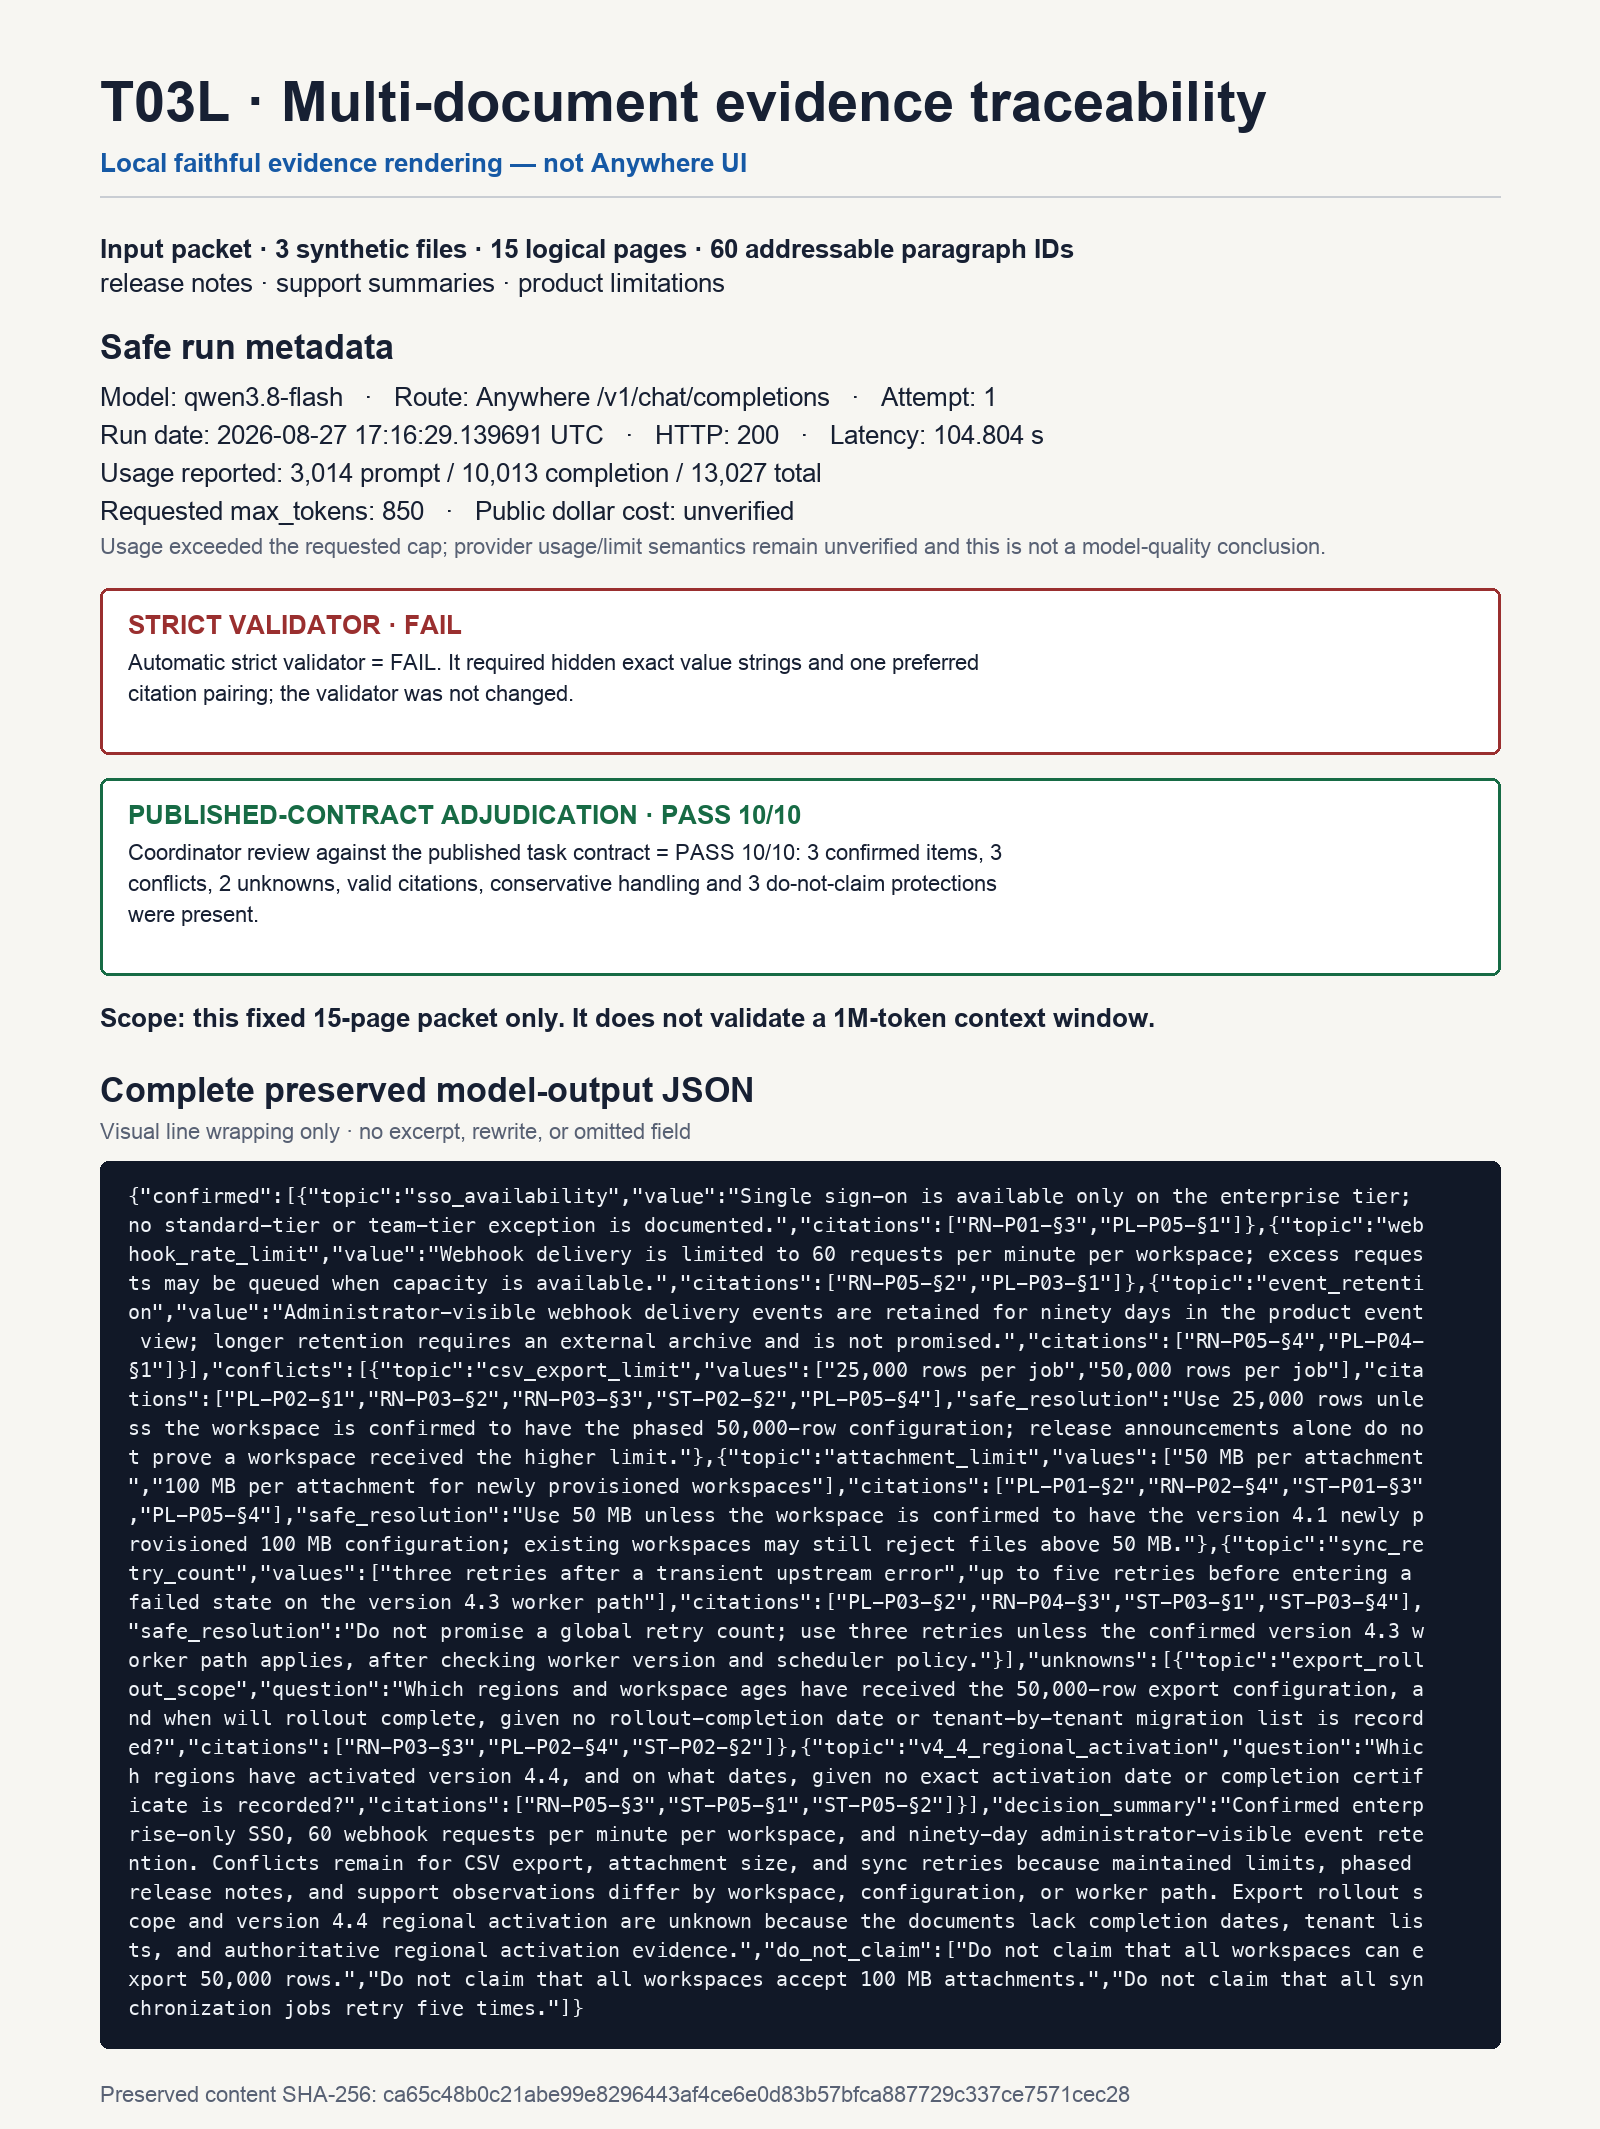
T03L · Rückverfolgbarkeit mehrerer Dokumente und Konfliktsynthese
Es hat bestätigte Fakten, Konflikte und Unbekanntes festgehalten; es prüft den 1M-Kontext nicht.
Automatischer strenger Validator: FEHLER zu den Einstellungen für versteckte exakte Zeichenfolgen und Zitate. Überprüfung durch den Koordinator anhand des veröffentlichten Auftragsvertrags: PASS 10/10. Beide Status bleiben sichtbar.
Genaue Eingabeaufforderung anzeigen
Verwenden Sie ausschließlich die drei synthetischen Dokumente, die dieser Eingabeaufforderung angehängt sind. Jede sachliche Aussage muss auf die angegebenen Absatz-IDs zurückverfolgt werden können. Lösen Sie einen Konflikt nicht durch die Wahl des neuesten, größten oder günstigsten Werts, es sei denn, die Dokumente rechtfertigen diese Wahl ausdrücklich.

Geben Sie ein gültiges JSON-Objekt mit genau diesen Schlüsseln auf oberster Ebene zurück:
- confirmed: Array aus genau 3 Objekten mit genau den Feldern „topic“, „value“ und „citations“
- conflicts: Array aus genau 3 Objekten mit genau den Feldern „topic“, „values“, „citations“ und „safe_resolution“
- unknowns: Array aus genau 2 Objekten mit genau den Feldern „topic“, „question“ und „citations“
- decision_summary: Zeichenkette, maximal 100 Wörter
- do_not_claim: Array mit genau 3 Zeichenketten

Verwenden Sie genau diese Themenbezeichnungen:
- confirmed: sso_availability, webhook_rate_limit, event_retention
- conflicts: csv_export_limit, attachment_limit, sync_retry_count
- unknowns: export_rollout_scope, v4_4_regional_activation

Zitierregeln:
1. Jedes Zitat muss eine echte Absatz-ID exakt wiedergeben.
2. Jeder bestätigte Eintrag benötigt mindestens zwei belegende Zitate aus verschiedenen Dokumenten.
3. Bei jedem Konflikt müssen sowohl die inkompatiblen Werte beibehalten als auch jede erforderliche Seite zitiert werden.
4. Unbekannte Elemente müssen unbekannt bleiben; geben Sie an, welche Belege fehlen.
5. „do_not_claim“ muss pauschale Aussagen zu Exporten mit 50.000 Zeilen, Anhängen von 100 MB und fünf Wiederholungsversuchen unterbinden.
6. Gebe ausschließlich JSON aus, ohne Markdown. Die gesamte Antwort darf maximal 850 Ausgabetoken umfassen.

Behauptet nicht, dass diese Aufgabe ein maximales Kontextfenster validiert. Sie misst die Rückverfolgbarkeit ausschließlich anhand dieses festen Pakets mittlerer Länge.
Vollständigen, beibehaltenen JSON-Code anzeigen
{"confirmed":[{"topic":"sso_availability","value":"Single Sign-On ist nur in der Enterprise-Stufe verfügbar; Ausnahmen für die Standard- oder Team-Stufe sind nicht dokumentiert.","citations":["RN-P01-§3","PL-P05-§1"]},{"topic":"webhook_rate_limit","value":"Die Zustellung von Webhooks ist auf 60 Anfragen pro Minute und Arbeitsbereich begrenzt; überschüssige Anfragen werden möglicherweise in eine Warteschlange gestellt, sofern Kapazität verfügbar ist.","citations":["RN-P05-§2","PL-P03-§1"]},{"topic":"event_retention","value":"Für Administratoren sichtbare Webhook-Zustellungsereignisse werden neunzig Tage lang in der Produkt-Ereignisansicht aufbewahrt; eine längere Aufbewahrung erfordert ein externes Archiv und wird nicht garantiert.","citations":["RN-P05-§4","PL-P04-§1"]}],"conflicts":[{"topic":"csv_export_limit","values":["25.000 Zeilen pro Auftrag","50.000 Zeilen pro Auftrag"],"citations":["PL-P02-§1","RN-P03-§2","RN-P03-§3","ST-P02-§2","PL-P05-§4"],"safe_resolution":"Verwenden Sie 25.000 Zeilen, es sei denn, es wurde bestätigt, dass der Arbeitsbereich über die stufenweise Konfiguration mit 50.000 Zeilen verfügt; Veröffentlichungsankündigungen allein beweisen nicht, dass ein Arbeitsbereich das höhere Limit erhalten hat."},{"topic":"attachment_limit","values":["50 MB pro Anhang","100 MB pro Anhang für neu bereitgestellte Arbeitsbereiche"],"citations":["PL-P01-§2","RN-P02-§4","ST-P01-§3","PL-P05-§4"],"safe_resolution":"Verwenden Sie 50 MB, es sei denn, es ist bestätigt, dass der Arbeitsbereich über die in Version 4.1 neu bereitgestellte Konfiguration mit 100 MB verfügt; bestehende Arbeitsbereiche können Dateien über 50 MB weiterhin ablehnen."},{"topic":"sync_retry_count","values":["drei Wiederholungsversuche nach einem vorübergehenden Upstream-Fehler","bis zu fünf Wiederholungsversuche, bevor auf dem Worker-Pfad der Version 4.3 der Status "fehlgeschlagen" erreicht wird"],"citations":["PL-P03-§2","RN-P04-§3","ST-P03-§1","ST-P03-§4"],"safe_resolution":"Keine globale Wiederholungsanzahl versprechen; nach Überprüfung der Worker-Version und der Scheduler-Richtlinie drei Wiederholungsversuche durchführen, sofern nicht der bestätigte Worker-Pfad der Version 4.3 gilt."}],"unknowns":[{"topic":"export_rollout_scope","question":"Welche Regionen und welche Workspace-Altersstufen haben die Exportkonfiguration für 50.000 Zeilen erhalten, und wann wird die Einführung abgeschlossen sein, da weder ein Datum für den Abschluss der Einführung noch eine Migrationsliste nach Mandanten erfasst wurde?","citations":["RN-P03-§3","PL-P02-§4","ST-P02-§2"]},{"topic":"v4_4_regional_activation","question":"Welche Regionen haben Version 4.4 aktiviert und zu welchen Zeitpunkten, da kein genaues Aktivierungsdatum und kein Abschlusszertifikat erfasst wurde?","Zitate":["RN-P05-§3","ST-P05-§1","ST-P05-§2"]}],"decision_summary":"Bestätigt: SSO nur für Unternehmen, 60 Webhook-Anfragen pro Minute pro Arbeitsbereich und eine für Administratoren sichtbare Ereignisaufbewahrungsdauer von neunzig Tagen. Es bestehen weiterhin Unstimmigkeiten hinsichtlich des CSV-Exports, der Anhangsgröße und der Synchronisierungswiederholungsversuche, da die beibehaltenen Grenzwerte, die schrittweisen Versionshinweise und die Beobachtungen des Supports je nach Arbeitsbereich, Konfiguration oder Mitarbeiterpfad variieren. Der Umfang der Export-Einführung und die regionale Aktivierung von Version 4.4 sind unbekannt, da in den Dokumenten Abschlussdaten, Mandantenlisten und verbindliche Nachweise für die regionale Aktivierung fehlen.","do_not_claim":["Behaupten Sie nicht, dass alle Arbeitsbereiche 50.000 Zeilen exportieren können.","Behaupten Sie nicht, dass alle Arbeitsbereiche Anhänge mit einer Größe von 100 MB akzeptieren.","Behaupten Sie nicht, dass alle Synchronisierungsaufträge fünfmal wiederholt werden."]}T01 hat den Validator bestanden. T02M und T03L haben ihre veröffentlichten Verträge bestanden, sind jedoch bei strengeren Prüfungen auf versteckte Darstellungspräferenzen durchgefallen. Die gemeldete Nutzungsauslastung hat alle angeforderten Obergrenzen überschritten, sodass die Routenabrechnung weiterhin ungeklärt ist.
Stärken, Grenzen und praktische Hinweise
Wo die Argumente am überzeugendsten sind
- Niedrige offizielle Basispreise für Token bei Text-Workflows mit hohem Volumen.
- Ein großes, listengestütztes Kontextfenster für die Arbeit mit Dokumenten und Codebasen.
- Eingabe von Text, Bildern und Videos im offiziellen Dienst.
- Strukturierte Ausgabe, Werkzeuge, Caching und Batch-Funktionen auf der dokumentierten Route Qwen.
- Eine Flash-Next-Option mit offenem Gewicht für Teams, die ihre eigene Infrastruktur betreiben können.
Wo weiterhin Vorsicht geboten ist
- Unabhängige Benchmark-Ergebnisse für Flash-Speicher in Serienqualität wurden nicht überprüft.
- Die Ergebnisse der „Flash-Next“-Anbieter müssen ihre genaue Bezeichnung und den Hinweis zur Methodik beibehalten.
- Bei Routen von Drittanbietern können andere Beschränkungen, Tools und Nutzungsabrechnungen gelten.
- Die genaue Zuordnung des GlobalGPT-Plans zum Qwen3.8-Flash-Plan steht noch aus.
- Drei kleine Aufgaben mit ersten Ergebnissen reichen nicht aus, um Zuverlässigkeit, maximale Kontextleistung oder Produktionssicherheit zu gewährleisten.
Ein praktischer Bewertungsablauf
Beginnen Sie mit einer einzigen wiederkehrenden Aufgabe, anstatt einen umfassenden „Schönheitswettbewerb“ zu veranstalten. Legen Sie die Eingabe, die Erfolgskriterien und das Ausgabeformat vor dem ersten Durchlauf fest. Verlangen Sie bei einem Dokumenten-Workflow Quellenangaben und eine Liste offener Fragen. Verwenden Sie bei Code ausführbare Tests. Bauen Sie bei der visuellen Analyse mindestens einen absichtlichen Konflikt oder eine Mehrdeutigkeit ein, damit das Modell mehr tun muss, als nur Beschriftungen zu übertragen.
Testen Sie anschließend sowohl die Route als auch das Modell. Notieren Sie sich die genaue ID, die Latenz, die Nutzung, die verfügbaren Tools und etwaige Dateibeschränkungen. Eine gehostete Plattform kann nützliche Such-, Speicher- oder Kollaborationsfunktionen bieten, aber sie kann auch die Token-Abrechnung und die maximalen Ausgabemengen verändern. Deshalb gehört die Anomalie bei der Nutzungsobergrenze in unseren „Anywhere“-Läufen zu den Routenbeschränkungen und nicht zu einer Aussage über die Intelligenz von Qwen.
Schließlich sollte die Wiederholung erst erfolgen, nachdem die ersten Ergebnisse gesichert sind. Eine Stabilitätsstudie sollte alle Durchläufe, Fehlerarten und Streuungen aufzeigen; sie sollte niemals ein schwaches erstes Ergebnis durch die vielversprechendste Stichprobe ersetzen. Im Rahmen dieser Überprüfung wurde kein Stabilitätslauf durchgeführt, sodass die Zuverlässigkeit in der Produktion weiterhin eine offene Frage bleibt.
Verwenden Sie Qwen3.8 Flash, wenn Preis, Kontext und multimodale Eingaben einen kontrollierten Test rechtfertigen. Verzichten Sie auf eine Migration in die Produktion, wenn Sie ein unabhängig erstelltes Leistungsranking, Abrechnungssicherheit auf Routenebene oder eine Funktion benötigen, die auf der von Ihnen gewählten Plattform noch nicht bestätigt wurde.
Welchen Anfahrtsweg sollten Sie wählen?
| Ihre Priorität | Die beste Route für den Einstieg | Warum |
|---|---|---|
| Native API-Steuerelemente und Token-Abrechnung | Qwen Cloud | Offizielle Unterlagen, Grundtarife und Leistungsmerkmale |
| Ein Abonnement für mehrere Chat-Models | GlobalGPT | Einfachere interaktive Modellumschaltung; plattformunabhängig |
| Selbsthosting und Gewichtsregulierung | Flash-Next | Artefakt mit offenem Gewicht, mit Verantwortung für die Infrastruktur |
| Die Forderungen dieser Rezension wiedergeben | Überall | Nur getestete Route; ungeklärte Semantik bezüglich „public dollar/cap“ |
Eine einfache Routenregel
- Benötigen Sie native API-Steuerelemente? Beginnen Sie mit Qwen Cloud.
- Benötigen Sie einen Arbeitsbereich für mehrere Modelle? Berücksichtigen Sie GlobalGPT und überprüfen Sie dabei den aktuellen Planzugang.
- Brauchst du Gewichte, mit denen du selbst trainieren kannst? Flash-Next bewerten und Mittel für die Infrastruktur einplanen.
- Benötigen Sie reproduzierbare Tests? Notieren Sie sich die genaue Vorgehensweise, da die Einschränkungen der Plattformen und die Tools voneinander abweichen können.
Wenn Sie sich zwischen einem schnelleren, preisgünstigen Modell und einem Flaggschiff-Modell entscheiden müssen, lesen Sie den Qwen3.8 – Max-Testbericht. Wenn Sie eine umfassendere Auswahlliste verschiedener Anbieter wünschen, nutzen Sie unseren Leitfaden zu den Die besten KI-Modelle für Aufgaben aus der Praxis.
Häufig gestellte Fragen
Ist Qwen3.8 Flash dasselbe wie Qwen3.8 Flash-Next?
Unter der Nummer Qwen wird Qwen3.8 Flash als die verwaltete Produktionsversion beschrieben, die auf dem Open-Weight-Artefakt Qwen3.8-Flash-Next basiert. Achten Sie darauf, die Bezeichnungen getrennt zu verwenden, wenn Sie über Gewichte, Tools oder Benchmarks sprechen.
Wie viel kostet die Qwen3.8 Flash-API?
Qwen Cloud hat am 27. August 2026 Grundtarife in Höhe von $0,15 pro Million Eingabe-Token und $0,47 pro Million Ausgabe-Token festgelegt. Für Cache, Tools und Gebühren von Drittanbieterplattformen können andere Preise gelten.
Unterstützt der Qwen3.8 Flash Bilder und Videos?
Ja. Auf der offiziellen Qwen-Cloud-Seite sind Text-, Bild- und Videoeingaben sowie Textausgaben aufgeführt. Die Einschränkungen hinsichtlich der Dateiverarbeitung und der Benutzeroberfläche können je nach Route variieren.
Was ist das Qwen3.8-Flash-Kontextfenster?
Qwen Cloud gibt ein Kontextfenster von 1 Mio. Token an, mit routenspezifischen Höchstgrenzen für Ein- und Ausgabe. Der 15-seitige Test in diesem Bericht überprüft die Leistung bei maximalem Kontext nicht.
Wo kann ich Qwen3.8 Flash ausprobieren?
Qwen Cloud ist der offizielle API-Weg. GlobalGPT bietet einen unabhängigen, modellübergreifenden Arbeitsbereich; offen GlobalGPT und überprüfen Sie, ob Ihr Tarif den Zugriff auf das aktuelle Modell ermöglicht. „Anywhere“ diente bei dieser Überprüfung lediglich als getesteter API-Pfad.
Fazit
Qwen3.8 Flash verfügt über eine überzeugende, dokumentierte Kombination: niedrige Basis-Token-Raten, eine Kontextliste mit 1 Million Einträgen, multimodale Eingabe und einen breiten Funktionsumfang für die Produktion. Das verantwortungsvolle Fazit lautet jedoch nicht, dass es in jeder Hinsicht das beste Modell ist. Unabhängige Belege für das genau verwaltete Modell sind nach wie vor spärlich, das Routing-Verhalten von Drittanbietern variiert, und die praktischen Erkenntnisse hier decken nur drei begrenzte erste Ausgaben ab.
Für Entwickler ist Qwen Cloud der übersichtlichste Ausgangspunkt. Für diejenigen, die mehrere Chat-Modelle vergleichen möchten, ohne separate APIs verwalten zu müssen, ist GlobalGPT der praktische, unabhängige Weg – nachdem der Zugriff auf den Live-Tarif bestätigt wurde. In jedem Fall sollten Sie eine Eingabeaufforderung mit einer Akzeptanzregel testen, die Sie überprüfen können.
Teste die Entscheidung, nicht den Modellnamen
Verwenden Sie eine Eingabe aus Ihrem tatsächlichen Arbeitsablauf, lassen Sie die Eingabe und die Akzeptanzkriterien unverändert und vergleichen Sie das Ergebnis mit dem Modell, das Sie bereits verwenden.
Probieren Sie Ihre Eingabe in GlobalGPT aus