إجابة سريعة: ادفع مقابل الذكاء الاصطناعي الذي يحسّن بشكل موثوق الأعمال التي تكررها كل أسبوع. البحث على غرار Perplexity يستحق الدفع مقابله عندما تكون المصادر ذات أهمية. يستحق النموذج العام الفعال أن تدفع مقابله عندما تقضي يومك بأكمله في مراجعة الاستراتيجيات والتحليلات والكتابة. ويستحق نموذج البرمجة أن تدفع مقابله عندما يتناسب مع دورة «التحرير - الاختبار - المراجعة». أما نماذج الصور والفيديو، فتستحق أن تدفع مقابلها عندما تحل مخرجاتها محل وقت الإنتاج.
يجمع هذا الدليل بين المراجع الرسمية للمنتجات، وملاحظة صادرة عن مطور مستقل معروف، ومقارنات عملية صغيرة أُجريت في 1 سبتمبر 2026. وقد صُممت الاختبارات لتكون محدودة النطاق عن قصد: حيث تم استخدام موجه واحد مشترك ونتيجة واحدة لكل نموذج، بحيث تكشف عن اختلافات مفيدة في سير العمل، لكنها لا لا إثبات وجود ترتيب عالمي. إفصاح: تتولى شركة GlobalGPT إدارة هذه المنشورة.
اشترِ المراجع والمصادر الحديثة.
اشترِ تعديلات يمكنك الاعتراض عليها.
احصل على تعليقات في حلقتك الفعلية.
شراء المنتجات التي تحل محل الإنتاج.

ما الذي تدفع مقابله فعليًّا عند شراء تقنية الذكاء الاصطناعي
الوصول المجاني كافٍ للأعمال التي تتم من حين لآخر. أما الخطة المدفوعة فتدرّ أرباحًا عندما تُغيّر تكلفة التشغيل من حيث العمل: عدد أقل من علامات التبويب في المتصفح، وعدد أقل من المسودات الأولية المكتوبة يدويًّا، ودورة تعليقات أسرع، ووصول أفضل إلى المعلومات الحالية، أو ناتج يبدأ أقرب إلى مستوى الجودة النهائي. والخطأ المكلف هو دفع ثمن الوصول إلى الخدمة، ثم استخدامها كأنها مجرد مربع بحث جديد.
كيف تحدد أي تقنية ذكاء اصطناعي تستحق أن تدفع مقابلها
السؤال الخاطئ هو: “أي نموذج هو الأذكى؟” أما السؤال المفيد فهو: “أي اشتراك يزيل العائق المتكرر الذي أواجهه بأقل عبء ممكن على عملية المراجعة؟” فالمؤسس الذي يحتاج إلى أبحاث تنافسية مدعومة بمصادر له حجة شراء مختلفة عن المهندس الذي يعمل على تصحيح أخطاء مستودع البرمجة أو المسوق الذي ينتج مواد تسويقية أسبوعية للمنتج. ابدأ بإدراج المهام الثلاث المتكررة لديك، ثم اختبر كل خيار مقابل نفس الملخص العملي.
إنه يحل مهمة واحدة على الأقل كل أسبوع.
يمكنك التمييز بين النتيجة الأفضل والنتيجة الأسوأ.
الوقت الذي يتم توفيره يفوق الوقت المستغرق في التبديل والتحقق.
دراسة: هل يستحق برنامج Perplexity أن ندفع مقابله؟
بالنسبة للأسئلة المتعلقة بالسوق في الوقت الفعلي، فليكن التركيز على قدرات البحث قبل الأسلوب الأدبي الأنيق. Perplexity هي خدمة تضع البحث في المقام الأول: تكمن قيمتها في تقديم إجابة يمكن تتبع مصدرها مع مراجع يمكنك التحقق منها، بدلاً من ملخص واثق من نفسه دون إشارة إلى المصادر. وهذا يجعلها خيارًا مدفوعًا موثوقًا به للمحللين والمشترين والكتاب والفرق التي تُعد تقارير تعتمد على المصادر. قارن دورها بدور Gemini في هذا مقارنة الميزات بين Gemini وPerplexity, ، واستخدم هذه القائمة من بدائل الحيرة عندما تحتاج إلى مسار عمل بحثي مختلف.
لا تشترِ خطة بحثية لمجرد كتابة رسائل بريد إلكتروني أو تلخيص ملاحظات موجودة بالفعل على حاسوبك المحمول. ففائدتها تزداد مع ارتفاع تكلفة أي ادعاء قديم أو غير مدعوم بالأدلة. في الممارسة العملية، استخدم البحث لجمع المصادر والتحقق منها، ثم قم بتسليم الأدلة إلى نموذج استدلالي لإعداد مذكرة قرار. فهذا التقسيم يجعل اكتشاف الأخطاء أسهل.
GPT وClaude وGemini: ما أظهره اختبار الاستراتيجية فعليًّا
قدمنا لكل من GPT-5.6 Sol وClaude Sonnet 5 وGemini 3.6 Flash نفس المهمة المقيدة: إطلاق ميزة تحليلية في مجال الأعمال بين الشركات (B2B) في غضون ستة أسابيع، مع مهندسين اثنين وميزانية محددة وطلب من قسم المبيعات لتطبيق تسجيل الدخول الموحد (SSO) ومشاكل في عملية الإعداد الأولي. كان على كل إجابة أن تبرز الافتراضات، وتضع خطة مدتها ستة أسابيع، وتحدد المخاطر الخفية، وتكتب تقريرًا تنفيذيًّا. كانت هذه عينة عمل تُقدَّم مرة واحدة، وليست معيارًا قياسيًّا.
“حدد أصغر سير عمل تحليلي قابل للتطبيق” وقرر ما إذا كان تسجيل الدخول الموحد (SSO) ضمن نطاق العمل، أم مقتصرًا على المرحلة التجريبية، أم سيتم تأجيله، قبل إشراك الفريق في المشروع.
“لا يمكنك إنشاء ميزة تحليلية جديدة، وحل مشكلة في عملية التسجيل لم يتم تشخيصها بعد، ونشر نظام تسجيل الدخول الموحد (SSO) على مستوى المؤسسة، كل ذلك في نفس الفترة الزمنية وبجودة عالية.”
قسّم المطورين إلى مجموعتين: مجموعة معنية بتثبيت عملية الإعداد الأولي، وأخرى معنية بإنشاء الأساس لبيانات التحليلات، ثم قم بدمجهما في الأسابيع اللاحقة.
أعدت قائمة بالافتراضات الأكثر شمولاً، بما في ذلك الامتثال ومعايير الإطلاق ومقاييس النجاح. ولم تبتكر مؤشرات الأداء.
تم اتخاذ القرار الأكثر وضوحًا فيما يتعلق بتوازن القدرات: عدم فرض دمج ميزات تسجيل الدخول الموحد (SSO) المخصصة، والتحليلات، وعملية التسجيل التي لم تُحل بعد، في عملية إطلاق واحدة يتولى تنفيذها مهندسان فقط.
قدمت أوضح تقسيم للمطورين أسبوعًا بأسبوع، لكنها افترضت وجود لوحات معلومات جاهزة وعزلًا للبيانات، وهو ما لم يرد في موجز المهمة.
التأثير على الشراء: تُعد GPT خيارًا أولًا قويًّا عندما تولي أهمية كبيرة للتحقق الشامل من الافتراضات؛ وClaude عندما تكون القيمة تكمن في الحكم التحريري الدقيق؛ وGemini عندما تكون خطط التنفيذ المنظمة ذات أهمية. أعد مراجعة الملخصات الخاصة بك قبل اتخاذ القرار النهائي. للاطلاع على كيفية الوصول إلى GPT وسياق الخطة، انظر دليل أسعار GPT-5.6 و مقارنة بين طرازي GPT-5.6.
تظل الصفحات الرسمية للمنتجات هي أفضل مكان للتأكد من تفاصيل الباقات والميزات الحالية: دردشةGPT, كلود, و الجوزاء. تشرح صفحات المنتجات ما يقدمه كل بائع حاليًا؛ أما الاختبار المذكور أعلاه فيسجل فقط النتائج التي توصلت إليها هذه المحاولات الثلاث عند استخدام هذه المطالبة المقيدة بالتحديد.
كيف تتناسب العائلات النموذجية الرئيسية مع أنواع العمل المختلفة
أفضل خطة أولية للأشخاص الذين يتنقلون بين مهام التحليل، وصياغة المسودات، وتفسير البيانات، والتخطيط، وحل المشكلات. قم بتقييم ما إذا كانت الخطة تسلط الضوء على الافتراضات وتحقق تحسناً بعد تلقي نقد مباشر.
ترقبوا: إجابات مصقولة تحتاج إلى التحقق من المصادر أو مراجعة التخصص.
غالبًا ما يكون هذا النهج مناسبًا بشكل كبير عندما يكون الناتج المطلوب حجة أو موجزًا أو إعادة صياغة أو سياسة أو قرارًا تحريريًّا، حيث تكون الفروق الدقيقة والموازنة الواضحة بين الخيارات أكثر أهمية من قائمة المهام الموسعة.
ترقبوا: اعتبار النثر البليغ بحثًا واقعيًّا دون التحقق من المصادر.
يُعد هذا الخيار مناسبًا لمن يرغبون في استخدام الخطط والجداول وتقسيم المهام، خاصةً عندما يكون العمل مرتبطًا بالفعل بخدمات Google. اختبر كيفية تعامله مع المعلومات الناقصة بدلاً من الافتراض بتفاصيل التنفيذ.
ترقبوا: خطة واضحة مبنية على افتراضات لم يتم التحقق منها.
يستحق المقارنة في مجالات العمل التقني، والبرمجة، والاستخدام ثنائي اللغة، والتجارب التي تراعي القيمة. ويعتمد الخيار الصحيح على لغتك، وواجهة المستخدم، وما إذا كانت الاستجابة ستصمد أمام مجموعة الاختبارات الخاصة بك.
ترقبوا: التوفير في تكلفة الاشتراك، لكن مع خسارة الوقت بسبب المراجعة الإضافية أو عدم ملاءمة الأداة.
استخدم هذه الأدوات عندما تبدأ المهمة بإجابة حديثة ومستندة إلى مصادر موثقة. ولا تكمن ميزتها في أنها تحل محل التفكير، بل في أنها تسرع عملية جمع الأدلة والتحقق من المصادر.
ترقبوا: قبول الاقتباس دون فتح المصدر الأصلي.
يصبح اللجوء إلى المتخصصين أمراً مجدياً عندما تتوفر لديك متطلبات عمل قابلة للتكرار، وقيود خاصة بالعلامة التجارية، وعملية مراجعة. وعادةً ما يكون أول ما يقدمونه هو توجيه عام، وليس عملاً إبداعياً جاهزاً للموافقة عليه.
ترقبوا: دفع تكاليف نموذج عندما لا تبرر المشاريع التي تُنفَّذ لمرة واحدة تكلفة عمليات التطوير المتكررة.
بالنسبة للأعمال الفنية، تنطبق قاعدة مماثلة. قم بتنفيذ مهمة صغيرة تمثيلية قبل الشروع في مهمة كبيرة تعمل بشكل مستقل: اطلب إجراء تشخيص، وإجراء تغيير بسيط، ووضع خطة اختبار، وتحديد المخاطر التي لم يتم حلها بعد. إن الأداء القوي للنموذج لا يقتصر على إنشاء الكود فحسب؛ بل يكشف عن النقاط التي لا تزال تحتاج إلى سياسة المنتج أو سياق المستودع. ولهذا السبب فإن مراجعة جهاز DeepSeek V4 Pro و مراجعة خطة الترميز الخاصة بنموذج GLM تُعد هذه المقالات قراءات مفيدة يمكن الرجوع إليها لاحقًا، بدلاً من الاكتفاء بادعاء عام واحد من نوع “أفضل الذكاء الاصطناعي في البرمجة”.
البرمجة: الدفع مقابل النموذج الذي يحسّن دورة المراجعة
في مجال البرمجة، تكتسي الواجهة أهمية تقارب أهمية النموذج. طلبنا من GPT-5.6 Sol وDeepSeek V4 Pro تشخيص مشكلة في جافا سكريبت وإصلاحها بشكل بسيط المجموع (البنود) وظيفة، تتضمن أخطاء واضحة في حالة وجود أسعار أو كميات مفقودة أو غير صالحة أو غير موجبة، وثلاثة اختبارات، وملاحظة تتعلق بالمخاطر. قدم GPT-5.6 Sol تنفيذًا موجزًا باستخدام Number.isFinite, ، ورسائل الخطأ المفهرسة، وتأكيدات Node، وملاحظة مفيدة حول القيم الكسرية. وقد أشار برنامج DeepSeek V4 Pro بشكل صحيح إلى NaN trap، قامت بتصحيح دفاعها الذي كان أضعف في البداية إلى Number.isFinite, ، كما أشار أيضًا إلى عدم وجود عملية التحقق من صحة المصفوفة.
GPT-5.6 Sol: إصلاح للتحقق من الصحة مع اختبارات قابلة للتشغيل
موجهات المهمة المشتركة
التنفيذ المُعاد
تم ملاحظة ما يلي في الإصدار GlobalGPT: احتفظت النتيجة صراحةً بالكميات الكسرية كقرار سياسي متبقٍ. يرجى اختبار ذلك في مستودعك الخاص قبل النشر.
وهذا لا يعني أن أيًا منهما هو الحل الأمثل في مجال البرمجة. بل يشير إلى أن مساعد البرمجة الجيد الذي يتقاضى أجرًا مناسبًا يجب أن يشرح حدود التحقق من الصحة، ويقدم اختبارات قابلة للتشغيل، ويحدد القرارات المتعلقة بالسياسات المتبقية بدلاً من إخفائها. اقرأ مراجعة جهاز DeepSeek V4 Pro و مراجعة خطة الترميز الخاصة بنموذج GLM للحصول على سياق خاص بالمسار. كود كيمي’s صفحة الترميز الرسمية وهو مسار عمل آخر يستحق التقييم عندما يكون استخدام واجهة الأوامر (CLI) هو المحور الرئيسي.
كيف ينبغي للمطورين تقييم برامج الذكاء الاصطناعي المدفوعة الخاصة بالبرمجة
لا تقم بتقييم قدرات الذكاء الاصطناعي في البرمجة باستخدام مهمة جديدة تمامًا من نوع “بناء تطبيق مهام”. استخدم مهمة محددة من مستودع تفهمه جيدًا: اختبار فاشل، أو خطأ برمجي محدود النطاق، أو قاعدة تحقق غير مكتملة، أو تحديث في الوثائق مرتبط برمز حقيقي. اطلب من المساعد إعادة صياغة السلوك الذي يعتقد أنه مطلوب قبل أن يغير أي شيء. فهذا يكشف ما إذا كان قد قرأ المهمة بعناية أم أنه يطبق نموذجًا مألوفًا.
بعد ذلك، تحقق من أربعة أمور. أولاً، هل يميز بين الأعراض والسبب الجذري؟ ثانياً، هل يقترح أصغر تصحيح متماسك، بدلاً من إعادة هيكلة الوحدات النمطية غير ذات الصلة؟ ثالثًا، هل ينتج اختبارات تفشل في الكشف عن الخلل الأصلي وتنجح في اختبار الإصلاح؟ رابعًا، هل يوضح القرارات المتعلقة بالمنتج التي لم تُتخذ بعد، مثل التقريب، أو التفويض، أو التوافق مع الإصدارات السابقة، أو سياسة رسائل الخطأ؟ هذه الأسئلة أكثر فائدة من التقييم العام الذي يقتصر على “هل يمكنه البرمجة؟” لأنها ترتبط مباشرةً بوقت المراجعة.
يؤثر أسلوب التوصيل على الجوانب الاقتصادية. فنوافذ الدردشة مناسبة للتشخيص وشرح الكود والمقتطفات الصغيرة. أما المحرر أو واجهة سطر الأوامر (CLI) أو سير العمل المرتبط بـ MCP، فتزداد قيمتها عندما يتعين نقل السياق بأمان بين الملفات والأوامر والاختبارات. لكن الوصول الأعمق يرفع أيضًا معايير المراجعة: لا تقم أبدًا بإيقاف الاختبارات العادية أو الأذونات أو مراجعة الكود لمجرد أن المساعد استخدم المصطلحات الصحيحة. بالنسبة للعديد من الفرق، فإن أفضل الإعدادات المدفوعة هي نموذج يقوم بالصياغة والشرح جيدًا، بالإضافة إلى الضوابط الهندسية الحالية التي تقرر ما إذا كان التغيير سيُطرح أم لا.
GPT Image 2 مقابل Nano Banana 2: اختبار واحد للمنتج والصورة
استخدمنا نفس التوجيهات لكلتا النموذجين: “صورة رئيسية بسيطة للتجارة الإلكترونية لزجاجة من الفولاذ المقاوم للصدأ قابلة لإعادة الاستخدام بلون كحلي غير لامع، وخلفية بلون حجر فاتح، وإضاءة نهارية، وتكثف خفيف، بدون نصوص أو شعارات”. حافظت صورة GPT 2 على اللون الأزرق الداكن للزجاجة، وشرط عدم وجود شعار، والتكثيف، لكنها انحرفت نحو خلفية تعكس نمط حياة في الهواء الطلق أو على شاطئ البحر بدلاً من مشهد كتالوج بسيط. كما حافظت صورة Nano Banana 2 على اللون الأزرق الداكن للزجاجة وخلوها من الشعار، مع تأطير أكثر ملاءمة للتصوير الداخلي للمنتج، لكن لم تقدم أي من النتيجتين بشكل دقيق سطح الحجر الفاتح المطلوب.
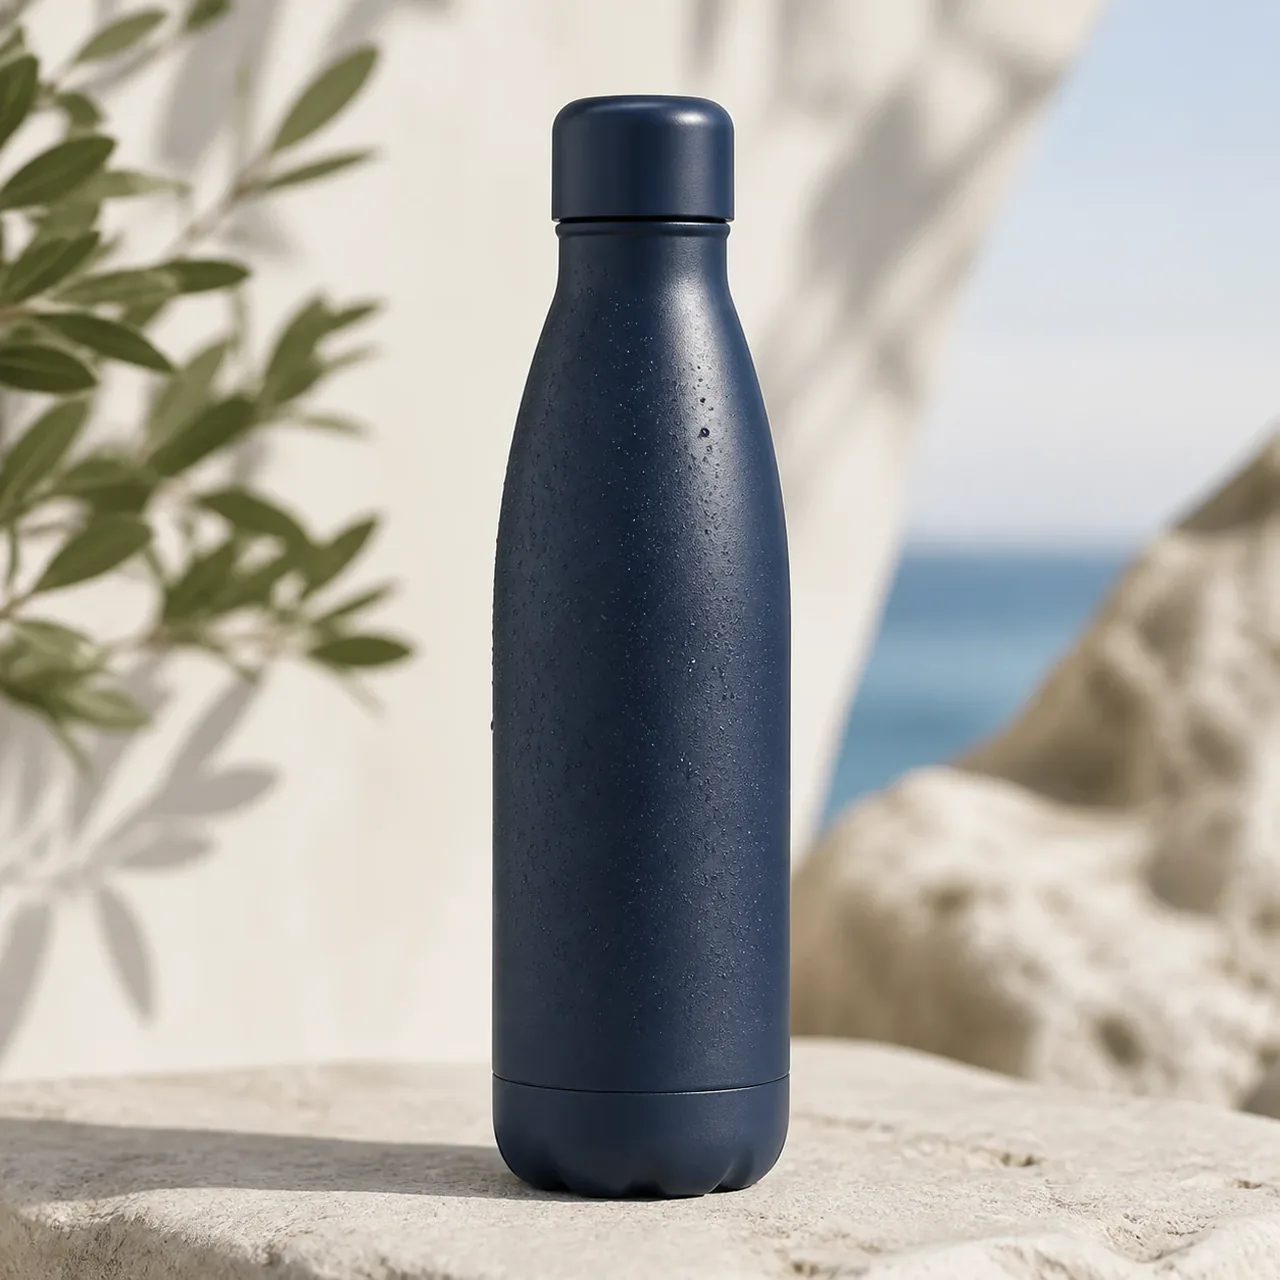
أفضل من حيث تفاصيل التكثيف؛ واتسم المشهد بطابع نمط الحياة أكثر من كونه مشهداً من الكتالوج.
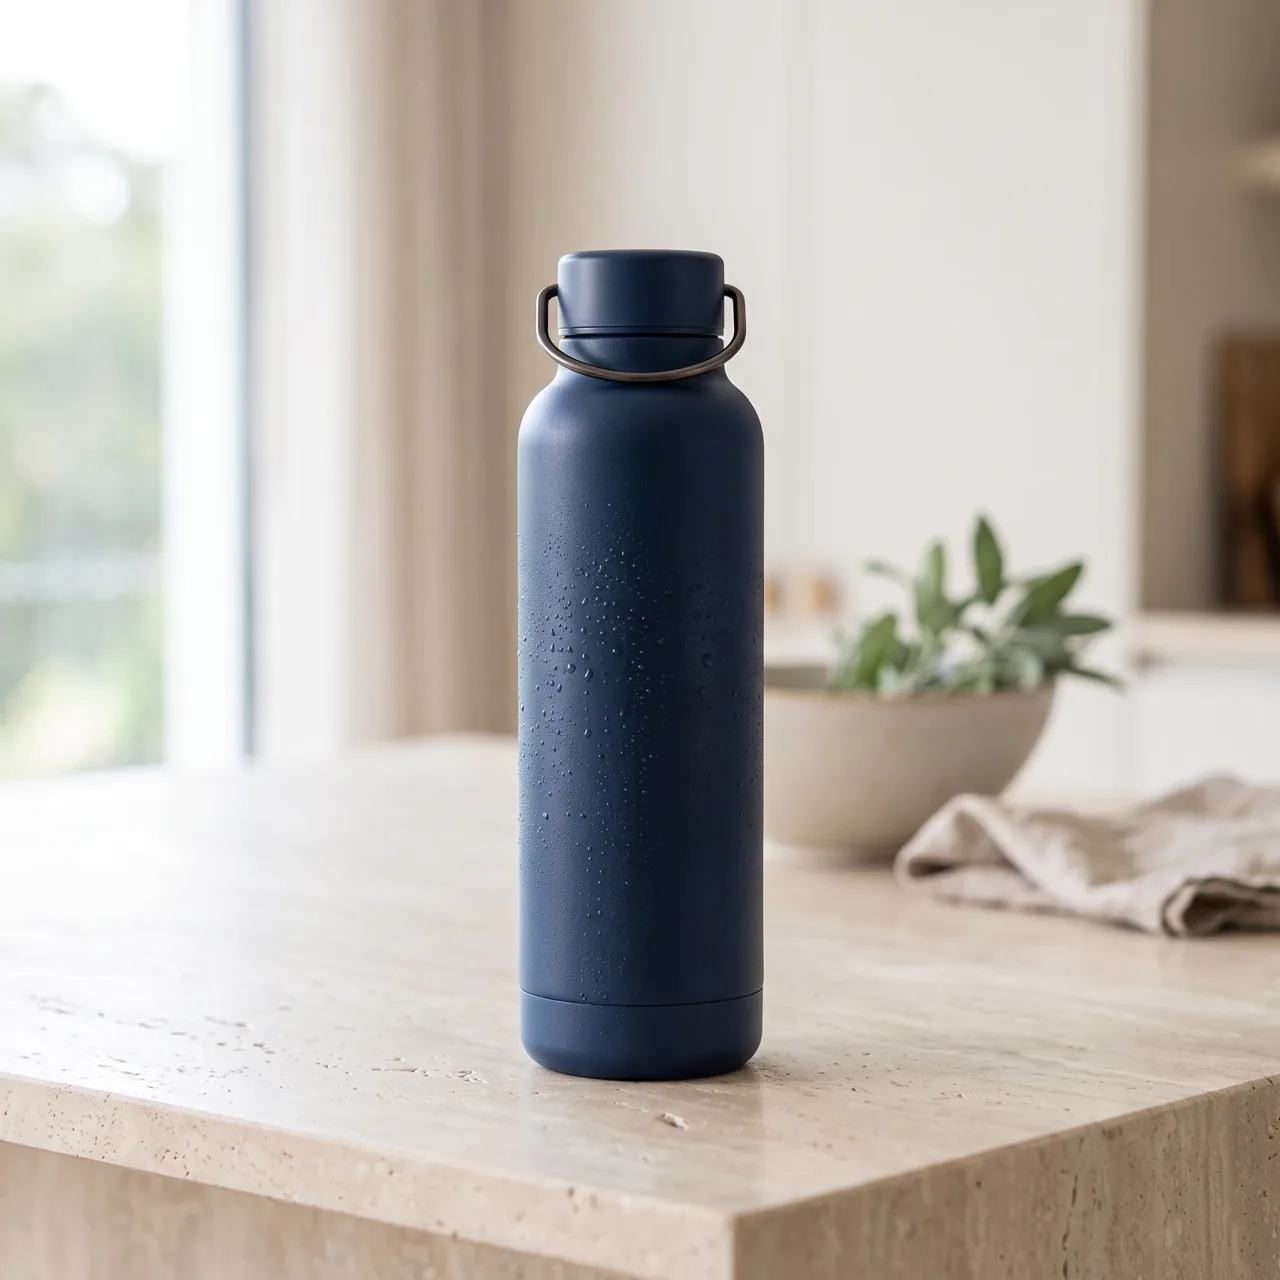
المزيد من تأطير صور المنتجات؛ لكنني ما زلت لم ألتزم بالتعليمات المتعلقة بالحجر الفاتح.
والدرس العملي المستفاد هو أن تدفع مقابل نموذج الصورة الذي يمكنك تصحيح أخطائه بسرعة. بالنسبة لهذه المطالبة بالذات، لم يكن أي من الناتجين جاهزًا للنشر دون إجراء تعديل. اختبر ألوان علامتك التجارية والنصوص والصور المرجعية وتعليمات التحرير الخاصة بك قبل اختيار أي خطة.
ما الذي يجب التحقق منه قبل الدفع لموديل صور
ينبغي أن يكون التقييم الإبداعي أكثر صرامة من مجرد السؤال عما إذا كانت الصورة تبدو جيدة بمفردها. فالصورة التجارية تنطوي على متطلبات يسهل إغفالها في موجز الأخبار: صورة المنتج الجانبية، ودقة الملصق، وألوان العلامة التجارية، واتجاه الإضاءة، والمساحة الفارغة المخصصة للنص، ونسبة العرض إلى الارتفاع الخاصة بالحملة، والقدرة على إجراء تغيير مدروس دون إفساد كل ما نجح بالفعل. قم بتجميع حزمة اختبار صغيرة تتضمن صورة واحدة واضحة للمنتج، ومشهدًا واحدًا يعكس أسلوب الحياة، وصورة واحدة تتضمن قيودًا متعلقة بالخطوط أو التغليف، وتعديلًا واحدًا على مادة موجودة بالفعل.
Veo 3.1 مقابل Seedance 2.0: اختبار فيديو لمنتج واحد
ثم طلبنا إعلانًا تجاريًّا لمنتج فاخر مدته خمس ثوانٍ: زجاجة بلون كحلي غير لامع موضوعة في وسط خلفية حجرية فاتحة اللون، مع حركة تقريب بطيئة، وتكثف بخار، وبدون شعار أو نص أو أشخاص. استمر إخراج Veo 3.1 لمدة ثماني ثوانٍ؛ وبحلول الثانية الثانية، أظهر تفاصيل مقربة جذابة للمنتج وتكثفًا، لكن الكاميرا كانت قد اقتربت أكثر من اللازم بحيث لم تستوفِ التركيب المطلوب المتمثل في وضع الزجاجة في المنتصف بالكامل. أما Seedance 2.0 فقد أنتجت مقطعًا مدته 5.04 ثانية وحافظت على عرض الزجاجة في وضع مستقيم بشكل كامل على سطح يشبه الحجر، على الرغم من أن الجزء العلوي من الزجاجة كان مقطوعًا وكان التكثيف أقل وضوحًا بكثير.
الموجه المشترك المستخدم في كلتا النتيجتين المولَّدتين
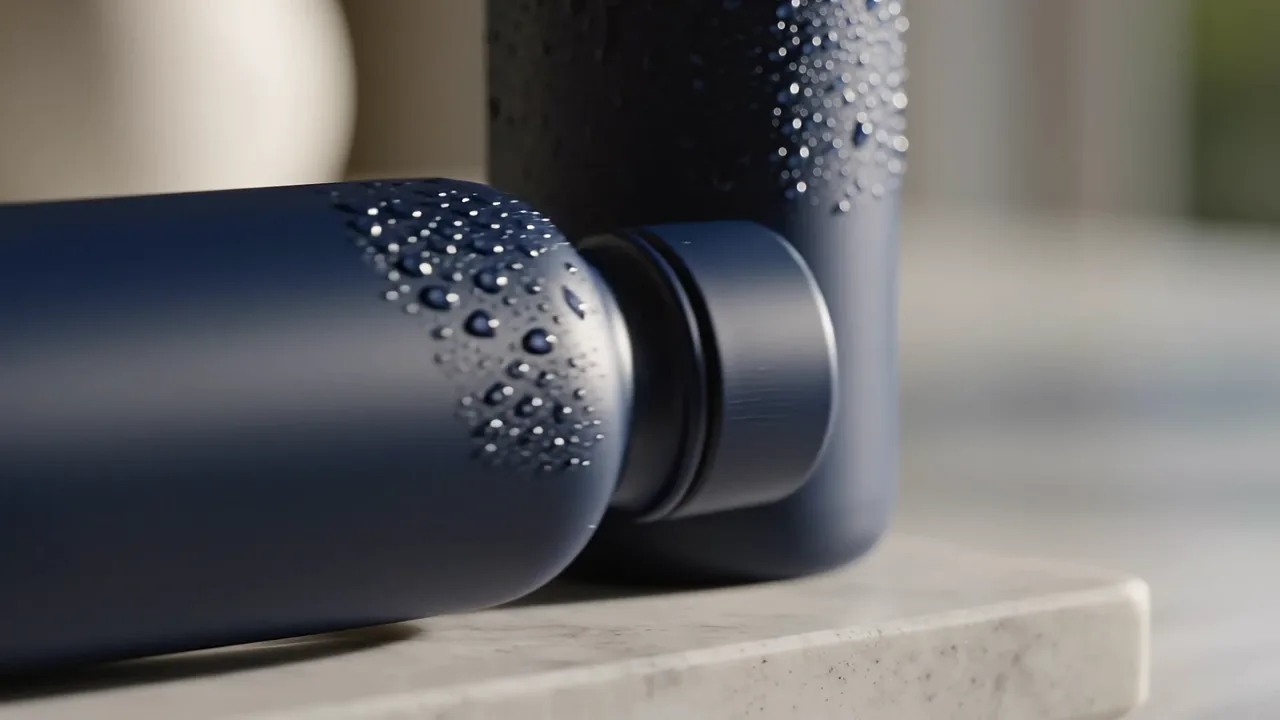
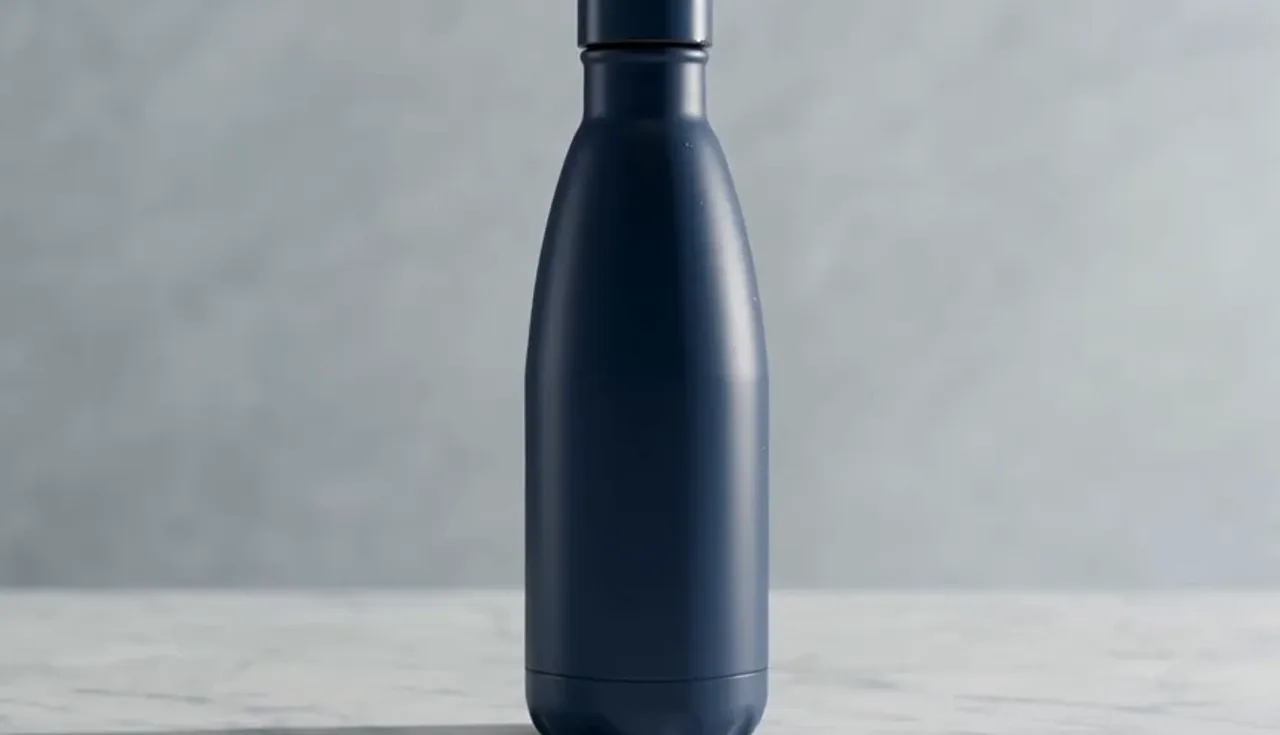
اختر تقنية الذكاء الاصطناعي الخاصة بالفيديو بناءً على السرعة التي تصل بها إلى ما تحتاجه من حيث الإطار والحركة والتحكم في المراجعة، وليس بناءً على إطار واحد جذاب. تحقق من الحقوق الحالية ومتطلبات الوصول في دليل الاستخدام التجاري لـ Veo 3.1 و دليل الوصول إلى Seedance 2.0. كما يضم موقع «أغنيس فيديو» أيضًا الوثائق الرسمية للمنتج; ؛ تحقق من شروط الخطة مباشرةً قبل الشراء.
كيفية وضع ميزانية للذكاء الاصطناعي دون دفع تكاليف نفس المهمة مرتين
لا يحتاج معظم الناس إلى اشتراك لكل فئة من فئات النماذج. تبدأ الميزانية المعقولة بالمهمة الوحيدة التي تستهلك أكبر قدر من الجهد. بالنسبة للمستشار، قد تكون هذه المهمة هي البحث والكتابة. وبالنسبة للمطور، قد تكون المراجعة والتصحيح مع مراعاة المستودع. أما بالنسبة للفريق الإبداعي، فقد تكون القدرة على إنتاج ومراجعة عناصر الحملة. قم بتمويل هذا العائق الرئيسي أولاً، ثم أضف مسارًا ثانيًا فقط بعد أن تكشف مهمة حقيقية عن وجود فجوة.
فكر في مستويات. المستوى الأول هو مساعد أساسي تستخدمه بشكل متكرر. المستوى الثاني هو متخصص في مهمة مختلفة تمامًا، مثل البحث المدعوم بمصادر أو إنتاج مقاطع الفيديو. أما المستوى الثالث فهو وصول مرن للتجارب، وحالات الزيادة في العمل، والحصول على آراء ثانية. ما يجب تجنبه هو الاشتراك في ثلاثة برامج دردشة عامة تنتج جميعها المسودة الأولى نفسها تقريبًا. التكلفة الشهرية الإضافية واضحة؛ أما التكلفة الأكثر ضررًا فهي أن لا أحد يعرف أي إجابة يمكن الوثوق بها أو أين تنتمي النسخة النهائية.
نهج عام/منطقي قوي، بالإضافة إلى إمكانية الوصول إلى المصادر البحثية عندما يتطلب العمل ذلك. لا تُضف الصور أو مقاطع الفيديو إلا في دورات الإنتاج الفعّالة.
الأفضل لـ كتاب، ومحللون، ومؤسسون، ومستشارون.
مسار واحد يتيح إمكانية البرمجة ويتناسب مع المحرر أو واجهة الأوامر (CLI)، ونموذج ثانٍ للأسئلة الصعبة في المراجعة، والاختبارات الحالية كمرحلة نهائية.
الأفضل لـ المطورون الأفراد وفرق المنتجات الصغيرة.
مسار واحد للصور/مقاطع الفيديو يتمتع بقدرة كافية على التكرار، ونموذج عام للمفاهيم والموجزات، وقائمة مراجعة قابلة للتكرار للحصول على الموافقة.
الأفضل لـ المسوقون وفرق التجارة الإلكترونية والوكالات.
بالنسبة للفرق، حددوا المسؤوليات قبل شراء التراخيص. من يمكنه استخدام البحث المباشر عبر الويب لمعالجة مطالبة أحد العملاء؟ من الذي يراجع الكود الذي تم إنشاؤه؟ من الذي يوافق على العناصر المرئية؟ أين يتم تخزين المطالبات والنتائج المعتمدة؟ هذه ليست أسئلة بيروقراطية. فهي تحدد ما إذا كان الذكاء الاصطناعي سيجعل الفريق أسرع أم أنه سيؤدي ببساطة إلى إنتاج المزيد من المسودات التي يتعذر تتبعها. إن الخطة المتواضعة ذات سير العمل المحدد أكثر قيمة من الوصول المتميز الذي يفتقر إلى معايير المراجعة.
الأسئلة التي يجب طرحها قبل أن يتدخل الذكاء الاصطناعي في الأعمال المهمة
“عبارة ”يستحق الدفع مقابله» ليست مجرد مسألة سعر. فكلما زادت خطورة عواقب أي خطأ، زادت الحاجة إلى وضع حدود تشغيلية واضحة للاشتراك. فلا ينبغي أن يمر كل من مسودة وصف المنتج والتوصية المالية الموجهة للعميل عبر نفس العملية غير الخاضعة للمراجعة. قبل أن تجعل النموذج جزءًا من سير عمل جاد، حدد المعلومات التي قد يتلقاها، ومن يتحقق من النتائج، وما يجب الحصول عليه من مصادر خارجية، وما لا يجوز نشره أبدًا دون موافقة مسؤول بشري.
- ما هي المهمة المحددة التي ستتولى هذه الخدمة تنفيذها أو ستعمل على تسريعها بشكل ملموس؟
- ما هو المصدر أو الاختبار أو الجهة المُراجعة التي تثبت أن منتجاتها آمنة بما يكفي للاستخدام؟
- ما الذي يجب أن يعرفه النموذج، وهل من المناسب مشاركة تلك المعلومات؟
- هل يمكن لأحد أعضاء الفريق الآخرين إعادة تنفيذ سير العمل دون نسخ سجل محادثة خاصة؟
- ما الذي قد يدفعنا إلى إلغاء هذا الاشتراك في غضون 30 يومًا؟
عندما تكون مساحة عمل واحدة متعددة النماذج أكثر قيمة من الاشتراكات المنفصلة
قد يكون الاشتراك المباشر خيارًا ناجحًا عندما تحتاج إلى أحدث الميزات الخاصة بمزود معين، أو ضوابط مؤسسية، أو سير عمل متكامل بشكل عميق. لكن الاشتراكات المنفصلة تصبح مكلفة ومزعجة عندما تتغير مهامك من البحث المقتبس إلى مراجعة الكود إلى صور المنتجات في نفس الأسبوع. وفقًا للصفحة الرئيسية الحالية لـ GlobalGPT، يوفر حساب واحد أكثر من 100 نموذج ذكاء اصطناعي بدءًا من $5.80 شهريًّا، إلى جانب Perplexity، وDeep Research، وYukie، والوصول عبر الويب وواجهة سطر الأوامر (CLI)، وخادم MCP لـ Claude Code وCodex وCursor.
يبدو التسلسل العملي متعدد النماذج كما يلي: ابدأ بـ Perplexity أو «البحث المتعمق» (Deep Research) للحصول على الأدلة الحالية؛ استخدم نموذجًا عامًّا لتشكيل المذكرة؛ اطلب من نموذج ثانٍ أن يختبر صحة الافتراضات؛ أرسل الأسئلة المحددة المتعلقة بالتنفيذ عبر CLI أو MCP إذا كان ذلك هو سير عمل التطوير الحالي لديك؛ ثم انتقل إلى الصور أو الفيديو فقط إذا كانت الحملة تحتاج إلى إنتاج بصري. هذا التسلسل يجعل اختيار الأداة واضحًا. كما أنه أرخص من الشراء التلقائي للخطة الأعلى سعرًا من كل مورد قبل معرفة أي خطوة تستحق الميزانية.
توقف عن الدفع بشكل منفصل عندما يتغير العمل باستمرار
استعن بالبحوث قبل البدء في الصياغة، وقم بتغيير النماذج عندما تحتاج إجابة استراتيجية إلى رأي ثانٍ، وقم بتوجيه أعمال البرمجة عبر واجهة سطر الأوامر (CLI) أو MCP، ثم أنشئ الصور ومقاطع الفيديو من الحساب نفسه.
جرب مساحة العمل متعددة النماذج من GlobalGPTالسبب الأقوى للدفع ليس الحصول على اسم نموذج مشهور، بل هو توفر المسار المناسب في اللحظة التي تتغير فيها المهمة، دون الحاجة إلى إعادة بناء مجموعة اشتراكاتك. وبالنسبة لنقطة دخول عامة للنموذج، فإن مسار «GPT-5.6 Sol» المُثبت من GlobalGPT هو متوفر هنا.
الأسئلة الشائعة
ما هي تقنية الذكاء الاصطناعي التي تستحق أن ندفع مقابلها أكثر من غيرها؟
أفضل نظام ذكاء اصطناعي من حيث العائد هو الذي يوفر لك الوقت بشكل متكرر في أداء عملك الأساسي. فالأعمال التي تعتمد بشكل كبير على البحث تستفيد من البحث المرجعي؛ والتحليل يستفيد من وجود نموذج عام قوي؛ والتطوير يستفيد من وجود نموذج وواجهة يعملان على تحسين دورة المراجعة؛ أما أدوات الصور والفيديو فيجب أن تحل محل الوقت الفعلي المستغرق في الإنتاج.
هل يستحق ChatGPT أن ندفع مقابله؟
قد يكون من المفيد شراء ChatGPT إذا كانت هذه هي بيئتك الرئيسية للصياغة والتحليل وحل المشكلات بشكل تكراري. قم بتشغيل المهام المتكررة الخاصة بك عبر هذا النموذج ونموذج آخر، ثم قارن بين وقت المراجعة وكذلك الإجابة الأولى.
هل يستحق برنامج Perplexity أن تدفع مقابله؟
يكون نهج «Perplexity» أكثر أهمية عندما تؤثر مصادر المعلومات الحالية والمراجع القابلة للتحقق بشكل جوهري على جودة بحثك. أما إذا كان عملك يقتصر بشكل أساسي على الكتابة أو البرمجة أو إنتاج الموارد دون اتصال بالإنترنت، فإن هذا النهج يكون أقل أهمية.
ما هو أفضل ذكاء اصطناعي للبرمجة؟
أفضل نظام ذكاء اصطناعي للبرمجة هو الذي يفهم سياق المستودع ذي الصلة، ويقترح تغييرًا قابلاً للمراجعة، ويُنتج اختبارات قابلة للتشغيل، ويتوافق مع محرر البرمجة أو واجهة سطر الأوامر (CLI) التي تستخدمها. تعامل مع الكود الذي يُنتج تلقائيًّا على أنه مسودة إلى أن تجتاز الاختبارات المعتادة وعملية المراجعة.
هل يجب عليّ الدفع مقابل استخدام الذكاء الاصطناعي لإنشاء صورة أو مقطع فيديو؟
ادفع عندما يقوم العارض/العارضة بإنتاج مسودات بانتظام تحل محل وقت التصوير أو التصميم أو التحرير أو الوقت الذي تقضيه الوكالة. قارن نفس المطلب الذي يراعي خصوصيات العلامة التجارية في أكثر من خدمة واحدة، وخصص ميزانية للتعديلات المتكررة، لأن النتائج الأولية قد تغفل تفاصيل تتعلق بالتأطير أو المواد.
هل يستحق الاشتراك في خدمة الذكاء الاصطناعي متعددة النماذج كل هذا العناء؟
يُعد الاشتراك في نماذج متعددة خيارًا مفيدًا عندما تتنقل بين الأبحاث والكتابة والبرمجة والصور والفيديو، أو عندما تحتاج إلى نموذج ثانٍ للتحقق من صحة إجابة مهمة. وقد تظل الخطة المباشرة من المزود هي الخيار الأفضل عندما يكون التحكم المباشر من الطرف الأول أمرًا غير قابل للتفاوض.
هل يمكنني استخدام GPT-5.6 Sol مع GlobalGPT؟
يُدرج الطراز GlobalGPT طراز GPT-5.6 Sol في كتالوج الطرازات الحالي. استخدم مسار GlobalGPT المُتتبع في هذه المقالة للتأكد من الواجهة المتاحة حاليًا واختيار خيار الوصول الذي يناسب سير عملك.