يُعد «Muse Spark 1.3» أقوى إصدار من «Muse Spark» أطلقته شركة «Meta» حتى الآن: حيث يبلغ مؤشر الذكاء الاصطناعي للتحليل (Artificial Analysis Intelligence Index) لنموذج «xhigh» المتاح للجمهور 61، ويحتفظ بنافذة سياق تضم مليون توكن، وقد نجح في اجتياز المهام الثلاث للبرمجة ذات الصعوبة المتوسطة في اختبار واجهة برمجة التطبيقات (API) الخاص بنا الذي يركز على الاستجابة الفورية. التحذير المهم هو أن الرسم البياني المعياري الرئيسي لشركة «ميتا» يستخدم نظام «ماكس ريزونينغ»، في حين أن نظام «ماكس» كان لا يزال في انتظار طرحه على نطاق أوسع بعد إجراء اختبارات أمان إضافية عند إعداد هذه المراجعة.

مراجعة Muse Spark 1.3: الحكم السريع
حكمنا
يستحق برنامج «Muse Spark 1.3» التجربة في مجالات برمجة الوكلاء، والعمل في السياقات الطويلة، والأتمتة التي تراعي التكاليف. وتُعدّ نتائجه العامة في فئة «xhigh» منافسةً بالفعل على مستوى الطليعة، لكن لا تستشهدوا بأعلى الدرجات التي حققتها «Meta» وكأن كل مستخدم لواجهة برمجة التطبيقات (API) قادر على تكرارها اليوم.
أطلقت شركة ميتا الإصدار 1.3 من تطبيق «Muse Spark» في 2 سبتمبر 2026, ، مما يجعلها مناسبة لسير العمل التفاعلي طويل المدى، وإنتاج كود أكثر دقة، وتعاونًا أكثر موثوقية. ويشكل هذا استمرارًا للتحول نحو وكلاء الذكاء الاصطناعي المبنية على نماذج استخدام الأدوات. تقول شركة «ميتا» إنها تطرح أسئلة توضيحية عندما تكون المتطلبات غامضة، وتُشير إلى وجود مشكلة عندما تتعثر، وتقوم بالتأكيد قبل اتخاذ أي إجراءات ذات عواقب. وفي مقارنات داخلية مع الإصدار 1.2، لاحظ مهندسو «ميتا» انخفاضًا في عدد استدعاءات الأداة بنحو 20%، وانخفاضًا في عدد الرموز بنحو 25%. وهذه ادعاءات من المزود، وليست نتائج من اختبارنا.
ما الذي تغير مقارنةً بإصدار Muse Spark 1.2؟
التحليل الاصطناعي: من 57 إلى 61 على xhigh.
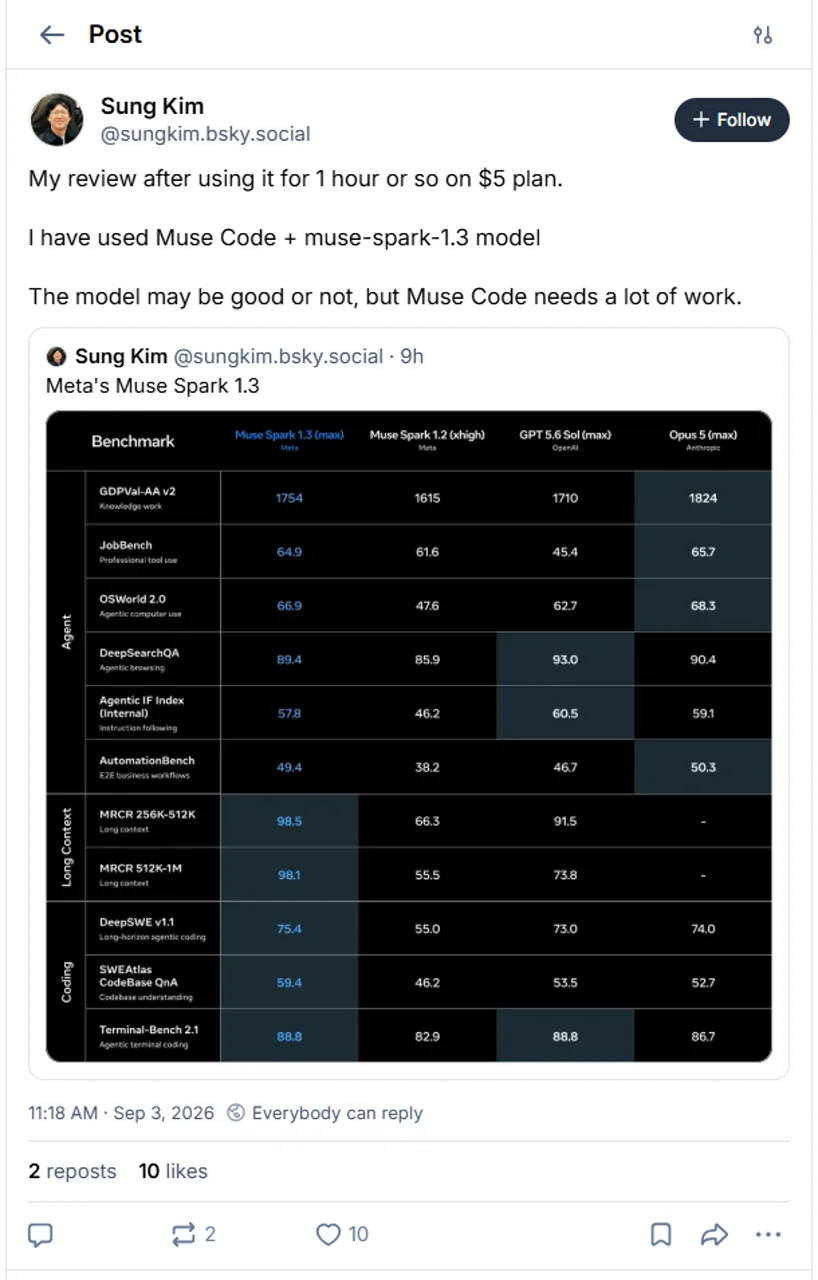
تُظهر نتائج Meta 75.4 مقابل 55.0 في DeepSWE، لكنها تقارن القيمة القصوى 1.3 بقيمة 1.2 xhigh.
لا تزال نافذة «1M» قائمة؛ وترتفع درجات MRCR ذات النطاق العالي ارتفاعًا حادًّا في مخطط «Meta».
ظلت معدلات التوكنات ثابتة، في حين سجلت AA قيمة $0.55 مقابل $0.40 لكل مهمة تم تقييمها.
اختبارات أداء Muse Spark 1.3: «Max» و«Xhigh» ليسا متطابقين
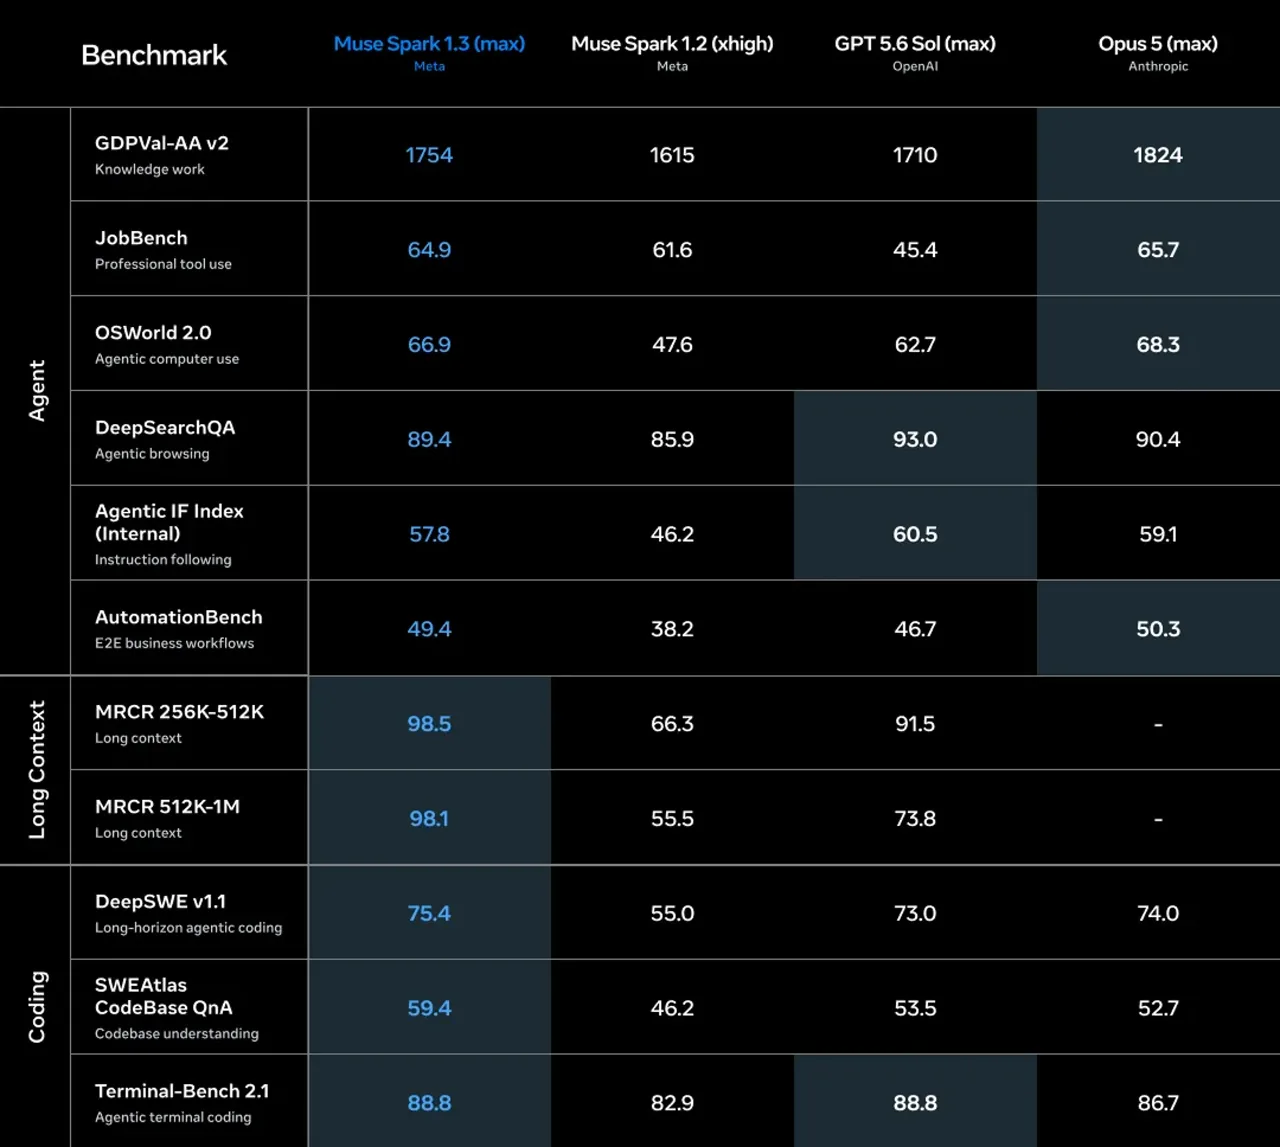
الرسم البياني الرسمي لشركة ميتا إنه أداء مثير للإعجاب. حقق Muse Spark 1.3 أعلى الدرجات التالية: 88.8 في اختبار Terminal-Bench 2.1، و75.4 في DeepSWE v1.1، و98.1 في MRCR 512K-1M، و66.9 في OSWorld 2.0. وقد تعادل مع GPT-5.6 Sol في أعلى النتائج في اختبار Terminal-Bench، وتفوقت على المنافسين المذكورين في نطاقي MRCR ذوي السياق الطويل. يمكن للمطورين الذين يقارنون السوق الأوسع نطاقًا استخدام نظرة عامة على وكيل البرمجة كسياق إضافي.
تقرير ميتا، الاستدلال الأقصى
| معيار | 1.3 كحد أقصى | 1.2 × الارتفاع | GPT-5.6 الحد الأقصى للشمس | أوبوس 5 ماكس |
|---|---|---|---|---|
| المنضدة الطرفية 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE الإصدار 1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | غير متوفر |
تحدّ الإعدادات المختلفة للجهود، وحزم أدوات الوكلاء، وإصدارات OSWorld من إمكانية المقارنة المباشرة. كما تصف Meta «مؤشر Agentic IF» بأنه مؤشر مركب داخلي.
كيفية قراءة الرسم البياني
تستخدم الإصدارات 1.3 وGPT-5.6 Sol وOpus 5 الإعداد «max»؛ بينما يستخدم الإصدار 1.2 الإعداد «xhigh».
تختلف الوكلاء المعينون ومجموعات الأسلاك الثابتة باختلاف التقييم.
تستخدم الإصداران 1.3 و1.2 إصدارات مختلفة من البيئة.
مؤشر Agentic IF هو مؤشر مركب من إعداد شركة Meta، وليس مؤشرًا قياسيًا عامًا منفردًا.
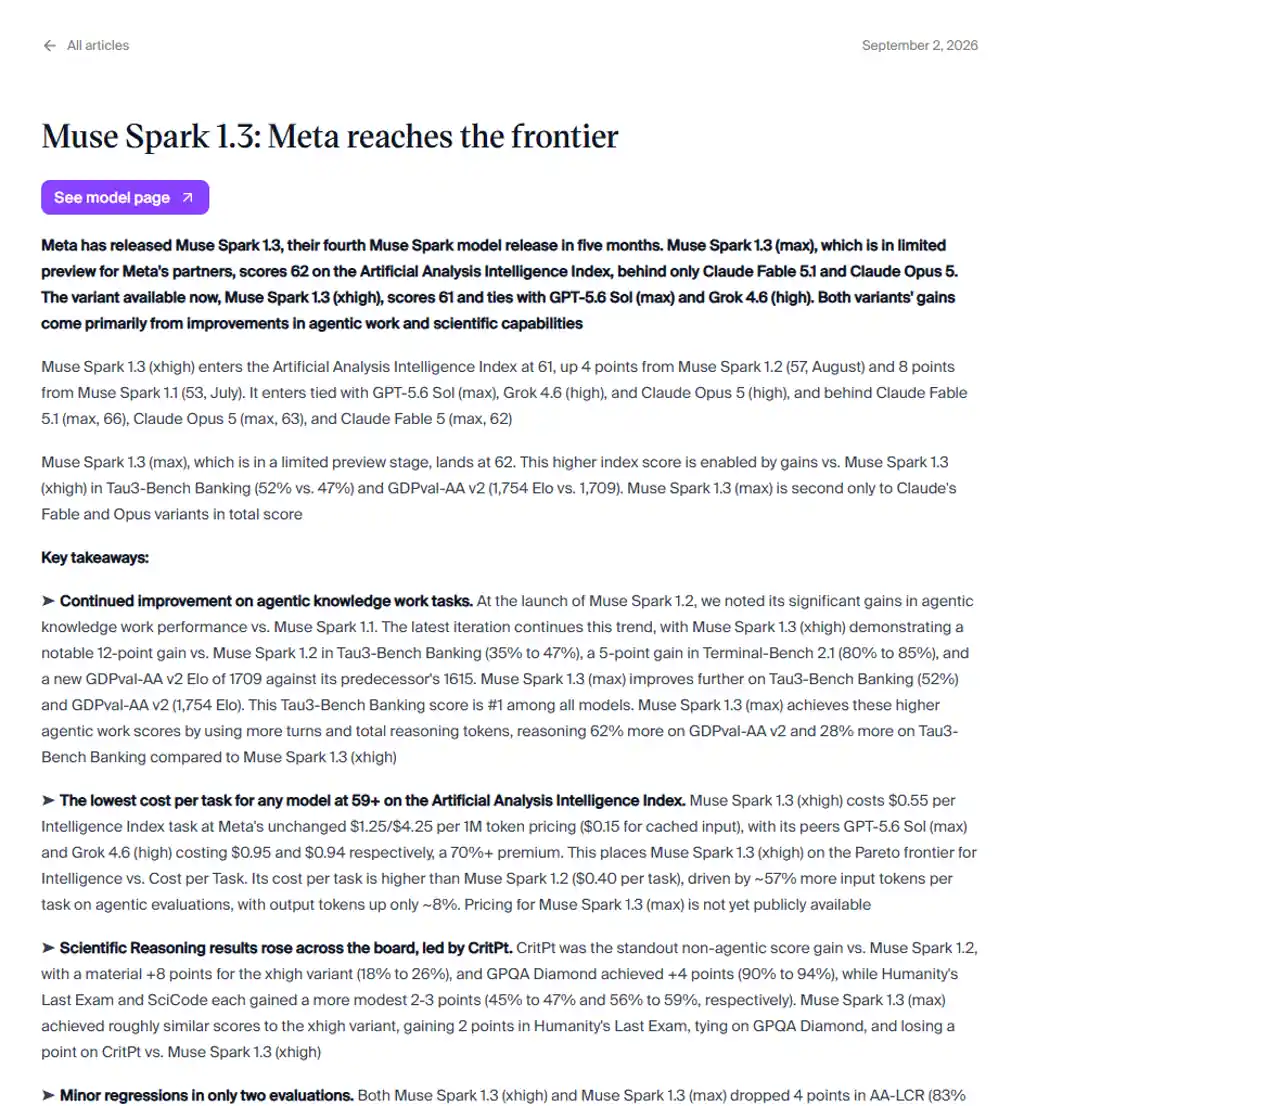
يوفر «التحليل الاصطناعي» رؤية أوضح من بين ما يمكن للمستخدمين الوصول إليه حاليًا. حقق Muse Spark 1.3 xhigh 61 نقطة، بارتفاع عن 57 نقطة في الإصدار 1.2. وبلغت نتيجة Terminal-Bench 85%، وGDPval-AA v2 1709 Elo، وTau3-Bench Banking 47%. يصل المتغير الأقصى في النسخة المحدودة للمعاينة إلى 62 بشكل عام. وهناك أيضًا بعض التراجع: ينخفض AA-LCR من 83% إلى 79%، بينما تنخفض دقة AA-Omniscience من 45% إلى 42% في xhigh.
أسعار Muse Spark 1.3
مساهم
muse-spark-1.3-المساهم
$0.10 مدخلات / $0.002 مخزنة مؤقتًا / $0.20 مخرجات لكل مليون توكن.
يمكن استخدام المطالبات لتحسين منتجات Meta.
قياسي
muse-spark-1.3
$1.25 مدخلات / $0.15 مخزنة مؤقتًا / $4.25 مخرجات لكل مليون توكن.
تقول شركة «ميتا» إن هذه الفئة لا تُستخدم لتحسين منتجاتها.
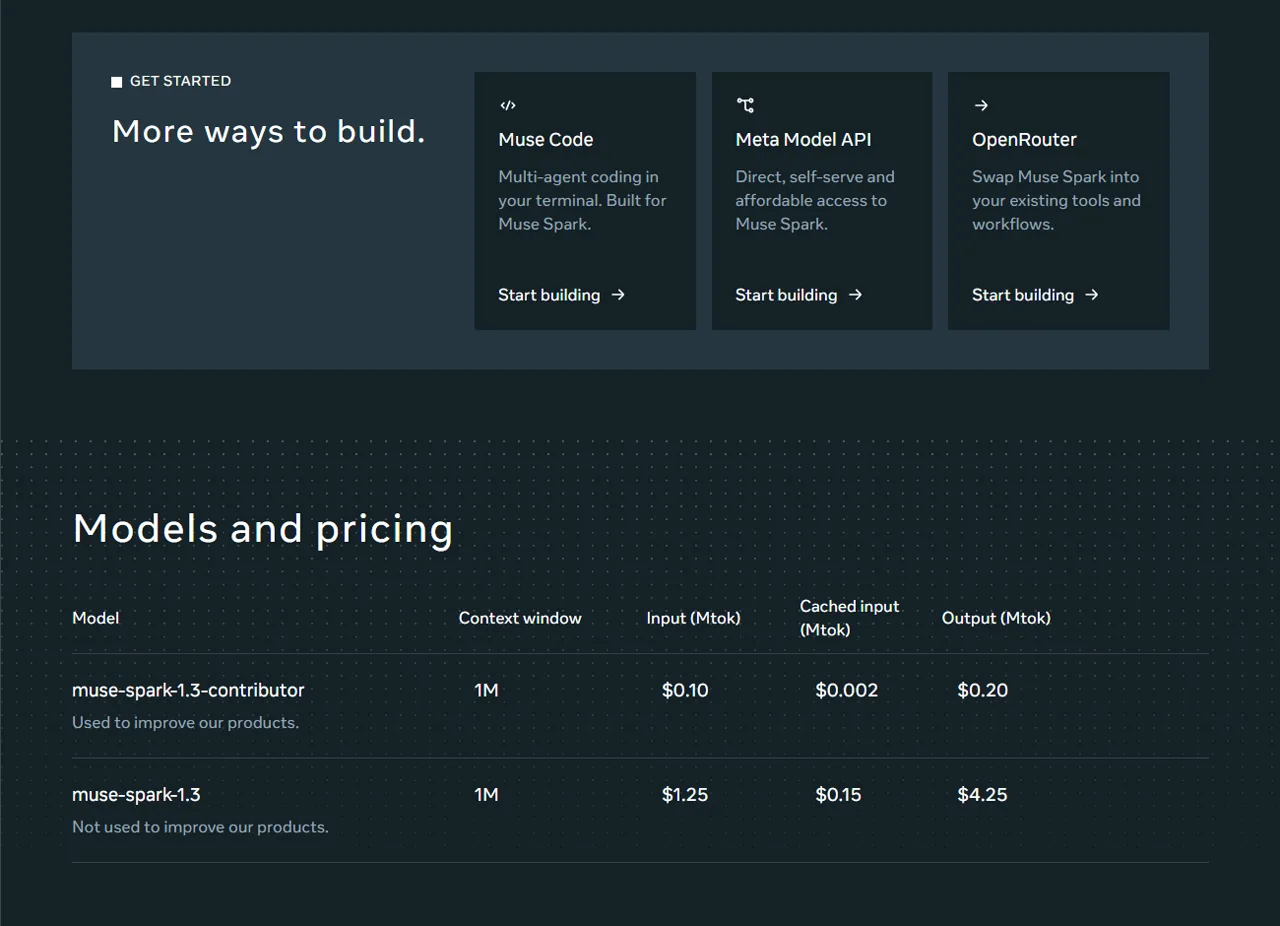
إن أسعار العملات الرمزية الرسمية لم تتغير عن 1.2، لكن تكلفة المهمة الواحدة لم تظل كما هي. لدينا مراجعة منصة الذكاء الاصطناعي الشاملة يشرح ذلك سبب وجوب تقييم تكلفة الوصول وتكلفة سير العمل بشكل منفصل. وقد سجلت «التحليل الاصطناعي» قيمة $0.55 لكل مهمة في «مؤشر الذكاء» عند مستوى 1.3 xhigh، مقابل $0.40 عند مستوى 1.2، ويرجع ذلك أساسًا إلى وجود ما يقارب 57% من الرموز المدخلة الإضافية في تقييمات الوكالة. تعتبر فئة المساهمين رخيصة للغاية، لكن شرط استخدام البيانات الخاص بها يمثل خيارًا حقيقيًّا للمنتج وليس مجرد حاشية.
الوصول إلى واجهة برمجة التطبيقات (API) لـ Muse Spark 1.3
شركة ميتا كتاب الطبخ الرسمي يستخدم الآن muse-spark-1.3 كإعداد افتراضي، وتوثق نافذة سياق تضم 1,048,576 رمزًا. تتوافق واجهة برمجة التطبيقات (API) مع حزمة أدوات التطوير (SDK) OpenAI. ويُعد كل من Muse Code وMeta Model API مسارات الوصول الحالية المؤكدة. تعرض صفحة النموذج الخاصة بـ Meta أيضًا OpenRouter، على الرغم من أن زره لا يزال يشير إلى عنوان URL 1.2 عند النقر عليه، لذا يرجى التحقق من المسار قبل النشر. للحصول على معلومات أساسية حول قابلية التشغيل البيني للوكلاء، راجع دليلنا الخاص بـ أدوات MCP والذكاء الاصطناعي.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "Review this patch for regressions."}],
)

print(response.choices[0].message.content)
اختبارات البرمجة العملية: 3/3 تم اجتيازها
قمنا باختبار ثلاث مهام متوسطة الصعوبة تتعلق بالمستودعات عبر واجهة برمجة التطبيقات (API) عند درجة حرارة صفر، باستخدام استجابة واحدة لكل مهمة. وكان يتعين على كل استجابة أن تُرجع ملفات كاملة بتنسيق JSON منظم. ثم قمنا بتطبيق تلك الملفات داخل مجلدات قابلة للإزالة وأجرينا فحوصات عامة وأخرى خفية. وهذه اختبارات صغيرة خاضعة للرقابة، ولا تُعد بديلاً عن Terminal-Bench أو تجربة على مستودع الإنتاج.
5/5 اختبارات؛ 18.4 ثانية؛ 2,473 رمزًا؛ $0.00905. اكتشف النموذج مجموعة معرّفات المعالجة غير المستخدمة، وأضاف آلية حماية مبكرة ضد التكرار، وكتب اختبار انحدار.
تم اجتياز فحص الأنواع وفحصين أثناء التشغيل؛ 47.6 ثانية؛ 4,945 وحدة لغوية؛ $0.01661. تم فصل عمليات التحقق من الصحة والتخزين الدائم وتسجيل التدقيق دون خرق حدود المعاملة.
9/9 اختبارات؛ 20.3 ثانية؛ 3,789 رمزًا؛ $0.01446. تم اجتياز اختبارات التوافق مع ملفات CSV، والأخطاء في ترقيم الأسطر، والإخراج الذري، وسلامة التشغيل التجريبي، والمساعدة، والوثائق.
المجموع: 11,207 توكن و$0.04013. الأوقات المذكورة هي أوقات الطلب من البداية إلى النهاية، وليست زمن الاستجابة الأصلي لواجهة برمجة تطبيقات Meta أو زمن الوصول إلى الهدف (TTFT).
وكانت النتيجة أفضل مما يوحي به الرقم “3/3” وحده: فقد كانت الردود الثلاثة الأولى قابلة للمراجعة ومراعية للقيود. ويكتسب هذا النهج في التعامل مع الأدلة نفس الأهمية عند قراءة مراجعة GPT-5. ومع ذلك، فإن العينة لا تقيس موثوقية استدعاء الأدوات المتكرر، أو التنقل في المستودعات الكبيرة، أو طبقة التنسيق في Muse Code. وقد يجد القراء الذين يقيّمون البدائل ذات التكلفة المنخفضة أيضًا أن مقارنة بين نماذج ترميز الميزانية مفيد.
ردود الفعل الأولية للمطورين
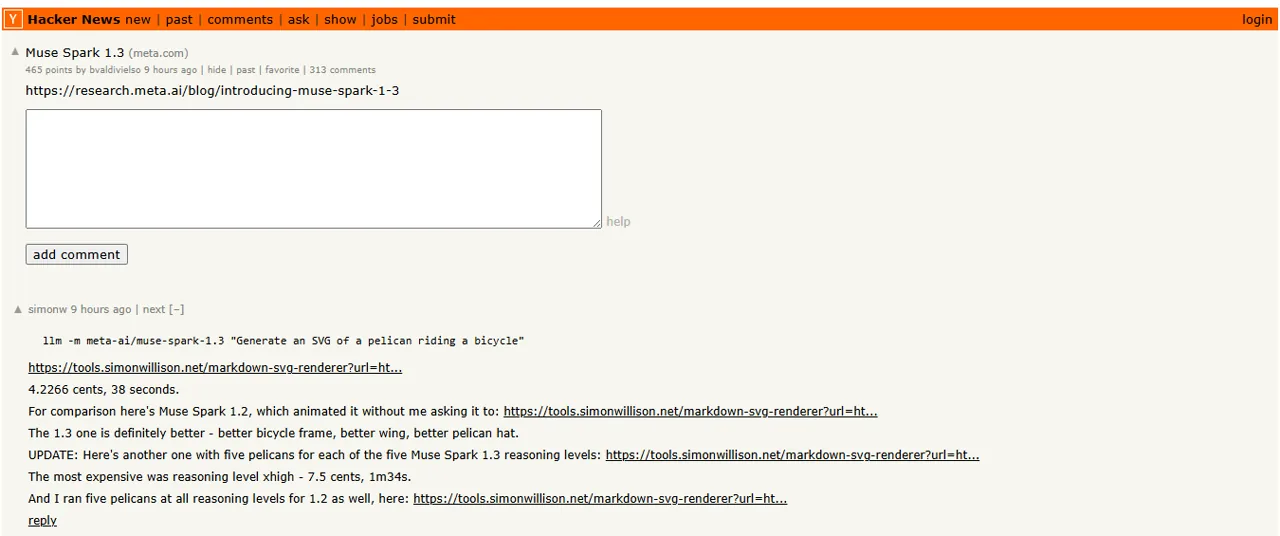
الردود الأولية متباينة وقليلة جدًّا بحيث لا يمكن القول بوجود إجماع. في اختبار Hacker News, ، سجل سيمون ويليسون زمنًا قدره 38 ثانية و4.2266 سنت في سباق SVG، ووصف النتيجة التي بلغت 1.3 بأنها “أفضل بالتأكيد” من النتيجة المقارنة التي بلغت 1.2. وصف داكس هذا الإصدار كتذكير بمدى اشتياقه للعارضات النحيفات. سونغ كيم, ، بعد قضاء حوالي ساعة مع “Muse Code”، قال إن النموذج قد يكون جيدًا، لكن منتج «Muse Code» «يحتاج إلى الكثير من العمل». ويتعلق هذا التعليق الأخير بتجربة الوكيل، وليس باختبار نظيف يقتصر على النموذج فقط.
الإيجابيات والسلبيات
ما الذي نجح
- تقييم عام قوي x أعلى درجة
- نافذة سياق الرمز 1M
- واجهة برمجة تطبيقات متوافقة مع OpenAI
- تم اجتياز مهام الترميز الثلاث جميعها في الاستجابة الأولى
- أسعار توكنات منخفضة جدًّا لمستوى المساهمين
ما الذي يجب مشاهدته
- نتائج «Headline max» ليست التجربة العامة الافتراضية
- ارتفعت تكلفة المهمة المستقلة مقارنة بـ 1.2
- انخفض مؤشران مستقلان
- قد تسهم بيانات المساهمين في تحسين منتجات ميتا
- ردود الفعل الأولية على «Muse Code» متباينة
من ينبغي أن يستخدم برنامج Muse Spark 1.3؟
استخدمه من أجل
تقييمات وكلاء البرمجة، والعمل على مستودعات السياقات الكبيرة، والأتمتة القائمة على الأدوات، والتجارب التي تراعي التكلفة حيث تكون سياسة البيانات مقبولة.
تخطي أو الانتظار عندما
إما أنك تحتاج إلى موثوقية إنتاجية مجربة على المدى الطويل، أو تحتاج إلى أقصى سعة في الوقت الحالي، أو لا يمكنك قبول استخدام البيانات على مستوى المساهمين وتجد أن الأسعار القياسية غير تنافسية.
الحكم النهائي على مراجعة Muse Spark 1.3
يحظى برنامج «Muse Spark 1.3» بتوصية لتقييمه. فهي تجمع بين الأداء العام الفائق الذي يرقى إلى مستوى أحدث ما توصلت إليه التكنولوجيا، ونتائج قوية في معالجة السياقات الطويلة، وسهولة استخدام واجهة برمجة التطبيقات (API) المألوفة، وأسعارًا تنافسية. وتؤكد مهام البرمجة الثلاث الخاصة بالاستجابة الفورية التي قمنا بها قدرتها على الالتزام بقيود الملفات المتعددة وإنتاج تصحيحات قابلة للاختبار.
اختر المستوى القياسي للكود الحساس. وللاطلاع على مقارنة أخرى بين الحدود، انظر GPT-5 مقابل Claude 4. تعامل مع نتائج الاختبارات القياسية القصوى على أنها أدلة أولية إلى أن يصبح مستوى الاستدلال هذا متاحًا على نطاق واسع. وقم بتقييم «Muse Code» بشكل منفصل عن واجهة برمجة تطبيقات النموذج: فقد تنجح تجربة المستخدم الخاصة بالوكيل، ودورة الأدوات، والتحكم في المستودع، أو تفشل، بشكل مستقل عن النموذج الأساسي.
الأسئلة الشائعة حول Muse Spark 1.3
ما هو Muse Spark 1.3؟
Muse Spark 1.3 هو نموذج ميتا للبرمجة وسير العمل التفاعلي الذي تم إصداره في 2 سبتمبر 2026، ويتميز بنافذة سياق تبلغ سعتها مليون توكن وقدرة أصلية على إدراك الصور ومقاطع الفيديو والمستندات.
كم يبلغ سعر برنامج Muse Spark 1.3؟
تبلغ تكلفة النموذج القياسي $1.25 لكل مليون رمز إدخال، و$0.15 للإدخال المخزن مؤقتًا، و$4.25 للمخرجات. تبلغ تكلفة نموذج المساهم $0.10 و$0.002 و$0.20 على التوالي، ولكن قد تُستخدم بياناته لتحسين منتجات Meta.
هل تتوفر ميزة «max reasoning»؟
وأوضحت شركة «ميتا» أن أوضاع الاستدلال الحالية متاحة منذ إطلاق الخدمة، وأن وضع «ماكس» سيتوفر لاحقًا بعد إجراء اختبارات أمان إضافية. يرجى مراجعة وثائق واجهة برمجة التطبيقات (API) الحالية قبل افتراض توفر الخدمة للجميع.
هل اجتاز برنامج Muse Spark 1.3 اختبارات البرمجة؟
نعم. فقد اجتازت استجاباته الأولى جميع اختبارات قابلية التنفيذ في إطار اختبارات إصلاح الأخطاء في لغة Python، وإعادة هيكلة TypeScript، واختبارات ميزات JSONL. ولا تحتوي العينة سوى على ثلاث مهام خاضعة للرقابة، ولا تمثل معدل موثوقية عامًا.
هل يُعد إصدار Muse Spark 1.3 أفضل من الإصدار 1.2؟
بشكل عام، استنادًا إلى الأدلة المتاحة. ارتفع معدل الذكاء العام xhigh من 57 إلى 61، وتشير تقارير Meta إلى تحسن كبير في القدرات الوكالية واسترجاع السياق الطويل، لكن «Artificial Analysis» لاحظت أيضًا ارتفاع تكلفة المهام وتراجعًا طفيفًا في استرجاع السياق الطويل ومعايرة الحقائق.
هل يجب أن أستخدم نموذج المساهم أم النموذج القياسي؟
استخدم الخيار «قياسي» للمطالبات الحساسة أو الخاصة، لأن شركة «ميتا» تؤكد أن هذه البيانات لا تُستخدم لتحسين منتجاتها. أما خيار «المساهم» فهو أرخص بكثير، لكن مطالباته قد تُستخدم لتحسين المنتجات.