
يُعد Claude Sonnet 5.5 نموذجًا قويًّا للعمل اليومي: فهو يتمتع بالقدرة الكافية لمعالجة الأخطاء الصعبة أو التعامل مع المستندات المكثفة، مع سعر أقل للوحدة مقارنةً بـ Opus 5.5. وتتجلى مزاياها بشكل خاص عندما تتمكن من تحديد الشكل الذي يجب أن تتخذه الإجابة الجيدة. أما في حالة الاستراتيجيات المفتوحة أو المشكلات غير المألوفة التي تنطوي على العديد من العوامل المتغيرة، فإن Opus لا تزال تستحق مكانًا في سير عملك.
في اختباراتنا الخاصة بـ GlobalGPT، قام Sonnet 5.5 بصياغة رسائل بريد إلكتروني للعملاء، وإصلاح وظيفة تخصيص الأموال التي اجتازت 43 فحصًا، وتسوية مجموعة من سجلات الفواتير المكونة من 13,078 كلمة بشكل صحيح. كما تضمنت رسالة البريد الإلكتروني افتراضًا صغيرًا متعلقًا بالعملية كان بحاجة إلى التحقق. والسؤال الأكثر إثارة للاهتمام هو متى تترجم سرعته وسعره إلى يوم عمل أفضل — ومتى يبدأ التفكير الإضافي في تكبد تكلفة تفوق ما يوفره.
يمكنك استخدام Claude Sonnet 5.5 على GlobalGPT إلى جانب نماذج رائدة أخرى في مجالات الكتابة والبرمجة والبحث والصور والفيديو. يمنحك اشتراك واحد متعدد النماذج طريقة ميسورة التكلفة لمتابعة مشروعك من المسودة الأولى وحتى إنجاز المخرجات النهائية، دون الحاجة إلى إدارة اشتراك منفصل لكل خطوة.
Claude Sonnet 5.5: التقييم السريع
خيار افتراضي عملي للأعمال المحددة بوضوح
ابدأ باستخدام «سونيت» لكتابة موجز أو الإبلاغ عن خطأ أو إعداد وثيقة أو تنفيذ أولي. زود البرنامج بالمواد المصدرية والقيود ومعايير القبول. ثم انتقل إلى «أوبوس» عندما يصبح الجزء الأصعب هو تحديد ماهية المشكلة الحقيقية.
ما أثار إعجابنا: التنسيق المنظم، والكود القوي، والتسوية الصحيحة للوثائق.
ما يجب مشاهدته: قد تتسلل افتراضات بسيطة إلى النص النهائي المصقول؛ ويؤدي الاستدلال إلى زيادة التكلفة؛ كما أن السياق المطول لا يضمن تذكر المعلومات.
هذه مراجعة لطراز تم إصداره مؤخرًا، وليست دراسة إنتاجية استمرت لعدة أشهر. نجمع بين مواصفات Anthropic والتقييمات المنشورة وثلاث مهام عملية تم تنفيذها في 1 أكتوبر 2026. تم تكرار مهمة الكتابة مرتين؛ بينما تم تنفيذ كل من مهمتي البرمجة والمستندات مرة واحدة. وتأخذ النتائج الواردة أدناه هذه العينة الصغيرة في الاعتبار.
ما الجديد في الإصدار Claude Sonnet 5.5؟
أصدرت Anthropic الإصدار Sonnet 5.5 في 28 سبتمبر 2026 باعتباره بديلاً أسرع وأقل تكلفة لبرنامج Opus 5.5. وتتمثل نقاط قوته المعلنة في إنجاز الأعمال اليومية المحددة النطاق، وإصلاح الأخطاء، وإنتاج مستندات وشرائح عرض وجداول بيانات متقنة. وهذا التموضع مهم: فأنت لا تحتاج إلى الطراز الأغلى ثمناً لكل عملية تحرير أو رد دعم أو مهمة تنفيذ.
ما الجديد في الإصدار Claude Sonnet 5.5؟
| الميزة | Sonnet 5.5 | ما يعنيه ذلك عمليًّا |
|---|---|---|
| المدخلات والمخرجات | إدخال النص والصور؛ إخراج النص | اسأل عن رسم بياني أو لقطة شاشة، ثم حوّل الإجابة إلى مسودة أو خطة. |
| نافذة سياق واجهة برمجة التطبيقات (API) | مليون توكن | هناك متسع لمواد مرجعية وافرة؛ قم بتنظيمها وتصنيفها بعناية. |
| الحد الأقصى للإخراج وفقًا لواجهة برمجة التطبيقات القياسية | 128 ألف توكينز | هذا مثال على الحد الأقصى، وليس طولًا موصى به لكل إجابة. |
| التفكير المنطقي | التفكير التكيفي | يمكن أن يؤثر الجهد على كل من وقت الإنجاز وإجمالي استخدام الرموز. |
| قطع المعرفة | يونيو 2026 | استخدم المصادر الحالية أو أدوات البحث للتحقق من صحة المعلومات. |
تصف حدود السياق والمخرجات هذه واجهة برمجة التطبيقات (API) Claude. كما أن الكمية التي يمكنك تحميلها أو تلقيها في تطبيق معين تعتمد أيضًا على واجهة ذلك المنتج. وبالمثل، فإن النموذج الذي يفهم الصورة ليس مولدًا للصور. يمكن لـ Sonnet تقييم مادة بصرية أو كتابة موجز إنتاجي؛ أما نموذج الصور أو الفيديو فيقوم بإنشاء الوسائط النهائية.
التحسين المفيد هو الجمع بين تنفيذ المهام بشكل أكثر فعالية وتكرار أسرع. يمكنك طلب مسودة أولية، وتفحص الأجزاء الضعيفة، وطلب مراجعة مركزة. فالموجه الجيد يحدد الهدف المطلوب: “حافظ على جميع الأرقام دون تغيير، واختصر النص إلى 200 كلمة، واذكر أي شيء لم يثبته النص الأصلي”.”
أسعار Claude Sonnet 5.5: أسعار التوكن والتكلفة الفعلية
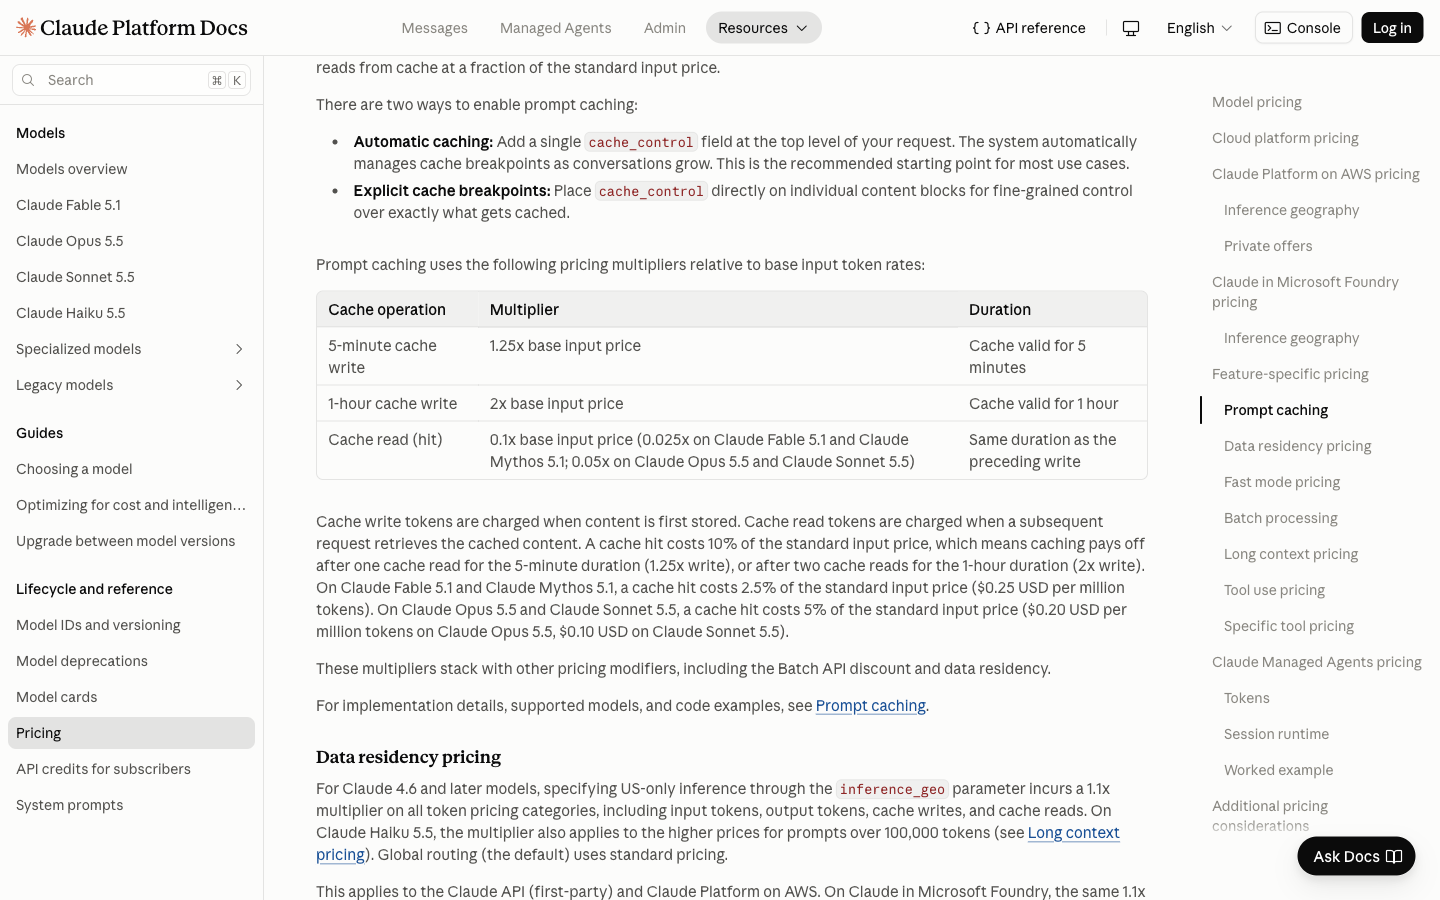
تكاليف Sonnet 5.5 $2 لكل مليون توكن مدخل و$10 لكل مليون توكن مخرج بأسعار واجهة برمجة التطبيقات (API) القياسية لـ Anthropic. وهذه هي نفس أسعار الوحدة المطبقة على Sonnet 5. وبالمقارنة مع أسعار المدخلات $4 والمخرجات $20 في Opus 5.5، فإن تكلفة Sonnet تبلغ نصف السعر لكل رمز مدخلات أو مخرجات — ولكن المهمة المكتملة قد تستهلك عددًا مختلفًا من الرموز.
أسعار Claude Sonnet 5.5: أسعار التوكن والتكلفة الفعلية
| فئة الفوترة الخاصة بواجهة برمجة التطبيقات (API) | السعر لكل مليون توكن |
|---|---|
| المدخلات غير المخزنة في ذاكرة التخزين المؤقت | $2.00 |
| الإنتاج، بما في ذلك الرموز الرقمية المُفوَّرة | $10.00 |
| قراءة ذاكرة التخزين المؤقت / تحديثها | $0.10 |
| كتابة ذاكرة التخزين المؤقت، 5 دقائق | $2.50 |
| كتابة ذاكرة التخزين المؤقت، ساعة واحدة | $4.00 |
بالنسبة للطلبات غير المخزنة في ذاكرة التخزين المؤقت، يُضرب عدد الرموز المدخلة في $2 لكل مليون، ويُضرب عدد الرموز المخرجة في $10 لكل مليون. وتبلغ تكلفة المدخلات المكونة من 10,000 رمز مع 2,000 رمز مخرج $0.04. تكلفة الإدخال المكون من 100,000 توكن مع الإخراج المكون من 10,000 توكن تبلغ $0.30. هذه أمثلة عملية على واجهة برمجة التطبيقات (API)، وليست فاتورة GlobalGPT؛ فقد تؤدي الأدوات وعمليات التخزين المؤقت ومستويات الخدمة وعوامل التعديل الأخرى في التسعير إلى تغيير المبلغ الإجمالي.
كم قد يكلف هذا الطلب
تكاليف نموذجية توضيحية لواجهة برمجة التطبيقات (API) لكل طلب. تشمل المدخلات والمخرجات غير المخزنة في ذاكرة التخزين المؤقت فقط.
الصيغة: (عدد الرموز المدخلة × $2 + عدد الرموز المخرجة × $10) ÷ 1,000,000. تُحتسب عمليات التفكير المفوترة ضمن الرموز المخرجة. هذه أمثلة فقط، وليست أسعار اشتراك أو فواتير محسوبة.
يستند ادعاء Anthropic بأن “التكلفة تقل بما يصل إلى 30% لكل مهمة” إلى إنجاز بعض الأعمال باستخدام عدد أقل من الرموز. ولا يُعد ذلك تخفيضًا في السعر بمقدار 30%. وفي الطرف الآخر،, تقييم إطلاق «التحليل الاصطناعي» بلغت النتيجة حوالي $7.60 لكل مهمة من مهام مؤشر الذكاء عند الجهد الأقصى، أي ما يزيد بنحو 50% عن Sonnet 5 في ذلك الاختبار. هذه المهام القياسية الصعبة ليست مجرد رسائل دردشة عادية، لكنها توضح لماذا قد يؤدي رفع مستوى الاستدلال إلى أقصى حد إلى إبطال ما يبدو أنه صفقة مربحة.
تعد فوترة واجهة برمجة التطبيقات (API) واشتراكات Claude وGlobalGPT خيارات مختلفة
تستخدم باقات المستخدمين في Claude نظام التسعير القائم على الاشتراك: الباقة المجانية هي $0، والباقة الاحترافية (Pro) هي $20 شهريًّا أو $200 سنويًّا، بينما تبدأ الباقة القصوى (Max) من $100 شهريًّا، قبل إضافة الضرائب المطبقة. يخضع استخدام التطبيق لحدود محددة في كل خطة. تدرج Anthropic أيضًا $100 أو $200 كرصيد شهري لواجهة برمجة التطبيقات (API) لمستويات Max المقابلة؛ بينما لا تتضمن الخطتان Free وPro رصيدًا شهريًا لواجهة برمجة التطبيقات (API). قارن بين حدود الوصول إلى التطبيق وحدود API بشكل منفصل عند اختيار الباقة. تناسب المنصة متعددة النماذج الأشخاص الذين يتنقلون بانتظام بين عائلات النماذج وأنواع الوسائط في عملهم.
إذا كان يومك يتضمن كتابة صفحة إطلاق، ومراجعة الكود، وإنشاء العناصر المرئية للحملة،, يجمع GlobalGPT هذه الأدوات معًا. وتكمن قيمتها في نطاق سير العمل الذي يغطيه الاشتراك الواحد، بدلاً من دفع تكاليف عدة منتجات منفصلة لمجرد إنجاز مشروع واحد. اختر الباقة التي تتناسب مع العمل الذي تقوم به فعليًّا.
المعايير المرجعية: قريبة من Opus في بعض المهام، وليس في كل المهام
تُظهر نتائج الإصدار خطوة كبيرة إلى الأمام مقارنةً بنموذج Sonnet 5. كما توضح هذه النتائج لماذا لا يمكن لنتيجة رئيسية واحدة أن تحسم اختيار النموذج. يتصدر نموذج Sonnet 5.5 مقارنة «Terminal-Bench» المُعلنة، بينما يظل نموذج Opus 5.5 متقدمًا في اختباري «FrontierCode» و«CursorBench». تعد تقييمات الأداء في مهام المعرفة المتقاربة واعدة، لكنها لا تجعل النماذج قابلة للتبادل.
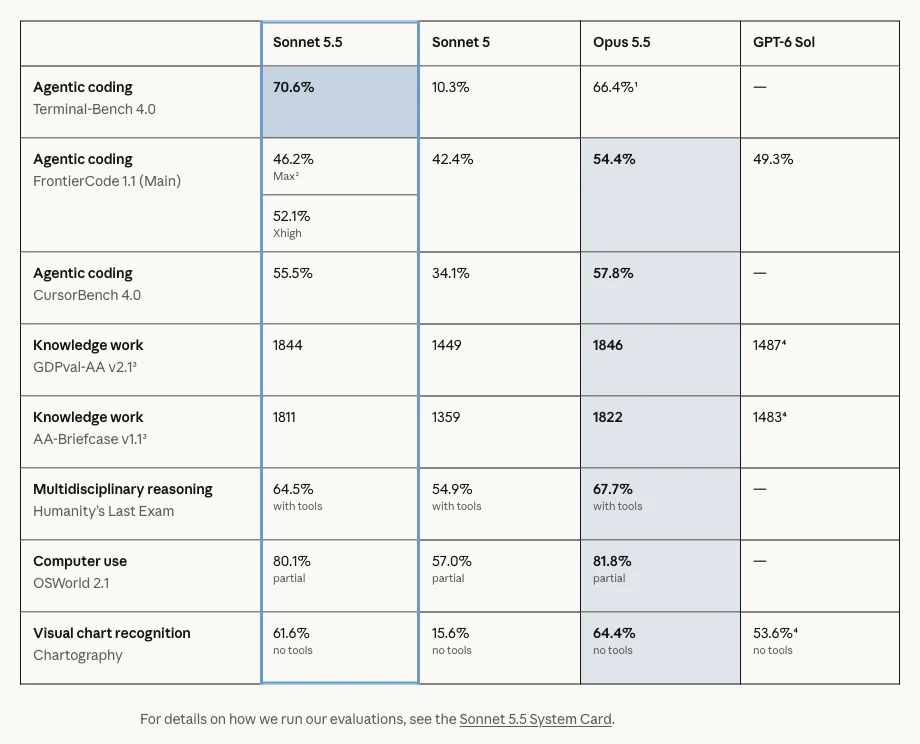
المعايير المرجعية: قريبة من Opus في بعض المهام، وليس في كل المهام
| التقييم في جدول إطلاق Anthropic | Sonnet 5.5 | السوناتة الخامسة | الأوبوس 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% (Xhigh) | - |
| FrontierCode 1.1 الرئيسي | 52.1% (Xhigh)؛ 46.2% (Max) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA الإصدار 2.1 | 1844 نقطة إيلو | 1449 نقطة إيلو | 1846 نقطة إيلو | 1487 |
| AA-Briefcase الإصدار 1.1 | 1811 إيلو | 1359 نقطة إيلو | 1822 نقطة إيلو | 1483 |
| الامتحان الأخير للبشرية | 64.5% مع الأدوات | 54.9% مع الأدوات | 67.7% مع الأدوات | - |
| OSWorld 2.1 | 80.1% جزئي | 57.0% جزئي | 81.8% جزئي | - |
| علم الخرائط | 61.6% بدون أدوات | 15.6% بدون أدوات | 64.4% بدون أدوات | 53.6% بدون أدوات |
هذه هي نتائج المقارنة المعيارية المنشورة، وهي منفصلة عن اختباراتنا GlobalGPT. تستخدم التقييمات بيئات وإعدادات جهد مختلفة؛ ولا تعبر تصنيفات Elo عن دقة بنسبة مئوية. تظهر قيم GPT-6 Sol في جدول المقارنة المنشور لـ Anthropic، ويشير الخط المائل إلى أن الصفحة لم تذكر قيمة لذلك التقييم. تشير Anthropic أيضًا إلى أن عمليات تشغيل GDPval-AA وAA-Briefcase عند الإطلاق استخدمت نشرًا ما قبل الإصدار الذي احتوى على خطأ في المخرجات المنظمة تم إصلاحه لاحقًا. تعامل مع الجدول على أنه صورة لتلك التقييمات، وليس ضمانًا بشأن حمل العمل الخاص بك.
تعتبر نتيجة FrontierCode مفيدة بشكل خاص: فقد حقق Sonnet أداءً أفضل في Xhigh مقارنةً بـ Max. ويعزو Anthropic انخفاض الأداء في Max إلى عمليات المراجعة الإضافية، وحالات انتهاء المهلة، والتغييرات التي جرت خارج النطاق المطلوب. فقد يؤدي التفكير الإضافي إلى مزيد من العمل دون أن يؤدي إلى إجابة أفضل. ابدأ بمهمة واضحة، وزد من الجهد عندما يكون لديك سبب محدد.
تُضفي النتائج المستقلة مزيدًا من السياق. فقد أفادت شركة «Artificial Analysis» أن مؤشر الذكاء بلغ 56 في إعداداتها القصوى/الافتراضية الاحتياطية، إلى جانب استخدام مكثف بشكل غير معتاد لرموز الإخراج. أ تقييم مسار المراجعة في CodeRabbit تم العثور على 6 حالات من أصل 13 حالة إشارة صعبة اكتشفها Sonnet 5.5، مقابل 4 حالات من أصل 13 اكتشفها Sonnet 5، مع متوسط وقت تشغيل أقل. هذه دراسة صغيرة أجراها أحد الموردين، ولا تُعد دليلاً على أن كل مراجعة للكود ستتحسن، لكنها مثال مفيد لتقييم مهمة كاملة بدلاً من مجرد النتيجة.
ما مدى سرعة طراز Claude Sonnet 5.5؟
تشير تقارير Anthropic إلى أن إنتاج النتائج أسرع بأكثر من 30% مقارنةً بـ Sonnet 5. ولا يُعد إنتاج النتائج سوى جزء واحد من عملية انتظار الإجابة؛ فمعالجة المدخلات، والاستدلال، ووقت الشبكة، وحمل الخدمة كلها عوامل مهمة أيضًا. فقد يبدأ النموذج في الكتابة بسرعة بمجرد انطلاقه، لكنه قد يستغرق وقتًا في العمل قبل وصول الإجابة النهائية.
استغرقت عمليات التكرار الثلاث التي أجريناها لنفس المطالبة المتعلقة برسالة البريد الإلكتروني الخاصة بالعميل وقتًا قدره 11.60 و12.16 و11.78 ثانية, ، بمتوسط قدره 11.78 ثانية. استغرقت مهمة الكود 19.08 ثانية، بينما استغرقت مهمة المستند 16.42 ثانية. قمنا بقياس وقت الاستجابة الكامل، بما في ذلك وقت الخدمة ووقت الشبكة. لم نقم بقياس زمن انتقال الرمز الأول (first-token latency) أو بإجراء اختبار تحكم Sonnet 5، لذا فإن هذه الأوقات لا تثبت تحسناً بمقدار 30%.
بالنسبة للاستخدام اليومي، فإن هذا يجعل هذا النموذج جديرًا بالتجربة في الأعمال التي يتم مراجعتها في دورات قصيرة. اطلب الناتج النهائي أولاً، وحافظ على نطاق العمل محدودًا، وتجنب طلب شرح مطول عندما يكون كل ما تحتاجه هو دالة مصححة أو رد قصير. وعندما تكون عناصر التحكم في الجهد ظاهرة، قم بتقييم الإعدادات الأقل استهلاكًا قبل اللجوء تلقائيًا إلى الإعداد «Max».
الأداء في الظروف العملية: ثلاثة اختبارات GlobalGPT
استخدمنا مهام عملية ذات إجابات يمكننا التحقق منها. استخدمت جميع الطلبات نموذج Claude Sonnet 5.5 مع نفس الحد الأقصى للإخراج البالغ 6,000 رمز، وبدون استخدام أي أدوات خارجية. تركنا إعدادات التحكم في أخذ العينات والاستدلال على الإعدادات الافتراضية للخدمة. احتفظنا بأول إخراج مكتمل لكل مهمة؛ أما عمليتا الكتابة الإضافيتان فهما عبارة عن فحص منفصل للتأكد من الاتساق. اكتملت جميع المكالمات الخمس دون الحاجة إلى إعادة المحاولة.
الكتابة: رد على العميل مع ضمان الالتزام بالوعود
طلبت التعليمات إرسال بريد إلكتروني إلى مايا يتراوح عدد كلماته بين 90 و120 كلمة بشأن تأخر وصول مصباح أزرق، مع ذكر ثلاث نقاط محددة بالضبط، وموعد نهائي للإرسال هو 4 أكتوبر، وخيار الرد بكلمة “استرداد” للحصول على استرداد كامل للمبلغ إلى طريقة الدفع الأصلية. كما حظرت التعليمات صراحةً ذكر أي سبب مختلق، أو ضمان الوصول، أو خصم، أو وعد باسترداد فوري للمبلغ.
تضمنت الإجابة الأولى 110 كلمات مع ثلاث نقاط بالضبط، وحافظت على موعد الإرسال وشروط استرداد المبلغ دون تغيير. ولم تذكر تاريخًا افتراضيًّا للتسليم، أو سببًا للتأخير، أو ميزة إضافية. ومع ذلك، أضافت عبارة “لا داعي للرد” للعملاء الذين يحتفظون بالطلب — وهي تفصيلة إجرائية لم ترد في الملخص. وهذا يجعلها مسودة مفيدة، لكنها لا تفي تمامًا بالمتطلبات الصارمة التي تقتصر على الحقائق فقط.
كان طول الردين المتكررين 101 و97 كلمة، وكانا يتوافقان أيضًا مع قواعد التنسيق، لكن كلاهما كرر نفس الافتراض القائل بعدم اتخاذ أي إجراء. أما الإجابة الثالثة، فقد استخدمت بالإضافة إلى ذلك نقطتين لتوضيح الخيار نفسه الذي يمكن تلخيصه بـ“الحفاظ على الترتيب والانتظار”. قبل إرسال رد موجه للعميل، تأكد من التفاصيل التشغيلية وقم بإزالة التكرار.
اختبار الكتابة: اجتياز التنسيق، افتراض وجود عملية واحدة
الإجابة الأولى: 110 كلمات، 3 نقاط، 11.60 ثانية. كانت شروط الشحن والاسترداد صحيحة. أما التعليمات المتعلقة بالاحتفاظ بالطلب دون الرد، فلم ترد في الملخص وتحتاج إلى تأكيد. الإجابات المتكررة: 101 و97 كلمة؛ وكلاهما كرر ذلك الافتراض.
Claude Sonnet 5.5 · GlobalGPT · 1 أكتوبر 2026 · سقف إنتاج يبلغ 6,000 توكن · بدون أدوات · يتم ترك إعدادات أخذ العينات والجهد على القيم الافتراضية للخدمة. يشير الوقت إلى الاستجابة الكاملة، وليس إلى التوكن الأول.
تعليمات المهمة
اكتب رسالة بريد إلكتروني باللغة الإنجليزية إلى مايا بشأن الطلب رقم R-418، وهو مصباح أزرق تأخر شحنه. يجب أن تتراوح عدد كلمات الرسالة الكاملة بين 90 و120 كلمة (بما في ذلك الرقمان)، وأن تحتوي على ثلاث نقاط بالضبط. أدرج اعتذارًا، واشرح الخطوة التالية بوضوح، واستخدم هذه الحقائق فقط: سيتم شحن المصباح بحلول 4 أكتوبر؛ أو يمكن لمايا الرد بكلمة “refund” لطلب استرداد كامل المبلغ إلى طريقة الدفع الأصلية. لا تعد بتاريخ تسليم أو وصول، أو استرداد فوري، أو خصم، أو تعويض، أو أي ميزة أخرى غير مقدمة. لا تختلق سببًا للتأخير. الموعد النهائي هو موعد الإرسال، وليس التسليم. أدرج تحية وخاتمة. أرسل البريد الإلكتروني فقط. في هذه المهمة، تُعتبر الكلمة رمزًا مفصولًا بمسافة بيضاء، باستثناء علامة النقطة المستقلة.
الناتج الأول الكامل
الموضوع: آخر المستجدات بشأن طلبك رقم R-418

مرحبًا يا مايا،

أعتذر عن التأخير في شحن المصباح الأزرق الخاص بك، الطلب رقم R-418. أدرك أن هذا الأمر مثير للإحباط، وأعتذر عن الإزعاج الذي تسبب فيه.

فيما يلي آخر المستجدات وما يمكنكِ فعله الآن:

- سيتم شحن المصباح الخاص بكِ بحلول 4 أكتوبر.
- إذا كنتِ ترغبين في الاحتفاظ بطلبكِ، فلا داعي للرد.
- إذا كنتِ تفضلين عدم الانتظار، فردي بكلمة "استرداد" على هذه الرسالة الإلكترونية، وسنقوم بإعادة المبلغ بالكامل إلى وسيلة الدفع الأصلية التي استخدمتيها.

شكرًا لكِ على صبركِ وتفهمكِ. يرجى الرد إذا كان لديكِ أي أسئلة بخصوص طلبكِ.

مع أطيب التحيات،
فريق خدمة العملاء
تكرار الكتابة 2 · الإخراج الكامل
عزيزتي مايا،

أعتذر عن تأخر شحن طلبك رقم R-418، وهو المصباح الأزرق. أدرك أن هذا الأمر مثير للإحباط، وأعتذر عن الإزعاج الذي تسبب فيه.

وفيما يلي الخطوات التالية:

- سيتم شحن المصباح الأزرق الخاص بك بحلول 4 أكتوبر.
- إذا كنت ترغبين في الانتظار، فلا داعي لاتخاذ أي إجراء.
- إذا كنتِ تفضلين عدم الانتظار، فردّي بكلمة "refund" على هذه الرسالة الإلكترونية لطلب استرداد كامل المبلغ إلى طريقة الدفع الأصلية التي استخدمتيها.

يرجى ملاحظة أن 4 أكتوبر هو الموعد النهائي للشحن، وليس تاريخ التسليم.

شكرًا لكِ على صبركِ وتفهمكِ.

مع أطيب التحيات،
فريق خدمة العملاء
تكرار الكتابة 3 · الإخراج الكامل
الموضوع: آخر المستجدات بشأن طلبك رقم R-418

مرحبًا مايا،

نأسف لتأخر شحن المصباح الأزرق الخاص بك، الطلب رقم R-418. أعتذر عن الإزعاج وأقدر صبرك.

فيما يلي الخيارات المتاحة لك:

- انتظار الشحن: سيتم شحن المصباح بحلول 4 أكتوبر.
- طلب استرداد المبلغ: أجيبي بكلمة "refund" وسنقوم برد المبلغ بالكامل إلى وسيلة الدفع الأصلية التي استخدمتها.
- الاحتفاظ بالطلب: إذا كنتِ لا تمانعين في الانتظار، فلا داعي لاتخاذ أي إجراء آخر.

يرجى ملاحظة أن 4 أكتوبر هو الموعد النهائي للشحن، وليس تاريخ التسليم.

مع أطيب التحيات،
فريق خدمة العملاء
سيتم شحن المصباح الخاص بك بحلول 4 أكتوبر. … إذا كنت تفضل عدم الانتظار، فرد على هذه الرسالة الإلكترونية بكلمة “استرداد”، وسنقوم بإعادة المبلغ بالكامل إلى وسيلة الدفع الأصلية التي استخدمتها.
مقتطف من الاختبار الأول للكتابة GlobalGPT؛ تم حذف إحدى النقاط الواردة بين السطور.
هذا نمط مفيد للتواصل مع العملاء والكتابة التجارية: تقديم الحقائق المعتمدة، وتحديد النبرة، وبيان الوعود التي يجب ألا ترد. ومن ثم، يمكن لـ«سونيت» المساعدة في صياغة النص دون أن يُطلب منها ابتكار سياستك.
البرمجة: إصلاح منطق التقريب، ثم التحقق من صحة المجاميع
كانت دالة بايثون المعيبة لدينا تقسم المبلغ باستخدام أرقام عائمة وتقوم بتقريب كل حصة على حدة. وقد يؤدي ذلك إلى إضافة أو فقدان سنتات. وقد طلبنا من سونيت استبدالها بطريقة توزيع «أكبر باقي» القائمة على النظام العشري، مع الحفاظ على المجموع، وحسم حالات التعادل وفقًا للمؤشر الأصلي، ورفض المدخلات غير الصالحة.
تم تمرير الدالة الأولى المُرجعة 43 فحصًا من أصل 43, ، بما في ذلك القيم الصفرية، والأوزان الكسرية، وحالات التعادل الحتمية، والمدخلات غير الصحيحة، والقيم الكبيرة، وحدود الدقة. فقد قام البرنامج بتحليل السلاسل العشرية، وتحويلها إلى كميات صحيحة دقيقة، وتوزيع السنتات المتبقية بترتيب ثابت. ولم تقتصر النتيجة المفيدة على مجرد كود يبدو معقولاً فحسب: بل إن حصص المجموعات كانت متوافقة فعليًّا.
وهذا يدعم استخدام Sonnet في عملية تنفيذ مركزة ذات معايير قبول واضحة. كان هذا اختبارًا وظيفيًّا مستقلاً، وليس عملية إصلاح مستودع ذاتية أو تدقيقًا أمنيًّا. بالنسبة لرمز الإنتاج، أضف اختبارات التكامل الخاصة بك وراجع كيفية معالجة الأخطاء في التطبيق المحيط.
اختبار البرمجة: اجتياز 43 اختبارًا
الإجابة الأولى: 19.08 ثانية. اجتازت جميع الاختبارات الـ43 المتعلقة بالتخصيص الصحيح، والروابط المستقرة، والتحقق من صحة المدخلات، والدقة. تم تقييمها كدالة قائمة بذاتها، وليس كعملية إصلاح مستقلة للمستودع.
Claude Sonnet 5.5 · GlobalGPT · 1 أكتوبر 2026 · سقف إنتاج يبلغ 6,000 توكن · بدون أدوات · يتم ترك إعدادات أخذ العينات والجهد على القيم الافتراضية للخدمة. يشير الوقت إلى الاستجابة الكاملة، وليس إلى التوكن الأول.
تعليمات المهمة
استبدل دالة بايثون الخاطئة أدناه بتنفيذ صحيح للدالة allocate_cents(total: str, weights: list[str]) -> list[int]. لا تقم بإرجاع سوى كود مصدر بايثون قابل للتنفيذ، دون استخدام علامات Markdown أو أي توضيحات.

المتطلبات:
1. total هو مبلغ محدود غير سالب بالدولار الأمريكي (USD) مكتوب كسلسلة نصية، مع صفر أو رقم أو رقمين من الأرقام العشرية، مثل "0" أو "12.3" أو "12.34". يجب استخدام أرقام عشرية ASCII مع نقطة عشرية واحدة اختيارية. يرجى رفض الإشارات، والترميز الأسي، والمسافات البيضاء، وNaN/Infinity، والسلسلة الفارغة، والنقطة العشرية الختامية، والنقطة العشرية الافتتاحية، وأكثر من رقمين كسريين، بما في ذلك "1.000". يُسمح بالأصفار الافتتاحية. يرجى رفض المدخلات غير السلسلية باستخدام ValueError.
2. weights هي قائمة غير فارغة من السلاسل. تستخدم كل سلسلة أرقامًا عشرية ASCII، مع نقطة عشرية اختيارية ورقم واحد أو أكثر بعدها. اشترط قيمًا محدودة غير سالبة مع وجود وزن واحد على الأقل موجب تمامًا. رفض السلاسل غير الصالحة، أو الإشارات، أو الترميز الأسي، أو المسافات البيضاء، أو المدخلات غير السلسلية، أو مدخلات weights غير القائمة باستخدام ValueError. يُسمح بالأصفار البادئة.
3. استخدم Decimal لتحليل المحفوظات العشرية المقدمة والحفاظ عليها بدقة. تحويل الدولارات إلى سنتات صحيحة. توزيع السنتات الصحيحة بالتناسب مع الأوزان، باستخدام طريقة «الباقي الأكبر»: أخذ الجزء الكامل من كل حصة، ثم تخصيص السنتات المتبقية لأكبر الباقيات الكسرية. كسر التعادل باستخدام الفهرس الأصلي الأقل. يجب أن تحافظ القائمة المرجعة على ترتيب الإدخال وأن يساوي مجموعها بالضبط إجمالي السنتات.
4. لا تفقد الدقة بصمت في حالة القيم الصحيحة الطويلة أو الأوزان غير المتكافئة جدًّا. لا تقم بتغيير الأوزان. استورد فقط من «decimal» أو «math» إذا كانت الاستيرادات ضرورية. لا تُجرِ أي عمليات تتعلق بالملفات أو الشبكة أو البيئة أو العمليات أو الإدخال/الإخراج.

تنفيذ خاطئ:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
الناتج الأول الكامل
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 if not isinstance(s, str) or not s:
 return False
 parts = s.split(".")
 if len(parts) > 2:
            return False
 if not parts[0] or not all(c in DIGITS for c in parts[0]):
 return False
 if len(parts) == 2:
 frac = parts[1]
 if not frac or not all(c in DIGITS for c in frac):
                return False
 if max_frac is not None and len(frac) > max_frac:
 return False
 return True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # تُرجع (المنطوق الصحيح، الأس) حيث value = المنطوق * 10**الأس
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("invalid total")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("invalid weights")
    for w in weights:
 if not valid(w, None):
 raise ValueError("وزن غير صالح")

 mant, exp = to_scaled(total)
    if exp >= -2:
 cents = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # غير قابل للوصول بالنسبة للمدخلات التي تم التحقق من صحتها

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    إذا كان W <= 0:
        raise ValueError("يجب أن يكون هناك وزن واحد على الأقل موجبًا")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
المستندات: العثور على السجلات الصحيحة بعد إجراء التصحيحات وإزالة التكرارات
تضمنت المهمة الثالثة حزمة فواتير مركبة مكونة من 13,078 كلمة: 120 سجلاً أساسياً، وثمانية تصحيحات، وأربع نسخ أرشيفية. وكان على برنامج «سونيت» أن يختار فقط فواتير «أطلس» المعتمدة والمؤرخة في سبتمبر 2026، وأن يستخدم أحدث إصدار من كل سجل، وأن يُرجع بيانات JSON دقيقة تتضمن المجموع وثلاثة فحوصات متابعة منطقية.
وقد اختارت كل شيء 16 رقم فاتورة صحيحًا, ، وأعاد النتيجة الدقيقة $15,305.66 إجمالاً، وحافظت على بنية JSON. وشملت الإجراءات اللاحقة مطابقة دفاتر الحسابات، والمستندات الداعمة للتصحيحات، وفحوصات التكرار أو التقطيع. ولم تعتبر النسخة القديمة الموجودة في الأرشيف بمثابة فاتورة جديدة.
هذا هو النوع من التفاصيل التي تهم في معالجة المستندات: يجب أن يسود التصحيح الأحدث، حتى عندما تظهر نسخة أقدم لاحقًا في المجموعة. والنتيجة واعدة بالنسبة لاستخراج المستندات المحدودة النطاق. ولا يزال الأمر مجرد تمرين اصطناعي، أصغر بكثير من نافذة السياق المعلن عنها التي تضم مليون رمز؛ فالأعمال المالية المهمة تتطلب إجراء حساب مستقل.
اختبار المستند: 16 سجلًا، المجموع الدقيق
الإجابة الأولى: 16.42 ثانية. تطابقت جميع أرقام الفواتير الـ 16 والمبلغ الإجمالي $15,305.66 مع المرجع المستقل؛ كما كانت صيغة JSON الدقيقة والمتابعات الثلاث صحيحة أيضًا.
Claude Sonnet 5.5 · GlobalGPT · 1 أكتوبر 2026 · سقف إنتاج يبلغ 6,000 توكن · بدون أدوات · يتم ترك إعدادات أخذ العينات والجهد على القيم الافتراضية للخدمة. يشير الوقت إلى الاستجابة الكاملة، وليس إلى التوكن الأول.
تضمنت الحزمة الاصطناعية المُرفقة 120 سجلًا أساسيًّا، وثمانية تصحيحات، وأربع نسخ أرشيفية (13,078 كلمة). وتضمنت الحقول: المعرّف، والإصدار، والمشروع، والتاريخ، والحالة، والمبلغ، والملاحظات الوصفية. التعليمات الواردة أدناه كاملة؛ وقد تم تلخيص الحزمة المصدرية الطويلة هنا.
تعليمات المهمة
قم بمراجعة سجلات فواتير المشاريع الاصطناعية الواردة أدناه. بالنسبة لكل معرّف، استخدم الإصدار الأعلى فقط؛ فالسجلات المكررة المتطابقة لا تؤدي إلى إنشاء فواتير إضافية. وقد يظهر الإصدار الأعلى قبل نسخة أرشيفية أقدم. حدد فقط السجلات التي يكون مشروعها النهائي هو "Atlas"، وحالتها النهائية "مُعتمدة"، وتاريخها النهائي في شهر سبتمبر 2026. المبالغ بالدولار الأمريكي. أعد صيغة JSON صارمة تحتوي على هذه المفاتيح بالضبط: "ids" (أرقام تعريف فريدة مختارة مرتبة تصاعديًا)، و"total_usd" (سلسلة تحتوي على رقمين عشريين بالضبط)، و"action_items" (ثلاث سلاسل موجزة بالضبط تحدد عمليات التدقيق المحاسبية التالية المنطقية). لا تضف علامات Markdown أو نصوصًا توضيحية. تجاهل الملاحظات السردية عند التصفية؛ فجميع الحقول المحاسبية منظمة. لا تحسب السجلات من الأشهر الأخرى، أو مسودات السجلات، أو سجلات Orion، أو الإصدارات القديمة، أو النسخ المكررة.
الناتج الأول الكامل
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056","INV-062","INV-068","INV-074","INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15305.66","action_items":["مطابقة الفواتير الـ 16 المختارة والمبلغ الإجمالي البالغ 15,305.66 دولار أمريكي مع دفتر الأستاذ العام ودفتر الأستاذ الفرعي للحسابات الدائنة في نظام Atlas لشهر سبتمبر 2026.",""مراجعة السجلات التي تم تغييرها نتيجة للتصحيحات (INV-003، INV-008، INV-020، INV-050، بالإضافة إلى الفواتير المستبعدة INV-002، INV-014 وINV-026) للتأكد من وجود أدلة الموافقة والوثائق الداعمة.","تأكد من عدم ترحيل النسخ المكررة من الأرشيف كفواتير منفصلة، وتحقق من وجود مشكلات تتعلق بالاستحقاق أو تاريخ القطع في الفواتير المصححة التي يقع تاريخها قرب نهاية الشهر."]}Sonnet 5.5 مقابل Opus 5.5: أيهما يجب أن تستخدم؟
اختر بناءً على طبيعة المهمة. يُعد «Sonnet» خيارًا أولًا مناسبًا عندما تكون التعليمات والهدف النهائي واضحين. أما «Opus» فهو نقطة انطلاق أقوى عندما تتطلب المهمة اتخاذ قرارات مستمرة، أو اكتشاف الافتراضات المفقودة، أو تنسيق سلسلة طويلة من القرارات. اقرأ مقالتنا مراجعة Claude Opus 5.5 لإلقاء نظرة عن قرب على هذا النموذج.
Sonnet 5.5 مقابل Opus 5.5: أيهما يجب أن تستخدم؟
| مهمتك | نقطة انطلاق موصى بها | لماذا |
|---|---|---|
| إعادة صياغة موجز، وكتابة مسودة نص موجه للعملاء، واستخراج السجلات | Sonnet 5.5 | تسهّل القيود الواضحة عملية التحقق من الجودة. |
| إصلاح خطأ محدد النطاق أو تنفيذ دالة محددة | Sonnet 5.5 | أداء قوي في تنفيذ المهام بمعدل رموز إدخال/إخراج أقل. |
| تحديد التصميم المعماري في ظل متطلبات غير مكتملة | الأوبوس 5.5 | الصعوبة تكمن في اتخاذ القرارات المستمرة، وليس في التنفيذ فحسب. |
| إنهاء حملة باستخدام النصوص والصور ومقاطع الفيديو | سير العمل متعدد النماذج GlobalGPT | استخدم «سونيت» لوضع النماذج الموجزة والمتخصصة للأصول. |
من أساليب العمل المفيدة أن تطلب من نموذج استدلال أقوى تقييم خطة صعبة، ثم تزود «سونيت» بالمواصفات المتفق عليها وعمليات الفحص المحددة. ويمكن تغيير النموذج المستخدم بين المراحل المختلفة. فليس عليك أن تحول كل تعديل بسيط إلى مهمة استدلال مكلفة للغاية.
استخدم Sonnet 5.5 في العمل على GlobalGPT
يجعل نموذج GlobalGPT هذا النموذج مفيدًا كجزء من بيئة عمل أوسع نطاقًا. افتح Claude Sonnet 5.5 لخطوة الكتابة أو التحليل، ثم انتقل إلى نموذج آخر عندما يحتاج المشروع إلى ميزة مختلفة. يمكنك إعداد موجز الحملة، وصقل النصوص، وإنشاء العناصر المرئية، وإنتاج مقاطع الفيديو دون الحاجة إلى إعادة بناء سير العمل عبر عدة اشتراكات.
للحصول على نتيجة أولية أفضل، أرسل المادة المصدرية مع مجموعة صغيرة من قواعد القبول. بالنسبة للنصوص، حدد الجمهور المستهدف، والطول، والنبرة، والحقائق التي يجب أن تظل دون تغيير. بالنسبة للكود البرمجي، قدم المثال الذي يحدث فيه الخطأ والسلوك المتوقع. بالنسبة للوثائق، حدد الأقسام المصدرية ووضح كيفية التعامل مع الإصدارات المتعارضة. هذه أفكار للكتابة والبحث والبرمجة تزودك بنقاط انطلاق قابلة لإعادة الاستخدام.
يمكن للمطورين أيضًا ربط سير عمل أجهزتهم الطرفية من خلال واجهة سطر الأوامر GlobalGPT مع رمز Claude. استخدم الموقع الإلكتروني الخاص بالمشروع الأوسع نطاقًا وواجهة سطر الأوامر (CLI) حيثما يتناسب ذلك مع عملية التطوير. وتكمن القيمة في وجود مجموعة مترابطة من الأدوات، حيث يتم اختيار النموذج وفقًا للمهمة التالية.
القيود وتفاصيل الترقية التي يجدر معرفتها
بذل جهد كبير هو خيار، وليس ضمانًا للجودة. قد يفرط «سونيت» في معالجة مشكلة محدودة النطاق أو يتجاوز التغييرات المطلوبة. اطلب منه الحفاظ على نطاق العمل، وإجراء الفحوصات ذات الصلة، والتوقف عند استيفاء معايير القبول. وإذا كان المنتج يوفر أدوات للتحكم في الجهد، فقارن بين جودة المهام المنجزة وتكلفتها قبل زيادة حجمها.
الحقائق الحالية لا تزال تحتاج إلى مصادر حديثة. لا تشمل آخر تحديثات النموذج في يونيو 2026 معلومات حديثة عن كل سعر أو سياسة أو إصدار. يرجى توفير الوثيقة الحالية أو استخدام سير عمل مزود بأدوات بحث. بالنسبة للمواد الحساسة، يرجى التحقق من شروط الخصوصية والاحتفاظ الخاصة بالخدمة والحساب الذي تستخدمه فعليًّا؛ فاسم النموذج لا يحدد هذه الإعدادات.
تتطلب عمليات ترحيل واجهة برمجة التطبيقات (API) أكثر من مجرد استبدال اسم النموذج. يُحدث الإصدار Sonnet 5.5 تغييرات في بعض أنماط الطلبات القديمة. ترفض واجهة برمجة التطبيقات (API) المباشرة Claude إعدادات درجة الحرارة وtop_p وtop_k غير الافتراضية، وقد يتطلب الأمر تحديث طرق التفكير القديمة أو تكوينات الأدوات المفروضة. يُعد التفكير التكيفي هو الإعداد الافتراضي؛ حيث يزيل وضع between_tools الموثق التفكير المسبق عند مستوى الجهد «High» أو أقل. كما توضح النظرة العامة الحالية أن الاستخدام القسري للأدوات يُرجع خطأً، وأن أدوات استخدام الكمبيوتر القديمة غير مقبولة في واجهة برمجة التطبيقات Claude وGoogle Cloud، وأن النص الموجود بين استدعاءات الأدوات قد يصل في كتل تفكير. راجع الدليل الرسمي للهجرة قبل نقل أحد التطبيقات. لدينا دليل واجهة برمجة التطبيقات (API) لـ Claude يتناول المفاهيم العامة المتعلقة بالإعداد والفوترة.
كما يطبق نموذج Anthropic إجراءات وقائية على الطلبات ذات المخاطر العالية في مجالي الأمن السيبراني وعلم الأحياء. ويظل تطوير البرمجيات الروتيني جزءًا من الاستخدام المقصود للنموذج. إذا كانت المهمة مشروعة ولكنها حساسة، فيجب وصف نطاقها والأذونات المطلوبة بوضوح، بدلاً من افتراض أن كل رفض يمثل قيدًا عامًا على البرمجة.
الحكم النهائي: نموذج جيد يمكن إدراجه في سير عملك اليومي
يستحق Sonnet 5.5 مكانته بفضل أدائه العملي القابل للتحقق. وتتمثل أقوى الأسباب لاستخدامه في قدرته على البرمجة ذات النطاق المحدد ومعالجة المستندات بشكل مفيد، وذلك بتكلفة أقل لكل رمز API مقارنةً بـ Opus. كما يُعد الكتابة من الاستخدامات الجيدة أيضًا، مع إجراء فحص نهائي للتأكد من صحة التفاصيل التي لم ترد أبدًا في موجز المهمة. تدعم مجموعة الاختبارات الصغيرة التي أجريناها هذا التوجه نحو العمل اليومي؛ فهي لا تثبت تفوقًا شاملاً في السرعة أو التكلفة أو الاستدلال المعقد.
ابدأ بمهمة حقيقية يمكنك تقييم نتائجها. اجعل القيود واضحة، وتحقق من التفاصيل المهمة، وانتقل إلى نموذج آخر عندما تتغير المشكلة. جرب Sonnet 5.5 على GlobalGPT لدمج الكتابة والبرمجة والتحليل والخطوة الإبداعية التالية في مسار عمل واحد متعدد النماذج.
الأسئلة الشائعة
ما هو Claude Sonnet 5.5؟
Claude Sonnet 5.5 هو نموذج من طراز Anthropic تم إصداره في 28 سبتمبر 2026. وهو يدعم إدخال النصوص والصور مع إخراج النصوص، وقد صُمم لتسريع عمليات البرمجة والكتابة والعمل على المستندات اليومية، بالإضافة إلى سير العمل المدعوم بالأدوات.
كم يبلغ سعر طراز Claude Sonnet 5.5؟
يبلغ السعر القياسي لواجهة برمجة التطبيقات (API) لـ Anthropic $2 لكل مليون توكن مدخل و$10 لكل مليون توكن مخرج. تبلغ تكلفة عمليات قراءة ذاكرة التخزين المؤقت $0.10 لكل مليون توكن. وتُعتبر اشتراكات التطبيقات بقيمة Claude والخطط بقيمة GlobalGPT منفصلة عن أسعار واجهة برمجة التطبيقات هذه.
هل Claude Sonnet 5.5 أسرع من Sonnet 5؟
يُظهر طراز Anthropic سرعة في إنتاج المخرجات تفوق طراز Sonnet 5 بأكثر من 30%. وفي اختبار الكتابة الذي أجريناه على طراز GlobalGPT، استغرقت ثلاث استجابات كاملة ما بين 11.60 و12.16 ثانية. لم نقم بتشغيل جهاز Sonnet 5 كجهاز مرجعي، لذا فإن اختبارنا لا يقيس تحسن السرعة بين الأجيال.
هل يُعد الإصدار Sonnet 5.5 أفضل من الإصدار Opus 5.5؟
اختر Sonnet 5.5 للمهام المحددة بوضوح وللحصول على سعر أقل للرموز في المدخلات والمخرجات. يُعد Opus 5.5 نقطة انطلاق أقوى للأعمال المعقدة والمفتوحة التي تتطلب تقديرًا مستمرًا. يتصدر Sonnet بعض التقييمات المنشورة، لكن لا يوجد فائز واحد يجمع عليه الجميع.
هل يستطيع برنامج Claude Sonnet 5.5 معالجة المستندات الطويلة؟
تحدد واجهة برمجة التطبيقات (API) Claude نافذة سياق تضم مليون رمز. وفي اختبارنا الذي أُجري على مستند اصطناعي أصغر حجمًا يتألف من 13,078 كلمة، اختار برنامج «سونيت» جميع السجلات المؤهلة البالغ عددها 16 سجلًا وحسب الإجمالي الصحيح. ولا يُثبت هذا النتيجة الدقة عبر نافذة السياق الكاملة المعلن عنها.
هل يمكنني استخدام Claude Sonnet 5.5 مع GlobalGPT؟
نعم. يوفر GlobalGPT نموذج Claude Sonnet 5.5 إلى جانب نماذج ذكاء اصطناعي أخرى، مما يتيح لك صياغة النصوص وكتابة الأكواد وتحليل المستندات، ثم الانتقال إلى العمل على الصور أو مقاطع الفيديو، كل ذلك ضمن منصة واحدة.
المصادر وملاحظات الاختبار
تم التحقق من مواصفات الإطلاق والأسعار في 13 أكتوبر 2026؛ وأُجريت الاختبارات العملية الواردة أدناه في 1 أكتوبر 2026. المصادر الرئيسية: إعلان إطلاق Anthropic, مرجع طراز Sonnet 5.5, تسعير واجهة برمجة التطبيقات (API), و تسعير اشتراك كلود. ويستمد السياق المستقل من «التحليل الاصطناعي» ودراسة «كود رابيت» المشار إليها في الرابط أعلاه.
استخدمت اختبارات GlobalGPT الإجابة الأولى المكتملة في ثلاث مهام، بالإضافة إلى تكرارين للكتابة. لم يتم تمكين أي أدوات خارجية. تشمل أوقات الاختبار الإجابات الكاملة، بما في ذلك الوقت المستغرق في الشبكة والخدمات؛ ولم يتم تحديد أي قيمة لجهود الاستدلال. كانت حزمة الفواتير اصطناعية ولم تحتوي على أي بيانات للعملاء. تم إنشاء الرسم التوضيحي للرأس خصيصًا لهذه المراجعة؛ أما الصور الأخرى فهي لقطات شاشة للمواقع الإلكترونية المذكورة.









