مقارنة بين طرازات Claude: Haiku مقابل Sonnet مقابل Opus، ومكانة Fable بينها
أرييت وين
آخر تحديث: 9 سبتمبر 2026
دليل عملي لعام 2026 لاختيار الحلول بناءً على السرعة، وتكلفة واجهة برمجة التطبيقات (API)، والسياق، ومدى تعقيد المهمة، وتكلفة الإجابة الخاطئة.
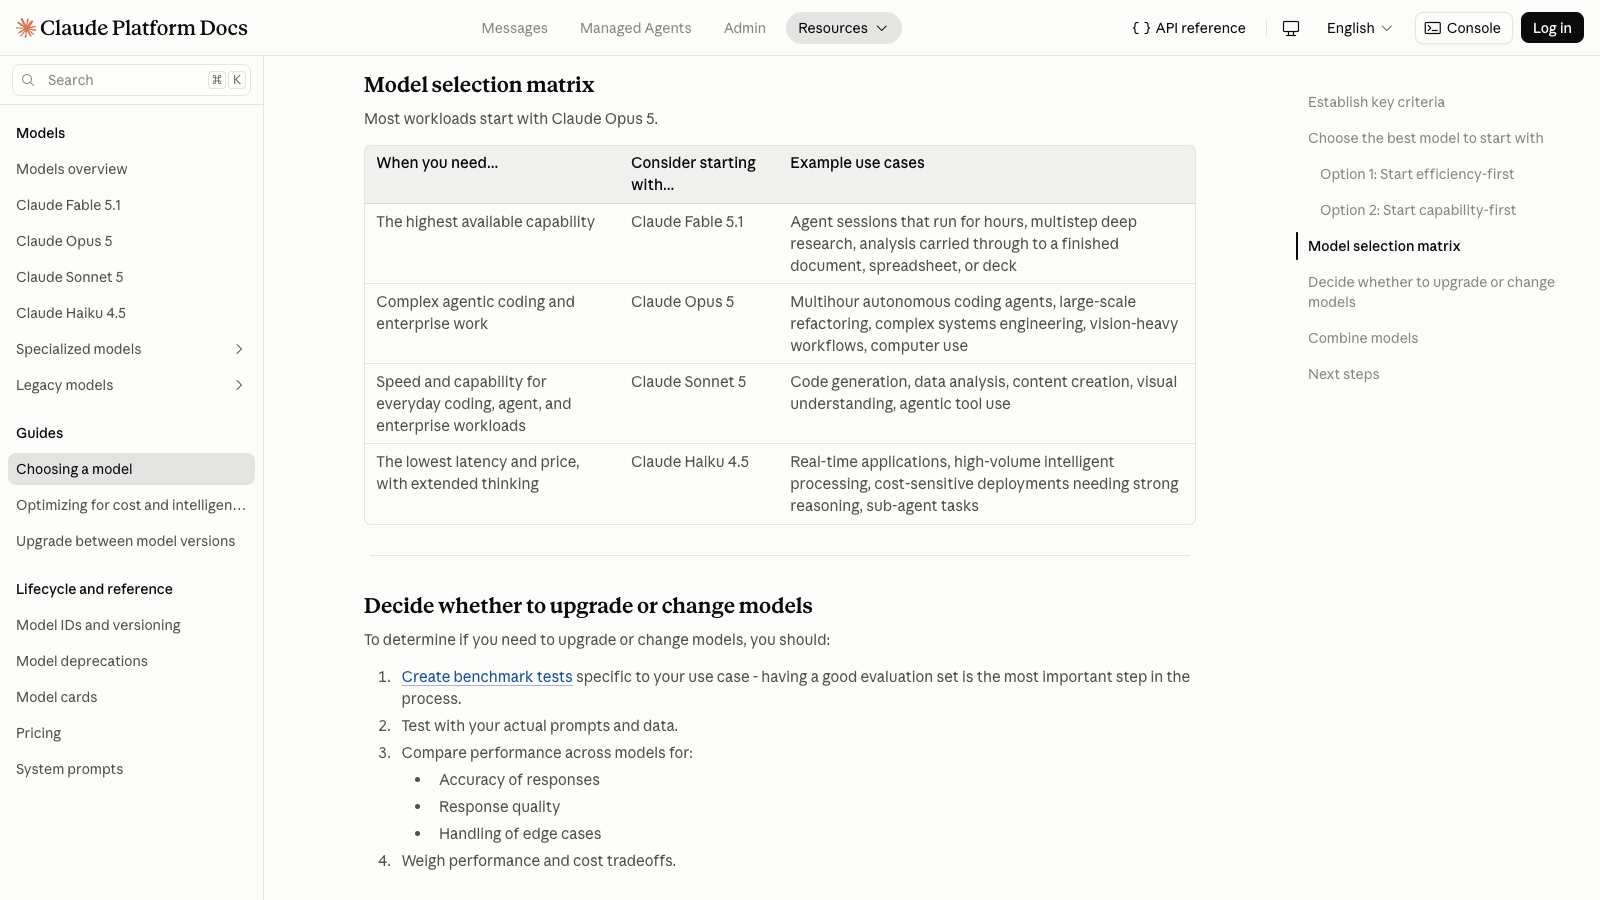
بالنسبة لمعظم الأعمال اليومية المتعلقة بالكتابة والتحليل والبرمجة واستخدام الأدوات، ابدأ باستخدام Claude Sonnet 5. اختر Haiku 4.5 عندما تكون زمن الاستجابة المنخفض والحجم الكبير أكثر أهمية من التعامل مع الحالات الاستثنائية الصعبة. اختر Opus 5 عندما تكون المهمة معقدة أو يصعب التحقق منها أو تكون عواقب الخطأ فيها باهظة. ويأتي Fable 5.1 فوق Opus كمسار تصعيد متخصص، وليس كخيار افتراضي.
تنطبق هذه التوصيات على أحمال العمل المختلطة العامة. تشير إرشادات الإنتاج الخاصة بـ Anthropic إلى أن معظم أحمال العمل ينبغي أن تبدأ باستخدام Opus 5، في حين تُخصص مصفوفة المهام الخاصة بها بشكل منفصل نموذج Sonnet لأعمال السرعة والقدرة اليومية. ولذلك، فإن نقطة البداية المناسبة تعتمد على مدى تحملك للمخاطر وعملية التقييم التي تتبعها، وليس فقط على اسم النموذج.
GlobalGPT يوسع نطاق سير العمل يمكنك الاستفادة من كل ذلك من خلال اشتراك واحد بأسعار معقولة: حيث تتشارك Claude وGPT-5.6 Sol وGemini 3 Pro وKimi K3 والعديد من وظائف الذكاء الاصطناعي لوحة تحكم واحدة للبحث والكتابة والتحليل والبرمجة والتحسين. كما يمكن لواجهة سطر الأوامر (CLI) الخاصة بها توفير إمكانية الوصول إلى تلك النماذج في محطة العمل الخاصة بك، وسير عمل التطوير، وأدوات الإنتاج الحالية. تُعد مقارنة النتائج أحد الجوانب المفيدة في سير العمل؛ وللاطلاع على خيارات أوسع نطاقًا على مستوى العائلة، راجع مقارنة بين ChatGPT وClaude وGemini. ويركز الجزء المتبقي من هذا الدليل على الاختيار ضمن نطاق Claude.
تعالج المستويات الأربعة الحالية مشاكل اقتصادية مختلفة. فالمكالمة الأرخص ليست دائمًا المهمة المنجزة الأقل تكلفة، كما أن النموذج الأقوى لا يعني تلقائيًا الاستخدام الأمثل للميزانية.
دليل اتخاذ القرار الخاص بطراز Claude
اختر وفقًا لحجم العمل وتكلفة الفشل
استخدم «سونيت» في الأعمال اليومية التي تتطلب التوازن، وانتقل إلى مستوى أدنى لتحقيق الكفاءة، وانتقل إلى مستوى أعلى عندما تكون عملية التحقق صعبة أو تكون تكلفة الأخطاء باهظة.
هايكو 4.5
الكفاءة أولاً
ابدأ من هنا للمهام ذات الحجم الكبير، والحساسة تجاه زمن الاستجابة، والمحددة بوضوح، والتي لا يتكلف اكتشاف أخطائها وتصحيحها سوى القليل.
تقدم إلى الأمام عندماالحالات الاستثنائية أو الوقت الذي يستغرقه المراجع في إجراء التصحيحات يقضيان على ميزة سعر التوكن.
السوناتة الخامسة
التوازن اليومي
يُستخدم في الأعمال التي تجمع بين الكتابة والتحليل والبرمجة والفهم البصري واستخدام الأدوات، والتي لا تزال تخضع للمراجعة المعتادة.
تقدم إلى الأمام عندمايصبح التفكير على المدى الطويل، أو عملية التحقق، أو تكلفة الفشل هو العامل المحدد.
العمل رقم 5
القدرة أولاً
ابدأ من هنا في حالات البرمجة المعقدة التي تتطلب تدخلًا نشطًا، أو الأعمال المؤسسية، أو التشخيصات الصعبة، أو القرارات التي قد تترتب على الخطأ فيها تكاليف باهظة.
لا تلجأ إلى التصعيد إلا في حالات الحاجة إلى استدلال معقد أو مهام الوكيل التي تستغرق وقتًا طويلاً، عندما يفشل Opus — الذي يتطلب جهدًا أكبر — في تلبية معايير تقييمك.
لا تفترضتكون الفئة الأعلى أرخص تلقائيًا بعد احتساب الجودة ووقت المراجعة ومحاولات إعادة التنفيذ.
القاعدة العملية
قم بتثبيت مهمة تمثيلية واحدة وفحوصات قبولها. اختر النموذج الأقل تكلفة الذي يجتاز الاختبارات بشكل موثوق، ثم احسب الوقت اللازم للتصحيح والتحقق قبل اعتباره الخيار الأرخص.
مجموعة طرازات Claude الحالية
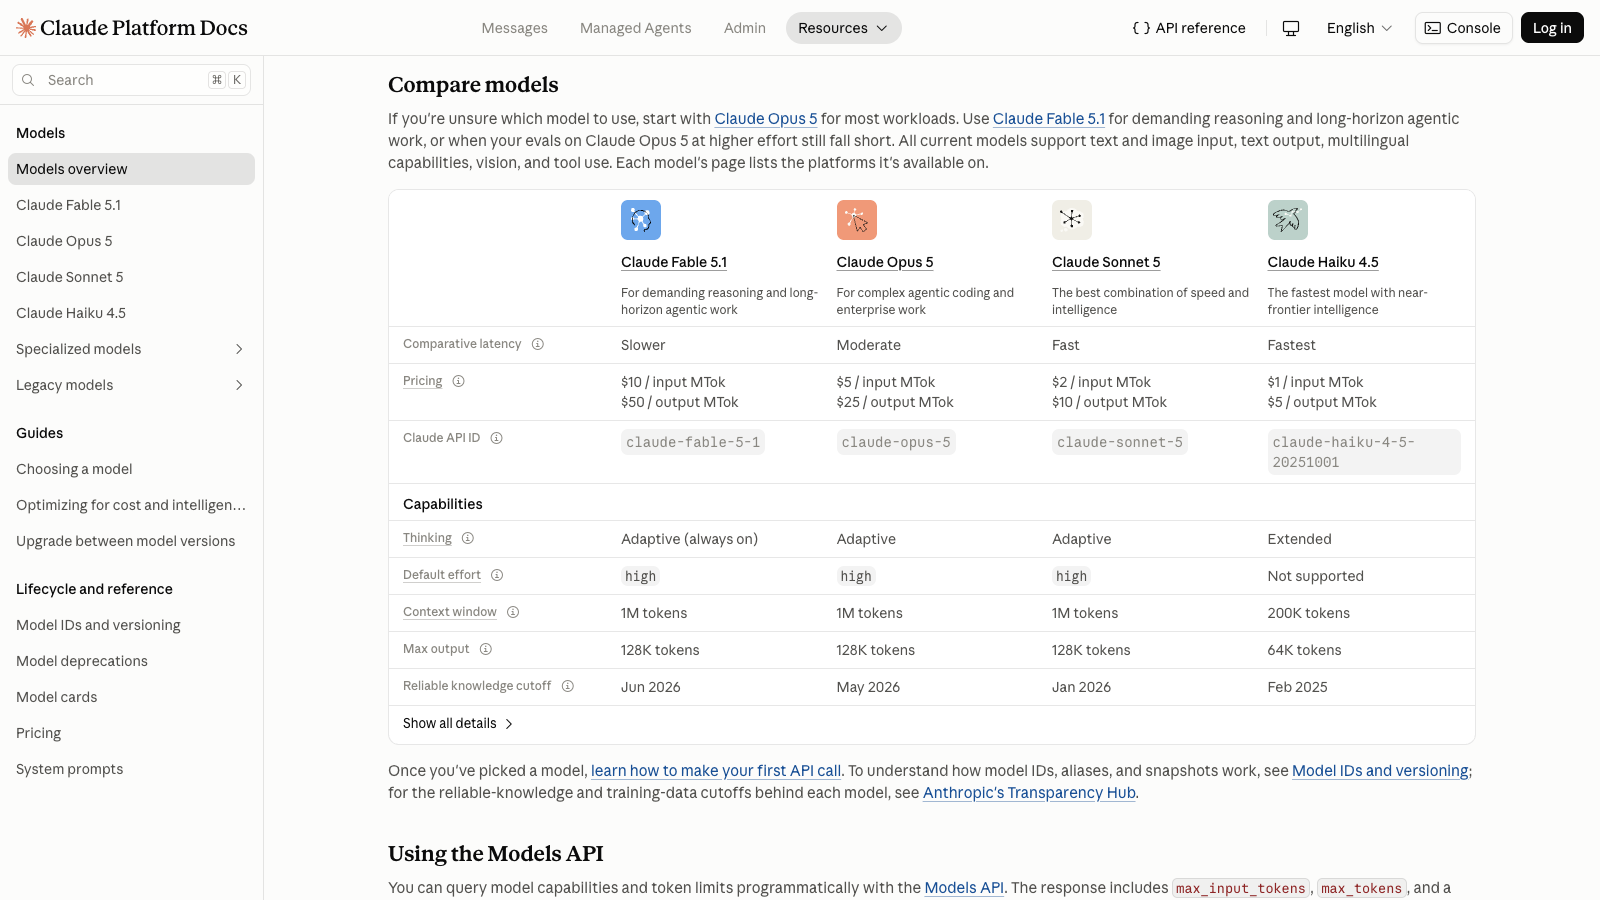
اعتبارًا من 8 سبتمبر 2026، تشمل المجموعة النشطة من Anthropic الطرازات التالية: Claude Haiku 4.5، وClaude Sonnet 5، وClaude Opus 5، وClaude Fable 5.1. تُعد Haiku وSonnet وOpus أسماءً ثابتةً للعائلات، لكن الإصدار المرتبط بكل عائلة يتغير بمرور الوقت. قم بتثبيت معرّف الطراز الدقيق الذي قمت بتقييمه في مرحلة الإنتاج بدلاً من افتراض أن تسمية العائلة ستشير دائمًا إلى نفس اللقطة.
الطراز الحالي
ملصق السرعة الرسمي
سياق واجهة برمجة التطبيقات (API)
القدرة القصوى
المدخلات/المخرجات الأساسية لواجهة برمجة التطبيقات (API)
هايكو 4.5
أسرع
200 ألف
64 كيلوبايت
$1 / $5 لكل MTok
السوناتة الخامسة
سريع
1M
128 كيلوبايت
$2 / $10 لكل MTok
العمل رقم 5
معتدل
1M
128 كيلوبايت
$5 / $25 لكل MTok
Fable 5.1
أبطأ
1M
128 كيلوبايت
$10 / $50 لكل MTok
تُدرج قائمة النماذج العامة لـ Anthropic كلًا من Haiku 4.5 وSonnet 5 وOpus 5 وFable 5.1 باعتبارها التشكيلة الحالية في 8 سبتمبر 2026.
الوصول إلى Claude.ai يختلف عن مواصفات واجهة برمجة التطبيقات (API)
يصف جدول خطط Claude.ai وصول المستهلكين، ويُدرج حاليًا نافذة سياق بحجم 200 ألف للخطط الفردية. وتُدرج وثائق واجهة برمجة التطبيقات (API) حدود السياق والمخرجات الخاصة بكل نموذج، بما في ذلك نافذة سياق بحجم 1 مليون لـ Sonnet 5 و Opus 5 و Fable 5.1. لا تستخدم جدول واجهة برمجة التطبيقات (API) لاستنتاج محتويات خطة Claude.ai معينة، ولا تستخدم جدول خطط المستهلكين لاستنتاج حدود نموذج واجهة برمجة التطبيقات (API). راجع دليل الأسعار والباقات لـ Claude بشأن التمييز على مستوى الخطة.
Claude Haiku مقابل Sonnet مقابل Opus: الاختلافات الرئيسية
المفاضلة الرئيسية لا تتمثل في مجرد ترتيب حسب الجودة. فالتقدم في الترتيب يوفر قدرات أكبر للقيام بالأعمال المعقدة، لكنه يؤدي أيضًا إلى زيادة التكلفة الأساسية للرموز ويقلل عمومًا من السرعة. كما تختلف حدود السياق وضوابط الاستدلال أيضًا.
المفاضلات العملية
الملصقات الرسمية ومواصفات واجهة برمجة التطبيقات (API) الأساسية، إلى جانب نقاط انطلاق عملية لأحمال العمل الشائعة.
البعد
هايكو 4.5
السوناتة الخامسة
العمل رقم 5
أفضل نقطة انطلاق
عمل سريع ومتكرر ومحدود النطاق
أعمال معرفية متنوعة في الحياة اليومية
عمل معقد وذو عواقب وخيمة
ملصق السرعة الرسمي
أسرع
سريع
معتدل
سياق واجهة برمجة التطبيقات (API) / المخرجات
200 ألف / 64 ألف
1 ميغابايت / 128 كيلوبايت
1 ميغابايت / 128 كيلوبايت
التحكم في الاستدلال
التفكير الموسع اليدوي
التفكير التكيفي والجهد
التفكير التكيفي والجهد
السعر الأساسي لواجهة برمجة التطبيقات
مدخل $1 / مخرج $5
مدخل $2 / مخرج $10
$5 مدخل $5 / $25 مخرج $25
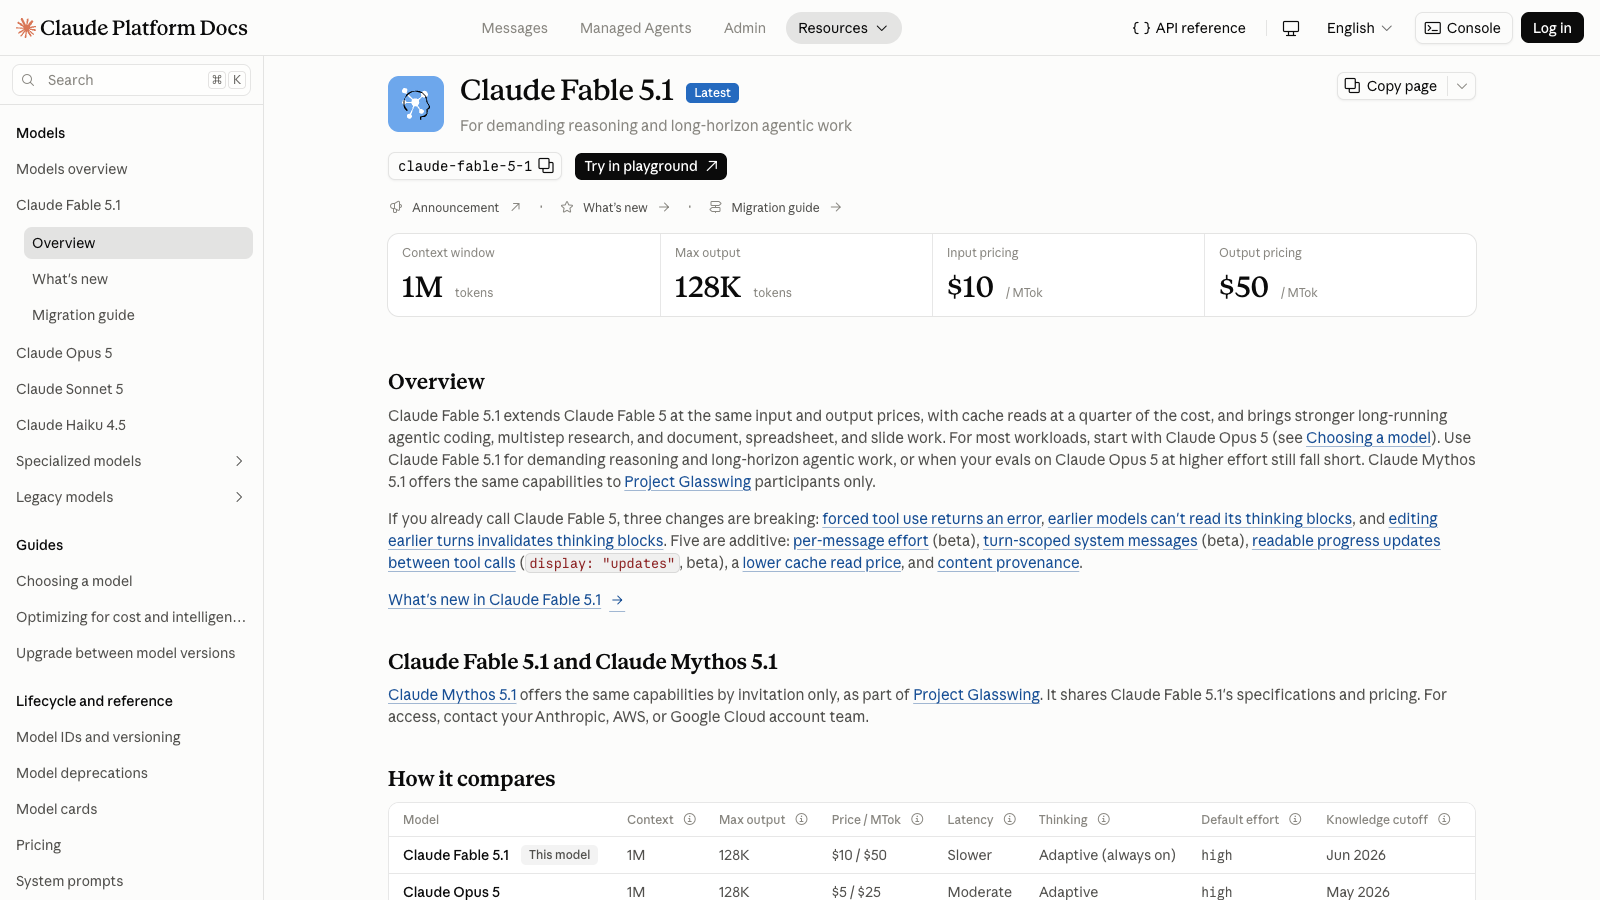
المكانة التي تحتلها لعبة «Fable»: يُصنف Fable 5.1 رسميًا على أنه «أبطأ»، مع سياق يبلغ 1 مليون، وإخراج أقصى يبلغ 128 ألف، وأسعار أساسية للإدخال/الإخراج تبلغ $10 / $50 لكل مليون توكن. تعامل معه على أنه مستوى تصعيدي عندما يفشل «أوبوس» في تقييمك حتى مع بذل جهد أكبر.
السرعة والكمون
تصنف Anthropic Haiku 4.5 على أنها “الأسرع”، وSonnet 5 على أنها “سريعة”، وOpus 5 على أنها “متوسطة”، وFable 5.1 على أنها “أبطأ”. هذه تصنيفات نوعية للمنتجات، وليست قياسات بالمللي ثانية أو عدد الرموز في الثانية. يعتمد زمن الاستجابة الفعلي على حجم الطلب، وإعدادات الاستدلال، والأدوات، والحمل، ووضع الخدمة.
عناصر التحكم في السياق والمخرجات والاستدلال
لا يزال سياق واجهة برمجة التطبيقات (API) الأصغر في Haiku البالغ 200 ألف، والحد الأقصى للإخراج البالغ 64 ألف، كافيين للعديد من المهام المحدودة. أما Sonnet و Opus فيوسعان كلا الحدين إلى 1M و 128K. يستخدم Haiku 4.5 التفكير الموسع اليدوي، بينما يدعم كل من Sonnet 5 و Opus 5 التفكير التكيفي والتحكم في الجهد. ويُعد هذا الاختلاف أحد الأسباب التي تجعل إعدادًا واحدًا متطابقًا للتفكير غير قادر على إنشاء اختبارات متكافئة تمامًا عبر جميع النماذج.
ما هو طراز Claude الذي ينبغي عليك استخدامه لكل مهمة؟
حجم العمل
ابدأ بـ
لماذا
الترقية عند
التصنيف، والاستخراج، والتوجيه، وتصنيف الحالات حسب الأولوية
هايكو 4.5
تناسب فترات الاستجابة القصيرة والتكلفة الأساسية المنخفضة للرموز المهام الواضحة والقابلة للتكرار.
الحالات الاستثنائية أو وقت التصحيح يقضيان على الوفورات.
الكتابة، والتحليل، والفهم البصري، والبرمجة في الحياة اليومية
السوناتة الخامسة
توازن بين السرعة والقدرات والسياق والتكلفة في الأعمال المختلطة.
يصبح التفكير أو التحقق على المدى الطويل هو العقبة الرئيسية.
البرمجة المعقدة، التشخيص الصعب، العوامل المستقلة
العمل رقم 5
القدرة أهم من السعر الأدنى لكل توكن.
لا يزال نظام «أوبوس» (Opus)، الذي يتطلب جهدًا أكبر، يفشل في اجتياز تقييم تمثيلي صارم.
الأعمال الاستثنائية التي تستغرق وقتًا طويلاً أو التي تعتمد بشكل كبير على التفكير المنطقي
Fable 5.1
إنه مسار التصعيد الحالي فوق أوبوس.
لا تستخدمها إلا عندما تبرر الفائدة المتوقعة تكلفتها المرتفعة.
هذه مجرد نقاط انطلاق، وليست حلولاً مناسبة لجميع الحالات. على سبيل المثال، قد يكون استخدام Opus مبرراً في حالة تغيير قصير في الكود ولكنه ذو أهمية كبيرة، في حين أن مهمة استخراج طويلة ولكنها منظمة بشكل كبير قد تظل مناسبة لاستخدام Haiku. للاطلاع على أمثلة عملية لسير العمل، راجع دليلنا الخاص بـ باستخدام Claude في الترميز.
عندما تتجاوز قائمتك المختصرة نطاق Claude، يتيح لك GlobalGPT تشغيل نفس المطالبة التمثيلية عبر Claude وGPT-5.6 Sol وGemini 3 Pro وKimi K3 في مساحة عمل واحدة. حافظ على ثبات معايير القبول: فالسرعة مهمة في الأعمال المتكررة، في حين أن جودة الإجابات ووقت التصحيح هما اللذان يحددان ما إذا كانت النتيجة الأقل تكلفة هي الأرخص فعليًّا.
اختر بناءً على تكلفة الفشل، وليس فقط بناءً على نوع المهمة
تخفي تسميات المهام المتغير الأهم: ماذا يحدث عندما تكون الإجابة خاطئة؟ الإطار الوارد أدناه هو أداة لاتخاذ القرارات التحريرية تستند إلى توجيهات «Anthropic» التي تضع الكفاءة والقدرة في المقام الأول. وهو ليس معيارًا قياسيًّا لـ «Anthropic».
سلم تكاليف الفشل
ابدأ بمستوى أدنى عندما يكون اكتشاف الأخطاء غير مكلف؛ وابدأ بمستوى أعلى عندما يكون التحقق غير مكتمل أو مكلفًا.
تكلفة منخفضة
أمثلة وضع العلامات، وتحديد المسار، وتنظيف المسودات، والملخصات القابلة للعكس
ابدأ هايكو 4.5
تصعيد عندما يؤدي وقت التصحيح إلى إهدار المكاسب في الكفاءة
المواد
أمثلة المسودات الموجهة للعملاء، والتحليلات التي خضعت للمراجعة، ورموز البرمجة الإنتاجية التي خضعت للاختبار
ابدأ السوناتة الخامسة
تصعيد عندما لا تتمكن المراجعة من الكشف عن الأعطال المهمة بشكل موثوق
باهظة الثمن
أمثلة التغيرات التي تتطلب درجة عالية من الاستقلالية، والتشخيص الصعب، والقرارات ذات الآثار المترتبة
ابدأ العمل رقم 5
تصعيد لا يتم إرسالها إلى «Fable» إلا بعد أن يفشل «Opus» — الذي يتطلب جهدًا أكبر — في تقييم الحالة المجمدة
متى يجب ترقية طراز Claude أو الرجوع إلى إصدار أقدم منه
لا تتقدم إلا عندما يظهر حد محدد
من الهايكو إلى السوناتة
قم بالترقية عندما تتجاوز الحالات الاستثنائية، أو حالات عدم تنفيذ التعليمات، أو الوقت المستغرق في تصحيح المراجعين، الوفورات المحققة.
سوناتة إلى «أوبوس»
قم بالترقية عندما يصبح التنفيذ على المدى الطويل، أو الاستدلال المعقد، أو عملية التحقق، أو تكلفة الفشل، هو العامل المقيد.
أوبوس عند بذل جهد أكبر
اختبر حمل العمل المكثف باستخدام اختبارات القبول المجمدة قبل الانتقال إلى المستوى الأعلى.
من «أوبوس» إلى «فابل»
لا تلجأ إلى تصعيد الأمر إلا إذا فشل «أوبوس» — الذي يتطلب جهدًا أكبر — في اجتياز التقييم التمثيلي، وكان المكسب يستحق التكلفة.
قاعدة تخفيض التصنيف: ارجع إلى المستوى الأدنى عندما ينجح طراز أرخص في اجتياز اختبارات القبول نفسها مرارًا وتكرارًا مع تحقيق زمن الاستجابة والموثوقية المطلوبين.
تُظهر مصفوفة Anthropic توزيع أربعة طرازات حالية من Claude وفقًا لاحتياجات مختلفة من حيث القدرات والسرعة وأحمال العمل.
مثال على تكلفة ثابتة لواجهة برمجة التطبيقات (API) بنظام Claude
بالنسبة لحجم عمل إجمالي ثابت يبلغ مليون رمز إدخال بالإضافة إلى 100,000 رمز إخراج عبر طلبات API قياسية متعددة، تتراوح التكلفة الأساسية للرمز بين $1.50 مع Haiku 4.5 و$15.00 مع Fable 5.1. هذا ليس طلبًا واحدًا، ولا يتجاوز حدود المخرجات لكل طلب.
حمل عمل واحد، أربعة طرازات من طراز Claude
يكلف حجم الرمز نفسه ضعف أو خمسة أضعاف أو عشرة أضعاف إجمالي حجم «هايكو» كلما صعدت إلى المستويات الأعلى.
حجم العمل 1.0 مليون مدخلات + 0.1 مليون مخرجات عبر طلبات متعددة
هايكو 4.5
$1.50
السوناتة الخامسة
$3.00
العمل رقم 5
$7.50
Fable 5.1
$15.00
نموذج
حساب المدخلات
حساب الناتج
الإجمالي
هايكو 4.5
1.0 × $1
0.1 × $5
$1.50
السوناتة الخامسة
1.0 × $2
0.1 × $10
$3.00
العمل رقم 5
1.0 × $5
0.1 × $25
$7.50
Fable 5.1
1.0 × $10
0.1 × $50
$15.00
يشمل: معدلات الرموز القياسية للمدخلات والمخرجات المستمدة من لقطة سعرية واحدة بنظام Anthropic.
المستثنى: التخزين المؤقت للمطالبات، واجهة برمجة التطبيقات (API) للدُفعات، الوضع السريع، الموقع الجغرافي، رسوم الأدوات، الضرائب، الخصومات، وأرصدة GlobalGPT.
يوضح جدول الأسعار تكلفة الرموز، وليس تكلفة النتيجة النهائية. فقد يصبح النموذج الأرخص تكلفةً أكثر تكلفةً إذا استهلكت عمليات إعادة المحاولة والتصحيح والتحقق وقتًا من الموظفين يفوق التوفير الذي تحققه الرموز.
اختبار عملي لنموذج Claude: نفس المطالبات، أنماط فشل مختلفة
في 9 سبتمبر 2026، أرسلنا نفس المطالبات الثلاث عبر واجهة برمجة التطبيقات (API) الخاصة بـ Anywhere إلى نماذج Claude Haiku 4.5 وSonnet 5 وOpus 5 وFable 5.1. وشملت المهام التقييم المنظم للحالات، والكتابة المستندة إلى الأدلة، وتصحيح أخطاء JavaScript القابلة للتدقيق. واحتفظنا بأول ناتج صالح لكل نموذج وقمنا بتقييمه وفقًا للقواعد التي تم تجميدها قبل مراجعة الردود.
ولم تكن النتيجة مجرد ترتيب بسيط. فقد حصل كل من «سونيت» و«أوبوس» و«فابل» على 26.5 من أصل 30، في حين اختلفت نقاط قوتها ونقاط ضعفها بشكل حاد. أما «هايكو»، فقد أرجع رمز الخطأ HTTP 503 في كلتا المحاولتين المسموح بهما لكل مهمة، لذا تظل جودة مخرجاته مجهولة في هذا الاختبار.
إعداد الاختبار والنتيجة الإجمالية
ثلاث مطالبات مجمدة، ونفس حدود الرموز على مستوى المهمة، وبدون أدوات أو بحث، مع الاحتفاظ بأول ناتج صالح لكل نموذج.
قاعدة إعادة المحاولةخطأ «Once for transport» أو «429/5xx» أو «محتوى فارغ» أو «استجابة غير صحيحة»
نموذج
المهام المنجزة
مجموع نقاط الجودة
الإشارة الأكثر فائدة
كلود هايكو 4.5
0/3
لم يتم تسجيله
أرجعت جميع الطلبات الستة المسموح بها رمز الخطأ 503؛ تتوفر المسارات فقط.
كلود سونيت 5
3/3
26.5/30
الطراز الوحيد الذي يفي بجميع متطلبات ملاحظات الإطلاق.
Claude Opus 5
3/3
26.5/30
عمق قوي في تصحيح الأخطاء؛ تم تجاهل أحد قيود طول الكتابة.
Claude Fable 5.1
3/3
26.5/30
مخرجات منظمة وخالية من الأخطاء؛ تم اقتطاع ملاحظة الإطلاق بعد استجابة فارغة واحدة.
المخرجات المنظمة
الاختبار 1: تصنيف تذاكر الدعم
نتيجة المهمة: Fable 5.1، 10/10
كان «Fable» النموذج الوحيد الذي أرجع ملف JSON قابلًا للتحليل المباشر، مع صحة جميع التسميات والإجراءات الست. أما «Opus» و«Sonnet» فقد أرجعا التسميات بشكل صحيح، لكنهما أضافا علامات «Markdown»؛ كما عزز كلاهما موعدًا نهائيًا واحدًا من المواعيد المحددة، ووعد «Sonnet» قبل الأوان بإجراء تصحيح أو رد المبلغ.
نموذج
الحالة
النتيجة
زمن الوصول في أي مكان
الرموز المُبلغ عنها
ماذا حدث؟
كلود هايكو 4.5
الطريق غير متاح
لم يتم تسجيله
غير متوفر
غير متوفر
ردان من النوع 503؛ لا توجد درجة جودة.
كلود سونيت 5
تم الاحتفاظ بالمخرجات
7.5/10
10.39 ثانية
1005
التسميات صحيحة، لكن JSON محاط بسياج ونتيجة استرداد/تصحيح مختلقة.
Claude Opus 5
تم الاحتفاظ بالمخرجات
8.5/10
11.87 ثانية
1051
تسميات صحيحة وإجراءات حازمة، لكن مع تقييد JSON وتشديد الموعد النهائي.
Claude Fable 5.1
تم الاحتفاظ بالمخرجات
10/10
8.55 ثانية
680
صيغة JSON قابلة للتحليل المباشر؛ وقد اجتازت جميع اختبارات التجميد.
مدخلات الاختبار الكاملة
أنت تدير صندوق بريد للدعم الخاص بخدمة SaaS. صنف كل تذكرة من التذاكر أدناه. أرجع JSON مع حقل واحد فقط من المستوى الأعلى باسم tickets. يجب أن يكون tickets مصفوفة بالترتيب الأصلي، ويجب أن يحتوي كل عنصر بالضبط على ticket_id وcategory وurgency وaction. يجب أن تكون category واحدة من: billing أو access أو bug أو feature. يجب أن تكون urgency واحدة من: low أو medium أو high. استخدم نص التذكرة فقط؛ لا تختلق نتائج سياسات أو حقائق تتعلق بالعملاء.

#481: تم تحصيل رسوم منا مرتين مقابل نفس التجديد السنوي. يتم إغلاق كشوف الرواتب يوم الجمعة وأحتاج إلى التحقيق في هذا الأمر قبل ذلك.
#482: تشير عملية إعادة تعيين كلمة المرور إلى أن البريد الإلكتروني قد أُرسل، لكن لم يصلني شيء. راجعت مجلد الرسائل غير المرغوب فيها وأعدت المحاولة مرة واحدة.
#483: تقوم عمليات التصدير بتنسيق CSV بتقريب كل مبلغ بالعملة إلى دولارات كاملة، بينما لا تزال لوحة التحليلات تعرض السنتات.
#484: يرجى إضافة وضع داكن إلى لوحة معلومات التحليلات.
#485: بعد تغيير نطاق شركتنا هذا الصباح، يتلقى كل موظف رسالة برفض الوصول عبر تسجيل الدخول الموحد (SSO).
#486: هل يمكنك إرسال نسخة من فاتورة الشهر الماضي إليّ؟
Claude Haiku 4.5: النتيجة التشغيلية الكاملة
لم يتم إنتاج أي ناتج للنموذج. فقد أرجعت كلتا المحاولتين المسموح بهما لاستخدام واجهة برمجة التطبيقات (API) لـ «Anywhere» رمز الخطأ HTTP 503، لذا تم تصنيف هذا المسار على أنه غير متاح واستبعاده من تقييم الجودة.
Claude Sonnet 5: الإخراج الكامل
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "billing",
 "urgency": "high",
 "action": "التحقيق في رسوم التجديد السنوي المكررة وإصدار تصحيح/استرداد قبل إغلاق كشوف رواتب العميل يوم الجمعة."
    },
    {
 "ticket_id": "#482",
      "category": "access",
 "urgency": "medium",
 "action": "التحقق من عنوان البريد الإلكتروني للحساب وإمكانية تسليم البريد، ثم تشغيل رسالة إعادة تعيين كلمة المرور يدويًا أو إعادة إرسالها."
    },
    {
 "ticket_id": "#483",
      "category": "bug",
 "urgency": "medium",
 "action": "تحويل المشكلة إلى قسم الهندسة لإصلاح تقريب التصدير بتنسيق CSV بحيث تتطابق قيم العملات مع الدقة على مستوى السنتات المعروضة على لوحة التحكم."
    },
    {
 "ticket_id": "#484",
 "category": "feature",
 "urgency": "low",
 "action": "تسجيل طلب وضع التعتيم (dark mode) للوحة معلومات التحليلات وإضافته إلى قائمة الميزات المعلقة للمنتج."
    },
    {
 "ticket_id": "#485",
      "category": "access",
 "urgency": "high",
 "action": "التحقيق فورًا في إعدادات تسجيل الدخول الموحد (SSO) المرتبطة بنطاق الشركة الذي تم تغييره واستعادة حق الوصول لجميع الموظفين المتأثرين."
    },
    {
      "ticket_id": "#486",
 "category": "الفوترة",
 "urgency": "منخفض",
 "action": "البحث عن فاتورة الشهر الماضي وإرسال نسخة منها إلى العميل."
    }
  ]
}
```
Claude Opus 5: الإخراج الكامل
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "الفوترة",
 "urgency": "عالية",
 "action": "إحالة الأمر إلى قسم الفوترة للتحقق من تكرار رسوم التجديد السنوية وتأكيد حل المشكلة قبل إغلاق كشوف رواتب العملاء يوم الجمعة."
    },
    {
 "ticket_id": "482",
      "category": "access",
 "urgency": "medium",
 "action": "التحقق من سجلات تسليم البريد الإلكتروني للرسالة الخاصة بإعادة تعيين كلمة المرور إلى ذلك العنوان، وفي حالة عدم تسليمها، تفعيل مسار إعادة تعيين معتمد للمستخدم."
    },
    {
 "ticket_id": "483",
      "category": "bug",
 "urgency": "medium",
 "action": "تقديم تقرير عن خطأ يتعلق بتقريب العملة في تصدير ملفات CSV، مع الإشارة إلى عدم تطابق القيم مع تلك الموجودة في لوحة التحكم، وطلب خطوات إعادة إنتاج الخطأ أو عينة من التصدير."
    },
    {
 "ticket_id": "484",
 "category": "feature",
 "urgency": "low",
 "action": "تسجيله كطلب ميزة للوضع المظلم للوحة معلومات التحليلات، والإقرار باستلامه دون الالتزام بجدول زمني."
    },
    {
 "ticket_id": "485",
      "category": "access",
 "urgency": "high",
 "action": "تصعيد الأمر باعتباره انقطاعًا في خدمة تسجيل الدخول الموحد (SSO) على مستوى المؤسسة مرتبطًا بتغيير النطاق؛ وطلب من قسم الهوية/المصادقة مراجعة تكوين نطاق SSO على الفور."
    },
    {
      "ticket_id": "486",
 "category": "billing",
 "urgency": "low",
 "action": "إرسال نسخة الفاتورة المطلوبة للشهر السابق إلى جهة الاتصال المعتمدة للحساب."
    }
  ]
}
```
Claude Fable 5.1: إخراج كامل
{"tickets":[{"ticket_id":"481","category":"الفوترة","urgency":"عالية","action":"التحقيق في حالة تكرار رسوم التجديد السنوي التي تم الإبلاغ عنها والرد قبل الموعد النهائي لدفع رواتب العملاء يوم الجمعة."},{"ticket_id":"482","category":"الوصول","urgency":"متوسط","action":"تحقق من سجلات تسليم رسائل إعادة تعيين كلمة المرور الخاصة بعنوان البريد الإلكتروني للمستخدم، وأعد إرسالها أو قدم طريقة بديلة لإعادة تعيين كلمة المرور."},{"ticket_id":"483","category":"خطأ","urgency":"متوسط","action":"قم بتكرار مشكلة تقريب المبالغ النقدية إلى دولارات كاملة عند التصدير إلى ملف CSV، وأحيل الأمر إلى قسم الهندسة لإصلاحه."},{"ticket_id":"484","category":"ميزة",""الاستعجال":"منخفض","الإجراء":"تسجيل طلب وضع "الوضع المظلم" (dark mode) للوحة معلومات التحليلات مع فريق المنتج والإقرار باستلام الطلب."},{"ticket_id":"485","الفئة":"الوصول",""الاستعجال":"عالي","الإجراء":"رفع مشكلة أخطاء رفض الوصول عبر تسجيل الدخول الموحد (SSO) على مستوى الشركة بعد تغيير النطاق ومراجعة تكوين نطاق SSO."},{"ticket_id":"486","الفئة":"الفوترة","urgency":"low","action":"البحث عن فاتورة الشهر الماضي وإرسال نسخة منها إلى العميل."}]}
سياسة «أول إخراج صالح». يُقاس زمن الاستجابة بالوقت الفعلي عبر «Anywhere»، وليس بزمن الاستجابة الأصلي Anthropic. يتم الإبلاغ عن عدد الرموز من قِبل المزود؛ ولا يُستنتج أي تكلفة مباشرة لواجهة برمجة التطبيقات (API) من هذا المسار.
اتباع القيود
الاختبار 2: مذكرة إطلاق تستند إلى الأدلة
نتيجة المهمة: Sonnet 5، 10/10
كان «سونيت» هو النموذج الوحيد الذي استوفى جميع المتطلبات المحددة. أما «أوبوس» فقد قدم ملاحظة قوية، لكنه تجاوز الحد الأقصى لعدد الكلمات وافترض أن جميع الذين لم يردوا هم طلاب مسجلون. أما «فابل»، فقد كانت إجابته الأولى فارغة؛ وأسفرت محاولته المسموح بها عن ملاحظة مقطوعة بشكل واضح، دون التوصية أو التحذير.
نموذج
الحالة
النتيجة
زمن الوصول في أي مكان
الرموز المُبلغ عنها
ماذا حدث؟
كلود هايكو 4.5
الطريق غير متاح
لم يتم تسجيله
غير متوفر
غير متوفر
ردان من النوع 503؛ لا توجد درجة جودة.
كلود سونيت 5
تم الاحتفاظ بالمخرجات
10/10
9.94 ثانية
796
استوفت متطلبات كل من «النطاق» و«الهيكل» و«الأدلة» و«التوصيات» و«التحذيرات».
Claude Opus 5
تم الاحتفاظ بالمخرجات
8/10
9.49 ثانية
826
تحليل قوي، لكنه يقل بـ 223 كلمة وفقًا لطريقة حساب الكلمات المجمدة، ويحتوي على استنتاج واحد غير مدعوم بالأدلة.
Claude Fable 5.1
تم الاحتفاظ بالمخرجات
6.5/10
19.27 ثانية
1685
الرد الأول فارغ؛ تم اقتطاع محاولة الإعادة المحفوظة قبل التوصية والتحذير.
مدخلات الاختبار الكاملة
اكتب مذكرة إطلاق داخلية تتراوح بين 180 و220 كلمة موجهة إلى مدير المنتج، مع الاعتماد حصريًّا على الحقائق الواردة أدناه. يجب أن تتضمن المذكرة: عنوانًا، وفقرة افتتاحية قصيرة، وثلاث نقاط محددة بالضبط، وتوصية، وتحذيرًا واحدًا محددًا بوضوح. لا تبتكر أي قرارات متعلقة بالميزانية، أو نسبًا مئوية، أو دلالة إحصائية، أو آثارًا سببية.

الحقائق:
- شارك في البرنامج التجريبي 120 طالبًا.
- عند نقطة التقييم في 31 مارس، كان 96 طالبًا قد حضروا ثلاث جلسات على الأقل.
- بلغ متوسط درجة الاستبيان 4.3 من 5 من أصل 71 مشاركًا.
- تذكر ورقة عمليات البرنامج ميزانية قدرها $18,000.
- تذكر مذكرة الموافقة المالية مبلغ $20,000. ولا توضح ما إذا كان الفرق ناتجًا عن تعديل أم خطأ في التسجيل.
- لم يتم توزيع المشاركين عشوائيًا ولم يتم جمع درجات أساسية.
- القرار يتعلق بإطلاق تجربة تجريبية ثانية، وليس بتطبيق البرنامج بشكل دائم.
Claude Haiku 4.5: النتيجة التشغيلية الكاملة
لم يتم إنتاج أي ناتج للنموذج. فقد أرجعت كلتا المحاولتين المسموح بهما لاستخدام واجهة برمجة التطبيقات (API) لـ «Anywhere» رمز الخطأ HTTP 503، لذا تم تصنيف هذا المسار على أنه غير متاح واستبعاده من تقييم الجودة.
Claude Sonnet 5: الإخراج الكامل
**الموضوع: نتائج البرنامج التجريبي — توصية بالمضي قدمًا في البرنامج التجريبي الثاني**

اختتم البرنامج التجريبي الأول فترة التقييم الأولى، وتبدو مؤشرات المشاركة والرضا الأولية مشجعة. وقبل اتخاذ قرار بشأن البرنامج التجريبي الثاني، هناك بعض النقاط المتعلقة بالبيانات والمسائل المعلقة التي ينبغي للفريق مراجعتها معًا.

- من بين 120 طالبًا مسجلاً، حضر 96 طالبًا ثلاث جلسات على الأقل حتى تاريخ نقطة التقييم في 31 مارس.
- أسفر استطلاع الرأي الذي أُجري بعد انتهاء الجلسات، والذي شارك فيه 71 مشاركًا، عن متوسط تقييم بلغ 4.3 من أصل 5.
- توجد تباينات في أرقام الميزانية بين الوثائق: تذكر ورقة عمليات البرنامج مبلغ $18,000، بينما تذكر مذكرة الموافقة المالية مبلغ $20,000؛ ومن غير الواضح ما إذا كان ذلك يعكس تعديلاً أم خطأً في التسجيل.

**التوصية:** بالنظر إلى نتائج الحضور والاستبيان، نوصي بالمضي قدمًا في تنفيذ تجربة تجريبية ثانية لجمع بيانات أكثر تنظيماً — ويفضل أن تكون مع مجموعة مقارنة محددة وقياس خط أساس — قبل النظر في أي قرار بتوسيع نطاق التنفيذ. وينبغي أن تُستغل هذه التجربة التجريبية الثانية أيضًا كفرصة لتسوية التباين في الميزانية مع قسم الشؤون المالية قبل إقرار التمويل نهائيًا.

**تحذير:** يجب تفسير هذه النتائج بحذر. لم يتم اختيار المشاركين عشوائيًا ولم يتم جمع أي درجات أساسية، لذا لا يمكننا ربط نتائج الاستبيان أو أنماط الحضور بالبرنامج نفسه. هذا قرار يحدد نطاق المشروع التجريبي الثاني، وليس قرارًا بشأن التنفيذ الدائم.
Claude Opus 5: الإخراج الكامل
**الموضوع: نتائج المرحلة التجريبية وتوصيات بشأن المجموعة التجريبية الثانية**

اكتملت المرحلة التجريبية الأولى عند نقطة المراجعة المحددة في 31 مارس، وأصبح لدينا الآن معلومات كافية لاتخاذ قرار بشأن تنفيذ مرحلة تجريبية ثانية. تلخص هذه المذكرة ما لاحظناه، وتوصياتنا، والقيود الرئيسية التي تحد من تفسير النتائج. لم يتم اتخاذ أي قرار نهائي بشأن التنفيذ على نطاق واسع في هذه المرحلة.

- **التسجيل والمشاركة:** سجل 120 طالبًا في البرنامج. وحتى مرحلة التقييم في 31 مارس، حضر 96 منهم ثلاث جلسات على الأقل.
- **ملاحظات المشاركين:** بلغ متوسط تقييم استبيان ما بعد المشاركة 4.3 من 5، استنادًا إلى 71 مشاركًا. لم يرد الطلاب المسجلون الباقون، لذا تعكس النتيجة تلك المجموعة الفرعية فقط.
- **تباين في الميزانية:** تذكر ورقة عمليات البرنامج ميزانية قدرها $18,000، في حين تذكر مذكرة الموافقة المالية مبلغ $20,000. لا تذكر مذكرة الشؤون المالية ما إذا كان الفرق يعكس تعديلاً أم خطأً في التسجيل، ولم نتمكن من تحديد الرقم الذي يسري.

**التوصية:** المضي قدماً في التخطيط لتجربة تجريبية ثانية، بشرط أن تقوم إدارة الشؤون المالية وإدارة عمليات البرنامج بمطابقة رقمي الميزانية وتأكيد رقم واحد ساري المفعول قبل الالتزام بالإنفاق. كما يجب أن يجمع المشروع التجريبي الثاني درجات خط الأساس عند التسجيل.

**تحذير:** لم يتم توزيع المشاركين عشوائيًا ولم يتم جمع أي درجات خط أساس. وبالتالي، فإن أرقام المشاركة والاستبيان تصف ما قامت به هذه المجموعة وما أبلغت عنه؛ ولا يمكنها إخبارنا بما أحدثه البرنامج أو كيف سيكون أداؤه مع مجموعة سكانية مختلفة.
Claude Fable 5.1: إخراج كامل
**الموضوع:** ملخص تقييم المرحلة التجريبية وتوصية بشأن المرحلة التجريبية الثانية

مرحبًا [السيد المدير]،

فيما يلي ملخص لحالة المشروع التجريبي في تقييم 31 مارس، إلى جانب توصية بشأن المضي قدمًا في المرحلة التجريبية الثانية. تغطي هذه المذكرة قرار المرحلة التجريبية الثانية فقط، ولا تتناول التنفيذ الدائم.

- **التسجيل والحضور:** سجل 120 طالبًا في البرنامج. وفي مرحلة التقييم في 31 مارس، حضر 96 طالبًا ثلاث جلسات على الأقل.
- **آراء المشاركين:** أظهر استطلاع الرأي متوسط تقييم بلغ 4.3 من 5 من بين 71 مشاركًا.
- **سجلات الميزانية:** تذكر ورقة عمليات البرنامج ميزانية قدرها $18,000، بينما تذكر مذكرة الموافقة المالية مبلغ $20,000. ولا تشير مذكرة الشؤون المالية إلى ما إذا كان الفرق ناتجًا عن تعديل أم خطأ في التسجيل.

**
سياسة «أول إخراج صالح». يُقاس زمن الاستجابة بالوقت الفعلي عبر «Anywhere»، وليس بزمن الاستجابة الأصلي Anthropic. يتم الإبلاغ عن عدد الرموز من قِبل المزود؛ ولا يُستنتج أي تكلفة مباشرة لواجهة برمجة التطبيقات (API) من هذا المسار.
اكتشفت النماذج الثلاثة المتاحة عيوبًا، وأنتجت بدائل نجحت في اجتياز ثماني حالات قابلة للتنفيذ. وقد أرجعت كل من «أوبوس» و«فابل» بيانات JSON صالحة، وتعادلتا في النتيجة 10/10. كما نجح كود «سونيت» في الاختبار، لكن علامات Markdown المحيطة به خالفت متطلبات JSON المباشر.
نموذج
الحالة
النتيجة
زمن الوصول في أي مكان
الرموز المُبلغ عنها
ماذا حدث؟
كلود هايكو 4.5
الطريق غير متاح
لم يتم تسجيله
غير متوفر
غير متوفر
ردان من النوع 503؛ لا توجد درجة جودة.
كلود سونيت 5
تم الاحتفاظ بالمخرجات
9/10
13.17 ثانية
1471
اجتاز البديل 8 حالات من أصل 8؛ أما الناتج المُحاط بسياج فقد خسر نقطة تنسيق JSON.
Claude Opus 5
تم الاحتفاظ بالمخرجات
10/10
20.17 ثانية
1826
JSON صالح، وتم تحديد العيبين، واجتازت 8 حالات قابلة للتنفيذ من أصل 8.
Claude Fable 5.1
تم الاحتفاظ بالمخرجات
10/10
15.89 ثانية
1409
JSON صالح، وتشخيص موجز، واجتياز 8 حالات قابلة للتنفيذ من أصل 8.
مدخلات الاختبار الكاملة
قم بتشخيص وإصلاح دالة JavaScript هذه. أرجع JSON يحتوي على أربعة حقول فقط بالضبط: root_cause (سلسلة)، replacement (سلسلة تحتوي على دالة الاستبدال الكاملة)، tests (مصفوفة من سلاسل حالات الاختبار)، و remaining_risk (سلسلة). لا تدّعِ أنك قمت بتنفيذ الاختبارات. قم بإجراء أصغر إصلاح واضح يفي بشروط العقد.

شروط العقد:
- tasks عبارة عن مصفوفة من الدوال التي لا تحتوي على معلمات وتُرجع وعودًا (promises).
- أرجع أول قيمة تم الوفاء بها حسب ترتيب الإدخال، حتى لو كانت تلك القيمة 0 أو false أو سلسلة فارغة.
- تجاهل المهام المرفوضة.
- أرجع null عندما تُرفض كل المهام أو تكون المصفوفة فارغة.

الكود الحالي:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5: النتيجة التشغيلية الكاملة
لم يتم إنتاج أي ناتج للنموذج. فقد أرجعت كلتا المحاولتين المسموح بهما لاستخدام واجهة برمجة التطبيقات (API) لـ «Anywhere» رمز الخطأ HTTP 503، لذا تم تصنيف هذا المسار على أنه غير متاح واستبعاده من تقييم الجودة.
Claude Sonnet 5: الإخراج الكامل
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5: الإخراج الكامل
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1: إخراج كامل
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
سياسة «أول إخراج صالح». يُقاس زمن الاستجابة بالوقت الفعلي عبر «Anywhere»، وليس بزمن الاستجابة الأصلي Anthropic. يتم الإبلاغ عن عدد الرموز من قِبل المزود؛ ولا يُستنتج أي تكلفة مباشرة لواجهة برمجة التطبيقات (API) من هذا المسار.
تُظهر نتائج «Anywhere» هذه السبب الذي يجعل اختيار النموذج يجب أن يستند إلى المهمة بدلاً من الاعتماد على قائمة تصنيف واحدة. في نموذج GlobalGPT، يمكنك تطبيق طريقة المقارنة نفسها على المطالبة الخاصة بك مقارنةً بنموذج Claude والنماذج الرائدة الأخرى، ثم اختيار الناتج الذي يتناسب بشكل أفضل مع معايير الجودة الخاصة بك، واحتياجاتك من حيث السرعة، وحجم عبء العمل المتعلق بالمراجعة.
كيفية إجراء المقارنة بطريقة عادلة
تجميد مهمة تمثيلية. استخدم نفس المقصد، والمواد المصدرية، والوصول إلى الأدوات، وفحوصات قبول الأهداف.
سجل أول ناتج صحيح. لا تمنح نموذجًا واحدًا محاولات إضافية في المقارنة الأساسية دون الإشارة إلى ذلك.
افصل بين الجودة والتوافر. ينبغي إدراج حالات فشل المصادقة والقدرة والمسار في ملاحظة التوافر، وليس في درجة الجودة.
قم بقياس مسار العمل بأكمله. احسب الوقت المنقضي، والجهد الذي بذله المراجع، ووقت التصحيح، ووقت استعادة المهام الفاشلة.
اختر النموذج الأقل تكلفةً. أعد إجراء الاختبار عند حدوث تغيير في المطالبات أو الأدوات أو إصدارات النماذج أو تكاليف الفشل.
أين يمكن استخدام GlobalGPT
يُعد طراز Anthropic بديلاً عن طراز Fable 5.1 في المهام الصعبة، عندما لا تفي تقييمات Opus 5 التي تتطلب جهدًا أكبر بالغرض.
اعتبارًا من 8 سبتمبر 2026، تشمل المجموعة الحالية من طرازات Anthropic الطرازات التالية: Claude Haiku 4.5، وClaude Sonnet 5، وClaude Opus 5، وClaude Fable 5.1. قد تتغير الإصدارات الدقيقة ومعرّفات الطرازات، لذا يرجى إعادة التحقق من النظرة العامة الرسمية على الطرازات قبل النشر.
ما الفرق بين Claude Haiku وSonnet وOpus؟
يُعطي «هايكو» الأولوية للسرعة وتكلفة الرموز الأساسية المنخفضة، بينما يوازن «سونيت» بين السرعة والقدرة على إنجاز الأعمال اليومية، أما «أوبوس» فيعطي الأولوية للقدرة على إنجاز المهام المعقدة أو ذات الآثار الكبيرة. ويعتمد الاختيار الصحيح على حجم العمل وتكلفة التحقق، وليس على ترتيب مطلق.
ما هو طراز Claude الذي ينبغي أن أستخدمه لأغلب المهام؟
ابدأ باستخدام نمط Sonnet 5 في معظم الأعمال اليومية المتعلقة بالكتابة والتحليل والبرمجة والفهم البصري واستخدام الأدوات. وبدلاً من ذلك، ابدأ باستخدام نمط Opus 5 عندما يكون ثمن الفشل باهظًا أو عندما يتطلب العمل تفكيرًا أعمق وتحققًا أكثر صعوبة.
ما هو طراز Claude الأفضل للبرمجة؟
يُعد Sonnet 5 نقطة انطلاق عملية للبرمجة اليومية، مع إجراء المراجعات والاختبارات المعتادة. استخدم Opus 5 في حالات التشخيص الصعبة، أو البرمجة المعقدة التي تتطلب تدخلًا فعّالًا، أو التنفيذ على المدى الطويل، أو التغييرات التي قد تترتب عليها تكاليف باهظة في حالة حدوث أخطاء.
ما هو طراز Claude الأفضل للكتابة؟
يُعد Sonnet 5 نقطة انطلاق متوازنة لمعظم عمليات الصياغة والتحرير. يمكن لـ Haiku 4.5 التعامل مع النصوص ذات الحجم الكبير والهيكل المنظم بدقة، في حين قد يكون من المفيد تجربة Opus 5 في حالات التوليف الصعبة أو المواد ذات الأهمية الكبيرة التي يصعب التحقق منها.
هل يعد Claude Sonnet أفضل من Opus؟
ليس في جميع الحالات. يُعد طراز Sonnet 5 أسرع وأرخص من حيث أسعار واجهة برمجة التطبيقات (API) الأساسية، في حين أن طراز Anthropic يجعل Opus 5 مناسبًا للأعمال الأكثر تعقيدًا. النموذج الأفضل هو الخيار الأقل تكلفة الذي يجتاز اختبارات القبول الخاصة بك بشكل موثوق.
هل سيحل نظام Claude Fable محل نظام Opus؟
يُعتبر الإصدار Anthropic الإصدار Fable 5.1 بمثابة مستوى تصعيدي للحالات التي تتطلب استدلالًا معقدًا أو مهامًا طويلة الأمد للوكيل، عندما لا يكفي حتى الإصدار Opus 5 الذي يتطلب جهدًا أكبر، وليس كبديل شامل لـ Opus.
هل يشترك كل من Claude.ai وواجهة برمجة التطبيقات (API) الخاصة بـ Claude في نفس نافذة السياق؟
الحدود الخاصة بالخطة رقم Claude.ai ومواصفات نموذج واجهة برمجة التطبيقات (API) منفصلتان. يذكر جدول الخطط الفردية لخطة Anthropic حاليًا نافذة سياق سعة 200 ألف، بينما تشير وثائق واجهة برمجة التطبيقات (API) إلى نافذة سياق سعة 1 مليون لخطط Sonnet 5 وOpus 5 وFable 5.1.
متى ينبغي عليّ الترقية من Haiku إلى Sonnet أو Opus؟
قم بالترقية عندما تفوق عيوب فشل اختبارات القبول، أو الحالات الاستثنائية الصعبة، أو وقت التصحيح، أو الجهد المبذول في التحقق، أو تكلفة الخطأ، المزايا التي يتمتع بها النموذج الأقل سرعةً من حيث السرعة وسعر الرمز. وقم بالرجوع إلى النموذج الأقل سرعةً عندما ينجح نموذج أرخص تكلفةً مرارًا وتكرارًا في اجتياز نفس الاختبارات الثابتة.
كم تبلغ تكلفة Claude Haiku وSonnet وOpus عند استخدام واجهة برمجة التطبيقات (API)؟
وفقًا لمعدلات Anthropic الأساسية التي تم التحقق منها في 8 سبتمبر 2026، تبلغ تكلفة Haiku 4.5 مدخلات بقيمة $1 ومخرجات بقيمة $5، وتبلغ تكلفة Sonnet 5 مدخلات بقيمة $2 ومخرجات بقيمة $10، وتكلفة Opus 5 هي $5 و$25 لكل مليون توكن. انظر Anthropic’s صفحة الأسعار الرسمية للاطلاع على الأسعار الحالية وطرق التسعير الإضافية.
الحكم النهائي: ابدأ بالطراز الأرخص الذي يستوفي المعايير
بالنسبة للأعمال المختلطة العامة، يظل الطراز Sonnet 5 هو الخيار الافتراضي الأكثر عملية، وقد كان الطراز الوحيد الذي استوفى جميع شروط ملاحظات الإطلاق في اختبارنا. حقق كل من Opus 5 وFable 5.1 نفس النتيجة الإجمالية لـ Sonnet البالغة 26.5/30 من خلال نقاط قوة مختلفة، في حين تعذر تقييم Haiku 4.5 لأن مسار Anywhere أرجع رمز الخطأ 503 في كل محاولة مسموح بها. يجب التعامل مع هذه النتائج على أنها دليل على أداء أحمال العمل، وليس تصنيفًا عالميًا دائمًا.
الخطوة التالية بسيطة: حدد مهمة حقيقية واحدة، وحدد معايير النجاح المطلوبة، واختبر كل مرشح جاد في ظروف قابلة للمقارنة، وأدرج وقت التصحيح في التكلفة النهائية. النموذج الفائز هو الأقل تكلفةً والذي يحقق النجاح بشكل موثوق، وليس النموذج الذي يتمتع بأقل معدل للرموز أو أعلى تصنيف.
يجعل نظام GlobalGPT هذه الطريقة جزءًا من سير عمل أوسع نطاقًا وميسور التكلفة في مجال الذكاء الاصطناعي. استخدم Claude وGPT-5.6 Sol وGemini 3 Pro وKimi K3 وغيرها من النماذج الرائدة المزودة بوظائف متعددة للذكاء الاصطناعي في لوحة تحكم واحدة، ثم انقل العمل إلى جهازك الطرفي وسير عمل التطوير وأدوات الإنتاج الحالية من خلال واجهة سطر الأوامر (CLI) الخاصة بـ GlobalGPT. تساعدك الاختبارات المقارنة على الاختيار؛ وتكمن الميزة الأكبر في الحفاظ على ترابط سير العمل بالكامل.
اكتشف الميزات الرسمية لبرنامج Eleven v4 Turbo، وأسعار واجهة برمجة التطبيقات (API) وإعداداتها، مع ست عينات صوتية حقيقية، ونتائج قياس التوقيت، وحاسبة تكلفة الحروف.
توطين الإعلانات المرئية بما يتجاوز مجرد الترجمة: تكييف النصوص والأصوات والتعليقات النصية والعروض والأشكال، مع ثلاثة نسخ مبدئية للمفهوم وسير عمل عملي وفقًا لنظام GlobalGPT.
إنشاء مسار عمل قائم على الذكاء الاصطناعي لإدارة مقاطع الفيديو الخاصة بالكتالوجات، يتضمن قوائم SKU، ومراجع المنتجات، وعمليات التحقق من الإنشاء، ونقل البيانات إلى Shopify، بالإضافة إلى مشروع تجريبي حقيقي يشمل منتجين.
قارن بين الشخصيات الافتراضية التي تعتمد على الذكاء الاصطناعي ومنشئي المحتوى الذي يقدمه المستخدمون (UGC) من حيث جودة المنتج وتكلفة الإنتاج والحقوق والتعديلات، مع مفهوم اصطناعي وسير عمل عملي وفقًا لنموذج GlobalGPT.