
يُعد الإصدار Grok 4.7 ترقية مهمة في مجالي البرمجة والأعمال المعرفية، لكن الأدلة لا تزال في مرحلة مبكرة: فالتصريحات الرسمية المتعلقة بالإطلاق ونتائج الاختبارات المستقلة تشير إلى حدوث تحسن، وليس إلى نجاح شامل.
إجابة سريعة
Grok 4.7 هي الترقية التي أطلقتها xAI في 21 سبتمبر 2026، وهي مخصصة لأعمال البرمجة والمهام المعرفية الصعبة. تقول xAI إنها تخصص وقتًا أطول للمشكلات الصعبة، وتراجع عملها بعناية أكبر، وتضيف مجموعة جديدة من إجراءات الحماية مع الحفاظ على نفس السعر والسرعة اللذين تتميز بهما النسخة Grok 4.6. كما تصفها صفحة الإطلاق بأنها أسرع بمرتين وأرخص بنصف السعر مقارنةً بالنماذج المماثلة، وهي مقارنة بين البائعين يجب قراءتها في سياق المهمة والمسار الأساسيين. تُظهر بيانات «Independent Artificial Analysis» تحسناً طفيفاً بشكل عام مقارنةً بنموذج Grok 4.6، وتسجل نافذة سياق تبلغ 500 ألف. في اختبار واجهة برمجة التطبيقات (API) المكون من ثلاث مهام، كان Grok 4.7 الأقوى في تصحيح الأخطاء والالتزام بحدود المصدر؛ وحافظت خطة المشروع الخاصة به على عدم اليقين بشكل جيد، لكنها كانت أقل قابلية للتنفيذ مما هو مطلوب. وهذا دليل عملي مفيد، وليس دليلاً على أنه يتفوق على كل النماذج المنافسة.
ما هو Grok 4.7؟
يُعد طراز Grok 4.7 أحدث طراز في سلسلة Grok من xAI، وقد تم الإعلان عنه في 21 سبتمبر 2026. إن الإعلان الرسمي عن xAI مما يجعله النموذج الأكثر كفاءة في الشركة في مجال البرمجة والأعمال المعرفية. والتغيير الجوهري هنا لا يكمن في قائمة ميزات جديدة موجهة للمستهلكين، بل في الطريقة التي يُتوقع أن يبذل بها النموذج جهده: تخصيص مزيد من الوقت للمهام الصعبة، ومزيد من المراجعة الذاتية، وطبقة أمان تهدف إلى جعل تلك القدرات الإضافية أكثر قابلية للتحكم.
هذا التوجيه مهم لأنه يصف نموذجًا لسير العمل بدلاً من شخصية روبوت الدردشة. يُسوَّق النموذج Grok 4.7 باعتباره نموذجًا للمهام التي تستفيد من التحليل المستمر: تصحيح الأخطاء، والتخطيط، والكتابة الفنية، وتوليف الأبحاث، والمطالبات الطويلة التي تتطلب من النموذج مراعاة عدة قيود.
والحد الفاصل مهم بنفس القدر. إعلان xAI هو مجرد تصريح من المورد بشأن السلوك المقصود. وهو ليس دليلاً مستقلاً على أن نموذج Grok 4.7 يتفوق على كل نموذج منافس، أو كل موجه، أو كل مستودع برمجة. تعامل مع صفحة الإطلاق باعتبارها المصدر لما تدعيه xAI، ثم استخدم قياسات مستقلة ومهمتك الخاصة لتقرر ما إذا كانت تلك الادعاءات ذات أهمية أم لا.
Grok 4.7 مقابل Grok 4.6: ما الذي تغير فعليًّا؟
الملخص الأكثر منطقية هو أنه يمثل تحسينًا من حيث الجهد والموثوقية، وليس منتجًا مختلفًا تمامًا.
| المساحة | Grok 4.7 | ما تؤيده الأدلة |
|---|---|---|
| إصدار | 21 سبتمبر 2026 | التاريخ المذكور في الصفحة الرسمية لإطلاق xAI |
| الموقع الرئيسي | البرمجة والعمل المعرفي | الموقف الرسمي لشركة xAI |
| المهام الصعبة | بذل جهد أطول وإجراء مراجعة ذاتية أكثر دقة | الوصف الرسمي لـ xAI؛ يُعد تشغيل واجهة برمجة التطبيقات (API) الخاص بنا الذي يشمل ثلاث مهام اختبارًا عمليًّا بسيطًا، وليس مقارنة متكافئة |
| السلامة | مجموعة إجراءات وقائية جديدة | الوصف الرسمي لـ xAI |
| السعر والسرعة | مماثل لطراز Grok 4.6، وفقًا لـ xAI | ادعاء يتعلق بالإطلاق، وليس تدقيقًا في الأسعار من قبل طرف ثالث |
| السياق | 500 ألف توكن في ملف تعريف «التحليل الاصطناعي» | ملف تعريف عارضة أزياء مستقلة؛ تحقق من المسار الذي تستخدمه |
| ضوابط الاستدلال | من ’منخفض» إلى «مرتفع جدًا» في قائمة «Artificial Analysis» | بيانات تعريف المسار/النموذج المستقلة |
يُعد هذا تمييزًا مفيدًا للمشترين. إذا كانت النسخة Grok 4.6 تتناسب بالفعل مع سير عملك، فإن النسخة 4.7 تُعد ترقية سهلة لا بأس من تقييمها. أما إذا لم تكن النسخة 4.6 مناسبة بسبب قيود تتعلق بالنظام البيئي أو زمن الاستجابة أو الموثوقية أو الوصول، فإن مجرد تحقيق رقم أعلى في اختبار الأداء لن يحل تلك المشكلات.
للحصول على إطار عمل أوسع لشراء النماذج، فإن دليل أسعار GPT-5.6 و مقارنة بين 1TP و21T وهي تذكير مفيد بضرورة الفصل بين جودة النموذج والجوانب الاقتصادية للخطة ومدى ملاءمتها لسير العمل.
القدرات: حيث يُفترض أن يُساعد الموديل Grok 4.7
الترميز وتصحيح الأخطاء
أقوى نقطة قوة لـ xAI عند إطلاقها هي البرمجة. والوعد لا يقتصر على أن Grok 4.7 يكتب المزيد من الأكواد فحسب؛ بل إنه قادر على الاستمرار في معالجة مشكلة هندسية صعبة لفترة أطول، وفحص إجابته بنفسه، وتقديم تصحيح أو تفسير أكثر مدروسية. هذا هو السلوك الذي يجب البحث عنه في مستودع حقيقي: هل يحافظ على التصميم الحالي، ويحدد السبب الجذري، ويضيف اختبارات مفيدة، ويوضح ما لا يزال غير قادر على معرفته؟
لا تقم بتقييم النموذج باستخدام موجه جديد من نوع “بناء تطبيق مهام”. بل زوده بخطأ محدد مصحوب باختبار فاشل، ومجموعة صغيرة من الملفات، وقيود واضحة. واطلب تشخيصًا قبل تقديم التصحيح. فهذا يجعل من السهل معرفة ما إذا كان الاستدلال الأطول يقلل من عبء المراجعة أم أنه مجرد نص أطول.
وتنطبق القاعدة نفسها على الفرق التي تقارن طرق البرمجة المختلفة. أ مراجعة جهاز DeepSeek V4 Pro و مراجعة خطة الترميز الخاصة بنموذج GLM توفر هذه الأمثلة سياقًا مفيدًا للمقارنة، ولكن لا ينبغي اعتبار أي منهما بديلاً عن اختبار المستودع وسلسلة الأدوات التي تستخدمها فعليًّا.
الأعمال المعرفية ذات السياق الطويل
يحدد «Artificial Analysis» نافذة سياق تضم 500 ألف توكن لـ Grok 4.7. وهذا الحجم كبير بما يكفي لتغيير طريقة تعاملك مع الأعمال التي تتطلب مصادر كثيرة: فالمواصفات الفنية الطويلة، أو مجموعة ملاحظات الاجتماعات، أو جزء من قاعدة الكود، أو حزمة الأبحاث يمكن أن تظل ضمن محادثة واحدة بدلاً من تلخيصها مرارًا وتكرارًا.
القدرة على فهم السياق تختلف عن جودة فهم السياق. فقد يقبل النموذج مدخلات كبيرة الحجم ويغفل مع ذلك أحد القيود الموجودة في منتصف النص، أو يفرط في إعطاء وزن للفقرة الأخيرة، أو ينتج ملخصًا يبدو موثوقًا به لكنه يحتاج إلى التحقق من المصادر. ويكمن الاختبار العملي في القدرة على استرجاع المعلومات تحت الضغط: ضع بعض الحقائق الحاسمة في أجزاء مختلفة من وثيقة طويلة، واطلب اتخاذ قرار يخضع لقيود معينة، وتحقق مما إذا كانت الإجابة تستشهد بالمقاطع الصحيحة.
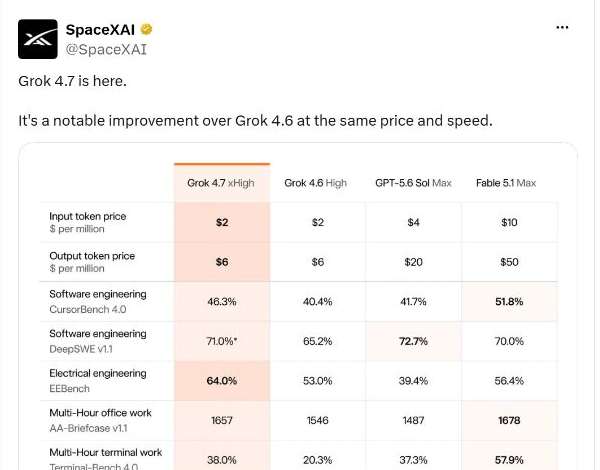
كرر الحساب الرسمي لشركة SpaceXAI على منصة X الترويج لعملية الإطلاق في 22 سبتمبر، واصفًا الإصدار Grok 4.7 بأنه تحسن ملحوظ مقارنة بالإصدار Grok 4.6 بنفس السعر والسرعة، كما نشر الرسم البياني الذي يقارن بين الطرازين. ويُعد هذا المنشور دليلاً مفيداً على الموقف العلني للشركة، وليس تأكيداً مستقلاً أو إجماعاً من المجتمع.
إذا تم استخدام النموذج في الأغراض البحثية، فاحرص على إبقاء «حلقة الأدلة» مرئية. إن مقارنة بين Gemini وPerplexity و دليل بدائل Perplexity تؤكدان نفس النقطة العملية: الإجابة المُحكمة لا تعني إجراء تدقيق للمصدر.
التحقق الذاتي والسلامة
تقول xAI إن نموذج Grok 4.7 يتحقق من عمله بمزيد من الدقة ويقدم مجموعة جديدة من إجراءات الحماية. وتعد هذه أهدافًا قيّمة، لا سيما عندما يُطلب من النموذج اتخاذ سلسلة طويلة من القرارات. إلا أنها لا تشكل ضمانة بأن الناتج صحيح أو آمن للتنفيذ التلقائي.
في سياق الاستخدام الإنتاجي، يجب الحفاظ على إجراءات الرقابة المعتادة المحيطة بالنموذج: الاختبارات، والأذونات، والمراجعة البشرية، والتحقق من المراجع، وشرط توقف واضح. ويُعد الفحص الذاتي للنموذج إشارة أخرى يجب فحصها، وليس بديلاً عن إجراءات الرقابة المحيطة به.
اختبارات الأداء لـ Grok 4.7: ما تثبته الأرقام
نتيجة ترميز قوية، حيث يُظهر الجدول الرسمي أن Grok 4.7 يتفوق على Grok 4.6.
تُظهر المقارنة بين الطرازات الأكبر حجمًا تحسناً ملحوظاً في أداء هذا المعيار الخاص بالأعمال المعرفية.
تعد هذه إشارة مفيدة لسير العمل الذي يعتمد على استخدام الأدوات، لكنها تظل مجرد تقييم واحد وليست درجة شاملة.
ويؤيد المؤشر المستقل نفس الاتجاه: التحسن، وليس دليلاً على فوز شامل.
اعتبر هذه البطاقات بمثابة أدلة توجيهية. فقد تؤدي تركيبة مجموعة البيانات، وإمكانية الوصول إلى الأدوات، وأخذ العينات، وإعدادات النموذج إلى تغيير الترتيب.
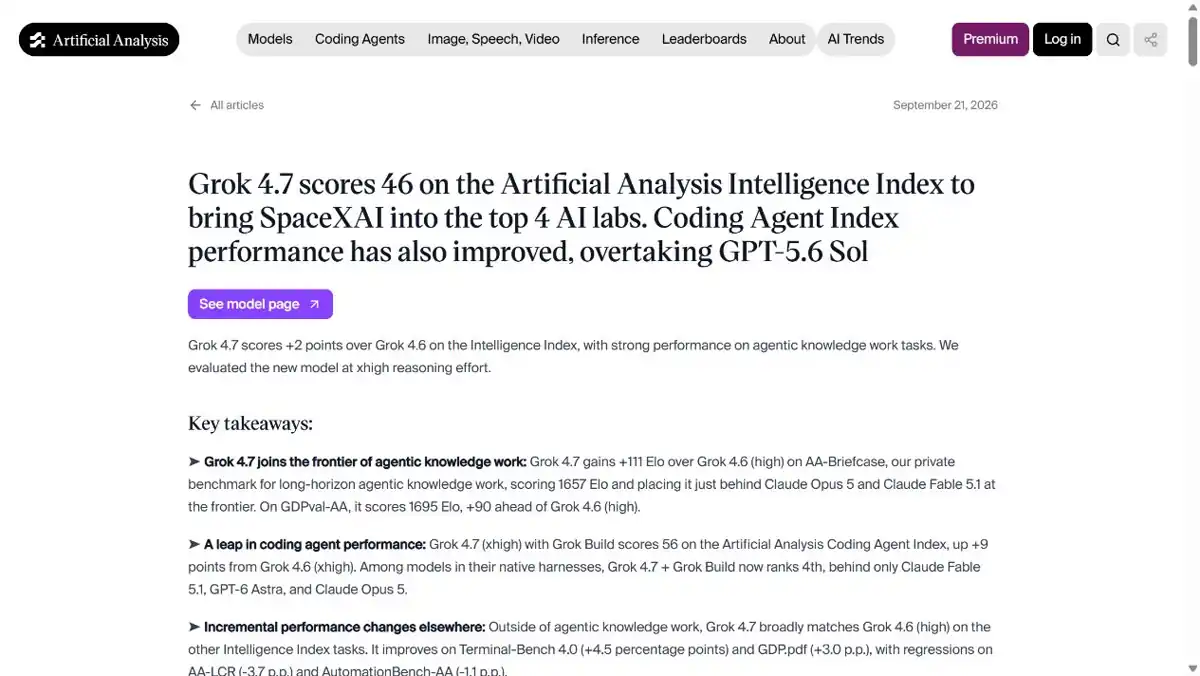
أحدث لمحة عامة مستقلة ومفيدة تأتي حاليًا من مقال مقارنة الأداء الخاص بمعالج ’Grok 4.7» من «Artificial Analysis», ، بتاريخ 21 سبتمبر 2026.
| القياس | النتيجة المُعلنة | كيفية قراءته |
|---|---|---|
| مؤشر الذكاء الاصطناعي التحليلي | 46 | أعلى بنقطتين من Grok 4.6 في المؤشر نفسه |
| AA-حقيبة عمل | 1,657 نقطة إيلو | 111 نقطة إيلو فوق Grok 4.6 في ذلك التقييم |
| نافذة السياق | 500 ألف توكن | حقل خاص بملف تعريف النموذج، وليس دليلاً على استرجاع السياق الطويل بشكل مثالي |
| جهد التفكير | من منخفض إلى xعالي | أداة تحكم على مستوى المسار مدرجة من قبل شركة Artificial Analysis |
الاتجاه مشجع: يُظهر المؤشر المستقل تحسناً مقارنةً بالإصدار السابق، كما أن الفارق الأكبر في مؤشر إيلو في «AA-Briefcase» يشير إلى تحسن أكثر وضوحاً في هذا التقييم بالذات. لكن الجدول لا يزال يعرض مجموعتين من البيانات، وليس تصنيفاً شاملاً. فقد تؤدي تركيبة المعايير المرجعية، والوصول إلى الأدوات، وعملية أخذ العينات، وإعدادات النموذج إلى تغيير النتيجة.
تُظهر الصفحة الرسمية لإطلاق xAI الرقم Grok 4.7 عند 46.3% على CursorBench 4.0 في جدول المقارنة الخاص بها، إلى جانب Grok 4.6 عند 40.4%، وGPT-5.6 Sol عند 41.7%، وFable 5.1 عند 51.8%. تُظهر الصفحة أيضًا 71.0% على DeepSWE v1.1 عند مستوى الجهد العالي، و64.0% على EEBench، و1,657 على AA-Briefcase v1.1. هذه أرقام مقارنة قدمها المورد، لذا يجب التعامل معها على أنها نتائج رسمية مُعلنة وليس بديلاً عن إعادة الاختبار المستقلة. الاستنتاج الأكثر أمانًا هو أن xAI تستهدف أعمال البرمجة الجادة والأعمال المعرفية المهنية، في حين تُظهر القياسات المستقلة تحسنًا ملموسًا في بعض المهام ونتائج أقل إقناعًا في مهام أخرى.
اختبار عملي لـ Grok 4.7: ثلاث مهام عملية
قمنا بتشغيل ثلاث مطالبات ثابتة على grok-4.7 معرف النموذج من خلال واجهة برمجة تطبيقات اختبار متوافقة مع OpenAI في 23 سبتمبر 2026. وكان هذا تقييمًا أحادي المسار، وليس واجهة برمجة تطبيقات xAI المباشرة، كما أنه لم يكن اختبارًا مقارنًا مع منافس. وقد تم الاحتفاظ بالإجابة الظاهرة من كل عملية تشغيل أدناه؛ مع استبعاد مسارات الاستدلال الخاصة.
| المهمة | الوقت الملحوظ | النتيجة |
|---|---|---|
| خطأ في التزامن في TypeScript | 333.7 ثانية، بث مباشر | نجاح باهر: تشخيص صحيح لمشكلة «الوعد المشترك»، تصحيح بسيط، اختباران مفيدان، وحدود دقيقة لما يمكن أن يثبته المقتطف البرمجي |
| ملاحظات بحثية متضاربة | 68.7 ثانية | "المرور القوي": تم الحفاظ على الإسناد، وحساب سيناريوهات السماح، ورفض الموافقة إلى حين التحقق من تعارض المصدر |
| خطة أسبوعية غير منظمة | 50.6 ثانية | نجاح جزئي: تم الحفاظ على المواعيد النهائية، والتناقضات، والمالكين المجهولين، والمخاطر الخمسة، لكن لم يتم تحويل العمل إلى جدول زمني يومي واضح |
تصف أرقام زمن الاستجابة هذا المسار وهذه المطالبات فقط. فقد واجهت مهمة الترميز في البداية مهلة انتظار لبوابة غير تدفقية، ثم اكتملت مع تمكين التدفق. وهذا تحذير عملي يتعلق بالنشر بشأن النقل ومعالجة مهلة الانتظار، وليس درجة سرعة عامة تبلغ 4.7 لـ Grok.
الاختبار 1: تصحيح أخطاء التزامن في TypeScript
المهمة 1 — تصحيح أخطاء التزامن في معالج واجهة برمجة التطبيقات (API) بلغة TypeScript

يقوم معالج صغير مكتوب بلغة TypeScript بإرجاع رمز حالة HTTP 200 مع نص فارغ بشكل متقطع عندما تصل طلبان في وقت متقارب.

الملفات المتوفرة:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

تظهر أعراض المشكلة في بيئة الإنتاج بشكل متقطع فقط عندما يتداخل طلبان. يمكن استدعاء أداة التحميل نفسها بشكل متزامن بأمان، وهي تُرجع حمولة مختلفة لكل طلب. لا توجد ملفات أخرى متاحة.

أعد هذه الأقسام بالضبط:
1. السبب الجذري
2. أصغر تصحيح آمن (اعرض الفروق الموحدة)
3. اختباران للرجوع (كود بنمط TypeScript أو Jest)
4. الافتراضات والقيود
لا تدّعِ أنك قمت بتشغيل الكود.1. السبب الجذري
`current` هي حالة على مستوى الوحدة النمطية تشترك فيها كل استدعاء. في دورة واحدة من JavaScript، يُعتبر فحص القيمة `null` والتعيين عمليتين مترابطتين، لذا لا يتم تنفيذ `load()` في كلتا الاستدعاءين المتداخلين. يقوم الاستدعاء الأول بتخزين الوعد الخاص به؛ أما الاستدعاء الثاني الذي يصل قبل تسوية ذلك الوعد، فيتخطى استدعاء `load()` الخاص به وينتظر نفس الوعد. ثم تُرجع `handler` رمز حالة HTTP 200 الذي يكون `body` الخاص به هو السلسلة النصية للمكالمة الأولى، وليس حمولة الطلب الثاني. لا توجد هذه النافذة إلا أثناء تنفيذ المكالمة، لذا لا يظهر الفشل إلا عند تداخل الطلبات.
يتم تنفيذ `current = null` في كل استمرار بعد أن يكون `await` قد التقط الوعد بالفعل. ولا يؤدي ذلك إلى إعادة قراءة المتابع الآخر للمتغير، لذا فإن هذه الملفات وحدها لا تحل المتابع إلى `null` أو `""`. ما تنتجه عند التداخل هو حل مشترك وتخطي عملية التحميل لكل طلب. كما أن عملية المسح تجعل الفتحة ذاكرة تخزين مؤقت سيئة للرحلة الواحدة: حيث يسقط أول استمرار يتم استئنافه `current`، ويمكن للمستدعي اللاحق بدء `load()` مختلف بينما لا يزال مستدعي آخر في مرحلة الفك.
2. أصغر تصحيح آمن (عرض الفروق الموحدة)
يجب أن يستدعي كل طلب `load()` بنفسه. يُسمح باستدعاءات `load()` المتزامنة، وكل منها يُرجع حمولة مختلفة، لذا فإن إزالة التكرار على وعد مشترك واحد غير آمن. لا يحتاج ملف `handler.ts` إلى أي تغيير.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. اختباران للرجوع (كود بنمط TypeScript أو Jest)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('الطلبات المتداخلة تُنفَّذ كل منها على حدة وتحتفظ بمحتواها الخاص', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('الحمولة المتداخلة المرفوضة لا تغير الاستجابة الأخرى', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('فشل المعالجة في المصدر'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('فشل المعالجة في المصدر');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. الافتراضات والقيود
لم أقم بتشغيل هذا الكود أو الاختبارات. تفترض الاختبارات وجود مشغل على غرار Jest وملف موجود في مجلد تابع لـ `src/` (على سبيل المثال `test/cache.test.ts`).
تعاملت مع عبارة “حمولة مختلفة لكل طلب” على أنها متطلب يقضي بعدم مشاركة استدعاءات `getPayload` المتداخلة لنفس نتيجة `load()`. إعادة كتابة صحيحة لـ«رحلة واحدة» (`load().finally(() => { current = null; }); return current`) ستظل تربط بين تلك الطلبات، لذا لم أستخدمها. لا يوجد مفتاح ذاكرة التخزين المؤقت، ولم يتم ذكر أي متطلبات لإزالة التكرار.
لا يتم كتابة نص HTTP فارغ حرفيًّا بواسطة العبارات المعروضة إذا نفذت `load` سلسلة غير فارغة. إذا كان هذا العرض ناجمًا عن محول خارج هذه الملفات، فإنه غير مرئي هنا. يزيل التصحيح فقط التداخل الذي تنفذه هذه الملفات فعليًّا. ولا يضيف قفلًا أو محاولات إعادة أو ذاكرة تخزين مؤقتة ذات مفتاح.Grok 4.7 توصلت بشكل صحيح إلى أن مستوى الوحدة النمطية الحالي تؤدي «الوعد» إلى تداخل الطلبات لتقاسم نتيجة محمل واحدة، على الرغم من أن كل طلب يحتاج إلى حمولته الخاصة. وقد اقترح التغيير الآمن الأصغر: إزالة «الوعد» المشترك واستدعاء load() حسب الطلب. غطى اختبارا الانحدار هذين حمولات متزامنة مختلفة، بالإضافة إلى العزل في حالة رفض أحد المُحمِّلات. وكان أقوى جانب في الإجابة هو تحفظها: فقد ذكرت صراحةً أن الكود المعروض يثبت وجود ارتباط بين الطلبات، لكنه لا يفسر بحد ذاته وجود نص أساسي فارغ حرفيًا إذا كان المُحمِّل يُرجع دائمًا سلسلة غير فارغة.
الحكم: نتائج قوية في مجالات دقة تحديد الأسباب الجذرية، ونطاق التصحيحات، وتغطية اختبارات الانحدار، والتعامل مع حالات عدم اليقين.
الاختبار 2: مذكرة بحثية تستند إلى مصادر متضاربة
المهمة 2 — قم بالتوفيق بين الملاحظات البحثية المتضاربة في مذكرة قرار.

استخدم هذه الملاحظات الست فقط واحتفظ باسم المصدر بجانب كل بيان واقعي:

- المورد أ، صفحة الأسعار، 2026-09-20: تبلغ تكلفة خطة الفريق $40 لكل مقعد شهريًا وتشمل 100,000 إجراء.
- المورد ب، منشور مقارنة، 21 سبتمبر 2026: تشمل خطة الفريق الخاصة بالمورد أ 120,000 إجراء لكل مقعد شهريًا.
- مقابلة مع العميل، 18/09/2026: يضم فريقنا 8 مقاعد واستخدم 710,000 عملية الشهر الماضي.
- جدول بيانات مالي، 19/09/2026: الحد الأقصى للميزانية الحالية هو $360 شهريًا.
- المورد «أ»، صفحة الحدود، 2026-09-20: يتم احتساب التجاوز بمعدل $0.004 لكل عملية بعد استنفاد الحصة المضمنة.
- مذكرة المشتريات، 22 سبتمبر 2026: لا يُسمح بالتبديل إلا إذا ظل الإجمالي الشهري في حدود الميزانية وتم التحقق من الحصة المخصصة.

يرجى إعادة هذه الأقسام بالضبط:
1. الحقائق التي تم التحقق منها
2. الادعاءات المنسوبة
3. جدول التضارب
4. الحسابات المستقلة (احسب كل من سيناريو 8 × 100,000 وسيناريو 8 × 120,000، بالإضافة إلى أي تجاوز)
5. التوصية
6. سؤال توضيحي واحد فقط إذا أدى التضارب إلى تغيير التوصية
لا تقم بحل التضارب بين 100,000 و 120,000 بصمت.
1. حقائق مؤكدة
- تبلغ تكلفة خطة “Team” $40 لكل مستخدم شهريًّا (المورد “أ”، صفحة الأسعار، 2026-09-20).
- يضم الفريق 8 مقاعد واستخدم 710,000 عملية الشهر الماضي (مقابلة مع العميل، 18/09/2026).
- يبلغ الحد الأقصى الحالي للميزانية $360 شهريًا (جدول بيانات الشؤون المالية، 19-09-2026).
- يتم احتساب التجاوز بمعدل $0.004 لكل عملية بعد استنفاد الحصة المضمنة (المورد أ، صفحة الحدود، 2026-09-20).
- لا يُسمح بالتبديل إلا إذا ظل الإجمالي الشهري في حدود الميزانية وتم التحقق من الحصة المضمنة (مذكرة المشتريات، 22 سبتمبر 2026).

2. المطالبات المنسوبة
- يشمل الفريق 100,000 عملية مشمولة (المورد أ، صفحة التسعير، 2026-09-20). لا تذكر تلك الملاحظة صراحةً عبارة «لكل مقعد».
- يتضمن فريق المورد أ 120,000 إجراءً لكل مقعد شهريًّا (المورد ب، منشور المقارنة، 21 سبتمبر 2026).

3. جدول التضارب
| البند | الادعاء | المصدر | الحالة |
| --- | --- | --- | --- |
| الإجراءات المشمولة | 100,000 إجراء مشمول؛ لم يُذكر «لكل مقعد» | المورد أ، صفحة الأسعار، 2026-09-20 | لم تُحل |
| الإجراءات المشمولة | 120,000 إجراء شهريًا لكل مقعد | المورد ب، منشور المقارنة، 21 سبتمبر 2026 | لم يُحل |

لم يتم حل التضارب بين الرقمين 100,000 و120,000. لا توضح هذه الملاحظات أي الرقمين هو الصحيح.

4. الحسابات المستقلة
التكلفة الأساسية للمقعد، وهي نفسها في كلا السيناريوهين: 8 مقاعد (مقابلة مع العميل، 18/09/2026) × $40 لكل مقعد شهريًا (المورد أ، صفحة الأسعار، 2026-09-20) = $320 شهريًّا.

تم حساب المضاعفين أدناه وفقًا للطلب. ولا يُعتبر ذلك دليلًا على أن المورد أ قد حدد بدلًا لكل مقعد.

- 8 × 100,000 = 800,000 عملية مشمولة، باستخدام الرقم 100,000 (المورد أ، صفحة الأسعار، 2026-09-20).
- الاستخدام 710,000 (مقابلة مع العميل، 2026-09-18) يقل بمقدار 90,000 عن 800,000، لذا فإن الإجراءات الزائدة = 0.
- رسوم التجاوز = 0 × $0.004 = $0 (المورد «أ»، صفحة الحدود، 2026-09-20).
- الإجمالي الشهري = $320 + $0 = $320، وهو ضمن الحد الأقصى البالغ $360 (جدول بيانات الشؤون المالية، 19/09/2026).

- 8 × 120,000 = 960,000 عملية مشمولة، باستخدام الرقم 120,000 (المورد ب، منشور المقارنة، 21/09/2026).
- الاستخدام 710,000 (مقابلة مع العميل، 18/09/2026) يقل بمقدار 250,000 عن 960,000، لذا فإن الإجراءات الزائدة = 0.
- رسوم التجاوز = 0 × $0.004 = $0 (المورد أ، صفحة الحدود، 2026-09-20).
- الإجمالي الشهري = $320 + $0 = $320، وهو ضمن الحد الأقصى البالغ $360 (جدول بيانات الشؤون المالية، 19/09/2026).

5. التوصية
لا توافق على التغيير في الوقت الحالي. وفقًا لكلتا الحصص المحسوبة، فإن الـ710,000 عملية التي تمت الشهر الماضي (مقابلة مع العميل، 18-09-2026) لا تنتج أي تجاوز ويبلغ الإجمالي الشهري $320، وهو ضمن الحد الأقصى البالغ $360 (جدول بيانات الشؤون المالية، 19-09-2026). ولا تعتمد نتيجة التكلفة هذه على اختيار 100,000 أو 120,000. ولا يزال التبديل لا يستوفي الشرط الثاني: يجب التحقق من الحد المسموح به (مذكرة المشتريات، 22-09-2026)، وتتعارض هذه الملاحظات التي تشير إلى 100,000 (المورد أ، صفحة التسعير، 2026-09-20) في تعارض مع 120,000 (المورد ب، منشور المقارنة، 2026-09-21).

6. سؤال توضيحي واحد فقط إذا كان التضارب يغير التوصية
لا يوجد سؤال توضيحي. التضارب بين 100,000 و120,000 لا يغير التوصية.
تضمنت حزمة الأبحاث تضاربًا متعمدًا حول ما إذا كانت الحصة المخصصة هي 100,000 أم 120,000 عملية لكل مقعد. حافظت Grok 4.7 على الفصل بين المصدرين، ولاحظت أن المصدر الأول لم يذكر صراحةً عبارة “لكل مقعد”، وحسبت كلا السيناريوهين المكونين من ثمانية مقاعد، وأظهرت أن كلاهما ظل عند $320 دون أي تجاوز في الاستخدام المقدم. ومع ذلك، أوصت بتأجيل الموافقة لأن عملية الشراء تتطلب التحقق من الحد المسموح به. وهذا هو التمييز الصحيح بين التوصية المستقرة من الناحية العددية والحقيقة التعاقدية التي لم يتم حسمها.
الحكم: درجة «جيد جدًا» في مجالات الإسناد والحساب وإدارة النزاعات والالتزام بقواعد اتخاذ القرار.
الاختبار 3: ملاحظات غير منظمة حول خطة التنفيذ
المهمة 3 — تحويل ملاحظات المشروع غير المنظمة هذه إلى خطة تنفيذ لمدة أسبوع لا تتجاوز 700 كلمة.

ملاحظات:
- إطلاق الصفحة المقصودة يوم الجمعة الساعة 17:00؛ لكن مالك المنتج ذكر في ملاحظة لاحقة أن الموعد هو صباح الخميس.
- مينا: كتابة العنوان الرئيسي وجدول الأسعار. تذكر مينا أيضًا أنها لن تتمكن من مراجعة النص إلا بعد ظهر يوم الأربعاء.
- أرجون: أحداث التحليلات؛ تذكر ملاحظة مكررة أن مسؤول التحليلات لم يُحدد بعد.
- قسم التصميم لديه مهمتان مكررتان: “تقطيع الصورة الرئيسية للجوال” و“تقطيع الصورة الرئيسية للجوال النهائي”.
- يجب إجراء المراجعة القانونية قبل أي إطلاق عام.
- يحتاج قسم ضمان الجودة إلى يوم كامل بعد توفر أحداث التحليلات.
- سيكون عمر غائبًا بعد ظهر يوم الثلاثاء.
- من المقرر إرسال البريد الإلكتروني الخاص بالإطلاق يوم الجمعة الساعة 16:00.
- غير معروف: من يملك القرار النهائي بالمضي قدمًا أو عدم المضي قدمًا.

المتطلبات: تجميع الأعمال المكررة، ووضع علامة «يُحدد لاحقًا» على المسؤولين غير المعروفين، والحفاظ على كلا الموعدين النهائيين، والإبلاغ عن التناقضات بدلاً من حلها بصمت، والختام بقائمة من خمسة مخاطر.

أعد هذه الأقسام بالضبط:
1. خطة الأسبوع
2. التناقضات والأمور غير المعروفة
3. خمسة مخاطر
لا تختلق أسماء مسؤولين أو تواريخ.
1. خطة أسبوعية

لا توجد تواريخ تقويمية في الملاحظات، لذا لم تتم إضافة أي منها. يتم استخدام النقاط المرجعية والتبعيات المذكورة فقط. يُعتبر العمل التصميمي المكرر مهمة واحدة. تظل المسؤولية عن المهام غير المحددة “يُحدد لاحقًا”. يتم الاحتفاظ بكل من مواعيد الإطلاق المتعارضة.

- النص: تكتب مينا العنوان وجدول الأسعار. ومراجعة النص من جانبها ستكون بعد ظهر يوم الأربعاء فقط.
- التصميم: مهمة واحدة، وهي اقتصاص الصورة الرئيسية للهاتف المحمول، بما في ذلك المراجعة “النهائية”. لم يتم تحديد مسؤول منفصل.
- أحداث التحليلات: يجب أن تكون موجودة قبل مرحلة ضمان الجودة. لم يتم تحديد المسؤول (أرجون في إحدى الملاحظات؛ «يُحدد لاحقًا» في ملاحظة أخرى).
- ضمان الجودة: يوم كامل واحد، فقط بعد توفر أحداث التحليلات. المسؤول «يُحدد لاحقًا». لم يتم تحديد يوم لضمان الجودة هنا.
- المراجعة القانونية: مطلوبة قبل أي إطلاق عام. المسؤول «يُحدد لاحقًا». لم يتم جدولتها في الملاحظات.
- الموافقة/الرفض: المسؤول «يُحدد لاحقًا». لم يتم التعامل مع الأمر على أنه تم البت فيه.
- مواعيد الإطلاق العام، وكلاهما محفوظ: صباح الخميس (مالك المنتج) والجمعة الساعة 17:00 (الصفحة المقصودة).
- البريد الإلكتروني الخاص بالإطلاق: الجمعة الساعة 16:00. المالك: يُحدد لاحقًا.
- عمر غائب بعد ظهر الثلاثاء. لم تُسند أي مهمة في هذه الملاحظات إلى عمر، لذا لم يتم نقل أي منها.

الترتيب، بدون تواريخ جديدة: يجب أن تكون مسودة مينا جاهزة للمراجعة بعد ظهر الأربعاء؛ ويُكمل قسم التصميم اقتصاص الصورة الرئيسية؛ ويقوم المسؤول الذي لم يتم تحديده بعد بتسليم أحداث التحليلات؛ ثم يحصل قسم ضمان الجودة على يوم كامل؛ وتنتهي المراجعة القانونية قبل أي إطلاق عام؛ ولا يزال قرار «المضي قدماً/عدم المضي قدماً» (يُحدد لاحقاً) دون مسؤول. لا تحذف مواعيد الخميس صباحًا، أو الجمعة الساعة 17:00، أو الجمعة الساعة 16:00.

2. التناقضات والمسائل المجهولة

التناقضات (لم تُحل):
- إطلاق الصفحة المقصودة يوم الجمعة الساعة 17:00، بينما تشير مذكرة لاحقة لمالك المنتج إلى صباح الخميس.
- المسؤول عن التحليلات هو أرجون في إحدى الملاحظات، و«يُحدد لاحقًا» في ملاحظة مكررة.

الأمور المجهولة، المُشار إليها بـ«يُحدد لاحقًا»:
- المسؤول النهائي عن قرار المضي قدمًا أو عدم المضي قدمًا.
- المسؤول النهائي عن التحليلات.
- المسؤول عن المراجعة القانونية.
- المسؤول عن ضمان الجودة.
- المسؤول عن البريد الإلكتروني الخاص بالإطلاق.
- المسؤول المسمى عن التصميم بخلاف «التصميم».
- دور عمر؛ لم يُذكر سوى غيابه بعد ظهر يوم الثلاثاء.
- أي وقت من أوقات الإطلاق هو الموثوق به، وما إذا كانت رسالة البريد الإلكتروني المقررة يوم الجمعة الساعة 16:00 تتطابق مع أي من هذين الوقتين. لم يتم ذكر أي تواريخ تتجاوز أوقات أيام الأسبوع هذه.

3. خمسة مخاطر

1. لا يمكن أن يكون كل من صباح الخميس والجمعة الساعة 17:00 موعدًا لإطلاق الصفحة المقصودة؛ فاستخدام أي منهما دون اتخاذ قرار قد يؤدي إلى الإطلاق مبكرًا أو تفويت الموعد النهائي الآخر.
2. تم تحديد وقت إرسال البريد الإلكتروني الخاص بالإطلاق ليكون يوم الجمعة الساعة 16:00، قبل الساعة 17:00 من يوم الجمعة، ولم يتم مواءمته في الملاحظات مع صباح يوم الخميس، لذا قد يتم إرساله في وقت لا تكون فيه الصفحة بعد في الحالة المقصودة أو لم تعد فيها.
3. هناك خلاف حول مسؤولية التحليلات، لذا قد تتأخر الأحداث؛ لا تزال عملية ضمان الجودة (QA) تحتاج إلى يوم كامل بعد الأحداث وقد لا تتناسب مع أي من موعدَي الإطلاق المحددين.
4. يجب أن يسبق المراجعة القانونية أي إطلاق عام، ولكن لا يوجد مسؤول عنها أو موعد مخصص لها، لذا قد يتم حظر الإطلاق أو قد يتم دون مراجعة.
5. لم يتم تعيين مسؤول عن قرار «المضي قدماً» أو «عدم المضي قدماً»، لذا لا يوجد شخص محدد لكل من الموعدين النهائيين الصارمين للموافقة على الإطلاق أو إيقافه.
قام الإصدار Grok 4.7 بدمج المهمة المكررة الخاصة بـ «mobile-hero»، وحافظ على تعارض موعد الإطلاق بين صباح الخميس والساعة 17:00 من يوم الجمعة، وأبقى على الموعد النهائي لإرسال البريد الإلكتروني في الساعة 16:00 من يوم الجمعة، ووضع علامة «TBD» (يُحدد لاحقًا) على المسؤولين الذين لم يتم تحديدهم بعد، وانتهى بعدد خمسة مخاطر بالضبط. ولم يحدد أي تواريخ تقويمية أو مسؤولين. كانت نقطة الضعف هي قابلية التنفيذ: فبدلاً من توزيع العمل على تسلسل من الاثنين إلى الجمعة، قدمت قائمة تبعيات مرتبة وأشارت إلى أنه لا يمكن تحديد يوم لـ QA. هذا الحذر مبرر، لكن السؤال طلب خطة تنفيذ لمدة أسبوع واحد، لذا فإن الإجابة لم تستوفِ الصيغة المطلوبة إلا جزئيًا.
الحكم: نجاح جزئي: الحفاظ على القيود ممتاز، أما الفائدة في مجال الجدولة فهي أقل.
ما هي التغييرات التي أدخلتها النسخة Grok 4.7 على سير العمل الفعلي؟
أفضل طريقة لفهم هذا الإطلاق هي النظر إليه كمسألة تتعلق بسير العمل: في أي الحالات يقلل الاستدلال المستمر من عبء المراجعة، وفي أي الحالات يؤدي ببساطة إلى إجابة أطول؟ تشير المهام الثلاث المتعلقة بواجهة برمجة التطبيقات (API) إلى نمط عملي. يُظهر Grok 4.7 قدرة جيدة على إبقاء عدة قيود مرئية في آن واحد، خاصةً عندما يطلب منه السؤال الفصل بين الحقائق والافتراضات. لكنه يكون أقل إقناعًا عندما تتطلب المهمة تقويمًا محددًا أو تسلسلًا تنفيذيًا لا تحدده الملاحظات المصدرية بشكل كامل.
الترميز وتصحيح الأخطاء
بالنسبة لأعمال المستودع، يُعد هذا النموذج أكثر ملاءمة للتشخيص المحدود النطاق مقارنة بطلب مفتوح مثل “إنشاء تطبيق”. زوده بأصغر مجموعة ملفات مفيدة، ووصف أعراض الفشل، واشترط تحديد السبب الجذري قبل إصدار التصحيح. اطلب إجراء اختبارات تفشل قبل التغيير وتنجح بعده. في اختبار المعالج الخاص بنا، بقيت الإجابة قريبة من الكود المقدم وامتنعت عن اختلاق سبب خارجي لأعراض النص الفارغ.
هذا السلوك مهم لأن جودة البرمجة لا تقتصر على إنشاء الكود فحسب. فالاستجابة البرمجية المفيدة يجب أن تحافظ على التصميم المحلي، وتحد من الفروق، وتحدد الافتراضات، وتجعل عملية التحقق أقل تكلفة. وقد حققت Grok 4.7 هذه الأمور في مهمة صغيرة واحدة، لكن مهمة واحدة لا يمكنها أن تضمن الموثوقية على نطاق المستودع. يجب على الفرق تكرار نفس المعايير على الأخطاء الحقيقية، وعمليات إعادة الهيكلة، والتغييرات التي تشمل ملفات متعددة، والمسارات الحساسة من الناحية الأمنية قبل نقل العمل إلى بيئة الإنتاج.
البحث وتوليف المصادر
وكشفت مهمة البحث عن نقطة قوة أخرى، وهي: الانضباط في تحديد المصادر والحدود. فلم يقم Grok 4.7 بدمج ادعاء البائع بـ 100,000 عملية مع الرقم 120,000 الوارد في المنشور المقارن دون توضيح. كما ميزت بين الحساب الذي يظل ثابتًا في كلا السيناريوهين وبين شرط الشراء الذي لا يزال يتطلب التحقق.
هذا هو النمط المناسب للأعمال التي تعتمد بشكل كبير على البحث. اطلب من النموذج تصنيف الحقائق المؤكدة، والادعاءات المنسوبة، والتناقضات التي لم تُحل، والحسابات، والتوصيات بشكل منفصل. فحتى المذكرة المُحسّنة قد تكون خاطئة إذا قامت بتحويل ادعاء ثانوي إلى حقيقة غير مذكورة المصدر. كانت إجابة Grok 4.7 مفيدة لأنها أبقت التناقض ظاهرًا على الرغم من أن النتيجة الحسابية لم تتغير.
التخطيط والعمليات
وقد اتضحت أوجه القصور بشكل أكبر عند مرحلة التخطيط. فقد حافظ النموذج على كل موعد نهائي ومالك غير معروف، لكنه لم يصل إلى حد وضع جدول زمني من الاثنين إلى الجمعة. وهذا أمان أكثر من اختلاق تواريخ، لكنه يعني أن المستخدم لا يزال مضطرًا إلى تحويل التبعيات إلى مهام في التقويم.
بالنسبة لتوجيهات العمليات، قم بتضمين أفق التخطيط، وأيام العمل المتاحة، وتوافر المالك، وصانع القرار. إذا كانت هذه الحقول غير موجودة، فاطلب أولاً خريطة التبعيات، ثم التقويم. هذا سير العمل المكون من مرحلتين يجعل التحذير الذي يصدره النموذج مفيدًا، بدلاً من اعتباره فشلًا في اتخاذ القرار.
الاسترجاع في سياق طويل
تؤدي نافذة السياق التي تبلغ 500 ألف إلى تغيير ما يمكن أن يتسع له طلب واحد، ولكنها لا تغير ما يمكن الوثوق به دون التحقق. وينبغي أن تستخدم المهام التي تعتمد على سياق طويل «اختبارات الاسترجاع»: ضع الحقائق الحاسمة بالقرب من بداية الحزمة ووسطها ونهايتها؛ وأضف تعارضًا واحدًا متعمدًا؛ ثم اطلب اتخاذ قرار مع تحديد مواقع المصادر. وقم بقياس كل من معدل الاسترجاع والالتزام بالحدود.
لا تحكم على مسار ذي سياق طويل بناءً على ما إذا كان يقبل طلبًا كبيرًا أم لا. سجل الأماكن التي يغفل فيها النموذج الحقائق، وما إذا كان يولي أهمية مفرطة للجزء الأخير، ومدى زيادة زمن الاستجابة مع زيادة حجم المدخلات، وما إذا كان المزود يقوم باقتطاع الطلب أو تحويله. إن النافذة الكبيرة المعلن عنها هي مجرد ادعاء بالسعة، وليست ضمانًا لاستنتاجات مستقرة عند الحد الأقصى.
كيفية تقييم Grok 4.7 بنفسك
استخدم مجموعة اختبار صغيرة وقابلة للتكرار قبل تغيير الإعدادات الافتراضية في بيئة الإنتاج. والهدف هنا ليس إعادة إنشاء لوحة نتائج، بل مقارنة النموذج مع المسار وعملية المراجعة التي تدفع مقابلها بالفعل.
- تجميد المدخلات. احفظ النص الدقيق للموجه، والملفات، وحزمة المصدر، ومعرّف النموذج، ودرجة الحرارة، وإعدادات الاستدلال، وأذونات الأداة. لا تقارن مسارًا مباشرًا بمسار مزود الخدمة أثناء تغيير النص الدقيق للموجه في الوقت نفسه.
- قيم العمل، لا الأسلوب. بالنسبة للبرمجة، قم بتقييم دقة تحديد الأسباب الجذرية، ونطاق التصحيح، والاختبارات، والافتراضات. أما بالنسبة للبحث، فقم بتقييم حدود الاستشهادات، والحسابات، والتعارضات، وجودة التوصيات. وبالنسبة للتخطيط، قم بتقييم الالتزام بالمواعيد النهائية، والمسؤولية، والتبعيات، وقابلية التنفيذ.
- سجل عملية النقل بشكل منفصل. قم بتسجيل «الوقت المستغرق حتى الحصول على الرمز الأول»، والوقت الإجمالي، ووضع البث/غير البث، وحالة HTTP، وسلوك إعادة المحاولة في سجل المسار. لا يُعتبر انتهاء مهلة البوابة فشلًا في جودة النموذج تلقائيًّا، لكنه يمثل مع ذلك تكلفة إنتاجية.
- تحقق من سلوك الفشل. أدرج مدخلاً غامضًا واحدًا، ومصدرًا متضاربًا واحدًا، ومجموعة ملفات غير مكتملة عمدًا واحدة. والسؤال المهم هنا هو: هل يقوم النموذج بالإشارة إلى عدم اليقين أم يملأ الفجوة بتخمين واثق؟.
- استعرضوا التكلفة والجهد معًا. تتبع رموز الإدخال، ورموز الإخراج، وبيانات الإدخال المخزنة مؤقتًا، ورموز الاستدلال عند الكشف عنها، ودقائق المراجعة البشرية. فقد لا تكون الاستجابة الأرخص التي تستغرق ضعف الوقت للتحقق منها أرخص في الواقع.
- كرر ذلك قبل التبديل. قم بتنفيذ كل مهمة مرتين على الأقل أو على عدة أمثلة تمثيلية قبل تغيير الإعداد الافتراضي للفريق. احتفظ بالإجابة الأولية المرئية وملاحظات التقييم حتى يتمكن مراجع آخر من إعادة إنتاج القرار.
تُعد التجارب الثلاث الواردة في هذه المراجعة عينة أولية، وليست بديلاً عن مجموعة التقييم الخاصة بالفريق. وهي توضح كيفية أداء نموذج Grok 4.7 في مهمة ترميز واحدة، ومذكرة واحدة تتعلق بتعارض المصادر، وحزمة تخطيط واحدة؛ ولا تُحدد هذه التجارب ترتيبًا عامًّا.
أسعار Grok 4.7 والوصول إلى واجهة برمجة التطبيقات (API)
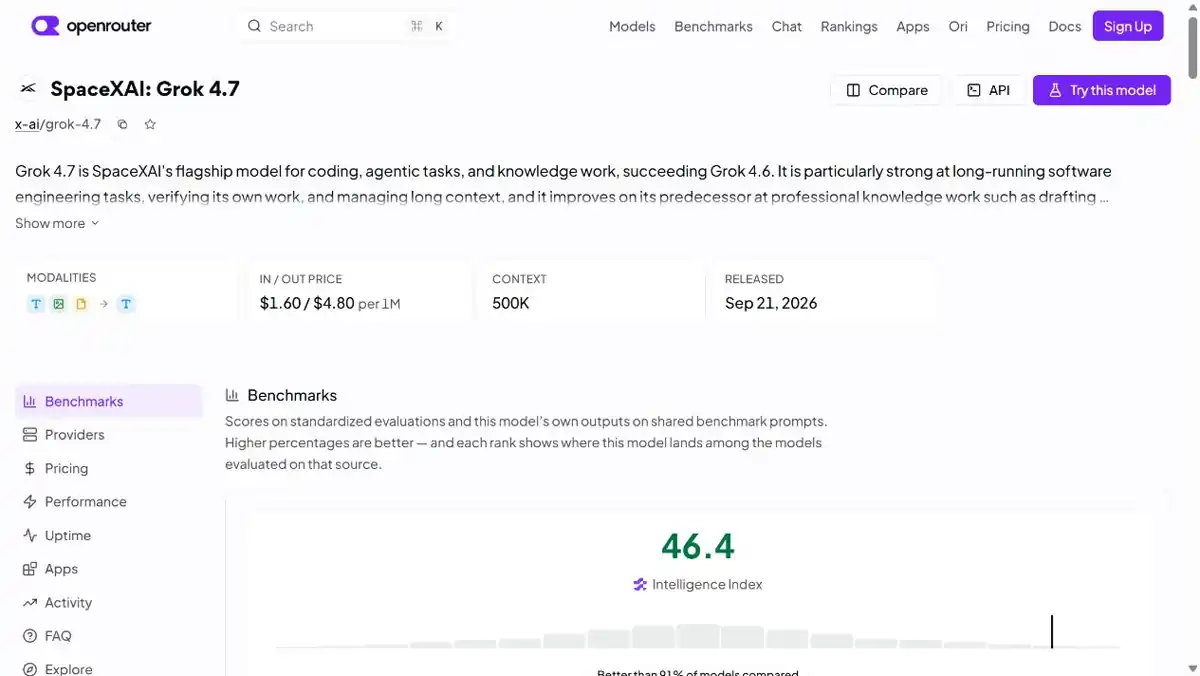
غالبًا ما تصبح مراجعات النماذج مضللة عندما يتعلق الأمر بالأسعار. فهناك ثلاثة أرقام مختلفة على الأقل قد يراها القارئ: سعر واجهة برمجة التطبيقات (API) المباشر لشركة xAI، وسعر المسار الذي يحدده المُجمِّع، وسعر اشتراك المستهلك. وهذه الأرقام ليست متبادلية.
وفقًا لإعلان شركة xAI، يتم تقديم الإصدار Grok 4.7 بنفس سعر وسرعة الإصدار Grok 4.6. وتشير صفحة الإطلاق إلى أن سعر الطراز القياسي يبدأ من $2 لكل مليون توكن مدخَل و $6 لكل مليون توكن من التوكنات الصادرة; ؛ ويورد موقع «Artificial Analysis» بشكل مستقل نفس الأرقام المتعلقة بالمسار المباشر و $0.50 لكل مليون رمز إدخال مخزّن مؤقتًا. وتشير xAI أيضًا إلى أن الإصدار السريع يضاعف سرعة الإنتاج مقابل ضعف السعر. استخدم الوثائق الرسمية للمطورين للتحقق من عقد واجهة برمجة التطبيقات (API) الحالي ومدى توفر الخدمة الخاصة بالحساب قبل إرسال حركة المرور في بيئة الإنتاج.
صفحة Grok من OpenRouter، 4.7 يعرض $1.60 لكل مليون توكن مدخل و $4.80 لكل مليون توكن مُصدر بالنسبة لمسارها. هذا سعر OpenRouter/المزود، وليس تصحيحًا لسعر القائمة المباشر لشركة xAI. قد تختلف عمليات التوجيه، وهامش الربح، والتخزين المؤقت، والحدود، والتوافر باختلاف المزود.
لا توجد إجابة واحدة دقيقة على السؤال “كم تبلغ تكلفة Grok 4.7؟” دون تحديد المسار. بالنسبة لمشتري مادة API، قم بالمقارنة بين:
- معدلات الرموز عند الإدخال والإخراج؛;
- معالجة المدخلات المخزنة مؤقتًا؛;
- السياق وحدود المخرجات؛;
- حدود الاستخدام وتوافر الخدمة في المناطق المختلفة؛;
- ما إذا كان المزود يوفر ضوابط للتحليل المنطقي؛;
- شروط التسجيل والاحتفاظ بالبيانات ومعالجتها.
فيما يتعلق بوصول المستهلكين، لا تفترض أن سعر واجهة برمجة التطبيقات (API) يعبر عن سعر اشتراك X أو Grok. فقد تختلف قواعد الوصول باختلاف خطة المستهلك ومسار واجهة برمجة التطبيقات (API) ومزود خدمات التجميع التابع لجهة خارجية.
ما هو مسار واجهة برمجة التطبيقات (API) الذي ينبغي عليك اختياره؟
| المسار | الأفضل لـ | ما يجب التحقق منه قبل الاستخدام | المفاضلة الرئيسية |
|---|---|---|---|
| واجهة برمجة تطبيقات Direct xAI | أنظمة الإنتاج التي تتطلب عقدًا خاصًا بالمزود | المعرّف الرسمي للطراز، وحدود الاستخدام، شروط البيانات، المناطق، خدمة البث، والسعر الحالي | أكثر مصادر التوريد شفافيةً، لكنك تتولى إدارة الفواتير والتوافر بشكل مباشر |
| الموجه المفتوح (OpenRouter) | مقارنة سريعة بين مزودي الخدمة وتجربة المسارات | مزود الخدمة الفعلي في المرحلة الأولية، وسعر المسار، والتخزين المؤقت، والخصوصية، والسياق، وسلوك الحل البديل | التبديل أسهل، لكن المسار يختلف عن خدمة xAI المباشرة |
| واجهة برمجة تطبيقات (API) للاختبار متوافقة مع OpenAI | تقييم داخلي أو عميل قديم يدعم بالفعل مخطط OpenAI | تعيين النماذج، وحدود مهلة الانتظار، دعم البث المباشر، حقول الاستخدام، فترة الاحتفاظ بالبيانات، ودلالات الأخطاء | تكامل سهل، لكن التوافق لا يضمن أن يتصرف المزودان بنفس الطريقة |
تم إرجاع المسار المتوافق المستخدم في الجزء العملي grok-4.7 ودعم البث المباشر. وقد تجاوز طلب الترميز غير المتعلق بالبث فترة انتظار البوابة قبل اكتمال إعادة المحاولة الخاصة بالبث. وتعد هذه الملاحظة مفيدة عند تصميم عميل، ولكن لا ينبغي نسخها في ادعاء يتعلق بزمن الوصول لـ DirectX AI.
كيفية الوصول إلى Grok 4.7
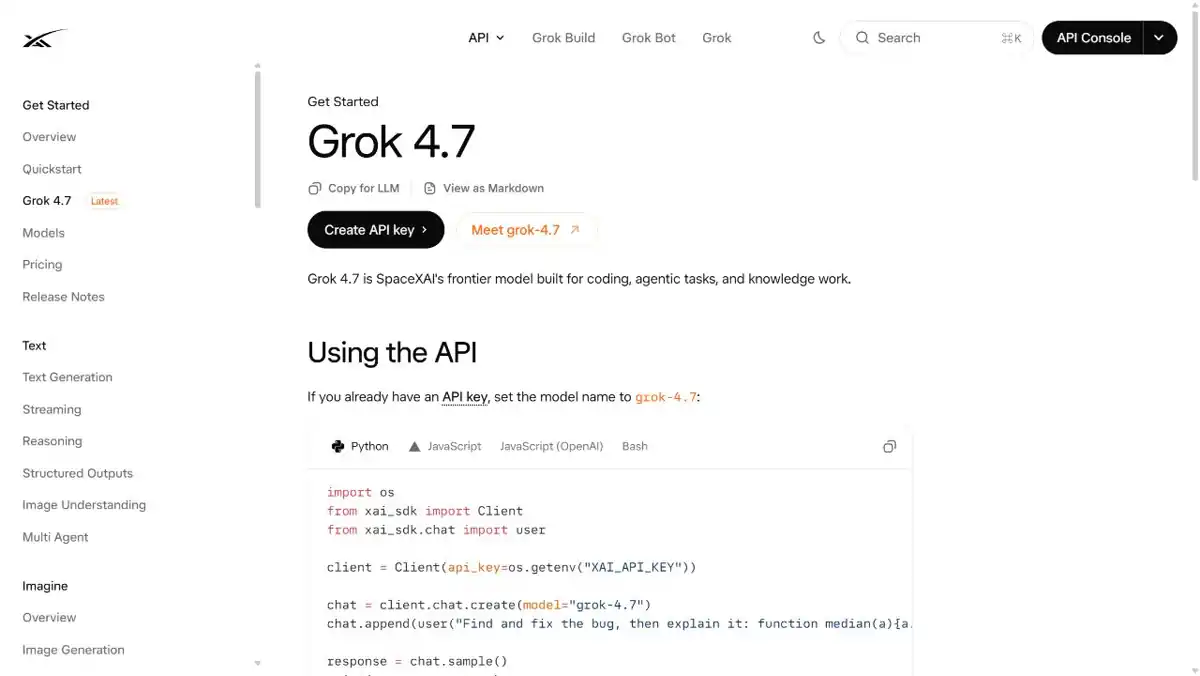
الطريقة الأسهل هي البدء بـ إعلان xAI و صفحة مطوري xAI, ، ثم تأكد مما إذا كنت بحاجة إلى إصدار Grok Build أو Cursor أو واجهة برمجة التطبيقات (API) المباشرة أو أداة تجميع. تقول xAI إن Grok 4.7 متاح في Cursor وGrok Build، ومن خلال واجهة برمجة تطبيقات Grok، ومن خلال أدوات البرمجة الخارجية، وموجهات النماذج، والمنصات السحابية. ويحدد هذا التمييز الفوترة، وضوابط النموذج، وشروط الخصوصية، والأدوات المتاحة.
إذا كنت تستخدم أداة تجميع، فافتح صفحة النموذج الخاصة بها وتحقق من مسار المزود، وأسعار الرموز، وحد السياق، ومعرّف النموذج قبل البدء في البناء استنادًا إليه. يُعد OpenRouter مسارًا موثقًا واحدًا، لكن لا ينبغي نسخ أسعاره إلى جدول فوترة xAI.
بالنسبة للقراء الذين يرغبون في مقارنة عدة مجموعات من النماذج في مساحة عمل واحدة،, مساحة العمل متعددة النماذج في GlobalGPT يمكن أن يكون مفيدًا في تقييم المطالبات جنبًا إلى جنب. هذه المقالة تقوم بـ لا يُزعم أن مسار Grok 4.7 متوفر بالفعل هناك. أما المسار الوارد في الكتالوج الذي تم التحقق منه، فهو مسألة تتعلق بالتوافر بشكل منفصل، ويجب التحقق منه عبر واجهة المستخدم الخاصة بالمنتج قبل الشراء.
Grok 4.7 مقابل ChatGPT وClaude وGemini
تتضمن هذه المراجعة ثلاث نتائج لمهمة Grok 4.7، ولكن لا توجد تجارب مقارنة مع ChatGPT أو Claude أو Gemini. ولذلك، فإن الاستنتاج العام القائل بأن “Grok 4.7 تتفوق” سيظل مجرد دعاية تسويقية، وليس تحليلاً. ويعتمد الاختيار الأفضل على العمل المرتبط بالنموذج:
| إذا كانت أولويتك هي... | ابدأ بتقييم… | لماذا |
|---|---|---|
| حزم تقنية طويلة | Grok 4.7 والمسارات الأخرى ذات السياق الواسع | تحقق من دقة الاسترجاع، وليس فقط من الفترة الزمنية المعلن عنها |
| تصحيح أخطاء المستودع | Grok 4.7، وهو نموذج يركز على البرمجة، وحلقة الاختبار المعتادة | مقارنة الجودة من حيث الأسباب الجذرية ومدة المراجعة |
| البحوث التي تركز على المصادر | سير عمل موجه نحو البحث بالإضافة إلى نموذج استدلال عام | تحقق من المراجع قبل قبول الاستنتاجات |
| عمليات تكامل الإنتاجية الحالية | النموذج المدمج بالفعل في أدواتك | قد تفوق تكلفة التبديل المكاسب المحققة من المؤشر المعياري |
| أقل فاتورة API | المسارات المباشرة ومسارات المجمّعين جنبًا إلى جنب | تختلف الأسعار باختلاف المزود وسلوك ذاكرة التخزين المؤقت |
إن “دليل ”أي تقنية ذكاء اصطناعي تستحق أن تدفع مقابلها؟» تطرح السؤال الصحيح عند الشراء: ما هي المهمة المتكررة التي ستتحسن بما يكفي لتعويض تكلفة الاشتراك أو فاتورة واجهة برمجة التطبيقات (API)؟ هذه قاعدة اتخاذ قرار أكثر استدامة من السعي وراء أحدث إضافة إلى قائمة المتصدرين.
القيود والمسائل المعلقة
إن نسخة Grok 4.7 حديثة جدًّا بحيث لا يمكن التوصل إلى إجماع مستقل واسع النطاق بشأنها. وتُترك الأدلة المتوفرة العديد من الأسئلة مفتوحة:
- ما مدى اتساق هذا التحسن في مجالات البرمجة والبحث والكتابة والمهام متعددة الوسائط؟
- هل يظل سياق 500 ألف موثوقًا به عند الاقتراب من الحد الأقصى، أم أن جودة الاسترجاع تتدهور قبل ذلك؟
- ما مقدار الزيادة في زمن الاستجابة التي يسببها بذل أقصى جهد في التفكير؟
- ما هي خطط المستهلكين والمناطق والأدوات وحدود المعدلات التي تُعرِّض النموذج للخطر؟
- كيف تؤثر الإجراءات الوقائية الجديدة على الأعمال الفنية المشروعة ولكن الحساسة؟
- هل تُقدم كل من xAI وOpenRouter ومزودي الخدمة الآخرين نتائج أو حدودًا تختلف اختلافًا جوهريًّا؟
هذه الأسئلة ليست أسبابًا لاستبعاد النموذج. بل هي سبب لإجراء تقييم صغير وممثل قبل ترحيل مسار العمل أو الوعد بتحقيق وفورات في التكاليف.
من الذي ينبغي أن يستخدم Grok 4.7؟
يُوصى بتجربة الإصدار Grok 4.7 أولاً إذا كنت:
- تصحيح الأخطاء في الكود أو تحليل المواد الفنية لفترات طويلة؛;
- التعامل مع حزم البيانات المصدر التي تتجاوز حجم نوافذ الدردشة العادية؛;
- نقدّر النموذج الذي يُبدي استعدادًا لبذل مجهود أكبر في التعامل مع المطالبة الصعبة؛;
- يمكن مراجعة المخرجات بدلاً من إرسالها مباشرةً إلى مرحلة الإنتاج؛;
- يقومون بمقارنة الجدوى الاقتصادية بين استخدام واجهة برمجة التطبيقات (API) المباشرة وخدمات التجميع.
قد لا يكون هذا الخيار مناسبًا تمامًا إذا كنت بحاجة إلى تكامل متطور، أو خطة استخدام موثقة بوضوح، أو ميزة مثبتة في أداء المهمة نفسها مقارنةً بالنموذج الموجود بالفعل في منظومتك. في هذه الحالات، قد تكون طبقة الوصول وسير العمل أكثر أهمية من مكاسب مؤشر بمقدار نقطتين.
الأسئلة الشائعة
ما هو Grok 4.7؟
Grok 4.7 هو الإصدار الذي أطلقته xAI في 21 سبتمبر 2026 للبرمجة والأعمال المعرفية. وتقول xAI إن هذا الإصدار يعمل لفترة أطول على المهام الصعبة، ويدقق في عمله بعناية أكبر، ويضيف مجموعة جديدة من إجراءات الحماية، مع الحفاظ على نفس السعر والسرعة اللذين يتميز بهما الإصدار Grok 4.6.
متى تم إصدار الإصدار Grok 4.7؟
أعلنت شركة xAI عن الإصدار Grok 4.7 في 21 سبتمبر 2026. وتعد صفحة الإطلاق الرسمية ووثائق المطورين أفضل المصادر للحصول على معلومات حول حالة الإصدار وتوافر النماذج والتغييرات في واجهة برمجة التطبيقات (API).
هل طراز Grok 4.7 أفضل من طراز Grok 4.6؟
تشير «Artificial Analysis» إلى مؤشر ذكاء يبلغ 46، أي أعلى بنقطتين من Grok 4.6، ومؤشر «Elo» لـ «AA-Briefcase» يبلغ 1,657، أي أعلى بـ 111 نقطة من 4.6. وتُعد هذه إشارات مفيدة، وليست نتيجة عامة تنطبق على كل مسار عمل.
ما هي نافذة السياق في Grok 4.7؟
يحدد «Artificial Analysis» نافذة سياق تضم 500 ألف توكن لـ Grok 4.7. ولا تضمن النافذة الكبيرة استرجاعًا مثاليًّا، لذا يجب اختبار النموذج باستخدام حقائق موضوعة في نقاط مختلفة ضمن مستند طويل قبل الاعتماد عليه في الأعمال التي تتطلب مصادر كثيرة.
كم يبلغ سعر Grok 4.7 API؟
تشير «Artificial Analysis» إلى أن معدل استهلاك واجهة برمجة التطبيقات (API) المباشر يبلغ $2 لكل مليون توكن مدخل و$6 لكل مليون توكن مخرج، بينما يبلغ معدل الاستهلاك عند استخدام المدخلات المخزنة مؤقتًا $0.50 لكل مليون توكن. يرجى مراجعة الوثائق الحالية لـ xAI قبل الاستخدام في بيئة الإنتاج.
هل سعر جهاز Grok 4.7 من OpenRouter هو نفسه سعر جهاز xAI؟
لا. يحدد OpenRouter سعر $1.60 لكل مليون توكن مدخل و$4.80 لكل مليون توكن مخرج لمساره. وهذا سعر خاص بالمزود ويجب مقارنته بشكل منفصل عن أسعار واجهة برمجة التطبيقات (API) المباشرة لشركة xAI. كما يعرض OpenRouter حقولًا خاصة بالمزود تتعلق بالذاكرة المؤقتة (cache) وزمن الاستجابة (latency) وسعة النقل (throughput) والخصوصية، والتي يمكن أن تغير التكلفة الفعلية للمسار.
كيف يمكنني الوصول إلى الإصدار Grok 4.7؟
ابدأ بالاطلاع على الإعلان الرسمي لشركة xAI ووثائق المطورين الخاصة بها، ثم اختر منتج Grok المخصص للمستهلكين، أو واجهة برمجة تطبيقات xAI المباشرة، أو أداة تجميع مثل OpenRouter. تحقق من معرّف النموذج، والمنطقة، وحدود المعدل، والسياق، والفوترة على المسار الذي تخطط فعليًّا لاستخدامه.
هل الإصدار Grok 4.7 متوفر على الإصدار GlobalGPT؟
لا تدعي هذه المراجعة وجود مسار Grok 4.7 تم التحقق منه على طراز GlobalGPT. يمكن استخدام طراز GlobalGPT لمقارنة مجموعات الطرازات المتاحة، ولكن يجب التحقق من الكتالوج الحالي وتوافر الطرازات المحددة في واجهة مستخدم المنتج قبل الشراء.
هل يُعد طراز Grok 4.7 خيارًا مناسبًا لعوامل الترميز؟
يُعد هذا الاختبار مفيدًا في مجالات التصحيح المحدود، ومراجعة الكود، والاستدلال متعدد الملفات، حيث يتعين على الوكيل شرح الافتراضات وإجراء الاختبارات. كانت مهمة البرمجة العملية قوية، لكنها لم تختبر تنفيذ الأدوات، أو تعديل المستودع، أو الأذونات، أو دورة الوكيل الكاملة.
لماذا كان اختبار البرمجة يحتاج إلى البث المباشر؟
تجاوز الطلب الأول غير المتدفق نافذة انتظار بوابة مسار الاختبار. أما الطلب نفسه فقد اكتمل بنجاح عند تمكين التدفق. وهذا يوضح سبب ضرورة أن تدعم عملاء الإنتاج التدفق ومهلات الانتظار الصريحة؛ لكنه لا يثبت أن كل مسار من نوع Grok 4.7 له نفس سلوك زمن الوصول.
كيف يمكنني اختبار نافذة السياق التي تبلغ 500 ألف؟
استخدم حزمة ثابتة تتضمن حقائق حاسمة موضوعة في البداية والوسط والنهاية، بالإضافة إلى تعارض واحد مقصود. اطلب تحديد مواقع المصادر وقم بتقييم مدى التذكر، وكيفية التعامل مع التعارضات، ووقت الاستجابة عند عدة أحجام للمدخلات، بدلاً من الاعتماد على الحد الأقصى المعلن عنه وحده.
هل يستحق الإصدار Grok 4.7 الترقية من الإصدار Grok 4.6؟
تشير الدلائل الأولية إلى أن الترقية مجدية وإن كانت تدريجية: فقد تحسنت القياسات المستقلة، وأظهرت التجربة العملية أداءً قويًّا في تصحيح الأخطاء وتوليف المصادر. لا تقم بالترقية إلا بعد أن تظهر مهامك الخاصة جهدًا أقل في المراجعة أو دقة أفضل، بتكلفة مرتبطة بمسار معين يمكنك تبريرها.
الحكم النهائي
يبدو أن الإصدار Grok 4.7 يمثل ترقية جادة وتدريجية للنموذج، مع هدف واضح: أعمال البرمجة والمعرفة التي تكافئ الجهد المستمر. يقدم الإصدار الرسمي تفسيرًا موثوقًا لهذا التغيير، وتُظهر الأرقام الأولية لـ Artificial Analysis تحسنًا مقارنةً بـ Grok 4.6 بدلًا من التراجع، كما تضيف تجربة تشغيل واجهة برمجة التطبيقات (API) الخاصة بنا إشارة عملية صغيرة. تعامل النموذج بشكل جيد للغاية مع خطأ في التزامن ومذكرة ذات مصدر متعارض؛ وكانت إجابته التخطيطية دقيقة ولكنها لم تكن عملية بالقدر المطلوب.
الحكم الصادق لا يزال مؤقتًا. فقد كانت هذه ثلاث جولات منفردة عبر مسار اختبار واحد، وتطلبت المهمة الأبطأ إجراء البث المباشر بعد انقضاء مهلة البوابة في حالة عدم البث، ولا توجد جولة مماثلة لأي منافس أو إجماع مستقل واسع النطاق. ابدأ بمهمة صعبة واحدة من سير عملك الفعلي، وقارن النتائج ووقت المراجعة مع النموذج الذي تستخدمه بالفعل، ثم قرر ما إذا كانت الترقية تستحق التكلفة الخاصة بهذا المسار.









