
مراجعة Claude Opus 5.5: السعر، ونتائج الاختبارات القياسية، واختبارات واجهة برمجة التطبيقات (API) الفعلية
يجمع نموذج Claude Opus 5.5 بين نافذة سياق تضم مليون رمز وسعر واجهة برمجة التطبيقات (API) يبلغ $4 / $20 لكل مليون رمز. تفصل هذه المراجعة بين الادعاءات المنشورة لـ Anthropic، ولقطات المقارنة المعيارية المستقلة، وخمس عمليات تنفيذ مباشرة للمهام عبر مسار واجهة برمجة التطبيقات (API) الخاصة بالرسائل.
النتيجة المقاسة محددة. أعطت ثلاث مهام إجابات صحيحة وقابلة للاستخدام؛ أما مهمة البرمجة فقد أعطت إجابة مفيدة لكنها وصلت إلى الحد الأقصى الأول البالغ 1,024 رمزًا؛ أما عملية الكتابة باللغة الصينية فقد أنتجت نصًّا مشوّهًا على المسار الذي خضع للاختبار. تُظهر العينة سلوكًا محددًا وحدودًا للمسار، وليست معدل نجاح عامًّا.
إجابة سريعة
- الأداء: أظهر اختبار Anthropic أداءً على مستوى Fable 5.1 في معظم المهام، بينما سجل اختبار «التحليل الاصطناعي» درجة 58 في مؤشر الذكاء عند بذل أقصى جهد. ولم تُظهر أدلة اختبار METR، التي تركز بشكل أضيق على مهارات التقدير، تحسناً كبيراً مقارنةً باختبار Fable 5.1.
- السعر: السعر الرسمي وفقًا لواجهة برمجة التطبيقات (API) هو $4 لكل مليون توكن مدخل و$20 لكل مليون توكن مخرج. تبلغ تكلفة عمليات القراءة من ذاكرة التخزين المؤقت $0.20 لكل مليون عملية؛ وتبلغ تكلفة عمليات الكتابة إلى ذاكرة التخزين المؤقت لمدة 5 دقائق $5 لكل مليون عملية.
- النتيجة العملية: تم اجتياز اختبارات استخراج النصوص الطويلة، وJSON الصارم، والاستدلال الحسابي في الجولات المسجلة. كان الترميز مفيدًا، لكنه توقف عند الحد الأقصى المحدد مسبقًا. تم تسجيل النتيجة الخاصة باللغة الصينية على أنها مشكلة تتعلق بالمسار أو الترميز، وليست حكمًا لغويًّا على مستوى النموذج.
- تحذير بشأن واجهة برمجة التطبيقات (API): لا يمكن تعطيل التفكير، ويؤدي فرض استخدام الأداة إلى ظهور خطأ، وترتبط كتل التفكير بالنموذج والمحادثة، والأقدم
computer_20251124لا يُسمح باستخدام هذه الأداة في واجهة برمجة التطبيقات (API) Claude ومسار Google Cloud.

ما ورد في الوثائق الرسمية
تشير صفحة إصدار Anthropic إلى أن تاريخ إصدار Claude Opus 5.5 هو 22 سبتمبر 2026، وتصفه بأنه أول طراز في عائلة Claude 5.5. ويزعم الإعلان أن الأداء يوازي مستوى Claude Fable 5.1 في معظم المهام، وأن تكلفة الحمل العملي النموذجية أقل بمقدار 40% مقارنةً بـ Opus 5، كما أن الإنتاج أسرع بمقدار 30% مقارنةً بـ Opus 5. هذه ادعاءات من جانب المزود، لذا يتم عرضها بشكل منفصل عن الأدلة المستقلة والتجريبية الواردة أدناه.
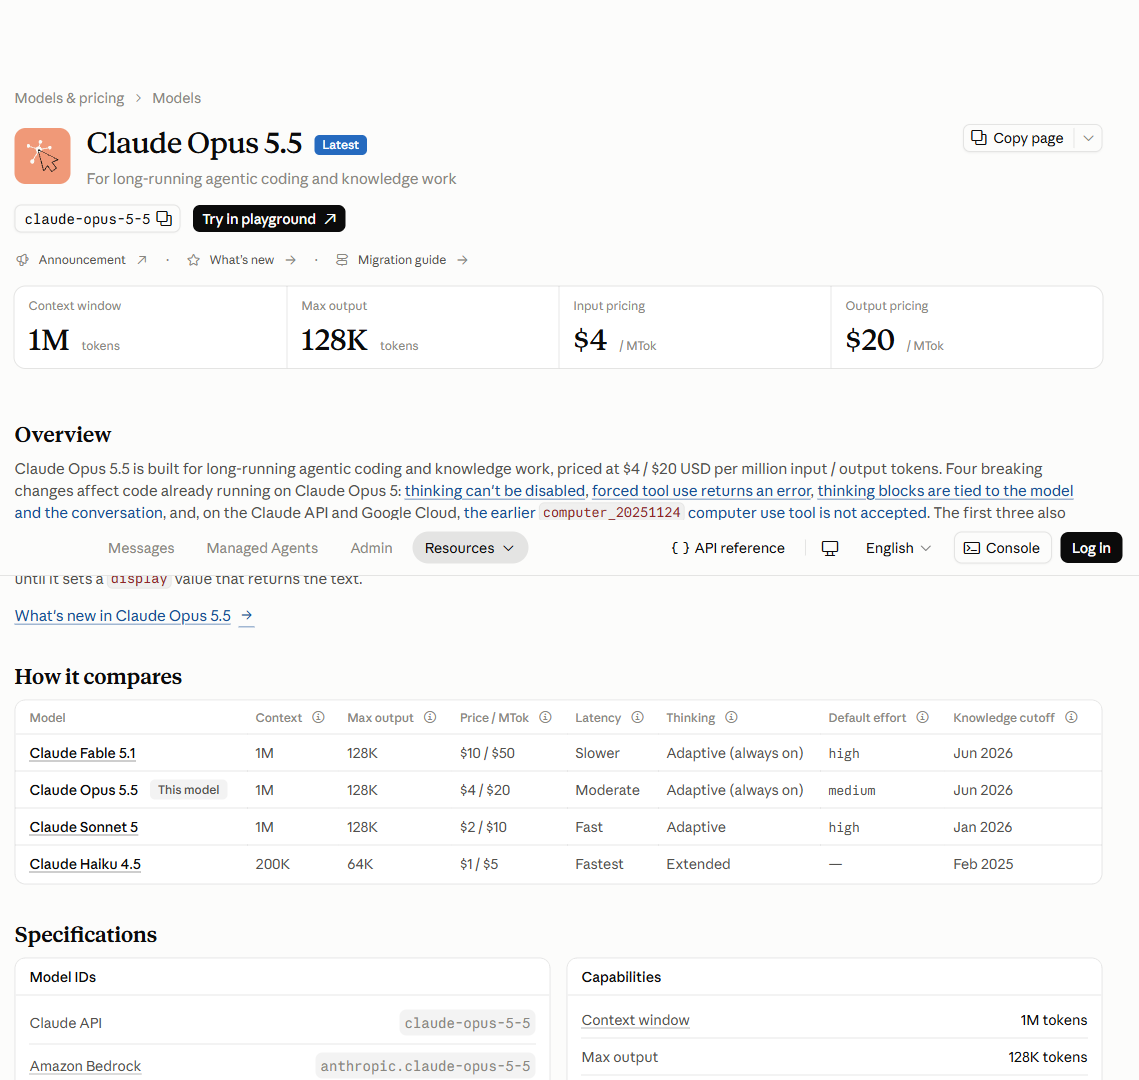
إن وثائق منصة Claude اذكر معرّف نموذج واجهة برمجة التطبيقات (API) على النحو التالي: كلود - أوبوس 5-5, ، ونافذة سياق سعة 1 مليون توكن، وحد أقصى للإخراج يبلغ 128 ألف، وتفكير تكيفي يعمل بشكل مستمر. كما تورد الوثائق التغييرات التي تؤثر على عمليات تكامل Opus 5 الحالية، والتي يتم تناولها في قسم الترحيل أدناه.
أدلة الأداء
لا يوجد رقم “أداء” واحد هنا. فالمصادر العامة الثلاثة تقيس عناصر مختلفة، لذا تحافظ كل بطاقة على وضوح مؤشراتها وحدود أدلتها.
إعلان Anthropic
الإشارة المنشورة: تشير Anthropic إلى أن Opus 5.5 يقدم أداءً يضاهي أداء Claude Fable 5.1 في معظم المهام، ويكلف 40% أقل من Opus 5 في أحمال العمل النموذجية، ويُنتج النتائج بسرعة تزيد عن 30%.
الحدود: أمثلة على تحديد المواقع والمختبرات التي نشرها المزود، وليست معيارًا مستقلًا.
التحليل الاصطناعي
الإشارة المنشورة: تشير نتائج اللقطة التي تم الحصول عليها بأقصى جهد إلى 59.6% في اختبار Terminal-Bench 4.0، و61.4% في اختبار «Humanity’s Last Exam»، و66.9% في اختبار SciCode.
الحدود: تعتمد النتائج على الجهد المبذول، ونظام التقييم، والتاريخ، وتعريف المقاييس. وهي لا تتنبأ بكل مطالبات واجهة برمجة التطبيقات (API).
تقييم ما قبل النشر الخاص بـ METR
الإشارة المنشورة: تقول شركة METR إن الأدلة التي توصلت إليها لم تُظهر تحسناً كبيراً مقارنةً بـ Fable 5.1 في مهارات اتخاذ القرار التي فحصتها، مع أنها لا تزال تتوقع تسارعاً ملحوظاً في بعض أعمال البحث والتطوير.
الحدود: هذا تقييم محدود يركز على دقة الحكم وسرعة إنجاز المهام، وليس تصنيفًا شاملاً للجودة.
عند قراءة هذه البطاقات مجتمعة، فإنها تدعم استنتاجًا محدودًا: يُعد “أوبوس 5.5” نموذجًا رائدًا في العديد من التقييمات العامة القديمة، لكن حجم الميزة يتغير باختلاف المهمة ومستوى الجهد وتصميم التقييم. ولا تثبت هذه البطاقات وجود نتيجة شاملة لـ«أفضل نموذج».
Claude Opus 5.5: وحدات التسعير والفوترة
يُعد سعر واجهة برمجة التطبيقات (API) وسعر اشتراك المستهلك منتجين مختلفين. الأرقام الخاصة بواجهة برمجة التطبيقات (API) الواردة أدناه هي أسعار الوحدات المستخدمة في إعداد ميزانية الرموز؛ أما الأرقام الخاصة بالمستهلك فهي بطاقات الباقات الظاهرة في منطقة المتصفح التي تم التقاطها.
التسعير الرسمي لواجهة برمجة التطبيقات (API)
تقدير بسيط: 10,000 توكن مدخلات بالإضافة إلى 2,000 توكن مخرجات يساوي حوالي $0.08 وفقًا للأسعار القياسية، قبل احتساب تكاليف التخزين المؤقت أو المعالجة المجمعة أو الضرائب أو هامش الربح الخاص بالمنصة.
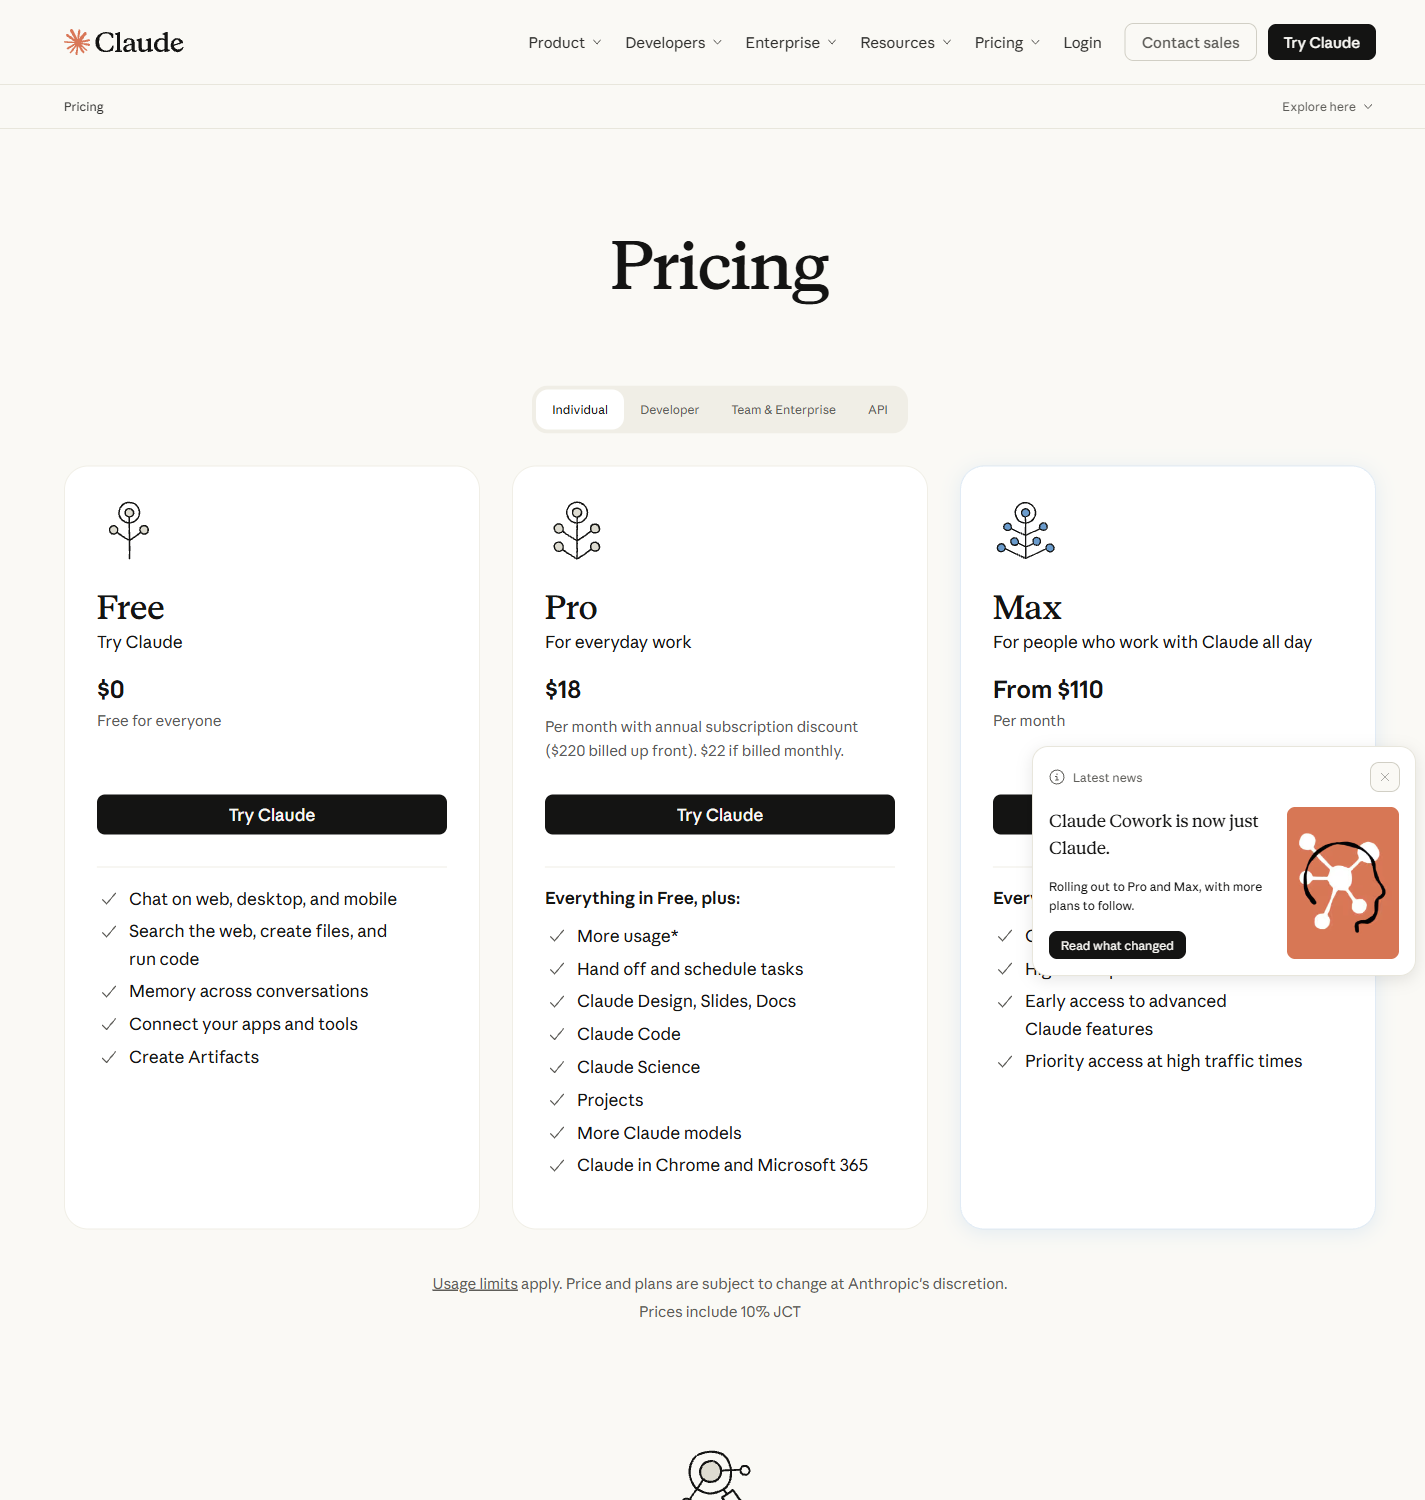
لقطة شاشة لخطة المستهلك
تُظهر الصفحة التي تم التقاطها أيضًا ملاحظة JCT برمز 10%. وهذه قيم معروضة تختلف حسب المنطقة، وليست وعدًا عالميًا بالسعر.
للحصول على شرح منفصل حول «الفوترة الرمزية» و«تكلفة نافذة السياق»، انظر دليل التسعير والسياق الخاص بـ GPT-5.5. يجب أن تظل تكلفة واجهة برمجة التطبيقات (API) الخاصة بالمزود، وسعر الاشتراك، وأي رصيد ائتماني لمنصة متعددة النماذج، عناصر منفصلة في ميزانيتك.
اختبار عملي: خمس بطاقات نتائج المهام
أرسلنا خمسة أوامر مستقلة عبر نفس مسار واجهة برمجة تطبيقات الرسائل (Messages API) الخاضع للرقابة في 23 سبتمبر 2026 باستخدام معرّف النموذج كلود - أوبوس 5-5. تم استخدام المرحلة الأولى max_tokens: 1024. قمنا بتسجيل الوقت المنقضي محليًّا، ووحدات الإدخال/الإخراج، وسبب التوقف، ومدى الصحة، والامتثال لتنسيق الحروف. أُعيد تنفيذ مهمة الكتابة باللغة الصينية بحد أقصى قدره 4,096 وحدة بعد أن كشفت الجولة الأولى عن مشكلة في إخراج المسار. هذه عينة مكونة من خمس مهام، وليست تقديرًا للموثوقية.
هل يمكنه إصلاح وظيفة إزالة التكرار من الأنواع المختلطة؟
إعداد المهمة
اعثر على الخطأ في برنامج مكتوب بلغة بايثون إزالة التكرار تنفيذ الدالة، والتعامل مع القيم غير النصية والقيم التي لا يمكن تجزئتها، والحفاظ على التهجئة الأولى، وتوفير الاختبارات.
وقد حددت الاستجابة ما يلي: .lower() فشل مع القيم غير النصية، تم تحويل السلاسل إلى casefold(), ، وأضفت حلاً بديلاً غير قابل للتجزئة، وأرسلت الكود المصحح بالإضافة إلى حالات الاختبار.
توقف الرد عند الحد الأقصى البالغ 1,024 رمزًا. كان الحل مفيدًا، لكن حجم التكوين كان صغيرًا جدًّا لإجراء مراجعة كاملة للكود.
الحكم على البطاقة: تم إرجاع إجابة مفيدة من الناحية الفنية؛ ولا يمكن لهذا التشغيل أن يدعم أي ادعاء يتعلق بزمن الاستجابة أو الاكتمال لأن الحد الأقصى لعدد الرموز أدى إلى قطعها.
هل يمكنه الحفاظ على الحقائق واختبار الحدود؟
إعداد المهمة
استخلص خمسة استنتاجات مرقمة من مذكرة تقييم موجزة، بما في ذلك المنهجية وما لم تقم الجولة التالية بقياسه.
أظهرت النتائج خمس نقاط مرقمة بالضبط. وحافظت على مقارنات المساعدين، وطريقة الـ20 تلميحًا، والفجوات المتعلقة بالاحتفاظ على المدى الطويل وتحويل العملاء.
كانت هذه حزمة مصادر قصيرة، لذا فهي لا تختبر نافذة السياق التي يبلغ حجمها 1M.
الحكم على البطاقة: استخراج نظيف مع الحفاظ على العدد المطلوب وحدود الأدلة الواردة في المذكرة المصدرية.
هل يمكنها إرجاع ناتج قابل للقراءة آليًّا دون الحاجة إلى تنقيح؟
إعداد المهمة
قم بإرجاع كائن JSON ثابت يحتوي على عنوان، وجمهور، وميزتين، وعيبين، وحكم. لا يُسمح باستخدام سياج ماركداون.
أرجعت بيانات JSON قابلة للتحليل تحتوي على المفاتيح المطلوبة، وميزتين، وعيبين، وتوصية موجزة. ولم يكن هناك غلاف Markdown.
لا يُثبت وجود استجابة صحيحة واحدة موثوقية المخطط عبر كائنات أكبر أو متداخلة.
الحكم على البطاقة: تم اجتياز اختبار التوافق الحرفي مع JSON في هذه الجولة.
هل يمكنها تطبيق قاعدة التقريب المتكرر بشكل صحيح؟
إعداد المهمة
ابدأ بـ 12 عنصرًا، واضرب كل دفعة تالية في 1.25، وقم بالتقريب لأسفل بعد كل دفعة، ثم سجل المجموع الكلي لأربع دفعات.
أُرجعت الأرقام 12 و15 و18 و22، ثم جُمعت لتصبح 67. كانت العمليات الحسابية الوسيطة واضحة.
هذه المهمة حتمية وصغيرة الحجم؛ وهي لا تمثل أداءً واسع النطاق في مجال الاستدلال.
الحكم على البطاقة: النتيجة الصحيحة والخطوات الوسيطة الشفافة.
هل أعطى المسار الذي تم اختباره نصًا صينيًّا صالحًا للاستخدام؟
إعداد المهمة
صياغة مقدمة لمراجعة باللغة الصينية تفصل بين الادعاءات الرسمية والسعر والأدلة المعيارية والاختبارات العملية.
كان هيكل الاستجابة موجودًا، لكن الأحرف الصينية ظهرت مشوشة في النتيجة المحفوظة عبر المسار الذي تم اختباره.
لا تميز الأدلة بين جودة لغة النموذج وسلوك المسار أو الترميز. ولا يتم تحديد أي درجة لجودة اللغة الصينية.
الحكم على البطاقة: النص المُرجَّع في هذا المسار غير صالح للاستخدام؛ يُرجى إعادة التشغيل باستخدام مسار UTF-8 تم التحقق منه قبل الإدلاء بأي ادعاءات تتعلق بجودة اللغة.
في جميع الاختبارات الأربعة التي أجريت بلغة محايدة أو باللغة الإنجليزية، بلغ المتوسط المحلي 6.24 ثانية. ويشير هذا الرقم إلى خمسة طلبات متتالية على مسار واحد، ولا يمثل زمن الاستجابة من جانب المزود. وكانت أبرز السلوكيات التي لوحظت هي الاستخراج الموجز، والامتثال الحرفي لمعايير JSON، وصحة العمليات الحسابية؛ أما المشكلتان اللتان لم يتم حلهما فهما الضغط على ميزانية الإخراج في الترميز، وظهور مخرجات صينية مشوشة على المسار الذي تم اختباره.
ملاحظات بشأن واجهة برمجة التطبيقات (API) وعملية الترحيل
تشمل الإجابة المختصرة هذه العوامل لأنها قد تؤدي إلى تغيير التكامل حتى عندما تبدو جودة نص النموذج جيدة.
- التفكير مستمر دائمًا. استخدم معلمة «الجهد الموثق» للتحكم في العمق ووقت الاستجابة والتكلفة؛ ولا يوجد زر لإيقاف التشغيل.
- يؤدي الاستخدام القسري للأداة إلى ظهور خطأ. يحتاج الكود الحالي الذي يتطلب الاختيار الإجباري للأداة إلى اختبار ترحيل منفصل.
- ترتبط «كتل التفكير» بالنمذجة والمحادثة. لا تفترض أن كتلة التفكير يمكن إعادة استخدامها بعد تغيير النماذج.
computer_20251124غير مقبول بشأن واجهة برمجة التطبيقات Claude ومسار Google Cloud المذكورين في الوثائق.- الحدود القصوى للإنتاج أمر مهم. تُظهر بطاقة الترميز أن الرد المفيد قد يُقطع رغم صغر حجمه
ماكس_توكينزالقيمة. - يُعد «الوضع الدفعي» و«الوضع السريع» مسارين منفصلين للفوترة. احرص على فصل الخصومات أو الرسوم الإضافية عن الأسعار القياسية للرموز.
حكم قائم على الأدلة
يتمتع Claude Opus 5.5 بأدلة قياسية عامة قوية ومؤرخة، ومعدل API قياسي منشور أقل من أرقام Opus 5 الواردة في إعلان Anthropic. في المهام الخمس المسجلة، أنتج استخراجًا نظيفًا، وبيانات JSON دقيقة، وعمليات حسابية صحيحة؛ وكانت إجابة الترميز مفيدة لكنها اقتطعت بسبب الحد الأقصى المبدئي؛ ولم يكن الناتج باللغة الصينية قابلاً للاستخدام عبر المسار الذي تم اختباره.
وبالتالي، فإن الاستنتاج الذي يمكن الدفاع عنه محدود: فقد أظهر النموذج قدرة قوية على اتباع التعليمات في عدة مهام صغيرة، في حين أن المسار والتكوين أظهرا حدودًا واضحة. وينبغي لأي قرار بشأن الترحيل أن يكرر نفس المطالبات مع ميزانية مخرجات مناسبة، وأن يتحقق من استدعاءات الأدوات، وأن يفصل بين أسعار الرموز الرسمية وأرصدة الاشتراك أو أرصدة المنصة.
إذا كنت تريد مسارًا ثانيًا للمقارنة، فإن DeepSeek V4 Pro مقابل تنسيق اختبار Flash يوضح كيف يمكن أن تظل الاستنتاجات على مستوى المهام منفصلة عن الادعاءات التي تشمل النموذج بأكمله. إن دليل حالات استخدام GPT-5.5 يضيف نقطة مرجعية موجهة نحو المهام، في حين أن ملاحظات حول اختبار أداء ذاكرة الفلاش Gemini و دليل مقارنة نماذج الذكاء الاصطناعي توفير سياق النموذج القريب. للاطلاع على الوصول إلى نماذج متعددة، انظر اشتراكات الذكاء الاصطناعي الشاملة و مقارنة بين المنصات متعددة النماذج.
الأسئلة الشائعة
كم يبلغ سعر طراز Claude Opus 5.5؟
يبلغ المعدل الرسمي لواجهة برمجة التطبيقات (API) $4 لكل مليون توكن مدخل و$20 لكل مليون توكن مخرج. وتبلغ تكلفة عمليات القراءة من ذاكرة التخزين المؤقت $0.20 لكل مليون توكن، بينما تبلغ تكلفة عمليات الكتابة إلى ذاكرة التخزين المؤقت كل 5 دقائق $5 لكل مليون توكن.
ما هي نافذة السياق Claude Opus 5.5؟
تشير وثائق منصة Claude إلى نافذة سياق تبلغ سعتها مليون توكن، وحد أقصى للإخراج يبلغ 128 ألف توكن. وهناك مسار تجريبي منفصل موثق يدعم ما يصل إلى 300 ألف توكن في الإخراج لدفعات الرسائل.
هل Claude Opus 5.5 أفضل من Opus 5؟
تشير تقارير Anthropic إلى انخفاض التكلفة النموذجية لحجم العمل وزيادة سرعة الإخراج، في حين تُظهر التقييمات المستقلة نتائج قوية في العديد من المهام القديمة. ويعتمد حجم أي تحسن في الجودة على معيار القياس، وإعدادات الجهد، والموجه، والمسار.
هل يمكن إيقاف التفكير؟
لا. تشير الوثائق الحالية الخاصة بالنموذج إلى أن «التفكير التكيفي» يكون قيد التشغيل دائمًا. استخدم معلمة «الجهد» للتحكم في عمق التفكير، ووقت الاستجابة، والتكلفة.
هل أثبتت المهام الخمس الخاصة بواجهة برمجة التطبيقات (API) موثوقيتها؟
لا. تُظهر البطاقات سلوكيات محددة وحدودًا في التهيئة، لكن خمس مهام لا تكفي لتقدير معدل نجاح عام. أما مسألة «سقف الترميز» ومسألة «المسار الصيني» فيتم الإبلاغ عنهما بشكل منفصل.
هل أثبتت هذه المراجعة جودة المنتجات الصينية؟
لا. فقد أظهر المسار الذي تم اختباره نصًّا صينيًّا مشوّشًا، لذا تم تسجيل النتيجة على أنها مشكلة تتعلق بالترميز أو المسار، في انتظار إعادة التشغيل باستخدام ترميز UTF-8 بعد التحقق من صحته.









