Die aktuelle API-Rate von Google für die Gemini 3.1 Pro-API beträgt $2 pro Million Eingabetoken und $12 pro Million Ausgabetoken für Prompts mit bis zu 200.000 Token. Oberhalb der 200k-Eingabegrenze steigen die veröffentlichten Preise auf $4 pro Million Eingabe-Token und $18 pro Million Ausgabe-Token. Für zwischengespeicherte Eingaben gelten Preise von $0,20/M bzw. $0,40/M zuzüglich $4,50 pro Million zwischengespeicherter Token pro Stunde für die Speicherung.
Auf der Modellseite wird der Endpunkt wie folgt bezeichnet: gemini-3.1-pro-vorschau, mit einer Eingabebegrenzung von 1.048.576 Token und einer Ausgabebegrenzung von 65.536 Token. Es unterstützt Denken, Funktionsaufrufe, Suchverknüpfungen, URL-Kontext, Codeausführung, die Batch-API, Flex sowie Prioritätsoptionen. Diese Funktionen erklären, warum der Gesetzentwurf mehr als eine Kennzahl benötigt.
Wenn Ihre Arbeit interaktiv ist – also die Recherche zu einem Auftrag, der Vergleich von Modellen, das Schreiben von Code und schließlich die Übergabe des Ergebnisses an einen Mitarbeiter –GlobalGPT bietet Ihnen einen Abonnement-Arbeitsbereich, der verschiedene Modelle und KI-Funktionen umfasst. Entwickler können zudem auf die API, die CLI, das MCP und den Yukie-Agenten zurückgreifen, wenn die Arbeit aus einem Chat in einen wiederholbaren Workflow überführt werden muss. Der unten angegebene API-Preis entspricht weiterhin dem von Google festgelegten, nach Verbrauch berechneten Preis.
- Was Gemini 3.1 Pro ist und was die Kontextbeschränkung bedeutet
- Gemini 3.1 Pro API-Preise pro Million Token
- Beispiele für die Kosten der Gemini 3.1 Pro API in der Praxis
- Wie sich das Kontext-Caching auf die Rechnung auswirkt
- Verbraucher-Tarife unterscheiden sich von der API-Abrechnung
- Wann API, CLI, MCP oder ein Multi-Modell-Arbeitsbereich geeignet sind
- Verbraucher-Tarife und API-Abrechnung erfüllen unterschiedliche Aufgaben
- Machen Sie aus der Preisliste ein konkretes Angebot
- Was sich in der Praxis durch einen größeren Kontext ändert
- Wenn ein Arbeitsbereich besser ist als ein Token-Ledger
- FAQ
Was Gemini 3.1 Pro ist und was die Kontextbeschränkung bedeutet
Auf der aktuellen Modellseite von Google wird „Gemini 3.1 Pro Preview“ als ein Modell beschrieben, das auf leistungsfähigeres logisches Denken, Softwareentwicklung, präzisen Werkzeuggebrauch und mehrstufige Agenten-Workflows optimiert ist. Das Modell akzeptiert Texte, Bilder, Videos, Audiodateien und PDF-Dateien als Eingabe und gibt anschließend Text aus.
| Modelldetails | Veröffentlichter Wert | Warum dies für die Kosten von Bedeutung ist |
|---|---|---|
| Modell-ID | gemini-3.1-pro-vorschau | Verwenden Sie beim Abgleich einer Rechnung oder einer SDK-Konfiguration die genaue ID. |
| Eingabebegrenzung | 1.048.576 Token | Ein großer Kontext ist möglich, aber die Tokens zählen weiterhin als Eingabe. |
| Ausgangsbegrenzung | 65.536 Token | Umfangreiche Ausgaben können den größten Teil der Kosten einer Anfrage ausmachen. |
| Werkzeuge | Denken, Funktionsaufruf, Suchverankerung, URL-Kontext, Codeausführung, Zwischenspeicherung | Der Einsatz von Tools kann über eine einfache Eingabeaufforderung hinaus zu zusätzlichen Anfragen oder einer höheren Token-Nutzung führen. |
Gemini 3.1 Pro API-Preise pro Million Token
Auf der Preisseite von Google werden die Modi „Standard“, „Batch“, „Flex“, „Priority“ und „Contributor“ unterschieden. Die folgende Tabelle basiert auf der aktuellen kostenpflichtigen Standardstufe für „Gemini 3 Pro Preview“, deren Modell-Link wie folgt lautet: gemini-3.1-pro-vorschau.
| Standard-Bezahlmodell | Eingabe ≤ 200.000 Token | Eingabeaufforderung > 200.000 Token |
|---|---|---|
| Eingabetoken | $2.00 / 1M | $4.00 / 1M |
| Ausgabe-Token, einschließlich Überlegungen | $12,00 / 1M | $18,00 / 1M |
| Zwischengespeicherte Eingabe | $0.20 / 1M | $0,40 / 1M |
| Cache-Speicher | $4,50 / 1 Mio. Token pro Stunde | |
| Erdung der Google-Suche | 5.000 Anfragen/Monat, verteilt auf die Modelle Gemini 3 und neuere; danach $14 pro 1.000 Anfragen | |
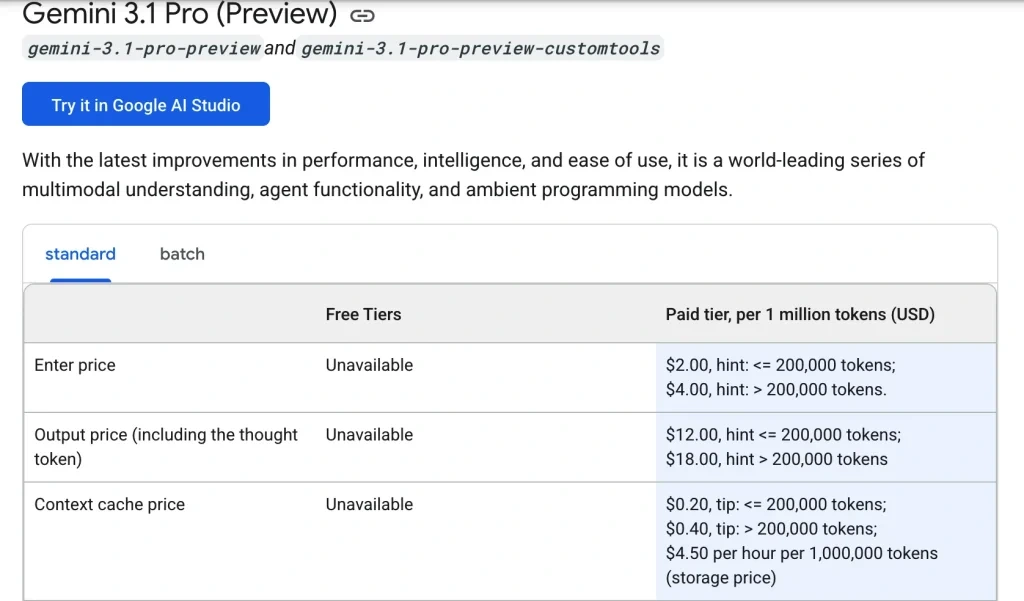
Zwei Details können leicht übersehen werden. Erstens umfasst der Begriff “Output” in der veröffentlichten Tabelle auch „Thinking Tokens“. Zweitens können bei einer Anfrage, die eine Verknüpfung mit der Google-Suche auslöst, Suchgebühren anfallen, sobald das gemeinsame monatliche Kontingent aufgebraucht ist. Eine Musterantwort allein stellt noch keine vollständige Rechnung dar.
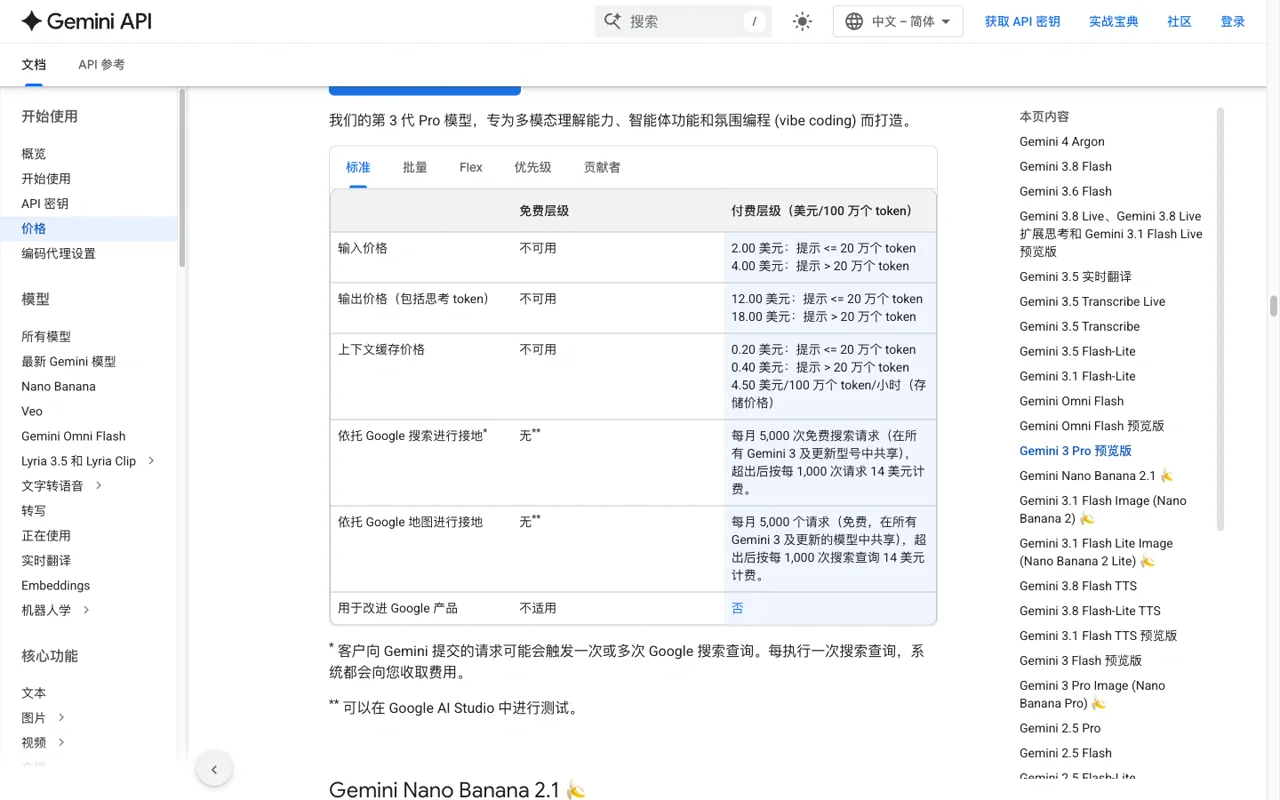
Diese Grenze ist es, die aus einer groben Schätzung eine andere Abrechnung macht. Wenn eine Anfrage eine umfangreiche Codebasis oder wiederkehrende Kontexte enthält, sollten Sie die Größe der Eingabe prüfen, bevor Sie sich für ein Modell oder eine Caching-Methode entscheiden.
Beispiele für die Kosten der Gemini 3.1 Pro API in der Praxis
Verwenden Sie Tokens ÷ 1.000.000 × den geltenden Tarif. In den folgenden Beispielen sind Steuern, Gutschriften und werkzeugspezifische Gebühren nicht berücksichtigt.
| Szenario | Eingabe | Ausgabe | Geschätzte Token-Kosten |
|---|---|---|---|
| Short-Call | 50.000 × $2/M = $0,10 | 8.000 × $12/M = $0,096 | $0.196 |
| Lange technische Aufgabenstellung | 250.000 × $4/M = $1,00 | 20.000 × $18/M = $0,36 | $1.36 |
| 1 Mio. Token im Kontext, 50.000 als Ausgabe | 1.000.000 × $4/M = $4,00 | 50.000 × $18/M = $0,90 | $4.90 |
geschätzte Kosten = (eingebrachte Token ÷ 1.000.000 × Eingangsrate) + (ausgegebene Token ÷ 1.000.000 × Ausgangsrate) + anfallende Tool-/Suchgebühren
Das 250.000-Beispiel überschreitet die 200.000-Grenze, sodass für die Anfrage die höheren Tarife gelten. Wenn die Anwendung ein großes, sich wiederholendes Präfix sendet, kann das Caching den Eingabeteil der Rechnung verändern – allerdings nur für Token, die tatsächlich als zwischengespeicherte Eingabe gelten.
Wie sich das Kontext-Caching auf die Rechnung auswirkt
Caching ist sinnvoll, wenn immer wieder dieselben langen Befehle, derselbe Code-Kontext oder dasselbe Referenzmaterial gesendet werden. Für die oben dargestellte Standardstufe liegen die Kosten für zwischengespeicherte Eingaben unterhalb der 200k-Grenze bei $0,20/M und oberhalb dieser Grenze bei $0,40/M, während gespeicherte Cache-Token $4,50/M Token pro Stunde kosten.
Das ist eine Entscheidung, die sich nach der Preisliste richtet, und kein garantierter Rabatt bei jeder wiederholten Anfrage. Verfolgen Sie die Nutzung von zwischengespeicherten Tokens in den Abrechnungsdaten des Anbieters und berücksichtigen Sie die Speicherdauer in der Schätzung.
Verbraucher-Tarife unterscheiden sich von der API-Abrechnung
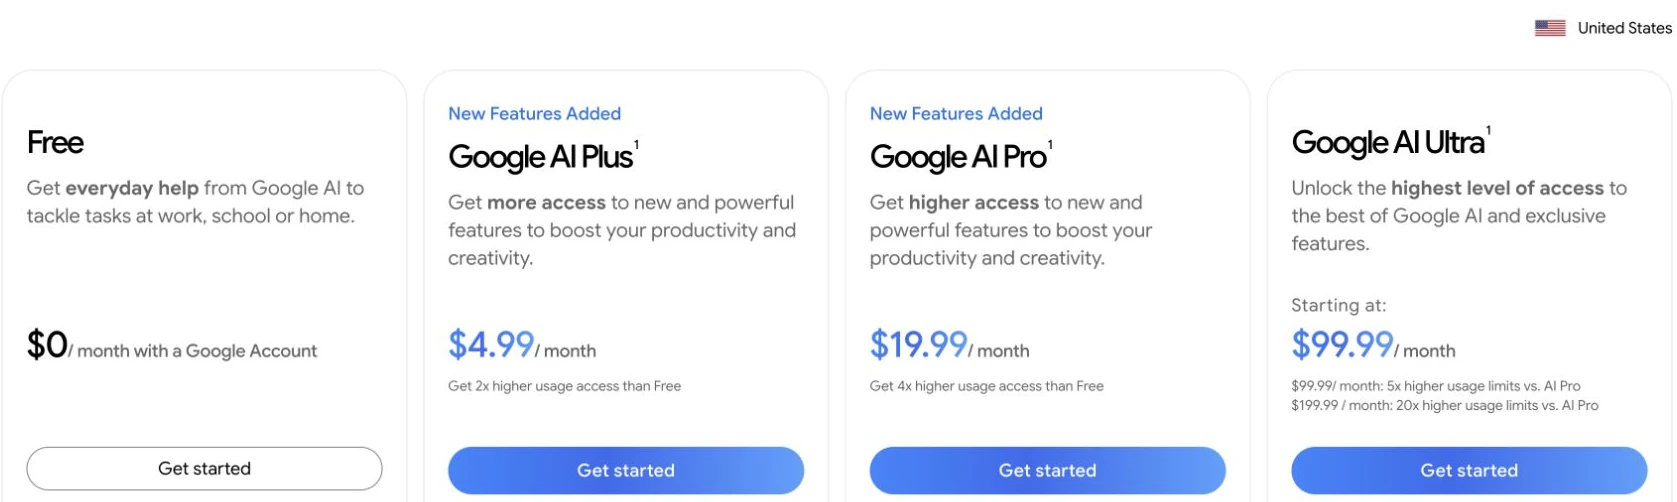
Ein Google AI Pro- oder Ultra-Abonnement ist ein Verbraucher-Tarif mit App-Funktionen und Zugriffsregeln. Die Abrechnung der Gemini-API erfolgt nach Tokens und Tools. Ein Verbraucher-Abonnement wird nicht automatisch in API-Guthaben umgewandelt, und ein API-Projekt umfasst nicht automatisch die Vorteile einer Verbraucher-App.
Wann API, CLI, MCP oder ein Multi-Modell-Arbeitsbereich geeignet sind
Entscheiden Sie sich für die API, wenn Ihre Software vorhersehbare, kontingentierte Aufrufe, einen Anbieterschlüssel und eine Rechnung benötigt, die Sie anhand der Token-Protokolle berechnen können. Wählen Sie eine CLI- oder MCP-Lösung, wenn das Modell neben einem Terminal, einem Repository oder einem bestehenden Tool-Server laufen soll. Ein Yukie-Agent-Ansatz ist sinnvoll, wenn es sich um eine mehrstufige Aufgabe handelt, die Planung und Übergaben erfordert, anstatt nur einmalig abgeschlossen zu werden.
GlobalGPT passt zum interaktiven Aspekt dieser Entscheidung: Modelle vergleichen, Entwürfe erstellen, Ergebnisse prüfen und direkt zur Programmierung oder zu anderen KI-Funktionen übergehen – alles in einem Dashboard. Der Preis und die Vertragsbedingungen sind eine separate Produktentscheidung; die oben aufgeführte Google-Preisliste bleibt die Quelle für die Kosten der Gemini-API.

Verbraucher-Tarife und API-Abrechnung erfüllen unterschiedliche Aufgaben
Gemini 3.1 Pro kann sowohl in einem Verbraucher-App-Tarif als auch in einem Entwickler-API-Workflow vorkommen, jedoch handelt es sich dabei nicht um dieselbe Rechnung. Mit einem Verbrauchertarif erwirbt man Zugriff auf eine Anwendung und die darin enthaltenen Limits. Über die API werden Tokens, Cache-Speicherplatz sowie die Nutzung von Tools oder Grundfunktionen im Rahmen eines Entwicklerprojekts abgerechnet.
| Falls Sie… | Wähle die entsprechende Route aus | Budget von etwa |
|---|---|---|
| Zugriff auf interaktive Apps | Privatkunden-Tarif | Tarifpreis, enthaltene Zugangsrechte und aktuelle Nutzungsbeschränkungen. |
| Ein Skript oder eine Produktintegration | Zwillings-API | Eingabe, Ausgabe, zwischengespeicherte Eingabe, Speicherung und Werkzeugkosten. |
| Arbeit mit Repositorys am Terminal | CLI oder ein API-verbundenes Tool | Modellaufrufe sowie der Workflow, der diese aufruft. |
| Ein mehrstufiger Prozess von der Forschung bis zur Produktion | MCP oder ein Yukie-Agent | Modellnutzung, zugelassene Werkzeuge und die Anzahl der Übergaben. |
Bezeichnen Sie ein Verbraucherabonnement nicht als API-Guthaben und versprechen Sie den Zugriff auf eine App-Funktion nicht anhand von API-Token-Tarifen.
Machen Sie aus der Preisliste ein konkretes Angebot
Beginnen Sie mit der Prompt-Größe, nicht mit dem Modellnamen. Zählen Sie die Eingabe-Tokens, stellen Sie fest, ob die Anfrage die Grenze von 200.000 Tokens überschreitet, schätzen Sie die Ausgabe einschließlich der „Thinking-Tokens“, sofern diese in der Preisliste enthalten sind, und addieren Sie etwaige Such- oder Grounding-Gebühren hinzu.
- Kurze Anfrage: Eingabe-Token ÷ 1.000.000 × den niedrigeren Eingabesatz.
- Lange Anfrage: Wende die höheren Ein- und Ausgaberaten auf die Anfrage an, die den Schwellenwert überschreitet.
- Wiederholter Kontext: Zähle nur die Token, die als zwischengespeicherte Eingabe gelten, und berücksichtige dabei die Speicherdauer im Cache.
- Suche nach „Grounding“: Fügen Sie gegebenenfalls die veröffentlichte Gebühr pro Anfrage nach dem gemeinsamen Kontingent hinzu.
- Produktionsprognose: Wiederholungsversuche und Tool-Aufrufe hinzufügen, anstatt nur die erste Antwort zu multiplizieren.
Ein Token-Rechner ist dann nützlich, wenn die Eingabewerte sichtbar sind. Geben Sie den Bereich, die Abrechnungseinheit und das Datum neben dem Ergebnis an, damit ein späterer Leser erkennen kann, was die Zahl bedeutet.
Was sich in der Praxis durch einen größeren Kontext ändert
Eine Eingabebegrenzung von einer Million Token bedeutet nicht, dass jede Anfrage das gesamte Repository umfassen sollte. Umfangreiche Eingaben erhöhen die Kosten und können die Identifizierung der relevanten Datei erschweren. Beginnen Sie mit einem Index, senden Sie den kleinsten relevanten Ausschnitt und fügen Sie die nächste Datei erst dann hinzu, wenn die erste Antwort zeigt, dass sie benötigt wird.
- Erstellen Sie vor dem Versenden der Quelldateien eine kurze Repository-Übersicht.
- Trenne stabile Anweisungen von der Änderung des Aufgabenkontexts.
- Ein wiederkehrendes Präfix nur dann zwischenspeichern, wenn der Nutzungsbericht einen Treffer bestätigt.
- Bitten Sie um Dateinamen und Zeilenangaben, damit das Ergebnis überprüft werden kann.
- Führen Sie für Tests oder Randfälle einen zweiten Durchlauf durch, anstatt eine uneingeschränkte Neufassung zu verlangen.
Hier kommen API, CLI und MCP ins Spiel: Das Modell kann parallel zum Projekt laufen, während der Workflow steuert, welcher Kontext übermittelt und welches Tool aufgerufen wird.
Wenn ein Arbeitsbereich besser ist als ein Token-Ledger
Verwenden Sie die API, wenn Sie vorhersehbare Anwendungsaufrufe und eine Abrechnung auf Token-Ebene benötigen. Verwenden Sie die CLI, wenn die Entwicklung in einem Terminal erfolgt. Verwenden Sie MCP, wenn für die Aufgabe genehmigte externe Tools erforderlich sind. Verwenden Sie einen Yukie-Agenten, wenn die Aufgabe Planung, den Einsatz von Tools und Übergaben umfasst.
Für interaktive Entdeckungen und Mixed-Media-Arbeiten, Der Gemini 3.1 Pro-Arbeitsbereich von GlobalGPT Bietet Ihnen die Möglichkeit, ein Modell zu vergleichen, Code zu schreiben und anschließend mit Bild-, Video-, Audio- oder Agenten-Schritten fortzufahren. Der Kostenvorteil ergibt sich daraus, dass ein größerer Teil des Workflows durch ein einziges Abonnement abgedeckt wird; die Gebühren für die Google-API werden weiterhin separat vom Anbieter in Rechnung gestellt.
FAQ
Wie viel kostet Gemini 3.1 Pro pro Million Token?
Für die Standard-Bezahlstufe gibt Google eine Eingabe von $2/M und eine Ausgabe von $12/M an, wenn die Eingabe 200.000 Token oder weniger umfasst. Oberhalb von 200.000 gelten die Raten $4/M für die Eingabe und $18/M für die Ausgabe.
Gibt es eine kostenlose Gemini 3.1 Pro API-Stufe?
Auf der Preisseite von Google wird ein kostenloses Kontingent angeboten, dessen Nutzung auf bestimmte Modelle beschränkt ist. Überprüfen Sie die aktuelle Zeile des jeweiligen Modells, bevor Sie davon ausgehen, dass für das Modell „Gemini 3.1 Pro“ ein kostenloser API-Zugang besteht.
Werden für die Google-Suche über die API Gebühren erhoben?
Auf der aktuellen Preisseite sind 5.000 kostenlose Suchanfragen pro Monat aufgeführt, die sich auf die Modelle Gemini 3 und neuere verteilen, danach $14 pro 1.000 Anfragen. Jede Suchanfrage kann nach Ausschöpfung des Kontingents separat in Rechnung gestellt werden.
Ist im Google AI Pro-Abonnement ein API-Guthaben enthalten?
Gehen Sie nicht davon aus. Die Preisgestaltung für Verbraucher-Tarife und die Abrechnung von API-Token erfolgen über separate Kanäle und sollten auf den jeweiligen offiziellen Seiten überprüft werden.
Wie lässt sich Gemini 3.1 Pro am günstigsten nutzen?
Vergleichen Sie bei programmierbaren Produktionsaufrufen die Token-Schätzung, das Caching sowie die Batch- oder Flex-Optionen, die Sie tatsächlich nutzen können. Bei interaktiver Arbeit mit mehreren Modellen und Funktionen sollten Sie einen aktuellen Arbeitsbereichsplan separat vergleichen, anstatt ihn als API-Guthaben zu behandeln.
Nutzen Sie die Preisliste als Rechenhilfe, nicht als Werbeslogan: Ermitteln Sie die genaue Modell-ID, überprüfen Sie die 200k-Grenze, zählen Sie die ausgegebenen „Thinking Tokens“ und trennen Sie die Verbraucherpläne von den API-Ausgaben.