
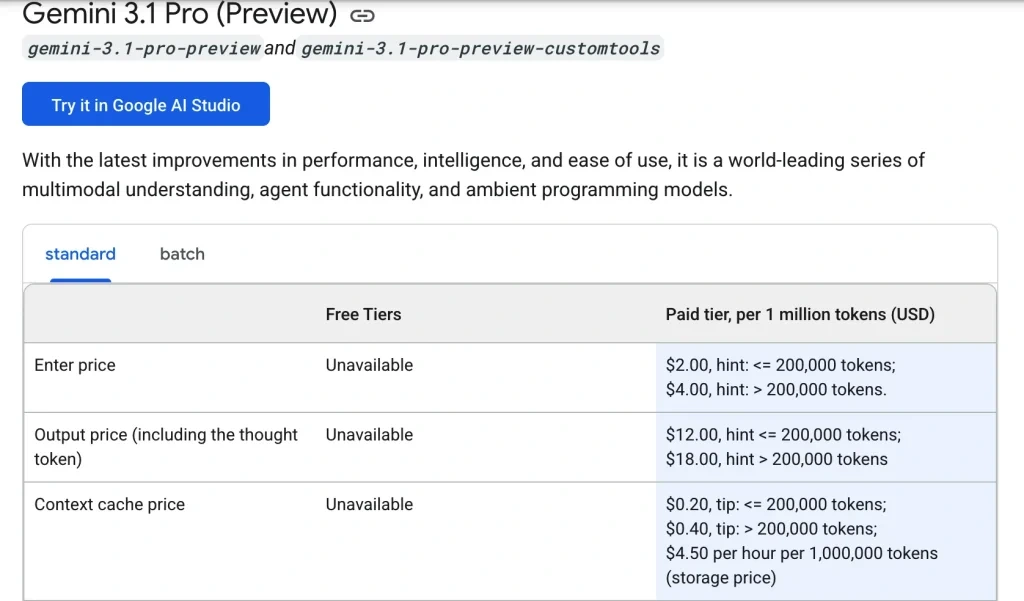
Costi di Gemini 3.1 Pro Preview $2 per milione di token in ingresso e $12 per milione di token in uscita sul livello API standard Gemini per prompt fino a 200.000 token. Oltre tale soglia, le tariffe sono $4 e $18. La fatturazione in uscita include i token di elaborazione. Per l'app Gemini, Google AI Pro è un servizio separato Abbonamento mensile $19.99 negli Stati Uniti.
Il costo da prevedere dipende dall'utilizzo che si fa del modello. Un abbonamento all'app, un progetto API e uno spazio di lavoro multimodello hanno regole di fatturazione diverse. Un documento lungo, una cronologia di conversazioni ripetitiva o un budget di elaborazione elevato possono incidere sul costo dell'API anche se il numero di richieste rimane invariato.
Per un lavoro che spazia dalla ricerca e dalla scrittura alla programmazione e alla creazione di contenuti multimediali, GlobalGPT riunisce i modelli Gemini, Claude, GPT e altri in un unico abbonamento e in un unico spazio di lavoro. Si tratta di un modo pratico per organizzare un flusso di lavoro di IA più ampio e gestire la spesa per gli abbonamenti senza dover aprire un account separato per ogni strumento. Questa guida è pubblicata da GlobalGPT; i prezzi dei fornitori riportati di seguito provengono dalle loro pagine ufficiali.
Che cos’è Gemini 3.1 Pro? Finestra del modello e del contesto
Google ha annunciato Gemini 3.1 Pro il 19 febbraio 2026. Il modello API trattato in questa sede è gemini-3.1-pro-preview. Il suo specifiche tecniche ufficiali del modello prevede un limite di 1.048.576 token in ingresso e un limite di 65.536 token in uscita. Accetta testo, immagini, video, audio e file PDF e produce testo. Tali capacità di input non lo rendono un modello per la generazione di immagini o video.
Per gli utenti che stanno confrontando il Limite di token Gemini Pro, la capacità e il costo rispondono a domande diverse: il modello può accettare un file di grandi dimensioni, ma un prompt superiore a 200.000 token rientra nella fascia di prezzo più alta. Anche la conversazione completa e il materiale di partenza ripetuto incidono sul prompt che invii.
Nel suo annuncio di lancio, Google ha riportato un punteggio ARC-AGI-2 pari a 77,1%. Si tratta di un risultato relativo al ragionamento fornito dal fornitore, non di una misura del costo per risposta utile. Un criterio di valutazione più significativo in termini di budget è verificare se il modello porta a termine l’effettivo compito di redazione, programmazione o analisi con un minor numero di correzioni. Il Guida alla programmazione di Gemini 3.1 Pro tratta tale flusso di lavoro in modo più dettagliato.
Prezzi dell'API Gemini 3.1 Pro per milione di token
Il Listino prezzi API Gemini distingue le richieste standard da quelle di inferenza in modalità Batch, Flex e Priority. Tutte le tariffe riportate nella tabella seguente sono espresse in dollari statunitensi per milione di token. Selezionare la fascia utilizzando il conteggio dei token di prompt; quindi applicare i tassi di immissione e di emissione corrispondenti.
| Modalità | Prompt ≤200k: input / output | Prompt >200k: input / output | Quando calza a pennello |
|---|---|---|---|
| Standard | $2 / $12 | $4 / $18 | Utilizzo interattivo regolare |
| Lotto | $1 / $6 | $2 / $9 | Lavoro asincrono; tempo di risposta previsto: 24 ore |
| Flex | $1 / $6 | $2 / $9 | Attività sincrona tollerante alla latenza; latenza variabile e disponibilità “best-effort” |
| Priorità | $3.60 / $21.60 | $7.20 / $32.40 | Un livello di inferenza prioritaria con tariffazione separata |
Lotto e Flex riducono della metà le velocità standard di input e output indicate, con diversi compromessi in termini di tempi e disponibilità. Sono utili per attività quali la classificazione di una raccolta di documenti o la preparazione di un rapporto di cui non si ha bisogno immediatamente. La loro riduzione non comporta automaticamente una riduzione della metà dello spazio di archiviazione nella cache né di tutti i costi relativi agli strumenti.
Il limite dei 200k: i dati in ingresso raddoppiano, l'output aumenta di 50%
Una richiesta di esattamente 200.000 token rientra nella fascia più bassa. Oltre i 200.000, la tariffa standard di input passa da $2 a $4, mentre quella di output passa da $12 a $18. I tassi più elevati si applicano al numero di token della richiesta; non si tratta di un sovrapprezzo applicato esclusivamente ai token oltre i 200.000.
Fonte: Prezzi dell'API Google Gemini. Livello standard; verificato il 15 settembre 2026. Tutte le barre utilizzano la stessa scala in dollari.
Un input più ampio può aumentare anche la velocità di output, anche se la risposta è breve.
Una stima mensile elaborata tramite API
Supponiamo di effettuare 100 richieste standard, ciascuna con 10.000 token in ingresso e 2.000 token in uscita fatturabili. La stima è 100 × [(10.000 ÷ 1.000.000 × $2) + (2.000 ÷ 1.000.000 × $12)] = $4,40. Si tratta di un calcolo indicativo, non di un preventivo definitivo; non include gli strumenti, la cache, lo spazio di archiviazione, le tasse e le commissioni della piattaforma.
Per una richiesta più grande con 250.000 token in ingresso e 10.000 token in uscita fatturabili, lo stesso metodo restituisce $1.18: $1.00 per l'input più $0.18 per l'output. Utilizza l'output fatturabile, compreso il lavoro di riflessione, anziché limitarti a contare solo le parole visibili nella risposta.
- Conta il prompt completo, compresa la cronologia della conversazione e i file sorgente.
- Identificare la modalità di richiesta e la parentesi corretta per la dimensione del prompt.
- Aggiungere il valore della produzione fatturabile, quindi eventuali costi relativi alla memorizzazione nella cache, allo stoccaggio e agli strumenti.
- Prima di procedere con l'ampliamento, confronta il rapporto sull'utilizzo con il preventivo.
Il guida ufficiale ai token spiega il conteggio dei token. Per la configurazione e l'implementazione, utilizzare il Guida per sviluppatori API Gemini 3.1 Pro.
In che modo la memorizzazione nel cache del contesto incide sul conto
La memorizzazione nella cache del contesto è utile quando lo stesso documento, repository o le stesse istruzioni di sistema compaiono in richieste ripetute. Essa applica uno sconto sull’input riutilizzato; non rende però gratuita l’intera richiesta. Nel livello standard, i dati memorizzati nella cache costano $0,20 per milione di token per prompt fino a 200k, oppure $0,40 oltre i 200k. L’archiviazione esplicita nella cache aggiunge $4,50 per milione di token memorizzati nella cache all’ora.
Google descrive due approcci nel suo Documentazione sulla memorizzazione nella cache del contesto: la memorizzazione implicita in cache trasferisce automaticamente i risparmi quando una richiesta viene soddisfatta dalla cache; la memorizzazione esplicita in cache consente di mantenere un prefisso specificato per un periodo di validità prescelto. Se non si imposta una durata, la memorizzazione esplicita in cache è impostata di default su un’ora. I token memorizzati in cache continuano a essere conteggiati ai fini dei limiti sui token, pertanto la memorizzazione in cache non fa rientrare un prompt lungo in una fascia di prezzo inferiore.
| Scenario con input ripetuti | Cinque operazioni di lettura da 100.000 token | Immagazzinamento | Totale indicativo |
|---|---|---|---|
| Non memorizzato nella cache, parentesi inferiore standard | $1.00 | $0 | $1.00 |
| Cache esplicita conservata per 1 ora | $0.10 | $0.45 | $0.55 |
| Cache esplicita conservata per 24 ore | $0.10 | $10.80 | $10.90 |
Queste stime mettono a confronto solo le componenti ricorrenti relative agli input e alla memorizzazione. I nuovi input e output non memorizzati nella cache sono da considerarsi aggiuntivi. Una cache di breve durata riutilizzata più volte può rivelarsi utile; mantenere una cache di grandi dimensioni durante la notte per poche sole letture può costare di più che inviare nuovamente tali input. Impostare la durata di conservazione in base alla sessione di lavoro effettiva e verificare l’utilizzo dei cache-hit, anziché dare per scontato che ogni prompt ripetuto comporti uno sconto.
L'utilizzo di strumenti può aggiungere un'altra voce. Per la convalida tramite Ricerca Google, Tabella dei prezzi di Google prevede 5.000 “richieste di ricerca” gratuite al mese, ripartite tra i modelli Gemini 3.x, e successivamente $14 ogni 1.000 richieste di ricerca. Il suo guida alla messa a terra chiarisce che la fatturazione Gemini 3 tiene conto delle query di ricerca eseguite dal modello, escludendo quelle vuote dal conteggio delle query uniche. Una singola richiesta di generazione che attiva due ricerche distinte consuma quindi due unità di ricerca fatturabili. È opportuno pianificare il budget in base alle ricerche effettuate, non solo alle risposte generate; la quota gratuita non garantisce 5.000 risposte fondate.
Google AI Pro e Ultra: prezzi mensili degli abbonamenti negli Stati Uniti
Se vuoi utilizzare Gemini in un'interfaccia di chat, confronta I piani di abbonamento di Google negli Stati Uniti anziché moltiplicare i messaggi di chat per le tariffe dei token API. La pagina pubblica dedicata agli Stati Uniti elenca le seguenti opzioni mensili. Si tratta dei prezzi di abbonamento pubblicizzati, non di un preventivo per ogni paese né dell’importo totale da pagare, tasse incluse.
| Piano degli Stati Uniti | Prezzo mensile pubblicizzato | Distinzione rilevante in materia di accesso |
|---|---|---|
| Gratuito | $0 | Accesso all'app Gemini, compreso l'accesso differenziato a 3.1 Pro |
| Google AI Plus | $4.99 | Accesso con un limite di utilizzo superiore rispetto alla versione gratuita |
| Google AI Pro | $19.99 | Accesso avanzato a Gemini, funzionalità dell'app Google e 5 TB di spazio di archiviazione |
| Google AI Ultra 5x | $99.99 | Limiti di utilizzo 5 volte superiori rispetto a quelli di AI Pro nella pagina dei piani per gli Stati Uniti |
| Google AI Ultra 20x | $199.99 | Limiti di utilizzo 20 volte superiori rispetto a quelli di AI Pro, come indicato nella pagina dei piani per gli Stati Uniti |
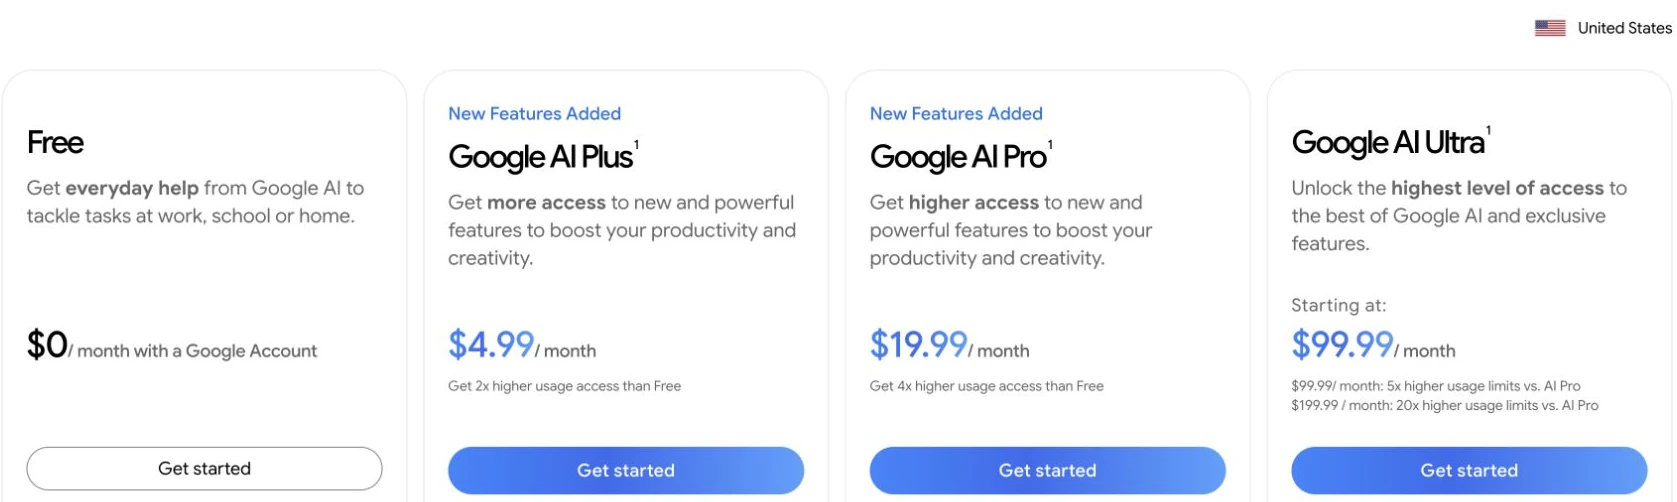
Le diciture “5x” e “20x” descrivono il confronto tra i piani pubblicati; non costituiscono una garanzia di un numero fisso di chiamate API. Vale la pena prendere in considerazione Google AI Pro se Gemini fa parte del vostro lavoro quotidiano e utilizzate anche le funzionalità e lo spazio di archiviazione inclusi nel pacchetto. I piani Free o Plus possono essere sufficienti per un utilizzo meno intenso. Il piano Ultra è indicato quando un utilizzo più intenso dell’app o funzionalità aggiuntive risolvono una limitazione che si riscontra effettivamente.
Google AI Pro include crediti API?
Google AI Pro include un Credito mensile per sviluppatori $10 attraverso il Programma per sviluppatori Google. Di Google Domande frequenti attuali descrive il vantaggio Pro/Ultra associato come credito mensile su Google Cloud. Il suo Linee guida generali sui crediti Cloud tratta prodotti quali Firebase, Vertex AI e Google Maps e spiega come applicare un vantaggio a un account di fatturazione idoneo tramite My Benefits.
Prima di utilizzare il credito presente nel tuo budget, verifica il vantaggio specifico nella sezione "I miei vantaggi", il servizio che copre, la data di scadenza e il saldo disponibile sul tuo conto di fatturazione. Assicurati che sia applicabile al servizio API Gemini e al progetto che intendi utilizzare. Fino ad allora, pianifica i costi dell’API tenendo conto dei crediti indicati in questa guida. Tieni separati l’abbonamento all’app Gemini e la fatturazione del progetto API quando monitori le spese.
La prova gratuita di Google Cloud $300 è un’altra offerta, distinta dalla precedente. La guida alla fatturazione delle API di Google esclude l’utilizzo dell’API Gemini da tale prova gratuita a partire da marzo 2026. Il credito di benvenuto di Cloud non dovrebbe quindi essere considerato come il beneficio mensile per gli sviluppatori associato a un piano Google AI.
Le impostazioni di fatturazione specifiche per l'account e le modalità di utilizzo sono illustrate in Guida alla fatturazione dell'API Gemini di Google. Anche i limiti di utilizzo delle app e i limiti di frequenza delle API variano; il Guida ai limiti di Gemini 3.1 Pro illustra le differenze. Il pagamento di un abbonamento non elimina tutte le limitazioni.
Confronto dei costi delle API: Gemini, GPT e Claude
Il confronto più utile parte da uno stesso budget di token. Le cifre riportate di seguito utilizzano tariffe standard delle API di prima parte (senza cache) per un prompt di 100.000 token e 10.000 token di output fatturabili. Sono esclusi strumenti, spazio di archiviazione, tasse, sovrapprezzi regionali di elaborazione e commissioni delle piattaforme di terze parti. Un numero uguale di token non implica necessariamente la stessa quantità di testo o risposte altrettanto efficaci tra diversi tokenizzatori di modelli.
| Modello selezionato | Ingresso / 1M | Uscita / 1M | 100k in ingresso + 10k in uscita |
|---|---|---|---|
| Anteprima di Gemini 3.1 Pro | $2 | $12 | $0.32 |
| GPT-5.5 | $5 | $30 | $0.80 |
| Claude Opus 4.8 | $5 | $25 | $0.75 |
| Claude Sonetto 4.6 | $3 | $15 | $0.45 |
| Claude Sonetto 5 | $2 | $10 | $0.30 |
Fonti: Google, OpenAI GPT-5.5, Antropico. Dati verificati il 15 settembre 2026; si tratta di esempi di calcolo, non di bollette effettive.
Sonnet 5 costa $0,30 per questo budget di token, rispetto a $0,32 di Gemini. Questo campione di cinque modelli non costituisce un’indagine sui modelli più economici presenti sul mercato né una classifica generale in termini di qualità o di ritorno sull’investimento.
Anthropic riporta ora come prezzo standard le velocità di ingresso $2 e di uscita $10 di Sonnet 5; l’aumento di prezzo annunciato in precedenza per settembre non avrà luogo. Sonnet 4.6 e Opus 4.8 rimangono riferimenti utili per i carichi di lavoro esistenti, ma si tratta di versioni precedenti del Claude e non della gamma completa attuale.
I prompt più lunghi possono modificare l’entità del divario di prezzo. La fascia più alta di Gemini inizia oltre i 200k token di prompt; la soglia documentata per GPT-5.5 è superiore a 272k token in ingresso. Anthropic riporta i prezzi standard per l’intera finestra di contesto da 1 milione per Claude 4.6 e versioni successive. Con 250.000 token di input e 10.000 token di output, la stima standard in token di Gemini è $1,18, quella di Sonnet 4.6 è $0,90 e quella di Sonnet 5 è $0,60. Confronta la fascia applicabile al carico di lavoro che invierai effettivamente.
Scegli in base al costo per attività completata: includi i tentativi falliti, i solleciti di follow-up, il tempo dedicato alla riflessione e le correzioni umane. Il prezzo dei token da solo non basta a stabilire quale modello gestisca al meglio il tuo lavoro. Per il contesto relativo ai prezzi del modello precedente, consulta il confronto esistente tra Costi di Gemini 3 Pro e Gemini 3 API.
Quando un abbonamento multimodello si adatta al tuo budget
Un progetto con API diretta è adatto a un prodotto che richiede chiamate programmabili e una fatturazione basata sull'utilizzo. Un piano Google AI è adatto agli utenti che desiderano Gemini e i vantaggi offerti dall'ecosistema Google. GlobalGPT È ideale per attività che coinvolgono diversi modelli e funzioni: ricercare un argomento, redigere e rivedere un articolo, chiedere aiuto per la codifica e infine creare contenuti multimediali di supporto, il tutto in un unico spazio di lavoro. La sua interfaccia a riga di comando (CLI) integra inoltre le attività basate sull’intelligenza artificiale con i flussi di lavoro del terminale e di sviluppo.

| Acquista | Come pianificare il proprio budget | Sceglilo per |
|---|---|---|
| API Gemini | Input, output, livello di servizio, cache e strumenti | Sviluppo di software o automazione delle chiamate |
| Abbonamento a Google AI | Piano mensile pubblicizzato negli Stati Uniti, con relativi requisiti di idoneità e limiti delle funzionalità | Utilizzo di Gemini e dei prodotti Google in dotazione |
| Abbonamento al GlobalGPT | Il piano della piattaforma selezionato e le relative tolleranze relative a modelli e funzioni | Un flusso di lavoro più ampio che abbraccia i principali modelli e strumenti multimediali |
Il valore di un abbonamento multimodello risiede nella sua ampiezza e nella praticità del flusso di lavoro. Confronta gli strumenti che utilizzeresti effettivamente e gli abbonamenti separati che altrimenti sarebbero necessari. Scegli un piano le cui quote siano adeguate a quel carico di lavoro; un abbonamento alla piattaforma e l’API di un fornitore ufficiale o un piano consumer sono prodotti diversi.
- Principalmente chat e app di Google? Inizia con il piano Google che meglio si adatta alle tue esigenze quotidiane. La guida a Cosa significa avere accesso gratuito a Gemini può esserti d'aiuto prima di effettuare l'aggiornamento.
- Devi spedire un prodotto? Utilizza un budget API con registri, stime di utilizzo e la corretta configurazione della fatturazione del progetto.
- Ricerca, scrittura, programmazione e media in un'unica routine? Esplorare L'area di lavoro multimodello di GlobalGPT. Per ulteriori opzioni, consultare Alternative al modello Gemini e adattare i loro punti di forza al tuo lavoro.
Come passo pratico successivo alla scelta del percorso di accesso, segui come utilizzare Gemini 3.1 Pro. Quando si seguono le istruzioni di configurazione, è importante distinguere tra l’abbonamento all’app e la fatturazione delle API.
Domande frequenti
Quanto costa Gemini 3.1 Pro per ogni milione di token?
Nel livello API standard Gemini, Gemini 3.1 Pro Preview costa $2 per milione di token in ingresso e $12 per milione di token in uscita per prompt fino a 200.000 token. Oltre i 200.000 token di prompt, le tariffe sono rispettivamente di $4 e $18. La fatturazione in uscita include i token di elaborazione.
Esiste un livello gratuito dell'API Gemini 3.1 Pro?
Google non indica alcun livello gratuito dell'API per Gemini 3.1 Pro Preview. L'app Gemini offre un piano gratuito con accesso variabile alla versione 3.1 Pro, mentre Google AI Studio mette a disposizione uno spazio per provare i modelli. Queste modalità di accesso non prevedono un limite gratuito di utilizzo dell'API in produzione per questo modello.
L'API prevede un costo per le immagini e i video?
Sì. Gemini 3.1 Pro accetta immagini, video, audio e PDF come input, e il loro utilizzo in termini di token incide sul costo. L'importo dipende dal tipo di file multimediale e dalle impostazioni di elaborazione. Il servizio genera testo; la generazione di immagini o video utilizza modelli con tariffe separate.
Si tratta esattamente di 200.000 token di input nella fascia di prezzo più alta?
No. Un prompt di esattamente 200.000 token rientra nella fascia di prezzo standard più bassa. Un prompt superiore a 200.000 token applica le tariffe di input e output più elevate. I token memorizzati nella cache vengono comunque conteggiati ai fini del rispetto dei limiti di token applicabili.
Il piano Google AI Pro $19.99 corrisponde alla fatturazione API?
No. Il piano mensile $19.99 negli Stati Uniti è un abbonamento per consumatori che include un credito mensile per sviluppatori pari a $10. Le linee guida generali di Google sui crediti Cloud riguardano prodotti come Vertex AI e spiegano come applicare un credito a un unico account di fatturazione idoneo. Verifica il tuo credito specifico in «I miei vantaggi», il servizio idoneo, la data di scadenza e il saldo disponibile prima di applicarlo al tuo budget API Gemini. Finché tali dettagli non saranno confermati, pianifica i costi delle API tenendo conto dei crediti.
Qual è il modo più economico per utilizzare Gemini 3.1 Pro?
Per un utilizzo occasionale dell’app, inizia con l’accesso disponibile nel piano gratuito. Per l’utilizzo a pagamento delle API, valuta il numero di token necessari e prendi in considerazione i piani Batch o Flex quando i relativi compromessi in termini di tempi sono adeguati. Per un utilizzo più ampio e sistematico che coinvolga diversi modelli e strumenti multimediali, confronta un abbonamento multimodello con gli abbonamenti separati che altrimenti dovresti utilizzare.
Stabilisci il budget in base al percorso effettivo e al carico di lavoro: Google’s Listino prezzi API per quanto riguarda il software, il suo pagina di abbonamento per l'app Gemini, oppure GlobalGPT per un flusso di lavoro multimodello integrato.



