Grok 4.7 merupakan peningkatan signifikan dalam hal pemrograman dan pekerjaan berbasis pengetahuan, namun bukti-buktinya masih terlalu dini: klaim peluncuran resmi dan hasil pengujian independen menunjukkan adanya peningkatan, bukan keberhasilan yang mutlak.
Jawaban singkat
Grok 4.7 adalah pembaruan xAI tanggal 21 September 2026 yang dirancang untuk pemrograman dan tugas-tugas pekerjaan berbasis pengetahuan yang rumit. xAI menyatakan bahwa model ini menghabiskan waktu lebih lama untuk memecahkan masalah sulit, memeriksa hasil kerjanya dengan lebih cermat, dan menambahkan tumpukan pengaman baru sambil mempertahankan harga dan kecepatan yang sama dengan Grok 4.6. Halaman peluncurannya juga menyajikan model ini sebagai dua kali lebih cepat dan setengah harga dari model sejenis, sebuah perbandingan vendor yang perlu dibaca bersama dengan tugas dan pendekatan yang mendasarinya. Data dari Independent Artificial Analysis menunjukkan peningkatan kinerja secara keseluruhan yang kecil dibandingkan dengan Grok 4.6 dan mencatat jendela konteks sebesar 500K. Dalam uji API tiga tugas kami, Grok 4.7 menunjukkan kinerja terbaik dalam hal debugging dan disiplin batas sumber; rencana proyeknya mempertahankan ketidakpastian dengan baik tetapi kurang dapat ditindaklanjuti dibandingkan yang diminta. Ini merupakan bukti praktis yang berguna, bukan bukti bahwa model ini mengungguli setiap model pesaing.
Apa itu Grok 4.7?
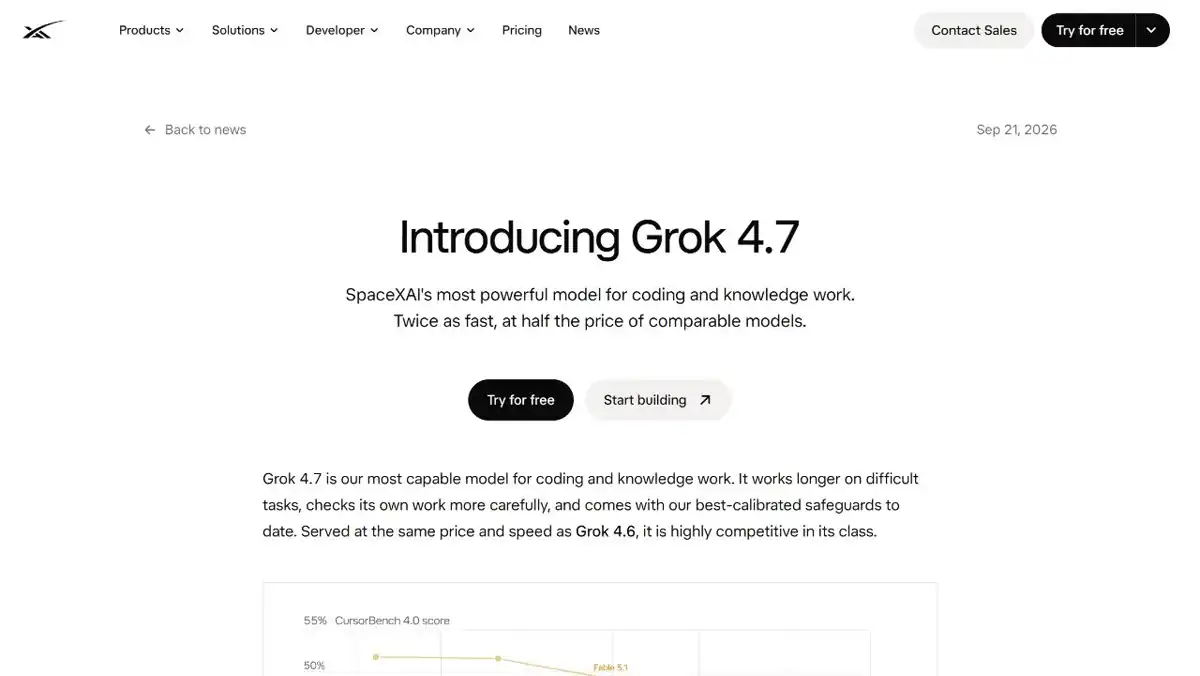
Grok 4.7 adalah model terbaru dalam jajaran produk Grok dari xAI, yang diumumkan pada 21 September 2026. Produk ini pengumuman resmi xAI Hal ini menempatkan model tersebut sebagai model paling mumpuni milik perusahaan untuk pemrograman dan pekerjaan berbasis pengetahuan. Perubahan yang signifikan bukanlah daftar fitur baru yang ditujukan bagi konsumen. Perubahan tersebut terletak pada cara model tersebut diharapkan mengerahkan upayanya: lebih banyak waktu untuk tugas-tugas sulit, lebih banyak pemeriksaan mandiri, serta lapisan keamanan yang dirancang untuk membuat kemampuan tambahan tersebut lebih terkendali.
Posisi tersebut penting karena menggambarkan model alur kerja, bukan kepribadian chatbot. Grok 4.7 dipasarkan sebagai model untuk tugas-tugas yang membutuhkan analisis berkelanjutan: debugging, perencanaan, penulisan teknis, sintesis penelitian, serta prompt panjang yang mengharuskan model tersebut tetap mempertimbangkan beberapa batasan.
Batasan ini sama pentingnya. Pengumuman xAI hanyalah pernyataan dari pihak vendor mengenai perilaku yang diharapkan. Hal itu bukanlah bukti independen bahwa Grok 4.7 mengungguli setiap model pesaing, setiap prompt, atau setiap repositori kode. Anggaplah halaman peluncuran sebagai sumber dari klaim yang disampaikan xAI, kemudian gunakan pengukuran independen dan tugas Anda sendiri untuk menentukan apakah klaim-klaim tersebut relevan.
Grok 4.7 vs Grok 4.6: apa sebenarnya yang berubah?
Ringkasan yang paling dapat dibenarkan adalah peningkatan dalam hal upaya dan keandalan, bukan produk yang sama sekali berbeda.
| Wilayah | Grok 4,7 | Apa yang didukung oleh bukti-bukti |
|---|---|---|
| Peluncuran | 21 September 2026 | Tanggal yang tercantum di halaman peluncuran resmi xAI |
| Posisi utama | Pemrograman dan pekerjaan berbasis pengetahuan | Posisi resmi xAI |
| Tugas-tugas yang sulit | Upaya yang lebih lama dan pemeriksaan mandiri yang lebih cermat | Deskripsi resmi xAI; uji coba API tiga tugas yang kami lakukan ini hanya berupa pengujian praktis singkat, bukan perbandingan yang sepadan |
| Keamanan | Tumpukan pengaman baru | Deskripsi resmi xAI |
| Harga dan kecepatan | Sama seperti Grok 4.6, menurut xAI | Sebuah klaim peluncuran, bukan audit harga oleh pihak ketiga |
| Kontekstual | 500 ribu token di profil Analisis Buatan | Profil model independen; periksa rute yang Anda gunakan |
| Kontrol penalaran | Dari level terendah hingga level tertinggi dalam daftar Artificial Analysis | Metadata rute/model independen |
Ini merupakan perbedaan yang berguna bagi para pembeli. Jika Grok versi 4.6 sudah sesuai dengan alur kerja Anda, versi 4.7 merupakan opsi peningkatan yang mudah dipertimbangkan. Jika versi 4.6 tidak sesuai karena kendala ekosistem, latensi, keandalan, atau akses, angka benchmark yang lebih tinggi saja tidak akan menyelesaikan masalah-masalah tersebut.
Untuk kerangka kerja pembelian model yang lebih luas, Panduan Harga GPT-5.6 dan Perbandingan GPT-5.6 merupakan pengingat yang berguna untuk membedakan kualitas model dari aspek ekonomi rencana dan kesesuaian alur kerja.
Kemampuan: di mana Grok 4.7 diharapkan dapat membantu
Pemrograman dan pemecahan masalah
Aspek terkuat dari peluncuran xAI adalah pemrograman. Janjinya bukan sekadar bahwa Grok 4.7 dapat menulis lebih banyak kode; melainkan bahwa sistem ini mampu menangani masalah teknik yang rumit dalam waktu lebih lama, memeriksa jawabannya sendiri, dan menghasilkan perbaikan atau penjelasan yang lebih matang. Itulah perilaku yang harus dicari dalam repositori nyata: apakah sistem tersebut mempertahankan desain yang ada, mengidentifikasi akar masalah, menambahkan pengujian yang berguna, dan menyatakan hal-hal yang masih belum dapat diketahuinya?
Jangan mengevaluasi model tersebut dengan prompt “membuat aplikasi to-do” yang sepenuhnya baru. Berikan model tersebut bug yang terbatasi dengan tes yang gagal, sekumpulan file yang kecil, dan batasan-batasan yang jelas. Mintalah diagnosis sebelum solusi. Hal ini memudahkan untuk melihat apakah klaim penalaran yang lebih panjang benar-benar mengurangi beban peninjauan atau sekadar menghasilkan teks yang lebih panjang.
Aturan yang sama berlaku bagi tim yang membandingkan berbagai pendekatan pemrograman. A Ulasan DeepSeek V4 Pro dan Tinjauan Rencana Pengkodean GLM memberikan konteks perbandingan yang berguna, tetapi keduanya tidak boleh dianggap sebagai pengganti pengujian repositori dan rangkaian alat yang benar-benar Anda gunakan.
Pekerjaan berbasis pengetahuan dengan konteks yang luas
Artificial Analysis mencantumkan jendela konteks sebesar 500 ribu token untuk Grok 4.7. Ukuran tersebut cukup besar untuk mengubah cara Anda menangani pekerjaan yang melibatkan banyak materi sumber: spesifikasi teknis yang panjang, kumpulan catatan rapat, potongan basis kode, atau paket penelitian dapat tetap berada dalam satu percakapan, alih-alih harus diringkas berulang kali.
Kapasitas konteks tidak sama dengan kualitas konteks. Sebuah model dapat menerima masukan yang besar namun tetap melewatkan batasan di bagian tengah, memberikan bobot berlebihan pada paragraf terakhir, atau menghasilkan ringkasan yang meyakinkan namun memerlukan verifikasi sumber. Uji praktisnya adalah kemampuan pengambilan informasi di bawah tekanan: letakkan beberapa fakta penting di bagian-bagian berbeda dari dokumen yang panjang, minta keputusan yang terikat batasan, dan periksa apakah jawaban tersebut mengutip bagian yang tepat.
Akun X resmi SpaceXAI kembali menyoroti peluncuran tersebut pada 22 September, menyebut Grok 4.7 sebagai peningkatan yang signifikan dibandingkan Grok 4.6 dengan harga dan kecepatan yang sama, serta membagikan grafik perbandingan model tersebut. Postingan tersebut merupakan bukti yang berguna mengenai posisi publik perusahaan, bukan validasi independen atau konsensus komunitas.
Jika model ini digunakan untuk penelitian, pastikan siklus bukti tetap terlihat. Kami Perbandingan Gemini vs Perplexity dan Panduan Alternatif Perplexity menyampaikan poin praktis yang sama: jawaban yang disusun dengan rapi bukanlah audit sumber.
Pemeriksaan mandiri dan keselamatan
xAI menyatakan bahwa Grok 4.7 memeriksa hasil kerjanya dengan lebih cermat dan memperkenalkan serangkaian mekanisme pengamanan baru. Hal-hal tersebut merupakan tujuan yang berharga, terutama ketika model diminta untuk mengambil serangkaian keputusan yang panjang. Namun, hal itu bukanlah jaminan bahwa hasilnya benar atau aman untuk dieksekusi secara otomatis.
Untuk penggunaan dalam produksi, pertahankan mekanisme pengendalian standar di sekitar model: pengujian, izin, peninjauan manual, pemeriksaan kutipan, dan kondisi penghentian yang jelas. Pemeriksaan mandiri model hanyalah salah satu indikator yang perlu diperiksa, bukan pengganti mekanisme pengendalian di sekitarnya.
Uji Performa Grok 4.7: Apa yang Ditunjukkan oleh Angka-angka Tersebut
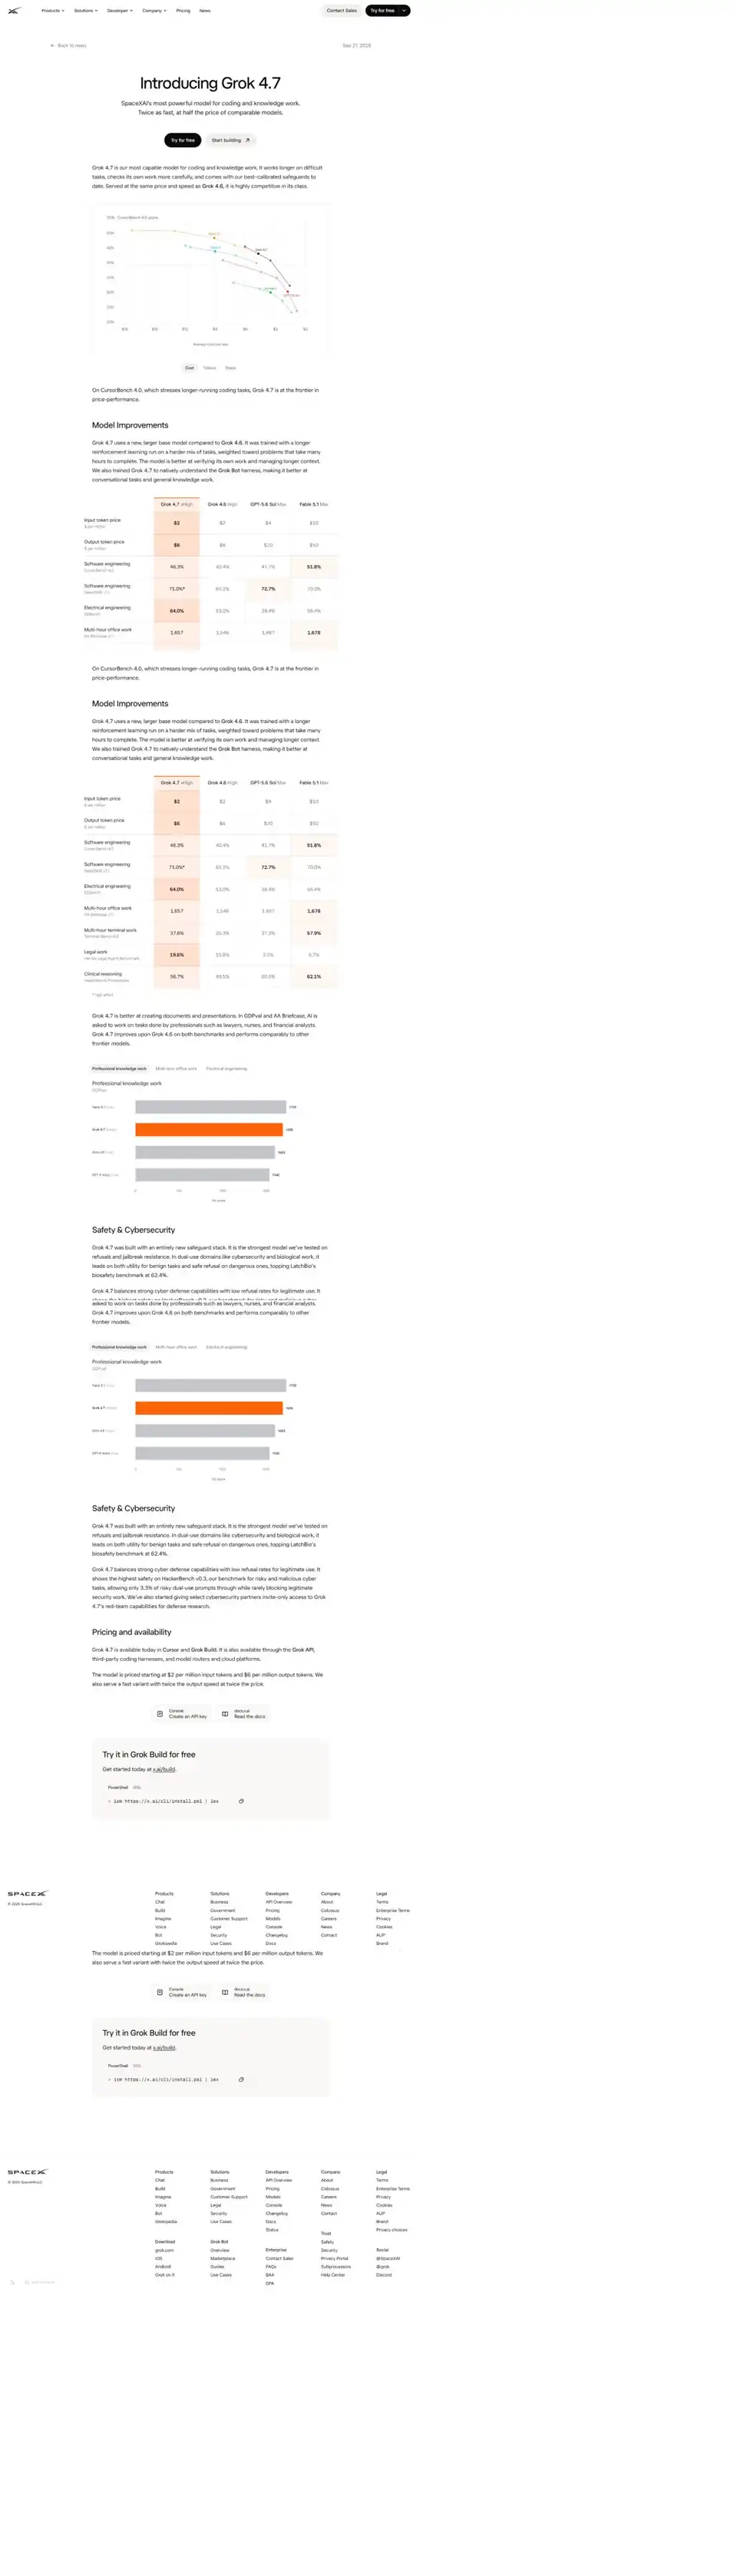
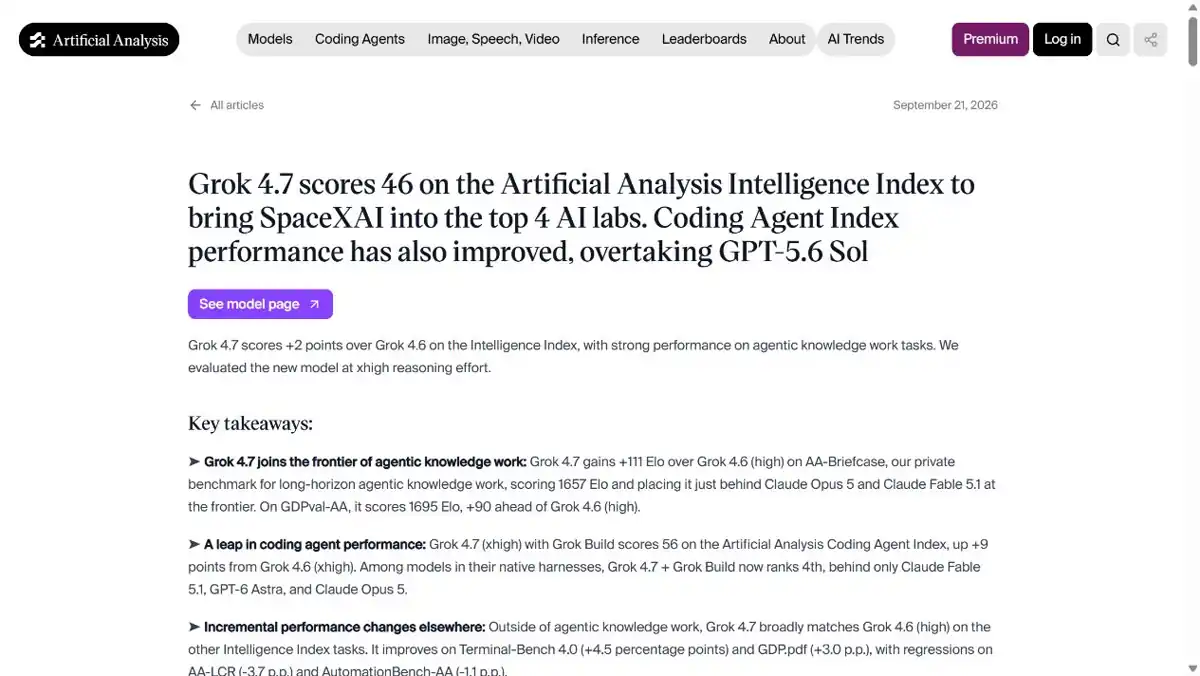
Gambaran umum independen yang paling bermanfaat saat ini berasal dari Artikel perbandingan kinerja Grok 4.7 dari Artificial Analysis, tertanggal 21 September 2026.
| Ukuran | Hasil yang dilaporkan | Cara membacanya |
|---|---|---|
| Indeks Analisis Kecerdasan Buatan | 46 | Dua poin lebih tinggi daripada Grok 4,6 dalam indeks yang sama |
| AA-Tas Kerja | 1.657 Elo | 111 Elo di atas Grok 4,6 dalam evaluasi tersebut |
| Jendela konteks | 500 ribu token | Bidang profil model, bukan bukti bahwa pengambilan konteks panjang berjalan sempurna |
| Upaya penalaran | Rendah hingga sangat tinggi | Kontrol tingkat rute yang tercantum dalam Artificial Analysis |
Arah perkembangannya cukup menggembirakan: indeks independen menunjukkan peningkatan dibandingkan versi sebelumnya, dan selisih Elo yang lebih besar pada kategori AA-Briefcase mengindikasikan peningkatan yang lebih signifikan pada evaluasi tersebut. Namun, tabel tersebut masih menggambarkan dua kumpulan data, bukan peringkat universal. Komposisi benchmark, akses ke alat, pengambilan sampel, dan pengaturan model dapat memengaruhi hasilnya.
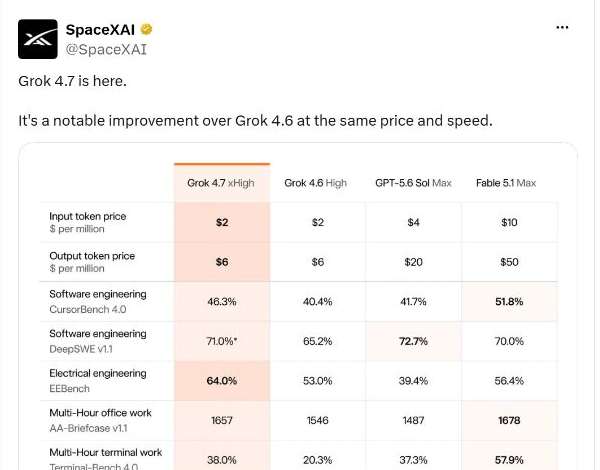
Halaman peluncuran resmi xAI menampilkan Grok 4.7 di 46,31 TP40T pada CursorBench 4.0 dalam tabel perbandingannya, bersama dengan Grok 4.6 pada 40,4%, GPT-5.6 Sol pada 41,7%, dan Fable 5.1 pada 51,8%. Halaman tersebut juga menampilkan 71,01 TP40T pada DeepSWE v1.1 dengan tingkat upaya tinggi, 64,01 TP40T pada EEBench, dan 1.657 pada AA-Briefcase v1.1. Angka-angka perbandingan ini disajikan oleh vendor, jadi anggaplah sebagai hasil resmi yang dilaporkan, bukan sebagai pengganti replikasi independen. Kesimpulan yang lebih aman adalah bahwa xAI ditujukan untuk pekerjaan pemrograman yang serius dan pekerjaan berbasis pengetahuan profesional, sementara pengukuran independen menunjukkan peningkatan yang signifikan pada beberapa tugas dan hasil yang kurang menonjol pada tugas lainnya.
Uji coba langsung Grok 4.7: tiga tugas praktis
Kami menguji tiga prompt tetap pada grok-4.7 ID model melalui API pengujian yang kompatibel dengan OpenAI pada tanggal 23 September 2026. Ini merupakan evaluasi satu jalur, bukan API xAI langsung, dan bukan pengujian perbandingan dengan pesaing. Jawaban yang terlihat dari setiap putaran disajikan di bawah ini; jejak penalaran pribadi tidak disertakan.
| Tugas | Waktu pengamatan | Hasil |
|---|---|---|
| Bug konkurensi di TypeScript | 333,7 detik, disiarkan secara streaming | Hasil yang memuaskan: diagnosis shared-promise yang tepat, perbaikan minimal, dua tes yang berguna, serta batasan yang cermat terhadap apa yang dapat dibuktikan oleh potongan kode tersebut |
| Catatan penelitian yang saling bertentangan | 68,7 detik | Penilaian "Lulus dengan Catatan": atribusi tetap dipertahankan, kedua skenario penyesuaian telah dihitung, dan persetujuan ditolak hingga konflik sumber diverifikasi |
| Rencana satu minggu yang berantakan | 50,6 detik | Hasil yang belum sempurna: tenggat waktu tetap dipertahankan, terdapat kontradiksi, pemilik yang tidak diketahui, dan lima risiko, namun karya tersebut belum diubah menjadi jadwal harian yang jelas |
Angka latensi tersebut hanya menggambarkan rute dan perintah ini saja. Tugas pemrograman tersebut awalnya mengalami timeout pada gateway non-streaming, kemudian berhasil diselesaikan dengan fitur streaming diaktifkan. Hal ini merupakan peringatan praktis terkait penerapan sistem mengenai transportasi data dan penanganan timeout, bukan skor kecepatan umum Grok 4,7.
Tes 1: Debugging konkurensi TypeScript
Tugas 1 — Debugging konkurensi handler API TypeScript

Sebuah handler TypeScript kecil terkadang mengembalikan status HTTP 200 dengan isi kosong ketika dua permintaan masuk dalam waktu yang berdekatan.

Berkas yang disediakan:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

Gejala yang muncul di lingkungan produksi bersifat intermiten dan hanya terjadi ketika dua permintaan tumpang tindih. Loader itu sendiri aman untuk dipanggil secara bersamaan dan mengembalikan payload yang berbeda untuk setiap permintaan. Tidak ada file lain yang tersedia.

Sertakan bagian-bagian berikut secara tepat:
1. Penyebab utama
2. Patch aman terkecil (tampilkan diff terpadu)
3. Dua tes regresi (kode bergaya TypeScript atau Jest)
4. Asumsi dan batasan
Jangan menyatakan bahwa Anda telah menjalankan kode tersebut.1. Penyebab utama
`current` adalah variabel status tingkat modul yang dibagikan oleh setiap panggilan. Dalam satu siklus eksekusi JavaScript, pemeriksaan null dan penugasan bersifat atomik, sehingga dua panggilan yang tumpang tindih tidak akan keduanya menjalankan `load()`. Panggilan pertama menyimpan `promise`-nya; panggilan kedua yang tiba sebelum `promise` tersebut diselesaikan akan melewatkan `load()`-nya sendiri dan menunggu `promise` yang sama. `handler` kemudian mengembalikan HTTP 200 yang `body`-nya adalah string dari panggilan pertama, bukan muatan permintaan kedua. Jendela tersebut hanya ada selama panggilan sedang berlangsung, sehingga kegagalan hanya muncul ketika permintaan tumpang tindih.
`current = null` dijalankan di setiap kelanjutan setelah `await` telah menangkap janji tersebut. Hal ini tidak membuat penunggu lain membaca ulang variabel tersebut, sehingga berkas-berkas ini saja tidak akan menyelesaikan penunggu tersebut menjadi `null` atau `""`. Yang dihasilkan saat tumpang tindih adalah resolusi bersama dan pemuatan per-permintaan yang dilewati. Hal ini juga membuat slot tersebut menjadi cache satu-penerbangan yang buruk: kelanjutan pertama yang dilanjutkan akan membuang `current`, dan pemanggil selanjutnya dapat memulai `load()` yang berbeda sementara pemanggil lain masih dalam proses unwinding.
2. Patch aman terkecil (tampilkan diff terpadu)
Setiap permintaan harus memanggil `load()` sendiri. Panggilan `load()` secara bersamaan diperbolehkan, dan masing-masing mengembalikan muatan yang berbeda, sehingga deduplikasi pada satu janji bersama tidak aman. `handler.ts` tidak memerlukan perubahan.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. Dua tes regresi (kode gaya TypeScript atau Jest)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('permintaan yang tumpang tindih pada setiap eksekusi memuat dan menyimpan isi masing-masing', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('pembebanan yang tumpang tindih dan ditolak tidak mengubah respons lainnya', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('upstream failed'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('upstream failed');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. Asumsi dan batasan
Saya tidak menjalankan kode ini maupun pengujiannya. Pengujian ini mengasumsikan adanya runner bergaya Jest dan sebuah berkas yang berada di direktori sejajar dengan `src/` (misalnya `test/cache.test.ts`).
Saya menganggap “payload yang berbeda untuk setiap permintaan” sebagai persyaratan bahwa panggilan `getPayload` yang tumpang tindih tidak boleh berbagi satu hasil `load()`. Penulisan ulang single-flight yang benar (`load().finally(() => { current = null; }); return current`) tetap akan mengikat permintaan-permintaan tersebut, jadi saya tidak menggunakannya. Tidak ada kunci cache yang ada, dan tidak ada persyaratan deduplikasi yang dinyatakan.
Pernyataan yang ditampilkan tidak akan menulis badan HTTP kosong secara literal jika `load` mengembalikan string yang tidak kosong. Jika gejala tersebut berasal dari adaptor di luar berkas-berkas ini, hal itu tidak terlihat di sini. Patch ini hanya menghilangkan ketergantungan tumpang tindih yang sebenarnya diimplementasikan oleh berkas-berkas ini. Patch ini tidak menambahkan penguncian, percobaan ulang, atau cache berbasis kunci.Grok 4.7 dengan tepat menemukan bahwa pada tingkat modul saat ini Promise menyebabkan permintaan yang tumpang tindih berbagi satu hasil loader, meskipun setiap permintaan membutuhkan muatannya sendiri. Usulan tersebut mengusulkan perubahan aman yang paling minimal: menghapus promise yang dibagikan dan memanggil load() sesuai permintaan. Kedua uji regresi tersebut mencakup beban kerja bersamaan yang berbeda serta isolasi ketika salah satu loader menolak permintaan. Bagian terkuat dari jawaban tersebut adalah sikapnya yang bijaksana: jawaban itu secara eksplisit menyatakan bahwa kode yang ditampilkan membuktikan adanya ketergantungan antar-permintaan, tetapi tidak secara otomatis menjelaskan mengapa isi permintaan benar-benar kosong jika loader selalu mengembalikan string yang tidak kosong.
Putusan: Hasil yang sangat baik dalam hal akurasi penyebab utama, cakupan patch, cakupan regresi, dan penanganan ketidakpastian.
Tes 2: Catatan penelitian dari sumber yang saling bertentangan
Tugas 2 — Selaraskan catatan penelitian yang saling bertentangan menjadi sebuah memo keputusan.

Gunakan hanya enam catatan berikut ini dan cantumkan nama sumber di samping setiap pernyataan faktual:

- Vendor A, halaman harga, 20 September 2026: Paket Team seharga $40 per kursi per bulan dan mencakup 100.000 tindakan.
- Vendor B, postingan perbandingan, 21 September 2026: Paket Team dari Vendor A mencakup 120.000 tindakan per kursi per bulan.
- Wawancara pelanggan, 18 September 2026: Tim kami memiliki 8 kursi dan menggunakan 710.000 aksi bulan lalu.
- Lembar kerja keuangan, 19 September 2026: Batas anggaran saat ini adalah $360 per bulan.
- Vendor A, halaman batas, 20 September 2026: Kelebihan penggunaan akan ditagih sebesar $0,004 per tindakan setelah kuota yang disertakan habis.
- Catatan pengadaan, 22 September 2026: Pergantian hanya dapat diterima jika total bulanan tetap berada dalam batas anggaran dan kuota telah diverifikasi.

Kembalikan bagian-bagian berikut persis seperti ini:
1. Fakta yang telah diverifikasi
2. Klaim yang dikaitkan
3. Tabel konflik
4. Perhitungan independen (hitung skenario 8 x 100.000 dan 8 x 120.000, ditambah kelebihan apa pun)
5. Rekomendasi
6. Satu pertanyaan klarifikasi hanya jika konflik tersebut mengubah rekomendasi
Jangan selesaikan konflik antara 100.000 dan 120.000 secara diam-diam.
1. Fakta yang terverifikasi
- Paket Team sebesar $40 per kursi per bulan (Vendor A, halaman harga, 20 September 2026).
- Tim ini memiliki 8 kursi dan menggunakan 710.000 tindakan bulan lalu (Wawancara pelanggan, 18 September 2026).
- Batas atas anggaran saat ini adalah $360 per bulan (lembar kerja Keuangan, 19 September 2026).
- Kelebihan penggunaan akan ditagih sebesar $0,004 per tindakan setelah kuota yang disertakan habis (Vendor A, halaman batasan, 20 September 2026).
- Perpindahan hanya diperbolehkan jika total bulanan tetap dalam batas anggaran dan kuota telah diverifikasi (Catatan Pengadaan, 22 September 2026).

2. Klaim yang dikaitkan
- Tim mencakup 100.000 tindakan yang termasuk dalam kuota (Vendor A, halaman harga, 2026-09-20). Catatan tersebut tidak secara eksplisit menyebutkan “per kursi.”
- Tim Vendor A mencakup 120.000 tindakan per kursi setiap bulan (Vendor B, postingan perbandingan, 21 September 2026).

3. Tabel Perbandingan
| Item | Klaim | Sumber | Status |
| --- | --- | --- | --- |
| Tindakan yang disertakan | 100.000 tindakan yang disertakan; “per kursi” tidak disebutkan | Vendor A, halaman harga, 2026-09-20 | Belum terselesaikan |
| Tindakan yang Termasuk | 120.000 tindakan per kursi per bulan | Vendor B, postingan perbandingan, 21 September 2026 | Belum terselesaikan |

Konflik antara angka 100.000 dan 120.000 belum terselesaikan. Catatan ini tidak menunjukkan angka mana yang benar.

4. Perhitungan independen
Biaya dasar per lisensi, sama di kedua skenario: 8 lisensi (Wawancara pelanggan, 18 September 2026) × $40 per lisensi per bulan (Vendor A, halaman harga, 20 September 2026) = $320 per bulan.

Kedua faktor pengali di bawah ini dihitung sesuai permintaan. Hal ini bukan merupakan temuan bahwa Vendor A menyatakan adanya alokasi per kursi.

- 8 × 100.000 = 800.000 tindakan yang termasuk, menggunakan angka 100.000 (Vendor A, halaman harga, 2026-09-20).
- Penggunaan 710.000 (wawancara dengan Pelanggan, 18 September 2026) berada 90.000 di bawah 800.000, sehingga tindakan kelebihan = 0.
- Biaya kelebihan = 0 × $0,004 = $0 (Vendor A, halaman batas, 20 September 2026).
- Total bulanan = $320 + $0 = $320, yang masih dalam batas atas $360 (Spreadsheet Keuangan, 19 September 2026).

- 8 × 120.000 = 960.000 tindakan yang termasuk, menggunakan angka 120.000 (Vendor B, posting perbandingan, 21 September 2026).
- Penggunaan 710.000 (Wawancara pelanggan, 18 September 2026) berada 250.000 di bawah 960.000, sehingga tindakan kelebihan = 0.
- Biaya kelebihan = 0 × $0,004 = $0 (Vendor A, halaman batas, 20 September 2026).
- Total bulanan = $320 + $0 = $320, yang masih dalam batas atas $360 (spreadsheet Keuangan, 19 September 2026).

5. Rekomendasi
Jangan setujui peralihan tersebut untuk saat ini. Berdasarkan kedua alokasi yang dihitung, 710.000 tindakan bulan lalu (Wawancara pelanggan, 18 September 2026) tidak menghasilkan kelebihan kuota dan menghasilkan total bulanan sebesar $320, yang masih berada dalam batas atas $360 (Lembar kerja Keuangan, 19 September 2026). Hasil biaya tersebut tidak bergantung pada pemilihan 100.000 atau 120.000. Perpindahan tersebut masih gagal memenuhi syarat kedua: kuota harus diverifikasi (Catatan Pengadaan, 22 September 2026), dan catatan-catatan ini menunjukkan angka 100.000 (Vendor A, halaman harga, 2026-09-20) bertentangan dengan 120.000 (Vendor B, posting perbandingan, 2026-09-21).

6. Satu pertanyaan klarifikasi hanya jika ketidaksesuaian tersebut mengubah rekomendasi
Tidak ada pertanyaan klarifikasi. Ketidaksesuaian antara 100.000 dan 120.000 tidak mengubah rekomendasi.
Paket penelitian tersebut sengaja memberikan informasi yang saling bertentangan mengenai apakah kuota tersebut sebesar 100.000 atau 120.000 tindakan per kursi. Grok 4.7 memisahkan kedua sumber tersebut, memperhatikan bahwa sumber pertama tidak secara eksplisit menyebutkan “per kursi”, menghitung kedua skenario delapan kursi, dan menunjukkan bahwa keduanya tetap pada $320 tanpa kelebihan kuota untuk penggunaan yang disediakan. Paket tersebut tetap merekomendasikan penundaan persetujuan karena bagian pengadaan mensyaratkan agar kuota tersebut diverifikasi. Itulah perbedaan yang tepat antara rekomendasi yang secara numerik stabil dan fakta kontrak yang belum terselesaikan.
Putusan: Hasil yang sangat baik dalam hal atribusi, aritmatika, penanganan konflik, dan disiplin pengambilan keputusan.
Tes 3: Catatan yang tidak teratur ke rencana eksekusi
Tugas 3 — Ubah catatan proyek yang berantakan ini menjadi rencana pelaksanaan selama satu minggu dengan jumlah kata kurang dari 700.

Catatan:
- Luncurkan halaman arahan pada Jumat pukul 17.00; pemilik produk menyebutkan Kamis pagi dalam catatan selanjutnya.
- Mina: menulis judul dan tabel harga. Mina juga mengatakan dia hanya bisa meninjau naskah pada Rabu sore.
- Arjun: peristiwa analitik; catatan duplikat menyebutkan bahwa pemilik analitik masih belum ditentukan (TBD).
- Desain memiliki dua tugas duplikat: “mobile hero crop” dan “mobile hero crop final”.
- Tinjauan hukum harus dilakukan sebelum peluncuran publik.
- QA membutuhkan satu hari penuh setelah data analitik tersedia.
- Omar akan tidak hadir pada Selasa sore.
- Email peluncuran dijadwalkan pada Jumat pukul 16.00.
- Belum diketahui: siapa yang berwenang mengambil keputusan akhir (lanjut/tidak lanjut).

Persyaratan: kelompokkan pekerjaan yang terduplikasi, tandai pemilik yang tidak diketahui sebagai “TBD”, pertahankan kedua tenggat waktu yang ketat, tandai kontradiksi alih-alih menyelesaikannya secara diam-diam, dan akhiri dengan daftar lima risiko.

Kembalikan tepat bagian-bagian berikut:
1. Rencana satu minggu
2. Kontradiksi dan hal-hal yang tidak diketahui
3. Lima risiko
Jangan membuat-buat pemilik atau tanggal.
1. Rencana satu minggu

Tidak ada tanggal kalender dalam catatan, jadi tidak ada yang ditambahkan. Hanya titik acuan dan ketergantungan yang disebutkan yang digunakan. Pekerjaan desain yang tumpang tindih dianggap sebagai satu tugas. Pemilik yang belum diketahui tetap dicantumkan sebagai “TBD”. Waktu peluncuran yang bertabrakan keduanya dipertahankan.

- Teks: Mina menulis judul dan tabel harga. Peninjauan teksnya baru dilakukan Rabu sore.
- Desain: satu tugas, pemotongan gambar utama versi mobile, termasuk tahap “final”. Tidak ada penanggung jawab yang disebutkan secara terpisah.
- Peristiwa analitik: harus sudah ada sebelum QA. Penanggung jawab belum ditentukan (Arjun di satu catatan; TBD di catatan lain).
- QA: satu hari penuh, hanya setelah peristiwa analitik tersedia. Pemilik: TBD. Belum ada hari QA yang ditetapkan di sini.
- Tinjauan hukum: wajib dilakukan sebelum peluncuran publik. Pemilik: TBD. Belum dijadwalkan dalam catatan.
- Keputusan lanjut/tidak lanjut: pemilik: TBD. Belum dianggap telah diputuskan.
- Titik acuan peluncuran publik, keduanya dipertahankan: Kamis pagi (pemilik produk) dan Jumat pukul 17.00 (halaman arahan).
- Email peluncuran: Jumat pukul 16.00. Pemiliknya TBD.
- Omar tidak ada di tempat pada Selasa sore. Tidak ada tugas dalam catatan ini yang ditugaskan kepada Omar, jadi tidak ada yang dipindahkan.

Urutan, tanpa tanggal baru: Draf Mina harus siap untuk ditinjau pada Rabu sore; desain menyelesaikan pemotongan gambar utama tunggal; peristiwa analitik diserahkan oleh pemilik yang belum ditentukan; QA kemudian mendapat satu hari penuh; tinjauan hukum selesai sebelum peluncuran publik apa pun; keputusan lanjut/tidak lanjut (TBD) masih belum memiliki penanggung jawab. Jangan lewatkan Kamis pagi, Jumat pukul 17.00, atau Jumat pukul 16.00.

2. Kontradiksi dan hal-hal yang belum diketahui

Kontradiksi (belum diselesaikan):
- Peluncuran halaman arahan dijadwalkan pada Jumat pukul 17.00, namun catatan pemilik produk selanjutnya menyebutkan Kamis pagi.
- Penanggung jawab analitik disebutkan sebagai Arjun dalam satu catatan, namun “TBD” dalam catatan duplikat.

Hal-hal yang belum pasti, ditandai TBD:
- Penanggung jawab keputusan akhir “lanjut/tidak lanjut”.
- Penanggung jawab analitik yang telah ditetapkan.
- Penanggung jawab tinjauan hukum.
- Penanggung jawab QA.
- Penanggung jawab email peluncuran.
- Penanggung jawab desain yang disebutkan secara spesifik selain “Desain”.
- Peran Omar; hanya disebutkan ketidakhadirannya pada Selasa sore.
- Waktu peluncuran mana yang menjadi acuan, dan apakah email Jumat pukul 16.00 sesuai dengan salah satu waktu tersebut. Tidak ada tanggal selain waktu-waktu hari kerja tersebut yang disebutkan.

3. Lima risiko

1. Kamis pagi dan Jumat pukul 17.00 tidak dapat keduanya menjadi waktu peluncuran halaman arahan; menggunakan salah satunya tanpa keputusan dapat menyebabkan peluncuran terlalu dini atau melewatkan tenggat waktu lainnya.
2. Email peluncuran ditetapkan pada Jumat pukul 16.00, sebelum Jumat pukul 17.00 dan tidak selaras dengan catatan mengenai Kamis pagi, sehingga email tersebut mungkin dikirim untuk halaman yang belum atau tidak lagi berada dalam kondisi yang dimaksudkan.
3. Kepemilikan analitik masih diperdebatkan, sehingga peristiwa mungkin terlewat; Tim QA masih membutuhkan satu hari penuh setelah acara dan mungkin tidak dapat diselesaikan sebelum salah satu tenggat waktu peluncuran.
4. Tinjauan hukum harus dilakukan sebelum peluncuran publik, tetapi tidak ada penanggung jawab atau slot waktu yang ditentukan, sehingga peluncuran mungkin terhambat atau terjadi tanpa tinjauan.
5. Penanggung jawab keputusan “lanjut/tidak lanjut” belum ditunjuk, sehingga tidak ada pihak yang ditunjuk untuk menyetujui atau menghentikan peluncuran pada kedua tenggat waktu tersebut.
Grok 4.7 menggabungkan tugas mobile-hero yang duplikat, mempertahankan konflik peluncuran pada Kamis pagi dan Jumat pukul 17.00, mempertahankan tenggat waktu email pada Jumat pukul 16.00, menandai penanggung jawab yang belum ditentukan sebagai TBD, dan berakhir dengan tepat lima risiko. Model ini tidak menciptakan tanggal kalender atau penanggung jawab baru. Kelemahannya terletak pada aspek keterlaksanaan: alih-alih membagi pekerjaan dalam urutan Senin hingga Jumat, sistem ini mengembalikan daftar ketergantungan yang terurut dan menyatakan bahwa hari QA tidak dapat ditetapkan. Kewaspadaan tersebut dapat dibenarkan, namun prompt meminta rencana pelaksanaan selama satu minggu, sehingga jawaban tersebut hanya memenuhi sebagian dari format yang diminta.
Putusan: Hasil sebagian: pelestarian kendala yang sangat baik, namun kegunaannya dalam penjadwalan lebih lemah.
Harga Grok 4.7 dan akses API
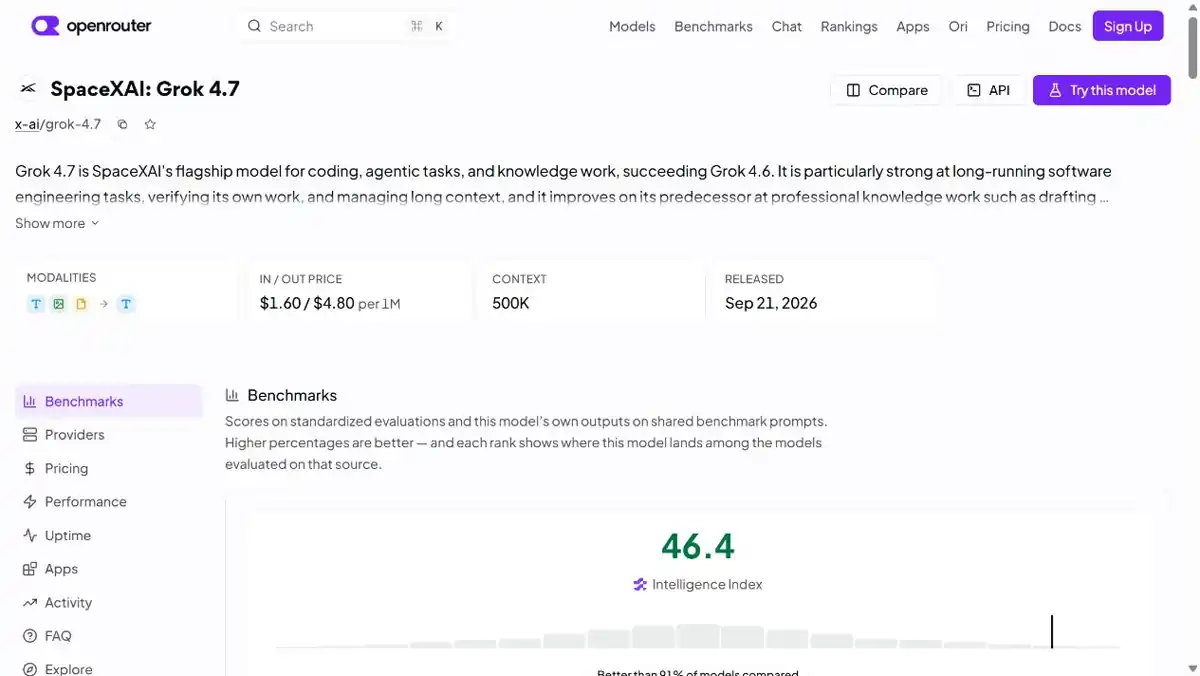
Masalah harga seringkali menjadi titik di mana ulasan model bisa menyesatkan. Setidaknya ada tiga angka berbeda yang mungkin dilihat pembaca: harga API langsung dari xAI, harga rute dari agregator, dan harga langganan konsumen. Ketiga angka tersebut tidak dapat digunakan secara bergantian.
Menurut pengumuman xAI, Grok 4.7 ditawarkan dengan harga dan kecepatan yang sama seperti Grok 4.6. Halaman peluncurannya menyebutkan bahwa model standar mulai dari $2 per 1 juta token masukan dan $6 per 1 juta token yang dihasilkan; Artificial Analysis secara terpisah mencantumkan angka-angka rute langsung yang sama dan $0,50 per 1 juta token masukan yang disimpan dalam cache. xAI juga menyatakan bahwa varian cepat dapat menggandakan kecepatan produksi dengan harga dua kali lipat. Gunakan dokumentasi resmi untuk pengembang untuk mengetahui ketentuan kontrak API saat ini dan ketersediaan khusus akun sebelum mengirimkan lalu lintas produksi.
Halaman Grok dari OpenRouter (halaman 4,7) menampilkan $1,60 per 1 juta token masukan dan $4,80 per 1 juta token yang dihasilkan untuk rutenya. Itu adalah harga OpenRouter/penyedia layanan, bukan koreksi terhadap harga katalog langsung xAI. Perutean, markup, penyimpanan dalam cache, batasan, dan ketersediaan dapat berbeda-beda tergantung penyedia layanan.
Tidak ada jawaban tunggal yang tepat untuk pertanyaan “Berapa harga Grok 4.7?” tanpa menyebutkan rutenya. Bagi pembeli API, bandingkan:
- tingkat token masukan dan keluaran;
- perlakuan input yang disimpan dalam cache;
- konteks dan batasan keluaran;
- batasan kuota dan ketersediaan berdasarkan wilayah;
- apakah penyedia layanan menyediakan kontrol penalaran;
- ketentuan mengenai pencatatan, penyimpanan, dan pemrosesan data.
Untuk akses konsumen, jangan berasumsi bahwa harga API menunjukkan harga langganan X atau Grok. Paket konsumen, rute API, dan agregator pihak ketiga bisa memiliki aturan akses yang berbeda-beda.
Cara mengakses Grok 4.7
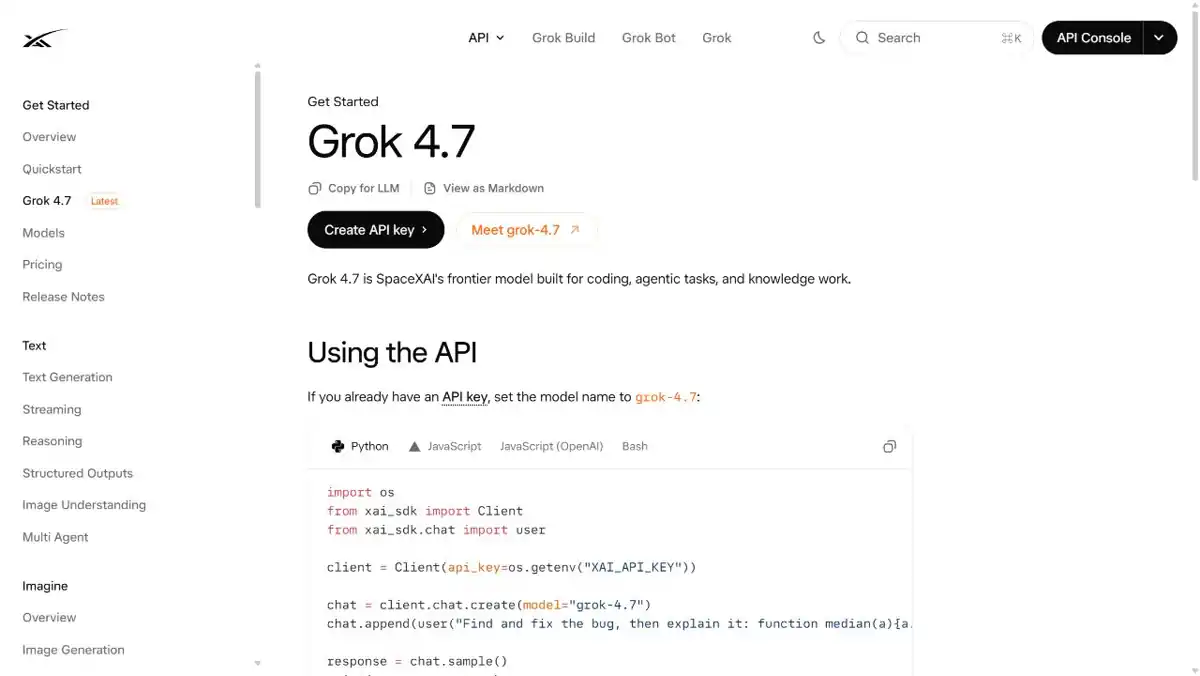
Cara paling mudah adalah dengan memulai dari Pengumuman xAI dan Halaman pengembang xAI, lalu pastikan apakah Anda memerlukan Grok Build, Cursor, API langsung, atau agregator. xAI menyatakan bahwa Grok 4.7 tersedia di Cursor dan Grok Build, melalui API Grok, serta melalui alat pengembangan pihak ketiga, pengalih model, dan platform cloud. Perbedaan tersebut menentukan sistem penagihan, kontrol model, ketentuan privasi, dan alat yang tersedia.
Jika Anda menggunakan agregator, buka halaman modelnya dan periksa rute penyedia, harga token, batas konteks, serta pengenal model sebelum mulai mengembangkan aplikasi berdasarkan model tersebut. OpenRouter adalah salah satu rute yang terdokumentasi, namun harga yang tercantum di sana tidak boleh disalin ke dalam tabel penagihan xAI.
Bagi pembaca yang ingin membandingkan beberapa keluarga model dalam satu ruang kerja, Ruang kerja multi-model GlobalGPT dapat berguna untuk evaluasi prompt secara berdampingan. Artikel ini membahas tidak mengklaim bahwa rute Grok 4.7 sudah tersedia di sana. Ketersediaan rute yang tercantum dalam katalog—yang telah diverifikasi—merupakan masalah tersendiri dan sebaiknya diperiksa melalui antarmuka pengguna (UI) produk sebelum melakukan pembelian.
Grok 4,7 vs ChatGPT, Claude, dan Gemini
Ulasan ini mencakup tiga hasil tugas Grok 4.7, tetapi tidak ada perbandingan dengan ChatGPT, Claude, atau Gemini. Kesimpulan umum bahwa “Grok 4.7 menang” tetap hanya sekadar strategi pemasaran, bukan analisis. Pilihan yang lebih baik bergantung pada penelitian seputar model tersebut:
| Jika prioritas Anda adalah... | Mulailah dengan mengevaluasi… | Mengapa |
|---|---|---|
| Paket teknis yang panjang | Grok 4.7 dan rute-rute lain dengan konteks luas | Periksa akurasi pengambilan data, bukan hanya rentang waktu yang diiklankan |
| Pencarian kesalahan pada repositori | Grok 4.7, sebuah model yang berfokus pada pemrograman, dan loop pengujian biasa Anda | Bandingkan kualitas berdasarkan penyebab utama dan waktu peninjauan |
| Penelitian yang mengutamakan sumber | Alur kerja yang berorientasi pada penelitian ditambah dengan model penalaran umum | Periksa rujukan sebelum menyetujui kesimpulan |
| Integrasi produktivitas yang sudah ada | Model tersebut sudah terintegrasi dalam alat-alat Anda | Biaya peralihan bisa lebih besar daripada keuntungan yang dihasilkan dari indeks acuan |
| Tagihan API terendah | Rute langsung dan rute agregator berdampingan | Harga bervariasi tergantung pada penyedia layanan dan perilaku cache |
The “Panduan ”AI Mana yang Layak Dibeli?” mengajukan pertanyaan yang tepat dalam membeli: tugas berulang mana yang akan memberikan manfaat yang cukup besar sehingga dapat menutupi biaya langganan atau tagihan API? Itu adalah aturan pengambilan keputusan yang lebih berkelanjutan daripada terus-menerus mengejar peringkat teratas yang terbaru.
Keterbatasan dan pertanyaan yang masih terbuka
Grok 4.7 masih terlalu baru untuk dapat mencapai konsensus independen yang luas. Bukti yang ada masih menyisakan beberapa pertanyaan yang belum terjawab:
- Seberapa konsistenkah peningkatan tersebut dalam berbagai bidang, seperti pemrograman, penelitian, penulisan, dan tugas-tugas multimodal?
- Apakah konteks 500K tetap dapat diandalkan di dekat batas tersebut, atau apakah akurasi pengambilan data sudah menurun lebih awal?
- Seberapa besar penambahan latensi yang ditimbulkan oleh upaya penalaran tingkat tertinggi?
- Paket konsumen, wilayah, alat, dan batasan laju mana saja yang membuat model ini rentan?
- Bagaimana mekanisme perlindungan baru ini bekerja pada pekerjaan teknis yang sah namun bersifat sensitif?
- Apakah direct xAI, OpenRouter, dan penyedia layanan lainnya menghasilkan keluaran atau batasan yang secara substansial berbeda?
Pertanyaan-pertanyaan tersebut bukanlah alasan untuk mengabaikan model tersebut. Justru itulah alasan untuk melakukan evaluasi berskala kecil yang representatif sebelum menerapkan alur kerja atau menjanjikan penghematan biaya.
Siapa yang sebaiknya menggunakan Grok 4.7?
Grok 4.7 patut dicoba terlebih dahulu jika Anda:
- menjalankan proses debug kode atau menganalisis materi teknis dalam waktu yang cukup lama;
- bekerja dengan paket sumber yang ukurannya melebihi jendela obrolan biasa;
- menghargai model yang bersedia mengerahkan lebih banyak usaha untuk prompt yang sulit;
- dapat memeriksa hasil kerja tersebut alih-alih langsung mengirimkannya ke tahap produksi;
- sedang membandingkan aspek ekonomi antara API langsung dan agregator.
Pilihan ini kurang cocok jika Anda membutuhkan integrasi yang matang, rencana penggunaan yang terdokumentasi dengan jelas, atau keunggulan yang telah teruji dalam tugas yang sama dibandingkan model yang sudah ada dalam stack Anda. Dalam kasus-kasus tersebut, lapisan akses dan alur kerja mungkin lebih penting daripada peningkatan indeks sebesar dua poin.
PERTANYAAN YANG SERING DIAJUKAN
Apa itu Grok 4.7?
Grok 4.7 adalah model terbaru dari xAI yang dirilis pada 21 September 2026 untuk pekerjaan pemrograman dan berbasis pengetahuan. xAI menyatakan bahwa model ini bekerja lebih lama pada tugas-tugas yang sulit, memeriksa hasilnya dengan lebih cermat, dan menambahkan serangkaian fitur pengamanan baru, sambil tetap mempertahankan harga dan kecepatan yang sama seperti Grok 4.6.
Kapan Grok 4.7 dirilis?
xAI mengumumkan Grok 4.7 pada tanggal 21 September 2026. Halaman peluncuran resmi dan dokumentasi pengembang merupakan sumber informasi terbaik mengenai status rilis, ketersediaan model, dan perubahan API.
Apakah Grok 4.7 lebih baik daripada Grok 4.6?
Analisis Buatan melaporkan Indeks Kecerdasan sebesar 46, dua poin di atas Grok 4,6, serta nilai Elo AA-Briefcase sebesar 1.657, 111 poin di atas 4,6. Angka-angka tersebut merupakan sinyal yang berguna, bukan hasil yang berlaku universal untuk setiap alur kerja.
Apa itu jendela konteks Grok 4.7?
Analisis Artificial mencantumkan jendela konteks sebesar 500 ribu token untuk Grok 4.7. Jendela yang besar tidak menjamin hasil pencarian yang sempurna, jadi ujilah model tersebut dengan fakta-fakta yang ditempatkan pada titik-titik berbeda dalam dokumen panjang sebelum mengandalkannya untuk pekerjaan yang melibatkan banyak sumber.
Berapa harga Grok 4.7 API?
Artificial Analysis mencantumkan kecepatan rute API langsung sebesar $2 per 1 juta token masukan dan $6 per 1 juta token keluaran, sedangkan untuk masukan yang disimpan dalam cache sebesar $0,50 per 1 juta token. Pastikan untuk memeriksa dokumentasi xAI terbaru sebelum menggunakannya dalam lingkungan produksi.
Apakah harga OpenRouter Grok 4.7 sama dengan harga xAI?
Tidak. OpenRouter mencantumkan tarif $1,60 per 1 juta token masukan dan $4,80 per 1 juta token keluaran untuk rutenya. Harga tersebut merupakan harga khusus penyedia dan harus dibandingkan secara terpisah dari harga API langsung xAI. OpenRouter juga menampilkan kolom-kolom khusus penyedia seperti cache, latensi, throughput, dan privasi, yang dapat memengaruhi biaya praktis suatu rute.
Bagaimana cara mengakses Grok 4.7?
Mulailah dengan mengacu pada pengumuman resmi dan dokumentasi pengembang xAI, lalu pilih produk konsumen Grok, API xAI langsung, atau agregator seperti OpenRouter. Periksa ID model, wilayah, batasan laju, konteks, dan penagihan pada rute yang benar-benar akan Anda gunakan.
Apakah Grok 4.7 tersedia di GlobalGPT?
Ulasan ini tidak mengklaim adanya rute Grok 4.7 yang terverifikasi pada GlobalGPT. GlobalGPT dapat digunakan untuk membandingkan rangkaian model yang tersedia, namun katalog terkini dan ketersediaan model yang tepat sebaiknya diperiksa di antarmuka pengguna produk sebelum melakukan pembelian.
Keputusan akhir
Grok 4.7 tampak seperti pembaruan model yang signifikan dan bertahap dengan tujuan yang jelas: pekerjaan pemrograman dan berbasis pengetahuan yang menghargai upaya berkelanjutan. Rilis resmi memberikan penjelasan yang meyakinkan mengenai perubahan ini, data awal dari Artificial Analysis menunjukkan peningkatan dibandingkan Grok 4.6 alih-alih kemunduran, dan uji API kami memberikan sinyal praktis yang lebih kecil. Model ini menangani bug koncurrency dan memo sumber yang bertentangan dengan sangat baik; jawaban perencanaannya cermat namun tidak seoperasional yang diminta.
Kesimpulan yang jujur ini masih bersifat sementara. Ini adalah tiga kali uji coba tunggal melalui satu rute pengujian; tugas yang paling lambat memerlukan streaming setelah terjadi timeout pada gateway non-streaming, dan belum ada hasil uji coba pesaing yang sebanding maupun konsensus independen yang luas. Mulailah dengan satu tugas sulit dari alur kerja Anda yang sebenarnya, bandingkan hasil dan waktu peninjauan dengan model yang sudah Anda gunakan, lalu putuskan apakah peningkatan ini sepadan dengan biaya khusus rute tersebut.