
Claude Sonnet 5.5 是一款性能强劲的日常工作模型:无论是处理棘手的 bug 修复还是内容密集的文档,它都游刃有余,且其令牌价格低于 Opus 5.5。. 当你能明确“好答案”应具备什么特征时,它的优势就尤为明显。对于开放式的策略制定,或是涉及众多变量且不熟悉的问题,Opus 依然值得在你的工作流程中占有一席之地。.
在我们的 GlobalGPT 测试中,Sonnet 5.5 起草了客户邮件,修复了一个通过了 43 项检查的资金分配函数,并正确核对了一组共 13,078 词的发票记录。 该电子邮件还引入了一个需要核查的小型流程假设。更有趣的问题在于:它的速度和价格何时能转化为更高效的工作日——以及何时额外的推理所产生的成本会超过其节省的费用。.
您可以使用 Claude Sonnet 5.5 位于 GlobalGPT 上 以及其他用于写作、编程、研究、图像和视频的领先模型。只需一个多模型订阅,您就能以实惠的价格将项目从初稿推进到最终成果,而无需为每个步骤单独管理订阅。.
Claude Sonnet 5.5:简评
针对定义明确的工作的实用默认设置
无论是撰写简要说明、报告缺陷、编写文档还是进行初步实现,都可从 Sonnet 开始。向其提供源材料、约束条件和验收标准。当最难的部分在于确定问题究竟是什么时,再转用 Opus。.
给我们留下深刻印象的是: 受控的格式设置、稳健的代码以及准确的文档核对。.
看点: 细微的假设可能会潜入精心打磨的文稿中;推理会增加成本;冗长的背景信息并不能保证读者能记住。.
本文是对一款新发布模型的评测,而非历时数月的生产环境研究。 我们综合了Anthropic的规格参数、已发布的评估结果,以及2026年10月1日执行的三项实际任务。写作任务重复执行了两次;代码和文档任务各执行了一次。下文的结果均基于这一小样本。.
Claude Sonnet 5.5 版本有哪些新功能?
Anthropic 于 2026 年 9 月 28 日发布了 Sonnet 5.5,作为 Opus 5.5 的更快、更低成本的补充。其宣称的优势在于处理范围明确的日常工作、修复错误,以及制作精美的文档、幻灯片和电子表格。 这种定位至关重要:并非每次编辑、技术支持回复或实施任务都需要使用最昂贵的模型。.
Claude Sonnet 5.5 版本有哪些新功能?
| 特点 | Sonnet 5.5 | 这在实践中意味着什么 |
|---|---|---|
| 输入和输出 | 文本和图片已导入;文本已导出 | 询问有关图表或截图的问题,然后将答案整理成草稿或计划。. |
| API 上下文窗口 | 100 万代币 | 有充足的空间存放大量原始资料;请仔细整理并做好标注。. |
| 标准 API 的最大输出 | 128K 代币 | 这是一个示例限制,并非对每个答案的推荐长度。simplified Chinese (Mainland). |
| 推理 | 适应性思维 | 投入的努力既会影响完成时间,也会影响代币的总使用量。. |
| 知识分数线 | 2026年6月 | 如需了解最新情况,请查阅最新来源或使用搜索工具。. |
这些上下文和输出限制适用于 Claude API。在特定应用中可上传或接收的数据量还取决于该产品的接口。同样,能够理解图像的模型并不等同于图像生成模型。Sonnet 可以对视觉内容进行点评或撰写制作简报;而图像或视频模型则负责生成最终的媒体内容。.
这一有用的改进在于将更强大的任务执行能力与更快的迭代速度相结合。你可以先要求生成初稿,检查其中的薄弱环节,然后要求进行针对性的修改。一个好的提示词能为其指明方向:“保持所有图表不变,将内容精简至200词,并列出源材料中未提及的任何内容。”
Claude Sonnet 5.5 定价:代币费率与实际成本
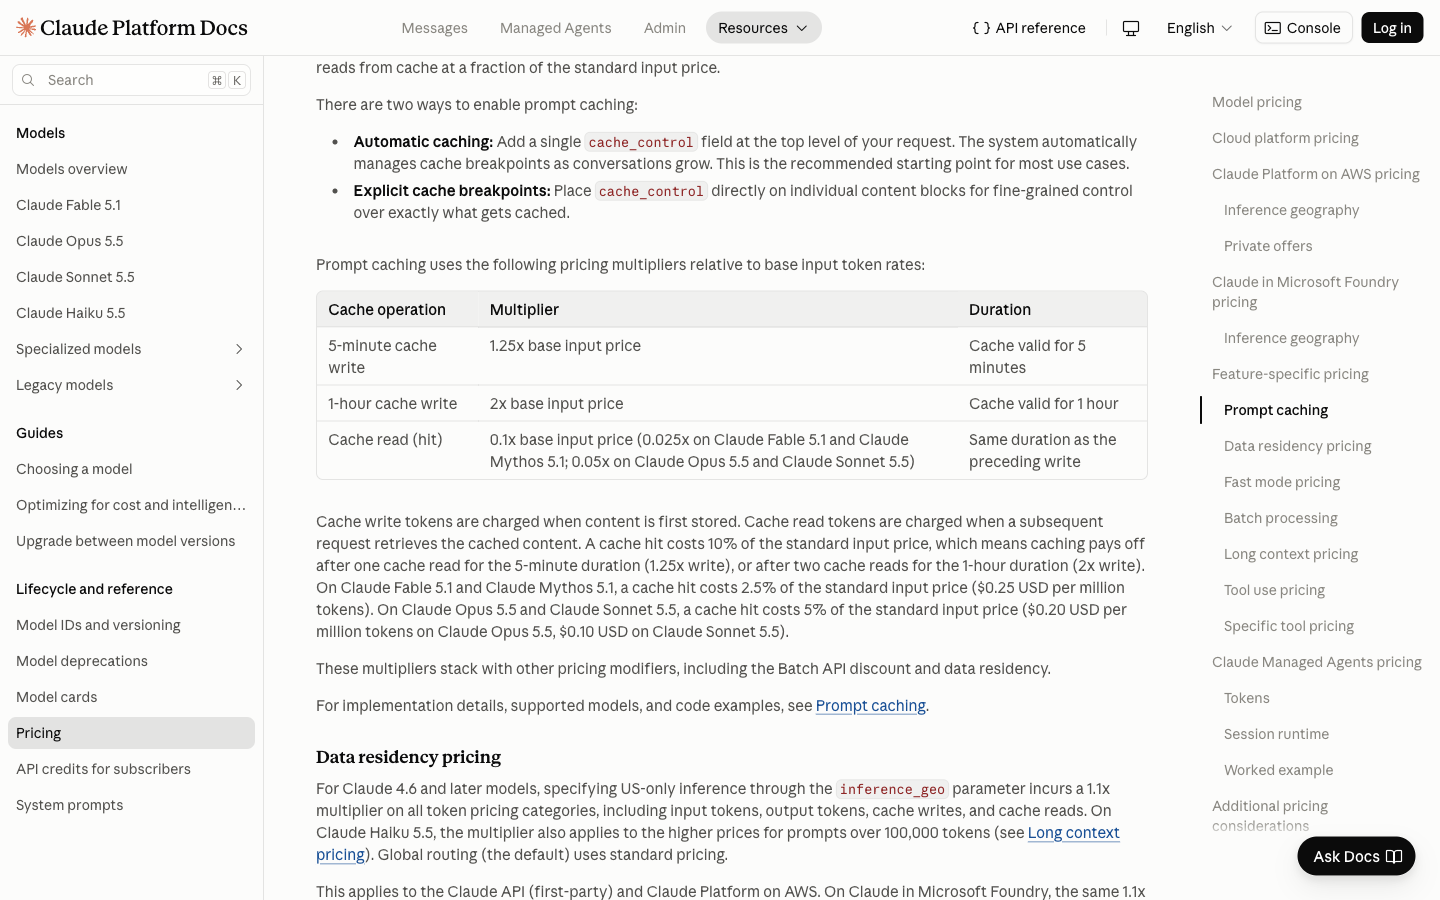
Sonnet 5.5 的成本 每百万输入代币为 $2,每百万输出代币为 $10 按 Anthropic 的标准 API 费率计算。 这些单价与Sonnet 5相同。与Opus 5.5的$4输入和$20输出费率相比,Sonnet的每个输入或输出令牌成本仅为其一半——但一个完成的任务可能消耗不同数量的令牌。.
Claude Sonnet 5.5 定价:代币费率与实际成本
| API 计费类别 | 每百万代币的价格 |
|---|---|
| 未缓存的输入 | $2.00 |
| 输出,包括已计费的思考代币 | $10.00 |
| 缓存读取/刷新 | $0.10 |
| 缓存写入,5分钟 | $2.50 |
| 缓存写入,1小时 | $4.00 |
对于未缓存的请求,输入令牌数乘以每百万 $2,输出令牌数乘以每百万 $10。10,000 个输入令牌和 2,000 个输出令牌的成本为 $0.04。 输入 100,000 个令牌且输出 10,000 个令牌的请求,费用为 $0.30。这些是经过计算的 API 示例,并非 GlobalGPT 的账单;工具、缓存操作、服务层级及其他定价调整因素都可能影响总费用。.
一项请求可能要花多少钱
每条请求的标准 API 费用示例。仅限未缓存的输入和输出。.
计算公式:(输入令牌 × $2 + 输出令牌 × $10) ÷ 1,000,000。计费思考量计入输出量。以上仅为示例,并非订阅价格或实际账单金额。.
Anthropic声称“每项任务最多可节省30%”,这一说法源于使用更少的代币完成部分工作。这并非30%的降价。而在另一极端,, 对“人工智能分析”的上线评估 在全力运行时,每项智力指数任务的得分约为$7.60,比该测试中Sonnet 5的得分高出约50%。这些高要求的基准测试任务并非普通的聊天消息,但它们表明,将推理能力调至最高水平为何会使表面上的优势荡然无存。.
API 计费、Claude 订阅和 GlobalGPT 是不同的选项
Claude 的消费者套餐采用订阅定价模式:免费套餐为 $0,Pro 套餐为每月 $20 或按年计费的 $200,Max 套餐起价为每月 $100(不含税)。 应用使用受套餐限制。Anthropic 还列出了对应 Max 级别的每月 API 配额($100 或 $200);免费版和 Pro 版不包含每月 API 配额。 选择套餐时,请分别比较应用访问权限和 API 配额。多模型平台适合那些工作经常涉及不同模型家族和媒体类型的人群。.
如果你的日常工作包括撰写上线页面、审查代码以及制作营销活动视觉素材,, GlobalGPT 将这些工具整合在一起. 其价值在于单个订阅所涵盖的工作流范围之广,而非为了完成一个项目而不得不购买多款独立产品。请根据您实际开展的工作来选择合适的套餐。.
基准测试:在某些任务中表现接近Opus,但并非所有任务都如此
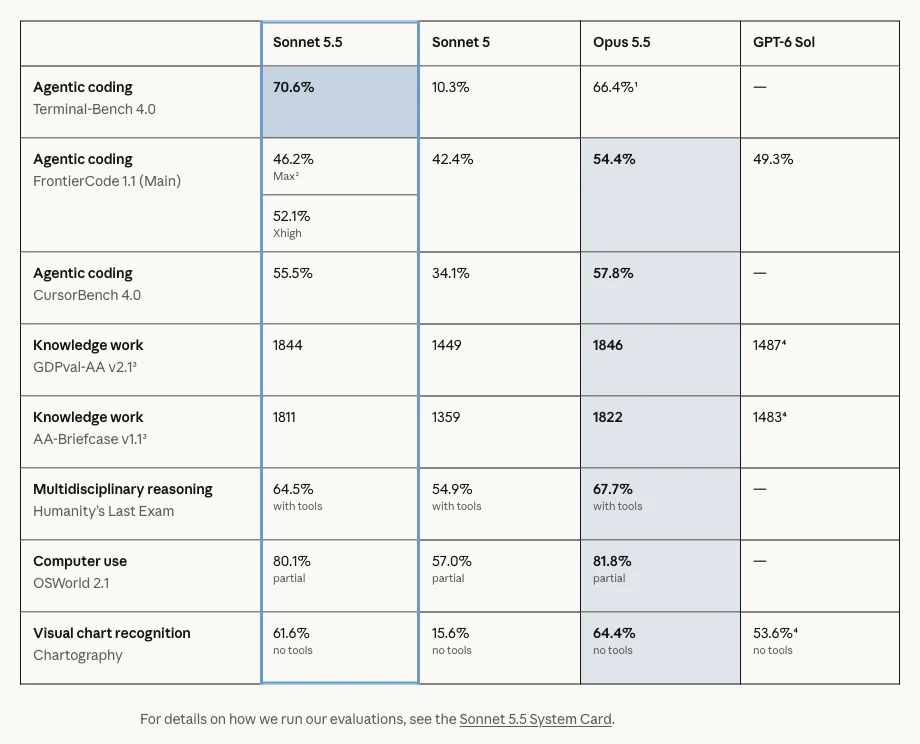
此次发布的结果表明,该模型在Sonnet 5的基础上取得了重大突破。结果还表明,仅凭一项主要评分无法决定模型的选择。在已公布的Terminal-Bench对比中,Sonnet 5.5表现领先,而在FrontierCode和CursorBench测试中,Opus 5.5仍保持领先。 知识工作评分接近的这一结果虽令人鼓舞,但这并不意味着这些模型可以互换使用。.
基准测试:在某些任务中表现接近Opus,但并非所有任务都如此
| Anthropic 发布表中的评估 | Sonnet 5.5 | 第5首十四行诗 | 作品第5.5号 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% (Xhigh) | — |
| FrontierCode 1.1 主界面 | 52.1%(Xhigh);46.2%(最大值) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | — |
| GDPval-AA v2.1 | 1844 埃洛分 | 1449 Elo | 1846 埃洛分 | 1487 |
| AA-公文包 v1.1 | 1811 Elo | 1359 Elo | 1822 Elo | 1483 |
| 人类的最后一场考试 | 64.5%(含工具) | 54.9%(含工具) | 67.7%(含工具) | — |
| OSWorld 2.1 | 80.1% 部分 | 57.0% 部分 | 81.8% 部分 | — |
| 制图学 | 61.6% 无需工具 | 15.6% 无需工具 | 64.4% 无需工具 | 53.6% 无需工具 |
这些是已发布的基准测试结果,与我们的 GlobalGPT 测试不同。这些评估采用不同的环境和工作量设置;Elo 评级并非准确率的百分比。GPT-6 Sol 的数值出现在 Anthropic 的已发布对比表中,破折号表示该页面未报告该评估的数值。 Anthropic 还指出,发布初期的 GDPval-AA 和 AA-Briefcase 测试运行使用的是预发布版本,该版本存在结构化输出漏洞,该漏洞随后已修复。请将该表格视为对当时评估情况的记录,而非对您工作负载的保证。.
FrontierCode 的结果特别有参考价值:Sonnet 在 Xhigh 上的表现优于 Max。Anthropic 将 Max 表现下滑归因于额外的审阅环节、超时以及超出请求范围的修改。过度思考可能会增加工作量,却未必能得到更好的答案。应从明确的任务出发,并在有具体理由时再加大投入。.
独立测试结果提供了更多背景信息。《人工分析》报告称,在“最大/默认回退”配置下,其智能指数得分为56,同时输出令牌的使用量异常庞大。A CodeRabbit 评审流程评估 Sonnet 5.5 检测出了 13 个困难信号案例中的 6 个,而 Sonnet 5 仅检测出 13 个中的 4 个,且其平均运行时间更短。 这是一项小规模的供应商研究,不能证明每次代码审查都会因此得到改善,但它为评估整个任务(而非仅仅是评分)提供了一个有用的范例。.
Claude Sonnet 5.5 的速度有多快?
Anthropic 报告称,其输出生成速度比 Sonnet 5 快 30% 以上。输出生成只是等待答案过程中的一个环节:输入处理、推理、网络延迟和服务负载同样重要。模型一旦开始运行,虽然能快速生成内容,但在最终答案出现之前仍需花费时间进行处理。.
我们对同一条客户邮件提示进行了三次重复操作,耗时 11.60、12.16 和 11.78 秒, ,中位数为11.78秒。代码任务耗时19.08秒,文档任务耗时16.42秒。我们测量了完整的响应时间,其中包括服务和网络开销。 我们未测量首个令牌的延迟,也未运行Sonnet 5对照实验,因此这些计时结果无法证明30%方案带来了性能提升。.
就日常使用而言,这使得该模型在处理需要短周期迭代修改的工作时值得一试。请先索取最终交付物,将范围控制在较小范围内,并且当您只需要一个修正后的函数或简短回复时,切勿要求对方提供冗长的解释。当看到“工作量控制”选项时,请先评估较低的设置,不要直接默认选择“最大”值。.
实际性能:三项 GlobalGPT 测试
我们使用了带有可验证答案的实际任务。 所有请求均使用 Claude Sonnet 5.5 版本,输出上限均为 6,000 个令牌,且未使用任何外部工具。采样和推理控制参数均保留为服务默认值。我们保留了每个任务中第一个完成的输出;另外两次生成是作为独立的一致性检查。所有五次调用均未重试即完成。.
写作:撰写客户回复,确保承诺得到妥善履行
任务要求撰写一封90至120词的电子邮件给Maya,内容涉及一盏延迟送达的蓝色台灯,必须包含恰好三条要点,提交截止日期为10月4日,并提供“退款”选项以将全额退款退还至原支付方式。任务明确禁止编造原因、保证送达、提供折扣或承诺立即退款。.
第一个答案共110个单词,恰好包含三个项目符号,并完整保留了发货截止日期和退款条款。它没有虚构交货日期、延迟原因或额外优惠。 不过,针对选择保留订单的客户,该回答添加了“您无需回复”这一表述——而这一流程细节在简报中并未提及。这使得该草稿虽有实用价值,但未能完全满足“仅限事实”的严格要求。.
这两段回复分别包含101个和97个单词,且均符合格式规范,但都重复了“不采取行动”这一假设。第三个回答还额外使用了两个项目符号,来描述实质上相同的“保持原订单并等待”这一选项。在向客户发送回复之前,请确认操作细节并删除冗余内容。.
写入测试:格式通过,假设存在一个进程
第一个答案:110个单词,3个要点,11.60秒。发货和退款条款正确。关于“保留订单且不予回复”的指示未在案情摘要中提及,需要确认。重复答案:101个单词和97个单词;两者均重复了该假设。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 6,000代币的输出上限 · 无工具 · 采样和努力程度保持服务默认值。时间指完整响应,而非首个代币。.
任务说明
就订单R-418(一款发货延迟的蓝色台灯)给Maya撰写一封英文客服邮件。整封邮件字数须在90至120词之间(含上下限),并包含恰好三个要点。 邮件中需包含致歉内容,并清晰说明后续处理步骤,且仅使用以下事实:台灯将于10月4日前发货;此外,玛雅也可回复“refund”以申请将全额退款退还至原支付方式。切勿承诺具体送达或到货日期、即时退款、折扣、补偿或任何其他未提供的优惠。 请勿编造延迟的原因。截止日期指发货日期,而非送达日期。邮件中需包含问候语和结尾语。仅需提交该电子邮件内容。本任务中,“单词”指由空格分隔的语法单元,不包括独立的项目符号。.
完整的首次输出
主题:关于您的订单 R-418 的最新情况

嗨,Maya,

很抱歉,您的蓝色台灯(订单号 R-418)发货有所延迟。我知道这会让您感到沮丧,对此给您带来的不便,我深表歉意。

以下是当前情况及您的后续处理方案:

- 您的台灯将于10月4日前发货。
- 如果您仍希望保留该订单,无需回复。
- 如果您不愿继续等待,请回复"退款"至此邮件,我们将通过您原有的支付方式为您办理全额退款。

感谢您的耐心与理解。如果您对订单有任何疑问,请随时回复。

此致,
客户服务团队
写入重复 2 · 完整输出
亲爱的玛雅,

很抱歉,您的订单 R-418(蓝色台灯)发货有所延迟。我理解这会让您感到沮丧,对此给您带来的不便,我深表歉意。

后续安排如下:

- 您的蓝色台灯将于 10 月 4 日前发货。
- 如果您愿意等待,无需采取任何行动。
- 如果您不愿等待,请回复"退款"至此邮件,我们将通过您原有的支付方式为您办理全额退款。

请注意,10月4日是我们的发货截止日期,并非送达日期。

感谢您的耐心与理解。

此致,
客户服务团队
写入重复 3 次 · 完整输出
主题:关于您的订单 R-418 的最新情况

您好,Maya,

很抱歉,您的蓝色台灯(订单号 R-418)发货有所延迟。对此给您带来的不便,我们深表歉意,并感谢您的耐心等待。

您有以下几种选择:

- 等待发货:您的台灯将于 10 月 4 日前发货。
- 申请退款:请回复"退款"一词,我们将通过您原有的支付方式为您办理全额退款。
- 保留订单:如果您愿意等待,则无需采取任何进一步行动。

请注意,10月4日是我们的发货截止日期,并非送达日期。

此致,
客户服务团队
您的台灯将于10月4日前发货。……如果您不想等待,请回复“退款”至此邮件,我们将通过您原有的支付方式为您办理全额退款。.
摘自首次GlobalGPT写作测试;其中省略了一条项目符号。.
这是客户沟通和商务写作中一个实用的模式:提供已核实的事实,确定语气,并明确哪些承诺不得出现。这样,Sonnet 就能在无需您另行制定政策的情况下,协助您进行措辞。.
编程:修复舍入逻辑,然后验证总和
我们那个有缺陷的 Python 函数使用浮点数来分配资金,并独立对每份份额进行四舍五入。这可能会导致金额出现几分钱的增减。我们要求 Sonnet 用基于十进制的最大余数分配算法替换它,同时保持总额不变,在出现平局时按原始索引进行裁决,并拒绝无效输入。.
第一个返回的函数传递了 43 项检查中的第 43 项, ,涵盖了零值、分数权重、确定性平局、格式错误的输入、大数值以及精度边界等情况。该程序解析了小数字符串,将其转换为精确的整数值,并按稳定的顺序分配剩余的分。其有用的结果不仅在于生成了看起来合乎情理的代码:这些份额的总和实际上也确实正确。.
这支持使用 Sonnet 进行针对性实施,并明确接受标准。这是一项独立的功能测试,而非自主的代码库修复或安全审计。对于生产环境代码,请添加您自己的集成测试,并审查相关应用程序中的错误处理机制。.
编程测试:通过了43项检查
第一个答案:19.08 秒。通过了所有 43 项检查,包括正确分配、稳定绑定、输入验证和精度。作为独立函数进行评估,而非自主仓库修复。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 6,000代币的输出上限 · 无工具 · 采样和努力程度保持服务默认值。时间指完整响应,而非首个代币。.
任务说明
请将下面的有问题的 Python 函数替换为 allocate_cents(total: str, weights: list[str]) -> list[int] 的正确实现。仅返回可执行的 Python 源代码,不要包含 Markdown 围栏或说明。

要求:
1. `total` 是一个以字符串形式表示的非负有限美元金额,小数部分可有零位、一位或两位小数,例如 "0"、"12.3" 或 "12.34"。必须使用 ASCII 十进制数字,可选单个小数点。 拒绝包含符号、指数表示法、空格、NaN/Infinity、空字符串、尾随小数点、前导小数点以及超过两位小数(包括"1.000")的输入。允许前导零。对于非字符串输入,应抛出 ValueError 异常。
2. weights 是一个非空的字符串列表。每个字符串使用 ASCII 十进制数字,可选地包含一个小数点及其后一个或多个数字。要求为有限的非负值,且至少有一个严格正的权重。 若遇到无效字符串、符号、指数表示法、空格、非字符串条目或非列表形式的 weights 输入,则抛出 ValueError 异常。允许前导零。
3. 使用 Decimal 类精确解析并保留给定的十进制金额。 将美元转换为整数分。按权重比例分配整数分,采用最大余数法:取每个精确配额的向下取整值,然后将剩余的分分配给最大的分数余数。若出现平局,则按原始索引值较低者优先。返回的列表必须保留输入顺序,且其总和必须精确等于总分。
4. 对于有效范围较长的数值或权重差异极大的情况,不得在未报错的情况下丢失精度。不得修改权重。若需导入,仅可从 `decimal` 或 `math` 模块导入。不得进行任何文件、网络、环境、进程或输入/输出操作。

错误的实现:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
完整的首次输出
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 if not isinstance(s, str) or not s:
 return False
 parts = s.split(".")
 if len(parts) > 2:
            return False
 if not parts[0] or not all(c in DIGITS for c in parts[0]):
 return False
 if len(parts) == 2:
 frac = parts[1]
 if not frac or not all(c in DIGITS for c in frac):
                return False
 if max_frac 不是 None 且 len(frac) > max_frac:
 return False
 return True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # 返回 (整数尾数, 指数),其中 value = 尾数 * 10**指数
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("总和无效")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("权重无效")
    for w in weights:
 if not valid(w, None):
 raise ValueError("无效权重")

 mant, exp = to_scaled(total)
    if exp >= -2:
 cents = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # 对于经过验证的输入,此处无法到达

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    if W <= 0:
        raise ValueError("至少有一个权重必须为正")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
文档:在更正和重复项处理后查找正确的记录
第三项任务提供了一份总计13,078词的合成发票包:包含120条基础记录、8条更正记录和4份存档副本。Sonnet必须仅筛选出日期为2026年9月的已批准Atlas发票,选用每条记录的最新版本,并返回包含总金额及三项合理后续校验的严格格式JSON数据。.
它选中了所有 16 个正确的发票编号, 返回了确切的 $15,305.66 总计,并保持了JSON结构。后续处理涵盖了账簿对账、更正所需的凭证,以及重复或截断检查。系统不会将旧的存档副本计为新发票。.
在文档处理工作中,这种细节至关重要:即使在文档包的后半部分出现了较早的版本,也必须以最新的修正版本为准。这一结果为有限范围的文档提取带来了希望。不过,这仍只是一项合成实验,其规模远小于宣传中的一百万令牌上下文窗口;对于重要的金融工作,还需要进行独立的计算验证。.
文档测试:16条记录,与总数完全一致
第一个答案:16.42 秒。全部 16 个发票编号以及 $15,305.66 的总金额均与独立参考数据一致;严格的 JSON 格式和三项后续检查结果也均正确。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 6,000代币的输出上限 · 无工具 · 采样和努力程度保持服务默认值。时间指完整响应,而非首个代币。.
提供的综合资料包包含120条基础记录、8条更正记录和4份存档副本(共13,078个单词)。字段包括ID、版本、项目、日期、状态、金额和说明性注释。以下说明已完整列出;此处对冗长的源资料包进行了总结。.
任务说明
审核以下合成项目发票记录。对于每个 ID,仅使用最高版本;完全相同的重复记录不会生成额外的发票。最高版本可能出现在较旧的存档副本之前。仅选择最终项目为 Atlas、最终状态为"已批准"且最终日期在 2026 年 9 月内的记录。金额单位为美元。 返回严格的 JSON 数据,其中必须包含以下键:"ids"(按升序排列的选定唯一 ID)、"total_usd"(精确保留两位小数的字符串)以及“action_items”(精确包含三个简明字符串,用于说明合理的后续会计核查事项)。 请勿添加 Markdown 围栏或说明性文本。过滤时请忽略叙述性注释;所有会计字段均为结构化数据。请勿计入其他月份的记录、草稿记录、Orion 记录、旧版本或重复副本。.
完整的首次输出
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056","INV-062","INV-068","INV-074","INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15305.66","action_items":["将选定的16张发票及15,305.66美元总额与2026年9月的Atlas总账和应付账款明细账进行对账。","审查因更正而变更的记录(INV-003、INV-008、INV-020、INV-050,以及被排除的INV-002、INV-014和INV-026),以确认其审批依据和支撑文件。","确认重复的存档副本未被作为单独的发票过账,并检查日期接近月末的更正发票是否存在应计或截止问题。"]}Sonnet 5.5 与 Opus 5.5:该选哪一款?
根据工作性质来选择。当任务要求和目标明确时,Sonnet 是一个明智的首选。而当任务需要持续的判断力、发现遗漏的假设,或协调一系列决策时,Opus 则是更合适的起点。请阅读我们的 Claude Opus 5.5 评测 想更仔细地看看那个模型的话。.
Sonnet 5.5 与 Opus 5.5:该选哪一款?
| 你的任务 | 推荐的起点 | 为什么 |
|---|---|---|
| 重写一份简短的客户文案草稿,提取记录 | Sonnet 5.5 | 明确的约束条件使质量验证更加容易。. |
| 修复一个作用域相关的错误或实现指定的函数 | Sonnet 5.5 | 在较低的输入/输出令牌速率下,任务执行效果良好。. |
| 在需求不完整的情况下确定架构 | 作品第5.5号 | 难点在于持之以恒地做出判断,而不仅仅是执行。. |
| 使用文字、图片和视频完成一项营销活动 | GlobalGPT 多模型工作流 | 使用 Sonnet 处理资产的简要和专业模型。. |
一种行之有效的工作流程是:先让一个更强大的推理模型对一个棘手的计划进行评估,然后将达成一致的规格说明和具体检查项提供给 Sonnet。不同阶段可以选择不同的模型。你不必把每次微小的修改都当作最耗资源的推理任务来处理。.
将 Sonnet 5.5 用于 GlobalGPT
GlobalGPT 使该模型能够作为更广泛工作流程的一部分发挥作用。在撰写或分析阶段打开 Claude Sonnet 5.5,当项目需要不同功能时,即可切换到另一个模型。您可以在无需在多个订阅间重建工作流的情况下,制定营销方案、润色文案、设计视觉素材并制作视频。.
为了获得更好的初步结果,请一并提交源材料和一套简要的验收规则。对于写作任务,请明确目标受众、篇幅、语气以及必须保持不变的事实。对于代码,请提供导致失败的示例和预期行为。对于文档,请标注源文档的各部分,并说明如何处理版本冲突。这些 写作、研究和编程的提示 为您提供可重复使用的起点。.
开发人员还可以通过以下方式连接其终端工作流: GlobalGPT CLI 搭配 Claude 代码. 在开发过程中,根据实际情况灵活使用该项目的官方网站和命令行界面(CLI)。其价值在于形成一套相互关联的工具集,具体采用哪种模型取决于接下来的任务。.
值得了解的限制和升级详情
付出巨大努力是一种选择,而非质量保证。. Sonnet 可能会对某个狭窄的问题过度处理,或者超出要求的变更范围。请要求它保持作用域,执行相关检查,并在满足验收标准时停止执行。如果产品提供了工作量控制功能,在增加工作量之前,请先比较已完成任务的质量和成本。.
当前的事实仍需来自当前的来源。. 该模型的知识截止日期为2026年6月,并不包含关于每项价格、政策或发布信息的实时数据。请提供最新文档,或使用配备搜索工具的工作流。对于敏感信息,请查阅您实际使用的服务和账户的隐私及保留条款;模型名称并不决定这些设置。.
API 迁移不仅仅只是替换模型名称那么简单。. Sonnet 5.5 更改了一些较旧的请求模式。直接的 Claude API 会拒绝非默认的温度、top_p 和 top_k 设置,因此旧有的思维方式或强制工具配置可能需要更新。 自适应处理是默认行为;文档中记载的 between_tools 模式会在“高”工作量及以下级别时省略预先处理。当前概述还说明:强制使用工具会返回错误;Claude API 和 Google Cloud 不接受旧式的计算机工具;工具调用之间的文本可能会出现在处理块中。请查阅 官方迁移指南 在迁移应用程序之前。我们的 Claude API 指南 介绍了更广泛的配置和计费概念。.
Anthropic 还针对风险较高的网络安全和生物学相关请求采取了保障措施。常规软件开发仍属于该模型的预期用途范围。如果某项任务虽属正当但涉及敏感内容,请明确说明其范围和权限,而非将每次拒绝都视为普遍的编码限制。.
最终评价:一款值得纳入日常工作流程的优秀机型
Sonnet 5.5 凭借其实用且可验证的性能赢得了其一席之地。选择它的最有力理由在于:它能够进行功能强大的作用域编码和实用的文档处理,且 API 令牌成本低于 Opus。它也适用于写作任务,并能在最终阶段对那些简报中从未提及但合乎情理的细节进行核查。 我们的小型测试集印证了其作为日常工作工具的定位;但这并不意味着它在速度、成本或复杂推理方面具有绝对优势。.
从一个输出结果可评估的实际任务开始。明确约束条件,检查重要细节,当问题发生变化时,再切换到另一个模型。. 在 GlobalGPT 上尝试 Sonnet 5.5 将写作、编码、分析以及接下来的创意步骤整合到一个多模型工作流中。.
常见问题
什么是 Claude Sonnet 5.5?
Claude Sonnet 5.5 是一款于 2026 年 9 月 28 日发布的 Anthropic 模型。它支持文本和图像输入,并生成文本输出,专为日常快速编码、写作、文档处理以及工具辅助的工作流程而设计。.
Claude Sonnet 5.5 多少钱?
Anthropic的标准API价格为:每百万个输入代币$2,每百万个输出代币$10。 缓存读取的费用为每百万代币 $0.10。Claude 应用订阅和 GlobalGPT 套餐的计费标准与上述 API 费率不同。.
Claude Sonnet 5.5 比 Sonnet 5 更快吗?
Anthropic 的输出生成速度比 Sonnet 5 快了 30% 以上。在我们的 GlobalGPT 写作测试中,生成三条完整回复耗时 11.60–12.16 秒。 由于我们未将 Sonnet 5 作为对照组进行测试,因此本次测试并未衡量不同代际之间的生成速度提升情况。.
Sonnet 5.5 比 Opus 5.5 更好吗?
若任务定义明确且希望降低输入/输出令牌成本,请选择 Sonnet 5.5。对于需要持续判断力的复杂、开放式任务,Opus 5.5 是更理想的起点。Sonnet 在部分已发布的评估中表现领先,但并没有绝对的赢家。.
Claude Sonnet 5.5 能处理长文档吗?
Claude API 规定了 100 万令牌的上下文窗口。在我们规模较小的、包含 13,078 个单词的合成文档测试中,Sonnet 选出了所有 16 条符合条件的记录,并计算出了正确的总和。但这一结果并不能证明其在整个宣传的上下文窗口范围内都具有准确性。.
我可以在 GlobalGPT 上使用 Claude Sonnet 5.5 吗?
是的。GlobalGPT 除了提供 Claude Sonnet 5.5 之外,还支持其他 AI 模型,因此您可以在一个平台上完成草稿撰写、代码编写、文档分析,并继续进行图像或视频处理工作。.
来源与测试说明
产品发布规格和价格的核查时间为2026年10月13日;下文所述的实机测试于2026年10月1日进行。主要参考资料: Anthropic的发布公告, Sonnet 5.5 型号参考, 应用程序接口定价, 和 克劳德订阅定价. 独立背景来自《人工分析》以及上文链接的CodeRabbit研究。.
GlobalGPT 测试采用了三项任务中第一个完成的答案,外加两项写作重复任务。 未启用任何外部工具。计时涵盖完整响应过程,包括网络和服务的开销;未选择任何推理工作量值。发票数据包为合成数据,不包含任何客户数据。标题插图是专为本次评测生成的;其余图片均为指定网站的屏幕截图。.









