是的——Grok 4.6 是一款官方的 xAI 模型,於 2026 年 8 月 12 日發布;若您的工作涉及長篇研究資料集、程式設計、多步驟分析或基於影像的任務,這款模型值得您認真關注。. 其 500K 代幣的上下文視窗與可自訂的推理機制,使其具備處理高要求專案的能力,儘管它未必是每項提示詞的最佳或最快選擇。真正的問題已不再是 Grok 4.6 是否存在,而是它的優勢是否符合您實際需要完成的工作。.
如果您希望在不將整個工作流程完全託付給單一服務供應商的情況下回答這個問題,, GlobalGPT 是一個絕佳的起點. 其瀏覽器工作區讓您能夠在同一個介面中,同時使用 Grok 4.6 與其他頂尖模型,執行相同的研究、寫作、分析或程式碼提示,並在同一處比較結果。 這是一種實用且令人耳目一新的簡便方式,讓您在選擇適合自己的設定或訂閱方案之前,先了解 Grok 4.6 真正突出的優勢所在——以及哪個模型更適合您的任務。.
究竟什麼是 Grok 4.6?
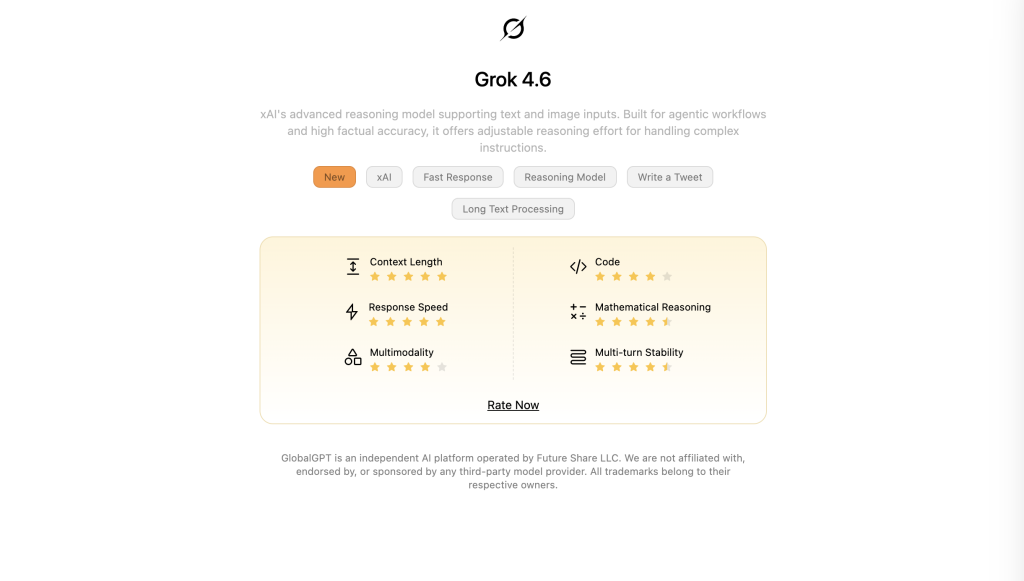
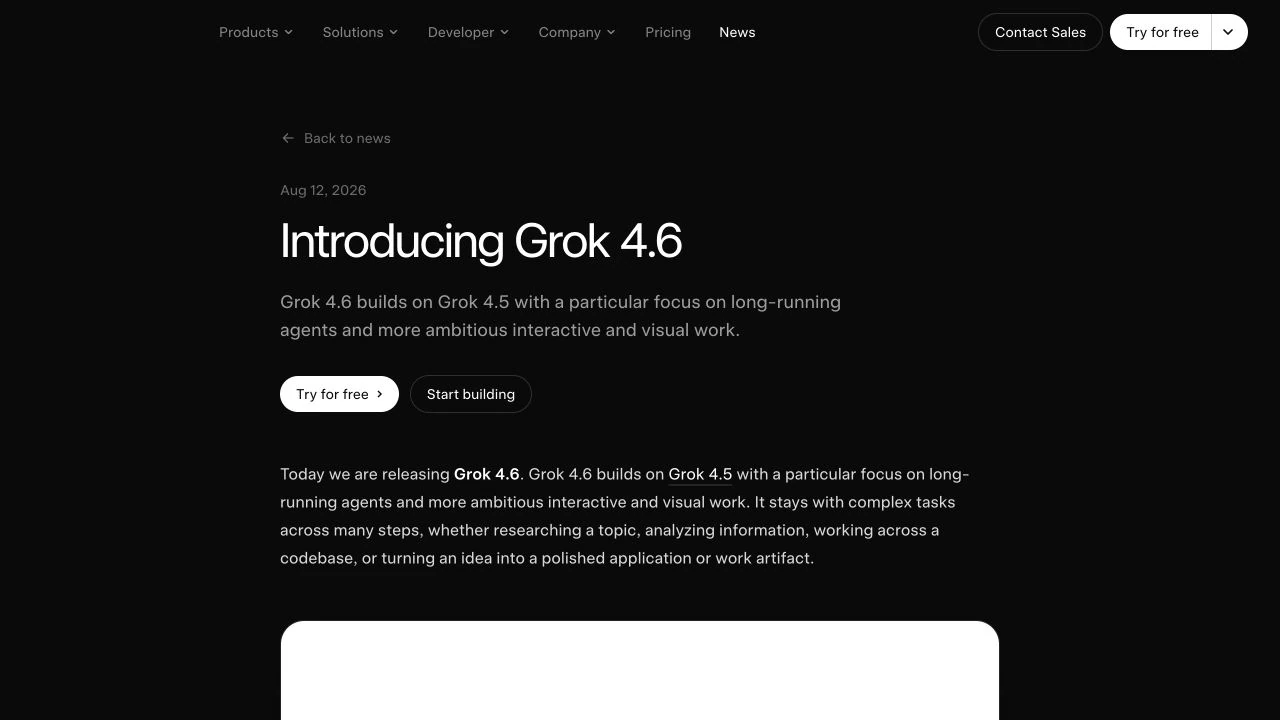
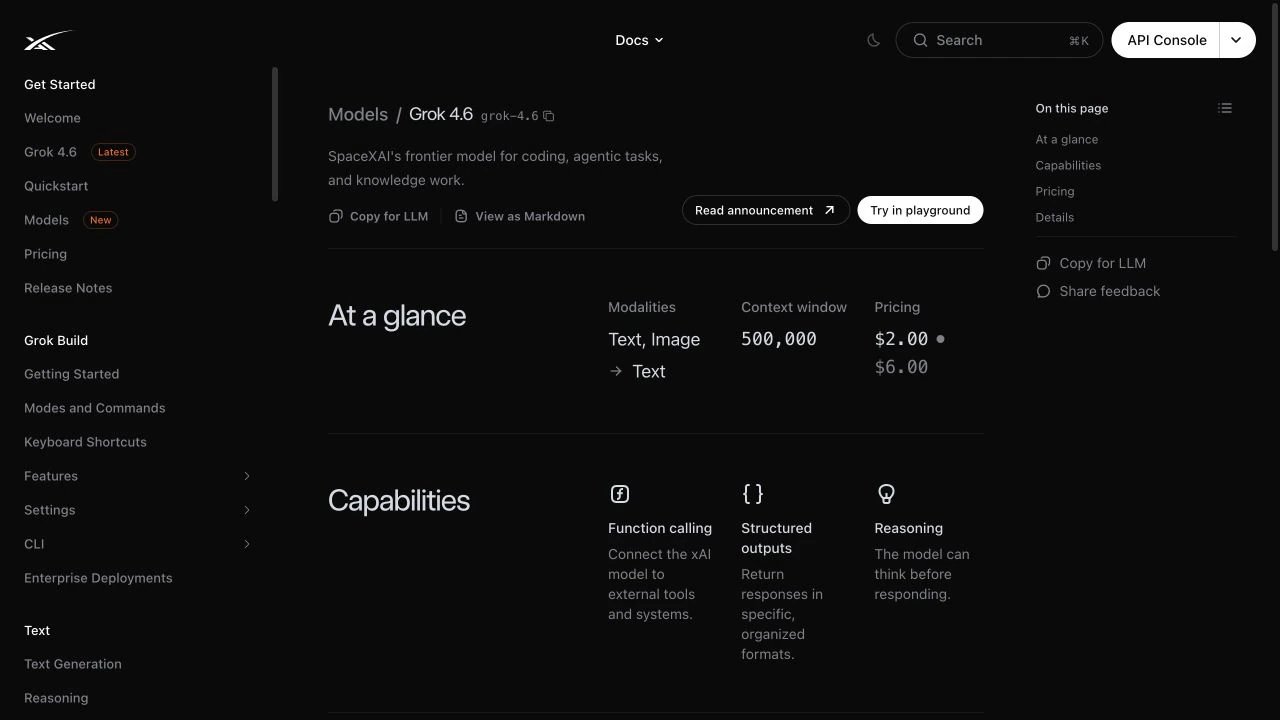
Grok 4.6 是 xAI 在 Grok 系列中的 2026 年旗艦機型。官方型號頁面描述了文字與圖像輸入、文字輸出、可配置的推理功能,以及 500K 令牌的上下文視窗。API 識別碼為 grok-4.6; ;這就是開發人員應在請求中使用的值。.
xAI 自身的發布說明用語相當具體:Grok 4.6 著重於 長期運作的代理程式 以及更具野心的互動式與視覺化作品。官方文件將其定位於程式編寫、具主動性的任務及知識型工作,並透過函式呼叫與結構化輸出,滿足需要工具或可預測回應格式的流程需求。.
該模型說明卡上標註了 2026 年 1 月的預訓練截止日期。這一點至關重要。雖然 50 萬的上下文視窗能讓您提供非常龐大的來源資料包,但這並不代表該模型自動就成為了即時搜尋引擎。針對當前價格、新聞或不斷變化的產品政策,請查證來源並核實答案。.
Grok 4.6 的官方規格為何?
| 規格 | 官方記錄的數值 | 為何重要 |
|---|---|---|
| 發佈日期 | 2026年8月12日 | 確認這是 xAI 的正式發布版本。. |
| API 模型 ID | grok-4.6 | 請在 API 請求中使用此精確的 slug。. |
| 上下文視窗 | 50萬個代幣 | 適用於篇幅較長的簡報、程式碼庫以及以原始資料為主的研究。. |
| 輸入/輸出 | 文字與圖像輸入;文字輸出 | 支援多模態提示,但不支援圖像生成。. |
| 推理 | 可設定的 | 讓工作流程能在速度與更深入的分析之間取得平衡。. |
| 函式呼叫 | 支援 | 將模型與工具及外部系統連接起來。. |
| 結構化輸出 | 支援 | 適用於 JSON、資料擷取及可預測的處理流程。. |
| 預訓練門檻 | 2026 年 1 月 | 請勿將基本型號視為理所當然地為最新版本。. |
來源:xAI 公告、模型文件及 Grok 4.6 模型說明卡。官方規格與獨立性能測試結果可能有所不同。.
Grok 4.6 具有哪些功能?
推理與結構化分析
可配置推理使 Grok 4.6 適用於那些能從深思熟慮的答案中獲益的任務:例如比較證據、建立決策表、規劃實作,或檢查受約束的計算。並非所有請求都必然因增加推理而更佳,因此例行性的提取與重寫應採用適當的設定。.
需要大量研究與資料蒐集的工作
500K 的上下文視窗為模型提供了處理大型報告、逐字紀錄、政策文件及來源資料包的空間。最有效的工作流程是透過明確的定位器與引用規則進行檢索,接著開啟原始來源進行驗證。.
編碼與除錯
已發表的軟體工程評估結果,以及我們進行的小規模除錯測試,均支持將其應用於程式碼審查、錯誤修復及結構化代理任務。開發人員在部署前,仍應在本地執行測試並審查修補程式。.
圖像理解
xAI 可處理包含文字與圖像輸入的文件,並產生文字輸出。此功能支援螢幕截圖解讀、文件影像分析及視覺問答,但不應與影像生成混為一談。.
長期運行的代理程式與工具的使用
這是與 xAI 推出時的定位最密切相關的功能。函式呼叫讓 Grok 4.6 能連線至外部工具,而結構化輸出則使結果更容易傳遞至下一步驟。這種組合非常適合那些需要收集背景資訊、處理程式碼庫、呼叫工具、檢查結果並回傳完成成果的代理程式。 該模型仍需仰賴外部執行環境、權限管理及目標驗證;所謂「代理式(agentic)」並不意味著基礎模型能獨立運作。.
互動式與視覺藝術作品
xAI 還突顯了更具挑戰性的互動式與視覺化作品。一個合理的測試案例,是包含大量螢幕截圖的產品簡報,或是以圖表為依據的報告——在此類情境中,模型必須將視覺證據與書面建議相互連結。在將結果視為最終結論之前,請務必檢查標籤、坐標軸、單位以及遺漏的細節。.
與較早的 Grok 型號相比,Grok 4.6 有什麼變化?
xAI 的定位著重於更強大的推理能力、程式設計代理工作以及長上下文處理表現。此次實質性的升級並非僅靠某項引人注目的功能,而是結合了更廣闊的工作範圍、可調整的推理能力,以及針對複雜多步驟任務所微調的模型。.
這仍需進行工作流程測試。一個模型即使在基準測試中表現優異,也可能與您的寫作風格、引用規範或程式碼庫格格不入。Grok 4.6 最適合透過您每週重複執行的任務來評估,而非僅憑單一的排行榜數值。.
在權威的基準測試中,Grok 4.6 的表現如何?
下表將 xAI 自身模型卡的測試結果與獨立測量結果分開列出。這點至關重要,因為那兩組 Terminal-Bench 數據屬於不同版本,絕不能將其呈現為直接的頭對頭比對分數。.
| 評估員 | 任務/指標 | 報告結果 | 證據類別與限制 |
|---|---|---|---|
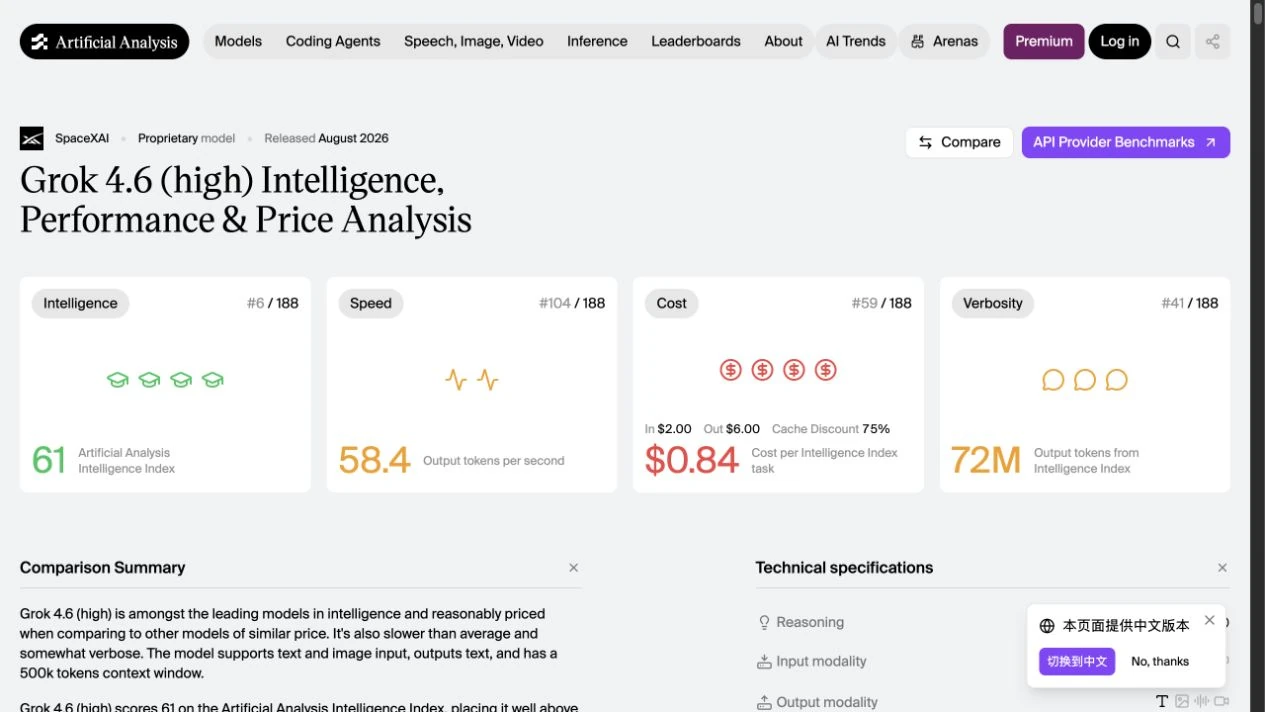
| 人工分析 | 智力指數 | 61(#6/擒獲時為188) | 獨立綜合報告;採用 AA 的方法論及日期。. |
| 人工分析 | 輸出速度 | 58.4 代幣/秒 | 獨立速度快照;路徑與硬體會影響延遲。. |
| 人工分析 | 每項情報任務的成本 | $0.84 | 此為 AA 根據其自身任務組合所作的估算;並非 xAI 的發票。. |
| 人工分析 | GDPval-AA v2 | 1753 | 獨立的工作成果評估。. |
| 人工分析 | AA-公事包 | 1577 | 獨立的知識型工作風格評估。. |
| 人工分析 | Terminal-Bench v2.1 | 88.4% | Independent v2.1 測試結果;無法與 Terminal-Bench 3.0 進行比較。. |
| xAI 模型卡片 | Terminal-Bench 3.0 | 26% | 另一版本的官方模型卡結果。. |
| Mercor APEX-SWE | 軟體工程 | 56.4% ± 6.2% | 200 項任務;應保留不確定性區間。. |
| Mercor APEX-Agents | 代理任務 | 57.5% ± 3.5% | 33 個世界 / 480 項任務;一項特定的代理評估。. |
| xAI 模型卡片 | DeepSearchQA | 81.6% | 供應商通報的研究品質保證狀況。. |
| xAI 模型卡片 | 事實性幻覺發生率 | 1.7% | 此為模型卡的測試條件,並非普遍的錯誤率。. |
資料來源:《Artificial Analysis》、Mercor APEX 排行榜及 xAI 模型卡。請勿將不同資料集、版本、工作量設定或評分者的分數合併計算。.
Grok 4.6 比 Grok 4.5 更好嗎?
官方型號卡給出的答案並非簡單的「是」,而是褒貶參半。Grok 4.6 在 DeepSearchQA 測試中獲得了明顯更高的分數,但同一張卡在事實性幻覺率方面的數值卻高於 Grok 4.5。 嚴謹的評估不應將單一強勢基準測試的結果,演繹為普遍可靠性的論斷。.
| 官方評估 | Grok 4.6 | Grok 4.5 | 該如何解讀這一點 |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | 在這項以搜尋為導向的評估中,據報取得了顯著的進步。. |
| 事實性幻覺發生率 | 1.7% | 0.98% | 數值越低越好;在報告所述的情況下,Grok 4.5 的數值更佳。. |
來源:xAI Grok 4.6 模型卡。這些評估針對不同的問題,並未得出一個通用的優勝者。.
在實際操作中,Grok 4.6 的速度、可靠性和性能表現如何?
已發表的證據顯示這是一種高效能模型,但「表現」包含多個面向:答案品質、延遲、上下文保留、指令遵循能力以及故障恢復能力。在我們的直接路徑中,就緒性探測返回了 HTTP 200 狀態碼,並且 準備就緒. 其他任務的首批有效輸出均成功返回,但其中一項受限編輯請求卻導致了客戶端基礎架構故障。.
「人工分析」除了提供標頭級別的功能外,還增添了一項實用的現實檢驗:其擷取的頁面顯示智慧指數為 61,輸出速度為每秒 58.4 個代號,且每項智慧任務的估計成本為 $0.84。 這組數據顯示,該模型雖具備實用能力,但並非極速型——相較於拋棄式的一行式回覆,它更適合處理具實質意義的工作。.
這種參差不齊的結果頗具參考價值。Grok 4.6 在結構化工作上表現可能相當強勁,但實際生產環境的使用者應設定重試規則、超時設定及備用模型,而非假設每條路由都會有相同的行為。.
Grok 4.6 在哪裡最實用?
長期進行的程式設計與產品開發工作
xAI 的啟動範例涵蓋了主題研究、資訊分析、跨程式碼庫作業,以及將構想轉化為精緻的應用程式或成果。因此,以功能為單位的工作項目,比僅具備單一功能的「玩具式」提示更適合用來評估模型。請為模型提供明確的目標、相關檔案、測試案例以及「完成標準」的定義。.
研究綜述與知識工作
憑藉 500K 視窗、結構化輸出以及強大的 DeepSearchQA 結果,Grok 4.6 自然成為將來源資料包轉化為摘要、標示分歧點或提取決策表的理想選擇。當引用規則明確時,來源核對測試便能佐證此用途。.
大型報告與多文件分析
針對年度報告、成績單、政策文件及專案歷史紀錄等資料,請善用上下文視窗功能,否則將需耗費大量時間進行分段處理。請索取頁碼或章節定位資訊,然後核對原始文件中具重大影響力的數據。.
以圖像為基礎的分析
文字與圖片的輸入功能對於螢幕截圖、圖表及示意圖非常實用。當視覺素材是較大規模推理任務的一部分時,此功能便顯得格外重要,例如在參考書面商業背景資訊的同時檢視儀表板。.
具有明確終點的代理型工作流程
函式呼叫與結構化輸出可支援諸如「調查問題」、「呼叫工具」、「更新計畫」以及「回傳機器可讀的結果」等工作流程。最安全的起點是設定一個具備有限權限、明確停止條件及客觀檢查器的任務。.
| 工作流程 | 為什麼 Grok 4.6 適合 | 最佳入門任務 |
|---|---|---|
| 編碼 | xAI 的定位分析,加上 APEX-SWE 與 CursorBench 的實證資料 | 一個真正的錯誤或功能級別的變更,並附有測試 |
| 研究 | 500K 語境、結構化輸出與 DeepSearchQA | 附有來源依據且包含頁碼定位器的簡報 |
| 長篇文件 | 大型官方上下文視窗 | 年度報告或多份文件組成的政策手冊 |
| 視覺分析 | 影像輸入加上 xAI 視覺工作定位 | 一份包含大量圖表且附有文字說明的報告 |
| 代理商 | 函式呼叫與結構化輸出 | 一項具有明確檢查器的有界調查 |
Grok 4.6 能否勝任研究與事實核對的工作?
來源封包測試要求 Grok 4.6 對六項主張進行分類、僅引用經核准的網址,並駁回兩項誘人的推論。.
(1) 成立 — xAI 的公告日期為 2026 年 8 月 12 日,並表示將於當天發布 Grok 4.6 版本。
(2) 成立 — xAI 官方模型文件中列出的模型 ID 為 grok-4.6。
(3) 已確認 — 官方文件載明其上下文視窗長度為 500k。
(5) 存在矛盾 — 這些是不同的 Terminal-Bench 版本,且採用的是不同的評量指標。
(6) 存在矛盾 — 該頁面僅顯示一個工作區條目,並未表明其包含於所有方案中。.
顯示完整的 Grok 4.6 輸出
| 主張 | 裁決 | 一句答覆 | 來源網址 | 確切限制 |
|---|---|---|---|---|
| (1) xAI 於 2026 年 8 月 12 日宣布推出 Grok 4.6 | 成立 | xAI 的公告日期為 2026 年 8 月 12 日,並表示將於當日發布 Grok 4.6。 | https://x.ai/news/grok-4-6 | 該封包僅引用日期與發布聲明,未引用完整貼文。 |
| (2) 官方 API 模型 ID 為 grok-4.6 | 成立 | xAI 官方模型文件將模型 ID 列為 grok-4.6。 | https://docs.x.ai/developers/models/grok-4.6 | Packet 的摘要未列出別名或其他 ID。 |
| (3) 官方語境視窗為 500k 令牌 | 符合 | 官方文件指出語境視窗為 500k。 | https://docs.x.ai/developers/models/grok-4.6 | 封包中僅提及「500k 上下文」,並未明確引用「token」一詞。 |
| (4) Artificial Analysis 獨立測量出的智慧指數為 61 | 支援 | AA 公布 Grok 4.6 的智慧指數為 61。 | https://artificialanalysis.ai/models/grok-4-6 | 數據包僅報告 AA 的評分,並非對 AA 方法的獨立審計。 |
| (5) Terminal-Bench 3.0(26%)與 v2.1(88.4%)可直接比較 | 相互矛盾 | 這些是不同的 Terminal-Bench 版本,且採用不同的衡量標準。 | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | Packet 同時提供兩組分數,但未提供等效性或對照表。 |
| (6) 一份 GlobalGPT Grok 4.6 頁的文件證明每個方案都包含該模型 | 被駁斥 | 該頁面僅顯示一個工作區條目,並非表示包含在每個方案中。 | https://www.glbgpt.com/home/grok-4-6 | Packet 本身指出這僅為介面條目,並非每個計畫皆然。 |
評測結論: 當來源封包和回應格式明確時,該模型能很好地遵循證據邊界。這對於研究工作流程頗有幫助,但該模型的回應終究僅是研究輔助工具——而非外部證據本身。.
顯示確切的測驗題目
請僅使用隨附的來源資料包。針對六項主張中的每一項,請以一句話回答「獲得支持」、「與之矛盾」或「未確立」,並提供來源網址及確切的限定範圍。.
Grok 4.6 適合用來編寫程式和除錯嗎?
這項 JavaScript 任務要求差異最小、能進行數值排序、正確處理奇數/偶數中位數、具備不可變性,並包含兩種精確的錯誤狀況。.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}顯示 Grok 4.6 所回傳的說明
原始版本會對其參數進行變異處理,並使用預設的字典序排序(sort()),因此會透過 slice() 建立一份副本,並透過 (a, b) => a - b 進行數值排序。 在透過 TypeError 拒絕非陣列,並透過 Error("empty input") 拒絕空陣列後,若結果長度為奇數,則取中間單一元素;若結果長度為偶數,則取兩個中央值的平均值,這即為傳統的中位數。.最佳用途: 中小規模的除錯、撰寫測試、程式碼審查,以及解釋不熟悉的函式。若為大型儲存庫,請將該模型與您自己的測試執行程式搭配使用,並在合併前審閱 diff 內容。.
顯示測試範圍
在不變更其簽名的前提下修復 median(values) 函式。勿修改輸入資料;若輸入非陣列,則拋出 TypeError;若陣列為空,則拋出 Error("empty input");並回傳最簡化的統一差異。.500K 的上下文視窗對處理長篇文件有幫助嗎?
一項涉及超過 22 萬個標記的檢索任務,要求提供七個欄位、章節/頁碼定位資訊,以及關於兩個「Terminal-Bench」版本的說明。.
{
  "release_date": {"value": "2026年8月12日", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "context_window": {"value": "500k 標記", "locator": "p.2"},
  "long_context_input_price": {"value": "每百萬個 token 需 $4(提示詞超過 200K token 時)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88.4%"]
}顯示完整的 Grok 4.6 JSON 輸出
{
  "release_date": {"value": "2026年8月12日", "section": "xAI 發行版", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "API 模型", "locator": "p.2"},
  "context_window": {"value": "500k 標記", "section": "API 模型", "locator": "p.2"},
  "長文脈輸入定價": {"value": "每百萬個標記 $4(提示詞超過 20 萬個標記)", "section": "定價", "locator": "p.3"},
  "終端基準版本": [{"value": "3.0", "section": "基準測試卡", "locator": "p.4"},{"value": "v2.1", "section": "獨立基準測試", "locator": "p.5"}],
  "terminal_bench_score": [{"value": "26%", "section": "基準測試卡", "locator": "p.4"},{"value": "88.4%", "section": "獨立基準測試", "locator": "p.5"}],
  "evidence_limits": {"value": "由於這兩項 Terminal-Bench 結果屬於不同的基準測試版本,因此無法相互比較。未說明實際可用性。", "section": "獨立基準測試", "locator": "p.5"}
}
這證明了什麼: 該模型能夠依據嚴格的結構規範,從龐大且雜訊繁多的資料包中擷取並組織資訊。. 這並不能證明: 即針對任意客戶文件,每 500,000 個代幣的請求,其速度、成本或準確性都將保持一致。.
Grok 4.6 能否遵循嚴格的指示,並以透明的方式進行推理?
針對一項帶有約束條件的資源分配問題,它給出了唯一的解:研究 7 小時、程式設計 9 小時,以及品質保證 8 小時。.
{"R":7,"C":9,"Q":8,"total":24,"check":"這些數值滿足 R+C+Q=24,其中 C=R+2 且 Q=R+1。"}顯示確切的提示文字
請將 24 小時分配給研究(R)、程式設計(C)和品質保證(Q)。 僅回傳包含整數鍵值 R、C、Q 及 total 的 JSON 物件,並附上一句驗證語句。限制條件:R + C + Q = 24;C = R + 2;Q = R + 1。請勿提供隱含的推理過程。.
在客戶兩次嘗試中,獨立的受限重寫任務均未傳回 API 回應。此情況被記錄為基礎設施異常,而非品質評分。從中可汲取的實務教訓是:在編輯製作過程中應預留備用方案。.
Grok 4.6 的價格是多少?
| 選項 | 目前公佈的價格 | 最適合 | 重要的界線 |
|---|---|---|---|
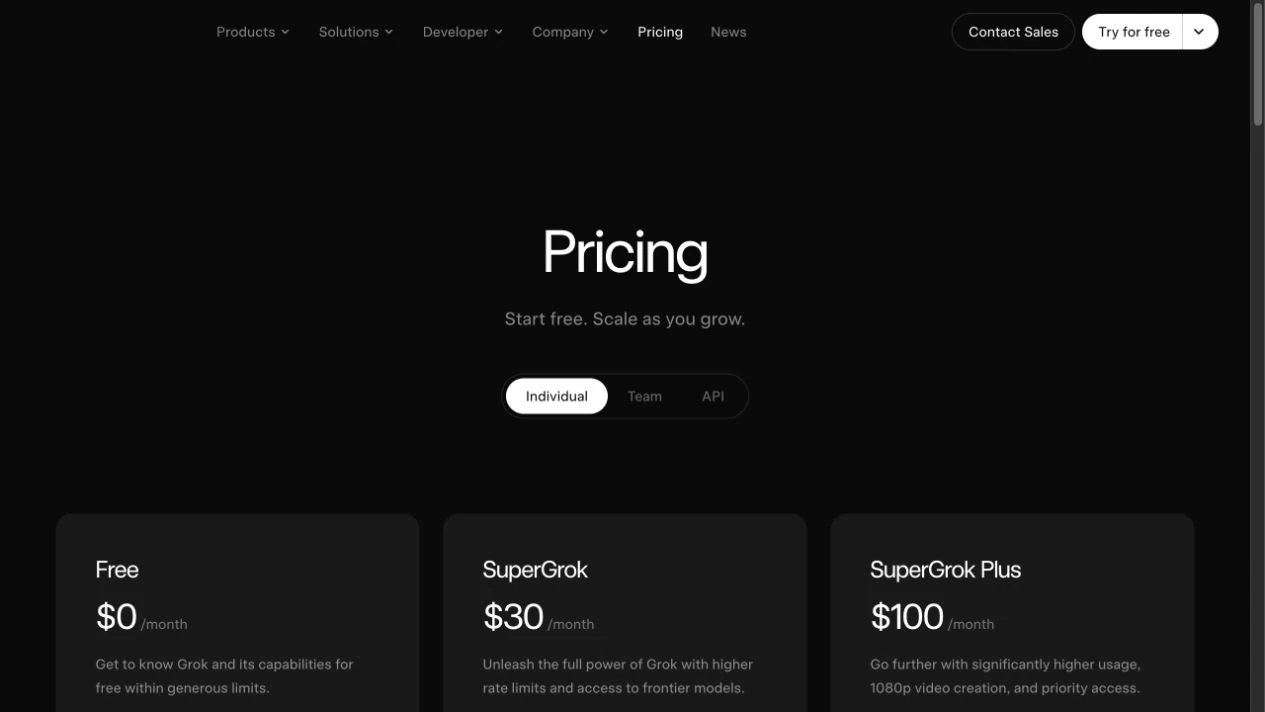
| xAI 消費者版 免費 | $0/月 | 體驗原生消費者體驗。. | 免費方案的存取權限與限制可能會有所變更。. |
| SuperGrok | $30/月 | 一般消費者用途;本頁列出 Grok 4.6。. | 發佈前請先確認目前的權限。. |
| SuperGrok Plus | $100/月 | 使用者使用量龐大;當前頁面列出 Grok 4.6。. | 請勿推斷其他方案是否具備存取權限。. |
| xAI API 基礎方案 | $2/M 輸入;$6/M 輸出;$0.50/M 快取輸入 | 開發者正在建置基於使用情況的整合方案。. | 如適用,工具費用將另行計費。. |
| xAI API 長上下文層級 | 超過 200K:$4/M 輸入;$1/M 快取;$12/M 輸出 | 非常龐大的提示文字和文件。. | 請勿將基準價格用於 200K+ 的請求。. |
| GlobalGPT | 查看當前的 GlobalGPT 計畫 | 在同一個工作區中,將 Grok 與多款領先模型進行比較。. | 請勿假設每個方案都包含 Grok 4.6;請查閱方案頁面。. |
一個 Grok 4.6 API 請求的費用是多少?
| 請求範例 | 計算 | 模型與標記的預估成本 |
|---|---|---|
| 50K 輸入 + 5K 輸出 | 50K × $2/M + 5K × $6/M | $0.13 |
| 100K 輸入 + 10K 輸出 | 100K × $2/M + 10K × $6/M | $0.26 |
| 250K 輸入 + 10K 輸出 | 250K × $4/M + 10K × $12/M | $1.12 |
| 400K 輸入 + 20K 輸出 | 400K × $4/M + 20K × $12/M | $1.84 |
以下為採用 xAI 建議售價計算的算術範例。這些範例未包含快取輸入折扣、稅金、工具調度費及第三方供應商的加價。.
當您的決策重點在於「哪種模型最適合這項任務?」而非「如何將每項任務都交由單一 API 處理?」時,GlobalGPT 便是絕佳的選擇。您可以在同一個工作區中比較寫作、研究、編碼和分析等各類提示語,然後使用該 GlobalGPT 定價頁面 請選擇符合您使用情況的訂閱方案。這是一項多模型訂閱建議,並非將 GlobalGPT 積分轉換為 xAI 代幣的定價方案。.
該如何存取 Grok 4.6?
消費者可以先從 xAI 目前的 Grok 訂閱方案開始使用。開發人員應參閱官方的 xAI API 文件,並使用確切的模型 ID grok-4.6. 若讀者希望在不建立多個 API 帳戶的情況下比較不同模型,可使用已驗證的 Grok 4.6 工作區條目,該條目位於 GlobalGPT; 不應將平台 UI 存取功能與每項原生 xAI 功能混為一談。.
Grok 4.6 的主要限制有哪些?
- 目前這些資訊仍需證據支持: 2026年1月的預訓截止日期並不保證具備實戰知識。.
- 基準測試的標題可能會誤導人: 每個評分都必須附上版本、評分者、推理過程及資料集。.
- 長篇內容的代價更高: 超過 200,000 個代號的提示語將使用較高層級的長上下文 API。.
- 路線的可靠性因情況而異: 儘管其他任務均已成功執行,但我們的受限編輯請求卻遭遇了基礎架構故障。.
- 各平台的存取方式並不完全相同: GlobalGPT 工作區條目並不代表包含所有原生 xAI 功能或所有訂閱權益。.
您應該選擇 Grok 4.6 還是另一種 AI 模型?
當工作重點在於長篇語境、編碼及結構化推理時,請選擇 Grok 4.6。 若您的首要考量是特定的工具生態系統、較低且可預測的成本、特定的多模態輸出,或是團隊已熟稔支援的工作流程,則應選擇其他模型。最公平的比較方式是讓各模型使用相同的提示語、相同的原始資料包以及相同的驗證工具——而 GlobalGPT 能輕鬆協助您進行這類安排。.
哪些人適合使用 Grok 4.6?
- 研究人員與分析師: 原始封包、證據表及長篇陳述書。.
- 開發者: 除錯、程式碼審查及結構化的實作計畫。.
- 創作者與編輯: 當您提供明確的撰稿要點與風格指南時,便能順利完成長篇稿件的起草工作。.
- 各團隊正在比較模型: 在同一個工作區中,針對同一提示進行可重複的評估。.
讀者通常會對 Grok 4.6 提出哪些問題?
Grok 4.6 是否已正式發布?
是的。xAI 的發布公告日期為 2026 年 8 月 12 日。.
官方的 API 模型 ID 是什麼?
grok-4.6.
什麼是「上下文視窗」?
xAI 支援 50 萬個代號的上下文視窗。.
Grok 4.6 是否支援圖片?
是的。官方模型文件中列出了圖像輸入和文字輸出。.
Grok 4.6 多少?
目前的消費者頁面顯示:「Free」方案為每月 $0、「SuperGrok」方案為每月 $30,以及「SuperGrok Plus」方案為每月 $100。 API 定價採用量計費制,且針對超過 200K 個代幣的長上下文有獨立的計費層級。.
Grok 4.6 比 Grok 4.5 更好嗎?
雖然它是較新的版本,且在多項引用的評估中表現優異,但任務內容與基準測試版本有所不同。請自行測試您日常的工作流程。.
我可以在 GlobalGPT 中使用 Grok 4.6 嗎?
GlobalGPT 包含一個已渲染的 Grok 4.6 工作區項目。請在定價頁面確認當前的方案配額。.
Grok 4.6 是否適合用於研究?
該系統在受限來源封包測試中表現良好,但針對重要論點,應始終參照所引用的來源進行核對。.
在 2026 年,Grok 4.6 值得使用嗎?
Grok 4.6 是一款值得信賴且正式發布的模型,具備實用的 50 萬字上下文視窗、可配置的推理機制、強而有力的已發表基準測試證據,並在結構化研究與長篇文件任務上展現出良好的首輪結果。其弱點同樣具有實務意義:基準測試數值需仔細標註版本資訊、即時事實仍需來源佐證,且推理路徑的可靠性可能有所波動。.
若要進行原生使用者存取或 API 開發,請先參閱 xAI 的現行文件。若要採用以比較為導向的工作流程,, 試試 Grok 4.6 搭配 GlobalGPT 與其他主流模型並列,接著選擇最符合您自身寫作、研究、分析或程式設計工作量的方案。.
主要資料來源: xAI 發布, xAI 模型文件, xAI API 定價, xAI 消費者定價, 人工分析, Mercor APEX-SWE 和 xAI 模型卡片.