先從你想發出的聲音開始。. 若需歌曲與結構化的伴奏,請選用 Pick Eleven Music v2;若需旁白與富有表現力的語音,請選用 Qwen Audio 3.0 TTS Flash;當您希望將語音、環境音與音效融合成一個完整的場景時,則請選用 Seed Audio 1.0。.
您無需尋找單一的「最佳」音訊模型。創作背景音樂的創作者、錄製旁白的行銷人員,以及搭建火車站場景的電影製作人,各自所需的模型都不同。我們針對這些實際工作情境進行了測試——而非僅僅列出功能清單——您可以在下方聆聽這十種初始輸出成果。.
如果你想用自己的提示詞來嘗試同樣的點子,, GlobalGPT 讓您能在單一介面中自由切換這三種模式。它同時也是一個功能更全面的多模型工作區: 您可以使用 GPT-5.6 Sol、Claude Opus 4.8 和 Gemini 3.1 Pro 等模型進行寫作與研究,當專案需要圖片或影片時,則可切換至 GPT Image 2 或 Seedance 2.0。 這意味著您可以起草劇本、生成音訊,並持續建構專案的其他部分,而無需將一堆獨立工具拼湊在一起。模型的存取權限因方案而異。.
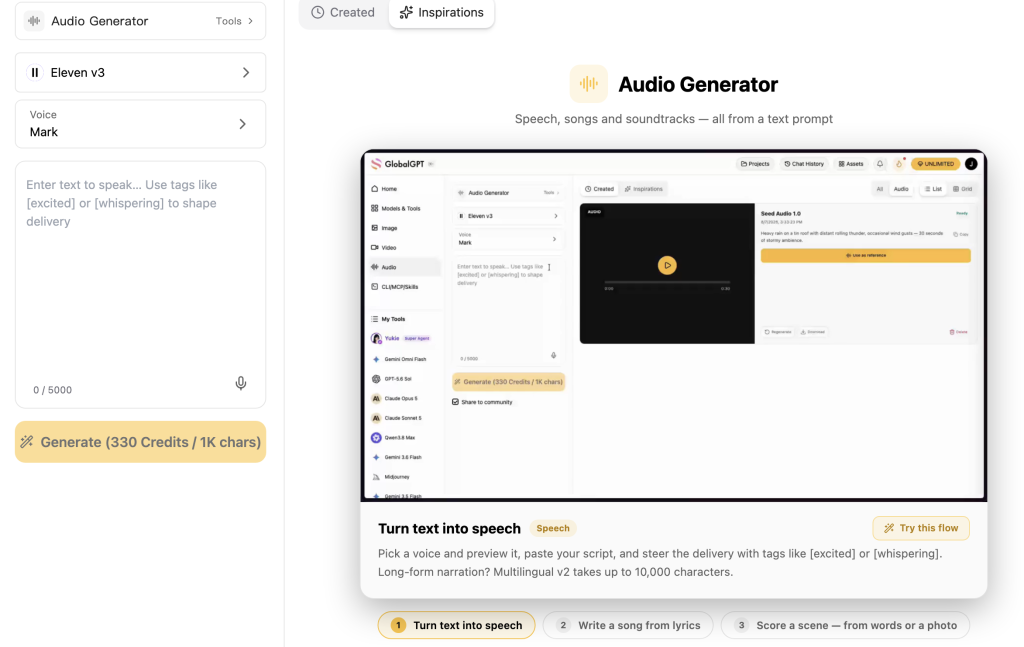
先從你想製作的東西開始
這些只是起點,並非普遍適用的排名。.
簡答:哪種模型適合哪種音訊任務?
以下是簡單的決策方法:根據最終產出物來選擇,而非品牌。當最終產出物是音樂時,Eleven 自然是首選;Qwen TTS Flash 適合旁白和富有表現力的聲音;Seed 則適合需要結合對話、環境音與音效的場景。 我們透過六項實作任務,展示了每種選擇在哪些情境下表現最為出色;而下方的十段示範音檔,則讓您親自聆聽各種選擇之間的取捨。.
| 模型 | 當……時,請從這裡開始…… | 我們嘗試了什麼 | 請謹記 |
|---|---|---|---|
| Eleven Music v2 | 你需要一首歌曲或一首結構完整的器樂曲 | 兩場音樂對決與一場聲樂歌曲展演 | 我們並未將其用於旁白 |
| Qwen Audio 3.0 TTS Flash | 你需要旁白或富有表現力的嗓音 | 兩場演講對決 | 這些結果適用於已測試的 Flash 版本 |
| Seed Audio 1.0 | 你需要一個包含多種音效類型的完整場景 | 音樂、對話,以及一幕火車站場景 | 彈性輸出並不會重現每個上游特徵 |
首先,這有三種不同的音訊模型
Eleven Music v2:專為音樂工作流程設計
ElevenLabs 說明 Eleven Music 可將文字轉為音樂,並能控制曲風、風格與結構。相關文件亦展示了人聲或器樂輸出、多語言生成,以及按段落或整首歌曲進行編輯的功能。這些功能使其成為此處最明確的專用音樂工作流程;但這並不意味著它與 Qwen 採用的是同類的 TTS 路徑。.

Qwen Audio 3.0 TTS Flash:本文測試的語音路徑
Qwen Audio 3.0 TTS Flash——確切的 Anywhere 路徑是 qwen-audio-3.0-tts-flash—這是 B1 和 B2 所採用的語音路徑。. 阿里雲語音合成技術文件 在其自訂語音上下文中列出該確切的 Flash 名稱。本文不會將其他 Qwen 資料列或變體中的持續時間、格式或內建語音聲明轉移過來。.

Seed Audio 1.0:更廣泛的音訊製作工作流程
字節跳動的職位 Seed Audio 1.0 用於生成涵蓋人聲、音效、環境音及統一編曲的完整場景。這使得它成為當單一輸出需協調多種音效類型時的自然選擇。所截取的概覽畫面並未明顯呈現音樂相關內容,因此本文中關於音樂的觀察均源自我們的實際測試,而非該圖片。.

獨立的 BytePlus API 頁面 識別 seed-audio-1.0 作為一種不涉及串流的路線,具備參考音訊或影像輸入、時序控制,以及最長可達 120 秒的輸出時間。這些是路線的具體資訊,與更廣泛的模型定位聲明是分開的。.

我們如何測試這三種音訊工作流程
我們在生成前凍結了提示詞,依序提交了十項任務,並保留了每項任務中的第一個有效輸出。這十項請求均成功完成,且無需任何重試。已排除就緒片段;下方的測試音訊即為原始的第一個有效媒體檔案。.
- 官方證據: 第一方產品或 API 文件。.
- 觀察到的路線證據: 本次會話的格式、持續時間、費用、解碼及訊號檢查。.
- 聽力材料: 某位使用者針對 A1、A2、B1 及 B2 的盲測成對偏好,以及針對 C1 和 C3 的語義評審。.
- 限制: 未執行穩定性檢查;B1 和 B2 並未自動逐字轉錄或核對。.
十項輸出的總計收費為 $0.4819752667。該數字僅用於描述本次服務,並非正式的價格承諾。.
音樂測試:Eleven Music v2 對決 Seed Audio 1.0
A1:紀錄片背景配樂
A1:紀錄片背景配樂
一首長達 30 秒的純器樂旅行紀錄片配樂,旋律漸強,結尾收束得當。.
顯示精確的凍結提示字元
為一部短篇旅遊紀錄片創作一段 30 秒的純器樂配樂。開頭以柔和的指彈原聲吉他與溫暖的鋼琴聲展開,在樂曲前三分之一處加入輕柔的手擊樂器,隨後漸次鋪陳,最後以乾淨俐落的終止式收尾。整體氛圍應充滿希望且富有沉思感。無人聲、無對白,亦無音效。.
| 模型 | 確切路線 | 狀態 | 實際持續時間 | 格式 | 觀察到的成本 |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 首次生效 | 30.041 秒 | MP3,44.1 kHz 立體聲 | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 30,000s | PCM WAV,40 kHz 立體聲 | $0.0700000 |
- 客觀檢查
- 兩份檔案均成功解碼,未出現明顯的剪切現象,且以清晰的淡出結束。未記錄樂器合規性的詳盡資料。.
- 聽眾的判斷
- 聽眾更偏好《Eleven Music v2》,因為其中從輕柔到強勁的漸進感更為自然,樂器間的配合也聽起來更為和諧。.
- 任務結果
- 這項首次產出任務,建議選用「Eleven」。.
- 限制條件
- 每個模型僅產生一個有效的初始輸出;未執行穩定性測試。.
A1 聽力測驗
聆聽 A1 的首批試聽音源
打出任一張卡牌,即可直接比較這兩款型號。.
Eleven Music v2
eleven-music-v2於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
Seed Audio 1.0
seed-audio-1.0於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
針對 A1,聽眾選擇了 Eleven 的第一段演奏,因為其從輕柔到強勁的過渡更為自然,且樂器間的配合也更為和諧。.
A2:結構化產品發佈提示
A2:結構化產品發布提示
一段長達 30 秒、分為三部分的定時器樂配樂:以極簡節奏開場,隨後加入鼓點並逐漸提升能量,最後以明快的高潮收尾。.
顯示精確的凍結提示字元
創作一段 30 秒的純器樂產品發布過場音樂,分為三個清晰段落:0–8 秒,簡約的合成器脈動;8–22 秒,加入清脆的電子鼓聲與逐漸升高的和聲能量;22–30 秒,呈現明亮的最終高潮與乾淨俐落的結尾。 風格應現代且充滿自信,但避免過於激進。不得包含人聲、語音或環境音效。.
| 模型 | 確切路線 | 狀態 | 實際持續時間 | 格式 | 觀察到的成本 |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 首次生效 | 30.041 秒 | MP3,44.1 kHz 立體聲 | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 27.704 秒 | PCM WAV,40 kHz 立體聲 | $0.0646436 |
- 客觀檢查
- 這兩份檔案均已正確解碼,且幾乎沒有剪切現象。針對 30 秒的請求,Seed 回傳的時間為 27.704 秒;這是路由的正常行為,並非品質上的損失。.
- 聽眾的判斷
- 聽眾更偏好《Seed Audio 1.0》,因其前奏更清晰、音樂層次更豐富;而《Eleven》的開場部分則較難聽清。.
- 任務結果
- 此項首輪輸出任務建議採用「Seed」;兩項音樂測試則分開進行。.
- 限制條件
- 該區段的精確計時並未經過徹底驗證;亦未進行穩定性測試。.
A2 聽力測驗
聆聽 A2 的首批作品
打出任一張卡牌,即可直接比較這兩款型號。.
Eleven Music v2
eleven-music-v2於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
Seed Audio 1.0
seed-audio-1.0於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
在 A2 項目中,Seed 的首個輸出結果贏得了聽眾青睞,因為其前奏更為清晰,且層次感更為豐富。針對 30 秒的請求,Seed 路線的輸出時間為 27.704 秒;我們將此偏差單獨記錄,並不視為品質上的扣分。由於兩款模型各在一個音樂任務中表現較佳,因此音樂類別並無勝出者。.
語音測試:Qwen TTS Flash 對比 Seed Audio 1.0
B1:中立的紀錄片旁白
B1:中立的紀錄片旁白
與英文港口解說相同,語調平穩中立、節奏適中,並穿插自然的停頓。.
顯示精確的凍結提示字元
每天早晨,港口總在城市之前甦醒。渡輪在水面上穿梭,店鋪的燈光陸續亮起,第一批通勤者踏上碼頭。到了七點,這片原本寧靜的海岸線已成為白天的中心。以清晰、中立的英語進行平穩的紀錄片旁白。 語速適中,並自然地停頓。無需配樂、環境音或音效。.
| 模型 | 確切路線 | 狀態 | 實際持續時間 | 格式 | 觀察到的成本 |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | 首次生效 | 27.507 秒 | MP3,22.05 kHz 單聲道 | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 18.780 秒 | PCM WAV,40 kHz 立體聲(兩聲道內容相同) | $0.0438200 |
- 客觀檢查
- 這兩份檔案均已正確解碼,且包含類似語音的訊號與停頓。使用者表示未發現明顯的文字問題。.
- 聽眾的判斷
- 聽眾認為 Qwen 聽起來更自然、更具紀錄片風格;而 Seed 聽起來則顯得生硬,就像考前提醒一樣。.
- 任務結果
- 針對此「首次輸出」任務,建議選用 Qwen。.
- 限制條件
- 未經逐字準確性驗證;未進行穩定性測試。.
B1 聽力測驗
聆聽 B1 的首批作品
打出任一張卡牌,即可直接比較這兩款型號。.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flash於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
Seed Audio 1.0
seed-audio-1.0於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
Qwen 的首段輸出聽起來更自然,且具有紀錄片般的質感;而 Seed 聽起來則顯得生硬。若核對文字紀錄是您工作流程的核心環節,這份獨立指南將為您說明 ChatGPT 是如何將音訊轉錄成文字的. 我們並未利用逐字謄本來逐字核對 B1 的內容。.
B2:情感發展
B2:情感發展
一位女性的聲音,從緊張的低語,轉為平淡的敘述,最後變成如釋重負的興奮。.
顯示精確的凍結提示字元
“「我們成功了,」瑪雅輕聲說道。接著燈光重新亮起。「好啦——現在可以慶祝了!」請使用同一位成年女性的聲音,語氣保持一致。第一句以輕聲且緊張的語調說出,中間那句採用中性的敘述語調,最後一句則帶有如釋重負的興奮感。情感變化要清晰明顯,但不要過於做作。無需配樂或音效。.
| 模型 | 確切路線 | 狀態 | 實際持續時間 | 格式 | 觀察到的成本 |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | 首次生效 | 25.913 秒 | MP3,22.05 kHz 單聲道 | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 9.180 秒 | PCM WAV,40 kHz 立體聲(兩聲道內容相同) | $0.0214200 |
- 客觀檢查
- 兩份檔案均已正確解碼;其中包含多個語音區段。持續時間的差異未被計入品質評分。.
- 聽眾的判斷
- 聽眾更偏好 Qwen,因為它能呈現更濃郁的低語質感,並營造出更令人信服的說故事氛圍。.
- 任務結果
- 針對此「首次輸出」任務,建議選用 Qwen。.
- 限制條件
- 未經逐字準確性驗證;未進行穩定性測試。.
B2 聽力測驗
聆聽 B2 的首批試聽音源
打出任一張卡牌,即可直接比較這兩款型號。.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flash於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
Seed Audio 1.0
seed-audio-1.0於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
Qwen 的首次輸出結果展現出更強烈的低語特質,且更具敘事感。使用者在 B1 或 B2 中未察覺明顯的文本問題,但確切的詞彙準確性仍待驗證。.
單一模型工作流程示範
C1:Eleven Music v2 結構化人聲歌曲
C1:結構化聲樂歌曲
一首長達 30 秒的獨立流行歌曲,其編制、曲式固定,且必須包含兩句指定歌詞。.
顯示精確的凍結提示字元
創作一首 30 秒的輕快獨立流行歌曲,包含一名女主唱、明快的吉他、貝斯及拍手聲。曲式結構:4 秒的器樂前奏、一段簡短的 verse、副歌,以及乾淨俐落的結尾。 請將以下每句歌詞各使用一次:主歌:「晨光灑落窗邊,計畫正展翅高飛。」副歌:「從當下出發,讓此刻綻放光芒。」請勿加入任何旁白或音效。.
| 模型 | 確切路線 | 狀態 | 實際持續時間 | 格式 | 觀察到的成本 |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 首次生效 | 30.041 秒 | MP3,44.1 kHz 立體聲 | $0.0750000 |
- 客觀檢查
- 該 MP3 檔案已正確解碼。偵測到一個可忽略不計的孤立滿量程樣本,且未出現大範圍的削波現象。.
- 聽眾的判斷
- 聽眾認為這項要求「部分符合」:聲音聽起來有些不自然,且帶有電噪聲的特徵。.
- 任務結果
- 針對這項首項成果,已部分達成。.
- 限制條件
- 此觀察結果僅適用於此第一項輸出;尚未執行穩定性測試。.
C1 聽力測驗
聆聽 C1 的首次輸出
播放此單一模型展示中的第一個有效輸出。.
Eleven Music v2
eleven-music-v2於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
C1 部分履行了合約。聽者認為聲音略顯不自然,並聽出有電噪聲的特徵。這是針對特定樣本的觀察,並非針對一般瑕疵的申訴。.
C3:Seed Audio 1.0 完整的火車站場景
C3:完整的火車站場景
一段長達 20 秒的沿海車站場景,融合了環境音、行駛中的火車、站內鈴聲以及精準的廣播公告。.
顯示精確的凍結提示字元
請創作一段長達 20 秒、完整的黎明時分沿海火車站場景。以柔和的海風聲和遠處的海鷗鳴叫聲開場。一列火車從左側駛來,並在月台前煞車。 一位語調平靜的女站務廣播員準確地宣布:「七點十五分的沿海列車現已抵達二號月台。」在廣播前加入一段簡短柔和的音樂鈴聲,隨後讓列車聲與環境音自然淡出。請確保語音清晰可辨,且場景在空間上具有連貫性。.
| 模型 | 確切路線 | 狀態 | 實際持續時間 | 格式 | 觀察到的成本 |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 20,000s | PCM WAV,40 kHz 立體聲 | $0.0466667 |
- 客觀檢查
- 該 WAV 檔案解碼正確,幾乎沒有削波現象,且在技術層面上包含所要求的多分段場景結構。.
- 聽眾的判斷
- 聽眾認為這項要求「部分符合」,因為火車煞車和停下的聲音聽起來有些不自然。.
- 任務結果
- 針對這項首項成果,已部分達成。.
- 限制條件
- 該公告的具體內容並未經獨立轉錄;穩定性測試未執行。.
C3 聽力測驗
聆聽 C3 的首度發行作品
播放此單一模型展示中的第一個有效輸出。.
Seed Audio 1.0
seed-audio-1.0於 2026 年 8 月 6 日透過已測試的 Anywhere 路徑產生。獲得一個首個有效輸出;未執行穩定性測試。.
C3 也部分達成了合約要求:聽眾認為火車的煞車和停靠聲響聽起來有些不自然。將生成式語音與視覺內容結合的影片創作者可能會發現這一點 對話、音訊與口型同步指南 頗為實用,儘管此處並未測試唇形同步效果。.
成本、產出長度與路徑行為
觀測電荷與實際輸出持續時間
2026年8月6日透過 Anywhere 進行,每項任務僅產生一個首個有效輸出結果。收費標準基於單次觀察,並非正式的收費標準表。兩條迷你刻度條採用各自獨立的視覺刻度;未採用雙軸或綜合評分。.
觀察到的成本範圍從 $0.00513(針對 Qwen B1)到 $0.075(針對每個 Eleven 輸出)。 實際耗時範圍從 Seed B2 的 9.180 秒,到 Eleven 音樂輸出的 30.041 秒。這些是實際測試結果,並非定價或品質評分。.
為什麼要在 GlobalGPT 上試用這些音訊模型?
音樂生成、富有表現力的語音合成(TTS)以及完整的音景營造是三種不同的任務,因此在此領域並無單一模型能全面勝出。 GlobalGPT 讓這種區分變得實用:您可以先使用 Eleven Music 製作一首曲目,接著切換至 Qwen Audio 進行旁白錄製,或是使用 Seed Audio 打造精心編排的場景,而無需為每個音訊工作流程維護獨立的平台。.
由於 GlobalGPT 是一個多模型工作區,而非僅限於音訊的工具,因此創作過程不必僅止於產出音訊檔案。您可以利用平台上的其他 AI 模型來起草或潤飾劇本、進行主題研究、製作輔助圖像,並圍繞已完成的音訊內容開發影片素材。.
2026年8月10日,該 GlobalGPT 定價頁面 顯示的每月等效值為:BASIC 方案為 $5.8、PRO 方案為 $10.8,以及 UNLIMITED 方案為 $25.0,並顯示「選擇年度計費」與「按年計費」的選項。 這些是該頁面的年度計費數據;實際存取權限會因方案而異。.
您應該選擇哪一款型號呢?
包含六項任務的首個輸出結果矩陣
| 工作流程 | 已測試的機型 | 結果 | 觀察到的原因 | 證據類型 | 限制 |
|---|---|---|---|---|---|
| A1 · 音樂 | Eleven 對戰 Seed | 十一為佳 | 更自然的樂曲發展與更和諧的樂器編配 | 盲測聽眾偏好 | 各一個首個輸出 |
| A2 · 音樂 | Eleven 對戰 Seed | 優先考慮種子 | 更清晰的開場與更豐富的分層 | 盲測聽眾偏好 | Seed 返回 27.704 秒 |
| B1 · 口說 | Qwen 對決 Seed | 首選 Qwen | 更自然的紀錄片敘事風格 | 盲測聽眾偏好 | 未逐字核對的文本 |
| B2 · 口語 | Qwen 對決 Seed | 首選 Qwen | 更濃郁的低語感與說故事氛圍 | 盲測聽眾偏好 | 未逐字核對的文本 |
| C1 · 聲樂歌曲 | 僅限十一 | 部分達成 | 聲音聽起來不自然,帶有類似電噪聲的特徵 | 使用者語義審查 | 針對特定樣本的觀察 |
| C3 · 聲景 | 僅限種子 | 部分達成 | 火車的煞車聲和停下來的聲音聽起來很不自然 | 使用者語義審查 | 公告內容未轉錄 |
沒有任何一組成績會被轉換為總分或產生唯一優勝者。.
- Choose Eleven Music v2 當工作本質上與音樂相關時:結構化的器樂曲、歌曲,或是樂段層級的音樂編輯。.
- 選擇 Qwen Audio 3.0 TTS Flash 當工作內容是旁白或受控的抒情演說時。.
- 選擇 Seed Audio 1.0 當輸出效果必須呈現為一個結合環境音、音效及人聲的完整場景時。.
這些建議綜合了工作流程的契合度以及六項針對首輪產出的評估結果。它們並未確定一個絕對的優勝者。.
此項比較之局限性
- 每個模型和任務僅產生一個首個有效輸出;不重複穩定性輸出。.
- B1 和 B2 並未逐字轉錄或核對。.
- 聽力評分具有主觀性,且取決於具體的試題。.
- 「Anywhere」路線並非整個上游產品。.
- 沒有任何公正的獨立排行榜會將這三條確切路線納入同一個評分方法之下。.
- 檔案格式、取樣率、聲道數、檔案大小及播放音量均未被納入品質評分項目。.
常見問題
01Eleven Music v2、Qwen Audio 3.0 和 Seed Audio 1.0 是否屬於同一類型的模型?
No. Eleven Music v2 是一款專用的音樂工作流程,Qwen Audio 3.0 TTS Flash 是本次測試的語音生成方案,而 Seed Audio 1.0 則定位於全場景音訊生成。因此,本次比較將依據不同任務提出建議,而非強行制定一個通用的排名。.
02哪款模型是專為 AI 音樂生成而設計的?
在本次比較中,Eleven Music v2 無疑是最出色的專用音樂軟體選擇。其官方文件說明了該軟體可控制音樂類型、風格、結構、人聲或器樂輸出,支援多種語言,並能進行樂段級或整首歌曲的編輯。.
03哪條經過測試的路線最適合敘事與富有表現力的演說?
Qwen Audio 3.0 TTS Flash(此處以確切的 Anywhere 路徑 qwen-audio-3.0-tts-flash 標示),在旁白與富有表現力的語音測試中表現最佳。聽眾在 B1 和 B2 兩組測試中均更偏好其首次輸出結果,但穩定性與精確的詞彙準確度並未納入測試範圍。.
04哪款機型能夠透過語音和音效營造出完整的聲景?
Seed Audio 1.0 是最適合創作音景的工作流程。其官方定位涵蓋人聲、音效、環境音及統一編排,而 C3 測試則將車站廣播、列車行進聲、鈴聲及沿海環境音整合於單一輸出中。.
05我能否在 GlobalGPT 中同時使用這三項功能?
是的。您可以在 GlobalGPT 的音訊工作區中,嘗試使用 Eleven Music 處理音樂、Seed Audio 1.0 處理完整的音訊場景,以及 Qwen Audio 3.0 處理語音。GlobalGPT 還將寫作、研究、圖像和影片的工作流程整合到同一個多模型平台中。 各模型的可用性會因方案而異。.
06這項比較是否能選出一位總冠軍?
不。這些模型適用於不同的工作流程,而實測結果僅涵蓋每個模型與任務下的一次有效輸出,且未進行穩定性重複測試。有用的結論是附帶條件的:專用音樂模型為「Eleven」、語音模型為「Qwen TTS Flash」,而完整音訊場景則適用「Seed」。.
試試您自己的音訊工作流程
請攜帶您自備的音樂簡報、旁白腳本或聲音景觀提示至 GlobalGPT 音訊產生器 並將結果與您實際需要完成的任務進行比較。請著重聆聽音樂結構、聲線演繹、場景連貫性以及對提示的遵循程度,而非僅憑模型名稱來選擇。.
一旦音訊方向確認無誤,您便可繼續運用 GlobalGPT 的其他 AI 模型來進行劇本開發、資料研究、輔助圖像製作及影片概念規劃。如此一來,這項測試便不再是孤立的音訊示範,而是轉變為實用的內容工作流程;僅在需要驗證穩定性時,才需重複產生輸出結果。.