
Claude Sonnet 5.5 是一款強大的日常工作型模型:無論是處理棘手的錯誤修正或內容密集的文件,它都游刃有餘,且其代幣價格低於 Opus 5.5。. 當你能明確界定何謂「好答案」時,其吸引力便格外顯而易見。對於開放式的策略規劃,或是涉及眾多變因且不熟悉的問題,Opus 依然值得在你的工作流程中佔有一席之地。.
在我們的 GlobalGPT 測試中,Sonnet 5.5 草擬了客戶電子郵件、修復了一個通過 43 項檢查的資金分配函數,並正確地核對了一組共 13,078 字的發票記錄。 這封電子郵件還提出了一項需要核實的小型流程假設。更值得探討的問題是:其速度與價格何時能轉化為更高效的工作日——以及何時額外的推理所產生的成本會超過其節省的開支。.
您可以使用 Claude Sonnet 5.5 對 GlobalGPT 並與其他用於寫作、程式設計、研究、圖像及影片的頂尖模型並駕齊驅。透過單一的多模態訂閱方案,您便能以經濟實惠的方式,將專案從初稿一路推進至最終成果,無需為每個步驟分別管理獨立的訂閱。.
Claude Sonnet 5.5:快速評測
針對定義明確的工作所設定的實用預設值
若要撰寫簡報、報告、文件或進行初步實作,請先使用 Sonnet。向它提供原始資料、限制條件及驗收檢查項目。當最困難的部分在於釐清問題的本質時,再轉用 Opus。.
令我們印象深刻的是: 受控的格式設定、穩健的程式碼,以及正確的文件對帳。.
推薦觀看: 細微的假設可能會潛入精心潤飾的文案中;推理會增加成本;冗長的背景說明也無法保證讀者能記住內容。.
本文是一篇針對新發布機型的評測,而非歷時數月的生產研究。 我們綜合了 Anthropic 的規格參數、已發表的評估報告,以及於 2026 年 10 月 1 日執行的三項實務任務。其中寫作任務重複執行了兩次;程式碼與文件任務則各執行一次。以下結果均以該小樣本為考量基礎。.
Claude Sonnet 5.5 有哪些新功能?
Anthropic 於 2026 年 9 月 28 日推出 Sonnet 5.5,作為 Opus 5.5 的更快、更經濟實惠的補充方案。其宣稱的優勢在於能妥善處理日常工作、修復錯誤,以及產出精緻的文件、簡報和試算表。 這種定位至關重要:您無需在每次編輯、技術支援回覆或實作任務中,都使用最昂貴的模型。.
Claude Sonnet 5.5 有哪些新功能?
| 特點 | Sonnet 5.5 | 這在實際上意味著什麼 |
|---|---|---|
| 輸入與輸出 | 文字與圖片已加入;文字已移除 | 詢問關於圖表或螢幕截圖的相關資訊,然後將答案轉化為草稿或計畫。. |
| API 上下文視窗 | 一百萬個代幣 | 有足夠空間存放大量原始資料;請仔細整理並標註。. |
| 標準 API 的最大輸出 | 128K 代幣 | 這僅為範例限制,並非每則回答的建議長度。. |
| 推理 | 適應性思維 | 投入的努力既會影響完成時間,也會影響總代幣用量。. |
| 知識截止 | 2026年6月 | 請使用當前資料來源或搜尋工具來查證事實的變更。. |
這些上下文與輸出限制說明了 Claude API 的規範。您在特定應用程式中可上傳或接收的內容量,亦取決於該產品的介面。同樣地,能夠理解影像的模型並非影像生成器。Sonnet 可以對視覺內容進行評論或撰寫製作簡報;而影像或影片模型則負責生成完整的媒體內容。.
這項實用的升級,在於結合了更強大的任務執行能力與更快速的迭代。您可以先要求初稿,檢視其中薄弱之處,並要求針對性修訂。一個好的提示語能為其指明方向:「保留所有圖表不變,將內容縮短至 200 字,並列出來源資料未闡明的任何內容。」“
Claude Sonnet 5.5 定價:代幣費率與實際成本
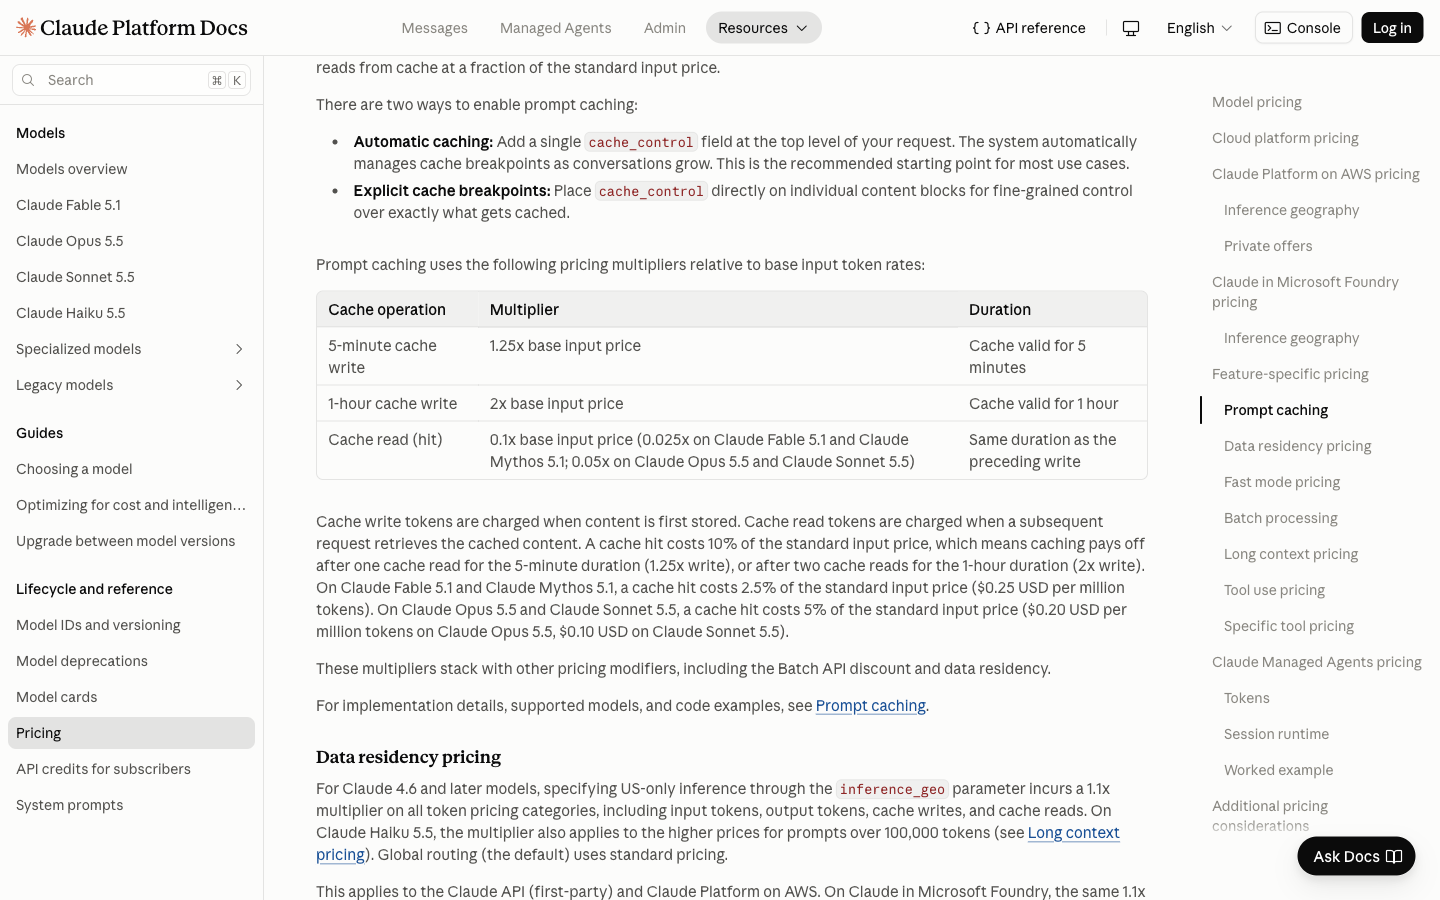
Sonnet 5.5 的成本 每百萬個輸入代幣為 $2,每百萬個輸出代幣為 $10 以 Anthropic 的標準 API 費率計算。 這些單價與 Sonnet 5 相同。相較於 Opus 5.5 的 $4 輸入費率與 $20 輸出費率,Sonnet 的每個輸入或輸出代幣成本僅為其一半——但完成一項任務可能消耗不同數量的代幣。.
Claude Sonnet 5.5 定價:代幣費率與實際成本
| API 計費類別 | 每百萬枚代幣的價格 |
|---|---|
| 未快取的輸入 | $2.00 |
| 輸出,包括已計費的思考代幣 | $10.00 |
| 快取讀取/刷新 | $0.10 |
| 快取寫入,5 分鐘 | $2.50 |
| 快取寫入,1 小時 | $4.00 |
對於未緩存的請求,輸入代幣數需乘以每百萬 $2,輸出代幣數則乘以每百萬 $10。輸入 10,000 個代幣且輸出 2,000 個代幣的請求,成本為 $0.04。 若輸入 100,000 個 token 且輸出 10,000 個 token,費用為 $0.30。這些是經過計算的 API 範例,並非 GlobalGPT 的帳單;工具、快取操作、服務層級及其他定價調整因子都可能影響總費用。.
一項請求可能要花多少錢
每筆請求的標準 API 費用示例。僅限未經快取的輸入與輸出。.
計算公式:(輸入代幣 × $2 + 輸出代幣 × $10) ÷ 1,000,000。計費思考量計入輸出總量。以上僅為範例,並非訂閱價格或實際計費金額。.
Anthropic 所聲稱的「每項任務最多可減少 30%」,是基於使用較少代幣完成部分工作而得出的結論。這並非 30% 的降價。在另一極端的情況下,, 《人工分析》的上市評估 在全力運算的情況下,每項「智力指數」任務的測量值約為 $7.60,比該測試中 Sonnet 5 的數值高出約 50%。這些高難度的基準測試任務並非普通的聊天訊息,但它們顯示出,為何將推理能力調至最高,反而會讓表面上的划算優勢蕩然無存。.
API 計費、Claude 訂閱方案以及 GlobalGPT 是不同的選項
Claude 的消費者方案採用訂閱制定價:免費方案為 $0,Pro 方案為每月 $20 或每年 $200,而 Max 方案每月起價為 $100(未含適用稅金)。 應用程式使用量受方案限制。Anthropic 亦列出對應 Max 層級的每月 API 配額為 $100 或 $200;免費版與專業版則不包含每月 API 配額。 選擇方案時,請分別比較應用程式存取權限與 API 配額。多模型平台適合工作內容經常橫跨不同模型家族和媒體類型的人士。.
如果你的日常工作包括撰寫首頁、審閱程式碼,以及製作行銷活動的視覺素材,, GlobalGPT 將這些工具整合在一起. 其價值在於單一訂閱方案所涵蓋的工作流程範圍之廣,而非為了完成一個專案而必須購買數項獨立產品。請根據您實際進行的工作來選擇適合的方案。.
效能測試:在某些任務中表現接近 Opus,但並非所有任務皆然
此次發布的結果顯示,相較於 Sonnet 5,這是一大飛躍。結果同時也說明了為何僅憑一項總分無法決定模型的選擇。在已公布的 Terminal-Bench 比較中,Sonnet 5.5 表現領先;而在 FrontierCode 和 CursorBench 測試中,Opus 5.5 則仍保持領先。 兩者在知識工作評分上幾乎不相上下,這雖令人樂觀,但並不意味著這些模型可以互換使用。.
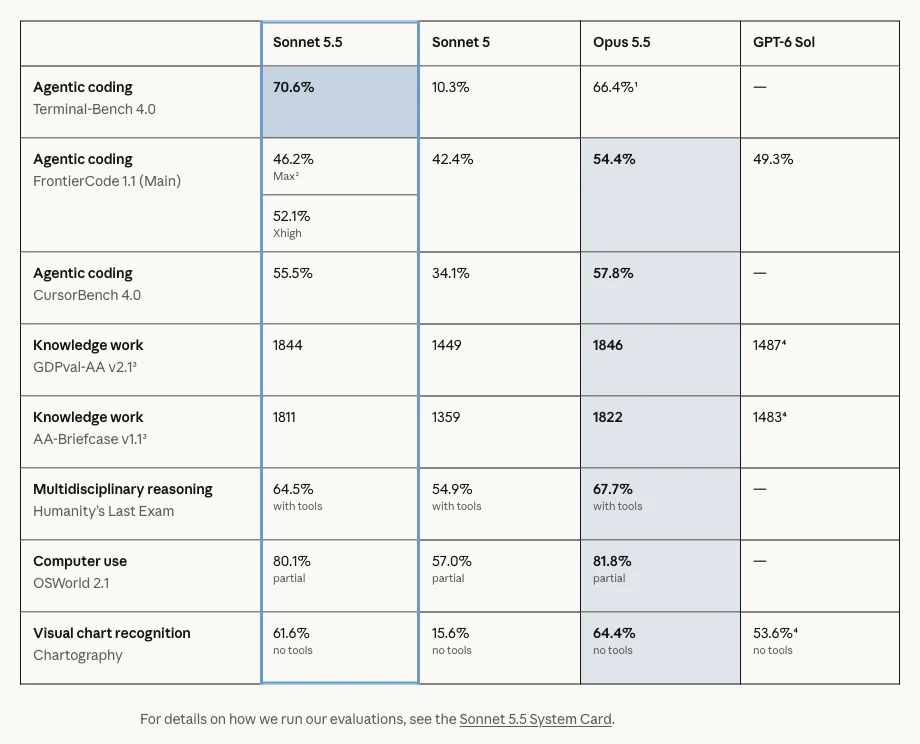
效能測試:在某些任務中表現接近 Opus,但並非所有任務皆然
| Anthropic 發射表中的評估 | Sonnet 5.5 | 第5首十四行詩 | 作品第 5.5 號 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% (Xhigh) | - |
| FrontierCode 1.1 主畫面 | 52.1% (Xhigh);46.2% (Max) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA v2.1 | 1844 埃洛分數 | 1449 Elo | 1846 埃洛分數 | 1487 |
| AA-公事包 v1.1 | 1811 Elo | 1359 Elo | 1822 埃洛分數 | 1483 |
| 人類的最終考驗 | 64.5%(含工具) | 54.9%(含工具) | 67.7%(含工具) | - |
| OSWorld 2.1 | 80.1% 部分 | 57.0% 部分 | 81.8% 部分 | - |
| 製圖學 | 61.6% 無需工具 | 15.6% 無需工具 | 64.4% 無需工具 | 53.6% 無需工具 |
這些是已公布的基準測試結果,與我們的 GlobalGPT 測試不同。這些評估採用了不同的環境和工作量設定;Elo 分數並非準確率的百分比。GPT-6 Sol 的數值出現在 Anthropic 的已公布比較表中,而破折號則表示該頁面未針對該項評估報告數值。 Anthropic 亦指出,首發的 GDPval-AA 及 AA-Briefcase 測試運行採用了預發布版本,該版本存在結構化輸出錯誤,此問題已於後續修正。請將此表格視為該次評估的參考圖表,而非對您工作負載的保證。.
FrontierCode 的結果特別有參考價值:Sonnet 在 Xhigh 上的表現優於 Max。Anthropic 將 Max 表現下滑歸因於額外的審閱輪次、超時,以及超出請求範圍的變更。過度的思考可能會增加工作量,卻未必能產生更好的答案。應從明確的任務出發,並在有具體理由時再增加投入的努力。.
獨立測試結果提供了更多背景資訊。《人工分析》報告指出,在「最大/預設備用」配置下,其智慧指數得分為 56,同時出現了異常大量的輸出標記使用量。A CodeRabbit 審查流程評估 Sonnet 5.5 偵測到 13 個困難訊號案例中的 6 個,而 Sonnet 5 則偵測到 13 個中的 4 個,且其平均執行時間較短。 這是一項規模較小的供應商研究,雖不能證明每次程式碼審查都會有所改善,但它是一個有用的範例,說明應評估完整的任務,而非僅僅關注評分。.
Claude Sonnet 5.5 的速度有多快?
Anthropic 的輸出生成速度比 Sonnet 5 快了超過 30%。輸出生成僅是等待答案的其中一個環節:輸入處理、推理、網路延遲以及服務負載同樣至關重要。模型一旦開始運作,即使寫入速度很快,在最終答案出現之前仍需耗費時間進行處理。.
我們對同一則客戶電子郵件提示進行的三次重複操作,耗時 11.60、12.16 及 11.78 秒, ,中位數為 11.78 秒。程式碼任務耗時 19.08 秒,文件任務則為 16.42 秒。我們計時的是完整的回應時間,包含服務與網路開銷。 由於我們並未測量首個標記延遲(first-token latency),也未執行 Sonnet 5 對照測試,因此這些計時結果並不能證明 30% 方案確實有所改善。.
就日常使用而言,這使得該模型值得用於需要短週期反覆修改的工作。請先要求提供最終成果,將範圍控制在狹窄範圍內,並避免在僅需修正一個函式或簡短回覆時,卻要求對方提供冗長的說明。當工作量控制選項可見時,請先評估較低的設定,而非預設選擇「最大值」。.
實際效能:三項 GlobalGPT 測試
我們採用了可驗證答案的實務任務。 所有請求均使用 Claude Sonnet 5.5 版本,輸出上限均設定為 6,000 個標記,且未使用任何外部工具。我們將採樣與推理設定維持在服務預設值。每個任務僅保留首次完成的輸出結果;另外兩次撰寫執行僅作為獨立的一致性檢查。所有五次呼叫均在無需重試的情況下完成。.
寫作:撰寫一封向客戶回覆的信件,並確保承諾得到妥善履行
任務說明要求撰寫一封長度為 90 至 120 字的電子郵件給 Maya,內容關於一盞延遲送達的藍色檯燈;必須精確列出三個要點;發送截止日期為 10 月 4 日;並提供「退款」的回覆選項,以將款項全額退還至原始付款方式。說明中明確禁止編造原因、保證送達、提供折扣或承諾立即退款。.
第一個答案共 110 個單字,包含恰好三個項目符號,並完整保留了發貨截止日期與退款條款。該答案並未虛構交貨日期、延遲原因或額外優惠。 然而,針對決定保留訂單的客戶,該回答新增了「您無需回覆」這項說明——這是簡報中未提及的流程細節。這使得該草稿雖具實用性,但未能完全符合「僅限事實」的嚴格要求。.
這兩則回覆分別有 101 字和 97 字,且均符合格式規範,但兩者都重複了相同的「不採取行動」假設。第三則回覆更進一步地,針對實質上相同的「維持現狀並等待」選項,使用了兩項項目符號。在發送給客戶的回覆之前,請確認操作細節並刪除重複內容。.
寫入測試:格式通過,假設僅有一個程序
首個答案:110 字、3 項要點、11.60 秒。發貨與退款條款均正確。關於「保留訂單且不予回覆」的指示並未載明於案情摘要中,需予以確認。後續答案:101 字與 97 字;兩者均重複了該假設。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 輸出上限為6,000個代幣 · 無輔助工具 · 採樣與投入程度維持服務預設值。時間指完整回應完成的時間,而非第一個代幣產生之時。.
任務說明
請以英文撰寫一封客戶服務電子郵件給 Maya,內容關於訂單編號 R-418——一盞因出貨延遲而尚未寄出的藍色檯燈。整封電子郵件的字數須介於 90 至 120 字之間(含上下限),並須包含精確的三个要點。 內容須包含致歉語,並清楚說明後續步驟,且僅可使用以下事實:該燭台將於 10 月 4 日前寄出;此外,Maya 亦可回覆「refund」以申請將款項全額退還至原始付款方式。請勿承諾任何送達或到貨日期、即時退款、折扣、補償,或任何其他未提供的優惠。 請勿捏造延遲的原因。截止日期指的是寄出日期,而非送達日期。請包含問候語與結語。僅需提交電子郵件內容。在此任務中,「單字」定義為以空白字元分隔的字元,不包含獨立的項目符號。.
完整的首次輸出結果
主旨:關於您的訂單 R-418 的最新資訊

嗨,Maya,

很抱歉,您的藍色檯燈(訂單編號 R-418)發貨有所延遲。我知道這會讓人感到沮喪,對於造成的不便,我在此致上歉意。

以下是目前的狀況及您接下來的處理方式:

- 您的燈具將於 10 月 4 日前寄出。
- 若您仍希望保留這筆訂單,無需回覆此郵件。
- 若您不願繼續等待,請回覆此電子郵件並註明「退款」,我們將透過您當初的付款方式為您辦理全額退款。

感謝您的耐心與體諒。若對訂單有任何疑問,請隨時回覆。

此致,
客戶服務團隊
寫入重複 2 · 完整輸出
親愛的 Maya:

很抱歉,您的訂單 R-418(藍色檯燈)發貨有所延遲。我理解這會讓您感到沮喪,並為此造成的不便致上歉意。

接下來將採取以下處理方式:

- 您的藍色檯燈將於 10 月 4 日前發貨。
- 若您願意等待,無需採取任何行動。
- 若您不願等待,請回覆此電子郵件並註明「退款」,我們將透過您原來的付款方式為您辦理全額退款。

請注意,10月4日是我們的出貨截止日期,並非送達日期。

感謝您的耐心與諒解。

此致,
客戶服務團隊
寫入重複 3 次 · 完整輸出
主旨:關於您的訂單 R-418 的最新資訊

嗨,Maya,

很抱歉您的藍色檯燈(訂單編號 R-418)發貨有所延遲。對於造成的不便,我深表歉意,並感謝您的耐心等待。

以下是您的處理選項:

- 等待發貨:您的檯燈將於 10 月 4 日前寄出。
- 申請退款:請回覆「退款」一詞,我們將透過您原來的付款方式為您辦理全額退款。
- 保留訂單:若您願意等待,則無需採取任何進一步行動。

請注意,10月4日是我們的出貨截止日期,並非送達日期。

此致,
客戶服務團隊
您的燈具將於 10 月 4 日前寄出。……若您不願等待,請回覆此電子郵件並註明「退款」,我們將透過您原先的付款方式為您辦理全額退款。.
節錄自首場 GlobalGPT 寫作測驗;其中省略了一項項目符號。.
這是一種在客戶溝通與商務寫作中相當實用的模式:提供經核准的事實、界定語氣,並明確指出哪些承諾絕對不能出現。如此一來,Sonnet 便能協助斟酌措辭,而無需被要求替您制定政策。.
程式設計:修復四捨五入邏輯,然後驗證總和
我們原先有缺陷的 Python 函式是透過浮點數來分配資金,並獨立對每份份額進行四捨五入。這可能會導致出現或損失幾分錢。我們請 Sonnet 將其替換為基於 Decimal 的最大餘數分配演算法,同時保留總額、以原始索引作為平局時的決策依據,並拒絕無效的輸入。.
第一個傳回的函式傳遞了 43 項檢查中的第 43 項, ,涵蓋了零數值、小數權重、確定性平分、格式錯誤的輸入、大數值以及精確度邊界。該程式會解析小數字串,將其轉換為精確的整數量,並以穩定的順序分配剩餘的分數。其有用的成果不僅是看起來合乎邏輯的程式碼:這些份額的總和確實正確無誤。.
這支持使用 Sonnet 進行針對性強且具備明確驗收標準的實作。這是一項獨立的功能測試,而非自主的儲存庫修復或安全性稽核。針對生產環境的程式碼,請自行新增整合測試,並檢視周邊應用程式中的錯誤處理機制。.
程式設計測驗:通過 43 項檢查
第一個答案:19.08 秒。通過了所有 43 項檢查,包括正確的記憶體分配、穩定的連結、輸入驗證以及精確度。此結果是作為獨立函式進行評估,而非自主儲存庫修復。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 輸出上限為6,000個代幣 · 無輔助工具 · 採樣與投入程度維持服務預設值。時間指完整回應完成的時間,而非第一個代幣產生之時。.
任務說明
請將下方的錯誤 Python 函式替換為 correct 實作版本:allocate_cents(total: str, weights: list[str]) -> list[int]。僅回傳可執行的 Python 原始碼,請勿包含 Markdown 圍欄或說明。

要求:
1. `total` 是一個以字串形式表示的非負有限美元金額,小數位數為零、一或二位,例如「0」、「12.3」或「12.34」。必須使用 ASCII 十進位數字,且可選地包含一個小數點。 請拒絕包含正負號、指數表示法、空白字元、NaN/Infinity、空字串、尾隨小數點、開頭小數點,以及超過兩位小數(包括「1.000」)的輸入。允許開頭有零。若輸入非字串,請拋出 ValueError 錯誤。
2. weights 是一個非空的字串清單。每個字串使用 ASCII 十進位數字,可選地包含一個小數點及其後一個或多個數字。必須為有限的非負值,且至少包含一個嚴格正的權重。 若遇到無效字串、正負號、指數表示法、空白字元、非字串項目,或非清單形式的 weights 輸入,則拋出 ValueError 錯誤。允許前導零。
3. 使用 Decimal 類別精確解析並保留所提供的十進位金額。 將美元轉換為整數分。根據權重比例分配整數分,採用最大餘數法:先取每個精確配額的下取整數,再將剩餘的分分配給最大的小數餘數。若出現平局,則以原始索引較低者為準。回傳的清單必須保留輸入順序,且總和必須精確等於總分數。
4. 對於長整數的有效值或極不均衡的權重,切勿在未報錯的情況下損失精確度。請勿修改權重。若需導入模組,僅限從 `decimal` 或 `math` 模組導入。不得進行任何檔案、網路、環境、進程或輸入/輸出操作。

錯誤的實作:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
完整的首次輸出結果
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 if not isinstance(s, str) or not s:
 return False
 parts = s.split(".")
 if len(parts) > 2:
            return False
 if not parts[0] or not all(c in DIGITS for c in parts[0]):
 return False
 if len(parts) == 2:
 frac = parts[1]
 if not frac or not all(c in DIGITS for c in frac):
                return False
 if max_frac 非 None 且 len(frac) > max_frac:
 return False
 return True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # 會傳回 (整數尾數, 指數),其值為 value = 尾數 * 10**指數
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("總和無效")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("權重無效")
    for w in weights:
 if not valid(w, None):
 raise ValueError("無效權重")

 mant, exp = to_scaled(total)
    if exp >= -2:
 cents = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # 對於已驗證的輸入無法觸及

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    if W <= 0:
        raise ValueError("至少有一個權重必須為正數")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
文件:在修正與刪除重複項目後,找出正確的記錄
第三項任務提供了一份由 13,078 字組成的合成發票資料包:包含 120 筆基礎記錄、8 筆更正記錄以及 4 份存檔副本。Sonnet 必須僅篩選日期為 2026 年 9 月且已獲核准的 Atlas 發票,採用每筆記錄的最高版本,並回傳嚴格格式的 JSON 資料,其中須包含總額以及三項合理的後續驗證。.
它選取了所有 16 個正確的發票編號, 回傳了完全相同的 $15,305.66 總計,並遵循了 JSON 結構。後續處理涵蓋了帳簿對帳、更正所需的憑證,以及重複或截斷檢查。系統並未將舊的存檔副本視為新發票。.
這正是文件處理工作中至關重要的細節:即使較早的版本出現在文件包的後面,最新修正的版本也必須被採用。這項結果對於有限範圍的文件擷取而言頗具前景。不過這仍僅是一項合成實驗,其規模遠小於宣傳中的一百萬個標記的上下文視窗;若要應用於重要的金融工作,仍需進行獨立的計算驗證。.
文件測試:16 筆記錄,與總數完全一致
第一個答案:16.42 秒。全部 16 個發票編號以及 $15,305.66 的總額均與獨立參考資料相符;嚴格的 JSON 格式及三項後續檢查結果亦均正確。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 輸出上限為6,000個代幣 · 無輔助工具 · 採樣與投入程度維持服務預設值。時間指完整回應完成的時間,而非第一個代幣產生之時。.
所提供的綜合資料包包含 120 筆基本記錄、8 項更正及 4 份存檔副本(共 13,078 字)。欄位包括 ID、版本、專案、日期、狀態、金額及說明備註。以下說明已完整列出;此處僅對冗長的原始資料包進行摘要。.
任務說明
請審核以下合成專案發票記錄。針對每個 ID,僅採用最高版本;內容完全相同的重複記錄不會產生額外的發票。最高版本可能出現在較舊的歸檔副本之前。僅篩選最終專案為「Atlas」、最終狀態為「已核准」,且最終日期落在 2026 年 9 月的記錄。金額單位為美元。 請回傳嚴格符合以下鍵值的 JSON 格式:"ids"(按升序排列的選取唯一 ID)、"total_usd"(精確保留兩位小數的字串),以及 "action_items"(精確包含三個簡潔字串,列出合理的後續會計核對事項)。 請勿添加 Markdown 圍欄或說明性文字。篩選時請忽略敘述性註解;所有會計欄位均為結構化資料。請勿計入其他月份的記錄、草稿記錄、Orion 記錄、舊版本或重複副本。.
完整的首次輸出結果
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056」、「INV-062」、「INV-068」、「INV-074」、「INV-086」、「INV-092」、「INV-098」、「INV-104」、「INV-116」],"total_usd":"15305.66","action_items":["將選定的 16 張發票及其總額 15,305.66 美元與 2026 年 9 月的 Atlas 總分類帳及應付帳款輔助分類帳進行對帳。","檢視因更正而變更的記錄(INV-003、INV-008、INV-020、INV-050,以及被排除的 INV-002、INV-014 和 INV-026),以確認其核准憑證及佐證文件。","確認重複的歸檔副本未被作為獨立發票過帳,並檢查日期接近月底之更正發票是否存在應計或結轉問題。」]}Sonnet 5.5 對比 Opus 5.5:該選擇哪一款?
根據工作性質來選擇。當指示明確且目標清晰時,Sonnet 是個明智的首選。若任務需要持續的判斷力、發掘隱藏的假設,或是協調一連串的決策,Opus 則是更理想的起點。請閱讀我們的 Claude Opus 5.5 評測 想更仔細地看看那個模型。.
Sonnet 5.5 對比 Opus 5.5:該選擇哪一款?
| 您的任務 | 建議的起點 | 為何 |
|---|---|---|
| 重寫簡短的客戶文案草稿,並從紀錄中擷取資料 | Sonnet 5.5 | 明確的限制條件能讓品質驗證更為容易。. |
| 修復一個作用域相關的錯誤,或實作指定的函式 | Sonnet 5.5 | 在較低的輸入/輸出標記速率下,仍能展現強勁的任務執行能力。. |
| 在需求尚未完整的情況下決定架構 | 作品第 5.5 號 | 困難之處在於持續做出判斷,而不僅僅是執行。. |
| 運用文字、圖片和影片完成一項宣傳活動 | GlobalGPT 多模型工作流程 | 請使用 Sonnet 來建立資產的簡要與專業模型。. |
一個實用的工作流程是:先請一個更強大的推理模型來審查一個棘手的計畫,然後將雙方達成共識的規格與具體檢查項目交給 Sonnet。各階段可選擇不同的模型。您無需將每一次微小的修訂都轉化為最耗資源的推理任務。.
將 Sonnet 5.5 應用於 GlobalGPT
GlobalGPT 讓此模型能作為更廣泛工作架構的一部分發揮作用。在撰寫或分析階段開啟 Claude Sonnet 5.5,當專案需要不同功能時,即可切換至另一種模型。您無需在多個訂閱方案間重新建立工作流程,即可制定行銷企劃書、精修文案、製作視覺素材,並產製影片。.
為了獲得更理想的初步成果,請一併提供原始素材及一套簡要的接受準則。若為撰寫類任務,請明確指定目標受眾、篇幅、語氣,以及必須保持不變的事實。若為程式碼類任務,請提供會導致錯誤的範例及預期行為。若為文件類任務,請標示原始段落,並說明如何處理版本衝突。這些 寫作、研究與程式設計的靈感提示 為您提供可重複使用的起點。.
開發人員亦可透過以下方式串接其終端工作流程: GlobalGPT CLI 搭配 Claude 代碼. 請在開發流程中適當地使用該專案的網站及命令列介面(CLI)。其價值在於形成一套相互連結的工具集,而模型的選擇則取決於下一項任務的需求。.
值得了解的限制事項與升級詳情
付出大量努力是一種選擇,而非品質保證。. Sonnet 可能會對狹義的問題過度處理,或超出所要求的變更範圍。請指示它保留範圍、執行相關檢查,並在滿足驗收標準時停止執行。若產品提供了工作量控制機制,請在增加工作量之前,先比較已完成任務的品質與成本。.
當前的事實仍需當前的消息來源。. 該模型的 2026 年 6 月知識截止日期,並不代表其具備關於每項價格、政策或發布資訊的即時知識。請提供最新文件,或使用具備搜尋工具的工作流程。若涉及敏感資料,請查閱您實際使用的服務及帳戶之隱私權與資料保留條款;模型名稱並不會決定這些設定。.
API 遷移不僅僅是替換模型名稱這麼簡單。. Sonnet 5.5 變更了部分較舊的請求模式。直接的 Claude API 會拒絕非預設的溫度、top_p 及 top_k 設定,因此過時的思維或強制工具配置可能需要更新。 自適應處理為預設模式;文件中記載的 between_tools 模式會於「高」工作量或以下等級時,移除預先處理步驟。當前概述亦說明,強制使用工具會返回錯誤;Claude API 及 Google Cloud 不接受舊式的電腦使用工具,且工具呼叫之間的文字可能會以處理區塊形式傳送。請檢視 官方遷移指南 在移動應用程式之前。我們的 Claude API 指南 涵蓋了更廣泛的設定與計費概念。.
Anthropic 亦針對風險較高的網路安全與生物學相關請求實施防護措施。例行性的軟體開發仍屬該模型的預期用途範圍。若某項任務雖屬正當但涉及敏感內容,應清楚說明其範圍與權限,而非假設每次拒絕都是出於一般性的程式編寫限制。.
最終評語:這是一款值得納入日常工作流程的優質機型
Sonnet 5.5 憑藉其實用且可驗證的表現贏得一席之地。採用它的最有力理由在於:具備強大的範圍限定編碼能力與實用的文件處理功能,且 API 代幣成本低於 Opus。撰寫文書也是其良好應用場景之一,並能在最終階段檢查那些雖未出現在簡報中、但合乎情理的細節。 我們的小型測試集支持其作為日常工作工具的定位;但並未證明它在速度、成本或複雜推理方面具有全面優勢。.
從一個你能評估其輸出結果的實際任務開始。將限制條件明確化,檢查重要細節,並在問題發生變化時切換至另一個模型。. 請在 GlobalGPT 上試試 Sonnet 5.5 將寫作、程式設計、分析以及接下來的創意步驟整合到一個多模型工作流程中。.
常見問題
什麼是 Claude Sonnet 5.5?
Claude Sonnet 5.5 是一款於 2026 年 9 月 28 日推出的 Anthropic 模型。它支援文字與圖像輸入,並能輸出文字,專為快速處理日常編碼、寫作、文件處理及工具輔助的工作流程而設計。.
Claude Sonnet 5.5 的價格是多少?
Anthropic 的標準 API 價格為每百萬個輸入代幣 $2,以及每百萬個輸出代幣 $10。 快取讀取的費用為每百萬個代幣 $0.10。Claude 應用程式訂閱與 GlobalGPT 方案的收費標準與上述 API 費率不同。.
Claude Sonnet 5.5 的速度是否比 Sonnet 5 更快?
Anthropic 的輸出生成速度比 Sonnet 5 快了超過 30%。在我們的 GlobalGPT 寫入測試中,生成三則完整回應耗時 11.60 至 12.16 秒。 由於我們並未將 Sonnet 5 作為對照組進行測試,因此本次測試並未測量不同世代間的速度提升幅度。.
Sonnet 5.5 是否比 Opus 5.5 更好?
若需處理任務定義明確且輸入/輸出標記單價較低的任務,請選擇 Sonnet 5.5。對於需要持續判斷力的複雜、開放式工作,Opus 5.5 則是更為穩健的起點。Sonnet 在部分已發表的評估中名列前茅,但並無絕對的贏家。.
Claude Sonnet 5.5 能否處理長篇文件?
Claude API 規定了 100 萬個標記的上下文視窗。在我們規模較小的 13,078 詞合成文件測試中,Sonnet 選出了所有 16 筆符合條件的記錄,並計算出了正確的總數。但此結果並不能證明其在整個宣稱的上下文視窗範圍內均具備準確性。.
我可以在 GlobalGPT 上使用 Claude Sonnet 5.5 嗎?
是的。GlobalGPT 除了提供 Claude Sonnet 5.5 之外,還包含其他 AI 模型,因此您可以在同一個平台上進行草擬、編寫程式碼、分析文件,並進一步進行圖像或影片相關的工作。.
資料來源與測試筆記
產品規格與價格資訊於 2026 年 10 月 13 日確認;以下實機測試則於 2026 年 10 月 1 日進行。主要參考資料: Anthropic 的發布公告, Sonnet 5.5 型號參考, API 定價, 以及 Claude 訂閱價格. 獨立的背景資訊來自《人工分析》(Artificial Analysis)以及上文連結的 CodeRabbit 研究。.
GlobalGPT 測試採用了三項任務中第一個完成的答案,外加兩次寫作重複作業。 未啟用任何外部工具。計時範圍涵蓋完整回應,包含網路與服務開銷;未選取任何推理工作量值。發票封包為合成資料,且不含任何客戶資料。標題插圖是為本次評測特別生成;其餘圖片則為指定網站的螢幕截圖。.









