
的 OpenAI 語音 API 透過……將文字轉為語音 文章連結 https://api.openai.com/v1/audio/speech. 傳送一個模型、您的輸入文字以及一段語音;將回應儲存為 MP3 或其他受支援的音訊格式。若要建立新的整合功能,且該功能需要關於語氣和表達方式的指示,請從以下步驟開始: gpt-4o-mini-tts.
工作請求僅是第一步。您還需要選定合適的計費單位、可播放的輸出檔案,以及針對長篇腳本的規劃。OpenAI 的新版 TTS 模型採用文字和音訊標記進行計費;其舊版 TTS 模型則以字元為單位。當您估算一個月的旁白工作量時,這項差異至關重要。.
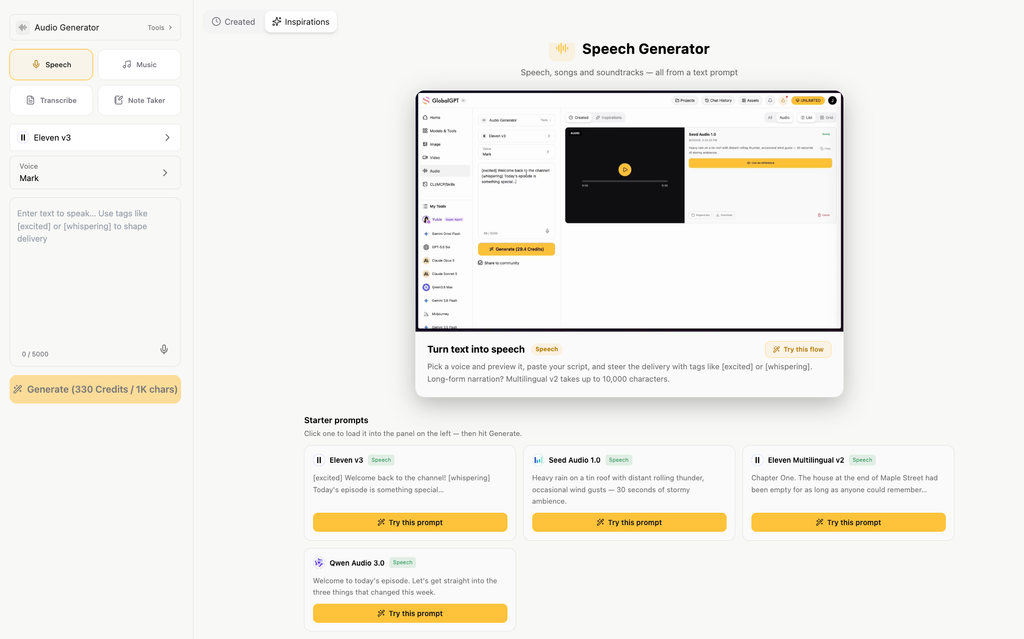
如果你的工作還包括撰寫腳本、製作視覺素材以及剪輯影片,, GlobalGPT 的音訊工作區 將語音生成功能整合至一個價格實惠的多模型訂閱平台中。您可以在單一儀表板中處理文字、語音、圖片和影片,並透過其 API 和 CLI 進行可重複的生產作業。其公開的 TTS API 採用獨立的任務工作流程,相關內容將於下文說明。.
OpenAI 語音 API 的功能是什麼?
Speech API 是一個文字轉語音端點:您的應用程式提供文字內容,並接收生成的語音。常見的應用情境包括產品導覽、輔助技術旁白、學習教材以及簡短的旁白。您可以在語音輸出前對文字內容進行控制,這在文字表述必須遵循經核准的腳本時特別實用。.
至於轉錄,其運作方向則恰好相反:輸入錄製的音訊,輸出文字。即時語音助理則增添了另一項要求——透過對話進行聆聽與回應。OpenAI 的 音訊紀錄 將這些工作流程分開。若您已擁有要朗讀的文字,請選擇「語音」端點。.
語音生成功能支援串流,因此應用程式可以分段接收音訊。將該串流儲存至檔案後,並不會自動在瀏覽器中播放,也不會自動建立對話型代理程式;您的應用程式仍需負責處理播放及任何對話邏輯。此外,OpenAI 亦要求必須明確告知聽眾,該語音是由人工智慧生成的。.
使用 OpenAI 語音 API 生成您的第一個音訊檔案
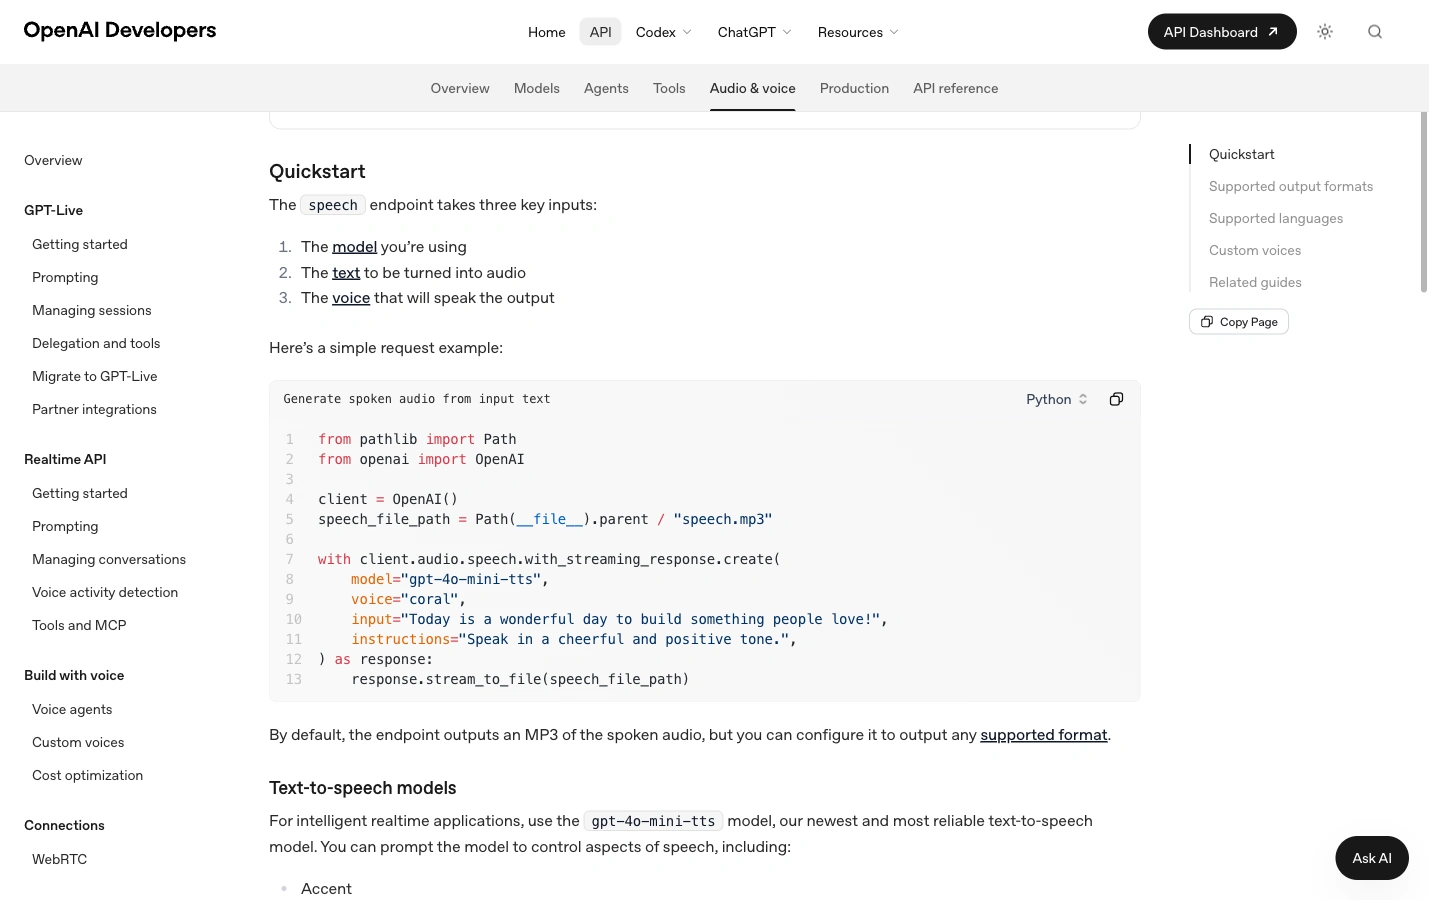
請在伺服器或您的開發電腦上執行此請求,並將 OpenAI API 金鑰儲存於 OPENAI_API_KEY 環境變數。請勿在瀏覽器 JavaScript 中使用此鍵。以下範例使用相同的簡短產品導覽腳本,並將結果儲存為 openai-product-tour.mp3.
選項 1:發出 curl 請求
OpenAI 語音 API · curl
#!/bin/sh
# 請先在您的伺服器環境中設定 OPENAI_API_KEY。
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "歡迎參加 Acorn Studio 產品導覽。只需三個步驟,您就能將一段簡短的腳本轉為語音導覽。首先,撰寫訊息;接著,選擇語音;最後,儲存音訊檔案並在手機上測試播放。",
    "voice": "coral",
    "instructions": "請以溫暖、對話式的語調清晰地說話。",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
由於回應內容包含音訊位元組,因此請將其儲存至檔案中,而非嘗試將其解析為 JSON。該 --fail-with-body 此選項會在發生 HTTP 錯誤時,讓 curl 傳回失敗的退出狀態碼。請在開啟檔案前檢查該狀態碼:即使收到錯誤回應,名為 .mp3.
選項 2:使用 Python SDK
請使用以下指令安裝 OpenAI 套件: python -m pip install openai. SDK 會從環境變數中讀取 API 金鑰。此範例會在回應傳來時立即寫入,如此一來便無需將整個音訊回應載入您自己的 Python 緩衝區中。.
OpenAI 語音 API · Python
"""安裝:python -m pip install openai。請在伺服器上設定 OPENAI_API_KEY。"""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "歡迎參加 Acorn Studio 產品導覽。只需三個步驟,您就能將 "
    "一段簡短的腳本轉為語音導覽。首先,撰寫內容。接著, "
    "選擇語音。最後,儲存音訊檔案並在手機上測試播放。"
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="請以溫暖且具對話感的語調清晰地朗讀。",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("已儲存 openai-product-tour.mp3")
這三個必填欄位是 模型, 輸入, 以及 聲音. 這裡,, 說明 要求以溫暖、對話式的語調呈現;它著重於引導語音,而非在語音腳本中添加詞語。此功能適用於 GPT-4o Mini TTS,但不受以下服務支援: tts-1 和 tts-1-hd.
若文件較長,請以句子或段落為界將文字分割,為各段落編號,並將每個輸出檔案以該編號儲存。各段落應保持一致的語氣與指示。保留足夠的上下文以確保措辭自然,並在分發拼接完成的錄音前,仔細聆聽各接合處的銜接效果。.
選擇模型、語音及輸出格式
| 模型 | 如何選擇 | 送貨說明 |
|---|---|---|
gpt-4o-mini-tts | 可控敘事與口語表達的起點。. | 支援 說明 在語調、風格和節奏方面。. |
tts-1 | OpenAI 使此模型能夠實現低延遲的語音生成。. | 使用其支援的語音與速度控制功能;省略 說明. |
tts-1-hd | OpenAI 使此模型能提供比 TTS-1 更優質的語音品質。. | 使用其支援的語音與速度控制功能;省略 說明. |
的 GPT-4o 迷你 TTS 型號頁面 將模型別名映射至 gpt-4o-mini-tts-2025-12-15 快照。若可重現性對您的應用程式至關重要,請審慎選擇一份有相關文件記載的快照,並將其與已儲存的腳本一併記錄下來。.
內建音色與輸入限制
《Speech API 參考手冊》列出了 GPT-4o Mini TTS 的 13 種內建語音: 合金、灰燼、敘事詩、珊瑚、迴聲、寓言、縞瑪瑙、新星、智者、微光、詩句、海洋風情,以及雪松. OpenAI 建議 馬林 或 雪松 以獲得最佳品質。這是 OpenAI 的建議:請透過聆聽自己說出的名字、數字及句型,來選擇適合的發音風格。.
較早期的 TTS 機型僅支援較少的語音選項:alloy、ash、coral、echo、fable、onyx、nova、sage 以及 shimmer。請勿假設每種語音都適用於所有機型。該 語音 API 參考手冊 也接受介於 0.25 和 4.0, 與 1.0 設為預設值。.
有兩項輸入限制需加以考量:端點參考限值 輸入 至 4,096 個字元, ,而 Mini TTS 型號頁面則指定最大值為 2,000 個輸入標記. 字元與標記是兩種不同的計量單位。請務必檢查 Mini TTS 的兩項限制條件,特別是在處理多語言文字時,並在提交前將過長的腳本拆分為多個部分。.
選擇目標位置的檔案格式
| 格式 | 實際應用 |
|---|---|
| MP3 | 預設輸出;一個方便分享與網頁播放的壓縮檔案。. |
| 作品 | 適用於支援該編解碼器的串流與通訊應用程式。. |
| AAC | 請考量在何種情況下,您的播放環境或媒體工作流程需要使用 AAC。. |
| FLAC | 適用於需要保留音訊訊號的工作流程之無損壓縮。. |
| WAV | 以熟悉的容器格式儲存未壓縮的音訊,以便進行編輯與處理。. |
| PCM | 未經處理的 24 kHz、16 位元有號小端字節序樣本,且無檔案標頭;您的播放器需要這些設定。. |
若需下載連結或使用簡單的音訊播放器,請從 MP3 開始。若下一步是進行編輯,請選擇 WAV。僅當您的應用程式懂得如何解讀原始 PCM 格式時,才應選擇此選項;若要將檔案名稱從 .pcm 至 .wav 不會建立 WAV 標頭。.
OpenAI 語音 API 的費用是多少?
根據 2026 年 9 月 28 日的查閱結果,OpenAI 將 GPT-4o Mini TTS 列於 每百萬個文字輸入標記 $0.60 加上 每百萬個音訊輸出標記為 $12. TTS-1 的成本 每百萬個字元 $15, ,而 TTS-1 HD 的價格為 每百萬個字元 $30. 請以各模型的原始單位進行計算。.
語音 API 定價:請將單位分開標示
OpenAI 對其較新的 TTS 模型按代幣計費,而對其較早的兩個 TTS 模型則按字元計費。GlobalGPT 則以「信用點」為單位列出其 TTS 任務。.
| 路線與型號 | 評分 | 範例 |
|---|---|---|
| OpenAI · GPT-4o 迷你 TTS | $0.60 / 1M 文字輸入代幣 $12 / 1M 音訊輸出代幣 | $0.0606,適用於 1,000 個文字輸入令牌 + 5,000 個音訊輸出令牌 |
| OpenAI · TTS-1 | $15 / 1M 個字元 | $0.015(每 1,000 個字元) |
| OpenAI · TTS-1 HD | $30 / 1M 字元 | $0.030,適用於 1,000 個字元 |
| GlobalGPT · Eleven v3、Eleven 多語言版 v2 或 Qwen Audio 3.0 TTS Flash | 330 學分 / 1,000 字元 | 330 學分,按所列每 1,000 字的費率計算;提交前請索取報價 |
以下為定價範例,並非下方音訊範例的收費金額。代幣、字元、分鐘和積分是不同的計量單位。GlobalGPT 任務估算值提供適用的積分數額;該表格並未將積分轉換為美元。.
匯率查閱日期:2026年9月28日。資料來源: OpenAI API 定價 和 GlobalGPT API 文件.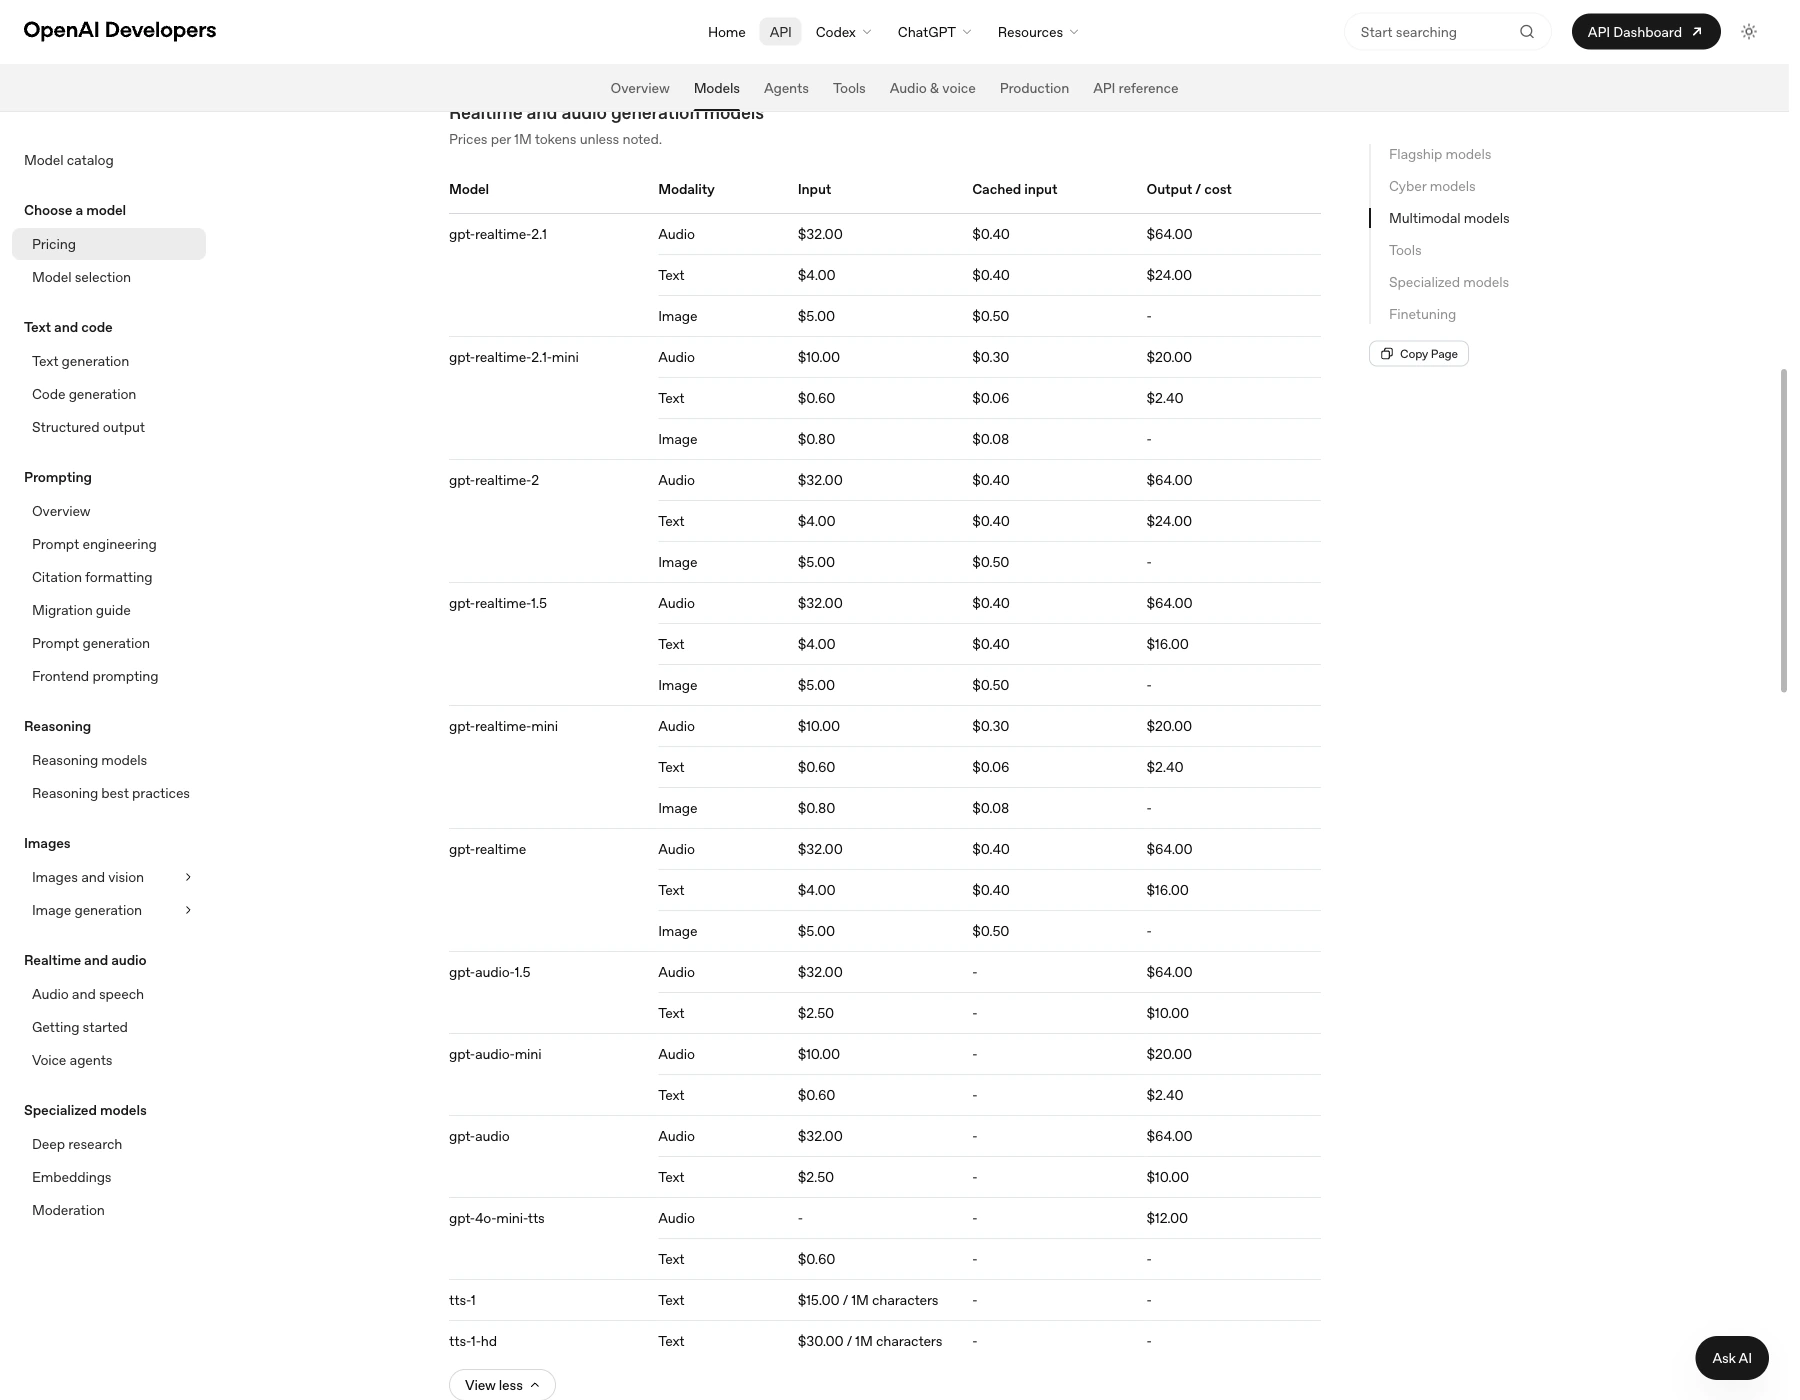
舉例來說,100 份劇本,每份 1,000 個字,總計 100,000 個字。按照所列的費率計算,這相當於 $1.50 搭配 TTS-1 或 $3.00 搭配 TTS-1 HD, ,且需在其他應用程式成本之前計算。僅憑相同的字元數不足以精確計算 Mini TTS 的費用:您需要文字輸入和音訊輸出的代幣數量。.
估算您的語音生成成本
請輸入您所選路線的計費單位。系統不會自動將字元轉換為代幣,也不會將分鐘轉換為代幣。.
計算公式:字元數 × $15 ÷ 1,000,000。文字總量可能橫跨多個 API 請求。.
2026年9月28日查詢的費率: OpenAI · GlobalGPT. 不包含儲存、主機服務、稅金以及您申請中的其他部分。.
在規劃階段,請在計算器中輸入實際使用次數或明確的假設值。在實際測量使用情況之前,請將「Mini TTS 音頻代幣」欄位視為預算輸入值。請勿將每分鐘的大致估算值視為每種聲音、語速或語言的保證價格。.
GlobalGPT 模型目錄以「信用點數」為單位標示 TTS 價格,其估算終點會針對您打算發送的請求提供報價。請將 API 信用點數的消耗,與為日常寫作及媒體工作所選擇的多模型工作區訂閱區分開來。這樣一來,便能更輕鬆地掌握預算狀況,且無需假設這兩項產品共用同一筆計費額度。.
使用 GlobalGPT API 建立 TTS 工作流程
若要建立一個可重複執行的「腳本→語音→影片」工作流程,, 在 GlobalGPT 中建立語音 並將專案的其餘部分保留在同一個工作區中。該 GlobalGPT API 揭露了媒體生成實質上是種任務,而 GlobalGPT 命令列介面 可與您的終端機及開發工具配合使用的連線方式。.
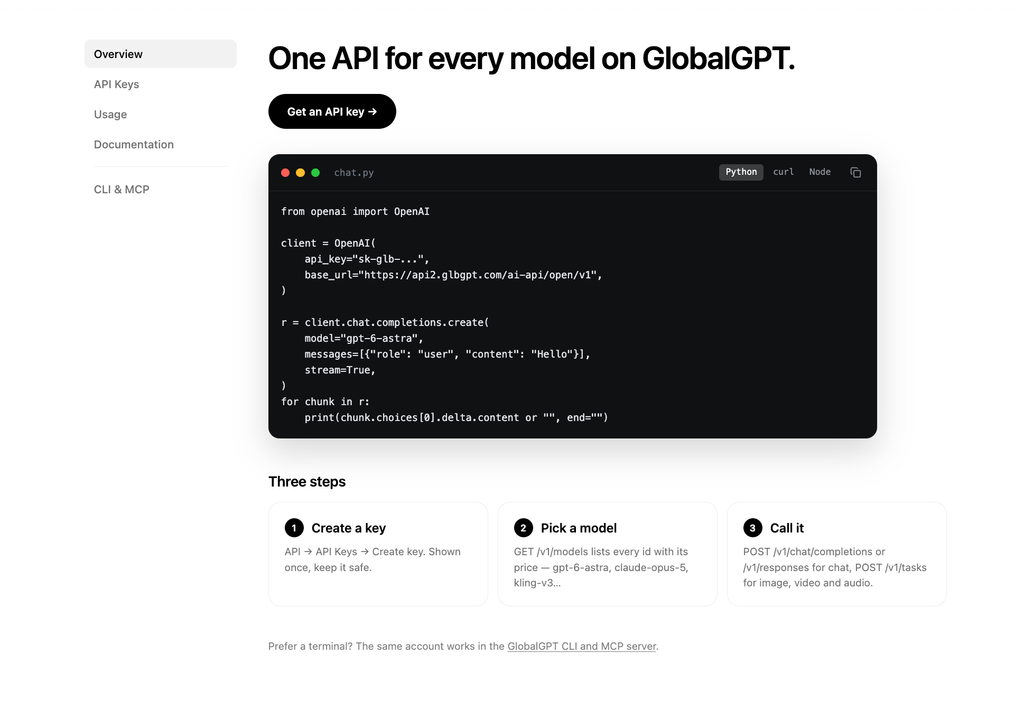
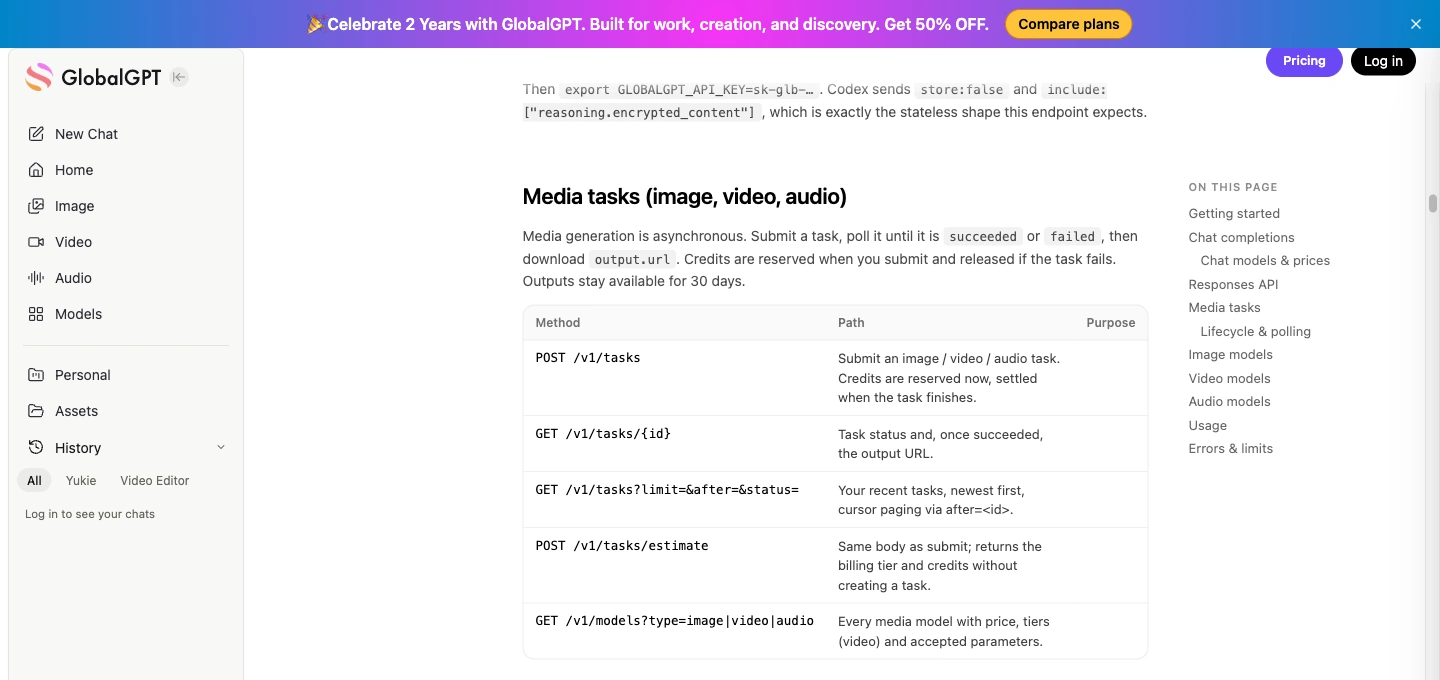
使用公開的基礎網址 https://api2.glbgpt.com/ai-api/open/v1. 將 TTS 請求傳送至 POST /tasks, 查詢 GET /tasks/{id}, ,並下載 output.url 在任務成功後。該文字欄位是 提示. 直接實作此任務合約;它與 OpenAI 的即時音訊回應有所不同。.
選擇一款已發表的 GlobalGPT TTS 模型
| 型號編號 | 輸入與輸出 | 有用的區分 |
|---|---|---|
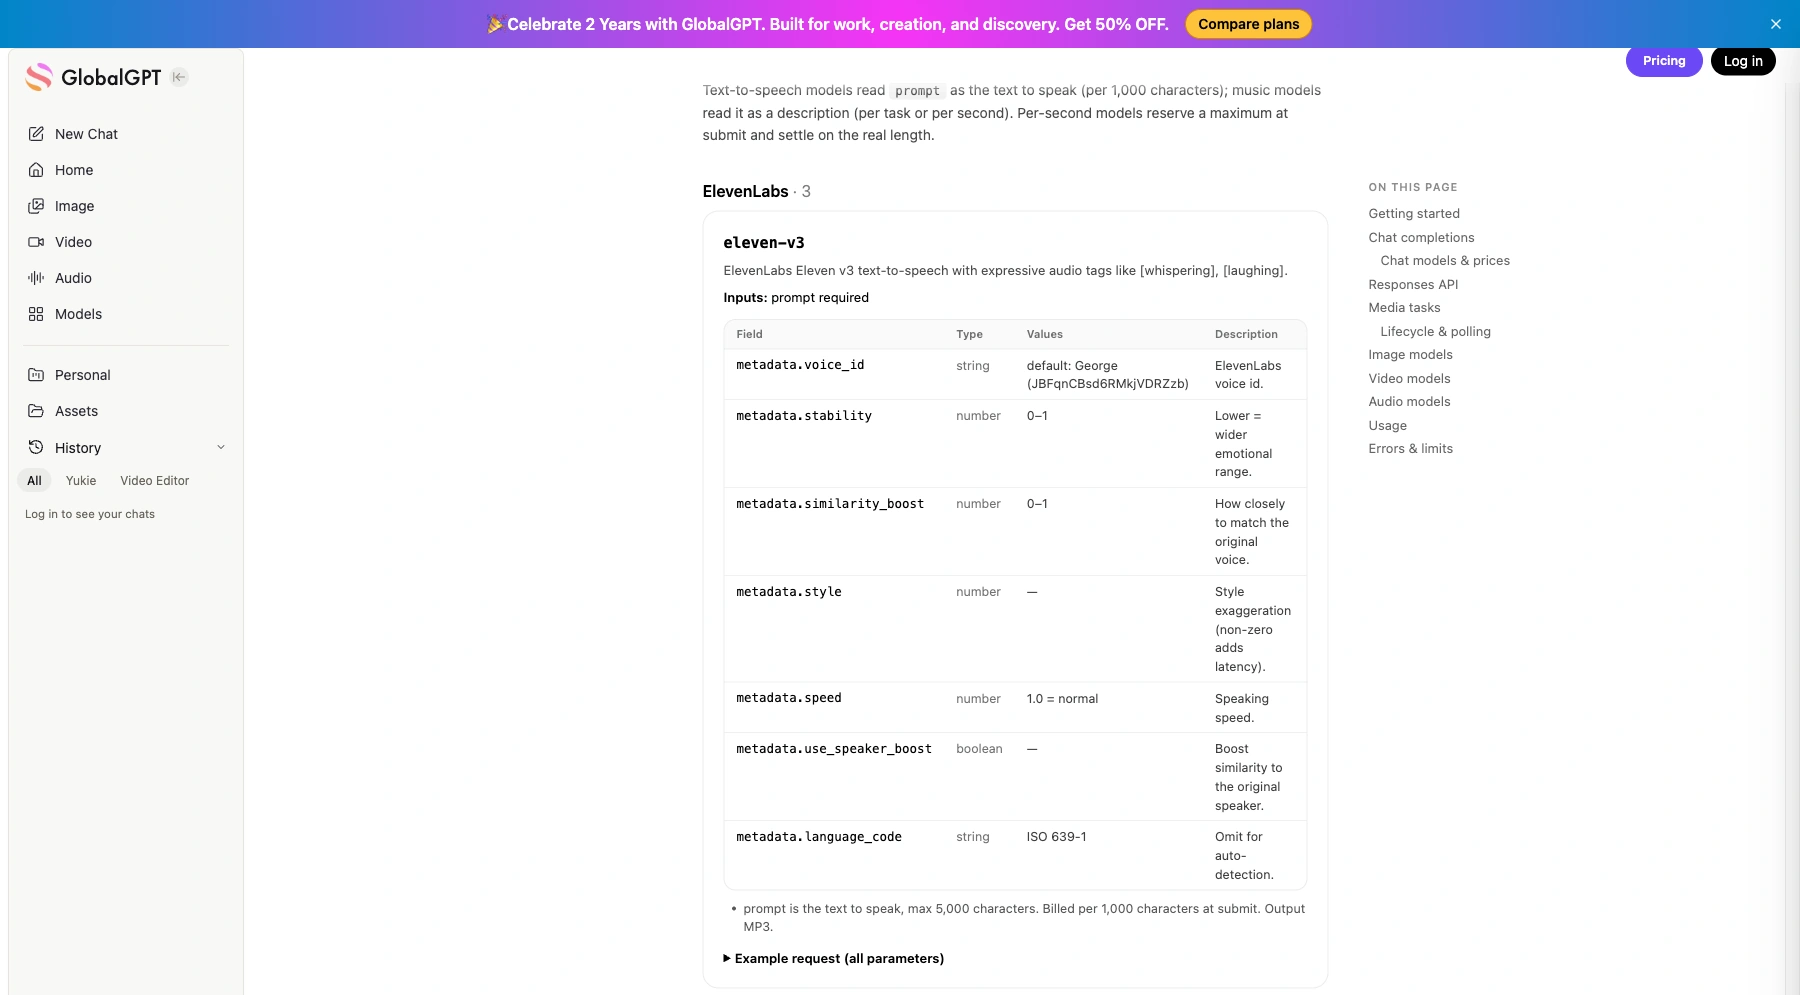
eleven-v3 | 最多 5,000 個字元;MP3 | 支援富媒體音訊標籤。. |
eleven-多語言-v2 | 最多 10,000 個字元;MP3 | 29 種語言;音訊標籤會被讀作文字。. |
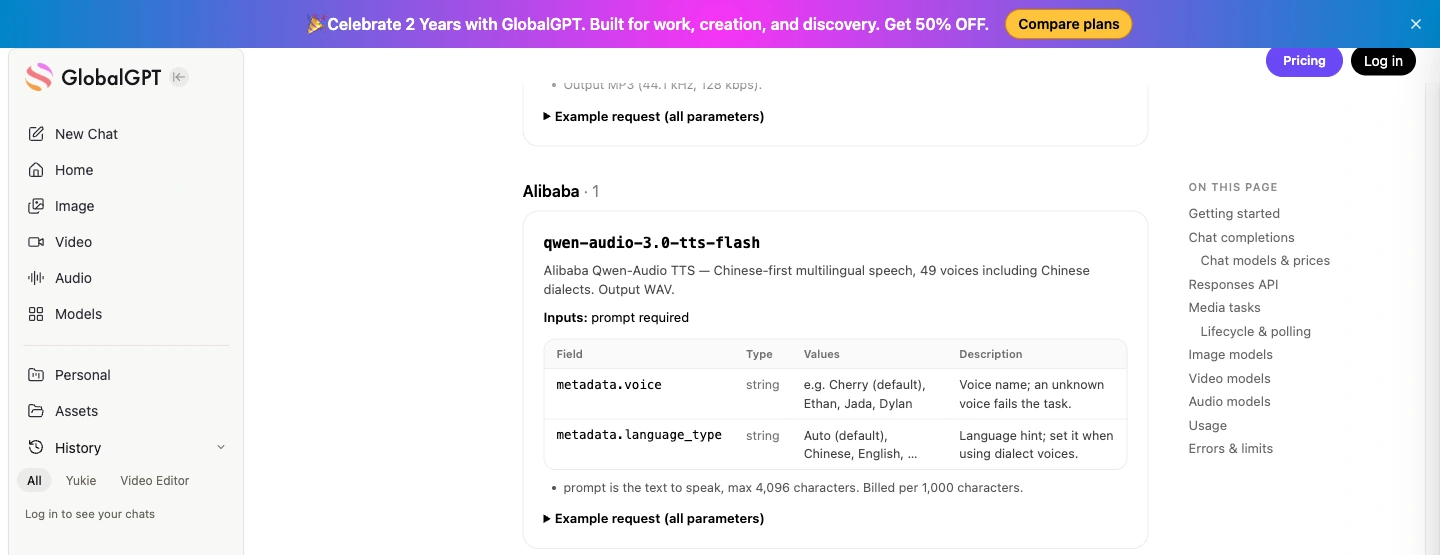
qwen-audio-3.0-tts-flash | 最多 4,096 個字元;WAV | 49 種語音;語音與語言控制使用 Qwen 專屬欄位。. |
這三項條目均列於 每 1,000 個字元可兌換 330 積分. .使用 POST /tasks/estimate 附上適用報價的預定請求正文;根據文件說明,此操作不會建立任何任務,也不會預留任何點數。使用公開 API 時會消耗付費點數。.
有關更廣泛的創作工作流程,請參閱 GlobalGPT 中的文字轉語音工作流程. 若您正在研究另一個同名但不同的開源 Qwen3-TTS 系列,請閱讀 Qwen3-TTS 型號與 API 選項; 請勿將上方的 Qwen-Audio 模型 ID 視為可互換的 Qwen3-TTS 部署。.
估算、提交一次,然後查詢已儲存的任務
安裝 請求 與 python -m pip install requests 並設定 GLOBALGPT_API_KEY 在伺服器上。以下範例使用 Eleven v3,選取一個已記錄的公開語音 ID,並設定 500 點的示範上限。執行前,請將該上限調整為符合您自身預算的數值。.
GlobalGPT 公開 TTS 任務 API · Python
"""安裝 requests;設定 GLOBALGPT_API_KEY。使用 GlobalGPT 的公開任務 API。"""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # 每項任務的信用點數上限;執行前請先編輯。

payload = {
    "model": "eleven-v3",
    "prompt": (
 "歡迎參加 Acorn Studio 產品導覽。 只需三個步驟,您就能將「
」一段簡短的腳本轉化為語音導覽。首先,撰寫訊息。接著,「
」選擇一個聲音。最後,儲存音訊檔案並在手機上測試播放。」
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("此工作屬於不同的輸入。請使用新的狀態檔名稱。" )
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("預估信用點數:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("估算值超過您每項工作的上限。")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # 持久化金鑰會將傳輸重試與此特定請求綁定。
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("被忽略的參數:", task["ignored_parameters"])

print("任務:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
    print("被忽略的參數:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("生成失敗: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # 使用新的請求:請勿將 API 金鑰傳送至媒體主機。
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("已儲存:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("任務仍在處理中。請重新執行以查詢已儲存的任務 ID。")
工作檔案會儲存確切的請求、一個冪等性金鑰以及任務 ID。若連線中斷,請重新執行相同的工作,以便程式碼能繼續執行現有的任務。若要刻意產生不同的音訊,請使用新的工作檔案名稱。若工作檔案中的腳本包含機密資訊,請將該檔案設為私有。.
檢查 被忽略的參數 因此,未受支援的設定不會在您不知情的情況下自動成為預設配置。ElevenLabs 的控制項,例如 voice_id 與 Qwen 的不同之處在於 聲音 和 語言類型 欄位。每 5 至 10 秒進行一次輪詢,處理一個 失敗 狀態,並立即儲存成功的檔案:文件中記載的結果保留時間為 三十天.
聆聽兩個產品導覽範例
這兩個由 AI 生成的範例,皆採用相同的 216 字產品導覽腳本,分別透過 Eleven v3 和 Qwen Audio 3.0 TTS Flash 進行生成。 兩者皆為單次請求產生的首個輸出結果,且採用預設語音設定。這些檔案供您檢視與試聽,並非針對匹配語音的受控比較,亦非 OpenAI 語音基準測試。.
Eleven v3:產品導覽音訊
eleven-v3 · 產品導覽範例
- 輸出
- MP3 · 單聲道 · 44.1 kHz
- 長度
- 約 15.6 秒
- 世代
- 首次輸出 · 1 個請求
設定: 以下為精確的文本內容,採用預設語音及其他設定;未指定語音覆寫或朗讀指示。預設語音身份未被錄製。.
狀態與時程: 該次執行成功。任務的伺服器時間戳顯示,從提交到完成共耗時 13 秒;這僅為單次請求,並非延遲基準測試。.
檔案觀察: 該 MP3 檔案包含一個 44.1 kHz 的單聲道音訊流,大小約為 251 kB。其幀資料可讀取至檔案結尾。.
費用參考: 公開目錄的計費標準為每 1,000 個字元 330 學分。針對新請求,請使用工作量估算;此費率不適用於樣本的開立發票。.
實際用途: 一個用於試聽簡短產品導覽的緊湊型 MP3 檔案。在正式發布前,請先於目標裝置上確認完整文字內容及播放效果。.
閱讀確切的輸入內容 · 216 個字元
歡迎參加 Acorn Studio 產品導覽。只需三個步驟,您就能將一段簡短的腳本轉化為語音導覽。首先,撰寫內容;接著,選擇語音;最後,儲存音訊檔案並在手機上測試播放效果。.
Qwen Audio 3.0 TTS Flash:產品導覽音檔
qwen-audio-3.0-tts-flash · 產品導覽範例
- 輸出
- WAV · 單聲道 · 24 kHz
- 長度
- 15.52 秒的 PCM 資料
- 世代
- 首次輸出 · 1 個請求
設定: 以下為精確的文本內容,採用預設語音及其他設定;未指定語音覆寫或朗讀指示。預設語音身份未被錄製。.
狀態與時程: 該次執行成功。任務的伺服器時間戳顯示,從提交到完成共耗時 17 秒;這僅是一次請求,並非延遲基準測試。.
檔案觀察: 該 WAV 檔案包含單聲道、16 位元、24 kHz 的 PCM 音訊,大小約為 745 kB。其標頭宣告的資料量多於檔案實際所含的資料;此處保留了原始輸出內容。.
費用參考: 公開目錄的計費標準為每 1,000 個字元 330 學分。針對新請求,請使用工作量估算;此費率不適用於樣本的開立發票。.
實際用途: 一個用於評估旁白工作流程的 WAV 樣本。請在製作流程中解決標頭長度不一致的問題,並在發行前確認播放是否完整。.
閱讀確切的輸入內容 · 216 個字元
歡迎參加 Acorn Studio 產品導覽。只需三個步驟,您就能將一段簡短的腳本轉化為語音導覽。首先,撰寫內容;接著,選擇語音;最後,儲存音訊檔案並在手機上測試播放效果。.
在相近的播放時間下,Qwen 樣本的大小約為 Eleven 樣本的三倍,這反映了 WAV 與 MP3 格式之間的差異。此外,其 WAV 標頭聲明的数据量也多於檔案實際所包含的數據。 這是一個值得在目標播放器中檢查的檔案封裝問題;此現象本身並不能證明語音品質的任何問題。.
解決常見的語音生成問題
| 症狀 | 首先應檢查什麼 |
|---|---|
| 儲存的 MP3 無法播放 | 請檢查 HTTP 狀態碼與回應類型。API 錯誤可能已被儲存為音訊副檔名。. |
| 該請求會拒絕語音或指令 | 請將語音及可選欄位與選定的模型配對。較舊版的 OpenAI 語音合成模型不接受指令。. |
| 一篇篇幅過長的劇本被退稿了 | 請檢查路徑的字元限制及 Mini TTS 代幣限制,然後在自然的分界處進行分割。. |
| 出現 401 或 429 回應 | 請檢查 401 狀態碼對應的金鑰/帳戶。若出現 429 狀態碼,請在重新嘗試前,先區分這是因速率限制所致,還是配額不足所致。. |
| 一項 GlobalGPT 請求仍處於待處理狀態 | 查詢已儲存的任務 ID 並檢查狀態;超時並非提交重複工作的理由。. |
| 該聲音與所要求的設定不符 | 在假設設定已套用之前,請先檢查特定模型的元資料及 ignored_parameters。. |
| 音訊播放時間或快進/快退條看起來有問題 | 將檔案元資料與實際媒體內容進行比對,並在目標播放器中測試完整檔案。. |
若出現 OpenAI 錯誤,請先從其 錯誤代碼指引. 對於 GlobalGPT 任務,請儲存任務 ID 及回傳的錯誤詳細資訊。在開發過程中,請將傳輸失敗、計費失敗以及語音錄製品質不佳的情況區分開來:每種情況都需要不同的解決方案。.
在發送旁白前,請在聽眾將使用的裝置上完整聆聽整段錄音。檢查開場白、人名與數字、過場段落,以及結尾句。請在播放前加入 AI 語音聲明,並保留精確的文字稿與模型設定副本,以便日後能有針對性地重新生成編輯後的腳本。.
常見問題
什麼是 OpenAI 語音 API 端點?
請使用 POST https://api.openai.com/v1/audio/speech。必填欄位為 model、input 和 voice。回應內容為生成的音訊檔案;預設格式為 MP3。.
OpenAI 語音 API 是免費的嗎?
Speech API 採用基於使用量的計費方式。請根據當前的 API 費率來規劃預算,而非假設有免費配額:GPT-4o Mini TTS 根據文字輸入和音訊輸出代幣計費,而 TTS-1 和 TTS-1 HD 則按字元計費。.
我可以控制聲音和說話風格嗎?
請選擇您所使用之模型支援的語音。GPT-4o Mini TTS 亦可接受關於語音呈現方式的指示,例如「溫暖」或「沉穩」的語調。請注意,「指示」欄位不適用於 TTS-1 或 TTS-1 HD。.
Speech API 是否支援串流?
是的。它能夠分段串流生成的音訊。您的應用程式仍需負責處理播放事宜;僅靠語音合成串流功能,並無法實現完整的即時語音對話。.
我是否可以透過變更 OpenAI 的基礎網址來使用 GlobalGPT?
請使用 GlobalGPT 針對 TTS 所記錄的媒體任務工作流程:將請求提交至 POST /tasks,透過 GET /tasks/{id} 進行輪詢,並在成功後從 output.url 下載結果。其記錄的 TTS 目錄包含 ElevenLabs 和 Qwen 模型,這些模型各有專屬的模型 ID 和參數。.
我應該從哪種音訊格式開始呢?
若只需簡單下載或使用網頁播放器,建議從 MP3 開始。若接下來需要進行編輯,WAV 格式則較為實用。原始 PCM 因沒有檔案標頭,因此播放器必須針對其取樣率與位元深度進行設定。.
從一個簡短的腳本、一個語音檔和一個儲存檔開始。一旦播放和成本變得可預測,便可加入分塊處理、重試機制,以及其餘的媒體工作流程。在實作時,請將所選 API 的請求格式、計費單位和輸出處理整合在一起。.
為您的下一部劇本賦予聲音
撰寫一份簡短的產品導覽草稿,使用 ElevenLabs 或 Qwen 製作旁白,並在 GlobalGPT 的多模型工作區中繼續處理圖片和影片。.
使用 GlobalGPT 產生語音音訊








