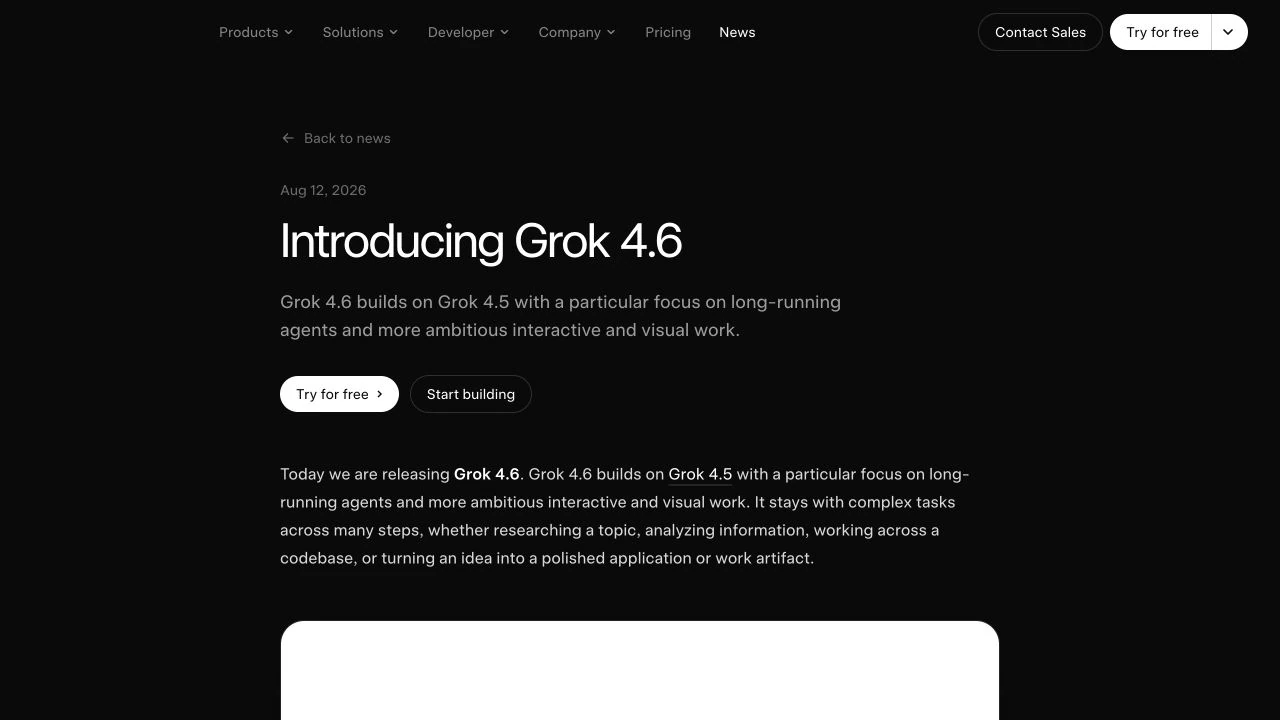
ใช่—Grok 4.6 เป็นโมเดล xAI อย่างเป็นทางการ ที่เปิดตัวเมื่อวันที่ 12 สิงหาคม 2026 และควรได้รับความสนใจอย่างจริงจัง หากงานของคุณเกี่ยวข้องกับชุดข้อมูลวิจัยขนาดใหญ่ การเขียนโค้ด การวิเคราะห์หลายขั้นตอน หรืองานที่เกี่ยวข้องกับภาพ. หน้าต่างบริบทขนาด 500K โทเคน และระบบการให้เหตุผลที่สามารถปรับแต่งได้ ทำให้มันมีความสามารถเพียงพอสำหรับโครงการที่ต้องการประสิทธิภาพสูง แม้ว่ามันจะไม่ใช่ตัวเลือกที่เร็วที่สุดหรือดีที่สุดโดยอัตโนมัติสำหรับทุกคำสั่ง แต่คำถามที่แท้จริงไม่ใช่ว่ามัน Grok 4.6 มีอยู่หรือไม่ แต่เป็นว่าจุดแข็งของมันสอดคล้องกับงานที่คุณต้องการให้เสร็จสิ้นหรือไม่.
หากคุณต้องการตอบคำถามนั้นโดยไม่จำเป็นต้องผูกมัดกระบวนการทำงานทั้งหมดของคุณกับผู้ให้บริการเพียงรายเดียว, GlobalGPT เป็นจุดเริ่มต้นที่ยอดเยี่ยม. พื้นที่ทำงานในเบราว์เซอร์ของมันช่วยให้คุณสามารถใช้ Grok 4.6 ร่วมกับรุ่นชั้นนำอื่น ๆ ได้ ดำเนินการวิจัย การเขียน การวิเคราะห์ หรือคำสั่งการเขียนโค้ดเดียวกัน และเปรียบเทียบผลลัพธ์ในที่เดียว นี่เป็นวิธีที่ปฏิบัติได้จริงและเรียบง่ายอย่างน่าชื่นใจ เพื่อดูว่า Grok 4.6 โดดเด่นอย่างแท้จริงในด้านใด — และโมเดลอื่นเหมาะกับงานของคุณมากกว่าในด้านใด — ก่อนที่จะเลือกการตั้งค่าหรือแพ็กเกจสมัครสมาชิกที่เหมาะกับคุณ.
Grok 4.6 คืออะไรกันแน่?
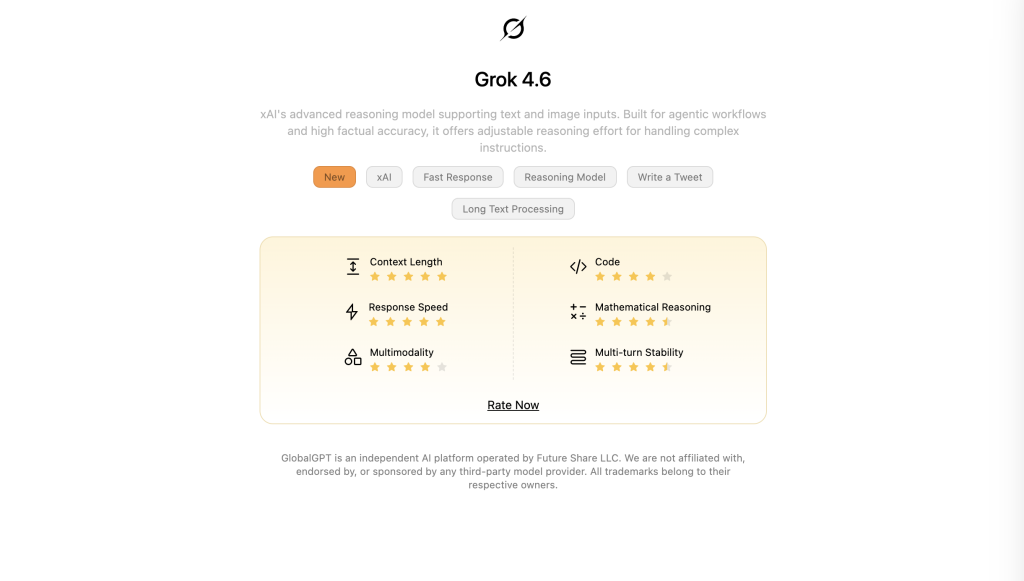
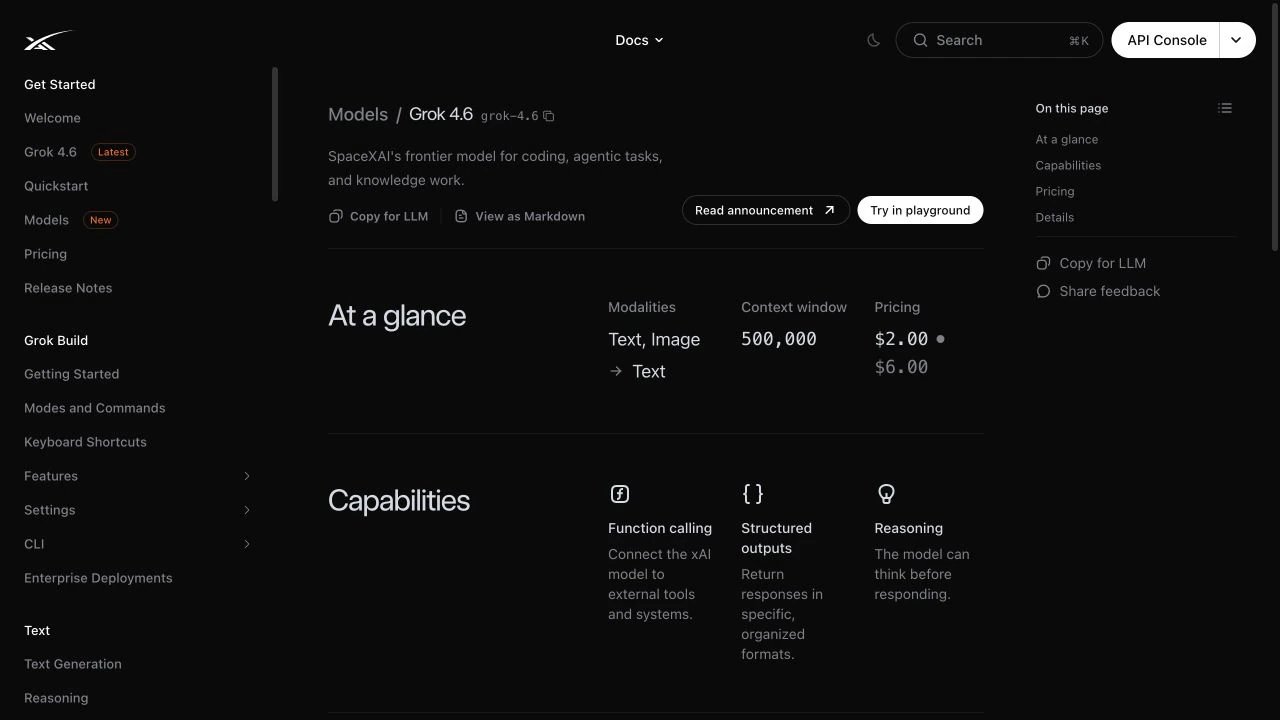
Grok 4.6 เป็นรุ่นเรือธงปี 2026 ของ xAI ในซีรีส์ Grok หน้าข้อมูลรุ่นอย่างเป็นทางการอธิบายถึงการรับข้อมูลเข้าแบบข้อความและภาพ การออกผลเป็นข้อความ การให้เหตุผลที่สามารถปรับแต่งได้ และหน้าต่างบริบทขนาด 500K โทเคน รหัส API คือ grok-4.6; นั่นคือค่าที่ผู้พัฒนาควรใช้ในคำขอ.
ภาษาการประกาศของ xAI เองมีความเฉพาะเจาะจง: Grok 4.6 เน้นไปที่ เอเจนต์ที่ทำงานต่อเนื่องเป็นเวลานาน และงานเชิงโต้ตอบและงานด้านภาพที่มีความท้าทายมากขึ้น เอกสารอย่างเป็นทางการระบุว่าภาษานี้เหมาะสำหรับการเขียนโค้ด งานที่เกี่ยวข้องกับเอเจนต์ และงานด้านความรู้ โดยมีการเรียกฟังก์ชันและผลลัพธ์ที่มีโครงสร้าง สำหรับกระบวนการทำงานที่ต้องการเครื่องมือหรือรูปแบบการตอบสนองที่คาดการณ์ได้.
บัตรโมเดลระบุวันที่ตัดรอบการฝึกอบรมล่วงหน้าคือเดือนมกราคม 2026 ความแตกต่างนี้มีความสำคัญ หน้าต่างบริบทขนาด 500K ช่วยให้คุณสามารถส่งแพ็กเก็ตข้อมูลต้นทางที่มีขนาดใหญ่มากได้ แต่ไม่ได้ทำให้โมเดลกลายเป็นเครื่องมือค้นหาแบบเรียลไทม์โดยอัตโนมัติ สำหรับราคาปัจจุบัน ข่าวสาร หรือนโยบายผลิตภัณฑ์ที่เปลี่ยนแปลง ให้ตรวจสอบแหล่งข้อมูลและยืนยันคำตอบ.
ข้อมูลจำเพาะอย่างเป็นทางการของ Grok 4.6 คืออะไร?
| ข้อกำหนด | ค่าที่บันทึกอย่างเป็นทางการ | ทำไมมันถึงสำคัญ |
|---|---|---|
| วันวางจำหน่าย | 12 สิงหาคม 2026 | ยืนยันว่านี่เป็นการปล่อยเวอร์ชันอย่างเป็นทางการของ xAI. |
| รหัสโมเดล API | grok-4.6 | ใช้ slug นี้อย่างถูกต้องในคำขอ API. |
| หน้าต่างบริบท | 500K โทเคน | เหมาะสำหรับการเขียนรายงานที่ยาว โครงสร้างโค้ด และการวิจัยที่มีข้อมูลต้นฉบับจำนวนมาก. |
| ข้อมูลเข้า / ข้อมูลออก | การป้อนข้อมูลแบบข้อความและภาพ; การออกผลแบบข้อความ | รองรับคำสั่งแบบหลายรูปแบบ แต่ไม่รองรับการสร้างภาพ. |
| เหตุผล | สามารถปรับตั้งค่าได้ | ช่วยให้กระบวนการทำงานสามารถเลือกระหว่างความเร็วกับการวิเคราะห์ที่ลึกซึ้งยิ่งขึ้น. |
| การเรียกใช้งานฟังก์ชัน | ได้รับการสนับสนุน | เชื่อมต่อโมเดลกับเครื่องมือและระบบภายนอก. |
| ผลลัพธ์ที่มีโครงสร้าง | ได้รับการสนับสนุน | มีประโยชน์สำหรับ JSON การสกัดข้อมูล และกระบวนการทำงานที่คาดการณ์ได้. |
| เกณฑ์ตัดรอบก่อนการฝึกอบรม | มกราคม 2026 | อย่าถือว่ารุ่นพื้นฐานเป็นรุ่นล่าสุดโดยอัตโนมัติ. |
ที่มา: ประกาศจาก xAI, เอกสารอธิบายโมเดล และ Model Card ของ Grok 4.6. ข้อมูลจำเพาะอย่างเป็นทางการอาจไม่ตรงกับผลการทดสอบประสิทธิภาพจากแหล่งอิสระ.
Grok 4.6 สามารถทำอะไรได้บ้าง?
การวิเคราะห์อย่างมีเหตุผลและตามโครงสร้าง
การให้เหตุผลที่สามารถปรับแต่งได้ทำให้ Grok 4.6 เหมาะสำหรับงานที่จำเป็นต้องมีคำตอบที่ผ่านการพิจารณาอย่างรอบคอบ เช่น การเปรียบเทียบหลักฐาน การสร้างตารางการตัดสินใจ การวางแผนการดำเนินการ หรือการตรวจสอบการคำนวณที่มีข้อจำกัด การให้เหตุผลที่มากขึ้นไม่ได้หมายความว่าจะดีกว่าโดยอัตโนมัติสำหรับทุกคำขอ ดังนั้น การสกัดข้อมูลและการเขียนใหม่แบบประจำเป็นประจำควรใช้การตั้งค่าที่เหมาะสม.
งานวิจัยและงานที่ต้องอ้างอิงแหล่งข้อมูลจำนวนมาก
หน้าต่างบริบทขนาด 500K ให้โมเดลมีพื้นที่เพียงพอสำหรับรายงานขนาดใหญ่ บันทึกการสนทนา เอกสารนโยบาย และชุดข้อมูลต้นฉบับ กระบวนการทำงานที่มีประสิทธิภาพที่สุดคือการค้นหาด้วยตัวระบุตำแหน่งที่ชัดเจนและกฎการอ้างอิง ตามด้วยการเปิดข้อมูลต้นฉบับเพื่อตรวจสอบ.
การเขียนโค้ดและการแก้ไขข้อผิดพลาด
ผลการประเมินด้านวิศวกรรมซอฟต์แวร์ที่ได้รับการเผยแพร่แล้ว รวมถึงการทดสอบการแก้ไขข้อผิดพลาดในระบบของเรา ซึ่งมีความซับซ้อนไม่มาก ได้สนับสนุนการใช้ระบบนี้ในการตรวจสอบโค้ด การแก้ไขข้อผิดพลาด และงานของเอเจนต์ที่มีโครงสร้างชัดเจน นักพัฒนาควรดำเนินการทดสอบในระบบท้องถิ่นและตรวจสอบแพตช์ก่อนการปรับใช้.
การเข้าใจภาพ
xAI บันทึกข้อมูลเข้าแบบข้อความและภาพ พร้อมทั้งให้ผลลัพธ์เป็นข้อความ ซึ่งระบบนี้สนับสนุนการตีความภาพหน้าจอ การวิเคราะห์เอกสารและภาพ รวมถึงการตอบคำถามแบบภาพ แต่ไม่ควรสับสนกับกระบวนการสร้างภาพ.
การใช้งานเอเจนต์และเครื่องมือมาอย่างยาวนาน
นี่คือความสามารถที่เกี่ยวข้องอย่างใกล้ชิดที่สุดกับตำแหน่งการเปิดตัวของ xAI การเรียกฟังก์ชันช่วยให้ Grok 4.6 สามารถเชื่อมต่อกับเครื่องมือภายนอกได้ ส่วนผลลัพธ์ที่มีโครงสร้างช่วยให้ผลลัพธ์สามารถส่งต่อไปยังขั้นตอนถัดไปได้ง่ายขึ้น การผสมผสานนี้เหมาะสำหรับเอเจนต์ที่รวบรวมบริบท ทำงานผ่านโค้ดเบส เรียกเครื่องมือ ตรวจสอบผลลัพธ์ และส่งคืนผลลัพธ์ที่เสร็จสมบูรณ์ โมเดลนี้ยังคงต้องการสภาพแวดล้อมการทำงานภายนอก การตรวจสอบสิทธิ์ และการตรวจสอบวัตถุประสงค์; คำว่า “agentic” ไม่ได้หมายความว่าโมเดลพื้นฐานจะทำงานอย่างอิสระ.
งานที่มีปฏิสัมพันธ์และเน้นด้านภาพ
xAI ยังเน้นย้ำถึงงานเชิงโต้ตอบและงานด้านภาพที่มีความท้าทายมากขึ้น การทดลองที่เหมาะสมคือเอกสารสรุปผลิตภัณฑ์ที่มีภาพหน้าจอจำนวนมาก หรือรายงานที่สนับสนุนด้วยแผนภูมิ ซึ่งโมเดลต้องเชื่อมโยงหลักฐานทางภาพกับคำแนะนำที่เขียนไว้ ตรวจสอบป้ายกำกับ แกน หน่วย และรายละเอียดที่ถูกละเว้นก่อนที่จะถือว่าผลลัพธ์นั้นเป็นขั้นสุดท้าย.
มีอะไรที่เปลี่ยนแปลงในรุ่น Grok 4.6 เมื่อเทียบกับรุ่น Grok ก่อนหน้านี้?
การวางตำแหน่งของ xAI เน้นไปที่ความสามารถในการวิเคราะห์เหตุผลที่แข็งแกร่งขึ้น การทำงานของเอเจนต์การเขียนโค้ด และประสิทธิภาพในการจัดการบริบทที่ยาว การอัปเกรดในทางปฏิบัติไม่ใช่เพียงคุณสมบัติที่โดดเด่นเพียงอย่างเดียว แต่เป็นการผสมผสานระหว่างพื้นที่ทำงานที่กว้างขึ้น ความสามารถในการวิเคราะห์เหตุผลที่ปรับแต่งได้ และโมเดลที่ได้รับการปรับแต่งให้เหมาะสมกับงานหลายขั้นตอนที่ซับซ้อน.
สิ่งนี้ยังจำเป็นต้องผ่านการทดสอบกระบวนการทำงาน (workflow) โมเดลอาจได้คะแนนสูงในการทดสอบมาตรฐาน (benchmark) แต่กลับไม่เหมาะสมกับสไตล์การเขียนของคุณ ข้อกำหนดการอ้างอิง หรือฐานโค้ด Grok 4.6 ควรได้รับการประเมินจากงานที่คุณทำซ้ำทุกสัปดาห์ ไม่ใช่จากตัวเลขบนตารางอันดับเพียงอย่างเดียว.
Grok 4.6 มีผลการทดสอบในมาตรฐานการวัดประสิทธิภาพที่เชื่อถือได้อย่างไร?
ตารางด้านล่างนี้แยกผลการวัดจาก Model Card ของ xAI เองออกจากผลการวัดจากแหล่งอิสระ ซึ่งสิ่งนี้มีความสำคัญอย่างยิ่ง เนื่องจากตัวเลขจาก Terminal-Bench ทั้งสองเป็นเวอร์ชันที่แตกต่างกัน และไม่ควรนำเสนอเป็นคะแนนเปรียบเทียบโดยตรง.
| ผู้ประเมิน | งาน / ตัวชี้วัด | ผลการรายงาน | ประเภทและข้อจำกัดของหลักฐาน |
|---|---|---|---|
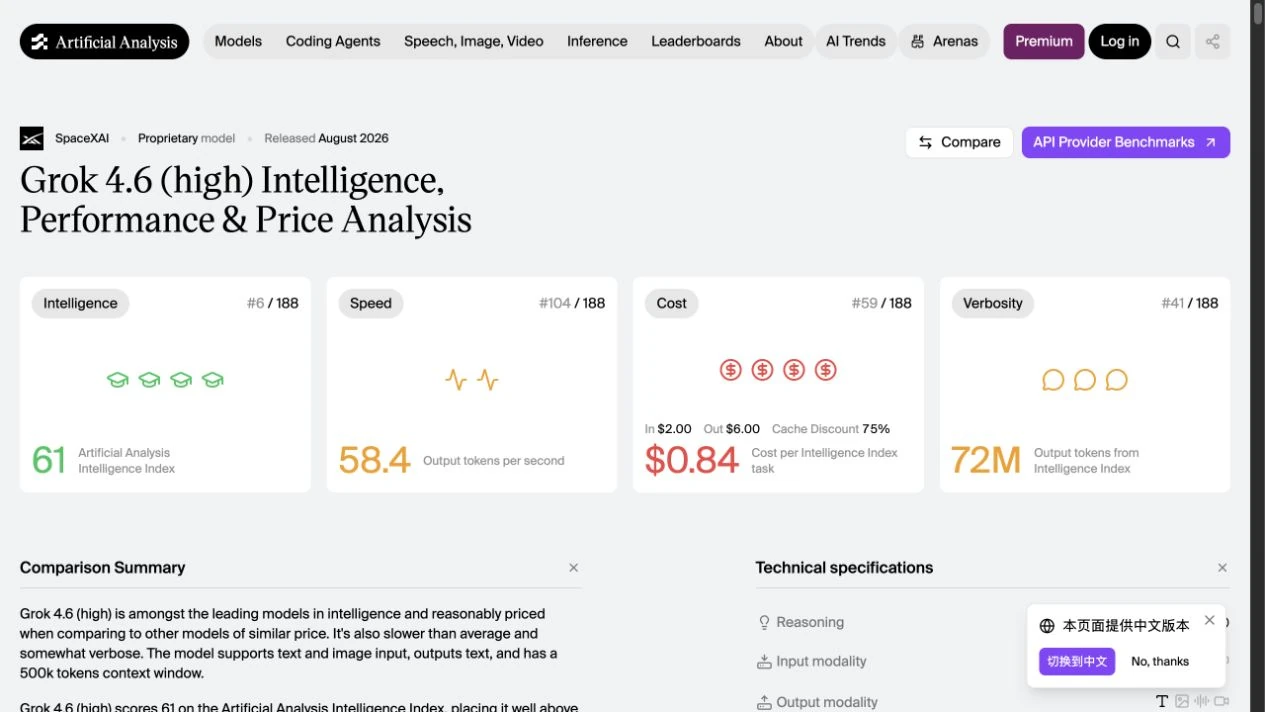
| การวิเคราะห์เทียม | ดัชนีความฉลาด | 61 (#6 / 188 ณ เวลาที่ถูกจับ) | ข้อมูลรวมที่อิสระ; ใช้วิธีการและวันที่ของ AA. |
| การวิเคราะห์เทียม | ความเร็วในการส่งออก | 58.4 โทเคนต่อวินาที | ข้อมูลความเร็วแบบอิสระ; เส้นทางและอุปกรณ์มีผลต่อความล่าช้า. |
| การวิเคราะห์เทียม | ค่าใช้จ่ายต่อภารกิจด้านข่าวกรอง | $0.84 | การประมาณการของ AA โดยใช้ชุดงานของบริษัทเอง; ไม่ใช่ใบแจ้งหนี้ของ xAI. |
| การวิเคราะห์เทียม | GDPval-AA v2 | 1753 | การประเมินผลงานแบบอิสระ. |
| การวิเคราะห์เทียม | AA-กระเป๋าเอกสาร | 1577 | การประเมินสไตล์การทำงานด้านความรู้แบบอิสระ. |
| การวิเคราะห์เทียม | Terminal-Bench v2.1 | 88.4% | ผลจาก Independent v2.1; ไม่สามารถเปรียบเทียบกับ Terminal-Bench 3.0 ได้. |
| บัตรข้อมูลโมเดล xAI | Terminal-Bench 3.0 | 26% | ผลอย่างเป็นทางการจากบัตรโมเดลในเวอร์ชันอื่น. |
| Mercor APEX-SWE | วิศวกรรมซอฟต์แวร์ | 56.4% ± 6.2% | 200 งาน; ควรเก็บช่วงความไม่แน่นอนไว้. |
| ตัวแทน Mercor APEX | งานของตัวแทน | 57.5% ± 3.5% | 33 โลก / 480 ภารกิจ; การประเมินเอเจนต์แบบเฉพาะเจาะจง. |
| บัตรข้อมูลโมเดล xAI | DeepSearchQA | 81.6% | สภาพการควบคุมคุณภาพการวิจัยตามรายงานของผู้จำหน่าย. |
| บัตรข้อมูลโมเดล xAI | อัตราการเกิดภาพหลอนจากข้อมูลจริง | 1.7% | เงื่อนไขการทดสอบของโมเดลการ์ด ไม่ใช่ค่าอัตราความผิดพลาดทั่วไป. |
แหล่งข้อมูล: Artificial Analysis, Mercor APEX leaderboards และ xAI Model Card. ไม่ควรรวมคะแนนจากชุดข้อมูล เวอร์ชัน การตั้งค่าความพยายาม หรือผู้ประเมินที่แตกต่างกัน.
Grok 4.6 ดีกว่า Grok 4.5 หรือไม่?
บัตรโมเดลอย่างเป็นทางการให้คำตอบที่ผสมผสาน แทนที่จะเป็นคำตอบง่ายๆ ว่า “ใช่” Grok 4.6 มีผล DeepSearchQA ที่สูงกว่ามาก ในขณะที่บัตรเดียวกันนี้รายงานอัตราการสร้างข้อมูลเท็จเกี่ยวกับข้อเท็จจริงที่สูงกว่า Grok 4.5 การวิเคราะห์อย่างจริงจังไม่ควรนำผลการทดสอบมาตรฐานที่แข็งแกร่งเพียงหนึ่งครั้งมาอ้างว่าเป็นความน่าเชื่อถือที่ครอบคลุมทุกกรณี.
| การประเมินอย่างเป็นทางการ | Grok 4.6 | Grok 4.5 | วิธีตีความ |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | มีผลการประเมินที่เน้นการค้นหาแสดงให้เห็นถึงการเพิ่มขึ้นอย่างมีนัยสำคัญ. |
| อัตราการเกิดภาพหลอนจากข้อมูลจริง | 1.7% | 0.98% | ยิ่งต่ำยิ่งดี; Grok 4.5 เป็นค่าที่ดีกว่าในสภาพที่รายงานนี้. |
แหล่งที่มา: xAI Grok 4.6 Model Card. การประเมินเหล่านี้ตอบคำถามต่าง ๆ และไม่ได้กำหนดผู้ชนะที่ชัดเจน.
Grok 4.6 มีความเร็ว ความน่าเชื่อถือ และประสิทธิภาพอย่างไรในการใช้งานจริง?
หลักฐานที่เผยแพร่แล้วชี้ให้เห็นถึงโมเดลที่มีประสิทธิภาพสูง แต่ “ประสิทธิภาพ” ประกอบด้วยหลายส่วน ได้แก่ คุณภาพของคำตอบ ความล่าช้า การรักษาบริบท การปฏิบัติตามคำสั่ง และการกู้คืนหลังเกิดข้อผิดพลาด ในเส้นทางตรงของเรา การทดสอบความพร้อมได้ส่งคืน HTTP 200 และ พร้อมแล้ว. ผลลัพธ์ที่ถูกต้องครั้งแรกสำหรับงานอื่นๆ ได้ส่งกลับมาอย่างสำเร็จ ส่วนคำขอแก้ไขที่มีข้อจำกัดหนึ่งข้อ ได้ก่อให้เกิดความล้มเหลวในโครงสร้างพื้นฐานด้านฝั่งลูกค้า.
Artificial Analysis ให้การตรวจสอบความเป็นจริงที่มีประโยชน์นอกเหนือจากความสามารถในการสร้างหัวข้อข่าว: หน้าเว็บที่บันทึกไว้แสดงดัชนีความฉลาด (Intelligence Index) 61 ความเร็วการส่งออก 58.4 tokens ต่อวินาที และค่าใช้จ่ายประมาณ $0.84 ต่องานความฉลาดหนึ่งงาน การรวมข้อมูลดังกล่าวชี้ให้เห็นว่านี่เป็นโมเดลที่มีประสิทธิภาพแต่ไม่เร็วสุดขีด — เหมาะสมกับงานที่มีความหมายมากกว่าการตอบกลับแบบหนึ่งบรรทัดที่ใช้แล้วทิ้ง.
ผลลัพธ์ที่หลากหลายนี้มีประโยชน์ Grok 4.6 อาจทำงานได้ดีกับงานที่มีโครงสร้างชัดเจน แต่ผู้ใช้ในสภาพแวดล้อมการผลิตควรกำหนดกฎการลองใหม่ (retry rules) ระยะเวลาหมดเวลา (timeouts) และโมเดลสำรอง (fallback model) แทนที่จะสมมติว่าทุกเส้นทางจะทำงานเหมือนกันทุกประการ.
Grok 4.6 ดูมีประโยชน์ที่สุดที่ใด?
งานพัฒนาโค้ดและผลิตภัณฑ์ที่ดำเนินมาอย่างยาวนาน
ตัวอย่างการเปิดตัวของ xAI ครอบคลุมตั้งแต่การวิจัยหัวข้อ การวิเคราะห์ข้อมูล การทำงานกับฐานโค้ด และการเปลี่ยนแนวคิดให้กลายเป็นแอปพลิเคชันหรือผลิตภัณฑ์ที่สมบูรณ์ ซึ่งทำให้งานที่มีขนาดเทียบเท่าฟีเจอร์เป็นเกณฑ์การประเมินที่ดีกว่าการให้คำสั่งแบบของเล่นที่มีเพียงฟังก์ชันเดียว ให้โมเดลมีเป้าหมายที่ชัดเจน ไฟล์ที่เกี่ยวข้อง การทดสอบ และคำนิยามของ "เสร็จสมบูรณ์".
การสังเคราะห์ผลการวิจัยและการทำงานด้านความรู้
หน้าต่าง 500K, ผลลัพธ์ที่มีโครงสร้างชัดเจน และผลลัพธ์ DeepSearchQA ที่แข็งแกร่ง ทำให้ Grok 4.6 เป็นตัวเลือกที่เหมาะสมที่สุดสำหรับการแปลงชุดข้อมูลต้นทางให้เป็นบทสรุปสั้นๆ การระบุจุดไม่เห็นพ้อง หรือการสกัดตารางการตัดสินใจ การทดสอบการตรวจสอบข้อมูลต้นทางสนับสนุนการใช้งานดังกล่าวเมื่อกฎการอ้างอิงถูกกำหนดไว้อย่างชัดเจน.
รายงานขนาดใหญ่และการวิเคราะห์เอกสารหลายฉบับ
ใช้หน้าต่างบริบทสำหรับรายงานประจำปี ใบแสดงผลการเรียน ชุดเอกสารนโยบาย และประวัติโครงการ ซึ่งหากไม่ใช้หน้าต่างนี้ จะต้องแบ่งเอกสารออกเป็นส่วนๆ อย่างละเอียด ขอให้ระบุตำแหน่งหน้าหรือส่วนที่ต้องการ แล้วตรวจสอบตัวเลขสำคัญในเอกสารต้นฉบับ.
การวิเคราะห์ที่อิงจากภาพ
การป้อนข้อมูลทั้งข้อความและภาพมีประโยชน์สำหรับภาพหน้าจอ แผนภูมิ และแผนภาพ สิ่งนี้จะมีค่ามากเมื่อองค์ประกอบภาพเป็นส่วนหนึ่งของงานวิเคราะห์ที่กว้างขึ้น เช่น การตรวจสอบแดชบอร์ดพร้อมกับบริบททางธุรกิจที่เขียนไว้.
กระบวนการทำงานแบบเอเจนต์ที่มีจุดสิ้นสุดที่ชัดเจน
การเรียกใช้ฟังก์ชันและผลลัพธ์ที่มีโครงสร้างช่วยสนับสนุนกระบวนการทำงาน เช่น การตรวจสอบปัญหา การเรียกใช้เครื่องมือ การอัปเดตแผน และการส่งคืนผลลัพธ์ที่เครื่องสามารถอ่านได้ จุดเริ่มต้นที่ปลอดภัยที่สุดคืองานที่มีสิทธิ์จำกัด เงื่อนไขการหยุดที่ชัดเจน และเครื่องมือตรวจสอบวัตถุประสงค์.
| กระบวนการทำงาน | ทำไม Grok 4.6 จึงเหมาะสม | งานเริ่มต้นที่ดีที่สุด |
|---|---|---|
| การเขียนโค้ด | ข้อมูลตำแหน่งจาก xAI พร้อมด้วยหลักฐานจาก APEX-SWE และ CursorBench | การเปลี่ยนแปลงที่ถือเป็นข้อบกพร่องจริงหรือการปรับปรุงคุณสมบัติ พร้อมการทดสอบ |
| การวิจัย | บริบท 500K, ผลลัพธ์ที่มีโครงสร้าง และ DeepSearchQA | การบรรยายสรุปที่มีข้อมูลจากแหล่งที่มา พร้อมด้วยตัวระบุหน้า |
| เอกสารยาว | หน้าต่างบริบทอย่างเป็นทางการขนาดใหญ่ | รายงานประจำปี หรือชุดเอกสารนโยบายหลายฉบับ |
| การวิเคราะห์ทางภาพ | การป้อนภาพร่วมกับระบบ xAI สำหรับการจัดวางงานด้านภาพ | รายงานที่มีแผนภูมิจำนวนมาก พร้อมด้วยคำอธิบายประกอบ |
| ตัวแทน | การเรียกฟังก์ชันและผลลัพธ์ที่มีโครงสร้าง | การวิจัยแบบจำกัดที่มีผู้ตรวจสอบที่ชัดเจน |
Can Grok 4.6 สามารถจัดการงานวิจัยและการตรวจสอบข้อมูลได้หรือไม่?
การทดสอบแพ็กเก็ตต้นทางได้ขอให้ Grok 4.6 จัดประเภทคำกล่าวอ้าง 6 ข้อ อ้างอิงเฉพาะ URL ที่ได้รับการอนุมัติ และปฏิเสธข้อสรุปที่น่าดึงดูดใจ 2 ข้อ.
(1) ได้รับการยืนยัน — ประกาศของ xAI มีวันที่ 12 สิงหาคม 2026 และระบุว่าบริษัทจะปล่อยเวอร์ชัน Grok 4.6 ในวันนั้น
(2) ได้รับการยืนยัน — เอกสารอย่างเป็นทางการของโมเดล xAI ระบุ ID ของโมเดลเป็น grok-4.6
(3) ได้รับการสนับสนุน — เอกสารอย่างเป็นทางการระบุว่าหน้าต่างบริบทมีขนาด 500k
(5) ขัดแย้ง — นั่นเป็นเวอร์ชัน Terminal-Bench ที่ต่างกัน และไม่ใช่ตัวชี้วัดเดียวกัน
(6) ขัดแย้ง — หน้าดังกล่าวแสดงเพียงรายการพื้นที่ทำงาน (workspace) เท่านั้น ไม่ใช่การรวมอยู่ในทุกแผน.
แสดงผลลัพธ์เต็มของ Grok 4.6
| ข้ออ้าง | คำตัดสิน | คำตอบในหนึ่งประโยค | URL ของแหล่งข้อมูล | ข้อจำกัดที่แม่นยำ |
|---|---|---|---|---|
| (1) xAI ประกาศ Grok 4.6 เมื่อวันที่ 12 สิงหาคม 2026 | ได้รับการสนับสนุน | ประกาศของ xAI มีวันที่ 12 สิงหาคม 2026 และระบุว่าบริษัทจะปล่อย Grok 4.6 ในวันนั้น | | https://x.ai/news/grok-4-6 | Packet อ้างอิงเพียงวันที่และบรรทัดที่ประกาศการปล่อยเวอร์ชันเท่านั้น ไม่รวมถึงเนื้อหาโพสต์ทั้งหมด |
| (2) ID แบบจำลอง API อย่างเป็นทางการคือ grok-4.6 | ได้รับการสนับสนุน | เอกสารแบบจำลองอย่างเป็นทางการของ xAI ระบุ ID แบบจำลองเป็น grok-4.6 | | https://docs.x.ai/developers/models/grok-4.6 | สรุปของ Packet ไม่ระบุชื่อเรียกอื่นหรือ ID อื่น |
| (3) หน้าต่างบริบทอย่างเป็นทางการคือ 500k tokens | รองรับ | เอกสารอย่างเป็นทางการระบุหน้าต่างบริบท 500k tokens | | https://docs.x.ai/developers/models/grok-4.6 | แพ็กเก็ตระบุว่า “500k context” แต่ไม่มีการระบุชัดเจนว่า “tokens” |
| (4) Artificial Analysis วัดค่า Intelligence 61 อย่างอิสระ | สนับสนุน | AA เผยแพร่ดัชนี Intelligence 61 สำหรับ Grok 4.6. | https://artificialanalysis.ai/models/grok-4-6 | Packet รายงานคะแนนของ AA ไม่ใช่การตรวจสอบวิธีการของ AA แยกต่างหาก |
| (5) Terminal-Bench 3.0 26% และ v2.1 88.4% สามารถเปรียบเทียบได้โดยตรง | ขัดแย้ง | เหล่านี้เป็นเวอร์ชัน Terminal-Bench ที่ต่างกัน และไม่ใช่ตัวชี้วัดเดียวกัน | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | Packet ให้คะแนนทั้งสอง แต่ไม่มีความเทียบเท่าหรือตารางแปลง |
| (6) หน้า GlobalGPT Grok 4.6 พิสูจน์ว่าทุกแผนรวมโมเดลนี้ | ขัดแย้ง | หน้าดังกล่าวแสดงเพียงรายการในพื้นที่ทำงาน (workspace entry) เท่านั้น ไม่ใช่การรวมอยู่ในทุกแผน | | https://www.glbgpt.com/home/grok-4-6 | แพ็กเก็ตเองระบุว่านี่เป็นรายการอินเทอร์เฟซ ไม่ใช่ทุกแผน |
สรุปการรีวิว: มันสามารถติดตามขอบเขตของหลักฐานได้อย่างดีเมื่อแพ็กเก็ตต้นทางและรูปแบบคำตอบถูกกำหนดไว้อย่างชัดเจน สิ่งนี้มีประโยชน์สำหรับกระบวนการทำงานด้านการวิจัย แต่คำตอบของโมเดลยังคงเป็นเพียงเครื่องมือช่วยในการวิจัยเท่านั้น — ไม่ใช่หลักฐานภายนอกเอง.
แสดงข้อความคำสั่งทดสอบอย่างแม่นยำ
ใช้เฉพาะแพ็กเก็ตแหล่งที่มาที่แนบมาเท่านั้น สำหรับแต่ละข้อกล่าวอ้างทั้งหกข้อ ให้ตอบว่า “ได้รับการสนับสนุน”, “ถูกขัดแย้ง” หรือ “ยังไม่ได้รับการยืนยัน” พร้อมด้วยคำตอบหนึ่งประโยค URL ของแหล่งที่มา และข้อจำกัดที่ชัดเจน.
Grok 4.6 เหมาะสำหรับการเขียนโค้ดและการแก้ไขข้อผิดพลาดหรือไม่?
งาน JavaScript นี้ต้องมีการเปรียบเทียบความแตกต่าง (diff) ที่น้อยที่สุด การจัดเรียงตามค่าตัวเลข การจัดการค่ามัธยฐานของจำนวนคี่/คู่ที่ถูกต้อง ความไม่เปลี่ยนแปลง (immutability) และเงื่อนไขข้อผิดพลาดที่แม่นยำสองกรณี.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}แสดงคำอธิบายที่ส่งกลับโดย Grok 4.6
ฟังก์ชันต้นฉบับได้ทำการแปลงอาร์กิวเมนต์และใช้การเรียงลำดับแบบเลกซิโคกราฟิกตามค่าเริ่มต้น (lexicographic sort()), ดังนั้นจึงสร้างสำเนาด้วย slice() และจัดเรียงตามค่าตัวเลขผ่าน (a, b) => a - b. หลังจากปฏิเสธค่าที่ไม่ใช่ array ด้วย TypeError และ array ที่ว่างด้วย Error("empty input") ผลลัพธ์ที่มีความยาวคี่คือองค์ประกอบกลางเดียว ส่วนผลลัพธ์ที่มีความยาวคู่คือค่าเฉลี่ยของค่าสองค่าที่อยู่ตรงกลาง ซึ่งก็คือค่ามัธยฐานตามมาตรฐาน.การใช้งานที่ดีที่สุด: การแก้ไขข้อผิดพลาดในโครงการขนาดเล็กถึงกลาง การเขียนการทดสอบ การตรวจสอบโค้ด และการอธิบายฟังก์ชันที่ไม่คุ้นเคย สำหรับรีโพสิตอรีขนาดใหญ่ ให้ใช้โมเดลนี้ร่วมกับโปรแกรมรันการทดสอบของคุณเอง และตรวจสอบความแตกต่างก่อนที่จะรวมโค้ด.
แสดงขอบเขตการทดสอบ
ปรับค่า median(values) โดยไม่เปลี่ยนแปลงรูปแบบของมัน อย่าเปลี่ยนแปลงข้อมูลเข้า; ส่ง TypeError สำหรับข้อมูลที่ไม่ใช่แบบอาร์เรย์ และส่ง Error("empty input") สำหรับอาร์เรย์ที่ว่าง; คืนค่าความแตกต่างที่รวมกันและน้อยที่สุด.หน้าต่างบริบท 500K ช่วยได้ไหมเมื่อทำงานกับเอกสารที่ยาว?
แบบฟอร์มการเรียกข้อมูลที่มีมากกว่า 220K โทเคน ได้ขอข้อมูล 7 สนาม ข้อมูลตำแหน่งส่วน/หน้า และคำอธิบายเกี่ยวกับสองเวอร์ชันของ Terminal-Bench.
{
  "release_date": {"value": "12 สิงหาคม 2026", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "context_window": {"value": "500k tokens", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 ต่อหนึ่งล้านโทเคน (คำสั่งที่มีมากกว่า 200K โทเคน)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88.4%"]
}แสดงผลลัพธ์ JSON ของ Grok 4.6 แบบเต็ม
{
  "release_date": {"value": "12 สิงหาคม 2026", "section": "การปล่อย xAI", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "API model", "locator": "p.2"},
  "context_window": {"value": "500k tokens", "section": "API model", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 ต่อหนึ่งล้านโทเคน (คำสั่งที่มีมากกว่า 200K โทเคน)", "section": "pricing", "locator": "p.3"},
  "terminal_bench_version": [{"value": "3.0", "section": "benchmark card", "locator": "p.4"},{"value": "v2.1", "section": "independent benchmark", "locator": "p.5"}],
  "terminal_bench_score": [{"value": "26%", "section": "benchmark card", "locator": "p.4"},{"value": "88.4%", "section": "independent benchmark", "locator": "p.5"}],
  "evidence_limits": {"value": "ผล Terminal-Bench ทั้งสองไม่สามารถเปรียบเทียบกันได้ เนื่องจากเป็นเวอร์ชันการทดสอบประสิทธิภาพที่แตกต่างกัน ไม่มีการระบุความพร้อมใช้งานจริง.", "section": "การทดสอบประสิทธิภาพแบบอิสระ", "locator": "p.5"}
}
สิ่งนี้พิสูจน์ว่า: โมเดลนี้สามารถดึงข้อมูลและจัดโครงสร้างข้อมูลจากแพ็กเก็ตที่มีขนาดใหญ่และมีข้อมูลรบกวนได้ ตามโครงสร้างข้อมูลที่กำหนดไว้อย่างเคร่งครัด. สิ่งที่มันไม่ได้พิสูจน์: ว่าทุกคำขอ 500K โทเคน จะมีความเร็ว ราคา หรือความแม่นยำที่เท่ากัน สำหรับเอกสารของลูกค้าใดก็ตาม.
Grok 4.6 สามารถปฏิบัติตามคำสั่งอย่างเคร่งครัดและใช้เหตุผลอย่างโปร่งใสได้หรือไม่?
สำหรับปัญหาการจัดสรรทรัพยากรที่มีข้อจำกัด ระบบได้ให้คำตอบที่เป็นคำตอบเดียวที่ถูกต้อง: วิจัย 7 ชั่วโมง, การเขียนโค้ด 9 ชั่วโมง และ QA 8 ชั่วโมง.
{"R":7,"C":9,"Q":8,"total":24,"check":"ค่าต่างๆ ตรงตามเงื่อนไข R+C+Q=24 โดย C=R+2 และ Q=R+1."}แสดงข้อความคำสั่งอย่างถูกต้อง
แบ่งเวลา 24 ชั่วโมงระหว่างการวิจัย (R), การเขียนโค้ด (C) และการตรวจสอบคุณภาพ (Q) ส่งคืนเฉพาะ JSON ที่มีคีย์แบบจำนวนเต็ม ได้แก่ R, C, Q, total และข้อความตรวจสอบหนึ่งประโยค ข้อจำกัด: R + C + Q = 24; C = R + 2; Q = R + 1. ไม่ให้แสดงกระบวนการคิดที่ซ่อนอยู่.
งานการเขียนใหม่แบบจำกัดที่ดำเนินการแยกต่างหาก ไม่ส่งคืนคำตอบ API ในสองครั้งที่ลูกค้าลองทำ ซึ่งถูกบันทึกไว้เป็นความผิดปกติของโครงสร้างพื้นฐาน ไม่ใช่คะแนนคุณภาพ บทเรียนที่ได้จากกรณีนี้คือควรมีเส้นทางสำรองสำหรับการผลิตเนื้อหาบรรณาธิการ.
ราคาของ Grok 4.6 เป็นเท่าไร?
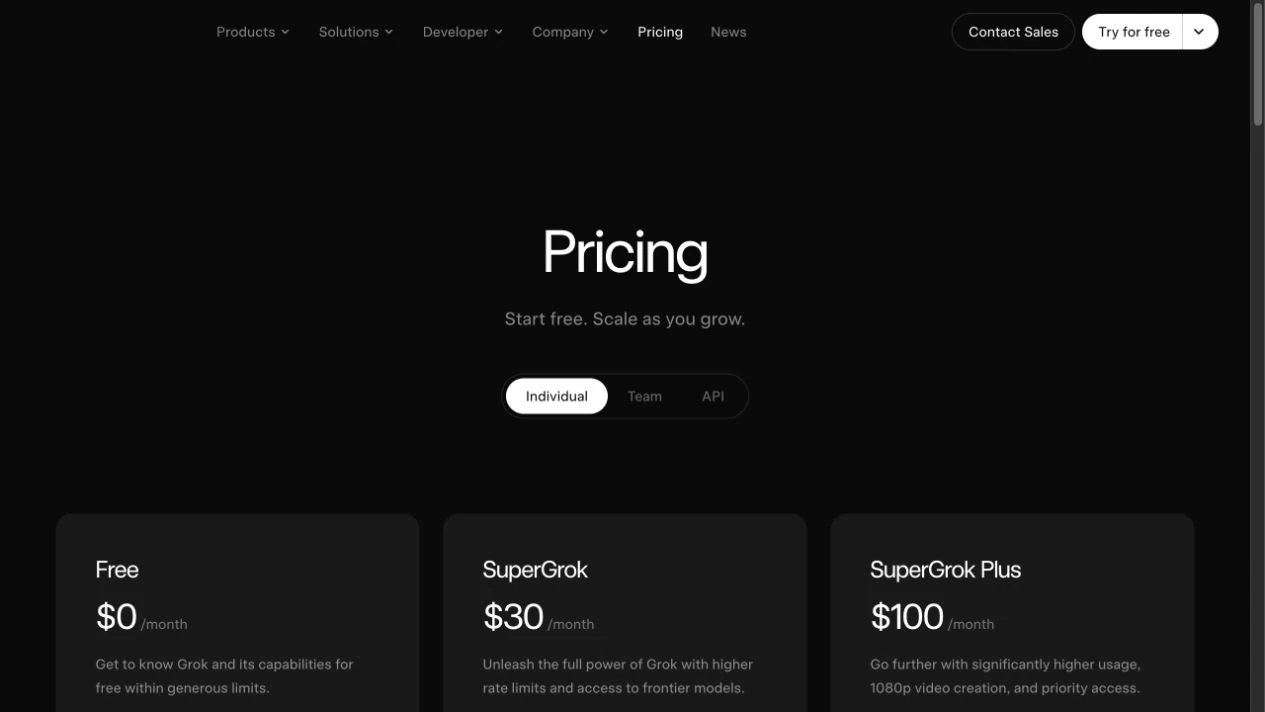
| ตัวเลือก | ราคาที่ประกาศไว้ปัจจุบัน | เหมาะที่สุดสำหรับ | ขอบเขตสำคัญ |
|---|---|---|---|
| xAI สำหรับผู้ใช้ทั่วไป ฟรี | 1,000,000 บาทต่อเดือน | ลองสัมผัสประสบการณ์ของผู้ใช้ท้องถิ่น. | เงื่อนไขการเข้าถึงและข้อจำกัดของแพ็กเกจฟรีอาจมีการเปลี่ยนแปลงได้. |
| ซูเปอร์กร็อก | $30/เดือน | การใช้งานทั่วไปของผู้บริโภค; หน้าปัจจุบันแสดง Grok 4.6. | ตรวจสอบสิทธิ์ที่มีอยู่ก่อนที่จะเผยแพร่. |
| SuperGrok Plus | $100/เดือน | การใช้งานของผู้ใช้สูงมาก; หน้าปัจจุบันแสดง Grok 4.6. | อย่าสันนิษฐานว่าแผนอื่น ๆ สามารถเข้าถึงได้. |
| ระดับพื้นฐานของ xAI API | $2/M เข้า; $6/M ออก; $0.50/M เข้าแบบแคช | ผู้พัฒนาที่สร้างระบบการเชื่อมต่อตามการใช้งาน. | เครื่องมือจะถูกคิดค่าบริการแยกต่างหาก หากมี. |
| ระดับ long-context ของ xAI API | มากกว่า 200K: $4/M เป็นข้อมูลเข้า; $1/M ถูกเก็บไว้ในแคช; $12/M เป็นข้อมูลออก | คำสั่งและเอกสารที่มีขนาดใหญ่มาก. | อย่าใช้ราคาพื้นฐานสำหรับคำขอที่มีจำนวนมากกว่า 200K. |
| โกลบอลจีพีที | ดูแผน GlobalGPT ปัจจุบัน | การเปรียบเทียบ Grok กับรุ่นชั้นนำหลายรุ่นในพื้นที่ทำงานเดียวกัน. | อย่าสมมติว่าทุกแผนจะรวม Grok 4.6; โปรดตรวจสอบหน้าแผน. |
ค่าใช้จ่ายสำหรับการส่งคำขอ API แบบ Grok 4.6 จะอยู่ที่เท่าไร?
| ตัวอย่างคำขอ | การคำนวณ | ค่าใช้จ่ายต่อโทเคนตามแบบจำลอง (ประมาณการ) |
|---|---|---|
| 50K ทางเข้า + 5K ทางออก | 50K × $2/M + 5K × $6/M | $0.13 |
| อินพุต 100K + เอาต์พุต 10K | 100K × $2/M + 10K × $6/M | $0.26 |
| 250K ทางเข้า + 10K ทางออก | 250K × $4/M + 10K × $12/M | $1.12 |
| 400K ทางเข้า + 20K ทางออก | 400K × $4/M + 20K × $12/M | $1.84 |
ตัวอย่างการคำนวณโดยใช้ราคาตามรายการของ xAI ซึ่งไม่รวมส่วนลดจากข้อมูลที่เก็บไว้ในแคช ภาษี ค่าบริการเรียกใช้เครื่องมือ และค่าเพิ่มจากผู้ให้บริการภายนอก.
GlobalGPT เป็นตัวเลือกที่เหมาะสมอย่างยิ่งเมื่อคุณต้องตัดสินใจว่า “โมเดลใดทำงานได้ดีที่สุดสำหรับงานนี้?” แทนที่จะเป็น “ทำอย่างไรให้ทุกงานถูกส่งไปยัง API เดียว?” คุณสามารถเปรียบเทียบคำสั่งสำหรับการเขียน การวิจัย การเขียนโค้ด และการวิเคราะห์ในพื้นที่ทำงานเดียว แล้วใช้ หน้าราคาของ GlobalGPT เพื่อเลือกแพ็กเกจที่ตรงกับปริมาณการใช้งานของคุณ นี่เป็นคำแนะนำแพ็กเกจแบบหลายโมเดล ไม่ใช่การแปลงเครดิต GlobalGPT เป็นราคาโทเคน xAI.
ทำอย่างไรจึงสามารถเข้าถึง Grok 4.6 ได้?
ผู้บริโภคสามารถเริ่มต้นด้วยตัวเลือกการสมัครสมาชิก Grok ของ xAI ที่มีอยู่ในปัจจุบัน ส่วนผู้พัฒนาควรใช้เอกสาร API อย่างเป็นทางการของ xAI และ ID ของโมเดลที่ถูกต้อง grok-4.6. ผู้อ่านที่ต้องการเปรียบเทียบโมเดลโดยไม่ต้องสร้างบัญชี API หลายบัญชี สามารถใช้ข้อมูลพื้นที่ทำงาน Grok 4.6 ที่ได้รับการยืนยันแล้วใน โกลบอลจีพีที; ไม่ควรสับสนระหว่างการเข้าถึงส่วนติดต่อผู้ใช้ (UI) ของแพลตฟอร์มกับทุกคุณสมบัติ xAI แบบเนทีฟ.
ข้อจำกัดหลักของ Grok 4.6 มีอะไรบ้าง?
- ข้อมูลปัจจุบันยังต้องการหลักฐาน: เส้นตายการสมัครฝึกอบรมล่วงหน้าในเดือนมกราคม 2026 ไม่เป็นการรับประกันว่าผู้สมัครจะมีความรู้ที่ใช้งานได้จริง.
- หัวข้อข่าวแบบเปรียบเทียบอาจทำให้เข้าใจผิด: เวอร์ชัน ผู้ประเมิน ความพยายามในการวิเคราะห์ และชุดข้อมูล ต้องแนบไว้กับทุกคะแนน.
- บริบทที่ยาวขึ้นจะทำให้ค่าใช้จ่ายสูงขึ้น: คำสั่งที่มีจำนวนโทเคนเกิน 200K จะใช้ระดับ API แบบ long-context ที่สูงกว่า.
- ความน่าเชื่อถือของเส้นทางมีความแตกต่างกัน: คำขอแก้ไขที่มีข้อจำกัดของเราได้พบปัญหาความล้มเหลวของระบบโครงสร้างพื้นฐาน แม้ว่างานอื่นๆ จะสำเร็จแล้วก็ตาม.
- การเข้าถึงแพลตฟอร์มนั้นไม่เหมือนกัน: การลงทะเบียนพื้นที่ทำงาน GlobalGPT ไม่ได้หมายความว่าจะรวมถึงทุกคุณสมบัติ xAI ที่มาพร้อมระบบหรือทุกสิทธิ์การสมัครสมาชิก.
คุณควรเลือก Grok 4.6 หรือโมเดล AI อื่น?
เลือก Grok 4.6 เมื่องานเน้นไปที่บริบทที่ยาว การเขียนโค้ด และการคิดเชิงโครงสร้าง เลือกโมเดลอื่นหากความสำคัญหลักของคุณคือระบบนิเวศเครื่องมือเฉพาะ, ค่าใช้จ่ายที่คาดการณ์ได้ต่ำลง, ผลลัพธ์แบบมัลติโมดัลเฉพาะ หรือกระบวนการทำงานที่ทีมของคุณรองรับได้ดีอยู่แล้ว การเปรียบเทียบที่ยุติธรรมที่สุดคือการใช้คำสั่งเดียวกัน, แพ็กเก็ตต้นทางเดียวกัน และตัวตรวจสอบเดียวกันสำหรับทุกโมเดล — ซึ่ง GlobalGPT ช่วยให้การจัดเตรียมสิ่งเหล่านี้เป็นเรื่องง่าย.
ใครควรใช้ Grok 4.6?
- นักวิจัยและนักวิเคราะห์: แพ็กเก็ตต้นฉบับ, ตารางหลักฐาน และเอกสารสรุปคดีที่ยาว.
- นักพัฒนา: การแก้ไขข้อผิดพลาด การตรวจสอบโค้ด และแผนการดำเนินการที่มีโครงสร้าง.
- ผู้สร้างและผู้บรรณาธิการ: การเขียนร่างแบบยาว เมื่อคุณให้คำแนะนำที่ชัดเจนและคู่มือสไตล์.
- ทีมที่เปรียบเทียบแบบจำลอง: การประเมินผลด้วยคำสั่งเดียวกันที่สามารถทำซ้ำได้ภายในพื้นที่ทำงานเดียว.
ผู้อ่านมักถามอะไรเกี่ยวกับ Grok 4.6?
Grok 4.6 ได้ออกอย่างเป็นทางการแล้วหรือไม่?
ใช่ครับ ประกาศการเปิดตัวของ xAI มีวันที่ 12 สิงหาคม 2026.
ID แบบจำลอง API อย่างเป็นทางการคืออะไร?
grok-4.6.
หน้าต่างบริบทคืออะไร?
xAI บันทึกหน้าต่างบริบทที่มีขนาด 500K โทเคน.
Grok 4.6 รองรับภาพได้หรือไม่?
ใช่ครับ เอกสารอธิบายรุ่นอย่างเป็นทางการระบุไว้ว่ามีการรับข้อมูลเข้าเป็นรูปภาพและส่งข้อมูลออกเป็นข้อความ.
Grok 4.6 มีราคาเท่าไร?
หน้าผู้ใช้ปัจจุบันแสดงแพ็กเกจ Free ที่ $0 ต่อเดือน, SuperGrok ที่ $30 ต่อเดือน และ SuperGrok Plus ที่ $100 ต่อเดือน ราคา API คำนวณตามปริมาณการใช้งาน และมีระดับราคาสำหรับ long-context แยกต่างหากสำหรับปริมาณที่เกิน 200K tokens.
Grok 4.6 ดีกว่า Grok 4.5 หรือไม่?
ระบบนี้ใหม่กว่าและแสดงประสิทธิภาพที่ดีในหลายการประเมินที่อ้างอิง แต่ภารกิจและเวอร์ชันของเกณฑ์มาตรฐานนั้นแตกต่างกัน ลองทดสอบกระบวนการทำงานประจำของคุณเองดู.
สามารถใช้ Grok 4.6 ใน GlobalGPT ได้หรือไม่?
GlobalGPT มีรายการพื้นที่ทำงาน Grok 4.6 ที่ได้รับการจัดสรรแล้ว โปรดตรวจสอบสิทธิ์การใช้งานแผนปัจจุบันบนหน้ากำหนดราคา.
Grok 4.6 สามารถเชื่อถือได้สำหรับการวิจัยหรือไม่?
ผลการทดสอบแพ็กเก็ตจากแหล่งข้อมูลที่มีข้อจำกัดนั้นดี แต่ข้ออ้างสำคัญควรได้รับการตรวจสอบเสมอโดยอ้างอิงจากแหล่งข้อมูลที่ระบุไว้.
รุ่น Grok 4.6 คุ้มค่าที่จะใช้ในปี 2026 หรือไม่?
Grok 4.6 เป็นโมเดลที่น่าเชื่อถือและได้รับการปล่อยอย่างเป็นทางการ ซึ่งมีหน้าต่างบริบทขนาด 500K ที่มีประโยชน์ ระบบการให้เหตุผลที่สามารถปรับแต่งได้ หลักฐานจากผลการทดสอบมาตรฐานที่ได้รับการเผยแพร่และเชื่อถือได้ รวมถึงผลลัพธ์ที่ดีในรอบแรกสำหรับงานวิจัยที่มีโครงสร้างและงานที่เกี่ยวข้องกับเอกสารยาว จุดอ่อนของโมเดลนี้ก็มีลักษณะที่ใช้งานได้จริงเช่นกัน: ตัวเลขจากผลการทดสอบมาตรฐานจำเป็นต้องมีป้ายกำกับเวอร์ชันอย่างระมัดระวัง ข้อมูลจริงที่อัปเดตแบบเรียลไทม์ยังคงต้องระบุแหล่งที่มา และความน่าเชื่อถือของเส้นทางอาจแตกต่างกันไป.
สำหรับการเข้าถึงแบบเนทีฟของผู้ใช้หรือการพัฒนา API ให้เริ่มจากเอกสารคู่มือปัจจุบันของ xAI สำหรับกระบวนการทำงานที่เน้นการเปรียบเทียบ, ลองใช้ Grok 4.6 ใน GlobalGPT เมื่อเปรียบเทียบกับรุ่นชั้นนำอื่น ๆ แล้ว ให้เลือกแพ็กเกจที่เหมาะกับปริมาณงานการเขียน การวิจัย การวิเคราะห์ หรือการเขียนโค้ดของคุณ.
แหล่งข้อมูลหลัก: การเปิดตัว xAI, เอกสารเกี่ยวกับโมเดล xAI, ราคา API ของ xAI, ราคาสำหรับผู้ใช้ทั่วไปของ xAI, การวิเคราะห์เทียม, Mercor APEX-SWE และ บัตรข้อมูลโมเดล xAI.