
บทรีวิว GPT-LIVE 1 · เอกสารได้รับการตรวจสอบเมื่อวันที่ 1 ตุลาคม 2026
GPT-Live 1 เป็นโมเดลของ OpenAI สำหรับการสนทนาด้วยเสียง ซึ่งสามารถฟังต่อไปได้แม้ในขณะที่กำลังพูดอยู่ แต่มันจะเป็นพื้นฐานที่ใช้งานได้จริงสำหรับเอเจนต์เสียง หรือเป็นเพียงโมเดลเสียงอีกตัวหนึ่งที่มีเดโมที่ดูดีเท่านั้น?
บทวิเคราะห์นี้จะพิจารณาส่วนต่าง ๆ ที่มีผลต่อการพัฒนาจริง ได้แก่ การสนทนาแบบ full-duplex การมอบหมายงานให้กับระบบหลังบ้าน การใช้เครื่องมือ ตัวเลือกการส่งข้อมูล ราคา ขีดจำกัดอัตรา และความแตกต่างระหว่าง GPT-Live กับ Realtime API นอกจากนี้ยังตรวจสอบว่า GlobalGPT มีกระบวนการทำงานด้านเสียงที่คล้ายกันในจุดใด และจุดใดที่ข้อมูลสาธารณะยังไม่สามารถพิสูจน์ได้ว่ามีความเท่าเทียมด้านคุณสมบัติ.
การประเมินนี้อิงจากเอกสารเป็นหลัก ไม่ใช่การทดสอบประสิทธิภาพแบบลงมือทำจริงที่ได้รับการจ่ายเงิน ข้อมูลด้านล่างนี้มาจากคู่มือรุ่นปัจจุบันของ OpenAI และ GPT-Live รวมถึงหน้าเสียงและ API ที่เปิดเผยต่อสาธารณะของ GlobalGPT ซึ่งหมายความว่าผลการประเมินนี้เน้นไปที่สถาปัตยกรรมและความเหมาะสม ไม่ใช่การอ้างอิงเกี่ยวกับความล่าช้า คุณภาพเสียง หรือความน่าเชื่อถือจากการโทรเพียงครั้งเดียวที่ยังไม่ได้รับการวัดผล.
คำตอบด่วน: GPT-Live 1 เป็นตัวเลือกที่เหมาะอย่างยิ่งเมื่อแอปพลิเคชันของคุณต้องการการสนทนาด้วยเสียงที่ฟังดูเป็นธรรมชาติและสามารถถูกขัดจังหวะได้ รวมถึงเอเจนต์ด้านหลังที่สามารถค้นหาข้อมูล เรียกใช้เครื่องมือ หรือทำงานให้เสร็จสิ้นได้ ในขณะที่การสนทนายังคงดำเนินต่อไป ค่าบริการของโมเดลนี้คือ $0.05 ต่อนาทีการสนทนา โดยคิดค่าบริการตามวินาที, โดยค่าบริการสำหรับโมเดลและเครื่องมือด้านหลังระบบจะถูกคิดแยกต่างหาก GlobalGPT ให้บริการกรณีการใช้งานด้านเสียงที่คล้ายกันผ่านเครื่องมือสาธารณะสำหรับการแปลงข้อความเป็นเสียง (text-to-speech), การแปลงเสียงเป็นข้อความ (speech-to-text), การบันทึกเสียง และการถอดเสียง แต่หน้าเว็บสาธารณะของมันไม่สร้างเซสชัน GPT-Live ที่เข้ากันได้กับ OpenAI หรือสถาปัตยกรรมการมอบหมายแบบฟูลดูเพล็กซ์ที่เหมือนกัน.
บนหน้านี้
GPT-Live 1 คืออะไร?
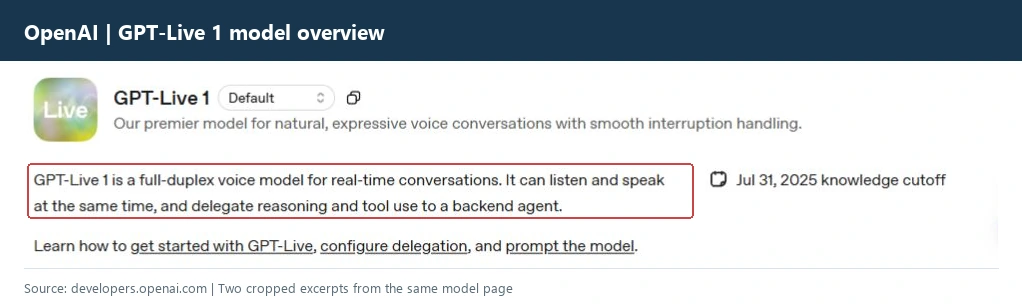
GPT-Live 1 เป็นโมเดลเสียงแบบฟูลดูเพล็กซ์ (full-duplex) สำหรับการสนทนาแบบเรียลไทม์ คำว่าฟูลดูเพล็กซ์หมายความว่าโมเดลนี้สามารถรับเสียงและสร้างเสียงได้พร้อมกัน ทำให้การโต้ตอบสามารถรวมถึงการขัดจังหวะ การยืนยันสั้นๆ และการพูดทับกันได้ แทนที่จะต้องรอจนกว่าการบันทึกเสียงจะเสร็จสิ้นก่อนที่จะตอบกลับ.
OpenAI แยกชั้นเสียงสดออกจากชั้นการวิเคราะห์และดำเนินการ GPT-Live บริหารจัดการการสนทนาด้วยเสียงและตัดสินใจว่าเมื่อใดจะขอความช่วยเหลือ ส่วนโมเดลหรือเอเจนต์ด้านหลังจะรับผิดชอบการวิเคราะห์ที่ลึกขึ้น การค้นหาบนเว็บ การเรียกฟังก์ชัน กฎทางธุรกิจ และสถานะของงาน OpenAI เรียกกระบวนการส่งต่อนี้ว่า คณะผู้แทน.
วิธีแบ่งคำขอ GPT-Live 1
ผู้ใช้สามารถพูดผ่านเบราว์เซอร์ เซิร์ฟเวอร์ หรือการเชื่อมต่อทางโทรศัพท์ GPT-Live จะรับฟัง ตอบกลับ และจัดการการสลับกันพูด.
โมเดลแบบเรียลไทม์จะส่งงานไปยังระบบหลังบ้าน Responses ที่ได้รับการกำหนดค่าไว้ หรือไปยังเอเจนต์ที่จัดการโดยลูกค้าเอง.
แอปพลิเคชันของคุณจะตรวจสอบสิทธิ์การใช้งาน, ดำเนินการเครื่องมือต่าง ๆ และส่งผลลัพธ์ที่ได้รับการตรวจสอบแล้วให้ GPT-Live อธิบายด้วยเสียง.
การแบ่งขั้นตอนนี้คือเหตุผลที่ทำให้ GPT-Live 1 รู้สึกแตกต่างจากคำขอแปลงเสียงเป็นข้อความ ตามด้วยคำขอเติมข้อความให้สมบูรณ์ และคำขอแปลงข้อความเป็นเสียง การออกแบบแบบต่อเนื่องสามารถทำงานได้ดี แต่แอปพลิเคชันของคุณต้องจัดการการตรวจจับการเปลี่ยนรอบการพูด สถานะของข้อความที่ถอดเสียง การขัดจังหวะ และลำดับการเล่น GPT-Live ให้ชั้นการสนทนาด้วยเสียงเพื่อทำหน้าที่นี้.
เพื่อเปรียบเทียบข้อมูลพื้นฐานที่เป็นประโยชน์ โปรดดูคู่มือของเราเกี่ยวกับ การเปิดตัวระบบเสียง ChatGPT และความแตกต่างในทางปฏิบัติระหว่างคุณสมบัติเสียงสำหรับผู้บริโภคกับ API สำหรับผู้พัฒนา.
GPT-Live 1 เทียบกับ Realtime API
ชื่อทั้งสองนี้อาจสับสนกันได้ง่าย เนื่องจากทั้งสองล้วนสนับสนุนเสียงแบบเรียลไทม์ คู่มือเสียงปัจจุบันของ OpenAI กำหนดให้ GPT-Live เป็นจุดเริ่มต้นสำหรับแอปพลิเคชันเสียงสนทนาแบบใหม่ ในขณะที่ Realtime API ยังคงเป็นทางเลือกที่เน้นไปที่เซสชันและเหตุการณ์เป็นหลัก เมื่อคุณต้องการใช้โมเดลการควบคุมเฉพาะของมัน.
การแบ่งปัน WebRTC หรือ WebSocket ในฐานะช่องทางสื่อสาร ไม่ได้ทำให้กระบวนการจับมือ (handshakes) ข้อมูลรับรอง (credentials) หรือรูปแบบเหตุการณ์ (event formats) ของ GPT-Live และ Realtime สามารถใช้แทนกันได้ โปรดพิจารณาทั้งสองเป็นตัวเลือกการบูรณาการที่แยกกัน และทำตามคู่มือการเชื่อมต่อสำหรับ API ที่คุณเลือก.
หากผลิตภัณฑ์ของคุณมีเอเจนต์ข้อความอยู่แล้ว GPT-Live สามารถทำหน้าที่เป็นส่วนหน้าสำหรับการสนทนา ในขณะที่เอเจนต์ที่มีอยู่ยังคงทำหน้าที่เป็นส่วนหลัง หากคุณต้องการตรวจสอบทุกเหตุการณ์เสียงหรือสร้างตัวควบคุมเซสชันแบบกำหนดเอง Realtime อาจให้คุณควบคุมในระดับที่ลึกกว่าตามที่คุณต้องการ.
จุดเด่นของ GPT-Live 1
ตามข้อมูลจำเพาะอย่างเป็นทางการ จุดเด่นที่สุดของ GPT-Live 1 คือการผสานระหว่างการสนทนาและการทำงาน มันถูกออกแบบมาสำหรับผู้ใช้ที่ต้องการสนทนาอย่างเป็นธรรมชาติ ในขณะที่ผู้ช่วยกำลังค้นหาข้อมูล เรียกใช้เครื่องมือ หรือดำเนินการให้เสร็จสิ้น.
การแยกส่วนหลังระบบยังช่วยในการบริหารจัดการด้วย แอปพลิเคชันของคุณยังคงควบคุมการตรวจสอบสิทธิ์ การยืนยันที่จำเป็น การทำงานของเครื่องมือ และสถานะของงาน GPT-Live ไม่ทำให้คำสั่งเสียงที่ไม่น่าเชื่อถือกลายเป็นสิทธิ์ควบคุมอัตโนมัติต่อระบบของคุณ.
สำหรับทีมที่เปรียบเทียบการออกเสียงแทนที่จะเปรียบเทียบโครงสร้างของเอเจนต์ ให้แยกคำถามนี้ออกมาเป็นคำถามที่ต่างกัน A กระบวนการแปลงข้อความเป็นเสียง ประเมินเสียงและวิธีการพูด; แต่ไม่ได้พิสูจน์ว่าผู้แบบจำลองสามารถรักษาการสนทนาสดที่ได้รับการมอบหมายได้.
การตั้งค่าเซสชันแบบมินิมัลดูเป็นอย่างไร
รูปแบบต่อไปนี้สะท้อนตัวอย่างอย่างเป็นทางการของ Python Delegation นี่เป็นตัวอย่างในเอกสารเท่านั้น ไม่ใช่คำขอที่ได้รับการดำเนินการจริง และไม่รวม API key.
session = {
    "model": "gpt-live-1",
    "delegation": {
 "type": "responses",
        "responses": {
 "model": "gpt-6-luna",
 "instructions": "ตอบสั้นๆ และมอบหมายการค้นหาคำสั่งให้เครื่องมือที่ได้รับการอนุมัติ"
 }
    }
}
จุดที่ GPT-Live 1 ยังไม่สมบูรณ์
GPT-Live 1 ไม่ใช่ผลิตภัณฑ์เอเจนต์เสียงที่สมบูรณ์ ซึ่งสามารถขจัดขั้นตอนการออกแบบแอปพลิเคชันได้ โมเดลที่ได้รับการบันทึกไว้ให้ชั้นการสนทนาแบบเรียลไทม์ แต่ระบบโดยรอบยังคงเป็นปัจจัยที่กำหนดว่าผลิตภัณฑ์นั้นปลอดภัย มีประโยชน์ และราคาเหมาะสมหรือไม่.
- ค่าใช้จ่ายด้านหลังระบบกำลังเพิ่มขึ้นเรื่อยๆ. อัตราค่าบริการเซสชันเสียง $0.05 ไม่รวมโมเดล Responses เครื่องมือ การค้นหาบนเว็บ และการใช้งานระบบหลังบ้านอื่นๆ.
- ไม่มีการระบุสิทธิ์ใช้งานระดับฟรี. หน้าข้อมูลของโมเดลระบุว่า ไม่รองรับจำนวนเซสชันพร้อมกันในระดับฟรี; ส่วนระดับ API ที่ต้องชำระเงินมีข้อจำกัดเกี่ยวกับจำนวนเซสชันพร้อมกัน.
- ระบบไม่สนับสนุนผลลัพธ์ที่มีโครงสร้าง. หน้าโมเดลของ GPT-Live ระบุว่าผลลัพธ์ที่มีโครงสร้างและการปรับแต่งละเอียดยังไม่ได้รับการสนับสนุน ดังนั้นควรใช้ระบบหลังบ้านสำหรับสคีมาที่เคร่งครัด.
- คุณยังจำเป็นต้องมีเซิร์ฟเวอร์แอปพลิเคชัน. เก็บกุญแจ API บนเซิร์ฟเวอร์ที่เชื่อถือได้ จัดการสิทธิ์ และรักษาสถานะของบันทึกการสนทนา/งานไว้เมื่อใช้การมอบหมายจากฝั่งไคลเอนต์.
- คุณภาพเสียงต้องขึ้นอยู่กับการประเมินของคุณเอง. หน้าเว็บไซต์อย่างเป็นทางการอธิบายบทบาทของโมเดลนี้ แต่ไม่ได้ยืนยันการออกเสียง คุณภาพการตัดคำ หรือความล่าช้าสำหรับคำศัพท์และสภาพเครือข่ายของคุณ.
- Realtime ไม่สามารถใช้แทนได้ทันทีโดยอัตโนมัติ. วิธีการสื่อสารและรูปแบบกิจกรรมที่แตกต่างกัน อาจทำให้แอป Realtime ที่มีอยู่จำเป็นต้องมีแผนการย้ายระบบ.
เอกสารของ OpenAI ยังชี้ให้เห็นความแตกต่างสำคัญเกี่ยวกับการขัดจังหวะด้วย งานด้านหลังสามารถดำเนินต่อไปได้หลังจากผู้เรียกขัดจังหวะ แต่แอปพลิเคชันของคุณจะเป็นผู้ตัดสินใจว่าจะดำเนินการให้เสร็จสิ้นหรือยกเลิกงานนั้น การเลือกนโยบายดังกล่าวส่งผลต่อความเชื่อมั่นของผู้ใช้ ค่าใช้จ่ายของเครื่องมือ และโอกาสที่จะดำเนินการงานผิด.
หากความต้องการของคุณเป็นเพียงการถอดเสียง การใส่คำบรรยาย หรือการบันทึกเสียงบรรยายเพียงครั้งเดียว การใช้จุดเชื่อมต่อเสียงเฉพาะทางอาจสะดวกกว่า บทความต่อไปที่ควรอ่านคือบทสรุปของเราเกี่ยวกับ วิธีการถอดเสียงวิดีโอ.
ตัวอย่างราคาและค่าใช้จ่ายของ GPT-Live 1
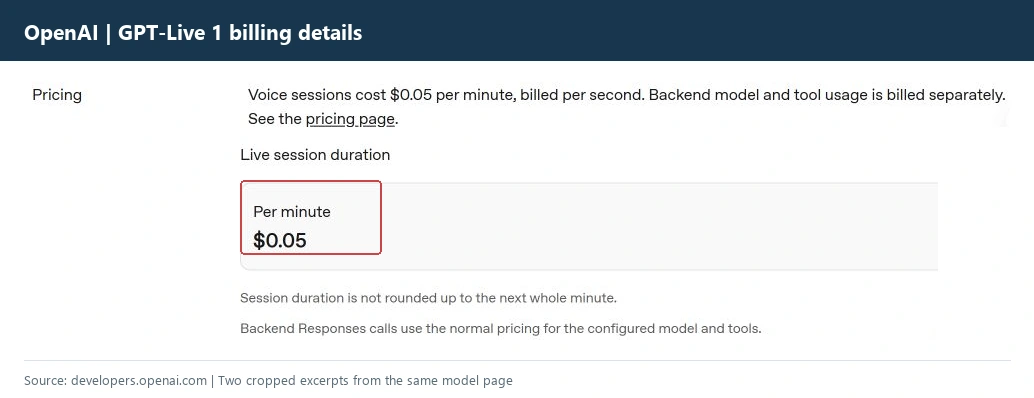
OpenAI ระบุ GPT-Live 1 ไว้ที่ $0.05 ต่อนาที สำหรับการสนทนาด้วยเสียง, คิดค่าบริการตามวินาที ระยะเวลาการใช้งานจะไม่ถูกปัดขึ้นเป็นนาทีเต็ม ราคาดังกล่าวครอบคลุมโมเดลเสียงแบบเรียลไทม์ ส่วนการเรียกใช้ Responses ด้านหลังระบบและการใช้งานเครื่องมือจะมีราคาตามนโยบายของตนเอง.
ตัวอย่างค่าบริการตามแบบที่ $0.05 ต่อนาทีเสียง
ในการจัดทำงบประมาณ ให้แยกตัวเลขสามส่วนออก ได้แก่ เวลาที่เชื่อมต่อกับโมเดลเสียงแบบเรียลไทม์ เวลาการประมวลผลด้านหลังระบบ (backend reasoning time) และเวลาการใช้เครื่องมือหรือการค้นหา แม้การสนทนาสั้นๆ ก็อาจมีค่าใช้จ่ายสูงได้ หากทุกครั้งที่มีการโต้ตอบต้องส่งข้อมูลไปยังโมเดลด้านหลังระบบขนาดใหญ่ หรือต้องเรียกใช้เครื่องมือที่มีค่าใช้จ่ายสูงซ้ำๆ.
หน้าโมเดลแสดงขีดจำกัดจำนวนเซสชันที่ทำงานพร้อมกันตามระดับ API: ระดับฟรีไม่รองรับ, ระดับ 1 กำหนดไว้ที่ 25, ระดับ 2 กำหนดไว้ที่ 50, ระดับ 3 กำหนดไว้ที่ 200, ระดับ 4 กำหนดไว้ที่ 300 และระดับ 5 กำหนดไว้ที่ 500. โปรดพิจารณาตัวเลขเหล่านี้เป็นขีดจำกัดของบัญชีที่ควรตรวจสอบก่อนการเปิดตัว ไม่ใช่คำสัญญาว่าทุกองค์กรจะได้รับปริมาณการประมวลผลที่เท่ากัน.
GlobalGPT มีบริการที่คล้ายกันหรือไม่?
ใช่ ในทางปฏิบัติแล้ว GlobalGPT ให้เครื่องมือเสียงสำหรับการพูดและการแปลงเสียงเป็นข้อความ อินเทอร์เฟซ AI Audio ที่เปิดให้ใช้งานสาธารณะของมันแสดงขั้นตอนการทำงานของ text-to-speech และ speech-to-text ซึ่งรวมถึงการบันทึกหรืออัปโหลดเสียง การถอดเสียง และดาวน์โหลดหรือส่งออกข้อความที่ได้ ส่วนภาพรวม API ที่เปิดให้ใช้งานสาธารณะยังบันทึกงานที่เกี่ยวข้องกับเสียงไว้พร้อมกับงานที่เกี่ยวข้องกับแชท ภาพ และวิดีโอ.
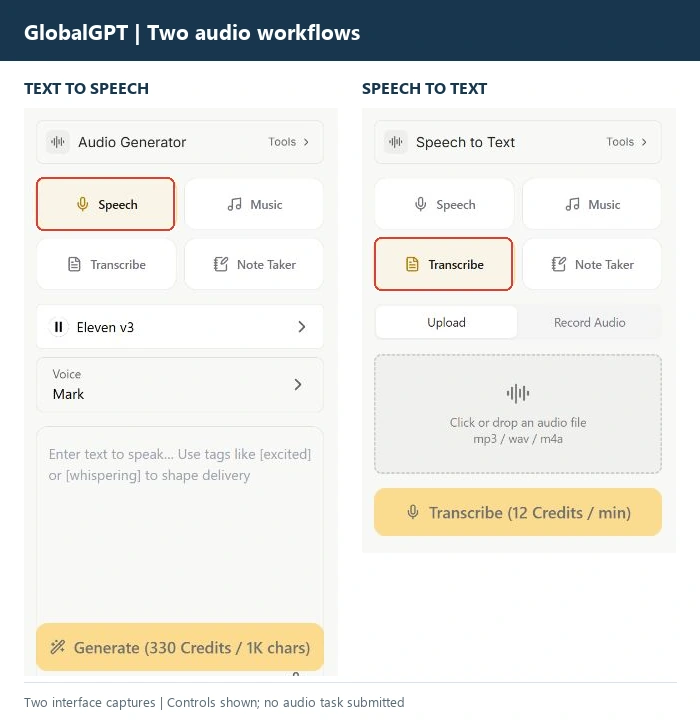
สิ่งนี้ช่วยให้ทีมมีจุดเริ่มต้นที่คล้ายกัน เมื่อเป้าหมายคือการเพิ่มเสียงหรืองานเสียง โดยไม่ต้องเปิดบัญชีผู้ให้บริการแยกต่างหากสำหรับแต่ละโมเดล คุณสามารถสำรวจ กระบวนการทำงานของโมเดล AI แบบครบวงจร, แล้วเลือกว่างานปัจจุบันของคุณต้องการการสนทนา การถอดเสียง การบรรยาย หรือการสร้างเนื้อหา.
นี่เป็นการเปรียบเทียบฟังก์ชันที่คล้ายกัน ไม่ใช่การยืนยันความเข้ากันได้ หน้าสาธารณะของ GlobalGPT ไม่สามารถพิสูจน์ได้ว่าการตั้งค่าคำขอ GPT-Live, จุดปลายทาง, กระแสเหตุการณ์ หรือการมอบหมายระบบหลังบ้านของ OpenAI สามารถคัดลอกมาใช้ได้โดยไม่มีการเปลี่ยนแปลง โปรดตรวจสอบแคตตาล็อกโมเดลและสนามคำขอของงานที่เลือกไว้ก่อนที่จะสร้างการบูรณาการอัตโนมัติ.
สำหรับการเปรียบเทียบด้านการสร้างเสียง ดนตรี และการออกแบบเสียง บทรีวิวของเราเกี่ยวกับ Eleven Multilingual v2, Seed Audio 1.0, และ ตัวเลือกแบบจำลองเสียง มีวัตถุประสงค์ที่แตกต่างกัน ตัวแทนเสียงและตัวสร้างเสียงไม่ควรถูกประเมินด้วยเกณฑ์การทดสอบเดียวกัน.
ใครควรใช้ GPT-Live 1?
เลือก GPT-Live 1 เมื่อผลิตภัณฑ์ของคุณต้องการให้ผู้ใช้พูดอย่างเป็นธรรมชาติ สามารถขัดจังหวะผู้ช่วยได้ และได้รับความช่วยเหลือจากระบบหลังบ้านในขณะที่การสนทนายังคงดำเนินต่อไป การจัดลำดับความสำคัญในการสนับสนุนลูกค้า การเปลี่ยนแปลงนัดหมาย การช่วยเหลือด้านการเดินทาง แบบฟอร์มที่มีคำแนะนำ และการดำเนินงานภายในองค์กร เป็นตัวอย่างของสถาปัตยกรรมที่เหมาะสม เมื่อคุณสามารถกำหนดสิทธิ์การใช้งานเครื่องมือและสถานะของงานได้อย่างชัดเจน.
เลือก Realtime เมื่อคุณต้องการใช้โมเดลการควบคุมเซสชัน/เหตุการณ์ของมัน และพร้อมที่จะรับผิดชอบส่วนโครงสร้างพื้นฐานของการสนทนาได้มากขึ้น เลือกใช้ระบบสแต็กแบบต่อกัน (chained stack) เมื่อการถอดเสียง การวิเคราะห์ และการสร้างคำพูดต้องสามารถสลับกันทำงานได้อย่างอิสระ หรือทำงานแบบไม่พร้อมกัน.
ควรพิจารณาใช้ GlobalGPT เมื่อคุณต้องการเข้าถึงกระบวนการทำงานด้านเสียงและ AI หลายอย่างในที่เดียว หรือเมื่อต้องการเปรียบเทียบเครื่องมือด้านเสียงก่อนที่จะเลือกสถาปัตยกรรมตัวแทนสดที่เฉพาะเจาะจงของผู้ให้บริการ เริ่มต้นด้วยงานเล็กๆ ที่ไม่มีความสำคัญสูง ตรวจสอบโมเดลและเส้นทางคำขออย่างละเอียด และวัดค่าความล่าช้าและคุณภาพผลลัพธ์ด้วยตัวเอง.
ก่อนการผลิต การทดสอบการหยุดชะงัก การแก้ไขสั้นๆ ไมโครโฟนที่มีเสียงรบกวน คำศัพท์เฉพาะด้าน ความล้มเหลวของเครื่องมือ การขอสิทธิ์ และผู้ใช้ที่เปลี่ยนใจในขณะที่ระบบหลังบ้านยังทำงานอยู่ กรณีเหล่านี้เป็นตัวกำหนดว่าตัวแทนเสียงจะได้รับความไว้วางใจหรือไม่.
หากต้องการข้อมูลเพิ่มเติมเกี่ยวกับการเลือกระหว่างกระบวนการทำงานด้านเสียง เพลง และการบรรยาย โปรดดู การเปรียบเทียบแบบจำลองเสียง. หากต้องการเปรียบเทียบหลายกลุ่มรุ่นโดยไม่ต้องจัดการการสมัครสมาชิกแยกกัน, ภาพรวม API ของ GlobalGPT คือขั้นตอนต่อไปที่ปฏิบัติได้จริง.
คำถามที่มักถูกถาม
GPT-Live 1 คืออะไร?
GPT-Live 1 เป็นโมเดลเสียงแบบเต็มดูเพล็กซ์ของ OpenAI ที่ออกแบบมาสำหรับการสนทนาแบบเรียลไทม์ มันสามารถฟังได้ในขณะที่กำลังพูด และสามารถมอบหมายงานการวิเคราะห์หรือการใช้เครื่องมือให้กับโมเดลหรือเอเจนต์ด้านหลังได้.
GPT-Live 1 มีราคาเท่าไร?
OpenAI คิดค่าบริการเซสชันเสียงที่ $0.05 ต่อนาที โดยคิดค่าบริการตามวินาที ส่วนการใช้โมเดลแบ็กเอนด์และการเรียกใช้เครื่องมือจะถูกคิดค่าบริการแยกต่างหาก.
GPT-Live 1 นั้นเหมือนกับ Realtime API หรือไม่?
ไม่ครับ ทั้งสอง API นี้ให้บริการสำหรับกรณีการใช้งานเสียงสดที่คล้ายกัน แต่มีโมเดลเซสชัน โมเดลการจับมือ และโมเดลเหตุการณ์ที่แตกต่างกัน ให้เลือก API ที่มีโมเดลการควบคุมตามที่ระบุในเอกสาร ซึ่งเหมาะสมกับแอปพลิเคชันของคุณ.
GPT-Live 1 รองรับการเรียกฟังก์ชันหรือไม่?
หน้าตัวอย่างระบุว่ามีการสนับสนุนการเรียกฟังก์ชัน แอปพลิเคชันของคุณยังคงดำเนินการเรียกฟังก์ชันที่ได้รับอนุญาต และตรวจสอบสิทธิ์ การยืนยัน และการพึ่งพา.
GPT-Live 1 สามารถทำงานได้หรือไม่เมื่อผู้ใช้ขัดจังหวะ?
ใช่ครับ เอกสาร OpenAI อธิบายถึงการสนทนาแบบ full-duplex และระบุว่างานด้านหลังระบบสามารถดำเนินต่อไปได้แม้ผู้เรียกจะขัดจังหวะ การตัดสินใจว่าจะเสร็จสิ้นหรืองดงานนั้นขึ้นอยู่กับแอปพลิเคชันของคุณ.
GPT-Live 1 รองรับผลลัพธ์ที่มีโครงสร้างหรือไม่?
หน้าแบบจำลองระบุว่าผลลัพธ์ที่มีโครงสร้างนั้นไม่ได้รับการสนับสนุน ให้ใช้การตรวจสอบความถูกต้องของ JSON หรือ schema อย่างเคร่งครัดในขั้นตอนการทำงานของระบบหลังบ้านแทน.
GlobalGPT มีเวอร์ชันที่เทียบเท่ากับ GPT-Live 1 หรือไม่?
GlobalGPT มีเครื่องมือเสียงที่คล้ายกันสำหรับการแปลงข้อความเป็นเสียง (text-to-speech), การแปลงเสียงเป็นข้อความ (speech-to-text), การบันทึกเสียง, การอัปโหลด และการถอดความ หน้าสาธารณะของระบบนี้ไม่ตรวจสอบว่ามีการเชื่อมต่อแบบ full-duplex ของ GPT-Live ที่ตรงกัน หรือจุดปลายทางแบบสดที่รองรับ OpenAI.
ผมควรเลือก GlobalGPT หรือ OpenAI เลยดีไหม?
เลือก OpenAI โดยตรงเมื่อคุณต้องการสถาปัตยกรรมเซสชันและการมอบหมายงานที่ได้รับการบันทึกไว้ของ GPT-Live พิจารณา GlobalGPT เมื่อคุณต้องการทดลองใช้งานเวิร์กโฟลว์ด้านเสียงและ AI หลายรูปแบบในแพลตฟอร์มเดียว ตรวจสอบเส้นทางโมเดล พารามิเตอร์ และราคาอย่างละเอียดก่อนขยายขนาด.
ลองใช้กระบวนการทำงานด้านเสียงที่กว้างขึ้น
ลองสำรวจเครื่องมือเสียงและแคตตาล็อกโมเดลของ GlobalGPT เมื่อคุณต้องการเปรียบเทียบระบบการวิเคราะห์เสียง การแปลงเสียงเป็นข้อความ และกระบวนการทำงานของ AI อื่นๆ ก่อนที่จะตัดสินใจใช้ชุดเครื่องมือของผู้ให้บริการรายใดรายหนึ่ง.



