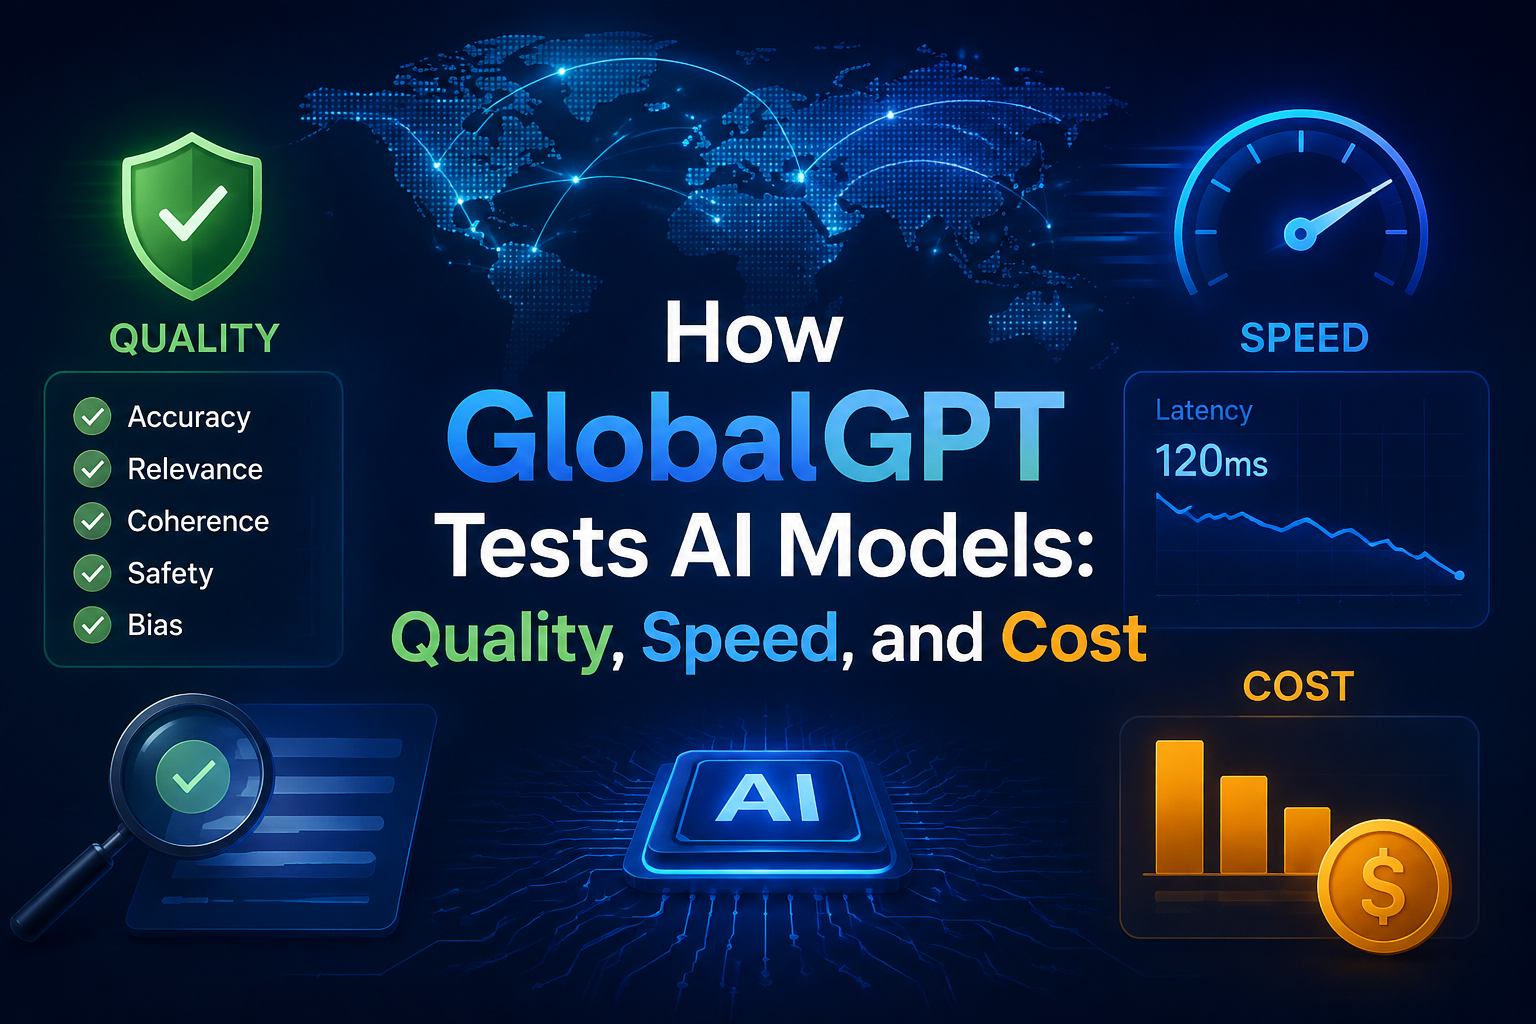
Сравнение моделей начинается с конкретной задачи: что мы запрашивали и соответствовал ли результат поставленным требованиям? Мы тестируем модели ИИ на GlobalGPT с помощью командной строки GlobalGPT. Исключения указаны в соответствующей статье.
ИИ проверяет результаты на наличие ошибок и соответствие заданному промту. Если результаты проходят эти проверки, мы сравниваем скорость, цену и использование токенов (если применимо). Авторы также оценивают субъективные качества, такие как стиль изложения и визуальная привлекательность. Оценка аудиоматериалов осуществляется исключительно с помощью ИИ на базе Gemini 3.6 Flash.
Мы — это Группа по проверке GlobalGPT, входящая в состав GlobalGPT. Эта методология охватывает тесты, которые мы публикуем в блоге при выпуске новых моделей, а также сравнительные обзоры моделей. В исследовательских отчетах, основанных на данных пользователей GlobalGPT, дается разъяснение используемых наборов данных и методов анализа.
Наша тестовая среда: GlobalGPT CLI
CLI GlobalGPT является нашей тестовой средой по умолчанию. Тесты, в которых используются другие интерфейсы, маршруты API или средства написания кода на языке программирования, следует рассматривать в соответствующем контексте. Названия моделей, доступные настройки, инструменты и права доступа могут различаться в зависимости от среды.
Модель, генерирующая выходные данные, и ИИ, оценивающий их, выполняют разные роли. Оценка оценивающего механизма является свидетельством о возвращаемых выходных данных; она не определяет, как тестируемая модель работает изнутри.
Разработка заданий: подсказки, входные данные и требования
Мы задаем моделям конкретные задачи с четко сформулированными требованиями. Задание по написанию текста может предполагать составление резюме, основанного исключительно на предоставленных заметках. Задание по программированию может предполагать создание функции, обрабатывающей пустой входной параметр. Задание, связанное с изображением, может предполагать точную формулировку текста на плакате.
Для сравнения: промпт и исходные данные определяют, какую задачу предстоит выполнить каждой модели. Различия в поддерживаемых форматах, настройках или доступных инструментах имеют значение при интерпретации результатов. Сравнение фиксированных промптов и учебное руководство, в котором промпт совершенствуется в ходе нескольких попыток, дают ответы на разные вопросы.
Оценка результатов: ошибки, рекомендации и эффективность
Ошибки и своевременное выполнение указаний
ИИ оценивает, соответствует ли результат поставленной задаче и содержит ли он очевидные ошибки. Соответствующие проверки могут включать в себя выявление неверных вычислений, необоснованных утверждений, отсутствующих полей или несоблюдения требуемого формата.
Результат «Пройден» означает, что в ходе проведенных проверок ошибок обнаружено не было. Это не гарантирует, что результат не содержит ни одной возможной ошибки. Эксперты по искусственному интеллекту могут упустить ошибки или вынести неверные суждения.
Доказательства исполнения являются отдельной частью оценки. В нашем Тест плана программирования Кими, за сгенерированным кодом следовали пять локальных проверок. Чтение кода, запрос к модели на проверку собственного ответа и запуск тестов дают разные подтверждения.
Скорость, цена и использование токенов
Как только результат соответствует требованиям задачи, эффективность помогает выделить наиболее подходящие варианты. Быстрый ответ, в котором отсутствует необходимый расчёт, не считается выполнением задачи в той же степени, что и правильный ответ.
| Мера | Как читать эту книгу |
|---|---|
| Время | Проверьте окно измерения. Время от запроса до завершения включает в себя время прохождения по маршруту и время обработки; это не обязательно соответствует задержке модели на стороне поставщика. |
| Использование токенов | Используйте категории, возвращаемые сервисом. Отсутствие данных о входных и выходных данных, данных из кэша или токенов рассуждений не означает, что они не используются. |
| Стоимость | Необходимо проводить различие между зафиксированными суммами списаний или зачислений по формуле GlobalGPT и расчетными значениями, основанными на ценах, указанных в API поставщика. Еще одним показателем являются абонентские сборы. |
| Создание медиафайлов | Учтите настройки вывода данных, а также применимые скидки или плату за каждый вывод данных. Данные о количестве токенов могут быть недоступны или не иметь практического значения. |
В предварительной оценке стоимости должна быть указана основа для расчёта. Кредиты нельзя конвертировать в доллары без подтверждённого правила конвертации, а одно лишь поле ответа с нулевым значением не является доказательством того, что запрос был бесплатным.
Оценка автора по субъективным заданиям
Авторы также сравнивают результаты в тех случаях, когда предпочтения влияют на полезность. В случае текстов или изображений это может означать объяснение того, какой результат отличается более ясным языком, более удобной для чтения версткой или композицией, которая лучше соответствует заданию.
Наш сайт Сравнение Seedream 5.0 Pro и GPT Image 2 показывает пары изображений, относящихся к конкретным задачам. Наглядные формулировки и верстка дают читателям возможность оценить не только предпочтения автора. Эстетические предпочтения остаются отдельным вопросом по сравнению с объективно проверенными требованиями.
Оценка звука с использованием ИИ на базе Gemini 3.6 Flash
Наши оценки качества звучания проводятся исключительно с помощью искусственного интеллекта. Для анализа фактического звучания мы используем Gemini 3.6 Flash. Речь идет об оценках, полученных с помощью искусственного интеллекта, а не о результатах тестирования, проведённого группой экспертов-слушателей.
Оценка зависит от поставленной задачи: анализируются речь, язык, звуковые явления, временные параметры или музыкальная структура. Наша Обзор Seed Audio 1.0 включает в себя сгенерированный аудиоматериал и анализ с помощью искусственного интеллекта контента, событий, временных параметров и артефактов.
Свойства файла, такие как формат и продолжительность, не связаны с оценкой содержания. Наличие аудиодорожки не доказывает правильность указанных слов или звуков. Любую опубликованную партитуру необходимо рассматривать с учетом критериев оценки и аудиозаписи, которую она описывает.
Как интерпретировать даты тестирования, условия и результаты тестирования
Подробные результаты тестирования следует приводить в самой статье. Полезный контекст включает:
- Дата тестирования, идентификатор модели и условия тестирования.
- Задание, инструкция, исходные материалы и требуемый результат.
- Доступные настройки, количество попыток и соответствующие изменения.
- Эксперт, проведенные проверки и обоснование выбора автора.
- Фактические результаты или выдержки из них, скриншоты или мультимедийные материалы, а также имеющиеся данные о сроках, использовании и затратах.
Данные в различных статьях и старых тестах различаются. Отсутствующие измерения невозможно восстановить как наблюдаемые факты. В разделе «Блог и руководства» на странице коллекции моделей приведены ссылки на соответствующие обзоры и данную методологию; полные формулировки задач и результаты вывода сохранены в статьях блога.
Интерпретация повторных попыток, неудачных запросов и исправлений
Первый результат, выбранный результат и исправленная попытка дают читателям разную информацию. Важна история попыток, связанных со статьёй, включая технические сбои, пустые ответы, усеченные ответы, а также изменения в запросах или настройках.
Даже завершенный запрос может вернуть непригодный для использования ответ. Неудачный запрос может выявить проблему в тестируемом маршруте, не указывая при этом на общие недостатки модели. В наших статьях используются разные области тестирования; за каждым результатом не стоит какого-то универсального количества прогонов или процедуры слепого тестирования.
Что можно и чего нельзя узнать из результатов выполнения задачи
Результат подтверждает вывод в отношении тестируемой задачи, модели, даты и условий. Небольшие наборы задач и отдельные измерения времени не позволяют составить универсальный рейтинг производительности. Если в ходе сравнения проверялась только одна сторона, эти данные не могут служить основанием для определения победителя среди обеих моделей.
Официальные технические характеристики, результаты внешних тестов, предыдущие испытания и собственные выводы автора статьи служат различными видами доказательств. Любой результат зависит от заявленной шкалы оценки, весовых коэффициентов и исключений. Читатели должны иметь возможность соотнести вывод с имеющимися доказательствами, включая частичные или неудовлетворительные результаты.
Чем обновления статей отличаются от повторного тестирования моделей
Как правило, мы проводим рецензирование статей каждые две–четыре недели, как указано в нашем Редакционные стандарты. Проверка содержимого не означает, что каждое тестирование модели было выполнено заново.
Обновление цены, исправление оценки существующего результата и формирование нового результата — это отдельные действия. Исторические данные остаются привязанными к исходному контексту тестирования; сама по себе более поздняя дата обновления статьи не делает их новыми результатами тестирования.