
Сайт OpenAI — API для распознавания речи преобразует текст в аудиозапись посредством ПОСТ https://api.openai.com/v1/audio/speech. Отправьте модель, вводной текст и голос; сохраните ответ в формате MP3 или в другом поддерживаемом аудиоформате. Если речь идет о новой интеграции, для которой требуются инструкции по интонации и манере речи, начните с gpt-4o-mini-tts.
Рабочий запрос — это лишь первый шаг. Вам также понадобятся правильная единица расчета, готовый к воспроизведению выходной файл и план для длинных сценариев. В новой модели TTS от OpenAI для расчета стоимости используются текстовые и аудиотокены, тогда как в старых моделях TTS — символы. Это различие имеет значение при расчете стоимости месячного объема озвучивания.
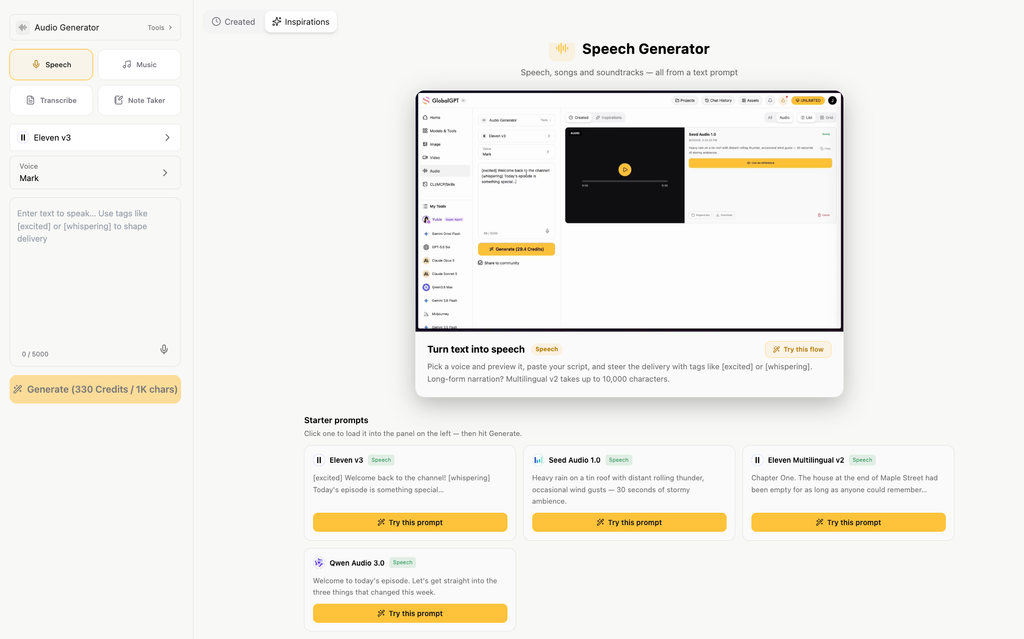
Если в ваши обязанности также входит написание сценария, создание визуальных элементов и монтаж видео, Аудиорабочая среда GlobalGPT превращает генерацию речи в доступную мультимодельную платформу на основе подписки. Вы можете работать с текстом, голосом, изображениями и видео в одной панели управления, а затем использовать API и CLI для автоматизации производственных процессов. Общедоступный API TTS использует отдельный рабочий процесс, который описан ниже.
Для чего предназначен аудио-речевой API OpenAI?
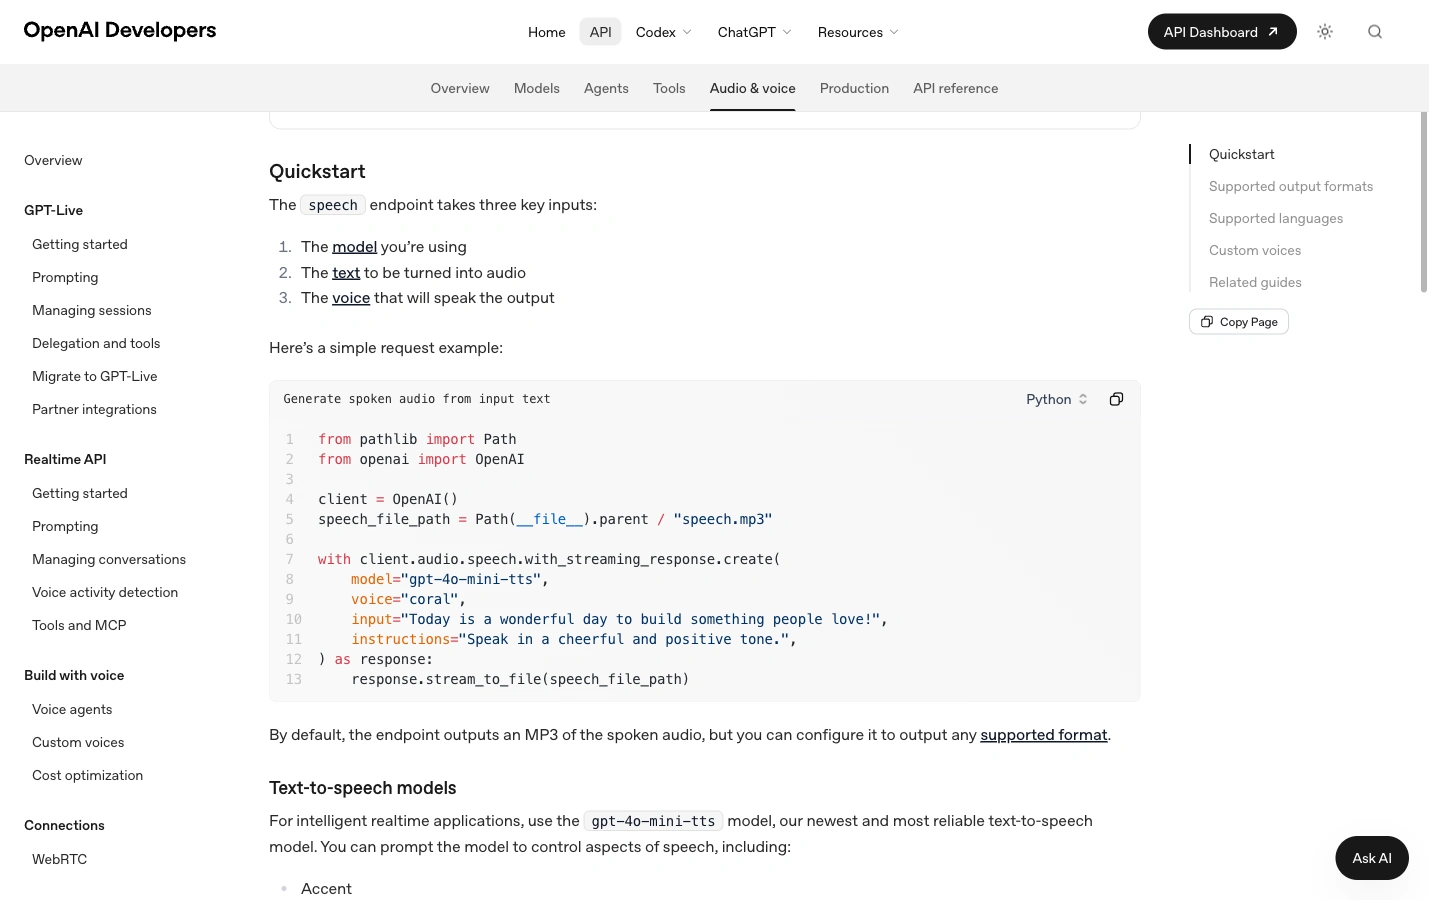
Speech API — это конечная точка преобразования текста в речь: ваше приложение передает текстовые данные и получает сгенерированную речь. Типичные области применения включают инструкции по использованию продуктов, озвучивание для обеспечения доступности, учебные материалы и короткие дикторские комментарии. Вы можете контролировать текст перед его озвучиванием, что особенно полезно в тех случаях, когда формулировки должны соответствовать утвержденному сценарию.
При транскрипции направление процесса меняется на противоположное: входными данными служит записанный аудиофайл, а на выходе получается текст. Голосовой помощник, работающий в режиме реального времени, предъявляет ещё одно требование — умение слушать и отвечать в ходе диалога. OpenAI’s аудиозаписи разделяет эти рабочие процессы. Выберите конечную точку «Речь», если у вас уже есть текст, который нужно прочитать вслух.
Функция генерации речи поддерживает потоковую передачу, поэтому приложение может получать аудио фрагментами. Сохранение этого потока в файл не приводит к его автоматическому воспроизведению в браузере или созданию диалогового агента; воспроизведение и вся логика ведения диалога по-прежнему остаются в ведении вашего приложения. Кроме того, OpenAI требует четкого уведомления слушателей о том, что голос сгенерирован искусственным интеллектом.
Создайте свой первый аудиофайл с помощью Speech API OpenAI
Запустите запрос на сервере или на вашем рабочем компьютере, указав ключ API OpenAI, сохраненный в файле OPENAI_API_KEY переменная среды. Не используйте этот ключ в JavaScript браузера. В приведенных ниже примерах используется один и тот же короткий скрипт для ознакомления с продуктом, а результат сохраняется как openai-product-tour.mp3.
Вариант 1: отправить запрос с помощью curl
OpenAI Speech API · curl
#!/bin/sh
# Сначала задайте переменную OPENAI_API_KEY в настройках вашего сервера.
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Добро пожаловать на обзор продукта Acorn Studio. За три шага вы сможете превратить короткий сценарий в аудиогид. Сначала напишите текст. Затем выберите голос. Наконец, сохраните аудиофайл и проверьте воспроизведение на своём телефоне.",
    "voice": "coral",
    "instructions": "Говорите чётко, тёплым, разговорным тоном.",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
Ответ содержит аудиобайты, поэтому лучше сохраните его в файл, а не пытайтесь анализировать его как JSON. --fail-with-body Этот параметр возвращает curl код завершения с ошибкой в случае HTTP-ошибки. Проверьте этот код перед открытием файла: даже при ошибке в файле с именем .mp3.
Вариант 2: использовать SDK для Python
Установите пакет OpenAI с помощью команды python -m pip install openai. SDK считывает ключ API из переменных среды. В этом примере ответ записывается по мере его поступления, что позволяет избежать загрузки всего аудиоответа в собственный буфер Python.
OpenAI Speech API · Python
"""Установка: python -m pip install openai. Задайте переменную OPENAI_API_KEY на сервере."""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Добро пожаловать на обзор продуктов Acorn Studio. За три шага вы сможете превратить "
    "короткий сценарий в аудиогид. Сначала напишите текст. Затем "
    "выберите голос. Наконец, сохраните аудиофайл и проверьте воспроизведение на своём телефоне."
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="Говорите чётко, тёплым, разговорным тоном.",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("Сохранён файл openai-product-tour.mp3")
Три основные области — это модель, ввод, и голос. Здесь, инструкции требует теплой, разговорной манеры речи; она направляет интонацию, а не добавляет слова к текстовому сценарию. Эта область работает с GPT-4o Mini TTS и не поддерживается tts-1 и tts-1-hd.
Если документ объёмный, разбивайте текст по границам предложений или абзацев, пронумеруйте фрагменты и сохраняйте каждую часть под соответствующим номером. Сохраняйте единый стиль и инструкции во всех фрагментах. Оставляйте достаточно контекста для естественного построения фраз и прослушивайте места соединения перед рассылкой готовой записи.
Выберите модель, голос и формат вывода
| Модель | Как выбрать | Инструкции по доставке |
|---|---|---|
gpt-4o-mini-tts | Отправная точка для управляемого повествования и устной речи. | Поддержка инструкции с точки зрения тона, стиля и темпа. |
tts-1 | OpenAI позволяет использовать эту модель для генерации речи с меньшей задержкой. | Используйте поддерживаемые функции голосового управления и регулировки скорости; пропустите инструкции. |
tts-1-hd | Модель OpenAI обеспечивает более высокое качество речи по сравнению с TTS-1. | Используйте поддерживаемые функции голосового управления и регулировки скорости; пропустите инструкции. |
Сайт Страница модели GPT-4o Mini TTS сопоставляет псевдоним модели с gpt-4o-mini-tts-15 декабря 2025 г. моментальный снимок. Если для вашего приложения важно, чтобы поведение было воспроизводимым, тщательно выбирайте задокументированный моментальный снимок и сохраняйте его вместе с сохраненными скриптами.
Встроенные голоса и ограничения ввода
В справочнике по API Speech перечислены 13 встроенных голосов для GPT-4o Mini TTS: сплав, пепел, баллада, коралл, эхо, сказка, оникс, нова, шалфей, мерцание, стихотворение, марин и кедр. OpenAI рекомендует Марин или кедр для достижения наилучшего качества. Такова рекомендация OpenAI: выбирайте голос для озвучивания, прослушивая, как звучат ваши собственные имена, цифры и синтаксические конструкции.
Более ранние модели TTS поддерживают меньший набор: alloy, ash, coral, echo, fable, onyx, nova, sage и shimmer. Не стоит полагать, что каждый голос работает со всеми моделями. Справочник по Speech API также допускает скорость в диапазоне от 0,25 и 4,0, с 1.0 в качестве значения по умолчанию.
Необходимо учитывать два предела входных значений: контрольные пределы конечных точек ввод на 4 096 символов, а на странице модели Mini TTS указан максимальный размер 2 000 входных токенов. Символы и токены — это разные единицы измерения. Проверяйте оба ограничения для Mini TTS, особенно при работе с многоязычным текстом, и разбивайте объемные сценарии на части перед отправкой.
Выберите формат файла для конечного результата
| Формат | Практическое применение |
|---|---|
| MP3 | Выходной файл по умолчанию — удобный сжатый файл для обмена и воспроизведения в Интернете. |
| Опус | Полезно для приложений потоковой передачи данных и общения, поддерживающих данный кодек. |
| AAC | Подумайте, в каких случаях ваша среда воспроизведения или рабочий процесс с мультимедиа требуют использования формата AAC. |
| FLAC | Сжатие без потерь для рабочих процессов, в которых необходимо сохранить аудиосигнал. |
| WAV | Несжатый аудиофайл в привычном формате для редактирования и обработки. |
| PCM | Необработанные образцы с частотой дискретизации 24 кГц, разрядностью 16 бит, со знаковым значением и порядком байтов «little-endian», без заголовка файла; вашему плееру необходимы именно такие настройки. |
Начните с формата MP3, если вам нужна ссылка для скачивания или простой аудиоплеер. Выберите формат WAV, если следующим шагом будет редактирование. Выбирайте формат «raw PCM» только в том случае, если ваше приложение умеет его интерпретировать; изменение имени файла с .pcm на .wav не создает заголовок WAV.
Сколько стоит API OpenAI Speech?
По данным на 28 сентября 2026 года в списке OpenAI указана модель GPT-4o Mini TTS по цене $0,60 за миллион текстовых токенов ввода плюс $12 на миллион токенов аудиовыхода. Стоимость TTS-1 $15 за миллион символов, а стоимость TTS-1 HD составляет $30 за миллион символов. Рассчитайте каждую модель в своих собственных единицах измерения.
Цены на Speech API: не смешивайте единицы измерения
Модель OpenAI рассчитывается по токенам, а две более ранние модели TTS — по символам. Модель GlobalGPT рассчитывается за задачи TTS в кредитах.
| Маршрут и модель | Оценить | Пример |
|---|---|---|
| OpenAI · GPT-4o Mini TTS | $0.60 / 1 млн токенов текстового ввода $12 / 1M токенов аудиовыхода | $0.0606 для 1 000 токенов входного текста + 5 000 токенов выходного аудио |
| OpenAI · TTS-1 | $15 / 1M символов | $0.015 за 1 000 символов |
| OpenAI · TTS-1 HD | $30 / 1 млн символов | $0.030 за 1 000 символов |
| GlobalGPT · Eleven v3, Eleven Multilingual v2 или Qwen Audio 3.0 TTS Flash | 330 кредитов / 1 000 символов | 330 кредитов по указанной ставке за 1 000 символов; перед отправкой запросите предварительный расчет стоимости |
Это примеры расценок, а не стоимость приведенных ниже аудиофрагментов. Токены, символы, минуты и кредиты — это разные единицы измерения. В смете по заданию GlobalGPT указано соответствующее количество кредитов; в таблице кредиты не пересчитываются в доллары.
Цены проверены 28 сентября 2026 года. Источники: Цены на API OpenAI и Документация по API GlobalGPT.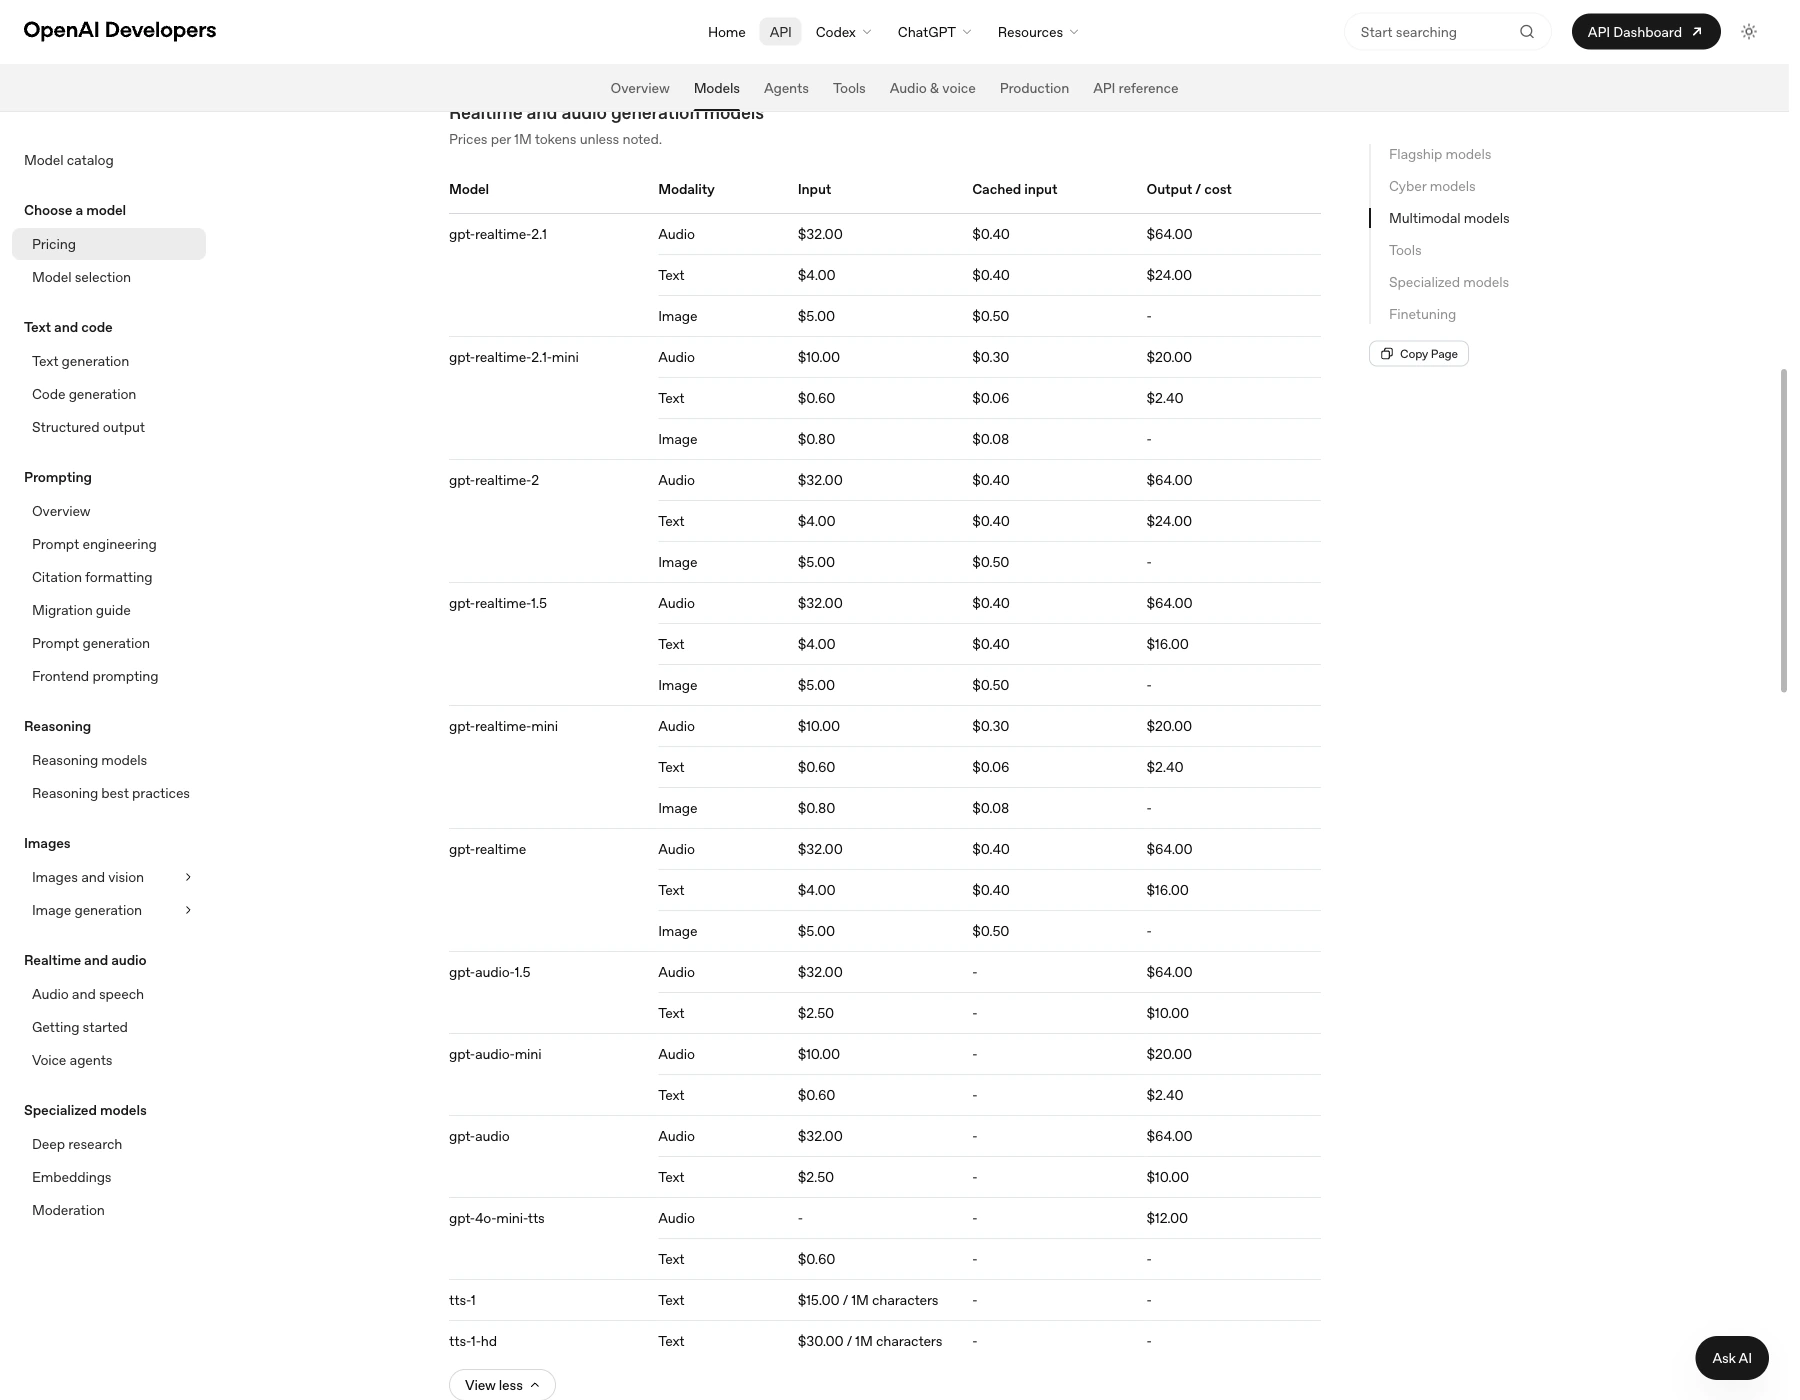
Например, 100 сценариев по 1 000 символов каждый составляют в общей сложности 100 000 символов. По указанным тарифам это составляет $1.50 с TTS-1 или $3.00 с TTS-1 HD, до учета прочих затрат на разработку приложения. Одного лишь количества символов недостаточно для точного расчета стоимости услуги Mini TTS: необходимо знать количество токенов входного текста и выходного аудио.
Рассчитайте стоимость генерации речи
Введите единицы измерения, в которых осуществляется тарификация по выбранному вами маршруту. Автоматического преобразования символов в токены или минут в токены не происходит.
Формула: количество символов × $15 ÷ 1 000 000. Общий объем текста может охватывать несколько запросов API.
Цены проверены 28 сентября 2026 года: OpenAI · GlobalGPT. Не включает расходы на хранение, хостинг, налоги и другие компоненты вашего приложения.
При планировании введите в калькулятор фактические показатели использования или явные допущения. Пока вы не измерили объем использования, рассматривайте поле «Аудиотокены Mini TTS» как бюджетный показатель. Не превращайте приблизительную стоимость за минуту в гарантированную цену для каждого голоса, темпа речи или языка.
В каталоге моделей GlobalGPT цены на услуги TTS указаны в кредитах, а конечный результат расчета предоставляет оценку стоимости запроса, который вы планируете отправить. Не следует смешивать расходование кредитов API с выбором подписки на мультимодельное рабочее пространство, предназначенного для повседневной работы с текстами и мультимедиа. Это упрощает контроль над бюджетом, поскольку позволяет не предполагать, что эти два продукта используют один и тот же лимит для выставления счетов.
Создание рабочего процесса TTS с помощью API GlobalGPT
Для обеспечения воспроизводимого рабочего процесса «от сценария к озвучиванию к видео», создать речь в GlobalGPT и сохранить остальную часть проекта в той же рабочей области. API GlobalGPT раскрывает суть поколения медиа как набор задач, в то время как GlobalGPT CLI подключения, совместимые с вашим терминалом и инструментами разработки.
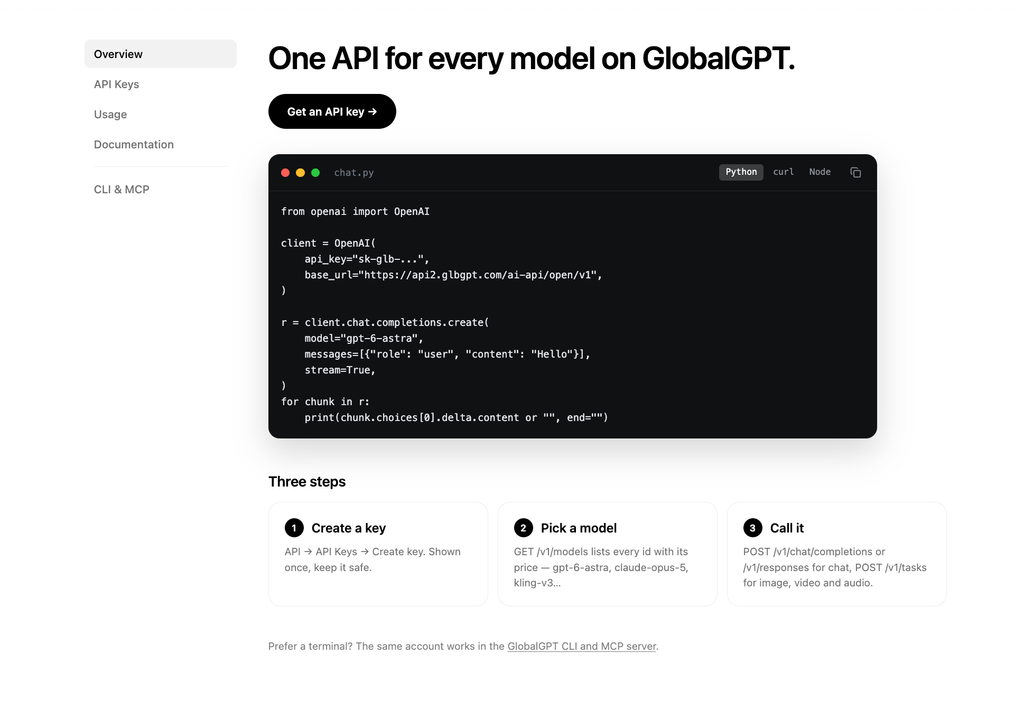
Используйте URL общедоступной базы данных https://api2.glbgpt.com/ai-api/open/v1. Отправляйте запросы на преобразование текста в речь на POST /tasks, запрос GET /tasks/{id}, и скачать output.url после успешного выполнения задачи. Поле ввода — это подсказка. Реализуйте этот контракт задачи напрямую; он отличается от немедленного аудиоответа OpenAI.
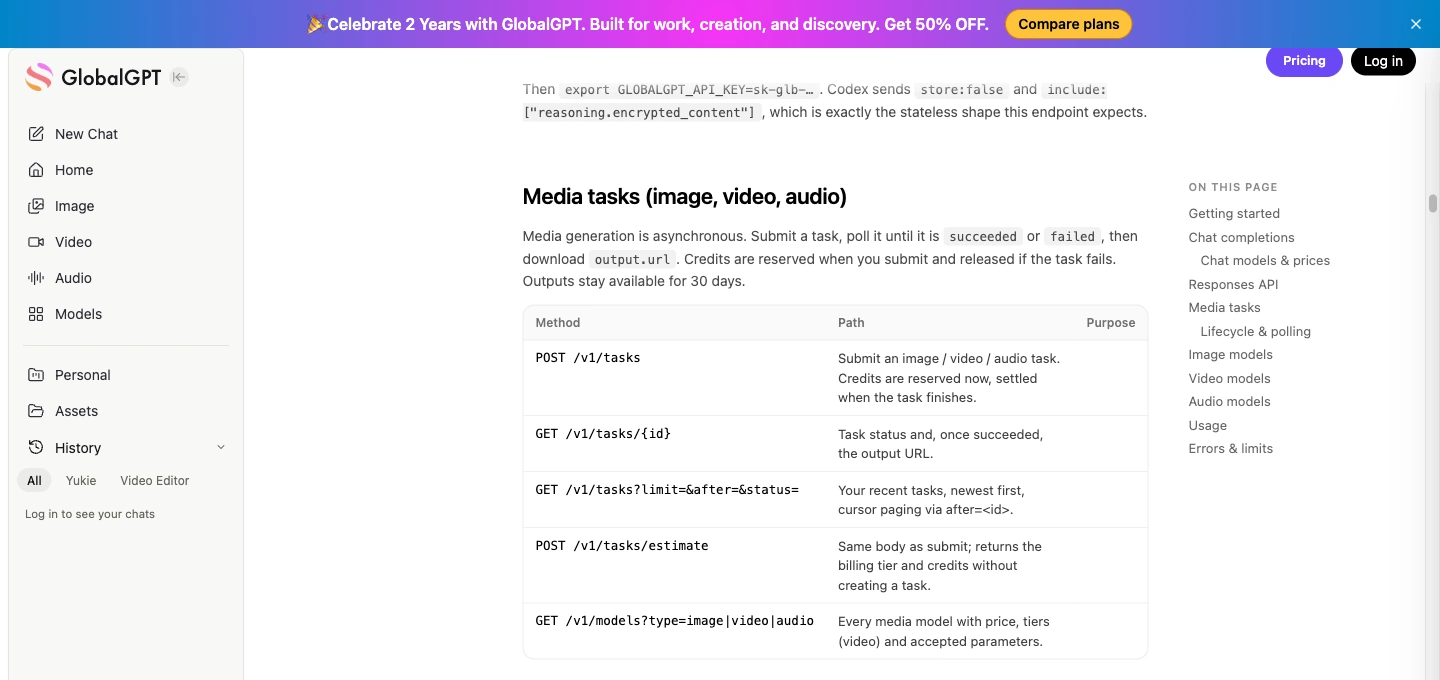
Выберите модель TTS GlobalGPT, для которой имеется документация
| Идентификатор модели | Вход и выход | Полезное разграничение |
|---|---|---|
eleven-v3 | До 5 000 символов; MP3 | Поддерживает расширенные аудио-теги. |
eleven-multilingual-v2 | До 10 000 символов; MP3 | 29 языков; аудио-теги воспроизводятся в виде текста. |
qwen-audio-3.0-tts-flash | До 4 096 символов; WAV | 49 голосов; для управления голосом и языком используются поля, специфичные для Qwen. |
Список всех трёх записей 330 кредитов за 1 000 символов. Используйте POST /tasks/estimate с заданным телом запроса для соответствующей сметы; согласно документации, при этом задача не создаётся и кредиты не резервируются. При использовании публичного API расходуются платные кредиты.
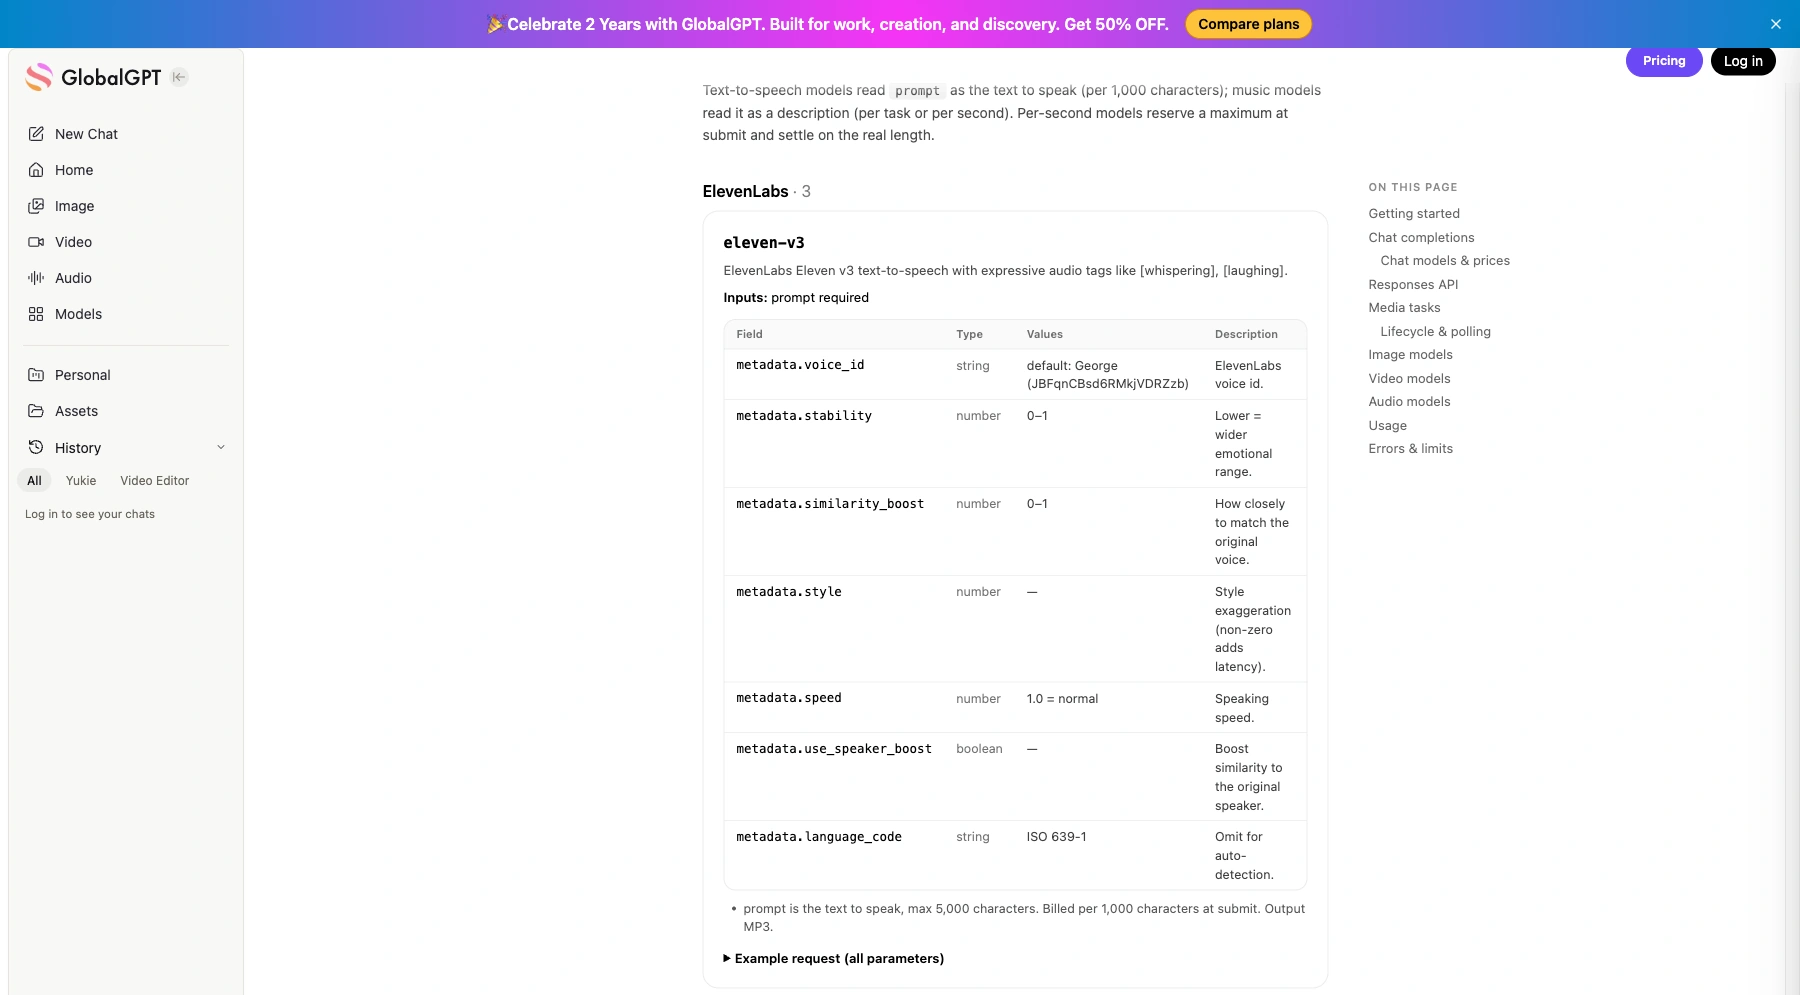
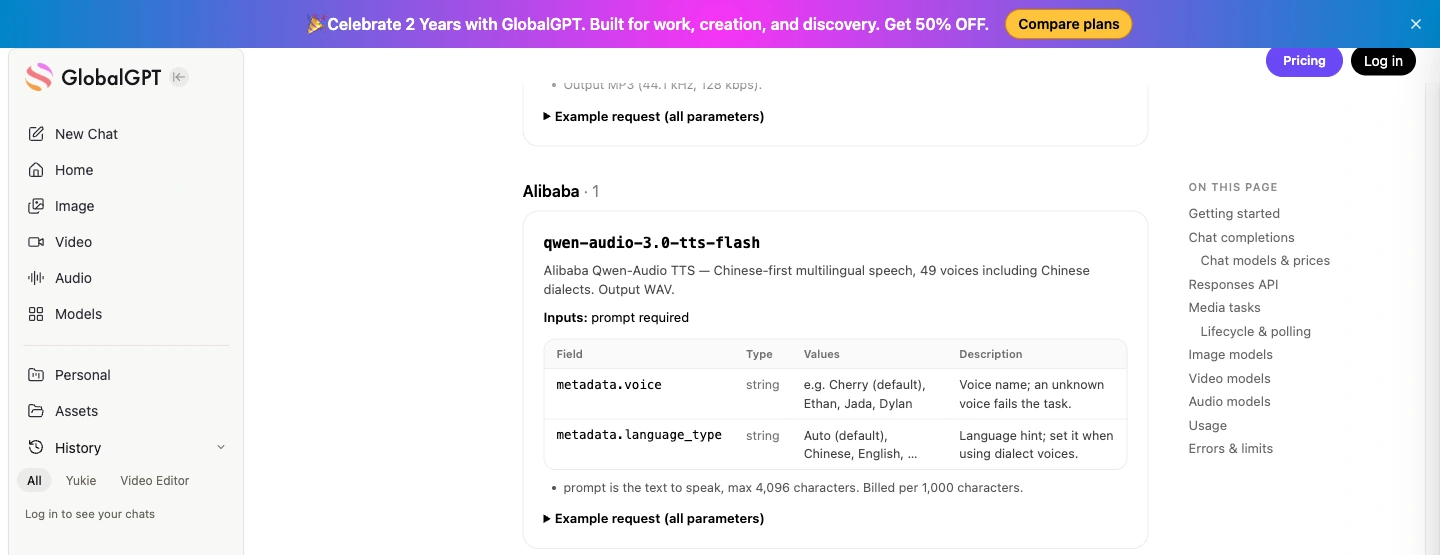
Что касается более общего рабочего процесса создания, см. Рабочие процессы преобразования текста в речь в GlobalGPT. Если вы изучаете отдельно названное семейство устройств с открытым исходным кодом Qwen3-TTS, ознакомьтесь с Модели Qwen3-TTS и варианты API; не следует рассматривать указанный выше идентификатор модели Qwen-Audio как взаимозаменяемый вариант развертывания Qwen3-TTS.
Составьте смету, отправьте её один раз, а затем проверьте статус сохраненной задачи
Установить запросы с python -m pip install requests и установить GLOBALGPT_API_KEY на сервере. В приведенном ниже примере используется Eleven v3, выбирается общедоступный голосовой идентификатор, описанный в документации, и устанавливается примерный лимит в 500 кредитов. Перед запуском измените этот лимит в соответствии со своим бюджетом.
API публичного задания TTS GlobalGPT · Python
"""Установка модуля requests; настройка переменной GLOBALGPT_API_KEY. Используется публичный API задач GlobalGPT."""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # Ваш лимит на одно задание; отредактируйте перед запуском.

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Добро пожаловать на обзор продукта Acorn Studio. Всего за три шага вы сможете превратить "
 "короткий сценарий в аудиогид. Сначала напишите текст. Затем "
 "выберите голос. И, наконец, сохраните аудиофайл и проверьте воспроизведение на своём телефоне."
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("Это задание относится к другому входу. Используйте новое имя файла состояния.")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("Расчетное количество кредитов:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("Оценка превышает ваш лимит на одно задание.")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # Сохраненный ключ связывает повторную попытку передачи данных именно с этим запросом.
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("Игнорируемые параметры:", task["ignored_parameters"])

print("Задача:", job["task_id"])
deadline = time.monotonic() + 600
пока time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
    print("Игнорируемые параметры:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("Ошибка генерации: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # Использовать новый запрос: не отправлять ключ API на медиа-хост.
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("Сохранено:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("Задача всё ещё находится в ожидании. Запустите снова, чтобы запросить ID сохранённой задачи.")
В файле задания сохраняются точный запрос, ключ идемпотентности и идентификатор задачи. Если соединение прервалось, запустите то же задание заново, чтобы код мог возобновить выполнение существующей задачи. Чтобы намеренно сгенерировать другой аудиофайл, используйте новое имя файла задания. Не разглашайте файл задания, если его скрипт содержит конфиденциальную информацию.
Проверьте игнорируемые_параметры Таким образом, неподдерживаемый параметр не станет по умолчанию вашей конфигурацией. Элементы управления ElevenLabs, такие как voice_id отличаются от Qwen голос и тип_языка поля. Проводить опрос каждые 5–10 секунд, обрабатывать не удалось состояние и незамедлительно сохранять файлы, обработка которых прошла успешно: согласно документации, срок хранения результатов составляет 30 дней.
Прослушайте два примера обзора продукта
В этих двух примерах, сгенерированных с помощью ИИ, используется один и тот же сценарий ознакомления с продуктом длиной 216 символов, обработанный с помощью Eleven v3 и Qwen Audio 3.0 TTS Flash. Каждый из них представляет собой первый результат одного запроса с настройками голоса по умолчанию. Вы получаете два коротких файла для просмотра и прослушивания; они не являются контролируемым сравнением сопоставимых голосов или тестом производительности голоса OpenAI.
Eleven v3: аудиосопровождение обзора продукта
eleven-v3 · пример обзора продукта
- Выход
- MP3 · моно · 44,1 кГц
- Длина
- Около 15,6 секунд
- Поколение
- Первый результат · 1 запрос
Настройки: приведенный ниже текст, голос по умолчанию и другие настройки; без переопределения голоса или указаний по произношению. Голосовая идентичность по умолчанию не была записана.
Статус и сроки: Генерация прошла успешно. Временные метки сервера показывают, что от момента отправки до завершения прошло 13 секунд; речь идет об одном запросе, а не о тесте на задержку.
Наблюдение за файлом: Файл MP3 содержит монофонический поток с частотой 44,1 кГц и занимает примерно 251 кБ. Его кадры можно считывать до самого конца файла.
Сведения о стоимости: Ставка по публичному каталогу составляет 330 кредитов за 1 000 символов. Для нового заказа используйте предварительную оценку стоимости; данная ставка не является счётом за образец.
Практическое применение: Компактный MP3-файл для прослушивания краткого обзора продукта. Перед использованием в релизе проверьте полный текст и воспроизведение на целевом устройстве.
Прочитать точный ввод · 216 символов
Добро пожаловать на обзор возможностей приложения Acorn Studio. Всего за три шага вы сможете превратить короткий текст в аудиогид. Сначала напишите текст. Затем выберите голос. И, наконец, сохраните аудиофайл и проверьте его воспроизведение на своём телефоне.
Qwen Audio 3.0 TTS Flash: аудиопрезентация продукта
qwen-audio-3.0-tts-flash · пример из обзора продукта
- Выход
- WAV · моно · 24 кГц
- Длина
- 15,52 секунды данных в формате PCM
- Поколение
- Первый результат · 1 запрос
Настройки: приведенный ниже текст, голос по умолчанию и другие настройки; без переопределения голоса или указаний по произношению. Голосовая идентичность по умолчанию не была записана.
Статус и сроки: Генерация завершилась успешно. Согласно временным меткам сервера, с момента отправки до завершения задачи прошло 17 секунд; речь идет об одном запросе, а не о тесте на задержку.
Наблюдение за файлом: Файл WAV содержит монофонический 16-битный сигнал PCM с частотой дискретизации 24 кГц и занимает примерно 745 кБ. В его заголовке указано больше данных, чем содержится в самом файле; здесь сохранен исходный вывод.
Сведения о стоимости: Ставка по публичному каталогу составляет 330 кредитов за 1 000 символов. Для нового заказа используйте предварительную оценку стоимости; данная ставка не является счётом за образец.
Практическое применение: Образец в формате WAV для оценки рабочего процесса озвучивания. Устраните несоответствие длины заголовка в вашем производственном конвейере и проверьте полноту воспроизведения перед распространением.
Прочитать точный ввод · 216 символов
Добро пожаловать на обзор возможностей приложения Acorn Studio. Всего за три шага вы сможете превратить короткий текст в аудиогид. Сначала напишите текст. Затем выберите голос. И, наконец, сохраните аудиофайл и проверьте его воспроизведение на своём телефоне.
Размер образца Qwen примерно в три раза превышает размер образца Eleven при аналогичной продолжительности, что обусловлено различиями между форматами WAV и MP3. Кроме того, в его заголовке WAV указано больше данных, чем физически содержится в файле. Это проблема упаковки файла, которую стоит проверить в вашем целевом проигрывателе; сама по себе она ничего не говорит о качестве голосовой записи.
Устранение типичных проблем при генерации речи
| Симптом | Что следует проверить в первую очередь |
|---|---|
| Сохраненный файл MP3 не воспроизводится | Проверьте статус HTTP и тип ответа. Возможно, ошибка API была сохранена с аудиорасширением. |
| Запрос отклоняет голосовую команду или инструкцию | Сопоставьте голос и дополнительные поля с выбранной моделью. Старые модели TTS OpenAI не поддерживают команды. |
| Длинный сценарий отклоняется | Проверьте ограничение по количеству символов в маршруте и ограничение на количество токенов Mini TTS, а затем разделите текст по естественным границам. |
| Появляется ответ 401 или 429 | Проверьте ключ/учетную запись на наличие ошибки 401. В случае ошибки 429 перед повторной попыткой необходимо отличить ограничения по скорости от недостаточной квоты. |
| Запрос GlobalGPT по-прежнему находится в обработке | Запросите идентификатор сохраненного задания и проверьте его статус; истечение времени ожидания не является поводом для отправки дубликата задания. |
| Голос не соответствует заданным настройкам | Прежде чем делать вывод о том, что настройка была применена, проверьте метаданные конкретной модели и список ignored_parameters. |
| Продолжительность аудиозаписи или полоса прокрутки отображается некорректно | Сравните метаданные файла с фактическим содержимым медиафайла и протестируйте файл целиком в целевом проигрывателе. |
Если возникла ошибка OpenAI, для начала проверьте её руководство по кодам ошибок. В случае задачи типа GlobalGPT сохраните идентификатор задачи и сведения о возвращенной ошибке. На этапе разработки следует разделять сбои при передаче данных, сбои при выставлении счетов и неудовлетворительное качество голосовой записи: для каждого из этих случаев требуется свой способ устранения неполадки.
Перед отправкой дикторского текста прослушайте всю запись на том устройстве, которое будет использовать ваша аудитория. Проверьте вступление, имена и цифры, переходы и заключительное предложение. Добавьте уведомление об использовании ИИ-голоса перед началом воспроизведения и сохраните копию точного текста и настроек модели, чтобы в случае необходимости можно было воспроизвести отредактированный сценарий.
Часто задаваемые вопросы
Что такое конечная точка API OpenAI Audio Speech?
Используйте запрос POST по адресу https://api.openai.com/v1/audio/speech. Обязательными полями являются «model», «input» и «voice». В качестве ответа возвращается аудиофайл; по умолчанию используется формат MP3.
Является ли API OpenAI Speech бесплатным?
В API Speech действует тарифная система, основанная на объеме использования. При составлении бюджета ориентируйтесь на действующие тарифы API, а не исходите из предположения о наличии бесплатного лимита: для сервиса GPT-4o Mini TTS оплата взимается за токены текстового ввода и аудиовывода, а для сервисов TTS-1 и TTS-1 HD — за символы.
Могу ли я влиять на интонацию и манеру речи?
Выберите голос, поддерживаемый вашей моделью. GPT-4o Mini TTS также принимает указания относительно манеры речи, например «теплый» или «спокойный» тон. Поле для указаний не работает с TTS-1 и TTS-1 HD.
Поддерживает ли Speech API потоковую передачу данных?
Да. Он может передавать сгенерированный звук порциями. Вашему приложению по-прежнему необходимо обеспечивать воспроизведение; одной только потоковой синтеза речи недостаточно для полноценного голосового общения в режиме реального времени.
Можно ли использовать GlobalGPT, изменив базовый URL-адрес OpenAI?
Используйте описанный в документации GlobalGPT рабочий процесс обработки медиазадач для преобразования текста в речь (TTS): отправьте запрос POST на /tasks, выполните опрос GET на /tasks/{id} и после успешного выполнения загрузите файл по адресу output.url. В документации по каталогу TTS указаны модели ElevenLabs и Qwen с собственными идентификаторами и параметрами.
С какого аудиоформата мне лучше начать?
Начните с формата MP3, если вам нужна простая загрузка или прослушивание через веб-плеер. Формат WAV пригодится, если далее планируется редактирование. Для прослушивания файлов в формате Raw PCM потребуется плеер, настроенный под соответствующую частоту дискретизации и разрядность, поскольку у этих файлов отсутствует заголовок.
Начните с одного короткого сценария, одного голоса и одного сохраненного файла. Как только время воспроизведения и затраты станут предсказуемыми, добавьте фрагментацию, повторные попытки и остальные элементы вашего медиа-рабочего процесса. В своей реализации учитывайте формат запросов выбранного API, единицы расчета и обработку выходных данных.
Придайте своему следующему сценарию голос
Составьте краткий обзор продукта, запишите голосовое сопровождение с помощью ElevenLabs или Qwen, а затем добавьте изображения и видео в мультимодельной рабочей среде GlobalGPT.
Создание голосового аудио с помощью GlobalGPT








