
Версия Grok 4.7 представляет собой значительное обновление в области программирования и интеллектуальной работы, однако пока еще рано делать окончательные выводы: официальные заявления о выпуске и результаты независимых тестов указывают на улучшение, но не на всеобщую победу.
Краткий ответ
Grok 4.7 — это обновление xAI от 21 сентября 2026 года, предназначенное для программирования и сложных задач, связанных с интеллектуальным трудом. xAI заявляет, что система тратит больше времени на сложные задачи, более тщательно проверяет свою работу и добавляет новый набор мер безопасности, сохраняя при этом ту же цену и скорость, что и у версии Grok 4.6. На странице анонса также указано, что она работает в два раза быстрее и стоит в два раза дешевле сопоставимых моделей — такое сравнение с конкурентами следует рассматривать с учетом конкретных задач и подходов. Данные независимой аналитической компании Artificial Analysis показывают небольшое общее превосходство над версией Grok 4.6 и фиксируют контекстное окно размером 500K. В нашем тесте API с тремя задачами Grok 4.7 продемонстрировала наилучшие результаты в отладке и соблюдении границ исходного кода; её план проекта хорошо учитывал неопределённость, но был менее пригодным для практического применения, чем требовалось. Это полезные практические данные, но не доказательство того, что она превосходит все конкурирующие модели.
Что такое Grok 4.7?
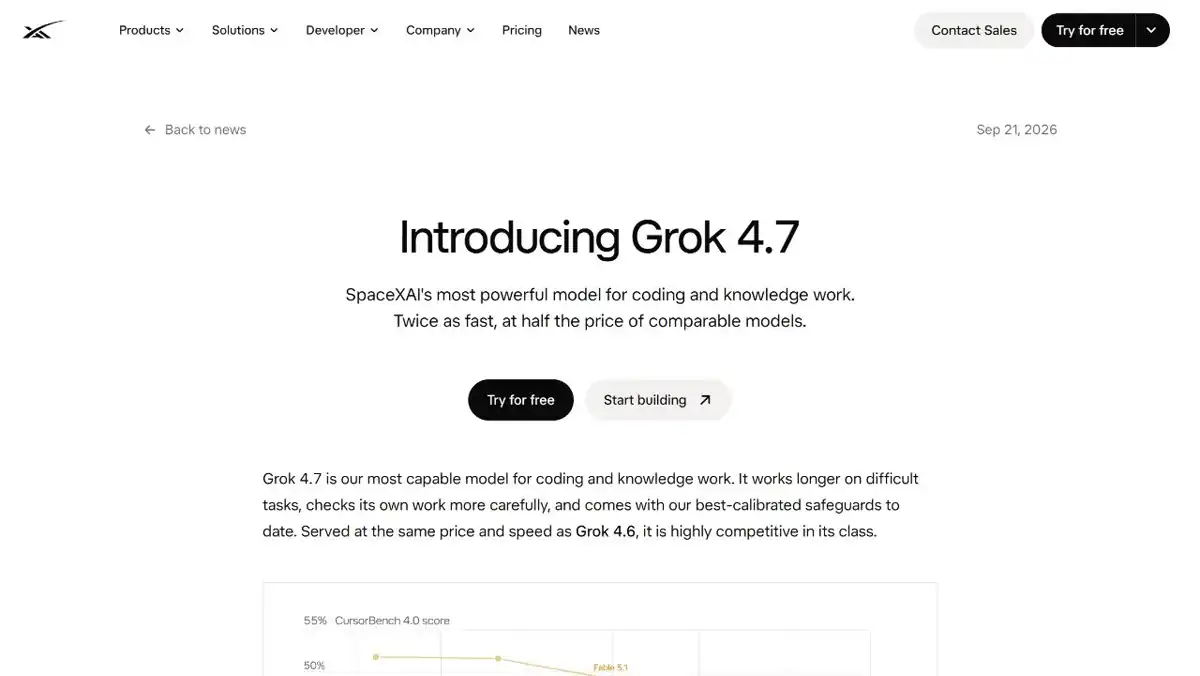
Grok 4.7 — это новейшая модель в линейке Grok компании xAI, представленная 21 сентября 2026 года. Данная официальное заявление xAI позиционирует её как самую функциональную модель компании для программирования и интеллектуальной работы. Существенное изменение заключается не в появлении новых функций, ориентированных на потребителя. Речь идет об изменении того, как модель должна распределять свои усилия: больше времени на сложные задачи, больше самопроверки и уровень безопасности, призванный сделать эти дополнительные возможности более контролируемыми.
Такое позиционирование имеет значение, поскольку оно описывает модель рабочего процесса, а не индивидуальность чат-бота. Модель Grok 4.7 позиционируется как решение для задач, требующих непрерывного анализа: отладка, планирование, написание технической документации, обобщение результатов исследований, а также работа с длинными запросами, при которой модели необходимо учитывать сразу несколько ограничений.
Не менее важна и граница. Заявление xAI представляет собой заявление поставщика о предполагаемом поведении. Оно не является независимым доказательством того, что модель Grok 4.7 превосходит каждую конкурирующую модель, каждый промпт или каждый репозиторий кода. Рассматривайте страницу запуска как источник информации о заявлениях xAI, а затем используйте независимые измерения и свою собственную задачу, чтобы решить, имеют ли эти заявления значение.
Grok 4.7 против Grok 4.6: что на самом деле изменилось?
Наиболее обоснованное резюме заключается в том, что речь идет об улучшении качества и надежности, а не о совершенно новом продукте.
| Площадь | Grok 4,7 | Что подтверждают факты |
|---|---|---|
| Выпуск | 21 сентября 2026 года | Дата, указанная на официальной странице запуска xAI |
| Основное позиционирование | Программирование и интеллектуальный труд | Официальное позиционирование xAI |
| Сложные задачи | Более длительная работа и более тщательная самопроверка | Официальное описание xAI; наш тест с использованием API для выполнения трёх задач представляет собой небольшую практическую проверку, а не сопоставительное сравнение |
| Безопасность | Новый набор мер безопасности | Официальное описание xAI |
| Цена и скорость | То же, что и Grok 4.6, согласно xAI | Заявление о запуске, а не аудит цен, проводимый третьей стороной |
| Контекст | 500 тыс. токенов в профиле «Искусственный анализ» | Профиль независимой модели; проверьте используемый вами маршрут |
| Элементы управления логикой | От ’Low» до «xhigh» в списке Artificial Analysis | Независимые метаданные маршрута/модели |
Для покупателей это важное различие. Если версия Grok 4.6 уже подходит для вашего рабочего процесса, то 4.7 представляет собой удобное обновление, которое стоит рассмотреть. Если же версия 4.6 не подходила из-за ограничений, связанных с экосистемой, задержками, надёжностью или доступом, то одно лишь повышение показателей тестов не решит этих проблем.
Для создания более широкой концепции приобретения моделей Руководство по ценам на GPT-5.6 и Сравнение GPT-5.6 являются полезными рекомендациями, позволяющими отделить качество модели от экономической эффективности проекта и соответствия рабочему процессу.
Возможности: в каких случаях может помочь Grok 4.7
Кодирование и отладка
Самым сильным аргументом в пользу запуска xAI является программирование. Обещание заключается не просто в том, что Grok 4.7 пишет больше кода, а в том, что он способен дольше заниматься сложной инженерной задачей, анализировать собственный ответ и выдавать более взвешенный патч или объяснение. Именно такого поведения следует ожидать в реальном репозитории: сохраняет ли он существующий дизайн, выявляет ли первопричину, добавляет ли полезные тесты и указывает ли, чего он пока не может знать?
Не оценивайте модель, используя исходную задачу типа “создать приложение для ведения списка дел”. Предоставьте ей конкретную ошибку с неудачным тестом, небольшой набор файлов и явные ограничения. Сначала попросите поставить диагноз, а уже потом — предложить исправление. Так будет проще определить, действительно ли более развернутое обоснование сокращает объем работы по рецензированию или просто приводит к более длинному тексту.
То же правило распространяется на команды, сравнивающие различные подходы к программированию. A Обзор DeepSeek V4 Pro и Анализ плана кодирования GLM предоставляют полезный контекст для сравнения, но ни один из них не следует рассматривать в качестве замены тестирования репозитория и набора инструментов, которые вы используете на практике.
Работа с информацией, требующая углубленного понимания контекста
В разделе «Анализ искусственного интеллекта» для версии Grok 4.7 указано контекстное окно объемом 500 тыс. токенов. Этого вполне достаточно, чтобы изменить подход к работе с объёмными исходными материалами: длинная техническая спецификация, набор протоколов совещаний, фрагмент кодовой базы или пакет исследовательских материалов могут оставаться в рамках одного диалога, вместо того чтобы их приходилось постоянно пересказывать.
Объем контекста — это не то же самое, что качество контекста. Модель может принять большой объем входных данных и при этом упустить ограничение, расположенное примерно в середине текста, придать чрезмерный вес последнему абзацу или сформулировать уверенное резюме, которое потребует проверки по источнику. Практическим тестом является поиск информации в условиях стресса: разместите несколько ключевых фактов в разных частях длинного документа, попросите принять решение с учетом ограничений и проверьте, цитируются ли в ответе правильные отрывки.
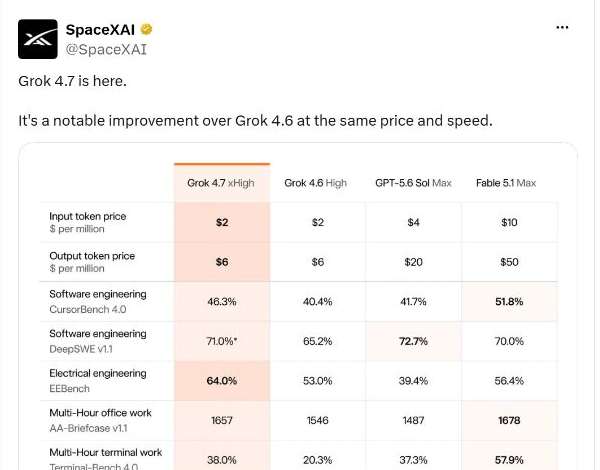
22 сентября официальный аккаунт SpaceXAI в X повторил информацию о запуске, назвав версию Grok 4.7 значительным улучшением по сравнению с версией Grok 4.6 при той же цене и скорости, а также опубликовав график сравнения моделей. Этот пост является полезным свидетельством публичного позиционирования компании, но не является независимой оценкой или консенсусом сообщества.
Если модель используется в исследовательских целях, следует обеспечить наглядность цикла доказательств. Наш Сравнение моделей Gemini и Perplexity и Руководство по альтернативам Perplexity подчеркивают одну и ту же практическую мысль: отточенный ответ — это не аудит источника.
Самодиагностика и безопасность
По заявлению xAI, версия Grok 4.7 более тщательно проверяет результаты своей работы и внедряет новый набор мер безопасности. Это важные задачи, особенно когда модели предстоит принимать длинную цепочку решений. Однако они не являются гарантией того, что выходные данные будут правильными или безопасными для автоматического выполнения.
При использовании в производственной среде следует применять к модели стандартные меры контроля: тестирование, разрешения, проверку специалистами, проверку ссылок и четкое условие остановки. Самопроверка модели — это еще один сигнал, требующий внимания, но она не заменяет меры контроля, применяемые к модели.
Тесты Grok 4.7: что показывают цифры
Отличный результат кодирования: согласно официальной таблице, версия Grok 4.7 опережает версию Grok 4.6.
Сравнение с более мощными моделями демонстрирует существенный прирост производительности в этом тесте для задач, связанных с обработкой информации.
Это полезный показатель для рабочих процессов, предполагающих использование инструментов, но, тем не менее, речь идет об одной оценке, а не о универсальном показателе.
Независимый индекс подтверждает ту же тенденцию: улучшение, а не доказательство всеобщей победы.
Рассматривайте эти карточки как ориентировочные данные. Состав набора данных, доступ к инструментам, выборка и настройки модели могут повлиять на порядок ранжирования.
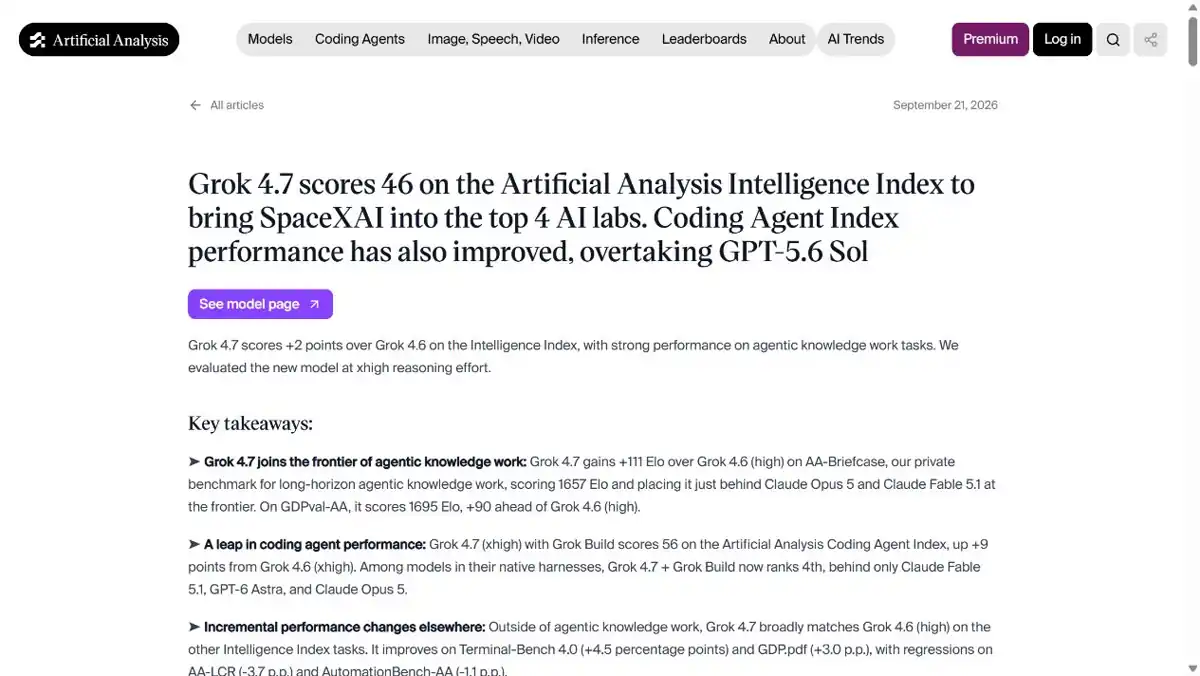
На данный момент наиболее полезный независимый обзор предоставляет Статья о тестировании модели Grok 4.7 от ’Artificial Analysis», от 21 сентября 2026 года.
| Мера | Сообщенный результат | Как это читать |
|---|---|---|
| Индекс искусственного интеллекта в области анализа | 46 | На два пункта выше, чем показатель Grok 4,6 в том же индексе |
| AA-Портфель | 1 657 Эло | 111 единиц Elo выше Grok 4,6 по данной оценке |
| Окно контекста | 500 тыс. токенов | Область профилей моделей, а не доказательство идеального извлечения информации из длинного контекста |
| Усилие рассуждения | От низкого до xвысокого | Контроль на уровне маршрута, указанный в отчете «Artificial Analysis» |
Тенденция обнадеживает: независимый индекс демонстрирует улучшение по сравнению с предыдущей версией, а более значительный разрыв по рейтингу Эло в тесте AA-Briefcase свидетельствует о более заметном улучшении именно в этой оценке. Однако таблица по-прежнему отражает результаты двух наборов данных, а не универсальный рейтинг. Состав тестов, доступ к инструментам, выборка и настройки модели могут повлиять на результат.
На официальной странице запуска xAI указано значение Grok 4.7 при 46,31 TP40T в тесте CursorBench 4.0 в своей сравнительной таблице наряду с Grok 4.6 при 40,4%, GPT-5.6 Sol при 41,7% и Fable 5.1 при 51,8%. На странице также указаны результаты: 71,01 TP40T на DeepSWE v1.1 при высокой интенсивности, 64,01 TP40T на EEBench и 1 657 на AA-Briefcase v1.1. Эти данные представлены поставщиком в целях сравнения, поэтому к ним следует относиться как к официально заявленным результатам, а не как к замене независимой проверки. Более осторожный вывод заключается в том, что xAI ориентирована на серьёзную программистскую работу и профессиональную интеллектуальную деятельность, в то время как независимые измерения показывают значительное улучшение по некоторым задачам и менее впечатляющие результаты по другим.
Практический тест Grok 4.7: три практических задания
Мы протестировали три фиксированных подсказки на grok-4.7 Идентификатор модели был получен с помощью тестового API, совместимого с OpenAI, 23 сентября 2026 года. Это была оценка с использованием одного маршрута, а не прямой API xAI и не тест с сопоставимыми конкурентами. Ниже приведены видимые ответы по каждому запуску; конфиденциальные трассировки рассуждений исключены.
| Задание | Наблюдаемое время | Результат |
|---|---|---|
| Ошибка параллелизма в TypeScript | 333,7 секунд, трансляция | Отличный результат: верная диагностика проблемы с shared-promise, минимальный патч, два полезных теста и тщательное ограничение того, что этот фрагмент кода может доказать |
| Противоречивые данные исследований | 68,7 секунд | «Сильный проход»: сохранена информация об авторстве, рассчитаны оба сценария корректировки, а утверждение было отклонено до выяснения конфликта в источниках |
| Неупорядоченный план на неделю | 50,6 секунд | Частичное выполнение: соблюдены сроки, устранены противоречия, установлены неизвестные владельцы и выявлены пять рисков, однако работа не была преобразована в четкий пошаговый план действий |
Показатели задержки относятся исключительно к данному маршруту и данным запросам. Задача кодирования сначала превысила таймаут шлюза без потоковой передачи, а затем была завершена с включенной потоковой передачей. Это практическое предупреждение, касающееся развертывания, которое касается транспорта и обработки таймаутов, а не общий показатель скорости Grok 4,7.
Тест 1: Отладка параллелизма в TypeScript
Задача 1 — Отладка параллелизма обработчика API на TypeScript

Небольшой обработчик на TypeScript периодически возвращает HTTP-код 200 с пустым телом, когда два запроса поступают с небольшим интервалом.

Предоставленные файлы:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

Симптом в производственной среде проявляется периодически только при перекрытии двух запросов. Сам загрузчик можно безопасно вызывать параллельно, и он возвращает разные данные для каждого запроса. Других файлов нет.

Верните именно следующие разделы:
1. Основная причина
2. Наименьший безопасный патч (покажите унифицированный дифф)
3. Два регрессионных теста (код в стиле TypeScript или Jest)
4. Допущения и ограничения
Не утверждайте, что вы запускали код.1. Основная причина
`current` — это состояние на уровне модуля, общее для всех вызовов. В рамках одного цикла выполнения JavaScript проверка на null и присваивание являются атомарными операциями, поэтому при перекрытии двух вызовов не выполняется `load()` для обоих. Первый вызов сохраняет своё обещание; второй вызов, поступающий до того, как это обещание разрешится, пропускает собственный вызов `load()` и ожидает того же самого обещания. Затем `handler` возвращает HTTP-ответ 200, `body` которого представляет собой строку первого вызова, а не полезную нагрузку второго запроса. Это окно существует только пока вызов находится в процессе выполнения, поэтому сбой проявляется только при перекрытии запросов.
`current = null` выполняется в каждом продолжении после того, как `await` уже захватил промис. Это не заставляет другой ожидающий процесс перечитывать переменную, поэтому сами по себе эти файлы не приводят к тому, что этот ожидающий процесс принимает значение `null` или `""`. При перекрытии они приводят к общему разрешению и пропуску загрузки для каждого запроса. Очистка также делает этот слот плохим кэшем для одного цикла: первое возобновление сбрасывает `current`, и последующий вызывающий может запустить другой вызов `load()`, пока другой вызывающий ещё находится в процессе размотки.
2. Наименьший безопасный патч (показать унифицированный дифф)
Каждый запрос должен вызывать `load()` самостоятельно. Допускаются параллельные вызовы `load()`, и каждый из них возвращает разные данные, поэтому дедупликация на основе одного общего промэйса небезопасна. Файл `handler.ts` не требует изменений.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. Два регрессионных теста (код в стиле TypeScript или Jest)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('перекрывающиеся запросы при каждом запуске загружаются и сохраняют собственное тело', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('отклоненный перекрывающийся запрос не влияет на другой ответ', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('upstream failed'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('upstream failed');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. Допущения и ограничения
Я не запускал ни этот код, ни тесты. Тесты предполагают использование запускателя в стиле Jest и наличие файла в папке, расположенной на одном уровне с `src/` (например, `test/cache.test.ts`).
Я рассматривал “разные данные для каждого запроса” как требование, согласно которому пересекающиеся вызовы `getPayload` не должны использовать один и тот же результат `load()`. Правильная переработка для однократного выполнения (`load().finally(() => { current = null; }); return current`) всё равно привела бы к связыванию этих запросов, поэтому я её не использовал. Ключ кэша отсутствует, и требование по дедупликации не указано.
Буквально пустое тело HTTP не записывается показанными операторами, если `load` возвращает непустую строку. Если эта проблема возникает из-за адаптера, находящегося за пределами этих файлов, она здесь не прослеживается. Патч лишь устраняет перекрытие, связывающее эти файлы, которое фактически реализовано в них. Он не добавляет блокировок, повторных попыток или кэша с ключами.В решении Grok 4.7 правильно установлено, что на уровне модуля текущий Promise приводит к тому, что перекрывающиеся запросы используют один и тот же результат загрузчика, хотя каждому запросу требуется собственное содержимое. Было предложено минимальное безопасное изменение: удалить общий Promise и вызвать load() по запросу. Два регрессионных теста охватывали различные параллельные нагрузки и сценарии изоляции в случае отказа одного загрузчика. Самым сильным моментом ответа стала его сдержанность: в нём прямо указывалось, что приведённый код доказывает наличие межзапросной связи, но сам по себе не объясняет наличие буквально пустого тела, если загрузчик всегда возвращает непустую строку.
Вердикт: Высокий уровень соответствия по таким показателям, как точность определения первопричин, объем исправлений, охват регрессионного тестирования и обработка неопределенностей.
Задание 2: Аналитическая записка по результатам исследования с использованием противоречивых источников
Задание 2 — Свести воедино противоречивые исследовательские заметки в памятку для принятия решения.

Используйте только эти шесть заметок и указывайте название источника рядом с каждым фактологическим утверждением:

- Поставщик A, страница с ценами, 20.09.2026: Тарифный план «Team» составляет $40 за одно рабочее место в месяц и включает 100 000 действий.
- Поставщик B, сравнительная публикация, 21.09.2026: Тарифный план «Team» поставщика A включает 120 000 действий за одно рабочее место в месяц.
- Интервью с клиентом, 18.09.2026: В нашей команде 8 рабочих мест, и в прошлом месяце мы использовали 710 000 действий.
- Финансовая таблица, 19.09.2026: Текущий предельный бюджет составляет $360 в месяц.
- Поставщик A, страница лимитов, 20.09.2026: Превышение лимита тарифицируется по ставке $0,004 за одно действие после исчерпания включённого лимита.
- Примечание отдела закупок, 22.09.2026: Смена поставщика допускается только в том случае, если месячный итог не выходит за пределы бюджета и лимит подтверждён.

Верните именно следующие разделы:
1. Подтвержденные факты
2. Приписанные претензии
3. Таблица несоответствий
4. Независимые расчеты (рассчитайте оба сценария: 8 x 100 000 и 8 x 120 000, плюс любой объем, превышающий лимит)
5. Рекомендация
6. Один уточняющий вопрос только в том случае, если конфликт влияет на рекомендацию
Не разрешайте конфликт «100 000 против 120 000» без объяснения причин.
1. Подтвержденные факты
- Тарифный план “Team” составляет $40 за одно рабочее место в месяц (поставщик A, страница с ценами, 20.09.2026).
- В команде 8 рабочих мест, и в прошлом месяце было совершено 710 000 действий (интервью с клиентом, 18.09.2026).
- Текущий верхний предел бюджета составляет $360 в месяц (финансовая таблица, 19.09.2026).
- Превышение лимита оплачивается по ставке $0,004 за одно действие после исчерпания включённого лимита (поставщик A, страница “Лимиты”, 20.09.2026).
- Смена поставщика допускается только в том случае, если месячный итог укладывается в бюджет и лимит подтвержден (Примечание отдела закупок, 22.09.2026).

2. Приписываемые претензии
- Пакет «Team» включает 100 000 включённых действий (поставщик A, страница с ценами, 20.09.2026). В данном примечании явно не указано «на одно рабочее место».
- Команда поставщика A включает 120 000 действий в месяц на одно рабочее место (поставщик B, сравнительная публикация, 21.09.2026).

3. Таблица противоречий
| Элемент | Утверждение | Источник | Статус |
| --- | --- | --- | --- |
| Включённые действия | 100 000 включённых действий; «на одно рабочее место» не указано | Поставщик A, страница с ценами, 20.09.2026 | Неурегулировано |
| Включённые действия | 120 000 действий на одно рабочее место в месяц | Поставщик B, сравнительная публикация, 21.09.2026 | Неурегулированный |

Противоречие между цифрами 100 000 и 120 000 не урегулировано. В этих примечаниях не указано, какая из цифр является правильной.

4. Независимые расчёты
Базовая стоимость одного рабочего места, одинаковая в обоих сценариях: 8 рабочих мест (интервью с клиентом, 18.09.2026) × $40 за одно рабочее место в месяц (Поставщик A, страница с ценами, 20.09.2026) = $320 в месяц.

Оба приведённых ниже множителя рассчитаны в соответствии с запросом. Они не являются подтверждением того, что Поставщик A указал норму расхода на одно рабочее место.

- 8 × 100 000 = 800 000 включенных действий, с использованием цифры 100 000 (поставщик A, страница с ценами, 20.09.2026).
- Объём использования 710 000 (беседа с клиентом, 18.09.2026) на 90 000 меньше 800 000, поэтому количество действий, превышающих лимит, = 0.
- Плата за превышение лимита = 0 × $0,004 = $0 (поставщик A, страница с лимитами, 20.09.2026).
- Ежемесячный итог = $320 + $0 = $320, что укладывается в предельное значение $360 (финансовая таблица, 19.09.2026).

- 8 × 120 000 = 960 000 включенных действий, с использованием цифры 120 000 (Поставщик B, сравнительная публикация, 21.09.2026).
- Объем использования 710 000 (интервью с клиентом, 18.09.2026) на 250 000 меньше 960 000, поэтому количество действий с превышением лимита = 0.
- Плата за превышение = 0 × $0,004 = $0 (Поставщик A, страница лимитов, 20.09.2026).
- Ежемесячный итог = $320 + $0 = $320, что укладывается в предельный уровень $360 (таблица финансового отдела, 19.09.2026).

5. Рекомендация
Пока не утверждать переход. При обоих рассчитанных лимитах 710 000 действий за прошлый месяц (интервью с клиентом, 18.09.2026) не приводят к превышению лимита, а месячный итог составляет $320, что укладывается в предельный показатель $360 (таблица финансового отчёта, 19.09.2026). Этот результат по затратам не зависит от выбора значения 100 000 или 120 000. Переход по-прежнему не соответствует второму условию: квота должна быть подтверждена (Примечание отдела закупок, 22.09.2026), а эти примечания указывают 100 000 (поставщик A, страница с ценами, 20.09.2026) в противоречии со значением 120 000 (поставщик B, сравнительная публикация, 21.09.2026).

6. Только один уточняющий вопрос, если конфликт влияет на рекомендацию
Уточняющих вопросов нет. Конфликт между значениями 100 000 и 120 000 не влияет на рекомендацию.
В исследовательском пакете данных намеренно были приведены противоречивые данные относительно того, составляла ли квота 100 000 или 120 000 действий на одно место. В документе Grok 4.7 эти два источника были рассмотрены отдельно; было отмечено, что в первом источнике не было явно указано “на одно рабочее место”, были просчитаны оба сценария с восемью рабочими местами и показано, что в обоих случаях показатель оставался на уровне $320 без превышения лимита при указанном объеме использования. Тем не менее в нём по-прежнему рекомендуется приостановить одобрение, поскольку отдел закупок требует подтверждения этого лимита. Именно в этом заключается правильное различие между рекомендацией, которая является стабильной с точки зрения цифр, и нерешённым договорным вопросом.
Вердикт: Отличная оценка за атрибуцию, арифметику, разрешение конфликтов и дисциплину принятия решений.
Тест 3: Неупорядоченные заметки в плане выполнения
Задача 3 — Превратите эти беспорядочные заметки по проекту в план выполнения на одну неделю объемом не более 700 слов.

Примечания:
- Запуск целевой страницы — в пятницу в 17:00; в более поздней заметке владелец продукта указывает, что запуск состоится в четверг утром.
- Мина: написать заголовок и таблицу цен. Мина также сообщает, что сможет проверить текст только в среду днём.
- Арджун: аналитические события; в дублирующейся заметке указано, что ответственный за аналитику будет определён позже.
- У отдела дизайна есть две одинаковые задачи: “обрезка главного изображения для мобильной версии” и “окончательная обрезка главного изображения для мобильной версии”.
- Юридическая экспертиза должна быть проведена до любого публичного запуска.
- Отделу контроля качества требуется один полный день после того, как станут доступны аналитические события.
- Омар будет отсутствовать во вторник днём.
- Рассылка письма о запуске запланирована на пятницу, 16:00.
- Неизвестно: кто принимает окончательное решение о запуске или отказе от него.

Требования: сгруппировать дублирующиеся задачи, пометить неизвестных ответственных как «будет определено позже», сохранить оба жестких срока, выделить противоречия, а не решать их незаметно, и завершить перечнем из пяти рисков.

Включите в отчет именно следующие разделы:
1. План на неделю
2. Противоречия и неизвестные моменты
3. Пять рисков
Не придумывайте ответственных или даты.
1. План на неделю

В примечаниях нет календарных дат, поэтому они не добавляются. Используются только указанные ориентиры и зависимости. Дублирующаяся работа по дизайну считается одной задачей. Неизвестные ответственные остаются с пометкой “TBD”. Обе конфликтующие даты запуска сохраняются.

- Текст: Мина пишет заголовок и таблицу цен. Рецензия её текста запланирована только на среду днём.
- Дизайн: одна задача — обрезка главного изображения для мобильной версии, включая “финальную” доработку. Отдельный ответственный не указан.
- Аналитические события: должны быть готовы до начала тестирования. Ответственный не определён (в одной заметке указан Арджун, в другой — «будет определено позже»).
- Контроль качества: один полный день, только после того, как будут доступны аналитические события. Ответственное лицо — «будет определено позже». День проведения контроля качества здесь не назначен.
- Юридическая экспертиза: требуется перед любым публичным запуском. Ответственное лицо — «будет определено позже». В заметках не запланировано.
- Решение о запуске/отказе: ответственное лицо — «будет определено позже». Не рассматривается как решённый вопрос.
- Основные сроки публичного запуска, оба сохранены: утро четверга (владелец продукта) и пятница 17:00 (целевая страница).
- Письмо о запуске: пятница 16:00. Ответственный — будет определён позже.
- Омар отсутствует во вторник днём. Ни одна задача в этих заметках не назначена Омару, поэтому ни одна не перенесена.

Порядок, без новых дат: черновик Мины должен быть готов к обзору в среду днём; дизайнеры завершают кадрирование единственного главного героя; события аналитики предоставляются ответственным лицом, которое пока не определено; затем у отдела контроля качества отводится один полный день; юридическая экспертиза завершается до любого публичного запуска; решение о запуске/отказе (будет определено позже) по-прежнему не закреплено за кем-либо. Не исключайте варианты: утром в четверг, в пятницу в 17:00 или в пятницу в 16:00.

2. Противоречия и неизвестные

Противоречия (неурегулированные):
- Запуск целевой страницы назначен на пятницу в 17:00, а в более поздней заметке владельца продукта указано утро четверга.
- В одной заметке ответственным за аналитику указан Арджун, а в другой — «будет определено позже».

Неизвестные моменты, помеченные как «будет определено позже»:
- Окончательный ответственный за принятие решения о запуске.
- Окончательно утвержденный ответственный за аналитику.
- Ответственный за юридическую экспертизу.
- Ответственный за контроль качества.
- Ответственный за рассылку писем, посвященных запуску.
- Конкретный ответственный за дизайн, помимо общего указания «Дизайн».
- Роль Омара; указано только его отсутствие во вторник днём.
- Какое время запуска является окончательным и соответствует ли рассылка в пятницу в 16:00 какому-либо из указанных времен. Даты, выходящие за рамки этих рабочих дней, не указаны.

3. Пять рисков

1. Запуск целевой страницы не может состояться одновременно в четверг утром и в пятницу в 17:00; использование любого из этих вариантов без принятия окончательного решения может привести к преждевременному запуску или пропуску другого срока.
2. Время отправки письма о запуске зафиксировано на пятницу в 16:00, до 17:00, и в заметках не согласовано с утром четверга, поэтому оно может быть отправлено, когда страница ещё не находится или уже не находится в запланированном состоянии.
3. Вопрос об ответственности за аналитику остаётся спорным, поэтому события могут быть пропущены; отделу контроля качества по-прежнему требуется полный день после событий, и он может не успеть до наступления любого из ориентиров запуска.
4. Юридическая экспертиза должна предшествовать любому публичному запуску, но у неё нет ответственного лица или выделенного временного интервала, поэтому запуск может быть заблокирован или состояться без экспертизы.
5. Не назначен ответственный за принятие решения о запуске или его отмене, поэтому ни для одного из жёстких сроков не указано конкретное лицо, которое должно одобрить или остановить запуск.
В версии Grok 4.7 была объединена дублирующаяся задача «mobile-hero», сохранены конфликты запусков в четверг утром и в пятницу в 17:00, оставлен крайний срок отправки электронного письма в пятницу в 16:00, неназначенные ответственные лица были помечены как «TBD», а в итоге осталось ровно пять рисков. В ней не были добавлены ни даты, ни ответственные лица. Слабым местом стала практическая реализуемость: вместо распределения работы по дням с понедельника по пятницу система выдала упорядоченный список зависимостей и сообщила, что день для контроля качества не может быть назначен. Такая осторожность оправдана, но в задании требовался план выполнения на одну неделю, поэтому ответ лишь частично соответствовал запрошенному формату.
Вердикт: Частичное соответствие: отличное сохранение ограничений, меньшая полезность для планирования.
Как версия Grok 4.7 влияет на реальные рабочие процессы
Наиболее полезно рассматривать этот запуск как вопрос, касающийся рабочего процесса: в каких случаях последовательное рассуждение сокращает объем работы по проверке, а в каких — просто приводит к более длинному ответу? Три задачи по API указывают на практический паттерн. Grok 4.7 легко справляется с одновременным учетом нескольких ограничений, особенно когда в задании требуется отделить факты от предположений. Он менее убедителен, когда задача требует конкретного календаря или последовательности действий, которые в исходных заметках не указаны в полной мере.
Кодирование и отладка
При работе с репозиторием эта модель лучше подходит для ограниченной диагностики, чем для открытого запроса типа “создать приложение”. Предоставьте ей минимальный набор полезных файлов, опишите симптом сбоя и потребуйте выявления первопричины перед выпуском исправления. Попросите предоставить тесты, которые давали бы сбой до внесения изменений и проходили бы после них. В нашем тесте обработчика ответ оставался близок к предоставленному коду и не допускал выдумывания внешней причины для симптома «пустого тела».
Это поведение имеет значение, поскольку качество программирования — это не просто генерация кода. Эффективный подход к программированию должен сохранять локальную архитектуру, минимизировать разницу в коде, выявлять допущения и упрощать верификацию. Grok 4.7 выполнил все эти задачи в рамках одного небольшого задания, однако одно задание не может обеспечить надежность в масштабах репозитория. Команды должны применять ту же схему оценки к реальной ошибке, рефакторингу, изменениям в нескольких файлах и сценариям, связанным с безопасностью, прежде чем переходить к работе в производственной среде.
Исследование и обобщение источников
В ходе исследования выявилась ещё одна сильная сторона: соблюдение границ источников. Grok 4.7 не объединила без пояснений заявленное поставщиком число в 100 000 действий с цифрой в 120 000, указанной в сравнительном посте. Кроме того, оно позволило отличить расчёт, остающийся стабильным в обоих сценариях, от условия закупки, которое всё ещё требует проверки.
Это подходящий подход для работ с большим объёмом исследовательской части. Попросите модель отдельно пометить проверенные факты, утверждения с указанием источников, неразрешённые противоречия, расчёты и рекомендации. Даже отполированная служебная записка может оказаться ошибочной, если в ней вторичное утверждение маскируется под факт без указания источника. Ответ Grok 4.7 оказался полезным, поскольку в нём конфликт оставался видимым, хотя результат вычислений не изменился.
Планирование и оперативная деятельность
На этапе планирования ограничения стали более очевидными. Модель учитывала все сроки и неизвестных владельцев, но не смогла самостоятельно сформировать график работы с понедельника по пятницу. Это более безопасный подход, чем выдумывать даты, однако он означает, что пользователю по-прежнему приходится самостоятельно преобразовывать зависимости в календарные задачи.
В запросах, касающихся операционной деятельности, укажите горизонт планирования, количество доступных рабочих дней, доступность владельца и лицо, принимающее решение. Если эти поля отсутствуют, сначала запросите карту зависимостей, а затем — календарь. Такой двухэтапный рабочий процесс позволяет использовать предупреждение модели с пользой, а не рассматривать его как неспособность принять решение.
Поиск по длинному контексту
Контекстное окно размером 500K изменяет объем данных, который может поместиться в одном запросе, но не влияет на то, каким данным можно доверять без проверки. При работе с длинным контекстом следует использовать пробные запросы: разместить решающие факты в начале, середине и конце пакета; добавить один намеренный конфликт; затем запросить решение с указанием источников. Оценивайте как полноту охватывания, так и соблюдение границ.
Не оценивайте маршрут с длинным контекстом по тому, принимает ли он запросы большого размера. Зафиксируйте, где в модели пропадают факты, перевешивает ли она значение заключительного фрагмента, насколько возрастает задержка с увеличением объёма входных данных, а также урезает ли или преобразует ли провайдер запрос. Указанный большой размер окна — это заявление о пропускной способности, а не гарантия стабильного вывода на пределе.
Как самостоятельно оценить модель Grok 4.7
Прежде чем изменять настройки по умолчанию в производственной среде, воспользуйтесь небольшим набором тестовых данных, позволяющим проводить повторяемые тесты. Цель заключается не в том, чтобы заново составить рейтинг, а в том, чтобы сравнить модель с уже используемым вами маршрутом и процессом проверки, за которые вы уже платите.
- Зафиксируйте входные данные. Сохраните точный текст запроса, файлы, исходный пакет, идентификатор модели, температуру, настройки логического вывода и права доступа к инструментам. Не сравнивайте прямой маршрут с маршрутом провайдера, одновременно изменяя текст запроса.
- Оценивайте произведение, а не стиль изложения. При кодировании оценивайте точность определения первопричин, объем исправления, тесты и допущения. При проведении исследований оценивайте границы цитирования, арифметику, противоречия и качество рекомендаций. При планировании оценивайте соблюдение сроков, ответственность, зависимости и реализуемость.
- Транспортировку следует регистрировать отдельно. Ведите журнал маршрутов, в котором фиксируются время до получения первого токена, общее время, режим (потоковый/непотоковый), статус HTTP и поведение при повторных попытках. Таймаут шлюза не всегда является сбоем, влияющим на качество модели, но все же приводит к производственным затратам.
- Проверьте поведение системы в случае сбоя. Включите один неоднозначный входной сигнал, один противоречивый источник данных и один намеренно неполный набор файлов. Интересно выяснить, будет ли модель отмечать неопределенность или восполнит пробел уверенным предположением.
- Рассмотрите затраты и объем работ в совокупности. Отслеживайте входные токены, выходные токены, кэшированные входные данные, токены рассуждений (при их раскрытии) и количество минут, затраченных на проверку человеком. Более «дешёвый» ответ, проверка которого занимает в два раза больше времени, на практике может оказаться не таким уж и дешёвым.
- Повторите перед переключением. Перед тем как изменить настройки по умолчанию для команды, выполните каждую задачу как минимум дважды или на нескольких типичных примерах. Сохраните исходный ответ и примечания по оценке, чтобы другой рецензент мог воспроизвести принятое решение.
Три тестовых прогона, представленные в данном обзоре, являются лишь начальной выборкой и не заменяют набор данных для оценки команды. Они демонстрируют поведение модели Grok 4.7 при решении одной задачи кодирования, одной записки о конфликте источников и одного пакета задач планирования; они не устанавливают универсального рейтинга.
Grok 4.7: цены и доступ к API
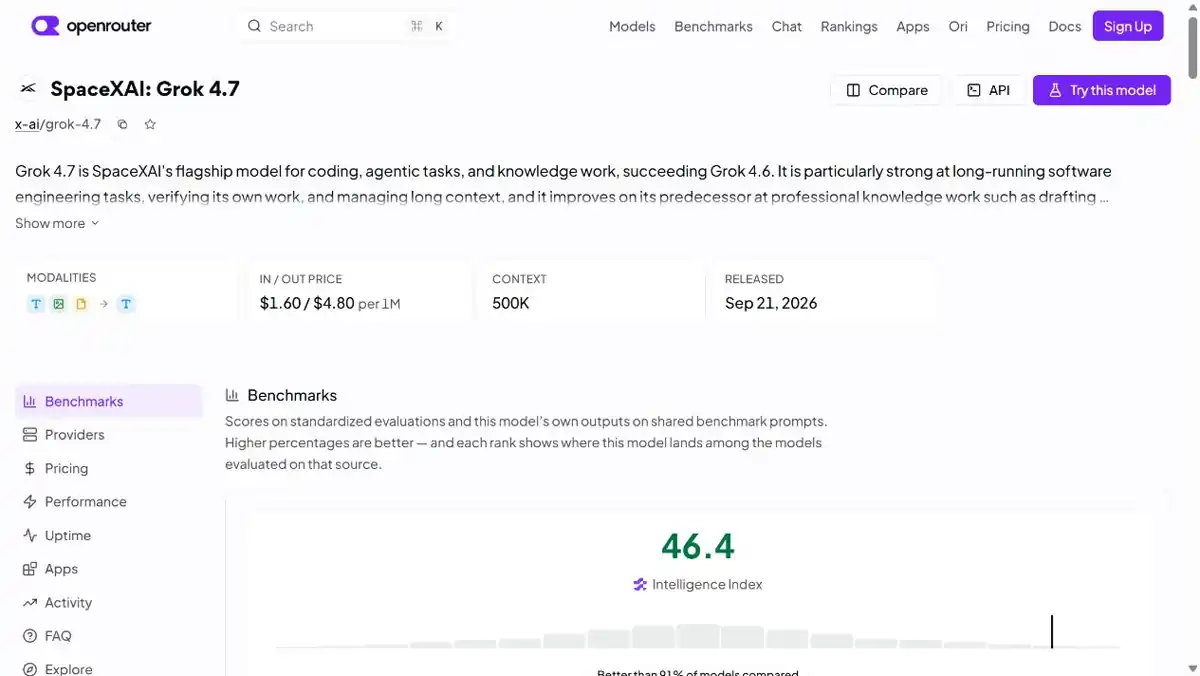
Именно в вопросе ценообразования обзоры моделей зачастую вводят в заблуждение. Читатель может столкнуться как минимум с тремя разными цифрами: прямой ценой API от xAI, ценой маршрута у агрегатора и ценой подписки для потребителя. Эти цифры не являются взаимозаменяемыми.
Согласно заявлению xAI, Grok 4.7 предоставляется по той же цене и со той же скоростью, что и Grok 4.6. На странице анонса указано, что стоимость стандартной модели начинается от $2 на 1 миллион входных токенов и $6 на 1 миллион выпущенных токенов; В работе «Искусственный анализ» отдельно приводятся те же данные по прямому маршруту и $0,50 за 1 миллион кешированных входных токенов. Компания xAI также заявляет, что ускоренная версия удваивает скорость вывода результатов при удвоенной цене. Воспользуйтесь официальная документация для разработчиков прежде чем отправлять трафик в производственную среду, необходимо ознакомиться с текущим соглашением об API и проверить доступность для конкретной учетной записи.
Страница Grok от OpenRouter, 4,7 страниц показывает $1,60 за 1 миллион входящих токенов и $4,80 за 1 миллион выпущенных токенов за маршрут. Это цена OpenRouter/провайдера, а не корректировка прямой цены xAI по прейскуранту. Маршрутизация, наценка, кэширование, ограничения и доступность могут различаться в зависимости от провайдера.
Невозможно дать однозначный ответ на вопрос “Сколько стоит Grok 4.7?”, не указав маршрут. Покупателям API рекомендуется сравнить следующие варианты:
- частота появления входных и выходных токенов;
- обработка данных из кэша ввода;
- ограничения по контексту и выводу;
- ограничения по скорости и региональная доступность;
- предоставляет ли поставщик средства управления процессом принятия решений;
- условия сбора, хранения и обработки данных.
Что касается доступа для потребителей, не следует полагать, что цена, указанная для API, отражает стоимость подписки на X или Grok. Для тарифного плана потребителя, канала доступа через API и стороннего агрегатора могут действовать разные правила доступа.
Какой маршрут API выбрать?
| Маршрут | Лучше всего подходит для | Что необходимо проверить перед использованием | Основной компромисс |
|---|---|---|---|
| API Direct xAI | Производственные системы, для которых требуется заключение собственного договора с поставщиком | Официальный идентификатор модели, ограничения по скорости, условия предоставления данных, регионы, потоковая передача данных и текущая цена | Самый прозрачный механизм предоставления услуг, но вы самостоятельно управляете выставлением счетов и доступностью |
| OpenRouter | Быстрое сравнение провайдеров и поиск оптимального маршрута | Фактический провайдер на входе, стоимость маршрута, кэширование, конфиденциальность, контекст и поведение при переходе на резервный вариант | Переключение стало проще, но маршрут отличается от прямого сервиса xAI |
| Тестовый API, совместимый с OpenAI | Внутренняя оценка или устаревший клиент, который уже поддерживает схему OpenAI | Сопоставление моделей, ограничения по времени ожидания, поддержка потоковой передачи, поля использования, срок хранения и семантика ошибок | Удобная интеграция, однако совместимость не гарантирует идентичного поведения провайдеров |
Совместимый маршрут, использованный в практическом разделе, вернул grok-4.7 и поддерживала потоковую передачу. Запрос на кодирование без потоковой передачи превысил окно ожидания шлюза до того, как завершилась повторная попытка потоковой передачи. Это наблюдение полезно при разработке клиента, но его не следует использовать в качестве прямого обоснования задержки xAI.
Как получить доступ к Grok 4.7
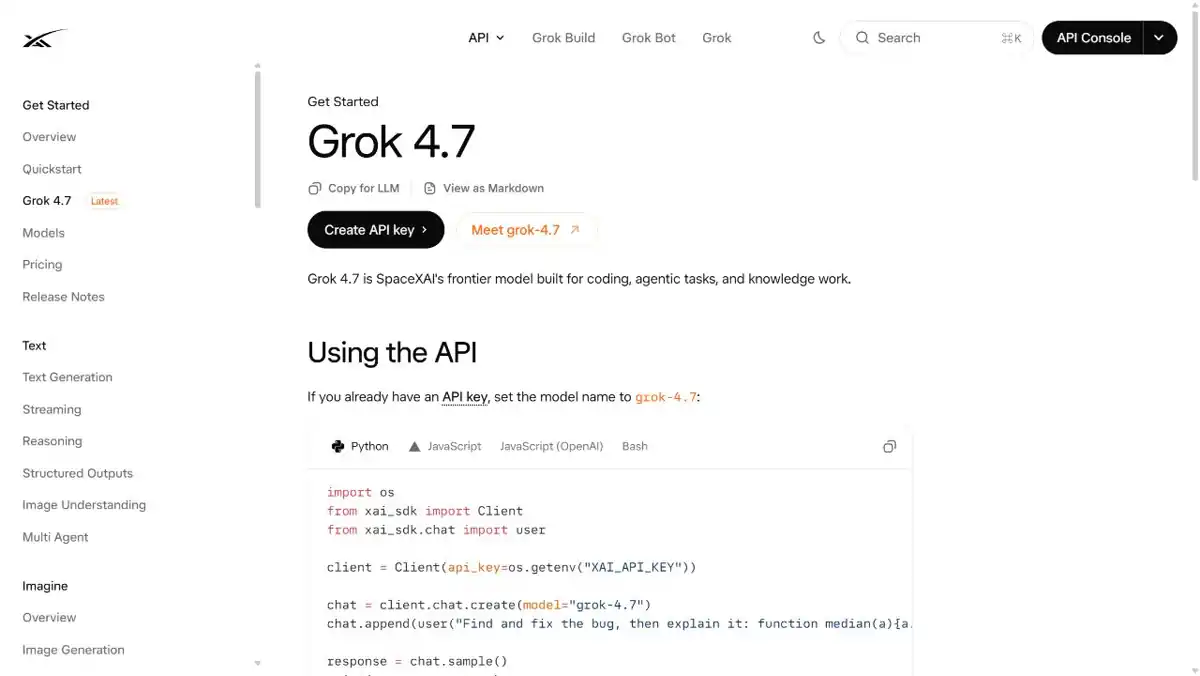
Самый простой способ — начать с Объявление xAI и Страница разработчика xAI, после чего уточните, что вам требуется: Grok Build, Cursor, прямой API или агрегатор. xAI сообщает, что версия Grok 4.7 доступна в Cursor и Grok Build, через API Grok, а также через сторонние инструментарии для программирования, маршрутизаторы моделей и облачные платформы. Это различие определяет условия оплаты, средства управления моделями, условия конфиденциальности и доступные инструменты.
Если вы используете агрегатор, откройте страницу его модели и проверьте маршрут провайдера, цены на токены, ограничение контекста и идентификатор модели, прежде чем приступать к разработке на его основе. OpenRouter — это один из задокументированных маршрутов, однако его цены не следует копировать в таблицу биллинга xAI.
Для читателей, которые хотят сравнить несколько семейств моделей в одном рабочем пространстве, Мультимодельное рабочее пространство GlobalGPT может пригодиться для параллельной оценки подсказок. В этой статье не утверждают, что маршрут Grok 4.7 там уже доступен. Наличие маршрута, указанного в каталоге, — это отдельный вопрос, который следует проверить в интерфейсе продукта перед покупкой.
Grok 4,7 по сравнению с ChatGPT, Claude и Gemini
В данном обзоре приведены результаты трёх тестов Grok 4.7, но отсутствуют данные о сравнительных тестах с моделями ChatGPT, Claude или Gemini. Универсальный вывод о том, что “Grok 4.7 выигрывает”, по-прежнему будет скорее маркетинговым ходом, а не результатом анализа. Более правильный выбор зависит от результатов исследований, связанных с этой моделью:
| Если вашим приоритетом является... | Начните с оценки… | Почему |
|---|---|---|
| Длинные технические пакеты | Grok 4.7 и другие маршруты с большим контекстом | Проверяйте точность поиска, а не только заявленный диапазон |
| Отладка репозитория | Grok 4.7 — модель, ориентированная на программирование, и ваш обычный тестовый цикл | Сравните показатели качества по основным причинам и время рассмотрения |
| Исследования, ориентированные на первоисточники | Рабочий процесс, ориентированный на исследования, в сочетании с общей моделью логического вывода | Прежде чем соглашаться с выводами, проверьте ссылки |
| Существующие интеграции для повышения производительности | Модель, уже встроенная в ваши инструменты | Затраты на смену поставщика могут превысить выгоду от перехода на эталонный индекс |
| Наименьший счет за API | Прямые и агрегаторные маршруты — бок о бок | Цены зависят от поставщика и особенностей работы кэша |
Сайт “Руководство ”За какой ИИ стоит платить?» использует правильный вопрос при покупке: какая из повторяющихся задач станет настолько эффективной, что окупит расходы на подписку или API? Это более надежное правило принятия решений, чем погоня за новейшими позициями в рейтинге.
Ограничения и нерешенные вопросы
Версия Grok 4.7 слишком новая, чтобы сформировался широкий независимый консенсус. Имеющиеся данные оставляют открытыми несколько вопросов:
- Насколько равномерно происходит улучшение результатов при выполнении задач, связанных с программированием, исследовательской работой, написанием текстов и мультимодальными задачами?
- Сохраняет ли контекст 500K свою надежность вблизи предела, или качество извлечения ухудшается раньше?
- Насколько увеличивается задержка при максимальной интенсивности мыслительной деятельности?
- Какие потребительские тарифные планы, регионы, инструменты и ограничения по скорости влияют на работу модели?
- Как новые меры безопасности влияют на законную, но конфиденциальную техническую работу?
- Дают ли direct xAI, OpenRouter и другие поставщики существенно различающиеся результаты или ограничения?
Эти вопросы не являются поводом для отказа от модели. Они являются поводом для проведения небольшой, но репрезентативной оценки перед внедрением рабочего процесса или обещанием экономии средств.
Кому рекомендуется использовать Grok 4.7?
В первую очередь стоит протестировать Grok 4.7, если вы:
- долго заниматься отладкой кода или анализировать техническую документацию;
- работать с исходными пакетами, размер которых превышает размер обычных окон чата;
- ценить модель, которая готова приложить больше усилий при работе со сложным промтом;
- может проверять результаты, а не отправлять их сразу в производственную среду;
- сравнивают экономическую эффективность прямого использования API и использования агрегаторов.
Этот вариант будет менее подходящим, если вам требуется зрелая интеграция, четко задокументированный план использования или доказанное преимущество при выполнении тех же задач по сравнению с моделью, уже имеющейся в вашем стеке. В таких случаях уровень доступа и рабочий процесс могут оказаться важнее, чем увеличение индекса на два пункта.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
Что такое Grok 4.7?
Grok 4.7 — это версия модели xAI, выпущенная 21 сентября 2026 года и предназначенная для программирования и работы с информацией. По заявлению xAI, она дольше работает над сложными задачами, более тщательно проверяет результаты своей работы и включает новый набор мер безопасности, при этом сохраняя ту же цену и скорость, что и версия Grok 4.6.
Когда вышла версия Grok 4.7?
21 сентября 2026 года компания xAI объявила о выпуске версии Grok 4.7. Официальная страница релиза и документация для разработчиков являются лучшими источниками информации о статусе выпуска, доступности моделей и изменениях в API.
Модель Grok 4.7 лучше, чем Grok 4.6?
Согласно отчету Artificial Analysis, индекс интеллекта составляет 46, что на два пункта выше показателя Grok 4.6, а рейтинг AA-Briefcase Elo — 1 657, что на 111 пунктов выше показателя 4.6. Это полезные ориентиры, но не универсальный результат для любого рабочего процесса.
Что такое окно контекста Grok 4.7?
В разделе «Анализ искусственного интеллекта» для модели Grok 4.7 указано контекстное окно размером 500K токенов. Большое окно не гарантирует идеального поиска, поэтому перед тем, как использовать модель для работы с большими объёмами исходных данных, необходимо протестировать её на фактах, расположенных в разных местах длинного документа.
Сколько стоит Grok 4.7 API?
В отчете «Artificial Analysis» указано, что при использовании прямого API-вызова производительность составляет $2 на 1 миллион входных токенов и $6 на 1 миллион выходных токенов, а при использовании кэшированных входных данных — $0,50 на 1 миллион токенов. Перед внедрением в производственную среду ознакомьтесь с актуальной документацией по xAI.
Цена на модель Grok 4.7 от OpenRouter такая же, как у xAI?
Нет. OpenRouter указывает для своего маршрута стоимость $1,60 за 1 миллион входных токенов и $4,80 за 1 миллион выходных токенов. Это цена, специфичная для данного провайдера, и её следует сравнивать отдельно от цен xAI на прямой доступ к API. OpenRouter также отображает специфичные для провайдера показатели, такие как кэш, задержка, пропускная способность и конфиденциальность, которые могут повлиять на фактическую стоимость маршрута.
Как получить доступ к Grok 4.7?
Начните с ознакомления с официальным объявлением xAI и документацией для разработчиков, а затем выберите потребительский продукт Grok, прямой API xAI или агрегатор, например OpenRouter. Проверьте идентификатор модели, регион, ограничения по скорости, контекст и условия оплаты для того маршрута, которым вы действительно планируете пользоваться.
Доступна ли версия Grok 4.7 на платформе GlobalGPT?
В данном обзоре не утверждается, что маршрут Grok 4.7 на GlobalGPT прошел проверку. GlobalGPT можно использовать для сравнения доступных семейств моделей, однако перед покупкой следует проверить актуальный каталог и точную доступность моделей в пользовательском интерфейсе продукта.
Подходит ли Grok 4.7 для кодирующих агентов?
Это задание стоит использовать для оценки умений в области отладки в ограниченных условиях, ревью кода и логического анализа нескольких файлов, когда агент должен обосновать свои допущения и сформулировать тесты. Практическое задание по программированию было сложным, но оно не проверяло выполнение инструментов, редактирование репозитория, права доступа или полный цикл работы агента.
Почему для теста по программированию потребовалась потоковая трансляция?
Первый запрос без потоковой передачи превысил время ожидания шлюза тестового маршрута. Тот же запрос был выполнен при включенной потоковой передаче. Это демонстрирует, почему клиенты в производственной среде должны поддерживать потоковую передачу и явные таймауты; однако это не доказывает, что каждый маршрут Grok 4.7 демонстрирует одинаковое поведение в отношении задержек.
Как мне протестировать контекстное окно размером 500K?
Используйте фиксированный набор данных, в котором решающие факты расположены в начале, середине и конце, а также один намеренно введенный конфликт. Запрашивайте информацию о расположении источников и оценивайте способность воспроизведения, обработку конфликтов и задержку при различных объемах входных данных, а не полагайтесь исключительно на заявленный максимальный показатель.
Стоит ли переходить с версии Grok 4.6 на версию Grok 4.7?
Первые результаты свидетельствуют о значимом, но постепенном улучшении: показатели независимых измерений повышаются, а практические испытания продемонстрировали высокую эффективность в области отладки и синтеза исходного кода. Переходите на новую версию только после того, как ваши собственные задачи покажут снижение трудозатрат на рецензирование или повышение точности при затратах, связанных с конкретным маршрутом, которые вы можете обосновать.
Окончательный вердикт
Grok 4.7 выглядит как серьёзное, постепенное обновление модели с чёткой целью: программирование и интеллектуальный труд, где вознаграждаются постоянные усилия. В официальном релизе приводится убедительное объяснение этих изменений, предварительные данные Artificial Analysis показывают улучшение по сравнению с версией Grok 4.6, а не регрессию, а результаты наших тестов API добавляют небольшой практический сигнал. Модель особенно хорошо справилась с ошибкой параллелизма и мемо с конфликтующими источниками; её ответ по планированию был тщательным, но не настолько оперативным, как требовалось.
Объективный вывод пока носит предварительный характер. Речь идет о трёх отдельных прогонах по одному тестовому маршруту; в самом медленном задании потребовалась потоковая передача данных после истечения таймаута шлюза без поддержки потоковой передачи, при этом отсутствуют сопоставимые результаты других участников или широкий независимый консенсус. Начните с одной сложной задачи из вашего реального рабочего процесса, сравните результаты и время проверки с моделью, которую вы уже используете, а затем решите, оправдывает ли обновление затраты, связанные с конкретной трассой.









