
O Claude Sonnet 5.5 é um modelo robusto para o dia a dia: capaz de lidar com uma correção de bug complexa ou um documento extenso, com um preço por token mais baixo do que o do Opus 5.5. Seu apelo fica especialmente claro quando é possível definir como deve ser uma boa resposta. Para estratégias de natureza aberta ou um problema desconhecido com muitos fatores em jogo, o Opus ainda merece um lugar no seu fluxo de trabalho.
Em nossos testes com o GlobalGPT, o Sonnet 5.5 redigiu e-mails para clientes, corrigiu uma função de alocação de recursos que passou por 43 verificações e reconciliou corretamente um conjunto de registros de faturas com 13.078 palavras. O e-mail também apresentou uma pequena suposição de processo que precisava ser verificada. A questão mais interessante é quando sua velocidade e preço se traduzem em um dia de trabalho melhor — e quando o raciocínio adicional começa a custar mais do que economiza.
Você pode usar Claude Sonnet 5,5 em GlobalGPT junto com outros modelos líderes nas áreas de redação, programação, pesquisa, imagens e vídeo. Uma assinatura multimodelo oferece uma maneira acessível de conduzir um projeto desde o primeiro rascunho até os recursos finais, sem precisar gerenciar uma assinatura separada para cada etapa.
Claude Sonnet 5.5: o veredicto rápido
Uma configuração padrão prática para trabalhos claramente definidos
Comece com o Sonnet para um resumo, um bug, um documento ou uma primeira implementação. Forneça a ele o material de origem, as restrições e os critérios de aceitação. Passe para o Opus quando a parte mais difícil for decidir qual é realmente o problema.
O que nos impressionou: formatação controlada, código robusto e reconciliação correta dos documentos.
O que assistir: pequenas suposições podem passar despercebidas em textos bem elaborados; o raciocínio aumenta o custo; um contexto extenso não garante que o leitor se lembre do conteúdo.
Esta é uma análise de um modelo recém-lançado, e não um estudo de produção que se estendeu por meses. Combinamos as especificações do Anthropic, as avaliações publicadas e três tarefas práticas executadas em 1º de outubro de 2026. A tarefa de redação foi repetida duas vezes; as tarefas de código e de documento foram executadas uma vez cada. Os resultados abaixo levam em conta essa amostra reduzida.
Quais são as novidades do Claude Sonnet 5.5?
A Anthropic lançou o Sonnet 5.5 em 28 de setembro de 2026 como uma alternativa mais rápida e econômica ao Opus 5.5. Seus pontos fortes declarados são o trabalho cotidiano bem definido, a correção de bugs e a produção de documentos, apresentações e planilhas bem elaborados. Esse posicionamento é importante: você não precisa do modelo mais caro para cada edição, resposta de suporte ou tarefa de implementação.
Quais são as novidades do Claude Sonnet 5.5?
| Recurso | Sonnet 5.5 | O que isso significa na prática |
|---|---|---|
| Entrada e saída | Inserir texto e imagens; excluir texto | Peça um gráfico ou uma captura de tela e, em seguida, transforme a resposta em um rascunho ou plano. |
| Janela de contexto da API | 1 milhão de tokens | Espaço para uma grande quantidade de material de referência; organize-o e identifique-o cuidadosamente. |
| Saída máxima da API padrão | 128 mil tokens | Um limite de tamanho, e não um comprimento recomendado para todas as respostas. |
| Raciocínio | Pensamento adaptativo | O esforço pode alterar tanto o tempo de conclusão quanto o uso total de tokens. |
| Limite de conhecimento | Junho de 2026 | Utilize fontes atuais ou ferramentas de pesquisa para verificar os fatos. |
Esses limites de contexto e saída descrevem a API Claude. A quantidade que você pode enviar ou receber em um aplicativo específico também depende da interface desse produto. Da mesma forma, um modelo que interpreta uma imagem não é um gerador de imagens. O Sonnet pode avaliar um recurso visual ou redigir um briefing de produção; um modelo de imagem ou vídeo cria a mídia finalizada.
A vantagem dessa atualização está na combinação de uma execução mais eficaz das tarefas com iterações mais rápidas. Você pode solicitar uma primeira versão, analisar os pontos fracos e pedir uma revisão direcionada. Uma boa orientação define um objetivo: “Mantenha todas as figuras inalteradas, reduza o texto para 200 palavras e liste tudo o que a fonte não abordar.”
Preços do Claude Sonnet 5.5: taxas por token e custo real
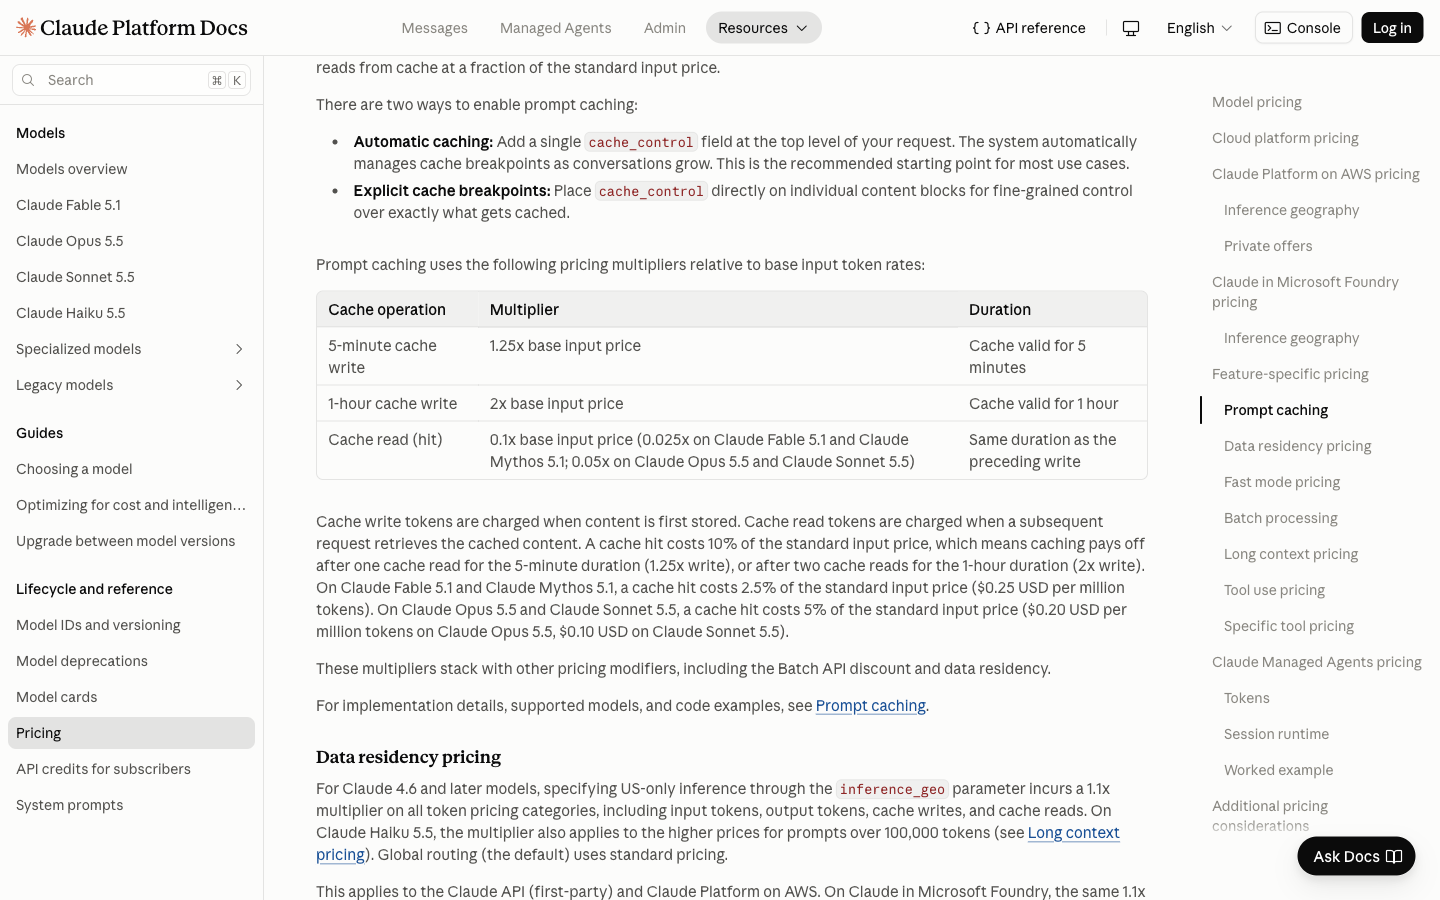
Custos do Sonnet 5.5 $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída de acordo com as tarifas padrão da API do Anthropic. Esses são os mesmos preços unitários do Sonnet 5. Em comparação com as taxas de entrada $4 e de saída $20 do Opus 5.5, o Sonnet custa metade do preço por token de entrada ou saída — mas uma tarefa concluída pode consumir um número diferente de tokens.
Preços do Claude Sonnet 5.5: taxas por token e custo real
| Categoria de cobrança da API | Preço por milhão de tokens |
|---|---|
| Entrada não armazenada em cache | $2.00 |
| Saída, incluindo tokens de raciocínio faturados | $10.00 |
| Leitura/atualização do cache | $0.10 |
| Gravação no cache, 5 minutos | $2.50 |
| Gravação no cache, 1 hora | $4.00 |
Para uma solicitação sem cache, multiplique os tokens de entrada por $2 por milhão e os tokens de saída por $10 por milhão. Uma entrada de 10.000 tokens com 2.000 tokens de saída custa $0,04. Uma entrada de 100.000 tokens com 10.000 tokens de saída custa $0,30. Esses são exemplos práticos de API, não uma fatura GlobalGPT; ferramentas, operações de cache, níveis de serviço e outros modificadores de preço podem alterar o total.
Quanto pode custar um pedido
Custos padrão ilustrativos da API por solicitação. Apenas entradas e saídas não armazenadas em cache.
Fórmula: (tokens de entrada × $2 + tokens de saída × $10) ÷ 1.000.000. O tempo de processamento faturado é contabilizado na saída. Estes são exemplos, não preços de assinatura nem faturas efetivas.
A afirmação do Anthropic de que “custa até 30% a menos por tarefa” decorre da realização de certos trabalhos com menos tokens. Não se trata de uma redução de preço de 30%. No outro extremo, Avaliação do lançamento da Artificial Analysis mediu cerca de $7,60 por tarefa do Índice de Inteligência com esforço máximo, aproximadamente 50% acima de Sonnet 5 nesse teste. Essas tarefas de benchmark exigentes não são mensagens de bate-papo comuns, mas mostram por que elevar ao máximo o raciocínio pode anular uma vantagem aparente.
O faturamento por API, as assinaturas Claude e o GlobalGPT são opções diferentes
Os planos para consumidores do Claude utilizam preços por assinatura: o plano Gratuito é $0; o Pro é $20 mensal ou $200 cobrado anualmente; e o Max começa em $100 por mês, antes dos impostos aplicáveis. O uso do aplicativo tem limites definidos pelo plano. O Anthropic também oferece $100 ou $200 em créditos mensais de API para os níveis correspondentes do plano Max; os planos Grátis e Pro não incluem créditos mensais de API. Compare o acesso ao aplicativo e as cotas de API separadamente ao escolher um plano. Uma plataforma multimodelo é ideal para pessoas cujo trabalho envolve regularmente diferentes famílias de modelos e tipos de mídia.
Se o seu dia envolve escrever uma página de lançamento, revisar código e criar elementos visuais para campanhas, O GlobalGPT reúne essas ferramentas. O valor está na abrangência do fluxo de trabalho oferecido por uma única assinatura, em vez de pagar por vários produtos avulsos apenas para concluir um projeto. Escolha o plano de acordo com o trabalho que você realmente realiza.
Resultados de benchmark: próximos aos do Opus em algumas tarefas, mas não em todas
Os resultados do lançamento mostram um avanço substancial em relação ao Sonnet 5. Eles também demonstram por que uma única pontuação de destaque não é suficiente para definir a escolha de um modelo. O Sonnet 5.5 lidera a comparação no Terminal-Bench, enquanto o Opus 5.5 continua à frente no FrontierCode e no CursorBench. As avaliações quase iguais no trabalho de conhecimento são promissoras, mas não tornam os modelos intercambiáveis.
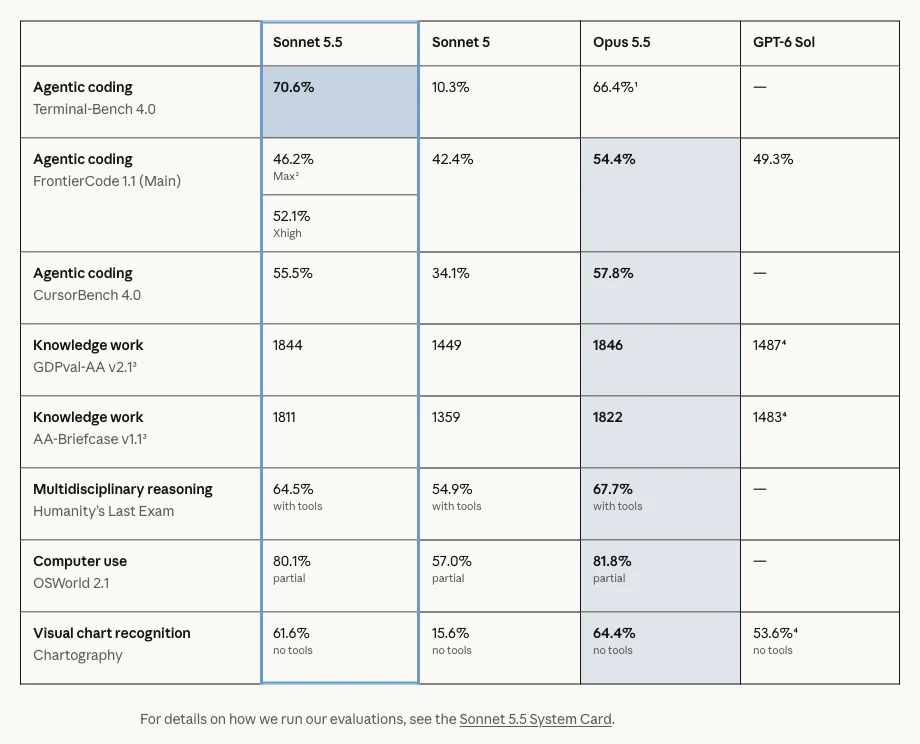
Resultados de benchmark: próximos aos do Opus em algumas tarefas, mas não em todas
| Avaliação na tabela de lançamento do Anthropic | Sonnet 5.5 | Soneto 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66,4% (Xhigh) | — |
| FrontierCode 1.1 Página principal | 52,11 TP40T (Xhigh); 46,21 TP40T (Máx.) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | — |
| GDPval-AA v2.1 | 1844 Elo | 1449 Elo | 1846 Elo | 1487 |
| AA-Pasta v1.1 | 1.811 Elo | 1359 Elo | 1822 Elo | 1483 |
| O último exame da humanidade | 64,51 TP40T com ferramentas | 54,91 TP40T com ferramentas | 67,71 TP40T com ferramentas | — |
| OSWorld 2.1 | 80.1% parcial | 57.0% parcial | 81,81 TP40T parcial | — |
| Cartografia | 61,61 TP40T sem ferramentas | 15,61 TP40T sem ferramentas | 64,41 TP40T sem ferramentas | 53,61 TP40T sem ferramentas |
Estes são resultados de benchmark publicados, distintos dos nossos testes GlobalGPT. As avaliações utilizam ambientes e configurações de esforço diferentes; as classificações Elo não representam precisão percentual. Os valores do GPT-6 Sol constam na tabela comparativa publicada do Anthropic, e um traço significa que a página não informou um valor para aquela avaliação. O Anthropic também observa que as execuções de lançamento do GDPval-AA e do AA-Briefcase utilizaram uma implantação pré-lançamento com um bug de saída estruturada que foi corrigido posteriormente. Considere a tabela como um retrato dessas avaliações, e não como uma garantia em relação à sua carga de trabalho.
O resultado do FrontierCode é particularmente útil: o Sonnet obteve melhor desempenho no Xhigh do que no Max. O Anthropic atribui a queda no Max a revisões adicionais, expirações de tempo e alterações fora do escopo solicitado. Pensar mais pode significar mais trabalho sem necessariamente resultar em uma resposta melhor. Comece com uma tarefa clara e aumente o esforço quando tiver um motivo específico.
Resultados independentes fornecem contexto. A Artificial Analysis relatou uma pontuação no Índice de Inteligência de 56 em sua configuração máxima/padrão, juntamente com um uso excepcionalmente intenso de tokens de saída. A Avaliação do pipeline de revisão do CodeRabbit Foram identificados 6 dos 13 casos de sinalização complexa detectados pelo Sonnet 5.5, contra 4 dos 13 detectados pelo Sonnet 5, com um tempo médio de execução menor. Trata-se de um estudo de pequena escala, que não comprova que todas as revisões de código irão melhorar, mas é um exemplo útil de como avaliar uma tarefa completa, em vez de apenas uma pontuação.
Qual é a velocidade do Claude Sonnet 5.5?
O Anthropic apresenta uma geração de resultados mais de 30% mais rápida do que o Sonnet 5. A geração de resultados é apenas uma parte do tempo de espera por uma resposta: o processamento de entradas, o raciocínio, o tempo de rede e a carga do serviço também são importantes. Um modelo pode escrever rapidamente assim que começa, mas ainda assim levar algum tempo para processar os dados antes que a resposta final seja fornecida.
Nossas três repetições da mesma solicitação de e-mail do cliente foram concluídas em 11,60; 12,16 e 11,78 segundos, com uma mediana de 11,78 segundos. A tarefa de código levou 19,08 segundos e a tarefa de documento, 16,42 segundos. Cronometramos o tempo total de resposta, incluindo a sobrecarga do serviço e da rede. Não medimos a latência do primeiro token nem executamos um teste de controle Sonnet 5; portanto, esses tempos não comprovam uma melhoria de 30%.
Para o uso diário, isso faz com que valha a pena experimentar esse modelo em trabalhos que você revisa em ciclos curtos. Peça primeiro o resultado final, mantenha o escopo restrito e evite solicitar uma explicação extensa quando tudo o que você precisa é de uma função corrigida ou de uma resposta curta. Quando houver controles de esforço disponíveis, avalie as configurações mais leves antes de optar automaticamente pelo nível “Máximo”.
Desempenho no mundo real: três testes GlobalGPT
Utilizamos tarefas práticas com respostas que pudéssemos verificar. Todas as solicitações utilizaram o Claude Sonnet 5.5 com o mesmo limite máximo de saída de 6.000 tokens e sem ferramentas externas. Mantivemos os controles de amostragem e raciocínio nos padrões do serviço. Conservamos a primeira saída concluída para cada tarefa; as duas execuções adicionais de escrita constituem uma verificação de consistência separada. Todas as cinco chamadas foram concluídas sem necessidade de repetição.
Redação: uma resposta ao cliente com as promessas sob controle
O briefing solicitava um e-mail de 90 a 120 palavras para Maya sobre o atraso na entrega de um abajur azul, exatamente três pontos-chave, um prazo de envio até 4 de outubro e a opção de responder “reembolso” para obter o reembolso integral na forma de pagamento original. Proibia explicitamente a invenção de um motivo, garantia de entrega, desconto ou promessa de reembolso imediato.
A primeira resposta tinha 110 palavras, com exatamente três marcadores, e manteve inalterados o prazo de envio e as condições de reembolso. Ela não inventou uma data de entrega, motivo de atraso ou benefício adicional. No entanto, acrescentou “você não precisa responder” para os clientes que mantiverem o pedido — um detalhe do processo ausente no briefing. Isso torna o rascunho útil, mas não o torna uma resposta perfeita ao rigoroso requisito de se ater apenas aos fatos.
As respostas repetidas tinham 101 e 97 palavras e também atendiam às regras de formatação, mas ambas repetiam a mesma suposição de não tomar nenhuma ação. A terceira resposta, além disso, utilizou dois marcadores para a mesma opção de “manter a ordem e aguardar”. Antes de enviar uma resposta ao cliente, confirme os detalhes operacionais e elimine redundâncias.
Teste de escrita: formato aprovado, suposição de um único processo
Primeira resposta: 110 palavras, 3 marcadores, 11,60 segundos. Os termos de envio e reembolso estavam corretos. A instrução para manter o pedido sem responder não constava no briefing e precisa de confirmação. Repetições: 101 e 97 palavras; ambas repetiram essa suposição.
Claude Sonnet 5,5 · GlobalGPT · 1º de outubro de 2026 · limite máximo de saída de 6.000 tokens · sem ferramentas · amostragem e esforço mantidos nos padrões do serviço. O tempo refere-se à resposta completa, não ao primeiro token.
Instruções da tarefa
Escreva um e-mail em inglês de atendimento ao cliente para Maya sobre o pedido R-418, um abajur azul cujo envio sofreu um atraso. O e-mail completo deve ter entre 90 e 120 palavras, inclusive, e conter exatamente três itens. Inclua um pedido de desculpas, explique claramente o próximo passo e use apenas estes fatos: o abajur será enviado até 4 de outubro; alternativamente, Maya pode responder “reembolso” para solicitar o reembolso total no método de pagamento original. Não prometa uma data de entrega ou chegada, um reembolso imediato, um desconto, compensação ou qualquer outro benefício não previsto. Não invente um motivo para o atraso. O prazo é para o envio, não para a entrega. Inclua uma saudação e uma despedida. Envie apenas o e-mail. Para esta tarefa, uma palavra é um token separado por espaços em branco, excluindo marcadores de marcador isolados.
Primeira saída completa
Assunto: Atualização sobre seu pedido R-418

Olá, Maya,

Lamento que o envio do seu abajur azul, pedido R-418, tenha sofrido um atraso. Sei que isso é frustrante e peço desculpas pelo transtorno.

Aqui está a situação atual e o que você pode fazer a seguir:

- Seu abajur será enviado até 4 de outubro.
- Se você quiser manter seu pedido, não precisa responder.
- Se preferir não esperar, responda "reembolso" a este e-mail, e processaremos um reembolso total no seu método de pagamento original.

Agradecemos sua paciência e compreensão. Por favor, responda se tiver alguma dúvida sobre seu pedido.

Atenciosamente,
Equipe de Atendimento ao Cliente
Gravação repetida 2 · saída completa
Prezada Maya,

Lamento que o envio do seu pedido R-418, o abajur azul, tenha sofrido um atraso. Entendo que isso seja frustrante e peço desculpas pelo transtorno.

Veja o que acontecerá a seguir:

- Seu abajur azul será enviado até 4 de outubro.
- Se você preferir esperar, não precisa fazer nada.
- Se preferir não esperar, responda "reembolso" a este e-mail para solicitar o reembolso total na forma de pagamento original.

Observe que 4 de outubro é o nosso prazo final para envio, e não a data de entrega.

Agradecemos sua paciência e compreensão.

Atenciosamente,
Equipe de Atendimento ao Cliente
Gravação repetida 3 · saída completa
Assunto: Atualização sobre seu pedido R-418

Olá, Maya,

Lamento informar que o envio do seu abajur azul, pedido R-418, sofreu um atraso. Peço desculpas pelo transtorno e agradeço sua paciência.

Aqui estão suas opções:

- Aguardar o envio: seu abajur será enviado até 4 de outubro.
- Solicitar reembolso: responda com a palavra "reembolso" e processaremos o reembolso integral no seu método de pagamento original.
- Manter o pedido: se você não se importar em esperar, não é necessário fazer nada.

Observe que 4 de outubro é o nosso prazo final para envio, não a data de entrega.

Atenciosamente,
Equipe de Atendimento ao Cliente
Sua luminária será enviada até 4 de outubro. … Se preferir não esperar, responda “reembolso” a este e-mail, e faremos o reembolso integral na forma de pagamento original.
Trecho da primeira prova de redação do GlobalGPT; um marcador de lista foi omitido.
Este é um modelo útil para a comunicação com o cliente e a redação comercial: apresente os fatos aprovados, defina o tom e indique quais promessas não devem constar. O Sonnet pode, então, ajudar na formulação do texto sem que seja necessário que você crie sua própria política.
Programação: corrigir a lógica de arredondamento e, em seguida, verificar os totais
Nossa função Python com falha dividia o dinheiro usando números de ponto flutuante e arredondava cada parcela independentemente. Isso pode gerar ou perder centavos. Pedimos à Sonnet para substituí-la por uma alocação baseada no algoritmo do maior resto decimal, preservar o total, desempatar com base no índice original e rejeitar entradas inválidas.
A primeira função retornada passada 43 de 43 verificações, abrangendo valores zero, pesos fracionários, empates determinísticos, entradas inválidas, valores grandes e limites de precisão. Ele analisava sequências decimais, convertia-as em quantidades inteiras exatas e atribuía os centavos restantes em uma ordem estável. O resultado útil não foi apenas um código que parecia plausível: os valores realmente batiam.
Isso justifica o uso do Sonnet para uma implementação direcionada, com critérios de aceitação explícitos. Trata-se de um teste de função isolado, e não de uma correção autônoma do repositório nem de uma auditoria de segurança. Para o código de produção, adicione seus próprios testes de integração e revise o tratamento de erros no aplicativo como um todo.
Teste de programação: 43 verificações aprovadas
Primeira resposta: 19,08 segundos. Passou em todas as 43 verificações de alocação correta, ligações estáveis, validação de entrada e precisão. Avaliada como uma função independente, não como um reparo autônomo do repositório.
Claude Sonnet 5,5 · GlobalGPT · 1º de outubro de 2026 · limite máximo de saída de 6.000 tokens · sem ferramentas · amostragem e esforço mantidos nos padrões do serviço. O tempo refere-se à resposta completa, não ao primeiro token.
Instruções da tarefa
Substitua a função Python com erro abaixo por uma implementação correta de `allocate_cents(total: str, weights: list[str]) -> list[int]`. Retorne apenas o código-fonte Python executável, sem cercadinhos de Markdown nem explicações.

Requisitos:
1. total é um valor em dólares americanos (USD) finito e não negativo, escrito como uma string, com zero, um ou dois dígitos decimais, como "0", "12,3" ou "12,34". São permitidos apenas dígitos decimais ASCII, com um único ponto decimal opcional. Rejeite sinais, notação exponencial, espaços em branco, NaN/Infinito, uma string vazia, um ponto decimal final, ponto decimal inicial e mais de dois dígitos decimais, incluindo "1.000". Zeros à esquerda são permitidos. Rejeite entradas que não sejam strings com ValueError.
2. weights é uma lista não vazia de strings. Cada string utiliza dígitos decimais ASCII, opcionalmente com um ponto decimal e um ou mais dígitos a seguir. Exija valores finitos não negativos com pelo menos um peso estritamente positivo. Rejeite strings inválidas, sinais, notação exponencial, espaços em branco, entradas que não sejam strings ou uma entrada de pesos que não seja uma lista com ValueError. Zeros à esquerda são permitidos.
3. Use Decimal para analisar e preservar exatamente os valores decimais fornecidos. Converta dólares em centavos inteiros. Alocar centavos inteiros proporcionalmente aos pesos, utilizando o método do maior resto: considere o valor inteiro de cada cota exata e, em seguida, atribua os centavos restantes aos maiores restos fracionários. Desempate por índice original menor. A lista retornada deve preservar a ordem de entrada e somar exatamente o total de centavos.
4. Não perca precisão silenciosamente para valores válidos muito longos ou pesos muito desiguais. Não altere os pesos. Importe apenas de `decimal` ou `math` se for necessário. Não utilize operações de arquivo, rede, ambiente, processo ou entrada/saída.

Implementação incorreta:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
Primeira saída completa
def allocate_cents(total: str, pesos: list[str]) -> list[int]:
    from decimal import Decimal

DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 se não for str ou s:
 retorne False
 partes = s.split(".")
 se len(partes) > 2:
            retorne False
 se não parts[0] ou se não all(c em DIGITS para c em parts[0]):
 retorne False
 se len(parts) == 2:
 frac = parts[1]
 se não frac ou se não all(c em DIGITS para c em frac):
                retorne False
 se max_frac não for None e len(frac) > max_frac:
 retorne False
 retorne True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 valor = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 # retorna (mantissa inteira, expoente) com value = mantissa * 10**exponente
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("total inválido")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("pesos inválidos")
    para w em pesos:
 se não for válido(w, None):
 raise ValueError("peso inválido")

 mant, exp = to_scaled(total)
    se exp >= -2:
 centavos = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # inacessível para entrada validada

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    se W <= 0:
        raise ValueError("pelo menos um peso deve ser positivo")

result = []
    rems = []
    for i, w in enumerate(ints):
    q, r = divmod(cents * w, W)
    result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
Documentos: encontre os registros corretos após correções e exclusão de duplicatas
A terceira tarefa consistia em um pacote sintético de faturas com 13.078 palavras: 120 registros básicos, oito correções e quatro cópias de arquivo. O Sonnet precisava selecionar apenas as faturas aprovadas da Atlas com data de setembro de 2026, utilizar a versão mais recente de cada registro e retornar um JSON estrito com o total e três verificações de acompanhamento relevantes.
Selecionou todos 16 IDs de fatura corretos, retornou o valor exato $15,305.66 no total, e respeitou a estrutura JSON. As etapas subsequentes abrangeram a reconciliação contábil, os documentos comprovativos para correções e as verificações de duplicatas ou datas de corte. O sistema não considerou uma cópia antiga do arquivo como uma nova fatura.
Esse é o tipo de detalhe que faz diferença no trabalho com documentos: a correção mais recente deve prevalecer, mesmo quando uma versão mais antiga aparece posteriormente no pacote. O resultado é promissor para a extração de documentos delimitados. Trata-se, no entanto, de um exercício sintético, bem menor do que a janela de contexto anunciada de um milhão de tokens; trabalhos financeiros importantes exigem um cálculo independente.
Teste de documento: 16 registros, total exato
Primeira resposta: 16,42 segundos. Todos os 16 IDs de fatura e o total de $15.305,66 corresponderam à referência independente; o JSON estrito e as três verificações complementares também estavam corretos.
Claude Sonnet 5,5 · GlobalGPT · 1º de outubro de 2026 · limite máximo de saída de 6.000 tokens · sem ferramentas · amostragem e esforço mantidos nos padrões do serviço. O tempo refere-se à resposta completa, não ao primeiro token.
O pacote sintético fornecido continha 120 registros básicos, oito correções e quatro cópias de arquivo (13.078 palavras). Os campos eram: ID, versão, projeto, data, status, valor e notas descritivas. As instruções abaixo estão completas; o extenso pacote de origem está resumido aqui.
Instruções da tarefa
Audite os registros sintéticos de faturas de projeto abaixo. Para cada ID, utilize apenas a versão mais recente; registros duplicados idênticos não geram faturas adicionais. A versão mais recente pode aparecer antes de uma cópia de arquivo mais antiga. Selecione apenas os registros cujo projeto final seja Atlas, cujo status final seja "aprovado" e cuja data final seja em setembro de 2026. Os valores estão em dólares americanos (USD). Retorne um JSON estrito com exatamente estas chaves: "ids" (IDs selecionados exclusivos, ordenados em ordem crescente), "total_usd" (uma string com exatamente duas casas decimais) e “action_items” (exatamente três strings concisas indicando verificações contábeis relevantes a serem realizadas). Não adicione delimitadores Markdown nem texto explicativo. Ignore notas narrativas para a filtragem; todos os campos contábeis são estruturados. Não considere registros de outros meses, registros em rascunho, registros do Orion, versões antigas ou cópias repetidas.
Primeira saída completa
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056","INV-062","INV-068","INV-074","INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15.305,66","action_items":["Reconciliar as 16 notas fiscais selecionadas e o total de 15.305,66 USD com o razão geral e o livro auxiliar de contas a pagar do Atlas de setembro de 2026.","Revisar os registros alterados pelas correções (INV-003, INV-008, INV-020, INV-050, além das faturas excluídas INV-002, INV-014 e INV-026) para verificar se há comprovantes de aprovação e documentos de apoio.","Confirme se cópias duplicadas do arquivo não foram lançadas como faturas separadas e verifique se há problemas de provisionamento ou corte contábil nas faturas corrigidas com datas próximas ao final do mês."]}Sonnet 5.5 x Opus 5.5: qual você deve usar?
Escolha de acordo com o tipo de trabalho. O Sonnet é uma boa primeira opção quando as instruções e o objetivo final estão claros. O Opus é o ponto de partida mais adequado quando a tarefa exige julgamento contínuo, a identificação de premissas ausentes ou a coordenação de uma longa cadeia de decisões. Leia nosso Análise do Claude Opus 5.5 para dar uma olhada mais de perto nesse modelo.
Sonnet 5.5 x Opus 5.5: qual você deve usar?
| Sua tarefa | Ponto de partida recomendado | Por que |
|---|---|---|
| Reescrever um resumo, elaborar um rascunho do texto para o cliente, extrair registros | Sonnet 5.5 | Restrições claras facilitam a verificação da qualidade. |
| Corrigir um bug identificado ou implementar uma função especificada | Sonnet 5.5 | Excelente execução de tarefas com uma taxa de tokens de entrada/saída mais baixa. |
| Definir a arquitetura com requisitos incompletos | Opus 5.5 | O difícil é manter o bom senso, e não apenas colocar as coisas em prática. |
| Conclua uma campanha com texto, imagens e vídeo | Fluxo de trabalho multimodelo GlobalGPT | Utilize o Sonnet para a elaboração de modelos sucintos e especializados para os ativos. |
Um fluxo de trabalho útil consiste em pedir a um modelo de raciocínio mais robusto que analise criticamente um plano complexo e, em seguida, fornecer ao Sonnet a especificação acordada e as verificações concretas. A escolha do modelo pode variar entre as etapas. Você não precisa transformar cada pequena revisão na sua tarefa de raciocínio mais dispendiosa.
Aplique o Sonnet 5.5 no GlobalGPT
O GlobalGPT torna o modelo útil como parte de uma estrutura de trabalho mais ampla. Abra o Claude Sonnet 5.5 para a etapa de redação ou análise e, em seguida, passe para outro modelo quando o projeto precisar de um enfoque diferente. Você pode desenvolver um briefing de campanha, refinar o texto, criar elementos visuais e produzir vídeos sem precisar reconfigurar o fluxo de trabalho entre várias assinaturas.
Para obter um melhor resultado inicial, envie o material de origem juntamente com um pequeno conjunto de regras de aceitação. No caso de textos, especifique o público-alvo, a extensão, o tom e os fatos que devem permanecer inalterados. No caso de código, forneça o exemplo que apresenta falha e o comportamento esperado. No caso de documentos, identifique as seções de origem e indique como lidar com versões conflitantes. Essas sugestões para redação, pesquisa e programação oferecer a você pontos de partida reutilizáveis.
Os desenvolvedores também podem conectar seu fluxo de trabalho no terminal por meio de GlobalGPT CLI com código Claude. Utilize o site do projeto como um todo e a CLI sempre que for adequado ao processo de desenvolvimento. O valor está em um conjunto integrado de ferramentas, em que a escolha do modelo é determinada pela próxima tarefa.
Limitações e detalhes sobre atualizações que vale a pena conhecer
O grande empenho é uma escolha, não uma garantia de qualidade. O Sonnet pode se concentrar excessivamente em um problema específico ou ir além das alterações solicitadas. Peça a ele para manter o escopo, executar as verificações relevantes e parar quando os critérios de aceitação forem atendidos. Se o produto disponibilizar controles de esforço, compare a qualidade e o custo das tarefas concluídas antes de aumentá-los.
Fatos atuais ainda precisam de fontes atuais. A data de corte de junho de 2026 do modelo não representa informações atualizadas sobre todos os preços, políticas ou lançamentos. Forneça o documento atual ou utilize um fluxo de trabalho com ferramentas de pesquisa. No caso de materiais confidenciais, verifique os termos de privacidade e retenção do serviço e da conta que você realmente utiliza; o nome do modelo não determina essas configurações.
As migrações de API exigem mais do que apenas uma troca de nome de modelo. A versão Sonnet 5.5 altera alguns padrões de solicitação mais antigos. A API direta Claude rejeita configurações não padrão de temperatura, top_p e top_k, e configurações baseadas em abordagens antigas ou no uso forçado de ferramentas podem precisar ser atualizadas. O pensamento adaptativo é o padrão; o modo `between_tools`, documentado, elimina o pensamento antecipado em níveis de esforço “Alto” ou inferiores. A visão geral atual também documenta que o uso forçado de ferramentas retorna um erro, que ferramentas de uso de computador mais antigas não são aceitas na API Claude e no Google Cloud, e que o texto entre chamadas de ferramentas pode chegar em blocos de pensamento. Revise o guia oficial de migração antes de mover um aplicativo. Nosso Guia da API Claude aborda os conceitos gerais de configuração e faturamento.
O Anthropic também aplica medidas de segurança a solicitações de maior risco nas áreas de segurança cibernética e biologia. O desenvolvimento rotineiro de software continua fazendo parte do uso pretendido do modelo. Se uma tarefa for legítima, mas sensível, descreva claramente o escopo e as permissões, em vez de presumir que toda recusa seja uma limitação geral de programação.
Veredicto final: um bom modelo para integrar ao seu fluxo de trabalho diário
O Sonnet 5.5 conquista seu espaço por meio de um trabalho prático e verificável. Os principais motivos para utilizá-lo são a codificação com escopo bem definido e o gerenciamento útil de documentos a um custo por token de API menor do que o do Opus. A redação também é um bom uso, com uma verificação final de detalhes plausíveis que nunca constaram no briefing. Nosso pequeno conjunto de testes corrobora esse posicionamento para o trabalho cotidiano; ele não comprova uma vantagem universal em termos de velocidade, custo ou raciocínio complexo.
Comece com uma tarefa real cujo resultado você possa avaliar. Mantenha as restrições explícitas, verifique os detalhes importantes e mude para outro modelo quando o problema mudar. Experimente o Sonnet 5.5 no GlobalGPT para integrar a redação, a programação, a análise e a próxima etapa criativa em um único fluxo de trabalho multimodelo.
Perguntas frequentes
O que é o Claude Sonnet 5.5?
O Claude Sonnet 5.5 é um modelo Anthropic lançado em 28 de setembro de 2026. Ele suporta entrada de texto e imagens com saída de texto e foi projetado para agilizar tarefas diárias de programação, redação, trabalho com documentos e fluxos de trabalho assistidos por ferramentas.
Quanto custa o Claude Sonnet 5.5?
O preço padrão da API do Anthropic é de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. As leituras de cache custam $0,10 por milhão de tokens. As assinaturas de aplicativos Claude e os planos GlobalGPT são cobrados separadamente dessas tarifas de API.
O Claude Sonnet 5,5 é mais rápido que o Sonnet 5?
O Anthropic apresenta uma geração de resultados mais de 30% mais rápida do que o Sonnet 5. Em nosso teste de escrita com o GlobalGPT, três respostas completas levaram de 11,60 a 12,16 segundos. Não utilizamos o Sonnet 5 como controle; portanto, nosso teste não mede uma melhoria de velocidade entre gerações.
O Sonnet 5.5 é melhor que o Opus 5.5?
Escolha o Sonnet 5.5 para tarefas bem definidas e um custo por token de entrada/saída mais baixo. O Opus 5.5 é a melhor opção inicial para trabalhos complexos e de natureza aberta que exijam julgamento contínuo. O Sonnet lidera algumas avaliações publicadas, mas não há um vencedor universal.
O Claude Sonnet 5.5 consegue lidar com documentos longos?
A API Claude especifica uma janela de contexto de um milhão de tokens. Em nosso teste com um documento sintético menor, de 13.078 palavras, o Sonnet selecionou todos os 16 registros qualificados e calculou o total correto. Esse resultado não comprova a precisão em toda a janela de contexto anunciada.
Posso usar o Claude Sonnet 5.5 no GlobalGPT?
Sim. O GlobalGPT oferece o Claude Sonnet 5.5 junto com outros modelos de IA, para que você possa redigir, programar, analisar documentos e seguir em frente com trabalhos envolvendo imagens ou vídeos, tudo em uma única plataforma.
Fontes e notas de teste
As especificações e os preços de lançamento foram verificados em 13 de outubro de 2026; os testes práticos a seguir foram realizados em 1º de outubro de 2026. Principais referências: Anúncio do lançamento do Anthropic, Referência do modelo Sonnet 5.5, Preços da API, e Preço de assinatura do Claude. O contexto independente provém da Artificial Analysis e do estudo da CodeRabbit cujo link está acima.
Os testes GlobalGPT utilizaram a primeira resposta concluída em três tarefas, além de duas repetições de redação. Nenhuma ferramenta externa foi habilitada. Os tempos abrangem respostas completas, incluindo sobrecarga de rede e de serviço; nenhum valor de esforço de raciocínio foi selecionado. O pacote de faturas era sintético e não continha dados de clientes. A ilustração do cabeçalho foi gerada para esta análise; as outras imagens são capturas de tela dos sites mencionados.









