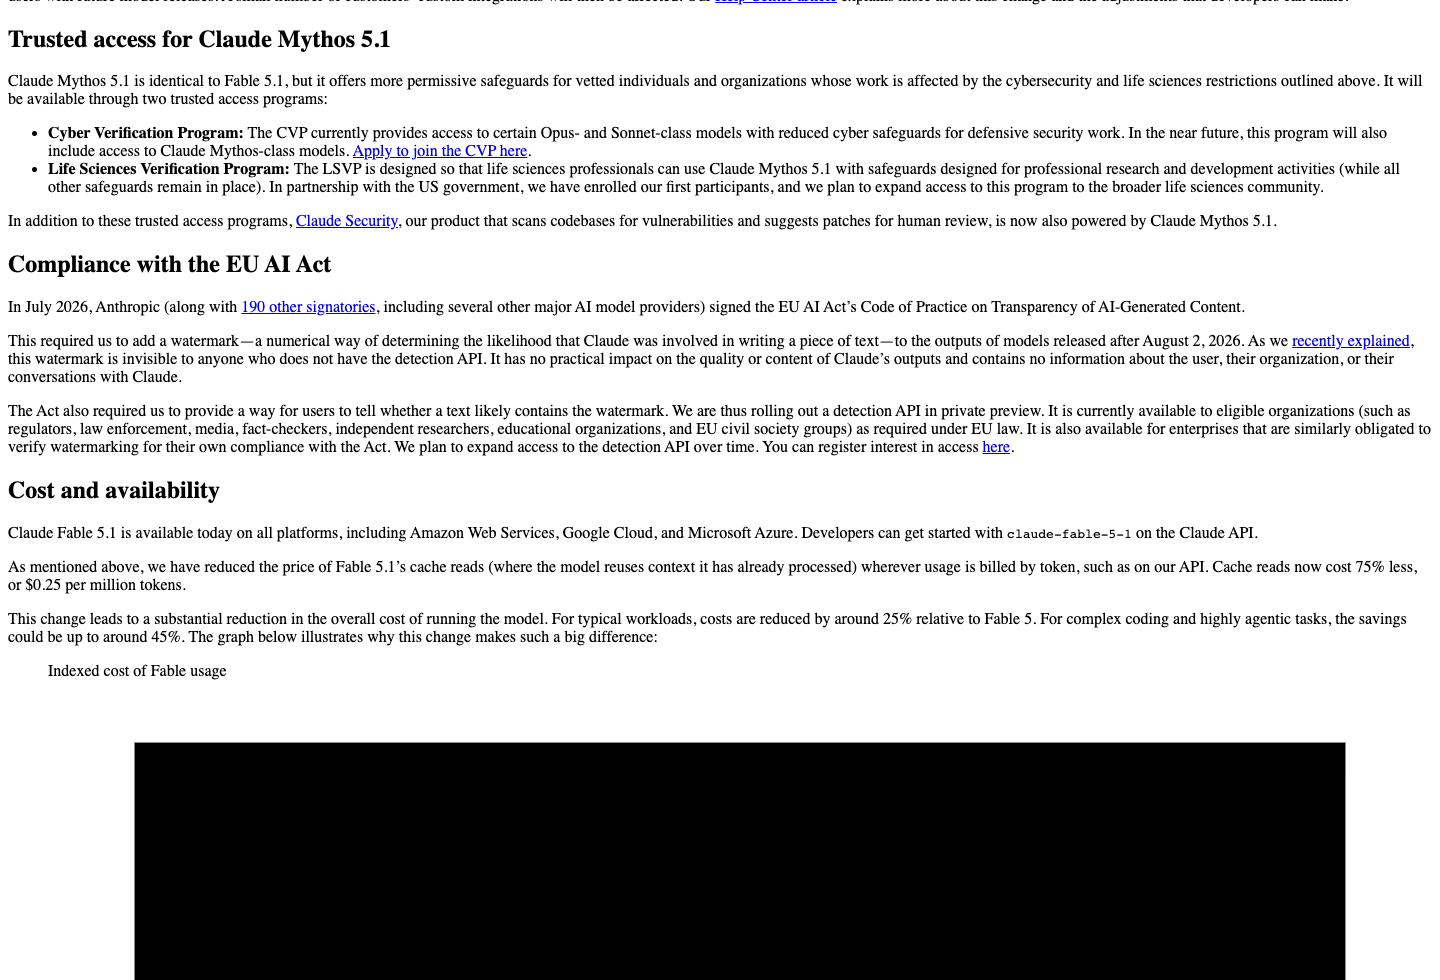
O Claude Fable 5.1 é o novo modelo de disponibilidade geral do Anthropic para programação, trabalho intelectual, resolução de problemas de longa duração e pesquisa científica. Foi lançado em 1º de setembro de 2026. A principal mudança não é um aumento no preço de tabela da API: a entrada permanece em $10 por milhão de tokens e a saída permanece em $50. Em vez disso, a versão Anthropic reduziu o preço da leitura em cache para $0,25 por milhão de tokens e estima custos mais baixos para cargas de trabalho que reutilizam muito contexto.
Isso faz com que o Fable 5.1 mereça uma análise cuidadosa quando seu trabalho depende de documentos longos, contextos repetitivos ou análises cuidadosamente restritas. Ele não torna todas as rotas de acesso idênticas, nem transforma um benchmark de fornecedor em um veredicto independente. A pergunta relevante é mais simples: a rota que você planeja usar oferece o contexto, os controles, os termos de privacidade e o comportamento do modelo de que seu fluxo de trabalho precisa?
Para equipes que comparam várias famílias de modelos em um único lugar, O espaço de trabalho multimodelo do GlobalGPT é uma opção prática além da rota oficial. É útil para comparar os modelos disponíveis para a mesma tarefa; verifique o diretório atual e planeje a cobertura antes de considerar qualquer plataforma como seu caminho de acesso Fable 5.1.

O que é o Claude Fable 5.1?
A Anthropic lançou o Fable 5.1 juntamente com o Mythos 5.1. A empresa os descreve como o mesmo modelo básico, mas com diferentes medidas de segurança e regras de acesso: o Fable está disponível ao público em geral, enquanto o Mythos é reservado para programas de acesso confiável nas áreas de segurança cibernética e ciências da vida. Essa distinção é importante. Os recursos do Mythos não devem ser interpretados como um acesso comum do Fable.
O Anthropic posiciona o Fable 5.1 em torno da codificação, do trabalho intelectual, da resolução de problemas de longo prazo e da pesquisa científica. Essas são afirmações sobre o produto, não uma promessa de que todas as plataformas de API ofereçam as mesmas ferramentas ou limites.
O que torna esse lançamento mais significativo do que uma simples renomeação de modelo é a combinação de capacidade, controles de esforço, economia de cache e um limite de implantação mais explícito. Para um desenvolvedor, isso pode significar um modelo mais fácil de justificar em tarefas com contextos repetitivos. Para uma equipe de pesquisa, significa separar uma resposta sólida, limitada à fonte, de um fluxo de trabalho que ainda requer acesso a ferramentas, revisão humana e termos de retenção específicos para cada rota.
- Use-o para: diagnóstico de código, síntese de documentos, análise com muitas restrições e interpretação de imagem para texto.
- Verifique primeiro: limites de contexto, disponibilidade de ferramentas, retenção de dados, região e acesso ao plano na rota escolhida.
- Não deduza que: que o acesso ao Mythos, uma especificação específica para a nuvem ou um benchmark oficial se aplique automaticamente à sua conta.
Identidade em resumo
Onde é possível acessar o Claude Fable 5.1?
A Anthropic informa que o Fable 5.1 está disponível em todas as suas plataformas e cita a AWS, o Google Cloud e o Microsoft Azure. Na API da Anthropic, o identificador do modelo é claude-fábula-5-1. Na rota do AWS Bedrock, as regras documentadas relativas ao contexto, saída, entrada, cache e retenção fazem parte da documentação da AWS e não devem ser consideradas válidas para todas as outras rotas.
- API Anthropic: utilize o identificador do modelo documentado e os limites atuais da plataforma.
- AWS Bedrock: A AWS especifica, para sua rota, uma janela de contexto de 1 milhão de tokens, saída máxima de 128 mil, entrada de texto e imagem e saída de texto.
- Outras rotas na nuvem: Confirme a região, o plano, o suporte a ferramentas e o tratamento de dados antes da migração.
Rotas de acesso: o que é transferível e o que não é
Leia cada especificação como específica para cada rota. O nome de um modelo, por si só, não garante os mesmos limites, entradas, ferramentas ou termos relativos aos dados.
ID do modelo:
claude-fábula-5-1Limites atuais, regiões e controles compatíveis.
Contexto de 1M, saída de 128K, entrada de texto/imagem, saída de texto.
Elegibilidade por região e conta.
ID exato do modelo, saída em JSON estruturada e entrada de imagem em PNG.
Ferramentas do sistema de arquivos e execução de agentes.
Para que foi desenvolvido o Fable 5.1?
O posicionamento oficial é amplo, por isso é útil separar o que está documentado do que pode ser verificado por meio de uma pequena verificação prática. Em nossos testes de entrada fechada e primeira saída por meio da API Anywhere, o Fable 5.1 produziu uma correção mínima em JavaScript que manteve os valores zero, rastreou uma contradição no orçamento de um conjunto de documentos sem resolvê-la por suposições, manteve um resultado observacional como não causal e extraiu valores rotulados de um gráfico PNG. Esses são sinais úteis para tarefas restritas, não uma reprodução dos benchmarks de agentes de longa duração do Anthropic.
Essa mesma rota da API não disponibilizava ferramentas relacionadas ao sistema de arquivos nem ao validador. Por esse motivo, não afirmamos ter obtido um resultado de agente autônomo de verdade.
Mapa de capacidades: reivindicação, verificação, limite
Claude Fable 5.1 Alterações nos preços e custos
O Anthropic apresenta o Fable 5.1 com $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída, as mesmas taxas de lista do Fable 5. As leituras em cache são de $0,25 por milhão de tokens. O Anthropic estima um custo cerca de 25% menor para cargas de trabalho típicas e de até cerca de 45% para trabalhos complexos, orientados a agentes e com grande quantidade de contexto; essas são estimativas do Anthropic com base em suas premissas declaradas de carga de trabalho, não um desconto garantido.
A variável-chave é a reutilização. Uma solicitação única não se beneficiará muito da tarifação por leitura do cache, enquanto um fluxo de trabalho que envia repetidamente um briefing extenso, um resumo da base de código ou um pacote de políticas pode se beneficiar. Para o contexto da geração anterior, consulte nosso Guia de preços do Claude Fable 5. Se a comparação que você está fazendo for entre assinaturas distintas, e não entre o faturamento por token de API, Planos GlobalGPT oferecem uma rota de assinatura multimodelo separada; não se trata de uma conversão dos preços da API Anthropic.
Preços de tabela oficiais da API
Mova o controle deslizante para definir o volume mensal de entradas. A estimativa pressupõe que a saída seja igual a 20% das entradas e que 50% dos tokens de entrada sejam leituras do cache.
10 milhões de tokens de entrada por mêsClaude Fable 5.1 x Fable 5: é uma atualização significativa?
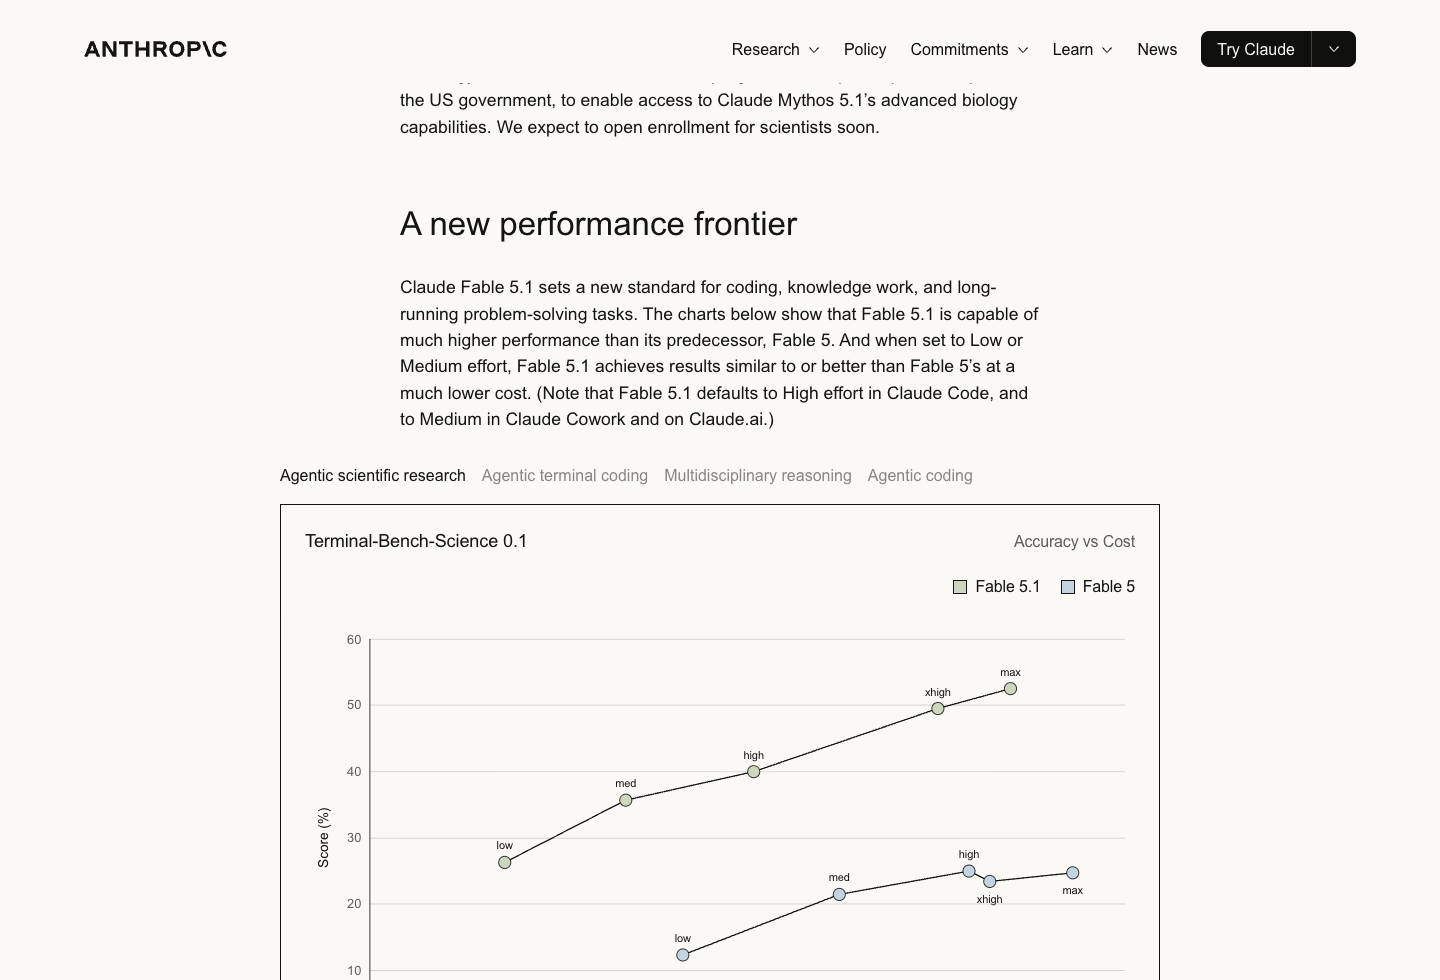
O Anthropic apresenta pontuações mais altas no Fable 5.1 do que o Fable 5 em várias avaliações específicas de tarefas, incluindo 52,6% contra 24,7% no Terminal-Bench-Science, 55,8% contra 42,0% no Terminal-Bench, 31,4% contra 17,1% no AutomationBench e 73,4% contra 70,5% no CursorBench. Seu resultado no GDPval-AA v2 é 1.853 contra 1.723. Esses são números relatados pelo Anthropic com seus próprios conjuntos de testes e condições, portanto, servem mais como contexto do que como um ranking geral reproduzido de forma independente.
Não realizamos um teste de referência direto do Fable 5 no mesmo ambiente. A conclusão sincera sobre a atualização é, portanto, condicional: os dados oficiais apontam para ganhos específicos na tarefa e menor custo de leitura do cache, enquanto uma avaliação independente comparando o Fable 5.1 com o Fable 5 ainda não foi concluída.
Se sua escolha for mais abrangente do que essa única atualização, nosso Comparação entre o Claude Fable 5 e o GPT 5.5 é uma boa sugestão de leitura, em vez de considerar uma única linha de benchmark como um ranking universal.
Resultados das tarefas relatados pelo Anthropic
Testes práticos: o que realmente verificamos
Utilizamos a rota da API Anywhere /v1/chat/completions após verificar o ID do modelo devolvido claude-fábula-5-1 e uma pequena sonda de saída estruturada. Cada resultado abaixo é a primeira saída válida de uma tarefa congelada com entrada fechada. A entrada em SVG foi rejeitada antes que o T05 chegasse ao modelo; portanto, o fixture idêntico foi convertido para PNG e executado uma vez; nenhum resultado válido foi substituído.
Evidência de primeira saída
A resposta identificou o motivo pelo qual os valores zero desapareceram, propôs uma alteração mínima no código e, explicitamente, não alegou ter realizado um teste.
{
  "root_cause": "scores.filter(Boolean) remove todos os valores falsos, incluindo a pontuação numérica 0; portanto, normalize([0, 4, null, undefined]) descarta o 0 e retorna [4] em vez de [0, 4]. O predicado é muito abrangente; ele deveria excluir apenas `null` e `undefined.```,
  "unified_diff": "--- a/normalize.js\n+++ b/normalize.js\n@@ -1,3 +1,3 @@\n function normalize(scores) {\n-  return scores.filter(Boolean);\n+  return scores.filter((score) => score != null);\n }",
  "expected_test_results": "espera-se que normalize([0, 4, null, undefined]) retorne [0, 4], pois score != null é falso apenas para null e undefined, portanto 0 é mantido. Espera-se que `normalize([7])` retorne `[7]`, sem alterações. Essas são expectativas baseadas na leitura do código; nenhum teste foi executado.",
  "remaining_risk": "Outros valores falsos que eram filtrados anteriormente (NaN, string vazia, false) agora serão mantidos, o que atende ao requisito declarado (remover apenas null/undefined), mas pode ser percebido como uma mudança de comportamento se algum chamador dependesse da filtragem antiga. Se a entrada não for um array, a função ainda gera uma exceção, como antes."
}A resposta mapeou as reclamações apresentadas, identificou o conflito entre $18.000 e $20.000 e manteve a causa sem solução, em vez de inventar uma.
{
  "afirmações": [{"afirmação":"O projeto-piloto teve início em 3 de março com 120 alunos matriculados.","source":"Documento A","section":"A1","status":"declarado"},{"claim":"A frequência foi registrada semanalmente.","source":"Documento A","section":"A2","status":"declarado"},{"claim":"Na avaliação de 31 de março, 96 dos 120 alunos matriculados haviam participado de pelo menos três sessões.","fonte":"Documento B","seção":"B1","status":"declarado"},{"afirmação":"O orçamento do programa era de $18.000.","fonte":"Documento B","seção":"B2","status":"contradito"},{"afirmação":"A nota financeira indica um orçamento aprovado para o programa de $20.000.","fonte":"Documento C","seção":"C1","status":"contradito"},{"afirmação":"A nota não especifica se a diferença orçamentária reflete uma revisão ou um erro de registro.",""fonte":"Documento C","seção":"C2","status":"declarado"}],
  "contradições": [{"tópico":"Orçamento do programa","fontes":[{"fonte":"Documento B","seção":"B2","valor":"$18.000"},{"source":"Documento C","section":"C1","value":"$20.000"}],"descrição":"O Documento B indica que o orçamento do programa era de $18.000, enquanto o Documento C lista um orçamento do programa aprovado de $20.000."}],
  "não resolvido": [{"questão":"Se a diferença de $2.000 entre o orçamento de $18.000 (Documento B, B2) e o orçamento aprovado de $20.000 (Documento C, C1) reflete uma revisão ou um erro de registro.","fonte":"Documento C","seção":"C2","motivo":"O Documento C afirma explicitamente que a nota não esclarece a causa da diferença, e nenhum outro documento fornecido aborda essa questão."}]
}O endpoint de chat verificado não disponibilizou ferramentas de gravação de arquivos nem de validação. Portanto, a tarefa não foi enviada como um teste de qualidade do modelo, e não há nenhuma saída ou pontuação declarada.
A resposta calculou a diferença observada e rejeitou a conclusão causal sem fundamento.
{
  "mean_control": {"value": 10, "units": "pontos"},
  "mean_treatment": {"value": 14, "units": "pontos"},
  "difference": {"value": 4, "units": "pontos", "direction": "tratamento menos controle"},
  "conclusão_fundamentada": "Neste conjunto de dados, o grupo de tratamento apresentou uma pontuação média 4 pontos maior do que o grupo de controle (14 contra 10 pontos).",
  "conclusão_não_fundamentada": "Que o tratamento tenha causado a pontuação 4 pontos mais alta; os grupos não foram designados aleatoriamente e não foram coletadas pontuações de referência, portanto, a diferença pode refletir diferenças pré-existentes entre os grupos.",
  "limitações": ["Atribuição não aleatória dos grupos, portanto, não se pode descartar viés de seleção", "Ausência de pontuações iniciais, portanto, não é possível avaliar diferenças pré-existentes entre os grupos", "Tamanho da amostra muito pequeno (n=4 por grupo)", "Não foram calculadas estatísticas inferenciais; a diferença não foi testada quanto à significância estatística", "O desenho observacional não sustenta afirmações causais"]
}A execução do PNG retornou os valores rotulados de abril, diferenciou as estimativas visuais dos valores rotulados e evitou extrapolações sem fundamento.
{
  "april_alpha": 30,
  "april_beta": 25,
  "trend": "Tanto o Alfa quanto o Beta aumentam de forma constante a cada mês, de janeiro a abril, com o Alfa consistentemente cerca de 5 horas acima do Beta (estimado visualmente: janeiro ~15/10, fev ~20/15, mar ~25/20, abr 30/25, conforme indicado).",
  "unsupported": ["Os valores de abril estão explicitamente indicados no gráfico; os valores de janeiro, fevereiro e março são apenas estimativas visuais", "Não são exibidos dados posteriores a abril ou anteriores a janeiro; portanto, não é possível fazer afirmações sobre outros meses", "As unidades são identificadas como horas de estudo, mas não são fornecidas informações sobre a fonte, o tamanho da amostra ou a definição dos grupos Alfa/Beta"]
}
Limites de segurança, dados e compatibilidade
O Fable 5.1 pode ser usado para identificar vulnerabilidades de software, mas o Anthropic afirma que ele não se destina ao desenvolvimento de exploits e pode encaminhar alguns trabalhos de dupla utilização para o Opus. A pesquisa em ciências da vida e o acesso ao Mythos têm restrições distintas. A retenção de dados é específica para cada rota: a documentação da AWS, por exemplo, não deve ser generalizada para todos os caminhos da API Claude ou de terceiros.
O Anthropic também aponta lacunas em sua própria cobertura de alinhamento para cenários de contexto muito longo, com múltiplos agentes e tarefas impossíveis. Isso é um motivo para validar uma implantação de alto risco com sua própria tarefa delimitada, e não um motivo para ignorar as melhorias documentadas do modelo.
Quem deve experimentar o Claude Fable 5.1?
Experimente quando seu trabalho se beneficiar de suporte cuidadoso à codificação, síntese baseada em código-fonte, verificações de contradições em documentos ou extração de texto a partir de imagens. Verifique primeiro se você precisa de uma implantação regional específica, termos de retenção zero, um agente que utilize ferramentas ou uma comparação direta Fable 5. Se você estiver optando por um plano geral Claude em vez do acesso à API, o separado Guia de preços da Claude AI explica a diferença entre plano e API.
Claude Fable 5.1 – Perguntas frequentes
Qual é a diferença prática entre o Claude Fable 5.1 e o Mythos 5.1?
O Anthropic descreve-os como o mesmo modelo subjacente, com diferentes medidas de segurança e regras de acesso. O Fable 5.1 é a opção de disponibilidade geral discutida aqui. O Mythos 5.1 é reservado para programas de acesso confiável nas áreas de segurança cibernética e ciências da vida; portanto, os recursos do Mythos não constituem uma garantia em relação a uma conta padrão do Fable.
Posso usar o Claude Fable 5.1 no aplicativo Claude, ou ele está disponível apenas via API?
Não deduza o acesso a aplicativos de consumidor com base em um anúncio sobre API ou nuvem. A Anthropic indica suas próprias plataformas e os principais provedores de nuvem como rotas de acesso, mas o plano, a região, a cota e o conjunto de ferramentas dependem da rota escolhida. Verifique exatamente a área de acesso da conta que você pretende usar antes de alterar um fluxo de trabalho relacionado a ela.
Qual é o ID correto do modelo Claude Fable 5.1?
Listas Anthropic claude-fábula-5-1 para sua API. Os provedores de nuvem podem usar identificadores específicos de rota; portanto, copie o ID do modelo da documentação do provedor para o endpoint que você está realmente chamando.
O Claude Fable 5.1 possui uma janela de contexto de 1 milhão de tokens?
A AWS documenta uma janela de contexto de 1 milhão de tokens e uma saída máxima de 128 mil para sua rota Bedrock. Isso é útil para o planejamento do Bedrock, mas não deve ser generalizado para todas as APIs Claude, consumidores ou rotas de terceiros sem verificar a documentação específica de cada uma.
O Fable 5.1 aceita imagens e gera imagens?
A documentação da AWS descreve a entrada de texto e imagem com saída de texto para a rota do Bedrock. Isso significa que a compreensão de imagens está documentada ali; não significa que o modelo seja um gerador de imagens nem que todas as rotas aceitem os mesmos formatos. Em nossa verificação da API restrita, a entrada em PNG funcionou depois que o SVG foi rejeitado pela camada de solicitação.
Em que situações o preço mais baixo da leitura do cache faz diferença?
Isso faz diferença quando o mesmo contexto amplo é reutilizado em várias solicitações: por exemplo, um resumo persistente de base de código, um corpus de políticas ou um extenso pacote de pesquisa. No caso de prompts curtos e isolados, o volume normal de entrada e saída é o que mais pesa no custo. Use a calculadora acima como uma estimativa para o planejamento e, em seguida, compare-a com o comportamento real de armazenamento em cache da sua rota.
O Fable 5.1 é capaz de executar sozinho um agente que utiliza ferramentas?
Isso depende do ambiente em torno do modelo. Um endpoint de autocompletamento de chat pode retornar uma resposta de texto consistente sem expor a gravação de arquivos, validadores, navegação ou uma sandbox de repositório. Nossa rota de teste não expôs essas ferramentas; portanto, não foi utilizada para alegar a execução de um agente autônomo.
O Claude Fable 5.1 é definitivamente melhor do que o Fable 5?
Os relatórios do Anthropic apontam ganhos específicos para determinadas tarefas e menor custo de leitura do cache. Esse é um forte motivo para avaliar a atualização em trabalhos semelhantes aos seus, mas não constitui um veredicto definitivo de que seja uma solução vencedora em todos os casos. Este artigo não apresentou uma linha de base do Fable 5 no mesmo ambiente.
Fontes: Anúncio do lançamento da versão Anthropic; Anúncio da AWS; Ficha técnica do modelo Amazon Bedrock.