
Resposta rápida: O GPT-6 Sol concluiu o resumo de cinco seções testado dentro do limite de saída de 2.400 tokens; o Claude Opus 5.5 apresentou o diagnóstico mais preciso em nossa tarefa de revisão de código curto. Nenhum dos resultados define um vencedor geral definitivo.
Essa comparação é mais abrangente do que uma simples pontuação. O Claude Opus 5.5 e o GPT-6 Sol diferem na forma como lidam com redação, síntese de pesquisas, revisão de código, respostas estruturadas, vias de acesso e fluxo de trabalho no dia a dia. Os resultados das tarefas abaixo mostram em que aspectos essas diferenças são relevantes.
GlobalGPT oferece os dois modelos em uma assinatura multimodelo acessível, além de outros modelos e recursos de IA. Um único painel permite conduzir um projeto desde a pesquisa e a redação até a programação, imagens e vídeo, enquanto sua interface de linha de comando (CLI) conecta esse mesmo contexto de trabalho às ferramentas de terminal e de produção.
Resposta rápida
Escolha o GPT-6 Sol em primeiro lugar, no que diz respeito ao fluxo de trabalho de redação restrito testado aqui; ele concluiu todas as cinco seções dentro do limite de saída compartilhado de 2.400 tokens. Escolha Claude Opus 5,5 quando o diagnóstico, a análise explícita de riscos e um JSON rigoroso são mais importantes. Use ambos quando o trabalho sofre alterações ao longo do dia.
Em que cada modelo se destaca
Claude Opus 5,5 é adequado para tarefas que exigem atenção deliberada: revisar uma alteração no código, desmembrar um requisito confuso, identificar riscos e manter um contrato de entrega rigoroso. O Anthropic se concentra na programação, no uso do computador, no trabalho intelectual, na segurança e em uma comunicação mais natural durante sessões prolongadas. Veja o Análise do Claude Opus 5.5 para uma visão separada, com foco no modelo. É uma escolha natural quando uma segunda análise cuidadosa vale mais do que uma primeira resposta mais sucinta.
GPT-6 Sol adapta a produção de conteúdo às restrições: um relatório extenso, um memorando de decisão, um plano estruturado ou um rascunho que deva incluir várias seções solicitadas. O OpenAI é descrito como um modelo GPT-6 mais acessível para trabalhos profissionais, precisão factual, programação, uso de computadores e colaboração. O Análise do GPT-6 Sol aborda o modelo por si só; na tarefa de formato longo apresentada aqui, ele concluiu o contrato na primeira saída, o que é útil quando o custo de uma seção ausente é alto.
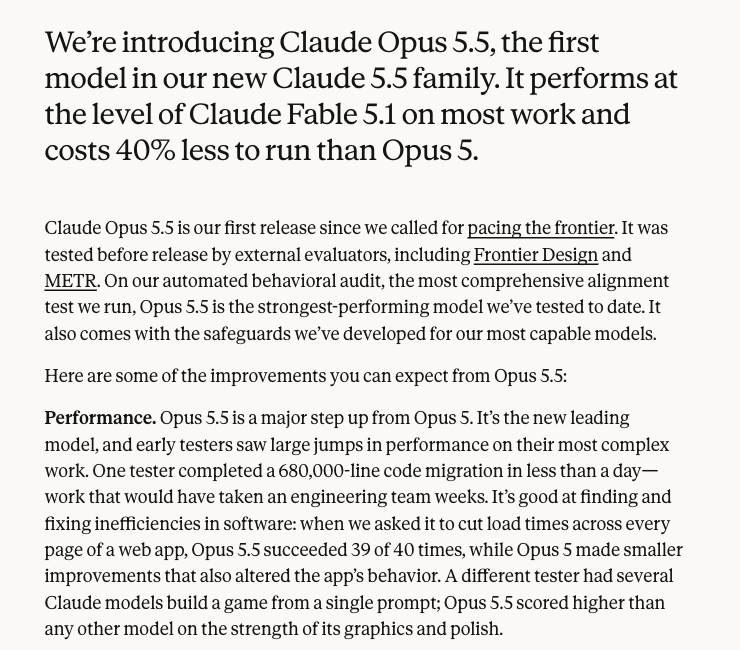
Este é o relato da própria Anthropic sobre o lançamento, incluindo exemplos fornecidos pelos primeiros testadores. Ele corrobora a direção pretendida para o produto; não estabelece um resultado comparativo direto com o GPT-6 Sol. Nossas instruções correspondentes, apresentadas abaixo, abordam a questão mais específica do que cada modelo retornou nesta rodada.
Comparação de recursos e funcionalidades
Claude Opus 5.5 vs GPT-6 Sol: mapa de capacidades
| Área de decisão | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Redação longa | Destaca-se pela elaboração cuidadosa e cheia de nuances, além de ressalvas explícitas | Tem facilidade para concluir um briefing extenso e com várias restrições de uma só vez |
| Síntese da pesquisa | Reconciliação detalhada e explicação dos riscos | Síntese concisa com uma recomendação clara |
| Codificação e revisão | Diagnóstico preciso e relatórios estruturados de risco | Patches úteis e minimalistas; validar explicações para casos extremos |
| Saída estruturada | JSON rigoroso e confiável na tarefa testada | JSON válido com todas as chaves solicitadas na tarefa testada |
| Multimodal e ferramentas | Verifique a rota e configure o acesso para a tarefa específica | Verifique a rota e configure o acesso para a tarefa específica |
| Melhor estilo de trabalho | Análise criteriosa, raciocínio complexo e trabalho sensível ao risco | Concluí o briefing restrito e testado dentro do limite máximo de produção estabelecido |
Como ler isto: Essas são tendências de fluxo de trabalho, não um ranking universal. A escolha certa depende se você valoriza uma revisão cuidadosa ou a conclusão desse briefing denso dentro do mesmo limite de produção.
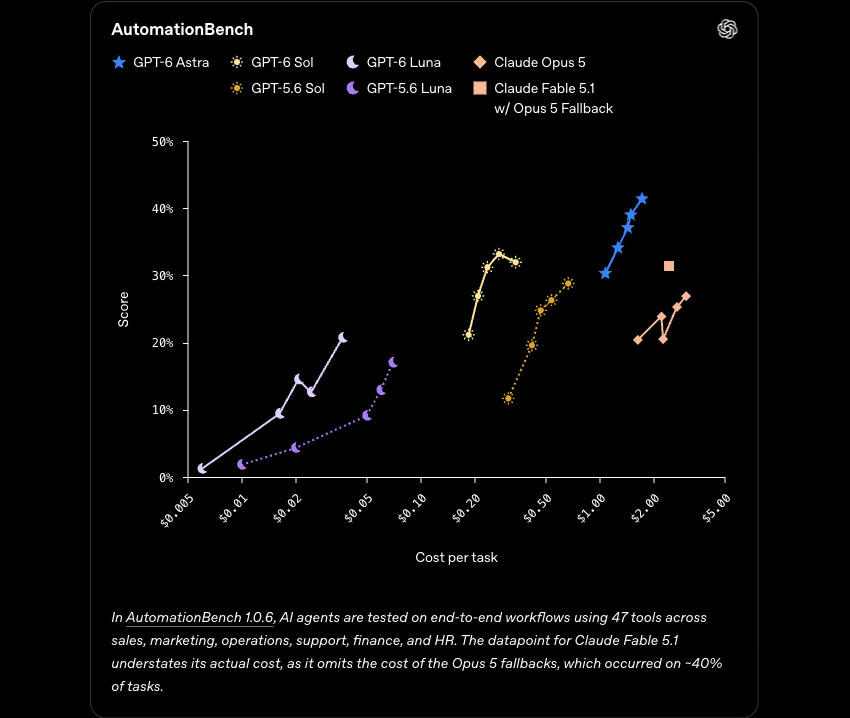
Interprete os dois eixos: o movimento para cima indica uma pontuação mais alta, enquanto o movimento para a esquerda indica um custo menor por tarefa. A série Claude aqui é a Opus 5, e não a Opus 5.5. Este gráfico, fornecido pela editora, ajuda a explicar o posicionamento da Sol em termos de custo-benefício; ele não pode resolver a comparação apresentada neste artigo. A nota de rodapé também indica que os dados do Fable omitem alguns custos de contingência.
Redação, documentos longos e síntese de pesquisas
No que diz respeito à redação, este teste distingue a conclusão dentro de um limite fixo de produção da qualidade da revisão editorial. O GPT-6 Sol teve melhor desempenho na tarefa de redação de texto longo. O Claude Opus 5.5 teve melhor desempenho quando a tarefa consistia em diagnosticar, qualificar e explicar. No que diz respeito às notas de pesquisa, ambos os modelos chegaram à mesma conclusão prática; portanto, a qualidade do material de origem e do processo de revisão ainda são mais importantes do que um vencedor em termos de destaque.
- Use o GPT-6 Sol para elaborar um primeiro rascunho com muitas restrições, um memorando de decisão ou um plano de conteúdo estruturado.
- Utilize o Claude Opus 5.5 para questionar suposições, identificar riscos e aperfeiçoar um rascunho antes que ele chegue ao cliente ou ao sistema de produção.
- Quando os fatos são importantes, forneça o material de origem a qualquer um dos modelos e mantenha uma etapa de revisão humana.
Programação, saída estruturada e trabalho pronto para uso em ferramentas
Ambos os modelos retornaram um JSON válido com todas as chaves solicitadas e o mesmo patch mínimo. O Claude descreveu o filtro existente corretamente; o GPT-6 Sol afirmou incorretamente que um elemento `None` geraria um erro. Isso reforça a preferência pelo Claude para o diagnóstico nesta tarefa específica. O tipo do campo “risk” não foi especificado na instrução, portanto, a string de risco do Sol não constitui uma violação do contrato.
Para trabalhos prontos para uso em ferramentas, avalie o formato de saída de que você realmente precisa: formato JSON válido, campos preenchidos, comandos reproduzíveis e um patch que possa ser aplicado sem necessidade de interpretação. Ambos os modelos podem fazer parte desse fluxo de trabalho, com testes e revisões integrados ao processo.
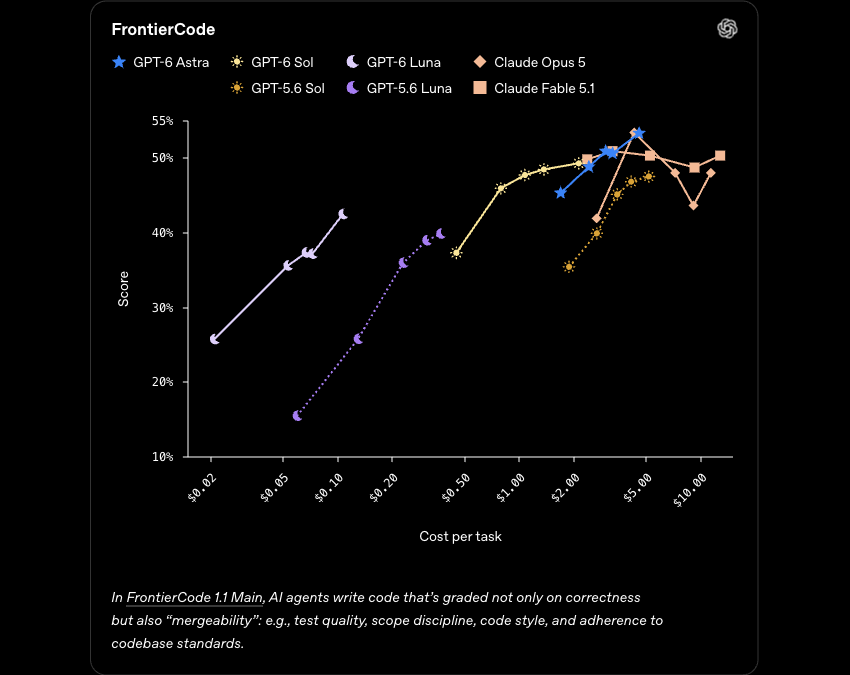
Este benchmark abrange uma codificação agênica mais ampla do que nossa breve solicitação de revisão de código. Seu comparador no Claude é o Opus 5; portanto, serve como contexto para o posicionamento da codificação do Sol, e não como evidência de que o Sol supera o Opus 5.5. Em nossa própria tarefa, ambas as correções estavam corretas; a distinção relevante foi a precisão do diagnóstico.
Preço e acesso
Preço e acesso: compare a rota, não apenas o modelo
| Rota | O que você está pagando | Quando faz sentido |
|---|---|---|
| Claude Opus 5.5 API | A Anthropic indica $4 por milhão de tokens de entrada, $20 por milhão de tokens de saída e $0,20 por milhão de tokens de leitura de cache em sua página de lançamento de 22 de setembro de 2026 | Você está desenvolvendo um produto ou um pipeline automatizado e deseja faturamento direto por token |
| API do GPT-6 Sol | O OpenAI apresenta $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, com uma redução de 50% em relação ao preço promocional do GPT-5.6 Sol; as leituras de entrada em cache recebem um desconto de 90% | Você precisa de um contrato de API diretamente com o provedor e deseja um custo por uso mais baixo para tarefas contínuas |
| GlobalGPT | Uma assinatura acessível que inclui os dois modelos, além de muitos outros modelos e funções de IA | Você quer reunir pesquisa, redação, programação, imagens e vídeos em um único painel |
Esses valores correspondem às tarifas dos tokens da API, e não aos preços das assinaturas. O OpenAI posiciona o GPT-6 Sol como o membro de menor custo da família GPT-6 para trabalhos profissionais, verificação de fatos, programação, uso de computadores e colaboração, enquanto o Anthropic posiciona o Claude Opus 5.5 nas áreas de programação, uso de computadores, trabalho de conhecimento, segurança e comunicação. O GlobalGPT mantém ambos os modelos e o restante da cadeia de ferramentas disponíveis por meio de uma assinatura acessível, enquanto sua CLI conecta esse acesso a um terminal, ao fluxo de trabalho de desenvolvimento e às ferramentas de produção existentes.
Fontes primárias: Página de lançamento da versão Claude Opus 5.5 da Anthropic e Página de lançamento do GPT-6 Sol e Luna da OpenAI.
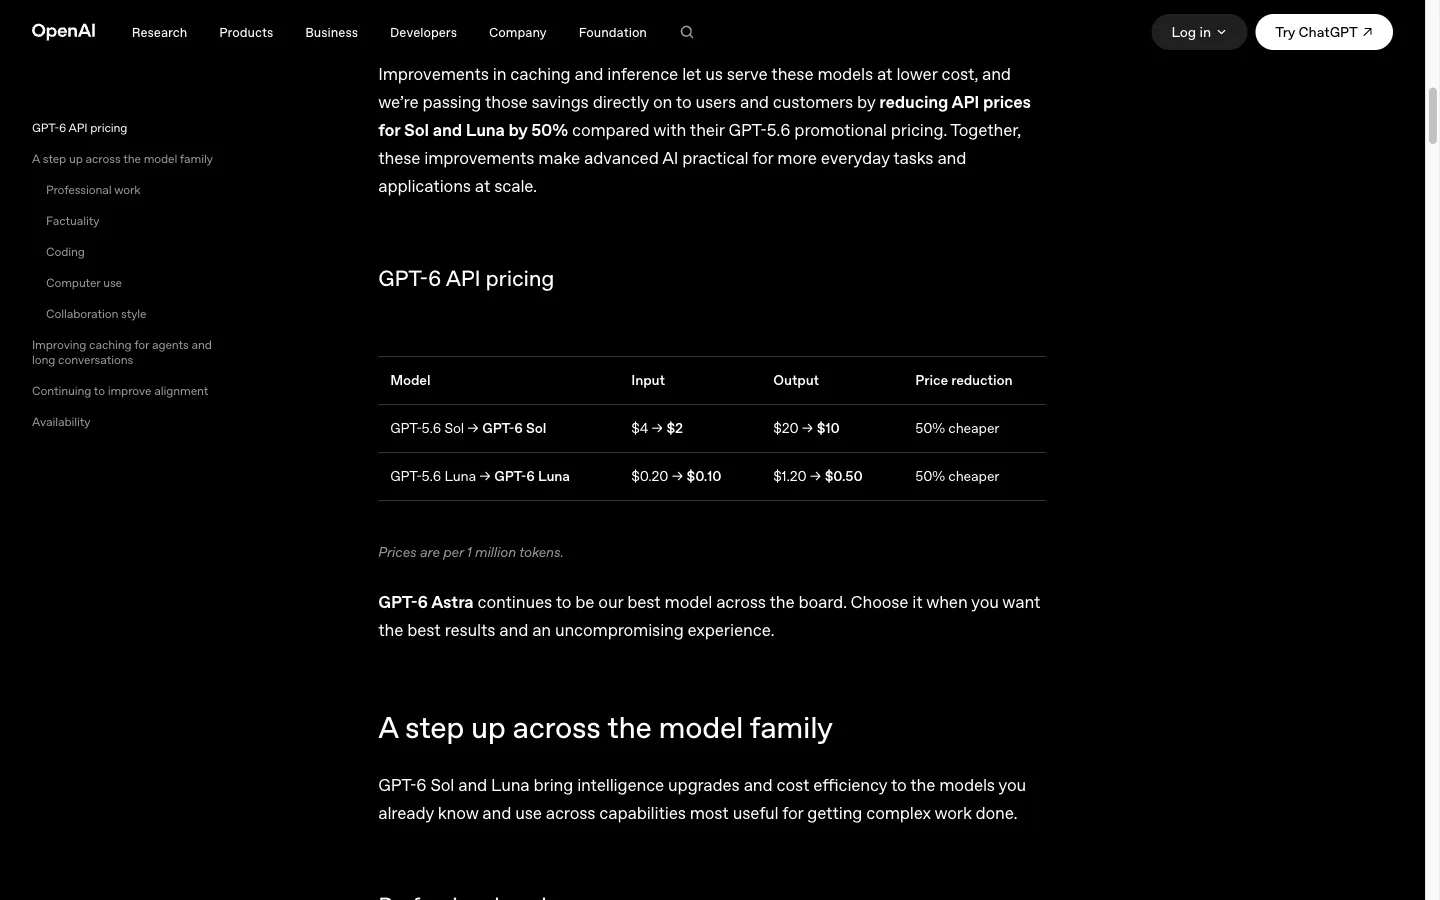
Essas tarifas se aplicam a tokens de API. Elas não se referem a uma assinatura mensal para consumidores nem ao plano GlobalGPT.
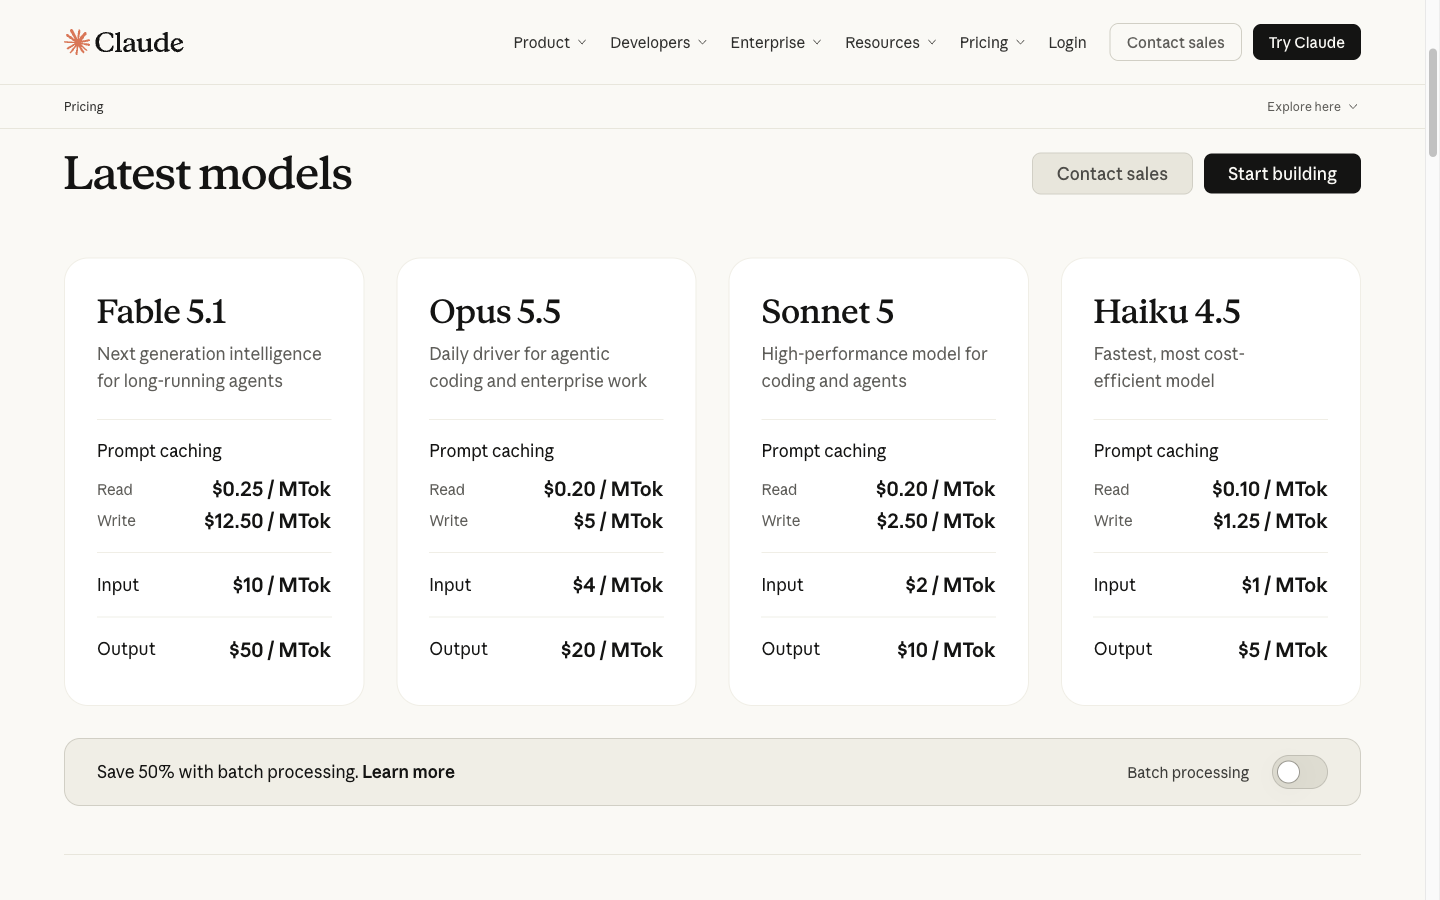
As taxas padrão de entrada e saída do Opus 5.5 são o dobro das do Sol, enquanto ambas as taxas publicadas de leitura em cache são de $0,20/M. Um fluxo de trabalho com uso intenso de cache pode, portanto, apresentar uma diferença de custo diferente daquela de um fluxo sem cache; compare a mesma combinação de tokens antes de decidir com base no preço.
O que a diferença de taxa significa para a mesma carga de trabalho
Exemplo de cálculo: 1 milhão de tokens de entrada não armazenados em cache + 100.000 tokens de saída, tarifas padrão da API. A cor azul-petróleo representa o custo dos insumos; a cor ferrugem, o custo da produção.
O Sol custa metade do preço para essa mesma combinação de tokens. Esse é um cálculo baseado na tabela de preços, não uma afirmação de que todas as tarefas concluídas custam metade do preço: novas tentativas, comprimento da saída, acertos no cache, custos com ferramentas e configurações de raciocínio podem alterar o valor da fatura.
Fontes: Preços da API Anthropic e Preços da versão OpenAI, consultado em 25 de setembro de 2026.Calcular o custo direto da API
Calculadora de custos de API
Insira os tokens que você espera enviar e receber. A estimativa utiliza as taxas verificadas da API acima: Claude Opus 5,5 com entrada de $4/M e saída de $20/M; GPT-6 Sol com entrada de $2/M e saída de $10/M.
| Modelo | Taxa de entrada | Taxa de produção | Custo estimado |
|---|---|---|---|
| Claude Opus 5,5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
Esta é uma estimativa de cobrança por token para uso direto da API. Ela não inclui o preço de uma assinatura de consumidor nem do plano GlobalGPT, e exclui descontos de cache, ferramentas, impostos e outras cobranças específicas do provedor.
Quem deve escolher qual modelo?
Qual modelo você deve escolher?
| Sua prioridade | Escolha primeiro | Por que |
|---|---|---|
| Um memorando longo e bem elaborado, com muitas restrições | GPT-6 Sol | A tarefa de formato longo revisada atingiu a regra de decisão solicitada em uma única saída |
| Diagnóstico de código, JSON estrito e riscos explícitos | Claude Opus 5,5 | A tarefa de codificação resultou em um diagnóstico mais preciso e em um levantamento mais preciso dos riscos |
| Notas de pesquisa que precisam ser reconciliadas | Ou | A tarefa de síntese com fonte controlada terminou em empate |
| Um fluxo de trabalho semanal misto | GlobalGPT com ambos | Mantenha a escolha do modelo, a redação, a programação, as imagens e os vídeos em um único painel; use a CLI quando o trabalho passar para o terminal |
Utilize os dois modelos em um fluxo de trabalho completo
Um fluxo de trabalho prático para o GlobalGPT
- Comece com um resumo da pesquisa e peça a um modelo para identificar as suposições.
- Transfira o resumo revisado para o outro modelo, para elaboração de rascunho ou para uma segunda opinião.
- Utilize a abordagem de codificação mais robusta para implementação, revisão e geração de resultados estruturados.
- Mantenha o trabalho resultante no mesmo painel e, em seguida, use o Fluxo de trabalho da CLI do GlobalGPT quando precisar ser inserido em um terminal ou em uma ferramenta de produção.
Esse fluxo de trabalho é o principal valor do acesso a ambos os modelos: você pode direcionar a tarefa, em vez de ter que reescrever seu processo para se adequar a um único modelo.

Como foi realizada a comparação
Ambos os modelos receberam a mesma mensagem do sistema, os mesmos dados de entrada da tarefa e o mesmo material de origem, sem o uso de ferramentas ou navegação. Cada resultado mantém a primeira saída retornada, incluindo o truncamento devido ao limite de saída. Trata-se de uma comparação prática para a escolha de um fluxo de trabalho, e não de uma classificação universal de todas as capacidades.
Método de comparação
Como essa comparação foi realizada
| Condição | Regra de comparação |
|---|---|
| Modelos | Claude Opus 5.5 e GPT-6 Sol, IDs exatos confirmados no diretório de modelos ativos |
| Paridade de prompt | A mesma mensagem do sistema, o mesmo prompt de tarefa, o mesmo material de origem; sem ferramentas nem navegação |
| Tarefas | Verificação de limites T01, comparação explícita em formato longo T01R, síntese de código-fonte T02, código/JSON T03 |
| Novas tentativas | Apenas falhas de transporte, capacidade ou envelope vazio; a saída fraca válida é mantida |
| Pontuação | 10 pontos por tarefa concluída: contrato objetivo 4, rastreabilidade 3, utilidade 2, formato 1 |
A primeira tarefa verifica se um modelo consegue adivinhar quando faltam elementos-chave do contexto; por isso, ela é mantida separada do cálculo do vencedor. A comparação direta inclui ambos os modelos e lhes atribui o mesmo briefing. Não foram realizadas repetições de teste de estabilidade.
Por que a primeira rodada não escolheu um vencedor
Tratamento do contexto
Por que a primeira rodada não escolheu um vencedor
Ambos os modelos se recusaram a inventar identidades de modelos porque a instrução original não os mencionava. Essa é a resposta correta diante da falta de contexto, mas não nos permite saber qual modelo é melhor na tarefa em si.
Claude Opus 5,5 · entrada completa
Você está comparando dois modelos de IA para um guia prático ao comprador. Utilizando apenas o pacote de informações abaixo, escreva um texto de 700 a 900 palavras com exatamente estes títulos: Decisão, Evidências, Considerações e Próximo passo. Mantenha esses fatos exatamente como estão: o Projeto North tem um prazo de 12 semanas; o orçamento para a migração é de $48.000; a revisão de segurança não está agendada. Se algum fato estiver em aberto, mencione isso explicitamente. Não invente preços, benchmarks ou recursos do produto.

PACOTE DE INFORMAÇÕES:
O Projeto North é uma migração de 12 semanas para uma equipe de 40 pessoas. O orçamento aprovado para a migração é de $48.000. O prazo para a revisão de segurança ainda não foi agendado. A equipe deseja uma recomendação de modelo para pesquisa, redação e revisão de código. Uma observação de uma parte interessada afirma que a versão preliminar atual é muito longa, mas não fornece a contagem de palavras.

Entregue apenas o guia.
Claude Opus 5,5 · potência máxima
## Decisão

Não é possível fazer nenhuma recomendação entre os dois modelos com base no pacote de informações fornecido. O pacote não menciona nenhum dos modelos nem apresenta preços, resultados de benchmarks ou recursos dos produtos. Escolher um modelo em detrimento do outro neste momento significaria inventar as evidências nas quais este guia deveria se basear.

A decisão prática é adiar a seleção do modelo. Trate a próxima fase como uma avaliação estruturada regida por três restrições fixas:

- O Projeto Norte tem um prazo de 12 semanas.
- O orçamento para a migração é de $48.000.
- A revisão de segurança ainda não está agendada.

Qualquer modelo que for adiante deve se encaixar no prazo de 12 semanas e no orçamento de migração de $48.000. Ele também deve passar por uma revisão de segurança, e essa revisão ainda não está agendada. Até que os dois modelos sejam identificados e avaliados em relação aos três usos declarados pela equipe (pesquisa, redação e revisão de código), a seleção permanece em aberto. Este guia afirma isso de forma clara, em vez de oferecer uma preferência que as evidências não possam sustentar.

## Evidências

O pacote de fontes contém os seguintes fatos, e somente esses fatos servem de base para este guia:

- **Escopo e cronograma:** O Projeto North é uma migração de 12 semanas.
- **Tamanho da equipe:** A migração atende a uma equipe de 40 pessoas.
- **Orçamento:** O orçamento aprovado para a migração é de $48.000.
- **Segurança:** O cronograma para a revisão de segurança ainda não foi definido.
- **Casos de uso:** A equipe deseja uma recomendação de modelo para pesquisa, redação e revisão de código.
- **Feedback das partes interessadas:** Uma observação de uma parte interessada indica que a versão preliminar atual é muito longa, mas não fornece a contagem de palavras.

O pacote não contém vários elementos nos quais uma comparação normalmente se basearia. Ele não identifica os dois modelos que estão sendo comparados. Não indica preços por licença, por token ou por assinatura para nenhuma das opções. Não fornece pontuações de benchmark nem resultados de testes internos. Não descreve o que cada modelo pode ou não fazer em termos de pesquisa, redação ou revisão de código. Não menciona nada sobre termos de tratamento de dados, opções de implantação ou requisitos de integração.

Como nenhum desses itens aparece no pacote, este guia não faz estimativas a respeito. Não se sabe se algum dos modelos se encaixa no orçamento de $48.000 para uma equipe de 40 pessoas. Também não se sabe se algum dos modelos tem melhor desempenho em pesquisa, redação ou revisão de código. Qualquer número ou alegação de capacidade adicionada aqui seria inventada.

## Advertências

Várias questões não resolvidas afetam a forma como essa decisão deve ser interpretada.

**As identidades dos modelos não estão definidas.** A comparação diz respeito a dois modelos de IA, mas o pacote não especifica quais. Qualquer avaliação posterior depende da resposta a essa questão primeiro.

**O escopo do orçamento não está definido.** O documento se refere ao valor de $48.000 como o "orçamento de migração aprovado". Não especifica se esse montante se destina a cobrir licenças de modelos ou taxas de uso. Em vez disso, pode cobrir apenas o trabalho de migração, como tempo da equipe, ferramentas ou serviços. Se os custos dos modelos tiverem de ser custeados pelo mesmo valor de $48.000, a margem de custos para qualquer um dos modelos é menor do que o número principal sugere. Isso precisa ser confirmado.

**O cronograma da revisão de segurança não está definido e representa um risco para o cronograma.** A revisão de segurança não está agendada. Com um prazo de 12 semanas, uma revisão não programada representa um risco real para o cronograma. O pacote de documentos não informa quanto tempo leva uma revisão nem se uma revisão reprovada forçaria a mudança para o outro modelo. Ambos os resultados poderiam consumir uma parcela significativa das 12 semanas. Nenhum modelo deve ser considerado aprovado até que a revisão esteja concluída.

**A ponderação dos casos de uso ainda não foi definida.** A equipe citou três usos: pesquisa, redação e revisão de código. O pacote de documentos não especifica se eles têm a mesma importância ou se um deles prevalece. Um modelo mais forte em uma área pode ser mais fraco em outra e, sem uma ponderação, não há base para equilibrar esses aspectos.

**O volume de uso ainda não foi definido.** A equipe conta com 40 pessoas, mas o pacote não informa quantas delas usarão o modelo nem com que intensidade. O volume de uso pode afetar fortemente o custo em algumas estruturas de preços. Isso não pode ser avaliado sem dados de preços e estimativas de uso.

**A instrução de duração con
GPT-6 Sol · entrada completa
Você está comparando dois modelos de IA para um guia prático ao comprador. Utilizando apenas o pacote de informações abaixo, escreva um texto de 700 a 900 palavras com exatamente estes títulos: Decisão, Evidências, Considerações e Próximo passo. Mantenha esses fatos exatamente como estão: o Projeto North tem um prazo de 12 semanas; o orçamento para a migração é de $48.000; a revisão de segurança não está agendada. Se algum fato estiver em aberto, mencione isso explicitamente. Não invente preços, benchmarks ou recursos do produto.

PACOTE DE INFORMAÇÕES:
O Projeto North é uma migração de 12 semanas para uma equipe de 40 pessoas. O orçamento aprovado para a migração é de $48.000. O prazo para a revisão de segurança ainda não foi agendado. A equipe deseja uma recomendação de modelo para pesquisa, redação e revisão de código. Uma observação de uma parte interessada afirma que a versão preliminar atual é muito longa, mas não fornece a contagem de palavras.

Entregue apenas o guia.
GPT-6 Sol · saída completa
## Decisão

Não se deve indicar um modelo vencedor neste momento. O pacote de origem solicita uma recomendação entre dois modelos de IA, mas não identifica nenhum dos modelos nem fornece resultados para pesquisa, redação ou revisão de código. Uma afirmação de que um deles é melhor seria, portanto, infundada. A recomendação prática é comparar os dois candidatos com o próprio trabalho da equipe antes de fazer uma seleção.

O Projeto North tem um prazo de 12 semanas. O orçamento para a migração é de $48.000. A revisão de segurança não está programada. Esses fatos tornam a decisão urgente, mas não justificam adivinhações. Uma escolha útil deve levar em conta se um modelo ajuda a equipe de 40 pessoas a concluir suas tarefas reais, como seu uso se encaixa no orçamento aprovado e o que permanece incerto até que o prazo da revisão de segurança seja conhecido.

Trate a recomendação como condicional: escolha o modelo que tenha melhor desempenho em trabalhos representativos, que possa ser utilizado dentro do orçamento de migração aprovado e que seja aprovado em qualquer análise necessária para o uso pretendido. Se nenhum dos candidatos atender a essas condições, o guia deve indicar que nenhum deles pode ser recomendado ainda. O material disponível não comprova que qualquer uma dessas condições tenha sido atendida.

## Evidências

A equipe deseja uma recomendação de modelo para três tipos de trabalho: pesquisa, redação e revisão de código. Essas são as categorias de comparação adequadas, pois decorrem da necessidade declarada, e não de supostos pontos fortes do produto. O pacote não contém exemplos dos resultados de nenhum dos modelos, nem resultados de avaliação, nem descrição do que os dois candidatos oferecem. Também não contém preços ou referências comparativas. Consequentemente, não há base probatória para classificar os modelos quanto à precisão, velocidade, qualidade, custo ou adequação.

O contexto do projeto fornece critérios úteis para a tomada de decisão. O Projeto Norte é uma migração para uma equipe de 40 pessoas; portanto, uma comparação deve refletir as tarefas que os membros dessa equipe realmente realizariam. O orçamento aprovado para a migração é de $48.000; qualquer proposta de uso de um modelo deve ser avaliada em relação a esse valor, e não a uma verba inventada para ferramentas de IA. A revisão de segurança não está agendada, o que deixa o momento da revisão — e seu efeito na adoção — em aberto.

Uma parte interessada afirmou que a versão preliminar atual é muito longa, mas não forneceu uma contagem de palavras. Isso é indício de uma preferência pela concisão, não de um limite mensurável para a saída do modelo. Ao comparar amostras de redação, os revisores podem avaliar se cada candidato atende à solicitação de ser conciso e preserva os fatos essenciais. Eles não devem alegar que algum dos modelos satisfaz um limite de palavras especificado pelas partes interessadas, pois nenhum foi fornecido.

Para pesquisa, uma evidência útil seria se cada candidato distingue os fatos fornecidos das questões em aberto e evita conclusões sem fundamento. Para a redação, seria se cada um produz um rascunho claro e adequadamente conciso, sem descumprir as restrições. Para a revisão de código, seria se cada um identifica problemas em um exemplo fornecido e os explica de forma que um revisor possa verificar. Esses são testes propostos, não conclusões sobre qualquer um dos modelos.

## Ressalvas

A maior ressalva é que os próprios candidatos ainda não foram definidos: o pacote não os nomeia. Também não informa como a equipe teria acesso a eles, qual seria o custo ou se algum deles está disponível para o trabalho pretendido. Nenhuma capacidade do produto deve ser inferida a partir da expressão “modelos de IA”. Mesmo uma comparação bem elaborada não pode resultar em uma recomendação de produto até que os candidatos e as evidências de avaliação sejam conhecidos.

O orçamento para a migração está aprovado, mas o pacote não aloca nenhuma parte dele para o uso ou teste dos modelos. Não considere $48.000 como um orçamento para aquisição de IA. Da mesma forma, um prazo de 12 semanas não estabelece uma data até a qual a revisão de segurança ocorrerá. Como a revisão de segurança não está agendada, permanece em aberto se e quando um candidato poderia ser utilizado de acordo com os requisitos da equipe.

Os três usos solicitados também podem produzir resultados diferentes. Um candidato pode ser preferível para uma tarefa e não para outra; o pacote não fornece base para supor um único vencedor nas áreas de pesquisa, redação e revisão de código. Uma recomendação deve tornar visível qualquer tipo de compensação desse tipo, em vez de ocultá-la em um rótulo geral. Se a equipe decidir que uma categoria é mais importante do que as outras, essa prioridade deve partir das partes interessadas, e não deste guia.

Por fim, a observação de que o rascunho é muito longo não deve ser confundida com evidência sobre o desempenho do modelo. Ela descreve um feedback sobre um rascunho atual, sem identificar seu autor nem indicar um comprimento-alvo. Pode servir de base para a apresentação da recomendação final, mas não pode decidir a comparação.

## Próximo passo

Identifique os dois candidatos e peça à equipe tarefas representativas de pesquisa, redação e revisão de código. Forneça a cada modelo os mesmos materiais e instruções para cada tarefa, incluindo orientações para sinalizar incertezas e evitar a adição de fatos. Peça aos revisores que registrem o que cada resposta acerta, o que deixa de lado e quais afirmações requerem verificação. Mantenha as observações específicas de cada tarefa separadas, para que uma amostra de redação bem-sucedida não substitua as evidências sobre a revisão de código.

Antes de escolher, confirme o custo do uso pretendido em relação ao orçamento de migração de $48.000 e estabeleça quando a revisão de segurança poderá ocorrer. Nenhuma das respostas está no pacote. Se essas questões não puderem ser resolvidas a tempo para uma decisão, relate essa restrição de forma clara, em vez de apresentar uma preferência provisória como uma escolha aprovada.

A recomendação final ao comprador pode, então, ser concisa e auditável: cite os candidatos, apresente as evidências para cada um dos três usos, explique eventuais compromissos e identifique questões pendentes relacionadas à aprovação ou ao orçamento. Até que essas informações estejam disponíveis, a resposta honesta para o Projeto Norte não é “Modelo A” ou “Modelo B”. É que a comparação ainda não foi fundamentada por evidências.
Considere isso como uma verificação de adequação ao contexto, e não como uma classificação de qualidade.
Redação longa
Conclusão dentro do mesmo limite de produção de 2.400 tokens
A mesma especificação exigia cinco seções. Ambos os modelos tinham um limite de saída de 2.400 tokens; os metadados fornecidos explicam a diferença visível.
O Claude atingiu o limite máximo de saída configurado antes da regra de decisão. Sol concluiu o resumo dentro desse limite. Isso corrobora uma recomendação para esta execução restrita, e não uma classificação geral da capacidade máxima de redação ou da velocidade. O texto completo retornado, incluindo a resposta truncada, está reproduzido a seguir.
Tarefa extensa
Redação de texto extenso: o GPT-6 Sol concluiu o briefing
Esta é a primeira tarefa de comparação direta. A instrução mencionava explicitamente Claude Opus 5,5 e GPT-6 Sol, entregou a ambos o mesmo pacote informativo do Projeto Norte e solicitou um memorando de decisão condicional.
| Medida | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Comprimento visível | 648 palavras; motivo_da_conclusão=comprimento | 1.065 palavras; motivo_da_conclusão=interrupção |
| Seções obrigatórias | 4 de 5; Regra de decisão ausente após o truncamento | 5 de 5 |
| Tabela de pontuação de quatro linhas | Presente e simétrico | Presente e simétrico |
| Verificações do piloto / condição de parada | Iniciado, mas interrompido antes de ser concluído | Três verificações e uma condição de interrupção |
| Pontuação | 7.0 / 10 | 10.0 / 10 |
Conclusão: Com o mesmo limite de saída de 2.400 tokens, o GPT-6 Sol retornou todas as cinco seções, enquanto o Claude Opus 5.5 atingiu o limite antes da regra de decisão. Isso demonstra a conclusão nessa configuração; não estabelece, porém, a capacidade máxima de redação de nenhum dos modelos nem sua velocidade geral.
Entrada completa compartilhada
Você está redigindo um memorando de decisão para uma equipe que deve escolher entre o Claude Opus 5.5 e o GPT-6 Sol. Os nomes dos modelos são fixos e devem aparecer exatamente como estão escritos. Utilizando apenas o pacote de evidências abaixo, escreva de 900 a 1.100 palavras, incluindo exatamente estas seções: Recomendação executiva; O que as evidências comprovam; Onde faltam evidências; Piloto de 30 dias; Regra de decisão.

Requisitos: (1) compare o Claude Opus 5.5 e o GPT-6 Sol de forma simétrica; (2) separe as evidências observadas, as suposições e as incógnitas; (3) mantenha as datas exatas, o orçamento, o tamanho da equipe e o status de segurança não resolvido; (4) inclua um quadro de resultados compacto de quatro linhas abrangendo síntese de pesquisa, redação extensa, revisão de código e JSON estruturado; (5) apresente uma recomendação condicional em vez de inventar um vencedor; (6) listar três verificações piloto mensuráveis e uma condição de interrupção; (7) não inventar preços, benchmarks, limites de contexto ou recursos do produto.

PACOTE DE EVIDÊNCIAS
- O Projeto North é uma migração de 12 semanas para uma equipe de 40 pessoas.
- O orçamento aprovado para a migração é de $48.000. O pacote de evidências não especifica se o uso do modelo está incluído nesse orçamento.
- O cronograma para a revisão de segurança não está definido.
- A equipe precisa de síntese de pesquisa, redação extensa, revisão de código e extração estruturada de JSON.
- Uma parte interessada afirma que a versão preliminar atual é muito longa, mas nenhuma meta de número de palavras foi aprovada.
- Ainda não foram fornecidos resultados controlados do Claude Opus 5.5 ou do GPT-6 Sol.
- A equipe deseja uma opção auditável e pode realizar um piloto de 30 dias com prompts idênticos e revisão humana.

Envie apenas o memorando. Não afirme que o pacote de evidências comprove que algum dos modelos seja melhor.
Claude Opus 5,5 · saída completa retornada
## Recomendação executiva

Não selecione o Claude Opus 5.5 nem o GPT-6 Sol por enquanto. O pacote de evidências não contém resultados controlados de nenhum dos dois modelos. Portanto, não há base observável para declarar que um seja melhor que o outro em qualquer uma das quatro cargas de trabalho exigidas.

A recomendação é condicional. Realize um teste piloto de 30 dias que forneça prompts idênticos a ambos os modelos e aplique a mesma revisão humana. Em seguida, selecione o modelo que atender aos limites acordados antes do início do teste piloto, desde que as questões de segurança e orçamento abaixo sejam resolvidas primeiro. Há três resultados possíveis:

- **Um modelo atinge os limites:** escolha esse modelo.
- **Ambos atingem:** aplique os critérios de desempate da regra de decisão.
- **Nenhum atinge:** não adote nenhum dos dois.

Essa abordagem oferece à equipe a escolha auditável que ela solicitou.

Os fatos fixos do projeto são:

- O Projeto Norte é uma migração de 12 semanas para uma equipe de 40 pessoas.
- O orçamento aprovado para a migração é de $48.000. O pacote de informações não especifica se o uso dos modelos está dentro desse orçamento.
- O prazo para a revisão de segurança não está programado.
- O pacote de informações não fornece datas no calendário (nem data de início, nem data de término do projeto, nem janela para o piloto); portanto, este memorando não atribui nenhuma.

## O que as evidências comprovam

**Evidências observadas.** Estes são fatos declarados diretamente no pacote de informações:

- O Projeto Norte é uma migração de 12 semanas para uma equipe de 40 pessoas.
- O orçamento aprovado para a migração é de $48.000, e não está especificado se ele cobre o uso do modelo.
- O cronograma para a revisão de segurança não está definido.
- As cargas de trabalho necessárias são síntese de pesquisa, redação de textos extensos, revisão de código e extração estruturada de JSON.
- Uma parte interessada afirma que o rascunho atual é muito longo, mas nenhuma meta de número de palavras foi aprovada.
- Nenhuma saída controlada do Claude Opus 5.5 ou do GPT-6 Sol foi fornecida.
- A equipe deseja uma opção auditável e pode realizar um piloto de 30 dias com prompts idênticos e revisão humana.

**O que isso sustenta.** As evidências definem o que deve ser avaliado e como, mas não qual modelo é o vencedor. Elas justificam um piloto estruturado, comparativo. Não justifica nenhuma afirmação sobre qualidade, velocidade, custo, tratamento de contexto ou disponibilidade de recursos para nenhum dos modelos.

**Quadro de resultados (estado atual das evidências)**

| Carga de trabalho | Claude Opus 5.5 | GPT-6 Sol | Medida do piloto |
|---|---|---|---|
| Síntese de pesquisa | Nenhuma saída controlada fornecida | Nenhuma saída controlada fornecida | Pontuação da rubrica do revisor cego |
| Redação extensa | Nenhuma saída controlada fornecida | Nenhuma saída controlada fornecida | Pontuação da rubrica mais adesão a uma meta de extensão aprovada |
| Revisão de código | Nenhuma saída controlada fornecida | Nenhuma saída controlada fornecida | Proporção de problemas conhecidos identificados |
| JSON estruturado | Nenhuma saída controlada fornecida | Nenhuma saída controlada fornecida | Taxa de aprovação na validação do esquema |

Todas as células para ambos os modelos são idênticas, pois o pacote os trata de forma idêntica. Atualmente, nenhuma linha favorece nenhum dos modelos.

## Onde faltam evidências

**Incertezas.** O pacote não se pronuncia sobre cada um desses pontos:

- Se os custos de uso do modelo se enquadram no orçamento de migração de $48.000 ou exigem financiamento separado.
- Quando ocorrerá a análise de segurança, o que ela abrangerá e se algum dos modelos é aceitável nesse contexto. O status de segurança permanece indefinido para ambos os modelos.
- Datários para a migração de 12 semanas e o piloto de 30 dias.
- Uma meta aprovada de contagem de palavras para textos longos. O comentário das partes interessadas de que o texto é "muito longo" não pode ser avaliado sem essa meta.
- Preços, resultados de benchmarks, limites de contexto e recursos do produto para o Claude Opus 5.5 e o GPT-6 Sol. Nenhum desses dados foi fornecido, e este memorando não faz suposições a respeito.
- Quem são os revisores humanos, quantos são e como as divergências entre eles serão resolvidas.
- Quais dados o piloto poderá utilizar antes da conclusão da revisão de segurança.

**Suposições.** Trata-se de propostas apresentadas neste memorando, não de fatos contidos no pacote, e cada uma delas requer aprovação da equipe:

- O piloto pode utilizar material não confidencial ou sintético até que a revisão de segurança autorize o uso de dados reais.
- Os revisores podem não saber qual modelo produziu cada resultado.
- A equipe pode montar um conjunto fixo de prompts para cada carga de trabalho que represente as tarefas reais do Projeto North.
- Os limites de aprovação propostos abaixo são pontos de partida que a equipe pode alterar antes do início do projeto-piloto, mas não durante o mesmo.

## Projeto-piloto de 30 dias

**Concepção**

1.
GPT-6 Sol · saída completa retornada
## Recomendação executiva

Não selecione o Claude Opus 5.5 nem o GPT-6 Sol por enquanto. O Projeto North é uma migração de 12 semanas para uma equipe de 40 pessoas, e o pacote não fornece resultados controlados de nenhum dos modelos. Portanto, ele serve para um plano de comparação, não para um veredicto de desempenho. Execute o piloto disponível de 30 dias com prompts idênticos e revisão humana; em seguida, faça uma escolha auditável com base nos critérios acordados antes que os resultados sejam examinados. Escolha qualquer um dos modelos somente se o trabalho revisado atender às necessidades da equipe, se seu uso se encaixar no acordo financeiro aprovado e se a revisão de segurança pendente permitir a adoção. Se essas condições não forem atendidas, adie a seleção em vez de considerar uma comparação incompleta como uma vitória.

O orçamento de migração aprovado é de $48.000. O pacote não informa se o uso do modelo está dentro desse orçamento. O prazo para a revisão de segurança não está programado. Essas são restrições de decisão tanto para o Claude Opus 5.5 quanto para o GPT-6 Sol, e não evidências para favorecer um em detrimento do outro.

## O que as evidências sustentam

**Observado:** A equipe precisa de síntese de pesquisas, redação de textos extensos, revisão de código e extração estruturada de JSON. Ela deseja uma opção auditável e pode realizar um piloto de 30 dias utilizando prompts idênticos e revisão humana. Uma parte interessada afirma que a versão preliminar atual é muito longa, mas nenhuma meta de número de palavras foi aprovada. Esse feedback identifica um problema a ser testado nas saídas de texto; ele não estabelece um modelo preferencial nem um comprimento aceitável.

O quadro de resultados atual, organizado por tarefa, não apresenta classificação deliberadamente:

| Linha de trabalho | Claude Opus 5,5 | GPT-6 Sol | Evidências do piloto a serem coletadas |
|---|---|---|---|
| Síntese de pesquisa | Ainda não testado | Ainda não testado | Precisão, cobertura e rastreabilidade avaliadas pelo revisor |
| Texto longo | Ainda não testado | Ainda não testado | Utilidade, clareza e concisão avaliadas pelo revisor |
| Revisão de código | Ainda não testado | Ainda não testado | Conclusões verificadas pelo revisor e alegações sem fundamento |
| JSON estruturado | Ainda não testado | Ainda não testado | Resultados válidos e extração correta de campos |

**Suposição para planejamento, não um resultado observado:** Amostras de trabalho comparáveis e uma rubrica de avaliação comum podem revelar diferenças relevantes para o Projeto North. O piloto deve testar essa suposição. Prompts idênticos, por si só, não tornarão a escolha auditável: a equipe também deve reter as entradas, ambas as saídas, os critérios de revisão, os julgamentos dos revisores e as razões para quaisquer exclusões ou novas execuções. A revisão humana deve aplicar o mesmo padrão a cada modelo.

Para textos longos, os avaliadores devem distinguir entre “muito longo” e “inútil”. Uma resposta mais curta pode omitir informações necessárias; uma resposta mais longa ainda pode ser clara e útil. Como não há um número-alvo de palavras aprovado, o projeto-piloto pode registrar o comprimento e as avaliações dos avaliadores, mas não deve declarar retroativamente um número arbitrário de palavras como padrão de aceitação. A mesma disciplina se aplica às demais tarefas: registrar o que os revisores observaram, em vez de converter preferências em afirmações sobre a capacidade geral do modelo.

## Onde faltam evidências

**Desconhecido:** O pacote não contém resultados controlados do Claude Opus 5.5 ou do GPT-6 Sol. Ele não estabelece qualidade relativa, confiabilidade ou adequação para nenhuma das quatro linhas de trabalho. Também não fornece preços, limites de contexto, benchmarks ou informações sobre a capacidade do produto. Consequentemente, este memorando não pode estimar o custo de uso nem inferir qual modelo teria melhor desempenho no material do Projeto North.

O limite orçamentário precisa ser esclarecido antes de uma decisão de compra. O $48.000 é o orçamento aprovado para *migração*; não está especificado se o uso do modelo deve ser custeado a partir dele. Considerá-lo como incluído ou adicional criaria uma suposição financeira que o pacote não sustenta. A equipe deve documentar a resposta e o caminho de aprovação aplicável antes de se comprometer com o uso contínuo.

A questão da segurança também permanece sem solução para ambos os candidatos. Não há cronograma definido para a revisão de segurança, e o pacote de documentos não apresenta nenhum resultado relacionado à segurança. Um resultado sólido do piloto não resolveria essa situação. A equipe deve identificar quem pode agendar e decidir sobre a revisão, quais informações o revisor necessita e se a atividade do piloto em si é permitida pelas regras aplicáveis; o pacote de documentos não responde a essas perguntas. Não são fornecidas datas de início ou término para a migração, o piloto ou a revisão de segurança; portanto, a equipe não deve sugerir que uma decisão de segurança será tomada dentro do prazo de 30 dias do piloto ou das 12 semanas da migração.

## Teste-piloto de 30 dias

Antes da primeira comparação, a equipe deve selecionar prompts representativos para todas as quatro linhas de trabalho, definir o formato esperado de cada resposta e chegar a um acordo sobre uma rubrica de revisão humana. Ambos os modelos devem receber prompts idênticos e as mesmas instruções de revisão. Os revisores devem registrar seus julgamentos com base no trabalho em si, e não na reputação do modelo. Preserve a solicitação, a saída, a revisão e qualquer correção solicitada para que um leitor posterior possa reconstruir cada julgamento. Registre os desvios em relação ao processo comum, em vez de descartar silenciosamente os casos difíceis.

Utilize três verificações mensuráveis:

1. **Qualidade da tarefa avaliada:** Para síntese de pesquisa, redação de texto extenso e revisão de código, conte a proporção de resultados que os avaliadores aceitam para a tarefa especificada. Registre também os motivos de rejeição separadamente — por exemplo, cobertura incompleta, redação pouco clara ou uma constatação não verificada na revisão de código. Relate os resultados por linha de trabalho e modelo, não apenas como uma pontuação agregada.
2. **Confiabilidade do JSON estruturado:** Conte os resultados que correspondem à estrutura acordada e aqueles cujos campos extraídos forem verificados como corretos por um revisor. Relate ambas as taxas para o Claude Opus 5.5 e o GPT-6 Sol; uma resposta estruturalmente válida não deve ser considerada precisa apenas porque é analisada corretamente.
3. **Esforço de revisão e rastreabilidade:** Registre o tempo humano necessário para verificar e, quando necessário, corrigir cada saída. Conte os casos em que não haja evidências suficientes para explicar a decisão do revisor. Compare essas medidas no mesmo conjunto de prompts, incluindo casos em que nenhuma das saídas seja aceitável.

Chegue a um acordo sobre os padrões de aceitação e como os empates serão tratados antes de analisar os resultados do piloto; o pacote não fornece nenhuma referência a partir da qual se possam derivar limites numéricos. Ao final de 30 dias, publique a rubrica, as contagens, as justificativas dos revisores e as questões não resolvidas. **Condição de interrupção:** suspenda a adoção se os requisitos de segurança para o piloto ou uso subsequente não puderem ser atendidos, ou se a equipe não conseguir estabelecer um orçamento válido e um caminho de aprovação. Não substitua nenhuma dessas autorizações por pontuações de qualidade favoráveis.

## Regra de decisão

Selecione o Claude Opus 5.5 se as evidências do piloto atenderem aos padrões pré-acordados, forem significativamente mais sólidas nas linhas de trabalho priorizadas pela equipe e se suas condições de segurança e financeiras estiverem resolvidas. Aplique exatamente a mesma regra ao GPT-6 Sol. Se ambos atenderem aos padrões sem uma diferença relevante e significativa, decida com base nas prioridades documentadas do projeto e nas restrições resolvidas, em vez de declarar um vencedor em termos de desempenho. Se nenhum dos dois se qualificar — ou se o limite orçamentário ou o status de segurança permanecerem sem solução —, não faça a seleção do modelo ainda. Esse resultado preserva uma decisão auditável para a equipe de 40 pessoas, sem afirmar mais do que as evidências podem sustentar.
Metadados: Claude — HTTP 200 · 25,98 s · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27,763 s · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
Síntese de fontes
Tarefa de pesquisa
Síntese de fontes: um empate
Ambos os modelos resolveram o conflito de datas definindo a data de 15 de outubro, mantiveram o orçamento acordado de $12.000 e consideraram a afirmação de que “sempre é preciso” como uma alegação sem fundamento do gerente. O resultado é um empate nessa tarefa.
| Medida | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Pontuação | 9.5 / 10 | 9.5 / 10 |
| Gestão de conflitos | A S2 controla o prazo | A S2 controla o prazo |
| Afirmação sem fundamento | Marcado como “sem suporte” | Marcado como “sem suporte” |
| Diferença prática | Explicação mais detalhada sobre os riscos | Recomendação mais concisa |
Entrada completa compartilhada
Reconcilie as notas de referência abaixo. Entregue (1) uma tabela em Markdown com as colunas Alegação, Fonte de referência, Status, Motivo e (2) uma recomendação de aproximadamente 250 palavras. Utilize a nota de política com data mais recente como referência apenas para o conflito de prazos. Marque as alegações sem fundamento como “sem fundamento”. Não acrescente fatos.

[S1 01/09/2026] O projeto-piloto termina em 30 de setembro. O orçamento é de $12.000.
[S2 03/09/2026] O projeto-piloto termina em 15 de outubro. O orçamento permanece em $12.000.
[S3 02/09/2026] O departamento jurídico não aprovou o compartilhamento de dados externos.
[S4 04/09/2026] Um gerente afirma que o modelo é “sempre preciso”; nenhuma evidência de teste foi anexada.
[S5 04/09/2026] A equipe do projeto-piloto conta com 8 membros.
[S6 05/09/2026] O memorando de decisão deve listar os riscos não resolvidos.

Envie apenas a tabela e a recomendação.
Claude Opus 5,5 · saída completa
| Reivindicação | Fonte determinante | Status | Motivo |
|---|---|---|---|
| O piloto termina em 30 de setembro | S2 (03/09/2026) | Substituída | Entra em conflito com S2. A nota com data posterior prevalece no conflito de prazos. |
| O projeto-piloto termina em 15 de outubro | S2 (03/09/2026) | Aceita (predominante) | Esta é a nota com data mais recente sobre o conflito de prazo, portanto, prevalece sobre a S1. |
| O orçamento é de $12.000 | S1 e S2 | Apoiado | Ambas as fontes concordam, e S2 afirma que o orçamento "permanece" em $12.000. Não há conflito. |
| O departamento jurídico não aprovou o compartilhamento de dados externos | S3 | Confirmado | Afirmado diretamente e não contradito por nenhuma outra fonte. |
| O modelo é "sempre preciso" | S4 | Não confirmado | Trata-se de uma afirmação de um gerente sem evidências de teste anexadas. |
| A equipe piloto tem 8 membros | S5 | Comprovado | Afirmado diretamente e não contradito. Provém de uma única fonte. |
| O memorando de decisão deve listar os riscos não resolvidos | S6 | Comprovado | Trata-se de um requisito declarado para o memorando e não há contradição. |

**Recomendação**

O memorando de decisão deve utilizar 15 de outubro como data de término do projeto piloto. S2 é a nota com data mais recente e resolve o conflito de prazos, substituindo a data de 30 de setembro em S1. A regra da data mais recente se aplica apenas a este conflito. As demais afirmações foram avaliadas com base em suas próprias evidências.

O orçamento deve ser registrado como $12.000. S1 e S2 concordam com esse valor, portanto, não é necessária nenhuma reconciliação. O tamanho da equipe, de oito membros, também pode ser incluído. Isso se baseia apenas em S5, mas nenhuma fonte o contradiz.

O S6 exige que o memorando liste os riscos não resolvidos, e as notas comprovam a existência de pelo menos dois.

- **Compartilhamento de dados externos:** O departamento jurídico não aprovou (S3). O memorando deve declarar isso claramente. Não deve sugerir que o compartilhamento de dados externos seja permitido durante o projeto-piloto.
- **Precisão do modelo:** A alegação de que o modelo é "sempre preciso" não tem fundamento. O S4 observa que nenhuma evidência de teste foi anexada e registra a alegação apenas como uma declaração do gerente. O memorando não deve apresentá-la como uma conclusão nem se basear nela para justificar decisões. Deve indicar a precisão do modelo como não verificada até que sejam fornecidas evidências de apoio.

Por fim, o memorando deve indicar brevemente que a data de término do projeto-piloto mudou entre S1 e S2. Os leitores podem se deparar com a data anterior, 30 de setembro, em outros lugares, e essa observação explicaria por que se utiliza 15 de outubro. O memorando não deve acrescentar explicações sobre a mudança, resultados de testes ou atualizações sobre a situação jurídica, pois nada disso consta nas notas de referência.
GPT-6 Sol · saída completa
| Reivindicação | Fonte de referência | Status | Motivo |
|---|---|---|---|
| O projeto-piloto termina em 30 de setembro. | S2 (03/09/2026) | Substituída | A nota com data posterior resolve o conflito de prazos e estabelece 15 de outubro. |
| O projeto-piloto termina em 15 de outubro. | S2 (03/09/2026) | Comprovada | S2 fornece o prazo determinante. |
| O orçamento é de $12.000. | S1 e S2 | Comprovada | Ambas as notas indicam o mesmo valor. |
| O departamento jurídico não aprovou o compartilhamento de dados externos. | S3 | Aprovada | S3 afirma isso diretamente; nenhuma nota posterior aborda essa aprovação. |
| O modelo é “sempre preciso”. | S4 | Não aprovada | Um gerente faz essa afirmação, mas nenhuma evidência de teste está anexada. |
| A equipe piloto tem 8 membros. | S5 | Comprovado | S5 indica o tamanho da equipe. |
| O memorando de decisão deve listar os riscos não resolvidos. | S6 | Comprovado | S6 estabelece esse requisito. |

**Recomendação:** Use 15 de outubro como data de término do projeto-piloto no memorando de decisão. S2 é posterior a S1 e resolve o conflito de prazos entre eles. Mantenha o orçamento em $12.000: as notas concordam com esse valor, portanto a alteração do prazo não oferece base para alterá-lo. Registre o tamanho da equipe do projeto-piloto como 8 membros, conforme indicado em S5.

Liste explicitamente os riscos não resolvidos, conforme exige S6. O memorando deve indicar que o Departamento Jurídico não aprovou o compartilhamento de dados externos, sem sugerir que a aprovação tenha sido concedida posteriormente ou que o compartilhamento seja permitido. Deve também distinguir a declaração do gerente sobre a precisão de uma conclusão comprovada. O S4 registra a declaração de que o modelo é “sempre preciso”, mas não fornece evidências de teste. Não apresente essa declaração como um resultado verificado.

Mantenha a reconciliação restrita. O S2 trata das datas finais conflitantes; ele não substitui as notas separadas sobre o Departamento Jurídico, a precisão, o tamanho da equipe ou os requisitos do memorando. Quando as notas não estabelecerem um resultado, deixe a questão em aberto em vez de apresentar uma suposição. Em particular, o registro não corrobora nem a alegação de que o compartilhamento de dados externos tenha sido aprovado, nem a alegação de que a precisão do modelo tenha sido comprovada.

O memorando resultante pode, portanto, utilizar o prazo de 15 de outubro e o orçamento de $12.000, ao mesmo tempo em que identifica as duas lacunas de evidência evidentes nessas notas: a aprovação jurídica pendente para o compartilhamento de dados externos e a ausência de evidências de teste para a afirmação de precisão.
Metadados: Claude — HTTP 200 · 12,846 s · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12,322 s · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
Codificação e saída estruturada
A diferença na codificação estava na explicação
Condição de filtragem original: se t
Um elemento None é considerado falso, portanto, esse filtro já o ignora.
Ambos os modelos retornaram um JSON válido com as quatro chaves solicitadas e o mesmo patch mínimo. O Claude descreveu corretamente o filtro existente; o GPT-6 Sol afirmou incorretamente que um elemento `None` causaria um erro. Esse erro específico de diagnóstico é importante quando um revisor decide se um patch corrige a falha real.
O Claude forneceu uma lista de riscos, enquanto o Sol forneceu uma breve sequência de riscos. A instrução não exigia um tipo específico para esse campo; portanto, essa diferença não constitui uma violação do contrato. A pontuação da tarefa do Sol é de 9,0/10 após a correção da dedução anterior de meio ponto, que não tinha fundamento; a dedução por imprecisão factual permanece.
Tarefa de codificação
Codificação e saída estruturada: Claude Opus 5.5 foi mais preciso
Ambos os modelos retornaram um JSON válido com as chaves solicitadas e o mesmo patch mínimo. O Claude explicou corretamente que o filtro original já ignora um Nenhum elemento. O GPT-6 Sol afirmou incorretamente que um Nenhum Esse elemento causaria um erro. O prompt não exigia um tipo específico para o campo “riscos”.
| Medida | Claude Opus 5,5 | GPT-6 Sol |
|---|---|---|
| Pontuação | 10.0 / 10 | 9.0 / 10 |
| Patch | Correto e minimalista | Correto e minimalista |
| Diagnóstico | Isola corretamente ambos os defeitos | Exagera a falha do elemento “None” |
| Contrato JSON solicitado | JSON válido; todas as quatro chaves estão presentes | JSON válido; todas as quatro chaves estão presentes |
Entrada completa compartilhada
Retorne apenas um JSON estrito com as chaves diagnosis, patch, tests e risks. Diagnostique e aplique uma correção mínima a esta função em Python para que todos os três casos sejam aprovados. A correção deve manter a assinatura da função.

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

Casos:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

Não execute código e não inclua balizas de Markdown nem texto fora do JSON.
Claude Opus 5,5 · saída completa
{"diagnóstico":"Duas falhas, identificadas pela análise do código (sem execução). (a) Caso 2: quando `tags` é `None`, o gerador itera sobre `None` e gera um `TypeError` em vez de retornar ''. (b) Caso 3: o filtro 'if t' é executado antes da remoção de espaços em branco. A tag composta apenas por espaço em branco ' ' é considerada verdadeira, portanto, ela é aceita e se torna ''. O resultado é sorted(['', 'seo']), que se une a ',seo' em vez de 'seo'. O elemento None no caso 3 já é descartado pelo 'if t'. O caso 1 já funciona: ' AI ', 'ai' e 'Code' são normalizados para {'ai', 'code'}, resultando em 'ai,code'.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":["assert normalize_tags([' AI ', 'ai', 'Code']) == 'ai,code' # rastreado: {'ai','code'} -> 'ai,code'","assert normalize_tags(None) == '' # rastreado: (None ou []) -> [] -> ''","assert normalize_tags([' ', None, 'SEO']) == 'seo' # rastreado: ' ' falha em t.strip(), None falha em t, 'SEO' -> 'seo'"],"riscos":["Elementos que não sejam strings, como 123, gerarão uma exceção AttributeError em .strip(). Esse comportamento permanece inalterado em relação ao original.","'tags ou []' trata qualquer entrada falsa (por exemplo, '' ou uma tupla vazia) como vazia. Isso é consistente com o comportamento exigido None -> ''.","Se uma única string for passada em vez de um iterável de tags, ela será iterada caractere por caractere. Isso não mudou em relação ao comportamento original.","Os espaços internos não são colapsados; portanto, 'machine learning' e 'machine learning' continuam sendo tags distintas.","Os testes foram derivados apenas por rastreamento manual e não foram executados, conforme instruído."]}GPT-6 Sol · saída completa
{"diagnosis":"A função gera um erro quando `tags` é `None` ou contém `None`, e mantém as entradas que ficam vazias após a remoção de espaços.","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI ","ai","Code"],"expected":"ai,code"},{"input":null,"expected":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"Não executado. Entradas diferentes de None são consideradas strings."}Metadados: Claude — HTTP 200 · 10,832 s · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7,71 s · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
Veredicto final
Escolha prática
Qual modelo é mais adequado para o seu trabalho?
O GPT-6 Sol lidera este pequeno conjunto de resultados iniciais porque concluiu o contrato em formato longo revisado, enquanto o Claude Opus 5.5 atingiu o limite compartilhado de 2.400 tokens de saída. O Claude Opus 5.5 lidera a tarefa de código/JSON em precisão de diagnóstico. A síntese de código está empatada.
Escolha GPT-6 Sol quando a prioridade imediata é concluir, de uma só vez, um documento de decisão extenso e com múltiplas restrições. Escolha Claude Opus 5,5 quando uma revisão de código ou de saída estruturada se beneficia de um diagnóstico mais explícito e de um inventário de riscos. Se o seu trabalho envolver ambos, direcione cada tarefa para o modelo mais adequado, em vez de forçar a adoção de uma única solução universal.
O GlobalGPT oferece uma maneira prática de manter tanto os modelos quanto o restante do seu fluxo de trabalho de IA em um único painel. Pesquisa, redação, programação, imagens, vídeo e trabalhos de produção conectados à CLI podem permanecer no mesmo ambiente de trabalho.
Perguntas frequentes
Qual modelo saiu vencedor na comparação?
O GPT-6 Sol liderou o pequeno conjunto de resultados iniciais por 28,5 a 26,5, após a exclusão da tarefa de limites original e a correção da dedução do contrato JSON. Essa vantagem resultou da conclusão do contrato revisado em formato longo, dentro do mesmo limite de saída de 2.400 tokens; o Claude Opus 5.5 liderou a tarefa de código e saída estruturada, enquanto a síntese de código-fonte terminou empatada.
Por que o primeiro teste de formato longo foi excluído?
A instrução original não mencionava nenhum dos dois modelos. Ambos os modelos se recusaram corretamente a adivinhar as identidades ausentes; assim, essa resposta verifica se um modelo solicita o contexto que falta, em vez de fingir que sabe.
O Claude Opus 5.5 é melhor para codificação?
Nesta tarefa envolvendo código e JSON, o Claude Opus 5.5 apresentou o diagnóstico mais preciso e uma lista de riscos mais estruturada. Uma única tarefa não é suficiente para estabelecer uma classificação universal de codificação.
O GPT-6 Sol é melhor para escrever?
O GPT-6 Sol concluiu o memorando extenso revisado dentro dos parâmetros solicitados já na primeira saída. O resultado corrobora essa recomendação de fluxo de trabalho para este teste, e não constitui uma afirmação geral sobre todas as tarefas de redação.
Posso testar os dois modelos sem precisar trocar de plataforma?
O GlobalGPT foi projetado como uma assinatura de IA multimodelo, reunindo diversas funções de IA em um único painel. Ele é útil para executar o mesmo pacote de prompts de pesquisa, redação e programação em diferentes modelos e manter todo o fluxo de trabalho em um único local.
GlobalGPT permite que você mantenha tanto os modelos quanto o restante do seu fluxo de trabalho de IA em um único lugar. Comece com o modelo adequado para a tarefa imediata e, em seguida, avance pelo processo de pesquisa, redação, programação, imagens, vídeo ou etapas de produção conectadas à CLI, sem precisar abrir um serviço separado para cada etapa.









