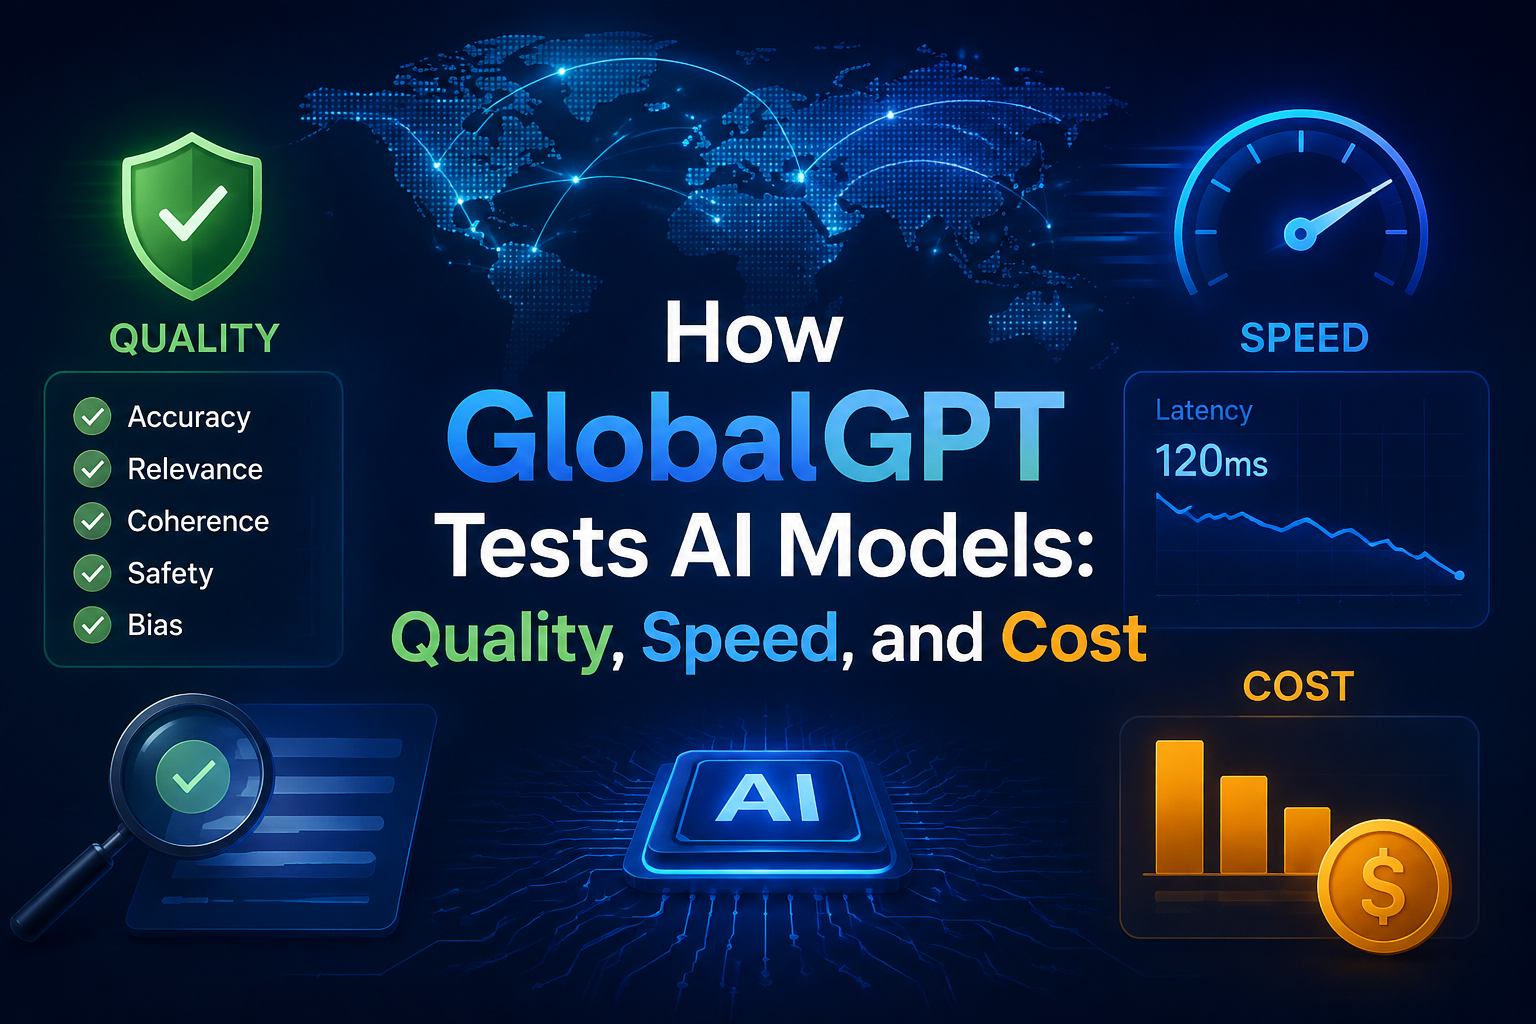
Een modelvergelijking begint met een specifieke taak: wat was onze vraag, en voldeed de output aan de vereisten? We testen AI-modellen op GlobalGPT met behulp van de GlobalGPT CLI. Uitzonderingen worden vermeld in het betreffende artikel.
AI controleert de output op fouten en of de instructies correct zijn opgevolgd. Wanneer de output deze controles doorstaat, vergelijken we de snelheid, de prijs en het gebruik van tokens, indien van toepassing. Auteurs beoordelen ook subjectieve kwaliteiten, zoals schrijfstijl en visuele aantrekkelijkheid. De audio-evaluatie wordt volledig door AI uitgevoerd met behulp van Gemini 3.6 Flash.
Wij zijn de GlobalGPT-beoordelingsteam, onderdeel van GlobalGPT. Deze methodologie omvat de tests die we op de blog publiceren wanneer er nieuwe modellen op de markt komen, evenals modelvergelijkingen. Onderzoeksrapporten op basis van GlobalGPT-gebruikersgegevens geven uitleg over de gebruikte datasets en analysemethoden.
Onze testomgeving: GlobalGPT CLI
De GlobalGPT CLI is onze standaardtestomgeving. Een test waarbij gebruik wordt gemaakt van een andere interface, API-route of native programmeertool moet in die context worden gezien. Modelnamen, beschikbare instellingen, tools en toegangsrechten kunnen per omgeving verschillen.
Het model dat een uitvoer genereert en de AI die deze beoordeelt, hebben verschillende rollen. Het oordeel van een beoordelaar is een indicatie van de geretourneerde uitvoer; het geeft geen uitsluitsel over hoe het geteste model intern werkt.
Taakontwerp: aanwijzingen, invoergegevens en vereisten
We geven modellen concrete opdrachten met duidelijk omschreven vereisten. Bij een schrijfopdracht kan het bijvoorbeeld gaan om het maken van een samenvatting op basis van uitsluitend de verstrekte aantekeningen. Bij een programmeeropdracht kan het gaan om het schrijven van een functie die een lege invoer verwerkt. Bij een afbeeldingsopdracht kan het gaan om de exacte tekst die op een poster moet staan.
Ter vergelijking: de prompt en het invoermateriaal bepalen wat er van elk model wordt verwacht. Verschillen in ondersteunde formaten, instellingen of beschikbare hulpmiddelen zijn van belang bij het interpreteren van de resultaten. Een vergelijking van vaste prompts en een tutorial waarin een prompt in meerdere pogingen wordt verbeterd, geven antwoord op verschillende vragen.
Evaluatie van de uitvoer: fouten, instructies en efficiëntie
Fouten en het onmiddellijk naleven van instructies
AI beoordeelt of de uitvoer in overeenstemming is met de opdracht en of er herkenbare fouten in zitten. Relevante controles kunnen betrekking hebben op onjuiste berekeningen, ongefundeerde beweringen, ontbrekende velden of het niet naleven van een vereiste opmaak.
Als de test is geslaagd, betekent dit dat er bij de uitgevoerde controles geen fouten zijn vastgesteld. Dit biedt geen garantie dat de output vrij is van alle mogelijke fouten. AI-beoordelaars kunnen fouten over het hoofd zien of onjuiste beslissingen nemen.
Het bewijs van uitvoering vormt een apart onderdeel van de beoordeling. In onze Test van Kimi's programmeerplan, de gegenereerde code werd gevolgd door vijf lokale controles. Het lezen van de code, het vragen aan een model om zijn eigen antwoord te controleren en het uitvoeren van tests leveren verschillende soorten bewijs op.
Snelheid, prijs en gebruik van tokens
Zodra een resultaat aan de taakvereisten voldoet, helpt efficiëntie om bruikbare opties te onderscheiden. Een snel antwoord waarin een vereiste berekening ontbreekt, heeft niet dezelfde taak volbracht als een juist antwoord.
| Maat | Hoe je het moet lezen |
|---|---|
| Tijd | Bekijk het meetvenster. De tijd tussen het verzoek en de voltooiing omvat de route en de verwerking; het gaat hier niet noodzakelijkerwijs om de latentie van het model aan de kant van de provider. |
| Gebruik van tokens | Gebruik de categorieën die door de dienst worden teruggestuurd. Het ontbreken van gegevens over invoer, uitvoer, cache of redeneringstokens betekent niet dat er geen gebruik van wordt gemaakt. |
| Kosten | Maak onderscheid tussen geboekte GlobalGPT-kosten of -credits en schattingen op basis van de API-prijzen van de aanbieder. Abonnementsgelden vormen een andere maatstaf. |
| Mediageneratie | Houd rekening met de uitvoerinstellingen en de van toepassing zijnde kredieten of kosten per uitvoer. Het aantal tokens is mogelijk niet beschikbaar of niet zinvol. |
Een prijsraming moet een duidelijk aangegeven berekeningsgrondslag hebben. Credits kunnen niet in dollars worden omgerekend zonder een geverifieerde omrekeningsregel, en een antwoordveld met de waarde nul is op zichzelf geen bewijs dat een verzoek gratis was.
Beoordeling door de auteur van subjectieve opdrachten
Auteurs vergelijken ook resultaten wanneer persoonlijke voorkeuren van invloed zijn op het nut ervan. Bij teksten of afbeeldingen kan dat betekenen dat wordt uitgelegd welk resultaat helderder taalgebruik heeft, een beter leesbare opmaak heeft of een compositie die beter aansluit bij de opdracht.
Onze Vergelijking tussen Seedream 5.0 Pro en GPT Image 2 toont bij elkaar geplaatste afbeeldingen bij specifieke taken. De zichtbare tekst en opmaak bieden lezers iets om te bekijken naast de voorkeur van de auteur. Een esthetische voorkeur staat los van een objectief gecontroleerde eis.
AI-audio-evaluatie met Gemini 3.6 Flash
Onze luistertests worden volledig door AI uitgevoerd. We gebruiken Gemini 3.6 Flash om de daadwerkelijke audio te analyseren. Dit zijn AI-beoordelingen, geen resultaten van een menselijk luisterpanel.
De beoordeling hangt af van de taak: gevraagde spraak, taal, geluidsgebeurtenissen, timing of muzikale structuur. Onze Recensie van Seed Audio 1.0 omvat gegenereerde audio en AI-analyse van inhoud, gebeurtenissen, timing en artefacten.
Bestandseigenschappen zoals formaat en duur staan los van beoordelingen van de inhoud. Het feit dat er een audiotrack aanwezig is, bewijst nog niet dat de gevraagde woorden of geluiden correct zijn. Elke gepubliceerde partituur moet worden gelezen in samenhang met de beoordelingscriteria en de audio die erin wordt beschreven.
Hoe je testdata, instellingen en uitkomstgegevens interpreteert
In het afzonderlijke artikel hoort de gedetailleerde testinformatie thuis. Nuttige context omvat onder meer:
- De testdatum, de modelcode en de omgeving.
- De opdracht, de instructie, het bronmateriaal en het vereiste resultaat.
- Beschikbare instellingen, aantal pogingen en relevante wijzigingen.
- De beoordelaar, de uitgevoerde controles en de redenen voor eventuele voorkeuren van de auteur.
- Daadwerkelijke output of fragmenten, schermafbeeldingen of media, en beschikbare gegevens over timing, gebruik en kosten.
De gegevens verschillen per artikel en per oudere test. Ontbrekende metingen kunnen niet als waargenomen feiten worden gereconstrueerd. In de rubriek ‘Blog & Handleidingen’ op de pagina van een modelcollectie staan links naar de relevante beoordelingen en deze methodologie; de volledige instructies en het bewijsmateriaal van de uitvoer zijn te vinden in de blogartikelen.
Uitleg over herhalingspogingen, mislukte verzoeken en herzieningen
Een eerste uitkomst, een geselecteerd resultaat en een herziene poging geven de lezers verschillende informatie. De geschiedenis van de pogingen in het artikel is van belang, met inbegrip van technische storingen, lege antwoorden, afgekorte antwoorden en wijzigingen in de prompts of instellingen.
Een voltooid verzoek kan nog steeds een onbruikbaar antwoord opleveren. Een mislukt verzoek kan een probleem met de geteste route aan het licht brengen, zonder dat dit een algemene zwakte in het model aantoont. In onze artikelen hanteren we verschillende testomvang; er ligt geen universeel aantal testruns of blinde testprocedure ten grondslag aan elk resultaat.
Wat de resultaten van een taak je wel en niet kunnen vertellen
Een resultaat ondersteunt een conclusie over de geteste taak, het model, de datum en de omgeving. Kleine reeksen taken en afzonderlijke tijdmetingen kunnen geen algemene prestatieranglijst opleveren. Als slechts één kant van een vergelijking is getest, kan dat bewijs niet dienen als onderbouwing voor een winnaar tussen beide modellen.
Officiële specificaties, externe benchmarks, eerdere tests en de eigen resultaten van een artikel leveren verschillende soorten bewijsmateriaal op. Elke score hangt af van de aangegeven schaal, de weging en de uitsluitingen. Lezers moeten het oordeel kunnen koppelen aan het bewijsmateriaal, inclusief gedeeltelijke of mislukte resultaten.
Het verschil tussen artikelupdates en het opnieuw testen van modellen
Over het algemeen beoordelen we artikelen om de twee tot vier weken, zoals beschreven in onze Redactionele normen. Een inhoudscontrole houdt niet in dat elke modeltoets opnieuw is uitgevoerd.
Het bijwerken van een prijs, het corrigeren van een beoordeling van een bestaande output en het genereren van een nieuwe output zijn afzonderlijke handelingen. Historische bevindingen blijven gekoppeld aan hun oorspronkelijke testcontext; het feit dat de datum van een artikel is bijgewerkt, maakt deze bevindingen op zich nog niet tot nieuwe testresultaten.