Modeloverzicht · Benchmarks · Praktische API-tests
Gemini 3.7 Flash wordt gepositioneerd als een snel model met redeneervermogen voor codering, agentisch werk, multimodale invoer en alledaagse productietaken. De meer relevante vraag is echter moeilijker te beantwoorden: levert het betere eindresultaten op dan Gemini 3.6 Flash wanneer beide modellen dezelfde prompt krijgen?
In deze Gemini 3.7 Flash-recensie worden drie soorten bewijsmateriaal onderscheiden. De documentatie van Google biedt ondersteuning voor modelgegevens, prijzen en officiële benchmarkclaims. Artificial Analysis levert onafhankelijke benchmarkgegevens van een derde partij. Onze praktische vergelijking maakt gebruik van zeven op elkaar afgestemde API-taken, waarbij voor beide modellen dezelfde prompt- en generatie-instellingen zijn gebruikt.
Gemini 3.7 Flash staat vermeld voor het testen via de GlobalGPT Gemini 3.7 Pagina met Flash-modellen. Zo kun je op één plek dezelfde prompt op meerdere modellen toepassen, inclusief de basislijn die in deze beoordeling is gebruikt. Zie voor meer context ons Gemini 3.6 Korte beoordeling en de Vergelijking tussen Gemini 3.6 Flash en Gemini 3.1 Pro.
Gemini 3.7 Flash-recensie: het korte antwoord
Gemini 3.7 Flash leverde in drie van de zes voltooide taakparen het beter afgewerkte antwoord op, tegenover twee overwinningen voor Gemini 3.6 Flash en één gelijkspel. De voordelen kwamen naar voren op het gebied van codering, gegevensanalyse en claimveilige SEO-bewerking. Gemini 3.6 Flash leverde het strakkere tekstuele frontend-ontwerp en de nauwkeurigere status-extractie, terwijl de agentgebaseerde planning in een gelijkspel eindigde.
Overzicht van de recensie
| Maat | Waargenomen resultaat | Wat dit betekent |
|---|---|---|
| Afdrukkwaliteit | 3,7 won 3; 3,6 won 2; 1 gelijkspel | De beoordelingen zijn gebaseerd op het voltooide werk dat op elke kaart te zien is. |
| Snelheid | Gemengd | 3.7 was bij vier taken sneller klaar, maar 3.6 had een iets lager gemiddelde over zes taken. |
| Token-efficiëntie | 3.7 gebruikte 7.948 output-tokens; 3.6 gebruikte 10.058 | Over alle voltooide taken heen leverde 3.7 21% minder output-tokens op. |
| Het beste resultaat van 3,7 | SEO-bewerkingen zonder risico op claims | Het hield zich aan de vaststaande feiten zonder daar ongefundeerde beschrijvingen aan toe te voegen. |
Dit zijn zes kleine, gecontroleerde tekstopdrachten, geen algemene ranglijst van modellen. T01 is buiten beschouwing gelaten omdat geen van beide modellen het gevraagde antwoord binnen de vastgestelde maximale uitvoerlengte heeft voltooid.
Wat is Gemini 3.7 Flash?
Gemini 3.7 Flash is het stabiele model van Google met hoge doorvoercapaciteit voor taken waarbij redeneren nog steeds van nut is. Google noemt tekst, afbeeldingen, video, audio en PDF-bestanden als invoerformaten; ondersteunde mogelijkheden zijn onder meer het aanroepen van functies, het uitvoeren van code, zoekopdrachten op basis van context, het zoeken naar bestanden, gestructureerde uitvoer en computergebruik (Preview). De praktische vraag is hoe die instellingen zich vertalen naar het uiteindelijke resultaat.
Verschijningsdatum en beschikbaarheid
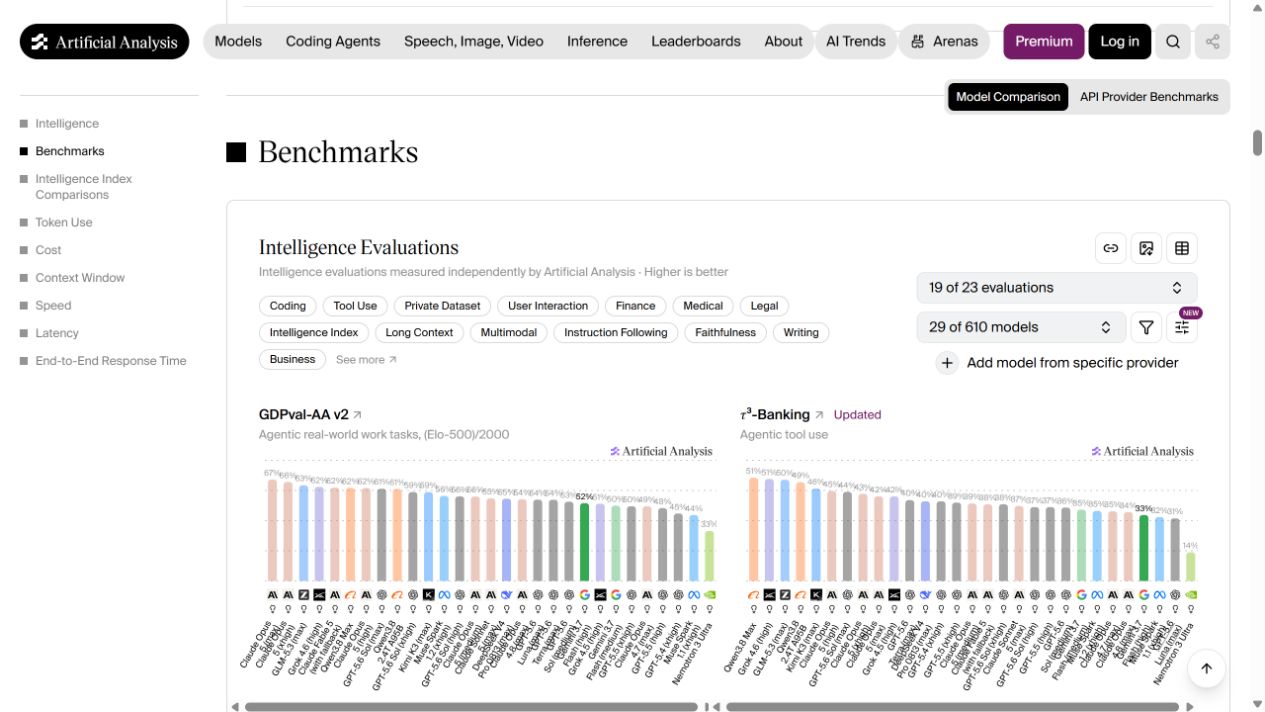
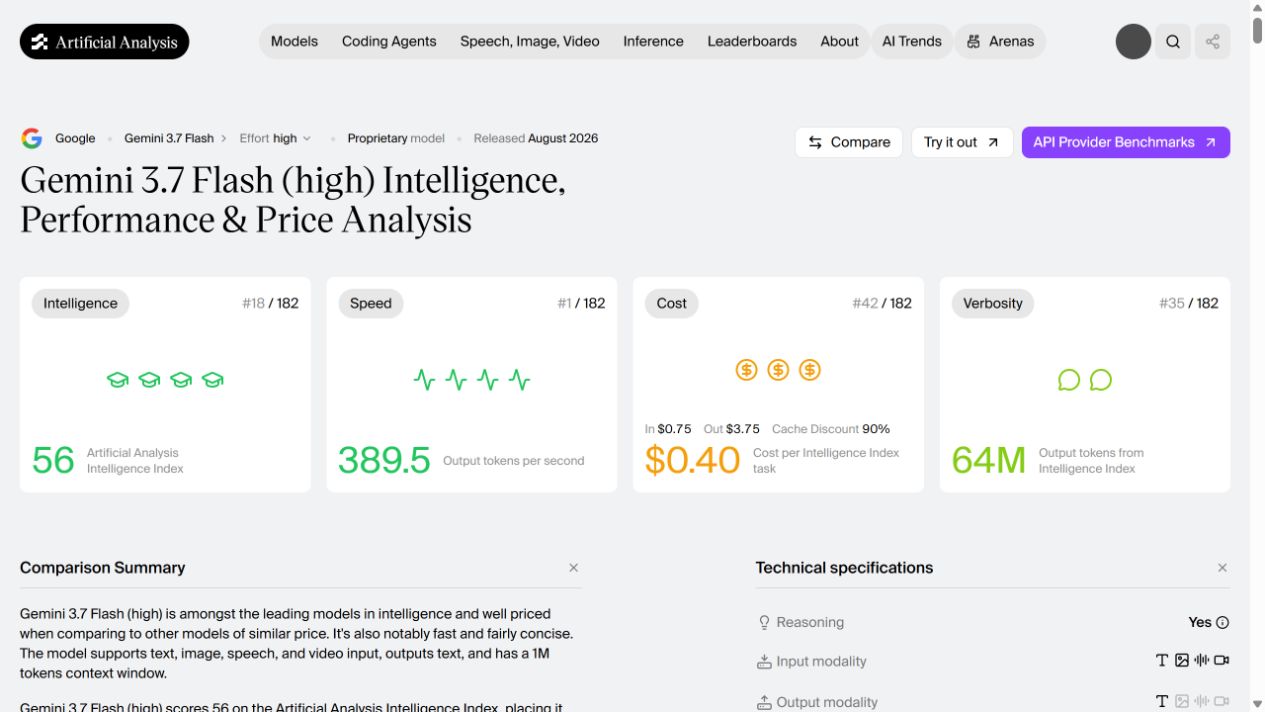
Op de afbeelding van de pagina ‘Artificial Analysis’ wordt Gemini 3.7 Flash (high) vermeld met een releasedatum in augustus 2026. Raadpleeg Google voor de officiële status, het model-ID, de ondersteunde functies en details over de uitrol. officiële Gemini 3.7 Flash-modelkaart en de bijbehorende API-documentatie. De beschikbaarheid kan variëren per product, regio, account en modelniveau, dus het feit dat een model op een pagina wordt vermeld, is op zich geen bewijs dat het voor iedereen toegankelijk is.
Wat is er veranderd ten opzichte van de Gemini 3.6 Flash?
De verandering komt niet alleen neer op een hogere benchmarkscore. Google beschrijft Gemini 3.7 Flash als een doorontwikkeling van Gemini 3.6 Flash, met verbeteringen in de redeneerbasis en het aanpasbare denkvermogen. In onze voltooide paren vertaalde zich dat in een betere omgang met beperkingen bij drie taken, maar het was geen volledige overwinning.
| Vergelijkingsgebied | Gemini 3,7 Flash | Gemini 3,6 Flash | Waargenomen bewijs |
|---|---|---|---|
| Fout in de code verholpen | Klopt, met nauwkeurigere tests | Klopt, maar langer | 3,7 lichte overwinning |
| Plan voor de tekstuele frontend | Gebruiksklaar, met twee redactionele fouten | Netter en intern consistenter | 3.6 kleine overwinning |
| Statusbewuste extractie | Volledige terugroepactie, maar één overdreven succeslabel | Nauwkeurigere statusformulering | 3.6 kleine overwinning |
| Gegevensanalyse | Klopt, met een duidelijkere standaardverdeling | Klopt, met meer voorwaardelijke details | 3,7 lichte overwinning |
| Agentische planning | Stevige afsluitpoorten | Meer gedetailleerde informatie over gereedschapsaanroepen | Stropdas |
| SEO-redactie | Alle vergrendelde claims bewaard | Er is één niet-ondersteund bijvoeglijk naamwoord toegevoegd | 3,7 lichte overwinning |
Gemini 3.7 Flash-specificaties en contextvenster
Specificaties zijn belangrijk omdat ze bepalen onder welke voorwaarden een vergelijking eerlijk is. Als je de limieten van de polissen vergelijkt in plaats van het gedrag van het model, dan is onze Gids voor limieten en quota van Gemini is de meer gedetailleerde vervolgtest. Een contextvenstergetal betekent niet automatisch dat een model elk lang document nauwkeurig zal samenvatten; het geeft alleen aan wat de API is ontworpen om te verwerken. De onderstaande extractietest zal de recall, de omgang met tegenstrijdigheden en onbekende elementen afzonderlijk beoordelen.
| Specificatie | Gemini 3,7 Flash | Gemini 3,6 Flash | Bron |
|---|---|---|---|
| Teruggegeven API-model-ID | gemini-3.7-flash | gemini-3.6-flash | Opgeslagen API-antwoorden |
| Invoercontext | Maximaal 1 miljoen tokens | Maximaal 1 miljoen tokens | Google-modelkaart |
| Maximale tekstuitvoer | 64K tokens | 64K tokens | Google-modelkaarten |
| Gedocumenteerde inputs | Tekst, afbeeldingen, audio, video | Tekst, afbeeldingen, audio, video | Google-modelkaarten |
Gemini 3.7 Flash-prijzen en API-kosten
Bij de prijsstelling moet er een duidelijk onderscheid worden gemaakt tussen het gepubliceerde tarief en de kosten van één specifiek antwoord. Uit de vastgelegde samenvatting van de kunstmatige analyse blijkt dat $0,75 per 1 miljoen ingevoerde tokens en $3,75 per 1 miljoen uitgegeven tokens voor de geselecteerde vermelding van Gemini 3.7 Flash (high). Deze cijfers zijn afkomstig van externe bronnen en vormen geen vervanging voor de officiële prijstabel van Google, noch een uitspraak over elke toegangsroute.
Vastgelegde prijsinformatie van derden
Alleen relatief visueel. De balken vormen geen vervanging voor de officiële factureringseenheid, het tariefniveau, de regio of de cache-/batchregels.
De Google-modelkaart vermeldt een introductietarief voor de API van $0,75 per 1 miljoen invoertokens en $3,75 per 1 miljoen uitvoertokens voor beide Flash-modellen tot en met 31 december 2026. In de onderstaande schattingen per kaart wordt dat tarief toegepast op geregistreerde tokens; herpogingen, caching, belastingen en routespecifieke kosten zijn hierin niet meegerekend.
| Kostenpost | Gemini 3,7 Flash | Gemini 3,6 Flash | Bewijsgrens |
|---|---|---|---|
| Inleidende inkoopprijs | $0,75 / 1M | $0,75 / 1M | Google-modelkaart; geldig tot 31 december 2026 |
| Startprijs | $3,75 / 1M | $3,75 / 1M | De facturering kan per route verschillen |
| Zes voltooide testparen | Over $0.0303 | Over $0.0382 | Afgeleid van geregistreerde tokens; T01 uitgesloten |
Gemini 3.7 Flash Officiële benchmarks
Officiële benchmarks geven antwoord op een specifieke vraag: hoe het model presteerde bij een gepubliceerde evaluatie onder de omstandigheden van die evaluatie. Ze bieden nuttige context, maar vormen geen vervanging voor de vergelijking van de output bij dezelfde prompt in deze beoordeling.
Benchmarks voor programmeren, agents en redeneren
De Google-modelkaart en de officiële documentatie zijn de bronnen die moeten worden geraadpleegd voor de benchmarkclaims van Google zelf. In de definitieve versie worden voor elk cijfer de meetwaarde, de datum, de modelvariant, het vergelijkingsmodel en de testomstandigheden vermeld. Een resultaat van 3,7 in vergelijking met een ouder model wordt niet zomaar gepresenteerd als een 3,7-versus-3,6-resultaat.
Wat benchmarkresultaten niet aantonen
- Een hogere coderingsscore betekent niet dat de eerste patch voor elke repository ook schoner is.
- Een score voor redeneervermogen is geen bewijs van betere SEO-redactie of betere interpretatie van schermafbeeldingen.
- Een door een derde partij opgestelde kennisindex vormt geen vervanging voor het taakspecifieke bewijsmateriaal in dit overzicht.
- Overlappende onzekerheden of uiteenlopende testomstandigheden mogen niet worden gebruikt om een definitieve rangorde vast te stellen.
Hoe we de Gemini 3.7 Flash hebben getest
Dit was een vergelijkende API-test, geen verzameling losstaande demo’s. Beide modellen kregen dezelfde prompt, hetzelfde bronmateriaal, een temperatuur van 0, hetzelfde maximum aantal output-tokens en dezelfde presentatiebehandeling. T05 werd beoordeeld op basis van een gezamenlijke herhaling van 5.000 tokens nadat beide eerste pogingen het lagere maximum hadden bereikt. T01 bleef voor beide modellen onvolledig, zelfs na dezelfde herhaling.
| Geregistreerd veld | Waarom het belangrijk is |
|---|---|
| Model-ID en geretourneerde model-ID | Bevestigt dat het gevraagde model het model is dat heeft geantwoord. |
| Verstreken seconden | Meet de responstijd van begin tot eind via dezelfde route. |
| Invoer- en uitvoertokens | Ondersteunt een vergelijkbare kostenraming. |
| Naleving van het formaat | Maakt onderscheid tussen een juist antwoord en een antwoord dat qua opbouw nog wat bijgeschaafd moet worden. |
| Redactionele kwaliteit | Controleert de juistheid, volledigheid, specificiteit, presentatie en veiligheid van de claim. |
Een verzoek waarvoor kosten in rekening zijn gebracht maar dat geen bruikbare output oplevert, wordt gemeld als een uitvoeringsprobleem en wordt niet als kwaliteitsverlies aangemerkt.
Gemini 3.7 Flash: testresultaten in de praktijk
Op elke kaart staan de daadwerkelijke opdrachtgegevens, een getrouw fragment uit elk opgeslagen antwoord en een beoordeling op basis van het voltooide werk. De verstreken tijd is de totale doorlooptijd. Voor de kosten wordt het hierboven beschreven introductietarief van Google gehanteerd.
Toets 1 — Onderzoekssynthese
Opdracht: Schrijf een aankoopaanbeveling van 180 woorden waarbij je uitsluitend gebruikmaakt van de vier verstrekte feiten, met één aanbeveling, drie redenen, twee onbekende factoren en een testplan.
Gemini 3,7 Flash
33,427 s · 85 invoer- / 4.996 uitvoertokens · geschat: $0,01880
De tweede geautomatiseerde run stopte bij het maximum van 5.000 tokens, waarna er een bruikbare aanbeveling van 180 woorden werd gegenereerd.
Gemini 3,6 Flash
28,706 s · 85 invoer- / 4.996 uitvoertokens · geschat $0,01880
Het gaf hetzelfde aantal voltooiingstokens en hetzelfde lengte reden voor voltooiing.
Wat uit de resultaten blijkt
Beide modellen bereikten eerst 2.400 tokens en herhaalden dit gedrag vervolgens bij 5.000. Gedeeltelijke tekst wordt niet als bewijs voor de kwaliteit beschouwd.
Test 2 — Oplossen van een programmeerfout
Opdracht: Repareren top_paid(records) de drie records met de hoogste waarde retourneren, de invoervolgorde bij gelijke waarden behouden, de handtekening behouden, omgaan met lege invoer, de oorzaak toelichten en twee tests toevoegen.
Gemini 3,7 Flash
11,379 s · 90 invoertokens / 1.431 uitvoertokens · geschat: $0,00543
paid.sort(key=lambda r: r["amount"], reverse=True); return paid[:3]Het stelde vast dat het oplopend sorteren de oorzaak was en testte het filteren, rangschikken, gelijke standen en lege invoer.
Gemini 3,6 Flash
13,984 s · 90 invoer- / 2.273 uitvoertokens · geschat $0,00859
paid.sort(key=lambda r: r["amount"], reverse=True); return paid[:3]Het leverde dezelfde correcte patch op en voldeed aan dezelfde acceptatiecriteria, maar de reactietijd was langer.
Wat uit de resultaten blijkt
Beide maken terecht gebruik van de stabiele sorteerfunctie van Python voor gelijke waarden. De oplossing in versie 3.7 is korter, maar de uiteindelijke code en de dekking zijn gelijk.
Test 3 — Implementatieplan voor de tekstuele frontend
Opdracht: Stel oplossingen op voor een beschreven afrekenpagina met twee kolommen, die te veel witruimte bevat, een zwakke hiërarchie heeft, een te klein ‘Nu betalen’-label, een moeilijk zichtbare vertrouwensverklaring, een kortingswaarschuwing, totalen en stapeling op mobiele apparaten. Er is geen screenshot bijgevoegd.
Gemini 3,7 Flash
15,009 s · 86 invoer- / 1.591 uitvoertokens · gesch. $0,00603
Het voorstel omvatte een raster van 58/42, een CTA van 48–56px, een vertrouwensbadge in de buurt, een oranje waarschuwing, mobiele stapeling, focusstatussen en aanraakdoelen van 44px.
Gemini 3,6 Flash
15,254 s · 86 invoer- / 1.767 uitvoertokens · geschat: $0,00669
Het leverde een consistente 60/40-indeling op, expliciete lettergroottes, een CTA van 48–52px, geordende inhoud in de rechterkolom, breekpunten en toegankelijkheidscontroles.
Wat uit de resultaten blijkt
Beide zijn bruikbaar. In het antwoord van 3.7 staat “click affordability”, waarmee blijkbaar “affordance” wordt bedoeld, en wordt een asymmetrisch raster „symmetrisch“ genoemd. De versie 3.6 hoeft minder te worden aangepast.
Test 4 — Statusafhankelijke extractie
Opdracht: Vat negen feiten over Orion in 120 woorden samen en voeg een tabel toe, waarbij je de statussen ‘bevestigd’, ‘gepland’, ‘in behandeling’, ‘onbekend’ en ‘niet geverifieerd’ behoudt.
Gemini 3,7 Flash
13,681 s · 117 invoer- / 1.064 uitvoertokens · geschat: $0,00408
Het liet de uitkomst voor het beeldintensieve model 18% nog in het ongewisse, maar omschreef het resultaat van de proef met het model 82% als “succesvol” en bestempelde de tweede proef als “Bevestigd / Gepland”.”
Gemini 3,6 Flash
9,270 s · 117 invoer- / 1.454 uitvoertokens · geschat: $0,00554
Het beschreef het proefproject op neutrale wijze als een project waarbij 82% zaken werden afgehandeld, en bestempelde het tweede proefproject als “Goedgekeurd (juridische afhandeling nog in behandeling)”.”
Wat uit de resultaten blijkt
Beide versies bevatten alle relevante feiten. Gemini 3.6 Flash gaf een nauwkeuriger beeld van de statussen ‘goedgekeurd’, ‘in behandeling’ en ‘onbekend’, terwijl 3.7 de eerste pilot enigszins overschatte.
Toets 5 — Redeneren met gegevens
Opdracht: Geef op basis van uitgaven, klikken, betaalde conversies en omzet voor vier kanalen de berekeningen weer, rangschik de meetbare ROAS en conversiepercentages, beschouw uitgaven van nul als niet-meetbaar en adviseer een voorwaardelijke $300-verdeling.
Gemini 3,7 Flash
16,540 s · 137 invoer- / 1.981 uitvoertokens · geschat $0,00753
ROAS: E-mail 7,00×, Zoekresultaten 3,00×, Sociale media 2,60×; Partner niet meetbaar. Conversie: E-mail 12,5%, Zoekresultaten en Partner 10%, Sociale media 5%. Er werden drie voorwaardelijke splitsingen aangeboden.
Gemini 3,6 Flash
18,096 s · 137 invoer- / 2.403 uitvoertokens · geschat: $0,00911
Het leverde dezelfde ranglijsten en behandeling van uitzonderingsgevallen op, en bood vervolgens efficiëntie, diversificatie en toewijzingen op basis van de Partner-test.
Wat uit de resultaten blijkt
Beide berekeningen zijn correct en beide stellen de aanbeveling onder voorwaarde. Beide voegen speculatieve context toe aan het feit dat Partner niets uitgeeft, dus die zin moet worden bevestigd door een bron of worden verwijderd.
Test 6 — Actiegericht plannen en het gebruik van hulpmiddelen
Opdracht: Stel een plan op van minder dan 220 woorden, waarbij je uitsluitend vier bij naam genoemde tools gebruikt. Stop als de pagina niet beschikbaar, niet officieel of dubbelzinnig is, en beweer niet dat de tools zijn uitgevoerd.
Gemini 3,7 Flash
10,787 s · 100 invoer- / 1.174 uitvoertokens · geschat $0,00448
De vier stappen komen één-op-één overeen met de meegeleverde tools, gevolgd door controles op het officiële domein, de beschikbaarheid en de duidelijkheid. Voor voltooiing is precies één gevalideerd CSV-record vereist.
Gemini 3,6 Flash
9,702 s · 100 invoertokens / 1.328 uitvoertokens · geschat $0,00506
Het plan is bruikbaar, maar voegt “of HTML-body parseren” toe, een bewerking die buiten de beschikbare tools valt.
Wat uit de resultaten blijkt
Beide houden zich aan de regel dat de verwerking bij een officiële bron moet worden gestopt en vermijden dat wordt gesimuleerd dat tools zijn uitgevoerd. Het 3.7-plan houdt zich strikter aan de beschikbare functies.
Toets 7 — SEO-schrijven en -redigeren
Opdracht: Lever HTML op met slechts één alinea en één korte lijst, gebruik het exacte trefwoord één keer en behoud vier vaste feiten zonder een resultaat, prijs, releasedatum of bewering over de beschikbaarheid te verzinnen.
Gemini 3,7 Flash
7,263 s · 125 invoertokens / 707 uitvoertokens · geschat: $0,00275
<p>In deze aanstaande review van de Gemini 3.7 Flash nemen we het model van Google onder de loep door officiële benchmarkgegevens te vergelijken met API-tests op basis van dezelfde prompt; de praktijkresultaten worden nog verwacht.</p>Het volgde de HTML-structuur, gebruikte het trefwoord één keer en behield de vergrendelde claims.
Gemini 3,6 Flash
7,542 s · 125 invoer- / 833 uitvoertokens · geschat $0,00322
<p>In deze voorlopige review van de Gemini 3.7 Flash wordt het nieuwe model van Google beoordeeld … hoewel gedetailleerde praktijkresultaten nog op zich laten wachten.</p>De structuur klopt, maar met “nieuw model” wordt een bewering toegevoegd die buiten de vaststaande feiten valt.
Wat uit de resultaten blijkt
Het doorslaggevende verschil zit hem in de veiligheid van de claim: 3.7 weigerde de niet-ondersteunde descriptor toe te voegen, maar leverde wel geldige, compacte HTML op.
Gemini 3.7 Flash-test: scorekaart en conclusies
Uit de vergelijking blijkt dat de Gemini 3.7 Flash beter scoort op het gebied van de kwaliteit van de uiteindelijke output, maar dat dit verschil vooral te danken is aan de nauwkeurige uitvoering van instructies en niet zozeer aan een groot verschil in prestatievermogen. De Gemini 3.6 Flash bleef concurrerend op het gebied van code en rekenkundige bewerkingen, en stelde het betere front-endplan op.
Scorecard voor vergelijkende toetsen
| Maat | Gemini 3,7 Flash | Gemini 3,6 Flash |
|---|---|---|
| Opdrachten gewonnen | 3 | 2 |
| Kwaliteitsstropdassen | 1 | 1 |
| Taken zonder duidelijk resultaat | 1 | 1 |
| Bruikbare voltooide taken | 6 van 7 | 6 van 7 |
| Uitvoertokens voor voltooide taken | 7,948 | 10,058 |
| Best waargenomen output | Afgebakend agentisch plan | Plan voor de tekstuele frontend |
Gemini 3.7 Beperkingen van de flitser
De grootste geconstateerde beperking kwam bij beide modellen voor: beide modellen verbruikten het volledige outputbudget twee keer bij een eenvoudige opdracht voor een onderzoekssamenvatting van 180 woorden. T01 is onbruikbaar in de geteste configuratie.
Gemini 3.7 Flash was niet over de hele linie beter. Het frontend-plan bevatte een formuleringsfout en een discrepantie tussen de interne lay-out en de beschrijving, terwijl beide gegevensantwoorden speculatieve context introduceerden rond een kanaal zonder uitgaven. Het pakket maakte uitsluitend gebruik van tekstuele invoer, waardoor het geen uitspraken doet over de kwaliteit van beeld, audio, video of echte lange context.
Is de Gemini 3.7 Flash de moeite waard?
Ja, Gemini 3.7 Flash is het proberen waard wanneer het belangrijk is dat instructies exact worden uitgevoerd. Het systeem voltooide drie taken en verbruikte minder output-tokens bij de zes bruikbare combinaties. Voor eenvoudige codeaanpassingen, rekenkundige bewerkingen of UI-planning is het verschil minder groot: daar won de Gemini 3.6 Flash de frontend-taak of bleef hij dicht in de buurt.
Je kunt dezelfde opdracht uitvoeren in GlobalGPT en vergelijk het met Gemini 3.6 Flash in dezelfde werkruimte. Gebruik je terugkerende taak als doorslaggevende test.
Gemini 3.7 Flash-recensie: Eindoordeel
Deze recensie van de Gemini 3.7 Flash eindigt met een nipt maar verdedigbaar resultaat: Gemini 3.7 Flash won drie voltooide opdrachten, Gemini 3.6 Flash won er twee en één eindigde in een gelijkspel. Eén onderzoekstaak leverde geen eenduidig resultaat op, omdat beide modellen tweemaal het gemeenschappelijke outputplafond bereikten.
Gemini 3.6 Flash is niet achterhaald. Het leverde het betere tekstuele frontend-ontwerp en de nauwkeurigere statustabel op, terwijl 3.7 sterker was op het gebied van codering, gegevensanalyse en SEO-bewerkingen op basis van vaste feiten. Wat betreft de agentische planningsopdracht was er sprake van een gelijkspel, dus de upgrade is eerder selectief dan absoluut.
Gemini 3.7 Veelgestelde vragen over Flash
Wanneer is Gemini 3.7 Flash uitgebracht?
Google vermeldt de Gemini 3.7 Flash als een stabiel model, waarbij de modeldocumentatie voor het laatst is bijgewerkt op 13 augustus 2026.
Is Gemini 3.7 Flash een stabiele versie of een preview?
In de documentatie van het Gemini API-model van Google wordt het als stabiel aangemerkt. AI Studio, Gemini-consumentenproducten en routes van derden kunnen echter nog steeds afwijkende beschikbaarheid of quota hanteren.
Wat is de model-ID van de Gemini 3.7 Flash API?
Bij de gevraagde vergelijking wordt gebruikgemaakt van `gemini-3.7-flash`, maar de geretourneerde model-ID moet uit het API-antwoord worden genoteerd voordat het artikel definitief als geverifieerd wordt aangemerkt.
Hoeveel kost Gemini 3.7 Flash?
Het tarief voor het betaalde abonnement van Google bedraagt $0,75 per 1 miljoen invoertokens en $3,75 per 1 miljoen uitvoertokens tot en met 31 december 2026; vanaf 1 januari 2027 wordt het vermelde tarief $1,50/$7,50.
Is Gemini 3.7 Flash gratis?
Het feit dat de API beschikbaar is voor consumenten of derden, betekent niet dat er onbeperkte gratis toegang tot de API is. Controleer de route, quota, tarieflimieten en factureringsvoorwaarden voor de toegangsmethode die u van plan bent te gebruiken.
Wat is het Gemini 3.7 Flash-contextvenster?
Het vastgelegde overzicht van de kunstmatige analyse toont een lijst met contexten van 1 miljoen tokens. Controleer de exacte officiële contextlimiet en eventuele prijs- of functionaliteitsbeperkingen voor lange contexten in de documentatie van Google.
Ondersteunt Gemini 3.7 Flash afbeeldingen, audio, video en PDF-bestanden?
Controleer welke invoertypen worden ondersteund voor de exacte API-model-ID. Bij de beoordeling wordt elke ondersteunde modaliteit beschouwd als een gedocumenteerde mogelijkheid, en niet als bewijs dat de kwaliteit voor elk invoertype gelijk is.
Wat zijn de Gemini 3.7 Flash-denkniveaus?
Gemini 3.7 Flash is uitgerust met configureerbare bedieningselementen. De exacte niveaus, standaardinstellingen, het gedrag van tokens en de gevolgen voor de facturering zijn te vinden in de officiële API-documentatie.
Is Gemini 3.7 Flash beter dan Gemini 3.6 Flash?
In deze vergelijkende API-test won de Gemini 3.7 Flash drie voltooide taken, de Gemini 3.6 Flash twee; één taak eindigde in een gelijkspel en bij één taak was de uitslag onduidelijk. Dit wijst op een klein voordeel voor de 3.7, maar niet op een algemene overwinning.
Is de Gemini 3.7 Flash beter dan de Gemini 3.1 Pro?
In dit concept wordt die bewering niet gedaan. Gemini 3.1 Pro is een andere vergelijkingsbasis, en vereist daarom een eigen, bijpassende reeks prompts en bewijsmateriaal, in plaats van een conclusie op basis van de Gemini 3.6 Flash-vergelijking.
Is de Gemini 3.7 Flash geschikt voor programmeren?
Ja, in de hier geteste specifieke taak voor het verhelpen van bugs. Beide modellen produceerden de juiste minimale patch, maar Gemini 3.7 Flash scoorde iets beter dankzij een zuiverdere testdekking met minder voltooiingstokens.
Kan Gemini 3.7 Flash tools gebruiken en agent-workflows uitvoeren?
Raadpleeg de officiële documentatie over de tool en het aanroepen van functies voor de exacte werkwijze. De agentische test in deze beoordeling evalueert de planning en het begrip van grenzen; er wordt niet beweerd dat een plan op zich al het bewijs vormt voor een succesvolle uitvoering van de tool.
Waar kan ik Gemini 3.7 Flash vinden?
Gebruik de officiële toegangspunten van Google indien beschikbaar, of probeer de Modelpagina GlobalGPT wanneer het model voor uw account en regio is ingeschakeld.
Komen officiële benchmarks overeen met de resultaten in de praktijk?
Niet automatisch. Officiële benchmarks en evaluaties door derden bieden nuttige context, terwijl tests met dezelfde prompt laten zien hoe een model omgaat met de specifieke taak die wordt gemeten. In deze beoordeling worden deze soorten bewijs apart behandeld.