
Grok 4.7 is een aanzienlijke verbetering op het gebied van programmeren en kenniswerk, maar het is nog te vroeg om hierover definitieve conclusies te trekken: officiële beweringen bij de lancering en onafhankelijke benchmarks wijzen weliswaar op verbeteringen, maar niet op een alomvattende overwinning.
Kort antwoord
Grok 4.7 is de upgrade van xAI van 21 september 2026, gericht op programmeren en complexe kenniswerk-taken. xAI zegt dat het meer tijd besteedt aan moeilijke problemen, zijn werk zorgvuldiger controleert en een nieuwe reeks veiligheidsmaatregelen toevoegt, terwijl de prijs en snelheid gelijk blijven aan die van Grok 4.6. Op de lanceringspagina wordt het ook gepresenteerd als twee keer zo snel en half zo duur als vergelijkbare modellen, een vergelijking met andere aanbieders die moet worden gezien in het licht van de onderliggende taak en aanpak. Onafhankelijke gegevens van Artificial Analysis geven aan dat het model een kleine algehele verbetering laat zien ten opzichte van Grok 4.6 en een contextvenster van 500K registreert. In onze API-test met drie taken presteerde Grok 4.7 het sterkst op het gebied van foutopsporing en het naleven van broncode-grenzen; het projectplan hield goed rekening met onzekerheden, maar was minder bruikbaar dan gevraagd. Dat is nuttig praktijkbewijs, maar geen bewijs dat het elk concurrerend model verslaat.
Wat is Grok 4.7?
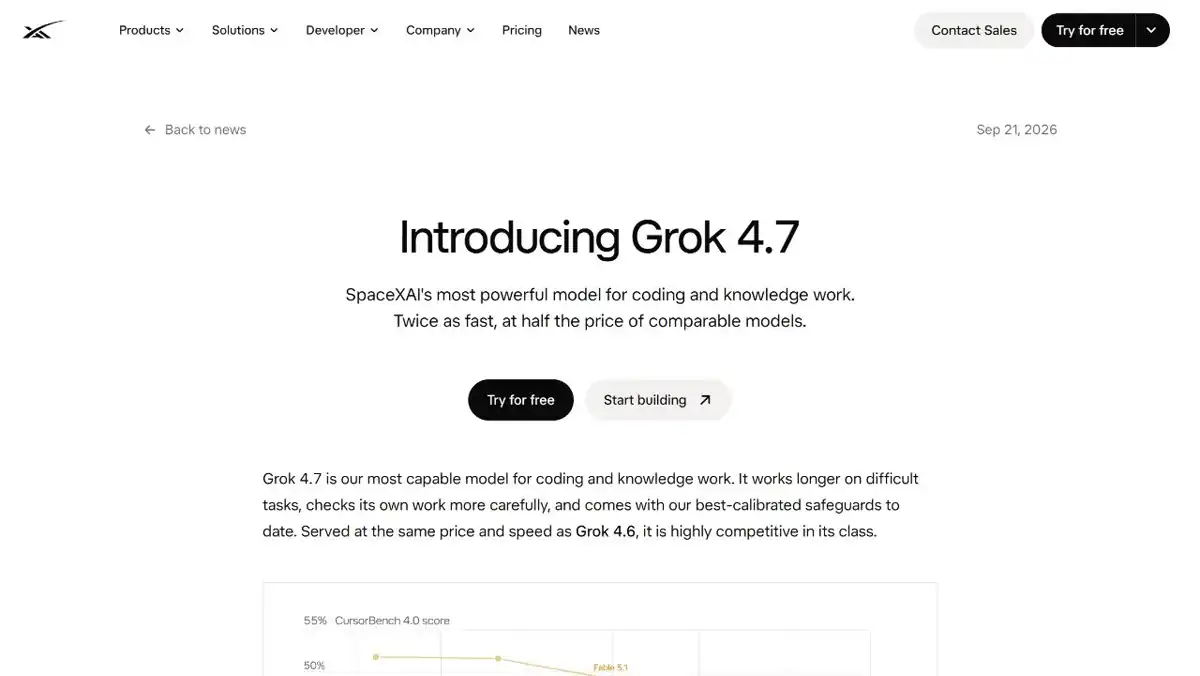
De Grok 4.7 is het nieuwste model uit de Grok-serie van xAI, dat op 21 september 2026 werd aangekondigd. De officiële aankondiging van xAI Hiermee wordt het gepositioneerd als het meest capabele model van het bedrijf voor codering en kenniswerk. De wezenlijke verandering zit niet in een nieuwe lijst met functies voor de consument. Het is een verandering in de manier waarop het model zijn inspanningen zou moeten inzetten: meer tijd besteden aan moeilijke taken, meer zelfcontrole en een veiligheidslaag die bedoeld is om die extra capaciteit beter beheersbaar te maken.
Die positionering is van belang omdat het een workflowmodel beschrijft in plaats van de persoonlijkheid van een chatbot. Grok 4.7 wordt op de markt gebracht als een model voor taken waarbij voortdurende analyse van pas komt: foutopsporing, planning, technisch schrijven, het samenvatten van onderzoeksresultaten en lange prompts waarbij het model rekening moet houden met verschillende beperkingen.
De afbakening is net zo belangrijk. De aankondiging van xAI is een verklaring van de leverancier over het beoogde gedrag. Het is geen onafhankelijk bewijs dat Grok 4.7 beter presteert dan elk concurrerend model, elke prompt of elke coderepository. Beschouw de lanceringspagina als de bron van wat xAI beweert, en gebruik vervolgens onafhankelijke metingen en je eigen taak om te bepalen of die beweringen ertoe doen.
Grok 4.7 versus Grok 4.6: wat is er nu eigenlijk veranderd?
De meest aannemelijke samenvatting is dat het gaat om een verbetering op het gebied van inspanning en betrouwbaarheid, en niet om een totaal ander product.
| Gebied | Grok 4,7 | Wat uit de bewijzen blijkt |
|---|---|---|
| Vrijgave | 21 september 2026 | Datum vermeld op de officiële xAI-lanceringspagina |
| Hoofdpositionering | Programmeren en kenniswerk | Officiële positionering van xAI |
| Moeilijke taken | Meer tijd en zorgvuldiger zelfcontrole | Officiële beschrijving van xAI; onze API-test met drie taken biedt een korte praktische controle, geen gerichte vergelijking |
| Veiligheid | Nieuwe beveiligingsstack | Officiële beschrijving van xAI |
| Prijs en snelheid | Hetzelfde als Grok 4.6, volgens xAI | Een claim bij de marktintroductie, geen prijscontrole door een derde partij |
| Context | 500.000 tokens in het profiel ‘Artificial Analysis’ | Onafhankelijk modelprofiel; controleer de route die je gebruikt |
| Redeneringscontroles | Van ’Low’ tot ‘xhigh’ in de lijst van Artificial Analysis | Onafhankelijke metadata voor routes/modellen |
Dit is een nuttig onderscheid voor kopers. Als Grok 4.6 al in uw workflow past, is 4.7 een soepele upgrade die het overwegen waard is. Als 4.6 niet paste vanwege beperkingen op het gebied van het ecosysteem, latentie, betrouwbaarheid of toegang, lost een hogere benchmarkwaarde op zich die problemen niet op.
Voor een breder kader voor de aankoop van modellen geldt dat de Prijsgids GPT-5.6 en Vergelijking GPT-5.6 zijn nuttige aandachtspunten om de kwaliteit van het model los te zien van de economische aspecten van het plan en de aansluiting op de workflow.
Mogelijkheden: waarbij Grok 4.7 van pas zou moeten komen
Coderen en debuggen
Het sterkste argument bij de lancering van xAI is het programmeren. De belofte is niet alleen dat Grok 4.7 meer code schrijft, maar ook dat het langer bij een lastig technisch probleem kan blijven, zijn eigen antwoord kan beoordelen en een beter doordachte patch of uitleg kan geven. Dat is het gedrag waarnaar je in een echte repository moet zoeken: behoudt het het bestaande ontwerp, identificeert het de hoofdoorzaak, voegt het nuttige tests toe en geeft het aan wat het nog niet kan weten?
Evalueer het model niet aan de hand van een “build a todo app”-opdracht waarbij je helemaal vanaf nul begint. Geef het een afgebakende bug met een mislukte test, een klein aantal bestanden en expliciete beperkingen. Vraag eerst om een diagnose voordat je een patch aanlevert. Zo kun je beter zien of de langere redenering daadwerkelijk minder revisiewerk oplevert, of dat het alleen maar meer tekst oplevert.
Dezelfde regel geldt voor teams die verschillende programmeerbenaderingen met elkaar vergelijken. A Recensie van de DeepSeek V4 Pro en de Beoordeling van het GLM-coderingsplan bieden een nuttige vergelijkingsbasis, maar geen van beide mag worden beschouwd als vervanging voor het testen van de repository en de toolchain die u daadwerkelijk gebruikt.
Kenniswerk met een brede context
Artificial Analysis vermeldt voor Grok 4.7 een contextvenster van 500.000 tokens. Dat is groot genoeg om je aanpak van bronmateriaalrijke taken te veranderen: een lange technische specificatie, een reeks notulen, een deel van een codebase of een onderzoekspakket kan in één gesprek blijven, in plaats van herhaaldelijk te worden samengevat.
Contextcapaciteit is niet hetzelfde als contextkwaliteit. Een model kan een grote hoeveelheid input verwerken en toch een beperking in het midden over het hoofd zien, te veel gewicht toekennen aan de laatste alinea, of een overtuigende samenvatting produceren die nog aan bronverificatie moet worden onderworpen. De praktische test is het terugvinden van informatie onder druk: plaats een paar doorslaggevende feiten op verschillende plaatsen in een lang document, vraag om een beslissing binnen bepaalde grenzen, en controleer of het antwoord de juiste passages aanhaalt.
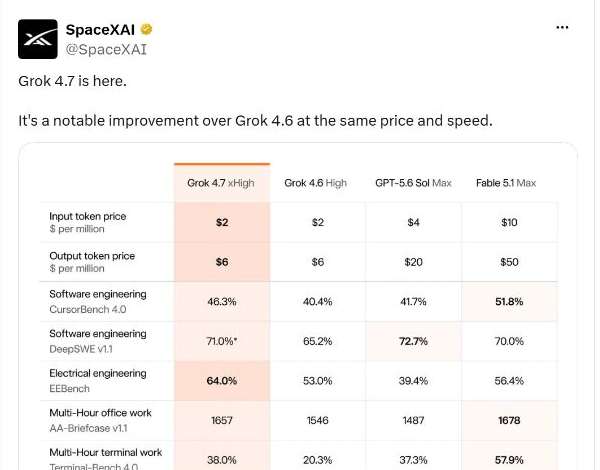
Het officiële X-account van SpaceXAI herhaalde op 22 september deze beschrijving van de lancering, waarbij Grok 4.7 werd aangemerkt als een opmerkelijke verbetering ten opzichte van Grok 4.6 bij dezelfde prijs en snelheid, en de grafiek met de modelvergelijking werd gedeeld. Dat bericht is een nuttig bewijs van de publieke positionering van het bedrijf, maar geen onafhankelijke bevestiging of consensus binnen de gemeenschap.
Als het model voor onderzoek wordt gebruikt, zorg er dan voor dat de bewijscyclus zichtbaar blijft. Onze Vergelijking tussen Gemini en Perplexity en Gids voor alternatieven voor Perplexity brengen hetzelfde praktische punt naar voren: een goed geformuleerd antwoord is geen broncontrole.
Zelfcontrole en veiligheid
xAI stelt dat Grok 4.7 zijn werk zorgvuldiger controleert en een nieuwe reeks veiligheidsmaatregelen introduceert. Dat zijn waardevolle doelstellingen, vooral wanneer het model een lange reeks beslissingen moet nemen. Ze bieden echter geen garantie dat de output correct of veilig is voor automatische uitvoering.
Zorg er bij productiegebruik voor dat er standaardcontroles rondom het model worden gehandhaafd: tests, machtigingen, menselijke beoordeling, citatiecontroles en een duidelijke stopvoorwaarde. De zelfcontrole van het model is een extra signaal om te controleren, maar geen vervanging voor de controles eromheen.
Grok 4.7-benchmarks: wat de cijfers aantonen
Een sterk resultaat, waarbij Grok 4.7 volgens de officiële ranglijst boven Grok 4.6 staat.
Uit de vergelijking met het grotere model blijkt een aanzienlijke verbetering bij deze benchmark voor kenniswerk.
Een nuttig signaal voor werkprocessen waarbij gereedschap wordt gebruikt, maar het blijft een enkele beoordeling en geen algemene score.
De onafhankelijke index wijst in dezelfde richting: verbetering, maar geen bewijs van een algemene overwinning.
Beschouw deze kaarten als indicatief bewijs. De samenstelling van de dataset, de beschikbare tools, de steekproef en de modelinstellingen kunnen de rangschikking beïnvloeden.
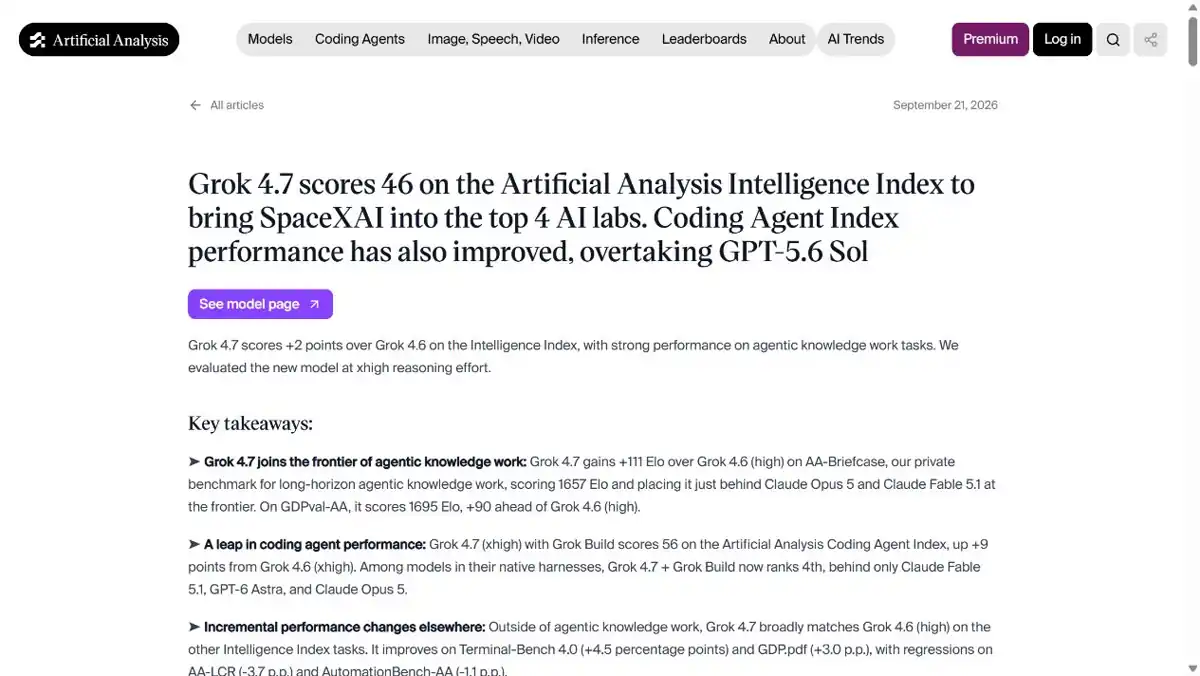
De meest bruikbare onafhankelijke momentopname komt momenteel van Het benchmarkartikel van ’Artificial Analysis’ over de Grok 4.7, gedateerd 21 september 2026.
| Maat | Gerapporteerd resultaat | Hoe moet je dit lezen? |
|---|---|---|
| Index voor kunstmatige analyse-intelligentie | 46 | Twee punten hoger dan Grok 4,6 in dezelfde index |
| AA-Aktetas | 1.657 Elo | 111 Elo boven Grok 4,6 in die beoordeling |
| Contextvenster | 500.000 tokens | Een veld met modelprofielen, geen bewijs van een perfecte terugvinding in een lange context |
| Redenering | Laag tot xhoog | Een controle op routeniveau, vermeld door Artificial Analysis |
De ontwikkeling is bemoedigend: de onafhankelijke index laat een verbetering zien ten opzichte van de vorige versie, en het grotere Elo-verschil in AA-Briefcase duidt op een duidelijkere vooruitgang bij die specifieke evaluatie. Maar de tabel geeft nog steeds een overzicht van twee datasets, en geen algemene ranglijst. De samenstelling van de benchmarks, de toegang tot tools, de steekproef en de modelinstellingen kunnen het resultaat beïnvloeden.
Op de officiële xAI-lanceringspagina staat Grok 4.7 vermeld bij 46,31 TP40T op CursorBench 4.0 in de vergelijkingstabel, naast Grok 4,6 bij 40,4%, GPT-5.6 Sol bij 41,7% en Fable 5.1 bij 51,8%. De pagina toont ook 71,0% op DeepSWE v1.1 bij hoge inspanning, 64,0% op EEBench en 1.657 op AA-Briefcase v1.1. Dit zijn door de leverancier gepresenteerde vergelijkingscijfers; beschouw ze daarom als officieel gerapporteerde resultaten en niet als vervanging voor onafhankelijke replicatie. De veiligere conclusie is dat xAI zich richt op serieus programmeerwerk en professioneel kenniswerk, terwijl onafhankelijke metingen een betekenisvolle verbetering bij sommige taken laten zien en minder indrukwekkende resultaten bij andere.
Praktijktest Grok 4.7: drie praktische opdrachten
We hebben drie vaste prompts getest op de grok-4.7 model-ID via een OpenAI-compatibele test-API op 23 september 2026. Dit was een evaluatie met één route, niet via de directe xAI-API en geen vergelijkende test met concurrenten. Het zichtbare antwoord van elke run is hieronder weergegeven; besloten redeneringstrajecten zijn weggelaten.
| Taak | Waargenomen tijd | Resultaat |
|---|---|---|
| TypeScript-bug met betrekking tot gelijktijdigheid | 333,7 seconden, gestreamd | Goed resultaat: juiste diagnose van ‘shared-promise’, minimale patch, twee nuttige tests en een zorgvuldige beperking van wat het fragment zou kunnen bewijzen |
| Tegenstrijdige onderzoeksnotities | 68,7 seconden | Sterke beoordeling: bronvermelding behouden, beide toelatingsscenario’s berekend en goedkeuring geweigerd totdat het conflict met de bron was geverifieerd |
| Een rommelig plan voor één week | 50,6 seconden | Gedeeltelijk geslaagd: deadlines, tegenstrijdigheden, onbekende eigenaren en vijf risico’s zijn behouden, maar het werk is niet omgezet in een duidelijk dag-tot-dag-schema |
De latentiegegevens hebben uitsluitend betrekking op deze route en deze prompts. De coderingstaak liep eerst vast vanwege een time-out bij een niet-streaming gateway, maar werd vervolgens voltooid met streaming ingeschakeld. Dit is een praktische waarschuwing voor de implementatie met betrekking tot transport en de afhandeling van time-outs, en geen algemene Grok 4,7-snelheidsscore.
Test 1: Foutopsporing bij gelijktijdigheid in TypeScript
Opdracht 1 — Foutopsporing bij gelijktijdige verwerking van TypeScript API-handlers

Een kleine TypeScript-handler retourneert af en toe een HTTP 200-status met een lege body wanneer twee verzoeken kort na elkaar binnenkomen.

Meegeleverde bestanden:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

Het symptoom in de productieomgeving treedt alleen sporadisch op wanneer twee verzoeken elkaar overlappen. De loader zelf kan veilig gelijktijdig worden aangeroepen en retourneert voor elk verzoek een andere payload. Er zijn geen andere bestanden beschikbaar.

Geef precies deze onderdelen weer:
1. Onderliggende oorzaak
2. Kleinste veilige patch (toon een unified diff)
3. Twee regressietests (code in TypeScript- of Jest-stijl)
4. Aannames en beperkingen
Beweer niet dat je de code hebt uitgevoerd.1. Onderliggende oorzaak
`current` is een status op moduleniveau die door elke aanroep wordt gedeeld. Binnen één JavaScript-cyclus zijn de null-controle en de toewijzing atomair, waardoor twee overlappende aanroepen niet beide `load()` uitvoeren. De eerste aanroep slaat zijn promise op; een tweede aanroep die binnenkomt voordat die promise is afgehandeld, slaat zijn eigen `load()` over en wacht op dezelfde promise. `handler` retourneert vervolgens een HTTP 200-status waarvan de `body` de string van de eerste aanroep is, en niet de payload van het tweede verzoek. Dat venster bestaat alleen zolang een aanroep in behandeling is, dus de fout treedt alleen op wanneer verzoeken elkaar overlappen.
`current = null` wordt in elke voortzetting uitgevoerd nadat `await` de belofte al heeft vastgelegd. Het zorgt er niet voor dat de andere wachtende de variabele opnieuw leest, dus deze bestanden alleen zetten die wachtende niet om naar `null` of `""`. Wat ze bij overlapping wel opleveren, is een gedeelde resolutie en een overgeslagen lading per verzoek. De `clear` maakt de slot ook tot een slechte cache voor één verzoek: de eerste voortzetting die wordt hervat, verwijdert `current`, en een latere aanroeper kan een andere `load()` starten terwijl een andere aanroeper nog bezig is met afwikkelen.
2. Kleinste veilige patch (toon een samengevoegde diff)
Elk verzoek moet zelf `load()` aanroepen. Gelijktijdige `load()`-aanroepen zijn toegestaan, en elke aanroep retourneert een andere payload, dus het verwijderen van duplicaten op basis van één gedeelde promise is onveilig. `handler.ts` hoeft niet te worden gewijzigd.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. Twee regressietests (TypeScript- of Jest-stijlcode)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('overlappende verzoeken bij elke uitvoering laden en behouden hun eigen body', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('een afgewezen overlappende payload verandert de andere respons niet', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('upstream failed'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('upstream failed');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. Aannames en beperkingen
Ik heb deze code noch de tests uitgevoerd. De tests gaan uit van een runner in Jest-stijl en een bestand in een submap van `src/` (bijvoorbeeld `test/cache.test.ts`).
Ik heb “verschillende payload voor elk verzoek” opgevat als een vereiste dat overlappende `getPayload`-aanroepen niet één `load()`-resultaat mogen delen. Een correcte herschrijving voor een enkele run (`load().finally(() => { current = null; }); return current`) zou die verzoeken nog steeds aan elkaar koppelen, dus heb ik deze niet gebruikt. Er is geen cache-sleutel aanwezig en er is geen vereiste voor het verwijderen van duplicaten gesteld.
Een letterlijk lege HTTP-body wordt niet geschreven door de getoonde instructies als `load` een niet-lege tekenreeks retourneert. Als dat symptoom afkomstig is van een adapter buiten deze bestanden, is het hier niet zichtbaar. De patch verwijdert alleen de overlapping die deze bestanden daadwerkelijk implementeren. Het voegt geen vergrendeling, herhalingspogingen of een cache met sleutels toe.Grok 4.7 heeft terecht vastgesteld dat op moduleniveau huidige Door de ‘promise’ delen overlappende verzoeken één loader-resultaat, ook al heeft elk verzoek zijn eigen payload nodig. Er werd de kleinste veilige wijziging voorgesteld: de gedeelde ‘promise’ verwijderen en load() op verzoek. De twee regressietests hadden betrekking op verschillende gelijktijdige payloads en op isolatie wanneer één loader een verzoek afwijst. Het sterkste punt van het antwoord was de terughoudendheid ervan: er werd expliciet vermeld dat de getoonde code koppeling tussen verzoeken aantoont, maar op zichzelf geen verklaring biedt voor een letterlijk lege body als de loader altijd een niet-lege tekenreeks retourneert.
Verdict: Uitstekend resultaat voor de nauwkeurigheid van de oorzaksanalyse, de reikwijdte van de patch, de regressietestdekking en de omgang met onzekerheden.
Test 2: Onderzoeksnota over tegenstrijdige bronnen
Opdracht 2 — Breng tegenstrijdige onderzoeksnotities met elkaar in overeenstemming in een besluitnota.

Gebruik uitsluitend deze zes notities en vermeld de naam van de bron naast elke feitelijke uitspraak:

- Leverancier A, prijspagina, 20-09-2026: Het Team-abonnement kost $40 per licentie per maand en omvat 100.000 inbegrepen acties.
- Leverancier B, vergelijkingsbericht, 21-09-2026: Het Team-abonnement van leverancier A omvat 120.000 acties per licentie per maand.
- Klantinterview, 18-09-2026: Ons team heeft 8 licenties en heeft vorige maand 710.000 acties gebruikt.
- Financiële spreadsheet, 19-09-2026: Het huidige budgetplafond is $360 per maand.
- Leverancier A, pagina met limieten, 20-09-2026: Overschrijdingen worden gefactureerd tegen $0,004 per actie na de inbegrepen toeslag.
- Inkoopnotitie, 22-09-2026: Een overstap is alleen toegestaan als het maandelijkse totaal binnen het budget blijft en de inbegrepen hoeveelheid is geverifieerd.

Geef precies deze onderdelen weer:
1. Geverifieerde feiten
2. Toegeschreven beweringen
3. Conflicttabel
4. Onafhankelijke berekeningen (bereken zowel het scenario 8 x 100.000 als het scenario 8 x 120.000, plus eventuele overschrijdingen)
5. Aanbeveling
6. Eén verduidelijkende vraag, uitsluitend indien het conflict de aanbeveling beïnvloedt
Los het conflict tussen 100.000 en 120.000 niet stilzwijgend op.
1. Geverifieerde feiten
- Het Team-abonnement kost $40 per licentie per maand (Leverancier A, prijspagina, 20-09-2026).
- Het team heeft 8 licenties en heeft vorige maand 710.000 acties uitgevoerd (klantinterview, 18-09-2026).
- Het huidige budgetplafond bedraagt $360 per maand (financiële spreadsheet, 19-09-2026).
- Overschrijdingen worden in rekening gebracht tegen $0,004 per actie na aftrek van de inbegrepen toelage (Leverancier A, pagina met limieten, 20-09-2026).
- Een overstap is alleen toegestaan als het maandelijkse totaal binnen het budget blijft en het inbegrepen aantal is geverifieerd (Inkoopnotitie, 22-09-2026).

2. Toegeschreven claims
- Het team omvat 100.000 inbegrepen acties (Leverancier A, prijspagina, 20-09-2026). In die opmerking staat niet expliciet “per werkplek”.
- Het team van leverancier A omvat maandelijks 120.000 acties per licentie (leverancier B, vergelijkingsbericht, 21-09-2026).

3. Conflicttabel
| Item | Bewering | Bron | Status |
| --- | --- | --- | --- |
| Inbegrepen acties | 100.000 inbegrepen acties; “per licentie” wordt niet vermeld | Leverancier A, prijspagina, 20-09-2026 | Onopgelost |
| Inbegrepen acties | 120.000 acties per licentie per maand | Leverancier B, vergelijkingsbericht, 21-09-2026 | Onopgelost |

Het conflict tussen 100.000 en 120.000 is niet opgelost. Uit deze opmerkingen blijkt niet welk cijfer juist is.

4. Onafhankelijke berekeningen
Basiskosten per licentie, gelijk in beide scenario’s: 8 licenties (klantinterview, 18-09-2026) × $40 per licentie per maand (Leverancier A, prijspagina, 20-09-2026) = $320 per maand.

Beide onderstaande vermenigvuldigingsfactoren zijn berekend zoals gevraagd. Ze vormen geen bewijs dat Leverancier A een vergoeding per stoel heeft vermeld.

- 8 × 100.000 = 800.000 inbegrepen acties, uitgaande van het cijfer 100.000 (Leverancier A, prijspagina, 20-09-2026).
- Het gebruik van 710.000 (klantgesprek, 18-09-2026) ligt 90.000 onder de 800.000, dus het aantal acties boven de limiet = 0.
- Kosten voor overschrijding = 0 × $0,004 = $0 (Leverancier A, pagina met limieten, 20-09-2026).
- Maandelijks totaal = $320 + $0 = $320, wat binnen het maximum van $360 valt (financiële spreadsheet, 19-09-2026).

- 8 × 120.000 = 960.000 inbegrepen acties, uitgaande van het cijfer 120.000 (Leverancier B, vergelijkingsbericht, 21-09-2026).
- Het verbruik van 710.000 (klantgesprek, 18-09-2026) ligt 250.000 onder 960.000, dus het aantal acties boven de limiet = 0.
- Kosten voor overschrijding = 0 × $0,004 = $0 (Leverancier A, pagina met limieten, 20-09-2026).
- Maandelijks totaal = $320 + $0 = $320, wat binnen het maximum van $360 valt (financiële spreadsheet, 19-09-2026).

5. Aanbeveling
Keur de overstap nog niet goed. Bij beide berekende limieten leiden de 710.000 acties van vorige maand (klantgesprek, 18-09-2026) geen overschrijding opleveren en resulteren in een maandelijks totaal van $320, wat binnen het maximum van $360 valt (financiële spreadsheet, 19-09-2026). Dat kostenresultaat is niet afhankelijk van de keuze tussen 100.000 of 120.000. De overstap voldoet nog steeds niet aan de tweede voorwaarde: de toewijzing moet worden geverifieerd (Inkoopnotitie, 22-09-2026), en deze notities vermelden 100.000 (Leverancier A, prijspagina, 20-09-2026) in conflict met 120.000 (Leverancier B, vergelijkingsbericht, 21-09-2026).

6. Slechts één verduidelijkende vraag als het conflict de aanbeveling wijzigt
Geen verduidelijkende vraag. Het conflict tussen 100.000 en 120.000 verandert de aanbeveling niet.
In het onderzoekspakket werd opzettelijk tegenstrijdige informatie gegeven over de vraag of de toelage 100.000 of 120.000 acties per zitplaats bedroeg. Grok 4.7 hield de twee bronnen gescheiden, merkte op dat de eerste bron niet expliciet “per zitplaats” vermeldde, berekende beide scenario’s met acht zitplaatsen en toonde aan dat beide uitkwamen op $320 zonder overschrijding voor het opgegeven gebruik. Toch werd aanbevolen de goedkeuring in de wacht te zetten, omdat de inkoopafdeling eiste dat het toegestane aantal werd geverifieerd. Dat is het juiste onderscheid tussen een aanbeveling die numeriek stabiel is en een onopgelost contractueel feit.
Verdict: Goede beoordeling voor bronvermelding, rekenvaardigheid, omgaan met conflicten en besluitvormingsdiscipline.
Test 3: Rommelige aantekeningen bij het uitvoeringsplan
Opdracht 3 — Zet deze rommelige projectnotities om in een uitvoeringsplan voor één week van maximaal 700 woorden.

Opmerkingen:
- Lancering landingspagina vrijdag 17:00; de producteigenaar vermeldt in een latere notitie dat dit donderdagochtend is.
- Mina: schrijf de koptekst en de prijstabel. Mina geeft ook aan dat ze de tekst pas woensdagmiddag kan nakijken.
- Arjun: analytische gebeurtenissen; in een dubbele notitie staat dat de verantwoordelijke voor de analyse nog moet worden bepaald.
- Ontwerp heeft twee dubbele taken: “mobile hero crop” en “mobile hero crop final”.
- Juridische beoordeling moet plaatsvinden vóór elke openbare lancering.
- QA heeft één volledige dag nodig nadat de analytics-events beschikbaar zijn.
- Omar is dinsdagmiddag afwezig.
- De lanceringsmail staat gepland voor vrijdag 16:00 uur.
- Onbekend: wie neemt de uiteindelijke go/no-go-beslissing?

Vereisten: groepeer dubbel werk, markeer onbekende verantwoordelijken als „nog te bepalen“, behoud beide strikte deadlines, signaleer tegenstrijdigheden in plaats van ze stilzwijgend op te lossen, en sluit af met een lijst van vijf risico’s.

Lever precies deze onderdelen in:
1. Plan voor één week
2. Tegenstrijdigheden en onbekende factoren
3. Vijf risico’s
Verzin geen verantwoordelijken of data.
1. Weekplan

Er staan geen kalenderdata in de notities, dus worden er ook geen toegevoegd. Er wordt alleen gebruikgemaakt van de vermelde mijlpalen en afhankelijkheden. Dubbel ontwerpwerk vormt één taak. Onbekende verantwoordelijken blijven “nader te bepalen”. Tegenstrijdige lanceringstijdstippen worden beide behouden.

- Tekst: Mina schrijft de kop en de prijstabel. Haar tekstbeoordeling vindt pas woensdagmiddag plaats.
- Ontwerp: één taak, het bijsnijden van de hero-afbeelding voor mobiel, inclusief de “laatste” controle. Er is geen aparte verantwoordelijke aangewezen.
- Analytics-gebeurtenissen: moeten aanwezig zijn vóór de kwaliteitscontrole. Verantwoordelijke is nog niet vastgesteld (Arjun in de ene notitie; nader te bepalen in een andere).
- QA: één volledige dag, pas nadat de analytics-events beschikbaar zijn. Verantwoordelijke nog te bepalen. Er is hier geen QA-dag toegewezen.
- Juridische beoordeling: vereist vóór elke publieke lancering. Verantwoordelijke nog te bepalen. Niet ingepland in de notities.
- Go/no-go: verantwoordelijke nog te bepalen. Wordt niet als beslist beschouwd.
- Kijkmomenten voor de publieke lancering, beide gehandhaafd: donderdagochtend (producteigenaar) en vrijdag 17:00 uur (landingspagina).
- Lanceringse-mail: vrijdag 16:00 uur. Verantwoordelijke nader te bepalen.
- Omar is dinsdagmiddag afwezig. Geen enkele taak in deze notities is aan Omar toegewezen, dus wordt er niets verplaatst.

Volgorde, zonder nieuwe data: Mina’s concept moet klaar zijn voor beoordeling op woensdagmiddag; het ontwerp voltooit de ‘single hero crop’; analyse-events worden geleverd door de nog niet vastgestelde verantwoordelijke; QA krijgt vervolgens één volledige dag; juridische beoordeling is afgerond vóór elke publieke lancering; go/no-go (nog te bepalen) heeft nog geen verantwoordelijke. Laat donderdagochtend, vrijdag 17:00 of vrijdag 16:00 niet vallen.

2. Tegenstrijdigheden en onbekenden

Tegenstrijdigheden (niet opgelost):
- De lancering van de landingspagina is vrijdag 17:00, en in een latere notitie van de producteigenaar staat donderdagochtend.
- De verantwoordelijke voor analytics is in de ene notitie Arjun en in een dubbele notitie ‘nog te bepalen’.

Onbekende zaken, gemarkeerd als ‘nog te bepalen’:
- Definitieve verantwoordelijke voor de go/no-go-beslissing.
- Definitieve verantwoordelijke voor analytics.
- Verantwoordelijke voor de juridische beoordeling.
- Verantwoordelijke voor QA.
- Verantwoordelijke voor de lanceringsmail.
- Naam van de verantwoordelijke voor het ontwerp, naast ‘Design’.
- De rol van Omar; er wordt alleen vermeld dat hij dinsdagmiddag afwezig is.
- Welk tijdstip voor de lancering is bindend, en of de e-mail van vrijdag 16:00 overeenkomt met een van beide tijdstippen. Er worden geen data buiten die weekdagstijdstippen vermeld.

3. Vijf risico’s

1. Donderdagochtend en vrijdag 17:00 kunnen niet beide het tijdstip zijn voor de lancering van de landingspagina; het gebruik van een van beide zonder definitieve beslissing kan leiden tot een te vroege lancering of het missen van de andere deadline.
2. De lanceringsmail staat vast op vrijdag 16:00 uur, vóór vrijdag 17:00 uur, en is in de notities niet afgestemd op donderdagochtend; daardoor kan deze worden verzonden terwijl de pagina nog niet of niet meer in de beoogde staat is.
3. Er is onenigheid over wie verantwoordelijk is voor de analytics, waardoor gebeurtenissen kunnen verschuiven; QA heeft nog steeds een volledige dag nodig na de gebeurtenissen en past mogelijk niet voor een van beide lanceringsmomenten.
4. Een juridische beoordeling moet voorafgaan aan elke openbare lancering, maar er is geen verantwoordelijke of tijdslot voor, waardoor de lancering kan worden geblokkeerd of plaatsvinden zonder beoordeling.
5. Er is geen ‘no-go’-verantwoordelijke aangewezen, dus voor geen van beide harde deadlines is er een aangewezen persoon die de lancering kan goedkeuren of tegenhouden.
Grok 4.7 heeft de dubbele ‘mobile-hero’-taak samengevoegd, het conflict tussen de lancering op donderdagochtend en vrijdag om 17.00 uur behouden, de e-maildeadline van vrijdag om 16.00 uur gehandhaafd, onopgeloste verantwoordelijken gemarkeerd als ‘TBD’ en eindigde met precies vijf risico’s. Er werden geen kalenderdata of verantwoordelijken verzonnen. De zwakte lag in de uitvoerbaarheid: in plaats van het werk toe te wijzen over een reeks van maandag tot en met vrijdag, leverde het een geordende lijst met afhankelijkheden op en gaf het aan dat er geen QA-dag kon worden toegewezen. Die voorzichtigheid is verdedigbaar, maar de vraag vroeg om een uitvoeringsplan voor één week, dus het antwoord voldeed slechts gedeeltelijk aan het gevraagde formaat.
Verdict: Gedeeltelijk geslaagd: uitstekend behoud van de beperkingen, minder bruikbaar voor planning.
Welke veranderingen brengt Grok 4.7 teweeg in de praktijk?
De meest zinvolle manier om de lancering te interpreteren is als een vraag over de werkstroom: waar zorgt een doordachte redenering ervoor dat er minder controlewerk nodig is, en waar leidt het simpelweg tot een langer antwoord? De drie API-taken suggereren een praktisch patroon. Grok 4.7 kan gemakkelijk meerdere beperkingen tegelijk in het oog houden, vooral wanneer de opdracht vraagt om feiten van aannames te scheiden. Het is minder overtuigend wanneer de taak een concrete tijdlijn of uitvoeringsvolgorde vereist die in de bronnotities niet volledig is gespecificeerd.
Coderen en debuggen
Voor repository-werk is het model beter geschikt voor een afgebakende diagnose dan voor een open verzoek om “een app te bouwen”. Geef het de kleinst mogelijke bruikbare set bestanden, beschrijf het storingssymptoom en eis een oorzaakanalyse voordat er een patch wordt geleverd. Vraag om tests die vóór de wijziging zouden mislukken en erna zouden slagen. In onze handler-test bleef het antwoord dicht bij de aangeleverde code en weigerde het een externe oorzaak te verzinnen voor het 'empty-body'-symptoom.
Dat gedrag is van belang omdat de kwaliteit van het coderen niet alleen draait om het genereren van code. Een nuttige coderingsoplossing moet het lokale ontwerp behouden, de diff beperken, aannames identificeren en verificatie goedkoop maken. Grok 4.7 deed al deze dingen in één kleine taak, maar één enkele taak kan geen betrouwbaarheid op repository-schaal waarborgen. Teams moeten dezelfde beoordelingscriteria toepassen op een echte bug, een refactor, een wijziging in meerdere bestanden en een beveiligingsgevoelig traject, voordat ze productiewerk doorzetten.
Onderzoek en synthese van bronnen
Het onderzoek bracht een ander sterk punt aan het licht: discipline bij het afbakenen van bronnen. Grok 4.7 voegde de bewering van de leverancier over 100.000 acties niet zomaar samen met het cijfer van 120.000 uit het vergelijkende bericht. Het maakte ook onderscheid tussen een berekening die in beide scenario’s stabiel is en een inkoopvoorwaarde die nog verificatie vereist.
Dit is het juiste patroon voor onderzoekintensief werk. Vraag het model om geverifieerde feiten, toegeschreven beweringen, onopgeloste tegenstrijdigheden, berekeningen en aanbevelingen afzonderlijk te markeren. Een goed opgestelde memo kan nog steeds onjuist zijn als er een secundaire bewering wordt vermomd als een niet-geciteerd feit. Het antwoord van Grok 4.7 was nuttig omdat het conflict zichtbaar bleef, ook al veranderde het rekenresultaat niet.
Planning en bedrijfsvoering
Tijdens de planning werden de beperkingen duidelijker. Het model hield rekening met alle deadlines en onbekende eigenaren, maar ging niet zo ver dat het een schema van maandag tot en met vrijdag opstelde. Dat is veiliger dan zelf data te verzinnen, maar het betekent wel dat de gebruiker de afhankelijkheden nog steeds zelf moet omzetten in agenda-afspraken.
Vermeld bij operationele aanwijzingen de planningshorizon, het aantal beschikbare werkdagen, de beschikbaarheid van de eigenaar en de beslisser. Als deze velden ontbreken, vraag dan eerst om een afhankelijkheidsschema en daarna om een kalender. Dankzij deze workflow in twee stappen wordt de waarschuwing van het model nuttig, in plaats van dat deze wordt gezien als een gebrek aan daadkracht.
Zoeken op basis van een lange context
Een contextvenster van 500K bepaalt weliswaar wat er in één verzoek past, maar niet wat zonder controle als betrouwbaar kan worden beschouwd. Bij werkzaamheden met een lange context moet gebruik worden gemaakt van controlevragen: plaats doorslaggevende feiten aan het begin, in het midden en aan het einde van een pakket; voeg één opzettelijk conflict toe; vraag vervolgens om een beslissing met vermelding van de bronlocaties. Meet zowel de recall als de grensdiscipline.
Beoordeel een route met een lange context niet op basis van het feit of deze een groot verzoek accepteert. Leg vast waar het model feiten mist, of het te veel gewicht toekent aan het laatste deel, in hoeverre de latentie toeneemt naarmate de invoergrootte toeneemt, en of de provider het verzoek afkapt of transformeert. Een groot geadverteerd venster is een capaciteitsbelofte, geen garantie voor stabiele redenering bij het uiterste.
Hoe je Grok 4.7 zelf kunt beoordelen
Gebruik een kleine, herhaalbare testset voordat je een standaardinstelling in de productieomgeving wijzigt. Het doel is niet om een ranglijst opnieuw samen te stellen, maar om het model te vergelijken met het beoordelings- en evaluatieproces waarvoor je al betaalt.
- Bevries de invoergegevens. Sla de exacte prompt, bestanden, bronpakket, model-ID, temperatuur, redeneringsinstelling en toolrechten op. Vergelijk geen directe route met een providerroute terwijl je tegelijkertijd de prompt wijzigt.
- Beoordeel het werk, niet de schrijfstijl. Beoordeel bij het coderen de nauwkeurigheid van de hoofdoorzaak, de reikwijdte van de patch, de tests en de aannames. Beoordeel bij onderzoek de grenzen van de bronvermeldingen, de rekenkundige juistheid, conflicten en de kwaliteit van de aanbevelingen. Beoordeel bij de planning de naleving van deadlines, de verantwoordelijkheid, de afhankelijkheden en de uitvoerbaarheid.
- Registreer het transport apart. Houd de tijd tot het eerste token, de totale tijd, de stream-/niet-streammodus, de HTTP-status en het herpogingsgedrag bij in een routelogboek. Een time-out van de gateway betekent niet automatisch een fout op modelniveau, maar brengt wel productiekosten met zich mee.
- Controleer het gedrag bij een storing. Neem één dubbelzinnige invoer, één tegenstrijdige bron en één opzettelijk onvolledige set bestanden op. De relevante vraag is of het model onzekerheid aangeeft of de leemte opvult met een zelfverzekerde schatting.
- Bekijk de kosten en de inspanning samen. Houd het aantal invoertokens, uitvoertokens, in de cache opgeslagen invoer, redeneringstokens (wanneer deze zichtbaar zijn) en de duur van menselijke beoordelingen bij. Een goedkopere reactie die twee keer zo lang duurt om te verifiëren, is in de praktijk misschien niet goedkoper.
- Herhaal dit voordat je overschakelt. Voer elke taak minstens twee keer uit of pas deze toe op verschillende representatieve voorbeelden voordat je een teamstandaard wijzigt. Bewaar het onbewerkte, zichtbare antwoord en de beoordelingsnotities, zodat een andere beoordelaar de beslissing kan reproduceren.
De drie runs in deze evaluatie vormen een eerste steekproef en zijn geen vervanging voor de evaluatieset van een team. Ze laten zien hoe Grok 4.7 presteert bij één codeertaak, één memo over bronconflicten en één planningspakket; ze vormen geen algemene ranglijst.
Grok 4.7: prijzen en API-toegang
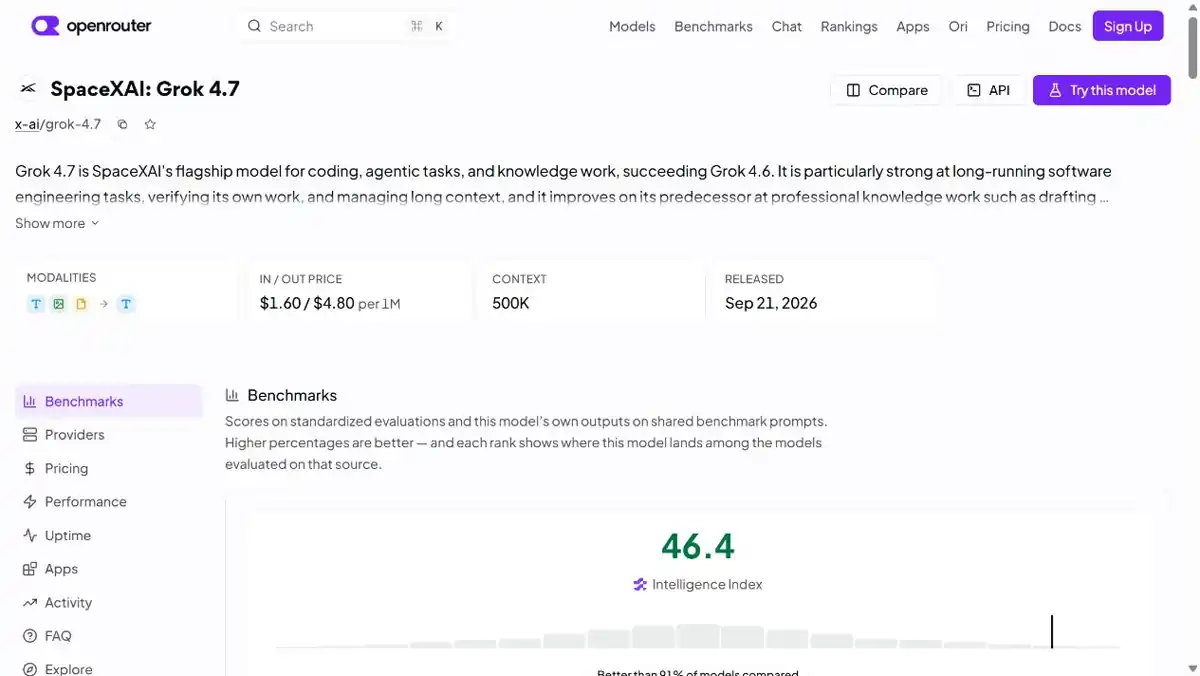
Juist op het gebied van prijsstelling kunnen modelbeoordelingen vaak misleidend zijn. Er zijn minstens drie verschillende bedragen die een lezer kan tegenkomen: de directe API-prijs van xAI, de routeprijs van een aggregator en de abonnementsprijs voor consumenten. Deze zijn niet onderling uitwisselbaar.
Volgens de aankondiging van xAI wordt de Grok 4.7 tegen dezelfde prijs en met dezelfde snelheid aangeboden als de Grok 4.6. Op de lanceringspagina staat dat het standaardmodel begint bij $2 per 1 miljoen ingevoerde tokens en $6 per 1 miljoen uitgegeven tokens; Artificial Analysis geeft op eigen houtje dezelfde cijfers voor de directe route weer en $0,50 per 1 miljoen in de cache opgeslagen invoertokens. xAI geeft ook aan dat een snelle variant de productiesnelheid verdubbelt, tegen een prijs die twee keer zo hoog is. Gebruik de officiële documentatie voor ontwikkelaars voor het huidige API-contract en de accountspecifieke beschikbaarheid, voordat u productieverkeer verstuurt.
OpenRouter’s Grok, pagina 4,7 toont $1,60 per 1 miljoen ingevoerde tokens en $4,80 per 1 miljoen uitgegeven tokens voor de betreffende route. Dit is een prijs van OpenRouter/de provider, geen correctie op de directe catalogusprijs van xAI. Routing, prijsopslag, caching, limieten en beschikbaarheid kunnen per provider verschillen.
Er is geen eenduidig antwoord op de vraag “Hoeveel kost Grok 4.7?” zonder de route te noemen. Voor een API-inkoper geldt het volgende:
- token-tarieven voor invoer en uitvoer;
- verwerking van in de cache opgeslagen invoer;
- context- en uitvoerbeperkingen;
- tariefbeperkingen en regionale beschikbaarheid;
- of de aanbieder mogelijkheden biedt om de redenering te sturen;
- bepalingen inzake het verzamelen, bewaren en verwerken van gegevens.
Wat de toegang voor consumenten betreft, mag u er niet vanuit gaan dat een API-prijs overeenkomt met de prijs van een X- of Grok-abonnement. Het consumentenabonnement, de API-route en de externe aggregator kunnen verschillende toegangsregels hanteren.
Welke API-route moet je kiezen?
| Route | Geschikt voor | Wat u vóór gebruik moet controleren | Belangrijkste afweging |
|---|---|---|---|
| Direct xAI API | Productiesystemen waarvoor een eigen contract van de aanbieder nodig is | Officiële model-ID, tarieflimieten, gegevensvoorwaarden, regio’s, streaming en huidige prijs | De meest transparante herkomst, maar je regelt de facturering en beschikbaarheid zelf |
| OpenRouter | Snelle vergelijking van providers en het uitproberen van routes | Daadwerkelijke upstream-provider, routeprijs, caching, privacy, context en fallback-gedrag | Gemakkelijker overstappen, maar de route is niet dezelfde als bij de directe xAI-dienst |
| OpenAI-compatibele test-API | Interne evaluatie of een bestaande klant die het OpenAI-schema al ondersteunt | Modeltoewijzing, time-outlimieten, ondersteuning voor streaming, gebruiksvelden, bewaartermijnen en foutbetekenissen | Eenvoudige integratie, maar compatibiliteit garandeert niet dat de provider zich op identieke wijze gedraagt |
De compatibele route die voor het praktijkgedeelte werd gebruikt, leverde het volgende resultaat op: grok-4.7 en ondersteunde streaming. Het coderingsverzoek voor niet-streaming overschreed het wachttijdvenster van de gateway voordat de herhalingspoging voor de stream was voltooid. Deze constatering is nuttig bij het ontwerpen van een client, maar mag niet worden gebruikt als argument voor een bewering over de latentie van DirectX AI.
Toegang tot Grok 4.7
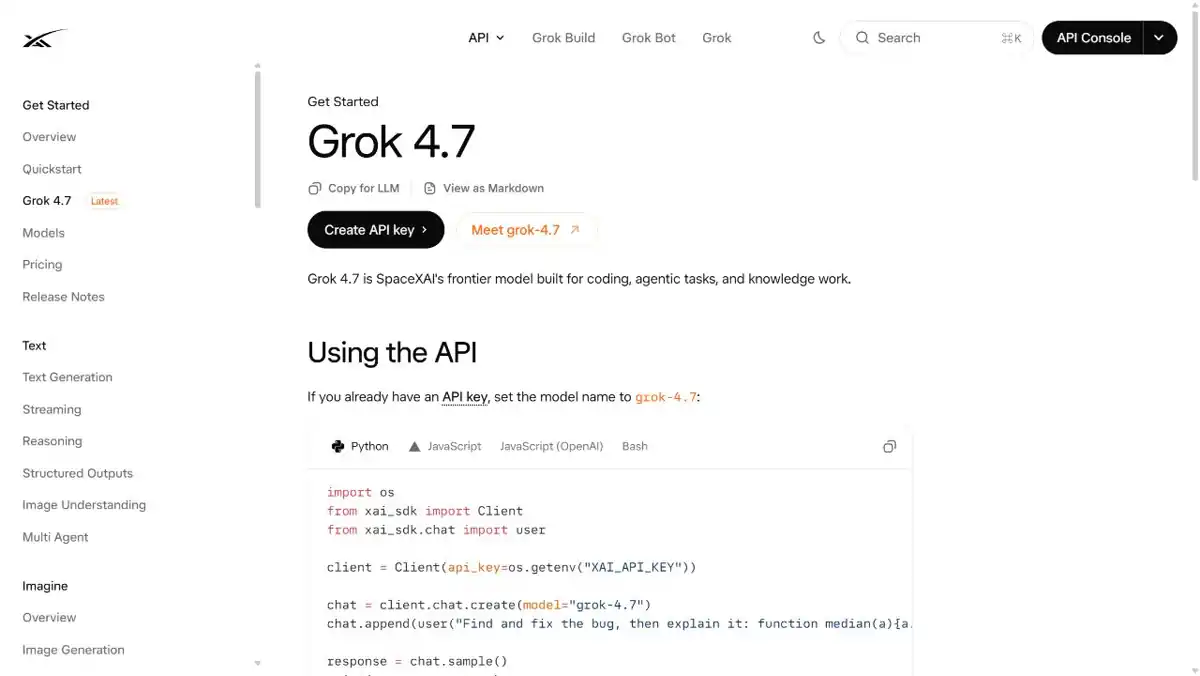
De eenvoudigste manier is om te beginnen met de Aankondiging van xAI en xAI-ontwikkelaarspagina, en controleer vervolgens of je Grok Build, Cursor, de directe API of een aggregator nodig hebt. xAI geeft aan dat Grok 4.7 beschikbaar is in Cursor en Grok Build, via de Grok-API en via coderingsharnassen, modelrouters en cloudplatforms van derden. Dit onderscheid is bepalend voor de facturering, modelcontroles, privacyvoorwaarden en beschikbare tools.
Als je een aggregator gebruikt, open dan de modelpagina ervan en controleer de route van de aanbieder, de tokenprijzen, de contextlimiet en de model-ID voordat je ermee gaat werken. OpenRouter is een van de gedocumenteerde routes, maar de bijbehorende prijzen mogen niet worden overgenomen in een xAI-facturatietabel.
Voor lezers die meerdere modelfamilies binnen één werkruimte willen vergelijken, De multi-model-werkruimte van GlobalGPT kan handig zijn om prompts naast elkaar te vergelijken. Dit artikel doet niet beweren dat een Grok 4.7-route daar al beschikbaar is. Of de route in de catalogus daadwerkelijk beschikbaar is, is een aparte kwestie en moet vóór aankoop in de gebruikersinterface van het product worden gecontroleerd.
Grok 4,7 versus ChatGPT, Claude en Gemini
Dit overzicht bevat drie resultaten van de Grok 4.7-taak, maar geen vergelijkende tests met de ChatGPT, Claude of Gemini. Een algemene conclusie als “Grok 4.7 wint” zou nog steeds marketing zijn, geen analyse. Een betere keuze hangt af van het onderzoek rondom het model:
| Als je prioriteit is... | Begin met het beoordelen van… | Waarom |
|---|---|---|
| Lange technische pakketten | Grok 4.7 en andere routes met een grote context | Controleer de nauwkeurigheid van de gegevensopvraging, niet alleen de opgegeven periode |
| Foutopsporing in de repository | Grok 4.7, een model dat gericht is op coderen, en je gebruikelijke testlus | Vergelijk de kwaliteit van de analyse van de onderliggende oorzaken en de doorlooptijd |
| Onderzoek waarbij de bron centraal staat | Een onderzoeksgerichte werkwijze in combinatie met een algemeen redeneringsmodel | Controleer de bronvermeldingen voordat je conclusies accepteert |
| Bestaande productiviteitsintegraties | Het model dat al in uw tools is geïntegreerd | De overstapkosten kunnen groter zijn dan het rendement op de benchmark |
| Laagste API-factuur | Directe routes en routes via aggregators naast elkaar | De prijzen variëren per aanbieder en afhankelijk van het cachegedrag |
De “Gids: ”Voor welke AI is het de moeite waard om te betalen?” stelt de juiste aankoopvraag: welke terugkerende taak levert voldoende voordeel op om de kosten van het abonnement of de API-factuur terug te verdienen? Dat is een duurzamere beslissingsregel dan het najagen van de nieuwste notering op de ranglijst.
Beperkingen en open vragen
Grok 4.7 is te nieuw om tot een brede, onafhankelijke consensus te komen. Het beschikbare bewijsmateriaal laat een aantal vragen open:
- In hoeverre is de vooruitgang consistent op het gebied van programmeren, onderzoek, schrijven en multimodale taken?
- Blijft de 500K-context betrouwbaar tot vlak bij de grens, of gaat de opvraagkwaliteit al eerder achteruit?
- Hoeveel extra vertraging veroorzaakt de grootste denkinspanning?
- Welke consumentenabonnementen, regio’s, tools en tarieflimieten maken het model kwetsbaar?
- Hoe werken de nieuwe beveiligingsmaatregelen bij legitieme maar gevoelige technische werkzaamheden?
- Leveren Direct xAI, OpenRouter en andere aanbieders wezenlijk verschillende resultaten of limieten op?
Die vragen zijn geen redenen om het model af te wijzen. Ze zijn juist de reden om een kleinschalige, representatieve evaluatie uit te voeren voordat een workflow wordt gemigreerd of een kostenbesparing wordt beloofd.
Voor wie is Grok 4.7 bedoeld?
Grok 4.7 is het waard om eerst te testen als je:
- gedurende langere tijd code debuggen of technisch materiaal analyseren;
- werken met bronpakketten die groter zijn dan gewone chatvensters;
- waarde hechten aan een model dat bereid is meer moeite te steken in een moeilijke prompt;
- kan de output controleren in plaats van deze direct naar de productie te sturen;
- vergelijken de economische aspecten van directe API’s en aggregators.
Het is minder geschikt als je een volwassen integratie nodig hebt, een duidelijk gedocumenteerd gebruiksplan, of een bewezen voordeel bij dezelfde taak ten opzichte van het model dat al in je stack zit. In die gevallen kan de toegangs- en workflowlaag belangrijker zijn dan een indexwinst van twee punten.
FAQ
Wat is Grok 4.7?
Grok 4.7 is de modelrelease van xAI van 21 september 2026 voor programmeer- en kenniswerk. xAI stelt dat het langer aan moeilijke taken werkt, het werk zorgvuldiger controleert en een nieuwe reeks veiligheidsmaatregelen toevoegt, terwijl de prijs en snelheid gelijk blijven aan die van Grok 4.6.
Wanneer is Grok 4.7 uitgebracht?
xAI heeft op 21 september 2026 Grok 4.7 aangekondigd. De officiële lanceringspagina en de documentatie voor ontwikkelaars zijn de beste bronnen voor informatie over de releasestatus, de beschikbaarheid van modellen en wijzigingen in de API.
Is Grok 4.7 beter dan Grok 4.6?
Artificial Analysis rapporteert een intelligentie-index van 46, twee punten hoger dan Grok 4.6, en een AA-Briefcase Elo van 1.657, 111 punten hoger dan 4.6. Dit zijn nuttige aanwijzingen, maar geen algemeen geldend resultaat voor elke workflow.
Wat is het contextvenster van Grok 4.7?
Artificial Analysis vermeldt een contextvenster van 500.000 tokens voor Grok 4.7. Een groot venster biedt geen garantie voor een perfecte zoekresultaat, dus test het model met feiten die op verschillende plaatsen in een lang document staan voordat je erop vertrouwt voor werk waarbij veel bronmateriaal nodig is.
Hoeveel kost de Grok 4.7 API?
Volgens Artificial Analysis bedraagt de directe API-route $2 per 1 miljoen invoertokens en $6 per 1 miljoen uitvoertokens, terwijl de route met ingeslagen invoer $0,50 per 1 miljoen tokens bedraagt. Raadpleeg de actuele xAI-documentatie voordat u het systeem in productie neemt.
Is de prijs van de Grok 4.7 van OpenRouter hetzelfde als die van xAI?
Nee. OpenRouter vermeldt voor zijn route $1.60 per 1 miljoen invoertokens en $4.80 per 1 miljoen uitvoertokens. Dat is een providerspecifieke prijs en moet los van de directe API-prijzen van xAI worden vergeleken. OpenRouter toont ook providerspecifieke velden voor cache, latentie, doorvoersnelheid en privacy, die de praktische kosten van een route kunnen beïnvloeden.
Hoe krijg ik toegang tot Grok 4.7?
Begin met de officiële aankondiging en de documentatie voor ontwikkelaars van xAI, en kies vervolgens het Grok-product voor consumenten, de directe xAI-API of een aggregator zoals OpenRouter. Controleer de model-ID, de regio, de tarieflimieten, de context en de facturering voor de route die je daadwerkelijk van plan bent te gebruiken.
Is Grok 4.7 beschikbaar op GlobalGPT?
In deze beoordeling wordt geen bewering gedaan over een geverifieerde Grok 4.7-route op GlobalGPT. GlobalGPT kan worden gebruikt om beschikbare modelfamilies te vergelijken, maar de huidige catalogus en de exacte beschikbaarheid van modellen moeten vóór aankoop worden gecontroleerd in de productinterface.
Is Grok 4.7 geschikt voor coderingsmiddelen?
Het is de moeite waard om te testen op begrensde foutopsporing, codereview en redeneren op basis van meerdere bestanden, waarbij de agent aannames moet toelichten en tests moet opstellen. De praktische programmeertaak was sterk, maar er werd geen aandacht besteed aan het uitvoeren van tools, het bewerken van de repository, machtigingen of een volledige agentcyclus.
Waarom was streaming nodig voor de programmeertest?
Het eerste verzoek zonder streaming overschreed het wachttijdvenster van de gateway van de testroute. Hetzelfde verzoek werd wel voltooid toen streaming was ingeschakeld. Dit laat zien waarom productieklanten streaming en expliciete time-outs moeten ondersteunen; het bewijst echter niet dat elke Grok 4.7-route hetzelfde latentiegedrag vertoont.
Hoe moet ik het contextvenster van 500K testen?
Gebruik een vast pakket met doorslaggevende feiten aan het begin, in het midden en aan het einde, plus één opzettelijk conflict. Vraag naar de locaties van de bronnen en beoordeel het herinneringsvermogen, de omgang met conflicten en de latentie bij verschillende invoergroottes, in plaats van uitsluitend af te gaan op het geadverteerde maximum.
Is Grok 4.7 de moeite waard om te upgraden vanaf Grok 4.6?
De eerste resultaten wijzen op een zinvolle maar stapsgewijze upgrade: de onafhankelijke metingen zijn verbeterd en tijdens de praktische test bleken de prestaties op het gebied van foutopsporing en broncodesynthese uitstekend. Voer de upgrade pas door als uit je eigen taken blijkt dat de beoordelingsinspanning is afgenomen of de nauwkeurigheid is verbeterd, tegen route-specifieke kosten die je kunt rechtvaardigen.
Eindoordeel
Grok 4.7 lijkt een serieuze, stapsgewijze modelupgrade te zijn met een duidelijk doel: programmeer- en kenniswerk waarbij aanhoudende inspanning wordt beloond. De officiële release geeft een geloofwaardige verklaring voor de verandering, de eerste cijfers van Artificial Analysis laten een verbetering zien ten opzichte van Grok 4.6 in plaats van een achteruitgang, en onze API-run voegt daar een klein praktisch signaal aan toe. Het model ging bijzonder goed om met een bug in de gelijktijdigheid en een memo met tegenstrijdige bronnen; het antwoord op de planning was zorgvuldig, maar niet zo operationeel als gevraagd.
Het eerlijke oordeel is nog voorlopig. Het ging om drie afzonderlijke doorlopen van één testroute; bij de traagste taak moest er worden gestreamd na een time-out van een niet-streamende gateway, en er is geen vergelijkbare run van een concurrent of brede onafhankelijke consensus. Begin met één moeilijke taak uit uw daadwerkelijke workflow, vergelijk de output en de verwerkingstijd met het model dat u al gebruikt, en beslis vervolgens of de upgrade de routespecifieke kosten waard is.









