エビデンスに基づくレビュー・2026年8月
オープンウェイト、ホスト型API、そして命名上のギャップ――これらをわかりやすく整理しました。.
証拠の制限: Qwen3-TTSの聴感評価スコアについては、直接の測定結果に基づくものは報告されていない。.
有益なQwen3-TTSのレビューでは、音声を評価する前に、より基本的な疑問に答える必要があります。それは、「どのQwen3-TTSについて話しているのか」ということです。 2026年現在、この名称には、ダウンロード可能な0.6Bおよび1.7Bのチェックポイント、Alibaba CloudがホストするQwen3-TTS API、そして別のQwen-Audio 3.0 TTSファミリーも推奨されている市場が含まれています。 これらの製品を単一のものとして扱うと、処理速度、対応言語、価格に関する誤解を招くような主張が生まれてしまいます。.
一言で言えば、Qwen3-TTSは2026年において最も柔軟性の高いオープンソース音声スタックの一つです。10言語の対応、タスク特化型のチェックポイント、約3秒での音声クローン作成、自然言語による音声デザイン、ストリーミング対応、そしてApache-2.0ライセンスでの提供といった特徴を備えています。 ただし、本レビューでは聴感評価スコアは算出していません。利用可能なテスト環境では実際のQwen3-TTSエンドポイントが公開されておらず、また、ローカルの2GB GPUでは、0.6B対1.7Bの代表的なベンチマークを行うには不適切だったためです。.
2026年のQwen3-TTSの状況
Qwenは、2026年1月22日にオープン形式のQwen3-TTSの重みデータを公開しました。その Qwen3-TTSの公式リポジトリ リリース済みの12Hzチェックポイントを5つ挙げています:1.7B VoiceDesign、1.7B CustomVoice、1.7B Base、0.6B CustomVoice、および0.6B Base。これに対応する Hugging Faceのコレクション また、トークナイザーも含まれています。これらは、開発者が公開されているライセンスの下で、確認、ダウンロード、および実行できるモデルです。.
アリババクラウドは、非リアルタイムおよびリアルタイムのインターフェースを通じて、ホスト型「Qwen3-TTS Flash」、「Instruct」、音声クローン、音声デザイン各シリーズを個別に提供しています。現在の 音声合成モデルカタログ ホストされたエイリアス、リージョン、言語、およびインターフェースについては、オープンチェックポイントの名前を変更しなくてもこれらの詳細が変更される可能性があるため、これを「真実の源」として扱う必要があります。.
命名に関しては、もう1つ注意すべき点があります。Alibaba Cloudの2026年版モデル選択ガイドでは、いくつかのホスト型ジョブについて、ユーザーに「Qwen-Audio 3.0 TTS」の利用を推奨しています。 Qwen-Audio 3.0 TTSは、0.6Bや1.7BのQwen3-TTSチェックポイントの名称変更版ではありません。すでにQwenファミリー全般について把握されている場合は、当社の Qwen 3.8 最大スペックとアクセスレビュー Qwen製品全体において、正確なモデル名の付け方がなぜ重要なのかを示しています。.
ローカル推論には「open checkpoint」という名称を、API 動作には正確な Alibaba Cloud モデル ID を、Qwen-Audio 3.0 TTS についてはあくまで別の選択肢としてのみ使用してください。そうすることで、各品質、遅延、価格に関する主張が、それらを生み出した製品に正しく紐づけられます。.
一言評価:強力で、オープンであり、証拠に敏感
ひとくちレビュー
オープンな展開、研究、クローン作成、およびキャラクターの声。.
2つのサイズにわたる、タスクごとに特化した5つのチェックポイント。.
ベンダーの処理速度は環境によって異なります。品質については、ここでは評価対象外です。.
「Hosted Qwen3-TTS」と「Qwen-Audio 3.0」は、それぞれ別のルートです。.
Qwen3-TTSは、制御性と導入の選択肢を求めるチームにとって最も魅力的なソリューションです。 Baseチェックポイントはクローン機能をサポートし、CustomVoiceは指示制御が可能な名前付きプリセットスピーカーを提供し、VoiceDesignは記述された説明から音声を生成できます。10言語に対応しているため、英語のみのオープンデモよりもはるかに有用であり、0.6Bバージョンは開発者にとってより軽量なスタート地点となります。.
主な注意点として挙げられるのは、エビデンスの質です。Qwenは、最適化された内部環境において、優れたベンチマーク結果と低いファーストパケット遅延を報告しています。しかし、これらの数値からは、ノートPCのコールドスタート時の状況、コンテナのVRAMの余裕、あるいは製品名の発音については明らかになっていません。「97ミリ秒」という普遍的な数値の提示には、ベンチマークの条件が省略されています。.
自社ホスト型のプロトタイプとしては、Qwen3-TTSは候補リストの上位に位置づけられます。本番環境向けのAPIについては、ホスト型であるQwen3-TTSのルートと、新しいQwen-Audioの推奨事項、運用サポート、地域ごとの利用可能性、およびクローン音声の管理コストを比較検討してください。 音声だけでなく、効果音や音楽まで対象とする場合は、より広範な Seed Audio 1.0 の音声、効果音、音楽のテスト これまでとは異なる、よりマルチモーダルなオーディオワークフローに対応します。.
結論として、Qwen3-TTSはアーキテクチャ、オープン性、機能の網羅性の点で非常に優れています。実際の運用レベルについては、具体的なチェックポイントやエンドポイント、お使いのハードウェア、使用言語、および独自のスクリプトでテスト済みの合意済みの参照音声によって異なります。.
Qwen3-TTSとは何ですか?
Qwen3-TTSは、毎秒12.5フレームで動作する離散音声トークナイザーを中核とする音声生成モデルのファミリーです。によると、 Qwen3-TTS 技術報告書, 、このシステムは10言語にわたる500万時間以上のデータを用いて学習されました。低いトークン率は設計上の重要な要素です。音響トークンの数を減らすことで、デコードの負荷を軽減し、ストリーミングの実用性を高めることができる一方で、モデルは音色、発音、プロソディを保持し続けなければなりません。.
3つの層、3つの証拠規則
0.6B / 1.7B
Base、CustomVoice、および1.7B VoiceDesign。ローカルモデルの推論に使用します。.
Flash / Instruct / VC / VD
APIのモデル、インターフェース、リージョン、日付を正確に指定してください。.
Qwen-Audio 3.0 TTS
現在のホスト型代替案であり、名称変更されたオープンチェックポイントではない。.
公開された5つのチェックポイントは、より大規模なモデルほどあらゆる処理をこなせるという「階層構造」ではなく、それぞれ特定のタスクに特化したものです:
| チェックポイントの解除 | サイズ | 最も適した求人 | 重要な境界 |
|---|---|---|---|
| Qwen3-TTS-12Hz-0.6B-ベース | 0.6B | 小規模なクローニングおよび研究ワークフロー | CustomVoice カタログが事前設定されていません |
| Qwen3-TTS-12Hz-1.7B-Base | 17億 | 大容量のクローニングおよび継続作業 | メモリと演算能力が不足している |
| Qwen3-TTS-12Hz-0.6B-CustomVoice | 0.6B | 指示制御付きプリセットボイス | 発売済みのスピーカーセットを使用します |
| Qwen3-TTS-12Hz-1.7B-CustomVoice | 17億 | 大容量のプリセット音声合成 | VoiceDesignのチェックポイントではありません |
| Qwen3-TTS-12Hz-1.7B-VoiceDesign | 17億 | 文章による説明から音色を作成する | 0.6B VoiceDesign ピアはリリースされていません |
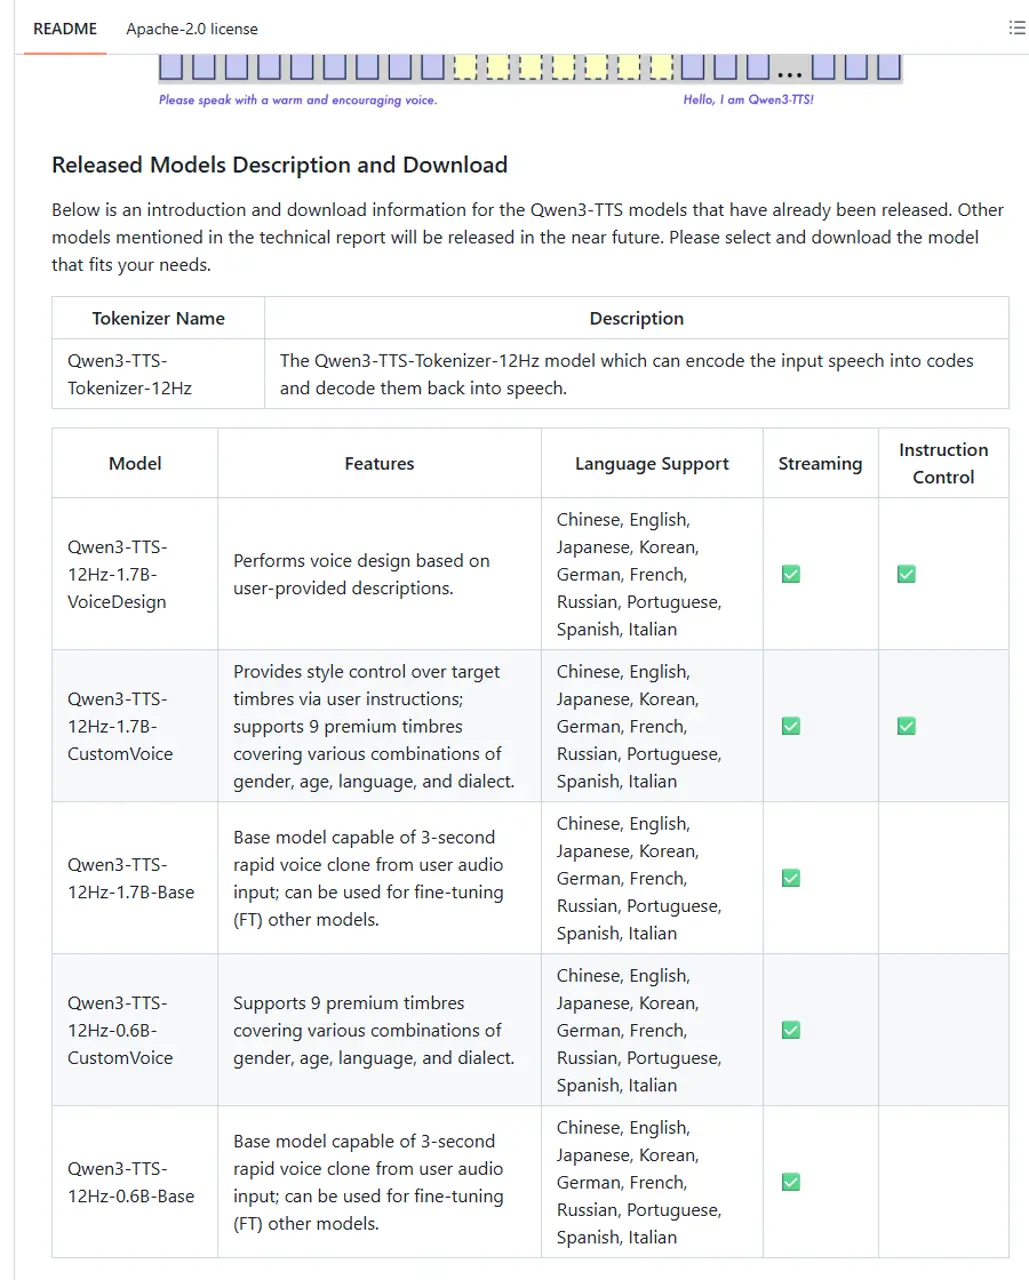
「Base」は、基準となるスピーカーがあり、その声を採用する許可が得られている場合に最適な選択肢です。「CustomVoice」は、Qwenが提供するプリセット音色のいずれかがプロジェクトに合致する場合、より手軽な選択肢となります。「VoiceDesign」は、「穏やかで成熟したナレーターで、低音域が柔らかい」といったキャラクターの要件があり、基準となる録音が必要ない場合に適しています。.
プリセットのナレーターで十分であれば、製品チュートリアルにクローン機能は必要ありません。また、VoiceDesignが適切なキャラクター像を作り出せるのであれば、架空のキャラクターに実在の人物の音声を収録する必要はないかもしれません。各タスクについて、対応するチェックポイントを用いて評価してください。.
このQwen3-TTSレビューのテスト方法
本レビューでは、公式文書、Qwen技術報告書、現地でのハードウェア検査、および別途ホストされたオーディオラッパーの制御下でのテストという4つの証拠層を用いています。公式情報源は、製品の事実およびベンダーが報告したベンチマークを裏付けています。ラッパーの制御による検証は、観察された動作のみを裏付けるものであり、Qwen3-TTSの音声品質スコアを裏付けるものではありません。.
利用可能なタスク環境の一覧 qwen-audio-3.0-tts-flash, ではない。 qwen3-tts-* モデル。.
明瞭な英語の音声録音を生成してください。次の文を正確に読み上げてください:「日の出とともに、研究チームはすべての信号を2回確認してから、結果を発表しました。」温かみがあり落ち着いた大人のナレーターの声を用い、自然なテンポで、子音をはっきりと発音し、「日の出」の後に短い間を入れてください。 音楽、効果音、イントロ、および引用された文に含まれていない言葉は一切追加しないでください。.当社のテストでは、この入力に対して21.263673秒のMP3ファイルが生成され、道順が音声で読み上げられました。テスト結果から、ラッパーがプロンプト全体を音声テキストとして扱ったことが確認されました。.
日の出とともに、研究チームはすべての信号を2回確認してから、結果を発表しました。.対象の文のみを用いた対照実験を再度実施した。今回のテストでは、22,050 Hz、128 kbps、モノラルのMP3ファイル(再生時間6.086531秒)が生成された。このファイルは対象の文と一語一語一致しており、指示は一切追加されていなかった。.
ユーザーは両方のファイルを聴き、以下の評価を確認しました。これは、MOS調査やリスニングパネルではなく、1人のリスナーによる実地確認です。.
| 「傾聴」の側面 | 指示付き制御 | プレーンテキストの制御 |
|---|---|---|
| 自然さ | 4/5 | 5/5 |
| 明瞭度 | 5/5 | 5/5 |
| 発音 | 5/5 | 5/5 |
| 韻律 | 4/5 | 5/5 |
| テキストの忠実度 | 1/5 | 5/5 |
| スタイルの遵守 | 得点なし | 5/5 |
| アーティファクトの欠如 | 5/5 | 5/5 |
| 生産現場での使いやすさ | 1/5 | 5/5 |
説明文を含むサンプルは明瞭で、概ね自然でしたが、説明文を読み上げたことで、テキストの忠実度と実用性が損なわれてしまいました。プレーンテキストのサンプルは自然で、文章に忠実に読み上げられており、内容の修正も一切必要ありませんでした。これらのスコアは、これら2つの qwen-audio-3.0-tts-flash ラッパーコントロール。これらは、Qwen3-TTSチェックポイントの音声品質評価ではありません。.
スタイルの指示とナレーションが同じフィールドにあると決して思い込まないでください。当社のガイドでは、 AIが作成したスピーチをより人間らしく聞こえるようにする スクリプトは改善されますが、エンドポイントのフィールドによって、指示が音声を制御するのか、それとも録音を開始するのかが決まります。.
現地での調査の結果、2 GBのVRAMを搭載したNVIDIA GeForce MX450と、約16.9 GBのシステムメモリが確認されました。これは、計画されている0.6B対1.7Bのマトリックスを評価するには不適切なプラットフォームです。 CPUオフロードは、代表的な速度ではなく、単なる初期段階の性能である可能性があります。そのため、Qwen3-TTSの音声品質、ローカルRTF、クローン類似度、および言語間の一貫性については、評価対象外となっています。.
Qwen3-TTSの音質:実証データが示すこと
公式レポートによると、Qwen3-TTSは、明瞭度、話者類似度、指示の遵守、多言語生成、長文音声、ストリーミングの各項目において優れた結果を示しています。これらは有用な比較指標ではありますが、あくまでQwenが報告したベンチマークであり、本研究で生成された録音データではありません。.
制作用の音声テストでは、発音、音声のノイズ、話し方、感情表現、再現性、編集の負担、略語、日付、通貨、URL、固有名詞、コードスイッチング、および長い文を網羅する必要があります。.
音声と文字起こし、およびメタデータを組み合わせて活用する;その ChatGPT 音声文字起こしのワークフロー これにより、テキストのチェックを再現可能にします。.
Qwen3-TTSは期待できそうですが、このレビューには実機でのチェックポイントスコアが記載されていません。出荷前に、繰り返し再生を行い、内蔵スピーカー、ヘッドフォン、および携帯電話のスピーカーで音質を確認してください。.
外部のレビュー担当者が注目した点
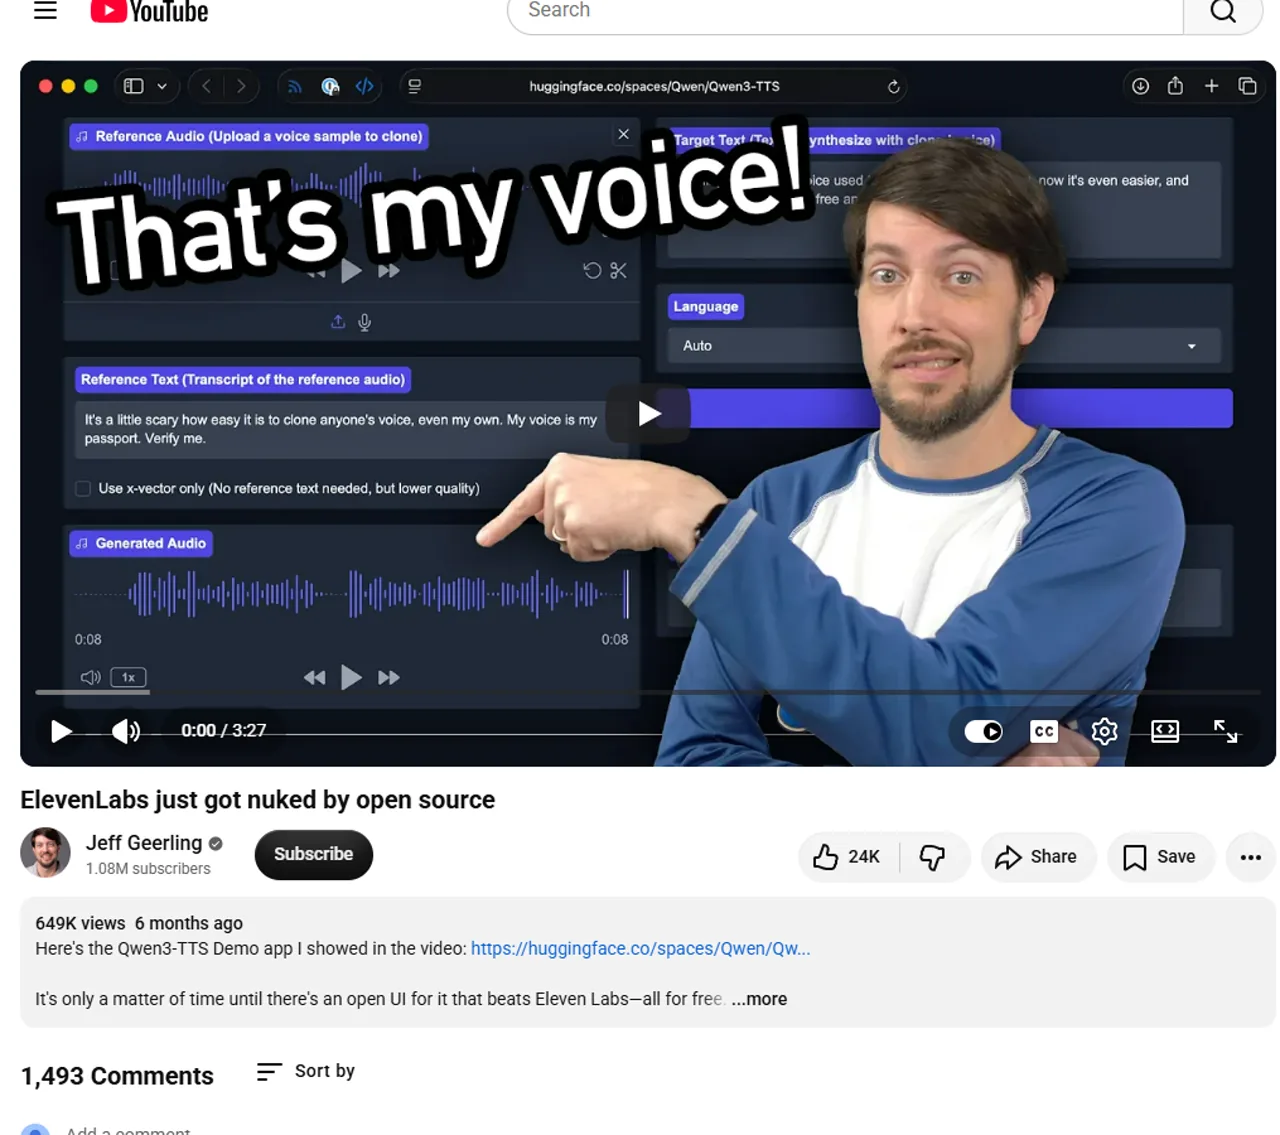
Qwenのソーシャルデモでは、多様な音色、言語、方言が際立っています。インディーズクリエイターのビジャン・ボーウェン氏は、ローカルでの実行と音声クローン技術に焦点を当てました。一方、ジェフ・ギアリング氏は、このリリースを、管理型TTSプラットフォームに対する強力なオープンソースの競合製品として位置づけました。これらはレビュー担当者の見解であり、ベンチマーク結果や市場全体のコンセンサスを示すものではありません。.
Qwen3-TTS の速度と遅延
最初のパケットの遅延
0.288 / 0.313
同時実行数 1 の場合、0.6B / 1.7B。.
最適化された社内vLLM環境――ノートPCでの動作を保証するものではありません。.
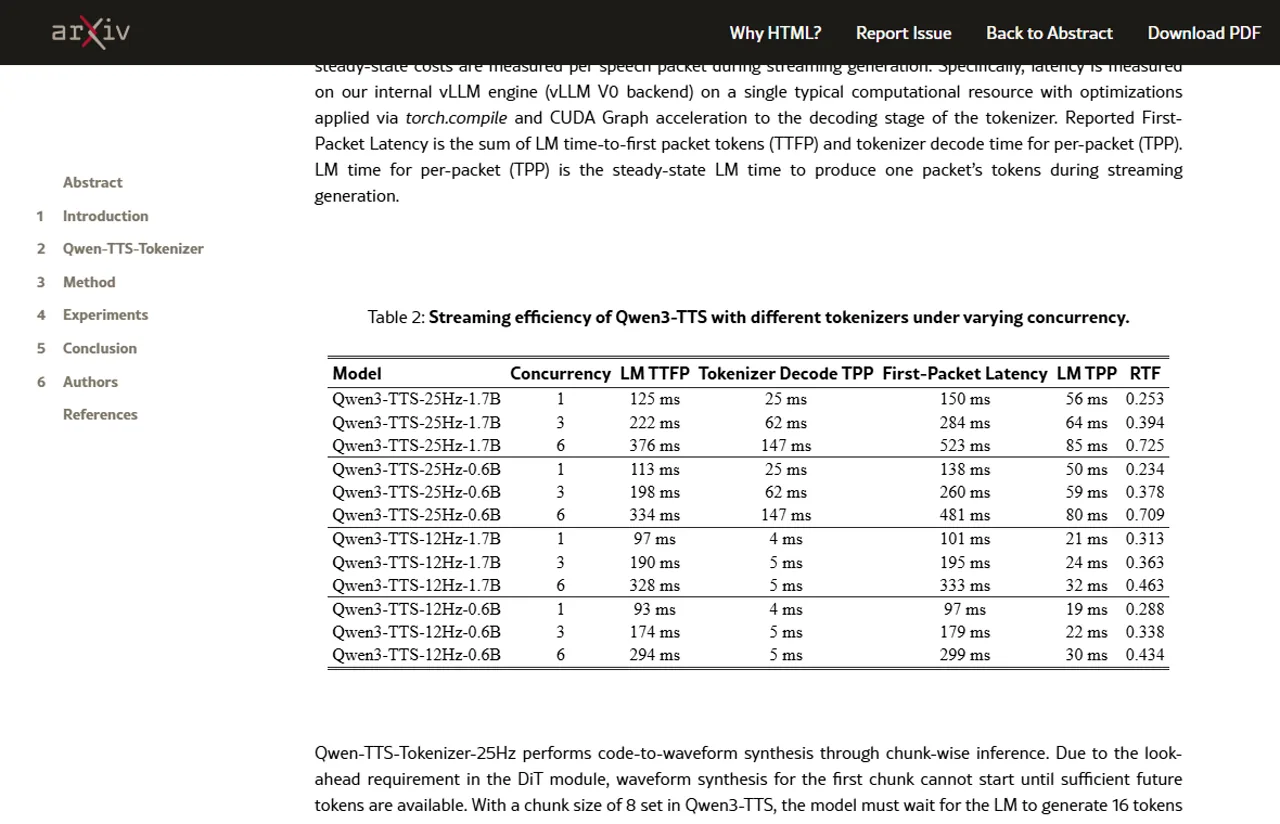
0.6B 12Hzモデルの最大速度値は、ファーストパケット遅延が97ミリ秒です。同じ技術報告書の表によると、1.7B 12Hzモデルの同時実行数1の場合、101ミリ秒となっています。 報告されたリアルタイム係数(RTF)は、それぞれ0.288および0.313でした。平たく言えば、RTFが1未満であるということは、その環境において、合成処理が生成されたオーディオの再生時間よりも速く実行されたことを意味します。.
これらの結果は、Qwenの最適化された内部vLLM環境から得られたものです。これらは、WindowsノートPC、起動直後のサーバーレスコンテナ、あるいは共有APIリージョンにおける一般的な「最初の音声再生までの時間」の保証値ではありません。 また、このレポートでは、並行処理がレイテンシに影響を与えることも示されています。モデルの読み込み、参照オーディオの処理、ネットワーク転送、キューイング、オーディオのパッケージ化、およびクライアントでの再生は、すべてコアデコーダの数値とは無関係に発生する可能性があります。.
公正なベンチマーク記録には、以下の内容が含まれているべきです:
- ハードウェア、精度、モデルの改訂、およびバックエンドへの配慮。.
- コールド状態またはウォーム状態、同時実行数、最初のオーディオ再生開始時刻、合計時間、VRAMのピーク使用量、出力時間、およびRTF。.
- APIの場合:リージョン、接続タイプ、リクエストID、キューイング、および再試行。.
最大容量よりもメモリや並行処理が重視される場合は、0.6Bモデルの方が安全な選択となるでしょう。マシンに余裕がある場合は、1.7Bモデルの方が品質の面でより妥当な選択肢となります。ただし、同じプロンプト、スピーカー、サンプリング設定、ウォーム状態を使用しない限り、モデルサイズだけでは実際のレイテンシの差を判断することはできません。.
Qwen3-TTS 言語と発音
公開されている Qwen3-TTS チェックポイントは、中国語、英語、日本語、韓国語、ドイツ語、フランス語、ロシア語、ポルトガル語、スペイン語、イタリア語の10言語に対応しています。このリストは、現在のリポジトリおよびリリース済みのモデル資料に基づいています。 別の Qwen オーディオ製品でタイ語、インドネシア語、マレー語、ベトナム語がサポートされているため、これらを勝手に追加しないでください。.
| 言語 | 公式サポートの開始 | 生産レビューの優先順位 |
|---|---|---|
| 中国語 | はい | 音、固有名詞、数字の読み方、地域ごとの文章スタイル |
| 英語 | はい | ストレス、略語、ブランド名、長い文 |
| 日本語 | はい | 語調、助詞、固有名詞、ラテン語混じりのテキスト |
| 韓国語 | はい | 語間、外来語、文末の表現 |
| ドイツ語 | はい | 複合語、数字、子音の重なり |
| フランス語 | はい | 連絡、略語、外来語 |
| ロシア語 | はい | ストレス、固有名詞、数字、ラテン語の挿入 |
| ポルトガル語 | はい | 意図した地域ごとのアクセントや綴りを確認する |
| スペイン語 | はい | 地域ごとの訛りや固有名詞を確認する |
| イタリア語 | はい | ストレス、二重子音、外国人の名前 |
“「対応」とは、そのモデルが当該言語を合成できることを意味するものであり、すべての地域においてすべての音声が同等にネイティブに近い発音であるという意味ではない。ポルトガル語やスペイン語だけでも、地域ごとに重要な違いが存在する。商用展開にあたっては、対象となるロケールを定義し、ネイティブのレビュー担当者を採用し、人名、測定値、住所、法的用語に関する発音回帰データセットを構築する必要がある。.
コードスイッチングには、独自のテストが必要です。「午前9時30分にサンパウロでQwen3-TTS APIを開く」といった文には、英語の文構造、モデル名、ポルトガル語の発音、句読点、そして時刻が組み合わされています。 これは、単一言語の整然としたデモ文よりも、実際のアプリのコピーにずっと近いものです。動画の吹き替えにおいては、発音もタイミングに合わせなければなりません。当社の Veo 3.1 ダイアログ、音声、リップシンクのワークフロー 周辺の同期に関する問題について扱っています。.
音声クローン、CustomVoice、VoiceDesign
Baseのチェックポイントは、約3秒間の参照音声から迅速な音声クローン作成をサポートしています。これは、最低限の性能基準を示すものであり、3秒間の音声が常に最適な生成サンプルとなることを保証するものではありません。参照音声が短いと、音域、テンポ、母音の網羅性、感情表現、マイクの一貫性などが欠ける可能性があります。.
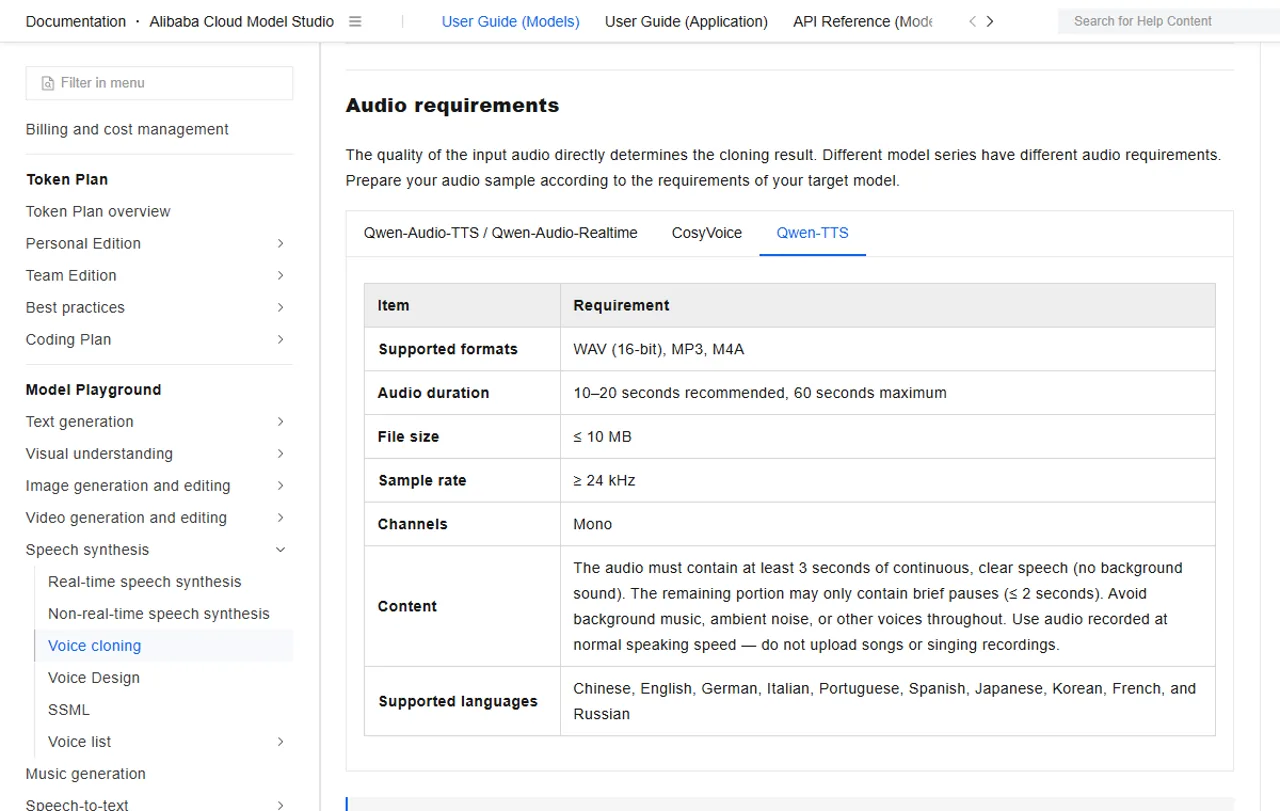
Alibaba Cloudのホスト型登録ガイドラインはより保守的です。少なくとも3秒間の連続した明瞭な音声が求められ、より長い音声サンプルも許可されており、実用的なクローン作成のためには、より明瞭で長い録音を使用することが推奨されています。現在の 音声クローンに関するドキュメント 論文で示された3秒間のデモをアップロード仕様として扱うのではなく、フォーマット、サンプリングレート、チャンネル数、再生時間、およびリージョンのルールに基づいて判断すべきである。.
CustomVoiceは、実在の人物を模倣することを避けています。公開版には、さまざまな言語やスタイルに対応した9種類のプレミアム音色が収録されており、あらかじめ設定されたキャラクターや指示の制御だけで十分な場合に特に魅力的です。.
VoiceDesignは、自然言語による記述から音色を作成します。ホスト型 ボイスデザインのドキュメント 個別の作成ワークフローを示しています。これは架空のキャラクターや合成されたブランドボイスに適していますが、説明文については、感じられる年齢、アクセント、文化的バイアスについて、依然として検証が必要です。.
音声識別リスクマトリックス
話者、範囲、期間、および撤退経路を記録する。.
参照を暗号化し、ソースとともに派生した音声を削除する。.
有害な身元に関する主張をブロックし、通報機能を追加する。.
聞き手が合成音声と人間の発話を混同する可能性がある場合は、その合成音声にラベルを付ける。.
クローン作成には、明確な権利とインフォームド・コンセントが必要です。元の同意記録を保管し、許可される利用範囲を定義し、下流での再登録を防止し、削除手続きを設けてください。そのリスクは単なる理論上のものにとどまらず、 顔から音声への変換におけるプライバシーと同意に関する分析 なぜ、本人確認、生体認証データ、なりすまし防止策は、単なる脚注ではなく、製品設計そのものに組み込まれるべきなのかを説明しています。.
Qwen3-TTS 0.6B 対 1.7B:どちらを実行すべきか?
最初の制約がデプロイである場合は、0.6Bを選択してください。これは、小型のGPU、高い並行処理能力、迅速な実験、およびコスト重視のセルフホスティングに適した選択肢です。このサイズには「Base」と「CustomVoice」の両方が存在するため、最大のチェックポイントから始めることなく、クローン作成やプリセットスピーカーの評価を行うことができます。.
品質の余裕や機能の幅広さを重視する場合は、1.7Bを選択してください。これはVoiceDesignを搭載した唯一のリリース済みサイズであり、メモリとスループットを犠牲にしてでも容量を優先したいチームにとっては、より妥当な選択肢となります。 技術レポートの同時実行数1における測定値では、Qwenの最適化された設定において、ファーストパケットとRTFにわずかな差が見られますが、お使いのハードウェアによっては、その差が拡大したり縮小したりする可能性があります。.
| 決定要因 | 0.6Bから始めましょう | 17億から始めましょう |
|---|---|---|
| GPUのメモリが不足している | よりしっかりとしたフィット感 | オフロードや低同時実行数のリスクが高まる |
| VoiceDesignが必要 | 発売済みのセットには含まれていません | 必須 |
| ベースのクローニングが必要 | 利用可能 | より大容量のモデルもご用意しています |
| CustomVoiceが必要 | 利用可能 | より大容量のモデルもご用意しています |
| 迅速な実現可能性調査が必要 | 最適な出発点 | パイプライン工事が完了してから使用してください |
| 最終的な制作方針の決定が必要です | 両方をベンチマークする | 両方をベンチマークする |
パラメータ数はVRAMの要件ではありません。精度、アテンションの実装、キャッシュ、参照長、バッチサイズ、フレームワークのオーバーヘッドなど、あらゆる要素が重要になります。かろうじて読み込めるだけのモデルでは、信頼性の高い本番サービスとは言えません。.
今回のレビューで検証した2GB版MX450については、どちらのサイズでも代表的なGPUベンチマーク結果が得られませんでした。実用的な次のステップとしては、新しいCUDAスタックと、適切なGPU、あるいは公式のホスト型エンドポイントの導入が挙げられます。「CPUオフロードで動作した」というのは、互換性に関する注記であり、速度に関する有意義な評価とはなりません。.
Qwen3-TTS API:HTTP、ストリーミング、およびモデル ID
再生のニーズに合わせて移動手段を選んでください
ナレーションの一括収録とファイルの完成に向けた最も簡単な手順。.
段階的な配信。音声が再生可能になった時点を確認してください。.
会話や順次再生に最適です。.
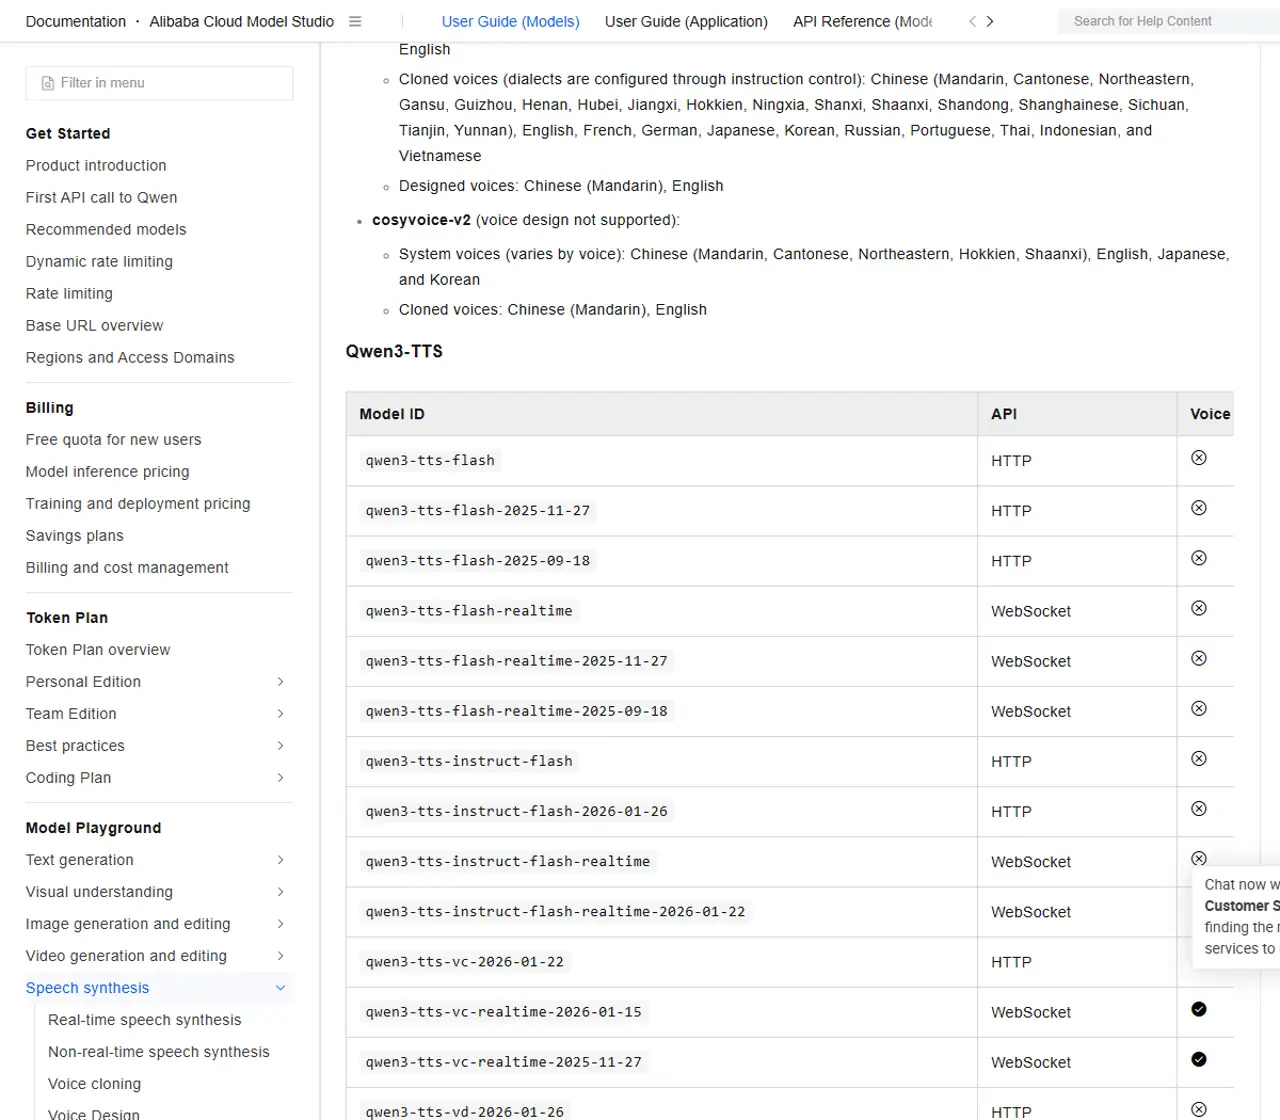
Alibaba Cloud では、非リアルタイムの HTTP 生成モデルとリアルタイムの WebSocket モデルが提供されています。完全な結果を待つことが可能で、最もシンプルなリクエストフローを希望する場合は、非リアルタイムの合成モデルを使用してください。 対話時の遅延やプログレッシブ再生が重要な場合は、WebSocketストリーミングを使用してください。HTTPストリーミングやサーバー送信イベント(SSE)でも増分データを返すことは可能ですが、専用の低遅延リアルタイムモデル群と混同しないようにしてください。.
現在ホストされているファミリーには、内蔵ボイス用の「Qwen3-TTS Flash」、自然言語によるパフォーマンス制御用の「Instruct Flash」、クローンボイス用の「VC」、および設計済みボイス用の「VD」が含まれます。 モデルIDや日付付きスナップショットは、非リアルタイムルートとリアルタイムルートで異なるため、類推によって名前を構築するのではなく、最新のドキュメントからコピーしてください。.
現在の Qwen-TTS API ドキュメント リクエストあたりの入力は512トークンに制限されます。これがこのファミリーに適用される制限です。他のTTSモデルについて文書化されている別の「600文字」というルールは、Qwen3-TTSの統合には適用しないでください。 Complete-audio URL は 24 時間有効であるため、本番システムでは、レスポンス URL を恒久的なメディアとして使用するのではなく、必要なファイルを耐久性のあるストレージに移動する必要があります。.
import os
import dashscope

dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

response = dashscope.MultiModalConversation.call(
    model="qwen3-tts-flash",
    api_key=os.environ["DASHSCOPE_API_KEY"],
    text="ご注文の商品は午後4時30分に受け取り可能です。",
    voice="Cherry",
    language_type="English",
)

print(response)
APIキーとエンドポイントのリージョンは一致している必要があります。北京とシンガポールのデプロイメントでは、認証情報とベースURLが異なります。また、モデルの利用可能性はリージョンによって異なる場合があります。WordPress、クライアントサイドのJavaScript、またはモバイルバイナリにキーを埋め込まないでください。合成リクエストは、自身が管理するサーバーを経由して送信し、機密性の高い入力情報を記録せずにリクエストIDをログに記録し、生成された音声に対してライフサイクルポリシーを設定してください。.
長い音声データの場合は、意味的な区切りで分割し、文脈を維持し、数値を正規化し、すべての結合箇所を注意深く聴き取ってください。通話間のペースやエネルギーが変化した場合でも、有効なクリップは別々のテイクのように聞こえることがあります。.
国際地域におけるQwen3-TTSの価格設定
地域別価格の概要(国際)
フラッシュ
$0.10
入力文字10,000文字あたりInstruct / VC / VD
$0.115
入力文字10,000文字あたりFlash / VC
$0.13
入力文字10,000文字あたり指示する
$0.143
入力文字10,000文字あたりVD
$0.143353
入力文字10,000文字あたり音声生成: 登録1件につき$0.01 · 設計された音声1件につき$0.20。.
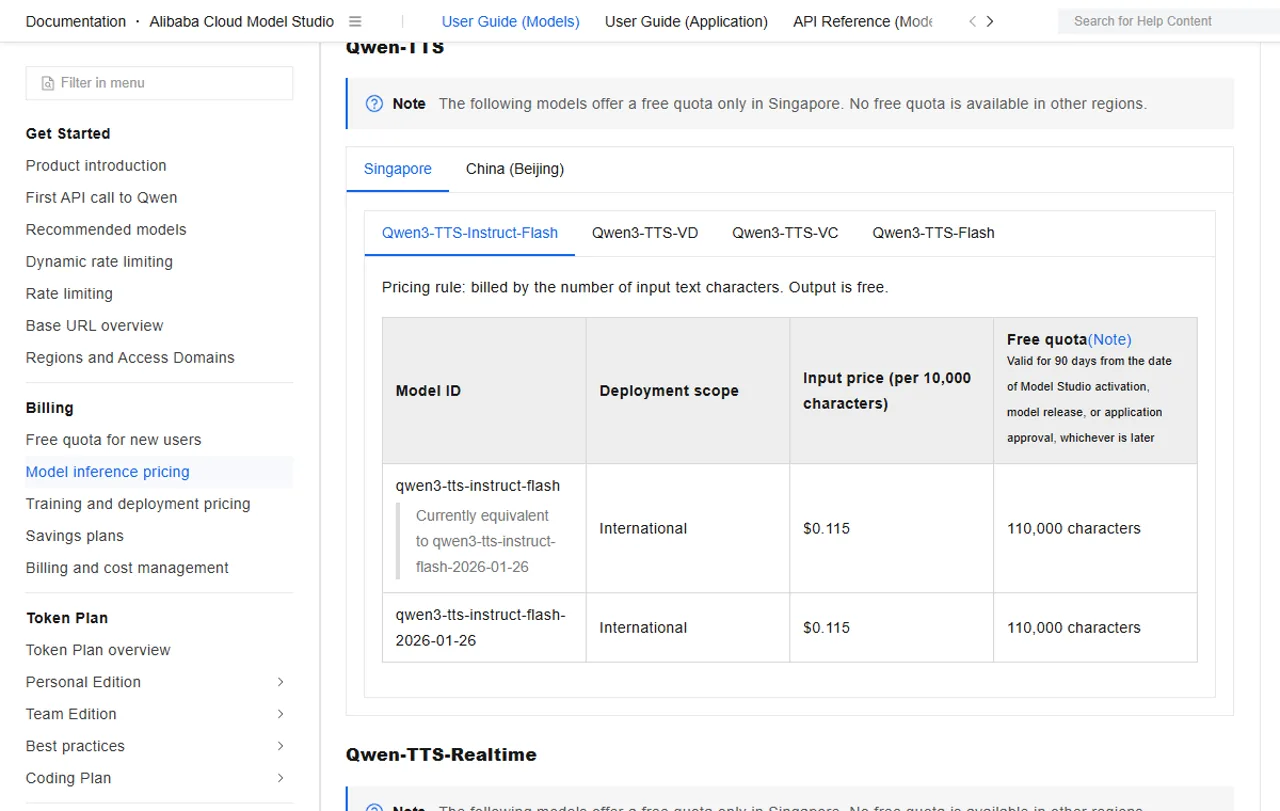
アリババクラウドの Model Studioの価格ページ 2026年8月11日時点で確認したところ、国際リージョンの価格は以下の通りでした。これらの行については、入力データには課金されますが、出力データは無料です。価格、無料クォータ、エイリアス、およびリージョンの利用可能性は変更される可能性があるため、大規模なバッチ処理を行う前に、選択したデプロイメント内容を確認してください。.
| ルート | モデルファミリー | 入力文字10,000文字あたりの価格 |
|---|---|---|
| 非リアルタイム | Qwen3-TTS フラッシュ | $0.10 |
| 非リアルタイム | Instruct、VC、またはVD | $0.115 |
| リアルタイム | Flash または現在の VC | $0.13 |
| リアルタイム | 指示する | $0.143 |
| リアルタイム | VD | $0.143353 |
音声の作成には、合成とは別途の料金がかかります。同じ国際料金表によると、Qwenの音声登録はクローン1つあたり$0.01、音声デザインはデザインされた音声1つあたり$0.20となっています。クローン化またはデザインされた音声は、使用時に文字単位の合成料金が別途発生する場合があります。.
予算については、音声制作、合成キャラクター、インフラ、再生成を個別に設定します。実際の制作コストは、編集時間や繰り返し依頼の有無によって決まることがよくあります。.
APIの価格設定は、ローカルでのコストとは異なります。オープンチェックポイントでは、ベンダーによる文字単位の課金はなくなりますが、その代わりにGPU使用時間、デプロイメントエンジニアリング、監視、ストレージ、スケーリング、インシデント対応などのコストが発生します。制御性、処理量、データの局所性、あるいはカスタマイズ性といった要素が、その運用上の負担を正当化できる場合には、セルフホスティングが有利となります。.
代替案とGlobalGPTオーディオルート
Qwen3-TTSが、あらゆる音声処理タスクにおいて自動的に最適な選択肢となるわけではありません。ElevenLabsは、洗練されたダッシュボード、幅広い制作ツール、そしてインフラの負担軽減を重視するチーム向けの、より成熟したマネージド音声プラットフォームです。 OpenAIの音声モデルは、すでに1つのAPIエコシステムを標準化している開発者に適している可能性があります。Qwen-Audio 3.0 TTSは、Alibaba Cloudの現在の推奨事項に従う際に比較すべき、新しいホスト型Qwenソリューションです。.
音楽や効果音に関するニーズは、別の比較の対象となる。その ElevenLabs、Lyria 3 Pro、Murekaのオーディオ比較 これにより、音声再生ツールと完全な音楽生成ツールを区別しやすくなります。テキスト読み上げモデルは、完成度の高い楽曲を生成できないからといって評価を下げられるべきではなく、また、音楽生成モデルが低遅延のナレーションAPIとして選ばれるべきではありません。.
GlobalGPTには現在、認証済みの オーディオジェネレータの経路 以下に一覧を掲載した qwen-audio-3.0-tts-flash およびSeed Audio 1.0。確認したページにはQwen3-TTSは記載されていませんでした。したがって、GlobalGPTは実質的に独立したオーディオワークスペースであるとはいえ、未解決のQwen3-TTSチェックポイントがそこで利用可能であるという証拠にはなりません。.
最終的な成果物が動画である場合は、別途ナレーターが必要か、生成されたセリフや効果音が必要か、あるいは映像に合わせて音を生み出すモデルが必要かを判断してください。これに対する当社の回答は、 Veo 3.1に音声が出るかどうか その広範な判断を具体化するものです。最も賢明なアプローチは、1つのモデルにすべてのオーディオ処理を無理に任せるのではなく、特化されたツールをいくつか組み合わせることです。.
ライセンス、同意、プライバシー、および商用利用
Qwen3-TTS リポジトリおよび公開されているモデルカードは、Apache-2.0 ライセンスを採用しています。このライセンスは、商用開発、改変、および配布には寛容ですが、他者の声、パフォーマンス、台本、商標、または個人データに関する権利を付与するものではありません。モデルのライセンスとコンテンツの権利は、別個の層として扱われます。.
ローカル推論では、より詳細な制御が可能となり、セキュリティに対する責任もより重くなります。参照記録の暗号化、アクセス制限、保存期間の最小化、派生データの記録、および登録済みの音声やキャッシュされた出力への削除処理の反映を行ってください。.
ホスト型合成サービスを利用する場合は、機密性の高いスクリプトや音声サンプルを送信する前に、利用規約、地域ごとのデータ取り扱い方針、保存期間、および企業向けの管理体制を確認してください。.
一般に公開されるクローン音声には、すべて所有者、同意記録、利用許諾方針、および不正利用への対応策を明記する必要があります。合成音声が実在の人物と誤認される可能性が合理的に考えられる場合は、その旨を開示してください。一般市民やリスクの高い公人のなりすましを禁止し、有害な音声を通報する手段を提供してください。.
Qwen3-TTSはどのような方に適していますか?
どのルートが適しているでしょうか?
パイプライン耐性、メモリの最適化、BaseまたはCustomVoice。.
VoiceDesign または、GPUの余力に基づく品質と処理能力の比較。.
リージョン、プライバシー、価格設定が条件に合致する場合、処理が高速化されます。.
セットアップ不要のスタジオ、ライセンス制のマーケットプレイス、または既存のベンダーによるサポート。.
Qwen3-TTSは、オープンな重み、デプロイメントの選択肢、クローンの作成、あるいはテキストで記述されたキャラクターの声を必要とする研究者、開発者、ゲームチーム、ローカライズグループに適しています。.
パイプラインの検証、限られたメモリの管理、あるいはBaseおよびCustomVoiceが製品の要件を満たしているかどうかのテストを行う場合は、0.6Bから始めてください。 VoiceDesignが必要な場合や、品質とスループットを適切に比較できる十分なハードウェア環境がある場合は、1.7Bから開始してください。インフラがボトルネックとなっており、リージョンの利用可能性、認証情報、データ処理がプロジェクトの要件に合致する場合は、ホスト型APIをご利用ください。.
セットアップ不要の編集スタジオ、大規模なライセンス付き音声マーケットプレイス、あるいは他社による既存のエンタープライズ向けサポートが必要な場合は、別の選択肢をご検討ください。文書による同意がない限り、決して複製を行わないでください。.
5つの実際のスクリプト、3回の繰り返し、名称が複雑なリスト、長い段落、および1つの回復テストを使用します。レイテンシとコストを測定した後、ネイティブのリスナーに、その結果が修正なしで利用可能かどうかを確認します。編集作業によって、ベンチマークでの優位性が覆される可能性があります。.
Qwen3-TTS よくある質問
Qwen3-TTSは無料ですか?
公開された Qwen3-TTS チェックポイントは Apache-2.0 ライセンスの下で提供されているため、文字単位のモデル利用料を支払うことなくダウンロードして実行できます。 ただし、自社でホストする場合でも、コンピューティング、ストレージ、エンジニアリング、モニタリングにかかるコストは発生します。Alibaba CloudがホストするQwen3-TTS APIは有料サービスであり、リージョンごとに料金と利用制限が設定されています。.
Qwen3-TTSは商用利用できますか?
Apache-2.0 ライセンスでは、公開されたコードやモデルの重みの商用利用が許可されていますが、個人の声を複製したり、保護されたスクリプトやブランドを使用したりする権利は付与されません。商用プロジェクトにおいては、依然として話者の同意、コンテンツの権利、プライバシー管理、および現地の法律やプラットフォームの利用規約への準拠が必要となります。.
Qwen3-TTSはどの言語に対応していますか?
公開された Qwen3-TTS リリースでは、中国語、英語、日本語、韓国語、ドイツ語、フランス語、ロシア語、ポルトガル語、スペイン語、イタリア語に対応しています。ホスト型モデルの対応言語は、エンドポイントや音声によって異なる場合がありますので、多言語対応の製品を構築する前に、Alibaba Cloud のモデル ID およびリージョンを正確に確認してください。.
Qwen3-TTSは、本当に97ミリ秒のレイテンシを実現できるのでしょうか?
Qwenは、最適化された内部vLLM環境において、同時接続数1の条件下で、0.6B 12Hzモデルについて97 msのファーストパケット遅延を報告しています。これは有効なベンダーベンチマークであり、すべてのデバイスに適用される保証ではありません。 コールドスタート、ハードウェア、精度、ネットワーク経由の伝送、キューイング、およびクライアント側のバッファリングにより、観測されるレイテンシが増加する可能性があります。.
Qwen3-TTSにはどれくらいのVRAMが必要ですか?
すべての構成に通用する、唯一の「適正な」VRAM容量というものは存在しません。モデルのサイズ、精度、アテンションバックエンド、バッチサイズ、キャッシュ、参照長、フレームワークのオーバーヘッドなど、あらゆる要素が影響します。今回検証した2GBのMX450は、代表的なベンチマークには適していませんでした。選択したチェックポイントを、本番環境に近い並行度でテストし、運用上の余裕を残しておくようにしてください。.
Qwen3-TTSの音声クローン作成には、どのくらいの音声データが必要ですか?
サンプル資料では、約3秒から迅速なクローン作成が可能であることが示されていますが、ホスト型登録ガイドラインでは、明瞭で途切れない音声を使用することを推奨しており、より長いサンプルも許可されています。3秒という時間は、あくまで最低限の実現可能な基準であり、自動的に達成すべき品質目標ではないと捉えてください。話者の通常の声域と対象言語を網羅した、同意を得たノイズのない音声を使用してください。.
Qwen3-TTS API の入力制限はどのようになっていますか?
現在の Qwen-TTS API ドキュメントでは、Qwen-TTS モデルの最大入力トークン数は 512 と記載されています。Complete-audio の URL は 24 時間有効です。長いスクリプトは意味的な区切りで分割し、返された URL を恒久的なホスティング先として扱うのではなく、必要な出力を永続的なストレージにコピーしてください。.
GlobalGPTでQwen3-TTSを使用することはできますか?
掲載されているチェック済みのGlobalGPTオーディオジェネレータ qwen-audio-3.0-tts-flash また、Seed Audio 1.0であり、Qwen3-TTSではありません。この方法を独立したオーディオワークフローとして利用することは可能ですが、オープンな0.6Bまたは1.7BのQwen3-TTSチェックポイントへのアクセスとして説明すべきではありません。.
最終評決
このQwen3-TTSのレビューでは、その異例の広範な機能範囲が明らかになった。0.6Bおよび1.7Bの公開チェックポイント、10言語のサポート、プリセット音声、高速クローン機能、VoiceDesign、ストリーミングアーキテクチャ、寛容なライセンス、そしてホスト型APIなどが挙げられる。.
率直に申し上げて、ここには限界もあります。利用可能なタスク環境では、実際のQwen3-TTSオーディオは生成されず、検証対象となった2 GBのGPUでは、代表的なローカル比較を行うことができませんでした。そのため、本記事では音声品質のスコアを付与したり、97 msというパフォーマンスが普遍的であると主張したりすることはありません。.
オープンなウェイトと制御を重視する場合は、まず0.6Bのチェックポイントをテストし、その後、同じスクリプトとハードウェアで1.7Bと比較してください。 本番環境への導入スピードを重視する場合は、購入を予定しているAlibaba Cloudのルートそのものをテストし、別枠で位置づけられているQwen-Audio 3.0 TTSファミリーと比較してください。モデル名、エンドポイント、リージョン、同意記録、レイテンシ、および編集総コストを、同じ意思決定シートにまとめてください。.
Qwen3-TTSは試してみる価値があります。ドキュメントだけで音声を認識できるかのように装うのは得策ではありません。成功への道とは、社名、言語、ハードウェア、プライバシー要件、そして生産の納期といった条件をすべてクリアできるものです。.