
について OpenAI 音声認識 API テキストを音声に変換します。 投稿 https://api.openai.com/v1/audio/speech. モデル、入力テキスト、および音声を送信し、応答をMP3またはその他の対応オーディオ形式で保存します。口調や話し方に関する指示が必要な新しい連携機能については、まず以下から始めてください。 gpt-4o-mini-tts.
作業依頼はあくまで第一歩に過ぎません。適切な課金単位、再生可能な出力ファイル、そして長編スクリプトの場合はその対応計画も必要です。OpenAIの新しいTTSモデルでは、テキストと音声トークンを基に料金が算出されますが、旧モデルのTTSでは文字数を基に算出されます。1か月分のナレーションの見積もりを立てる際には、この違いが重要になります。.
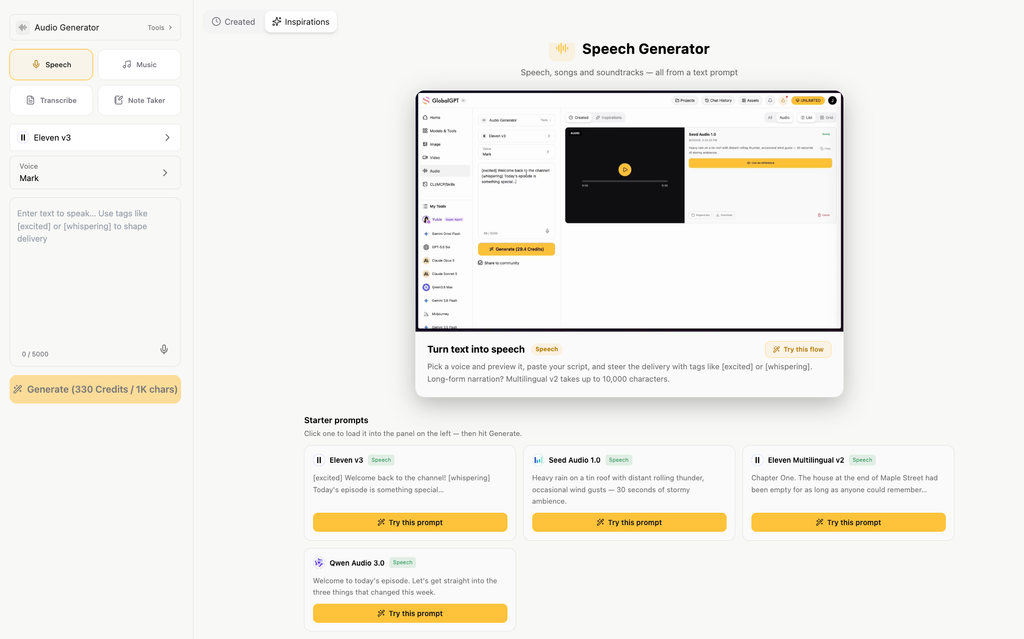
もしあなたの仕事内容に、台本の作成、映像素材の制作、そして動画の編集も含まれるのであれば、, GlobalGPTのオーディオワークスペース 音声生成機能を、手頃な価格のマルチモデルサブスクリプションプラットフォームに統合しています。1つのダッシュボード上でテキスト、音声、画像、動画を横断して作業でき、APIやCLIを活用して反復可能な本番環境での作業を行うことができます。公開されているTTS APIでは、後述する別のタスクワークフローが採用されています。.
OpenAI Audio Speech API にはどのような機能がありますか?
Speech API はテキスト読み上げエンドポイントです。アプリケーションがテキストを送信すると、生成された音声が返されます。代表的な用途としては、製品の操作説明、アクセシビリティのためのナレーション、学習教材、短いナレーションなどが挙げられます。音声が再生される前にテキストを制御できるため、承認済みの台本に沿った表現が必要な場合に役立ちます。.
文字起こしの場合、その流れは逆になります。録音された音声が入力され、テキストが出力されます。ライブ音声アシスタントには、会話を通じて聞き取り、応答するというさらなる要件が加わります。OpenAIの 音声記録 これらのワークフローを区別します。読み上げたいテキストがすでに用意されている場合は、「Speech」エンドポイントを選択してください。.
音声生成機能はストリーミングに対応しているため、アプリケーションは音声をチャンク単位で受信できます。そのストリームをファイルに保存しても、ブラウザで自動的に再生されたり、会話型エージェントが作成されたりすることはありません。再生や会話ロジックの処理は、引き続きアプリケーション側で行う必要があります。また、OpenAIでは、その音声がAIによって生成されたものであることを、リスナーに対して明確に開示することが求められています。.
OpenAI Speech API を使って、最初の音声ファイルを生成しましょう
サーバーまたは開発用マシン上で、OpenAI API キーを OPENAI_API_KEY 環境変数。このキーはブラウザのJavaScript内では使用しないでください。以下の例では、同じ短い製品ツアー用スクリプトを使用し、その結果を openai-product-tour.mp3.
オプション 1:curl リクエストを実行する
OpenAI Speech API · curl
#!/bin/sh
# まず、サーバー環境で OPENAI_API_KEY を設定してください。
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "Acorn Studioの製品ツアーへようこそ。3つのステップで、短いスクリプトを音声ガイドに変えることができます。まず、メッセージを入力します。次に、音声を選択します。最後に、音声ファイルを保存し、スマートフォンで再生テストを行います。",
    "voice": "coral",
    "instructions": "温かみのある会話調で、はっきりと話してください。",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
応答には音声データが含まれているため、JSONとして解析しようとするのではなく、ファイルに保存してください。その --fail-with-body このオプションを指定すると、HTTPエラーが発生した場合にcurlは失敗を示す終了ステータスを返します。ファイルを開く前にそのステータスを確認してください。エラー応答であっても、ファイル名に .mp3.
オプション 2:Python SDK を使用する
次のコマンドで OpenAI パッケージをインストールします。 python -m pip install openai. SDKは環境変数からAPIキーを読み取ります。この例では、応答が到着するたびにそれを書き出すため、オーディオ応答全体を自身のPythonバッファに読み込む必要がなくなります。.
OpenAI Speech API · Python
"""インストール方法: python -m pip install openai。サーバー上でOPENAI_API_KEYを設定してください。"""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "Acorn Studioの製品ツアーへようこそ。3つのステップで、"
    "短いスクリプトを音声ガイドに変えることができます。まず、メッセージを入力します。次に、"
    "声を選択します。最後に、音声ファイルを保存し、スマートフォンで再生テストを行います。"
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="温かみのある会話調で、はっきりと話してください。",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("openai-product-tour.mp3 を保存しました")
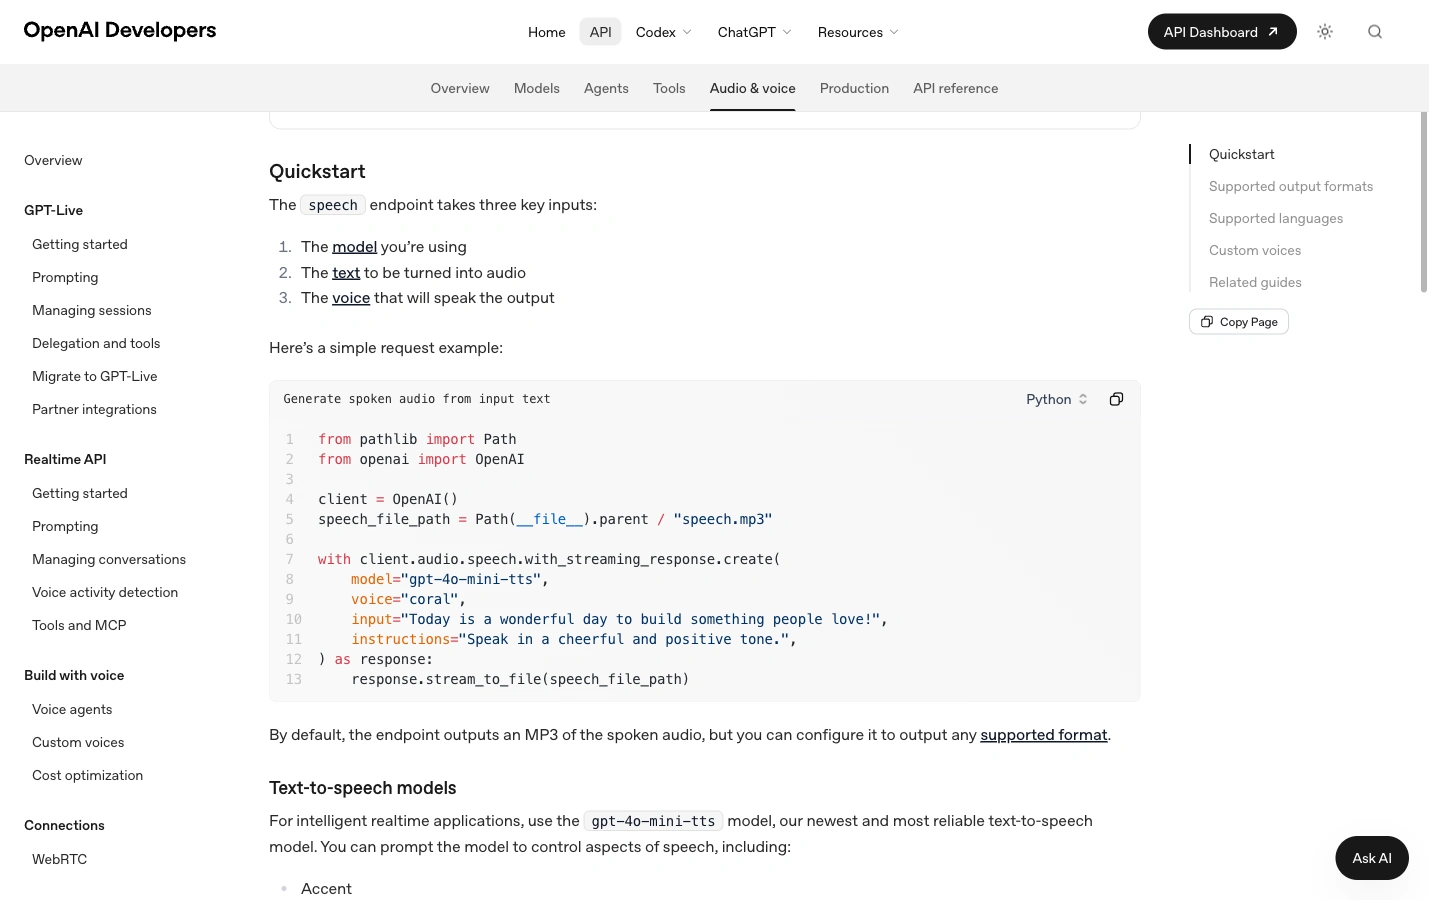
3つの重要な分野は以下の通りです。 モデル, 入力, そして 音声. ここで、, 手順 温かみのある、会話調の話し方を求めます。これは、話し言葉の台本に言葉を追加するのではなく、声の出し方を導くものです。このフィールドは GPT-4o Mini TTS で動作しますが、以下のものではサポートされていません。 tts-1 そして tts-1-hd.
長い文書の場合は、文や段落の区切りでテキストを分割し、各セグメントに番号を付け、その番号をファイル名として保存してください。セグメント間で一貫した語り口や指示を維持してください。自然な表現ができるよう、十分な文脈を残しておき、編集した音声を配布する前に、つなぎ目部分の音声をよく確認してください。.
モデル、音声、出力形式を選択してください
| モデル | 選び方 | 配送に関するご案内 |
|---|---|---|
gpt-4o-mini-tts | コントロール可能な語りや話し方の出発点。. | サポート 手順 トーン、スタイル、そしてテンポの点で。. |
tts-1 | OpenAIは、このモデルを低レイテンシの音声生成に適したものと位置づけています。. | 対応している音声操作や速度調整機能を利用し、省略する 手順. |
tts-1-hd | OpenAIにより、このモデルはTTS-1よりも高品質な音声を実現できるようになっています。. | 対応している音声操作や速度調整機能を利用し、省略する 手順. |
について GPT-4o ミニTTS モデルページ モデルエイリアスを gpt-4o-mini-tts-2025-12-15 スナップショット。アプリケーションにおいて再現性のある動作が重要な場合は、ドキュメントに記載されているスナップショットを慎重に選び、保存したスクリプトとともに記録しておいてください。.
内蔵ボイスと入力制限
Speech APIのリファレンスには、GPT-4o Mini TTS用の13種類の組み込み音声が記載されています: アロイ、アッシュ、バラード、コーラル、エコー、フェイブル、オニキス、ノヴァ、セージ、シマー、ヴァース、マリン、そしてシダー. OpenAIは次のように推奨しています マリン または 杉 最高の品質を得るために。これがOpenAIの推奨事項です。自分の名前や数字、文のパターンを実際に聞いてみて、最適な発声方法を選んでください。.
以前のTTSモデルでは、サポートされている音声セットはより限定されており、「alloy」、「ash」、「coral」、「echo」、「fable」、「onyx」、「nova」、「sage」、「shimmer」のみです。すべての音声がすべてのモデルで動作するとは限りません。 Speech API リファレンス また、以下の範囲の速度も指定可能です 0.25 および 4.0, である。 1.0 デフォルトとして。.
考慮すべき入力制限が2つあります。エンドポイントの基準範囲です。 入力 への 4,096文字, 、またMini TTSのモデルページには、最大値として 2,000個の入力トークン. 文字とトークンは異なる単位です。Mini TTS では、特に多言語テキストの場合、両方の制約を確認し、大きなスクリプトは送信前に分割してください。.
保存先のファイル形式を選択してください
| フォーマット | 実用例 |
|---|---|
| MP3 | デフォルトの出力形式。共有やWebでの再生に便利な圧縮ファイルです。. |
| 作品 | このコーデックに対応したストリーミングや通信アプリケーションで役立ちます。. |
| AAC | 再生環境やメディアのワークフローにおいて、AACが必要となる場合について検討してください。. |
| FLAC | オーディオ信号を保持する必要があるワークフロー向けのロスレス圧縮。. |
| WAV | 編集や処理に便利な、おなじみのコンテナ形式の非圧縮オーディオ。. |
| PCM | ファイルヘッダーのない、24 kHz、16ビット、符号付き、リトルエンディアンの生データサンプルです。お使いのプレーヤーでは、これらの設定が必要です。. |
ダウンロードリンクやシンプルなオーディオプレーヤー用には、まずはMP3を選択してください。次のステップで編集を行う場合は、WAVを選択してください。アプリケーションがPCM形式を正しく処理できる場合にのみ、raw PCMを選択してください。ファイル名を .pcm への .wav WAVヘッダーは作成されません。.
OpenAI Speech APIの利用料金はいくらですか?
2026年9月28日時点での確認によると、OpenAIにはGPT-4o Mini TTSが テキスト入力トークン100万個あたり$0.60 プラス オーディオ出力トークン100万個あたり$12. TTS-1の価格は $15/100万文字あたり, 、またTTS-1 HDの価格は 100万文字あたり $30. 各モデルをそれぞれの単位で計算する。.
Speech API の料金体系:単位を区別しておく
OpenAIは、最新のTTSモデルをトークン単位で、それより以前の2つのTTSモデルを文字単位で課金しています。GlobalGPTは、TTSタスクをクレジット単位で表示しています。.
| ルートとモデル | レート | 例 |
|---|---|---|
| OpenAI・GPT-4o ミニTTS | $0.60 / 1M テキスト入力トークン $12 / 1Mオーディオ出力トークン | 1,000個のテキスト入力トークン+5,000個の音声出力トークンに対して$0.0606 |
| OpenAI · TTS-1 | $15 / 1M文字 | 1,000文字につき$0.015 |
| OpenAI · TTS-1 HD | $30 / 1M文字 | 1,000文字につき$0.030 |
| GlobalGPT · Eleven v3、Eleven Multilingual v2、または Qwen Audio 3.0 TTS Flash | 330クレジット/1,000文字 | 記載の1,000文字あたりの単価で330クレジット分;ご依頼の前に見積もりをご依頼ください |
これらは価格の例であり、以下の音声サンプルに対する料金ではありません。トークン、文字数、分、クレジットはそれぞれ異なる単位です。GlobalGPTのタスク見積もりには、適用されるクレジット額が記載されていますが、この表ではクレジットをドルに換算していません。.
2026年9月28日時点の金利。出典: OpenAI APIの価格設定 そして GlobalGPT APIドキュメント.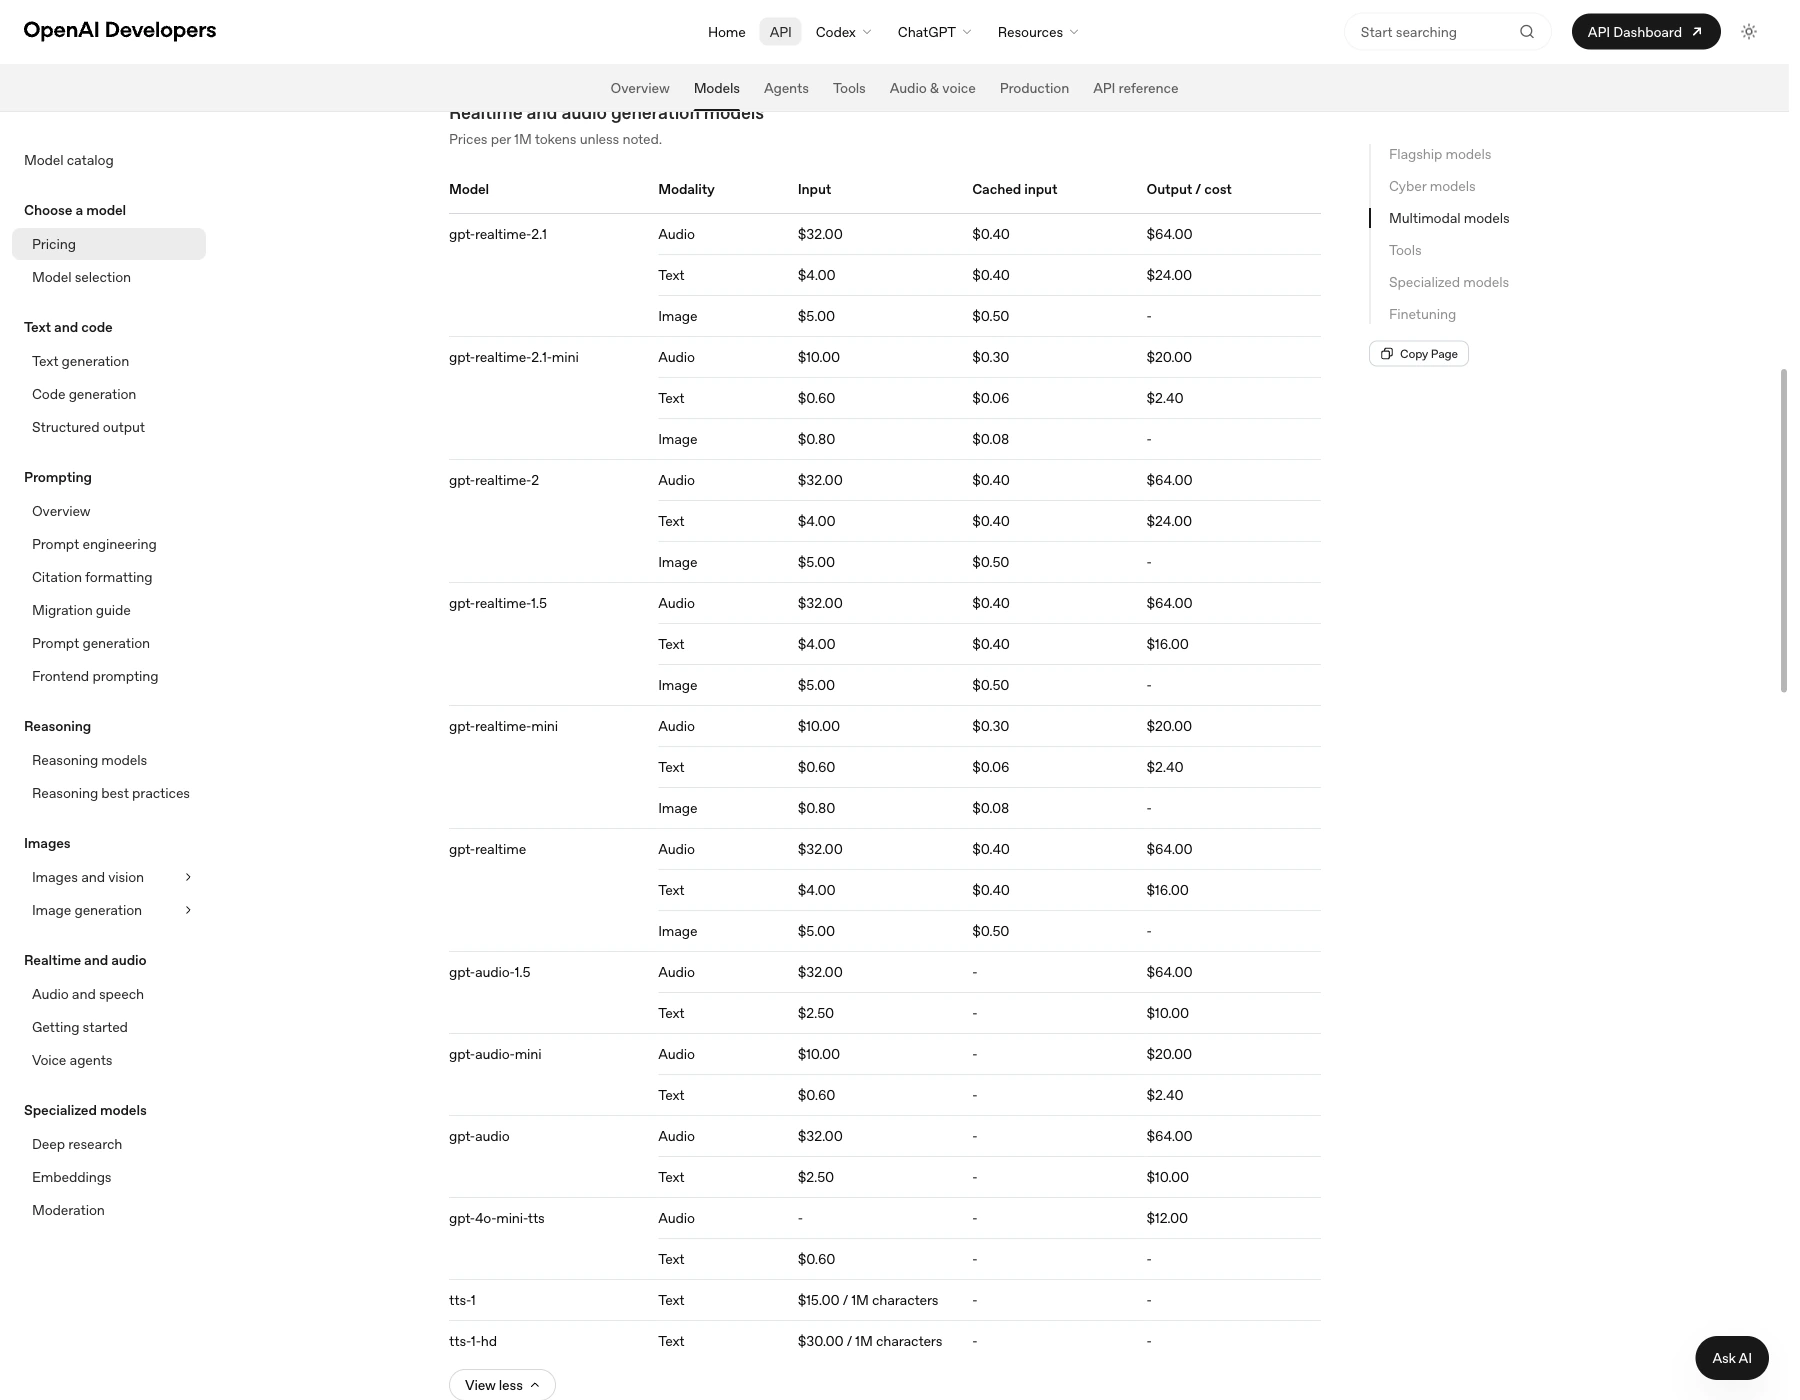
たとえば、1,000文字ずつからなるスクリプトが100本あれば、合計で100,000文字になります。記載されている料金に基づくと、それは $1.50(TTS-1付き) または $3.00(TTS-1 HD 搭載), 、その他のアプリケーション費用に先立って。この文字数だけでは、Mini TTSの料金を正確に計算するには不十分です。テキスト入力と音声出力のトークン数が必要です。.
音声生成コストを見積もる
選択したルートの課金単位を入力してください。文字からトークン、あるいは分からトークンへの自動変換は行われません。.
計算式:文字数 × $15 ÷ 1,000,000。テキストの合計文字数は、複数のAPIリクエストにまたがる場合があります。.
2026年9月28日時点の料金: オープンAI · グローバルGPT. ストレージ、ホスティング、税金、およびアプリケーションのその他の部分は対象外です。.
計画立案の際は、実際の使用回数または明確な仮定を計算ツールに入力してください。使用状況を測定するまでは、「Mini TTS」のオーディオトークン欄を予算の入力項目として扱ってください。分あたりの概算値を、すべての音声、話し方、言語について保証された価格として扱わないでください。.
GlobalGPTモデルカタログでは、TTSの価格がクレジット単位で表示されており、その見積もりエンドポイントを利用すると、送信しようとしているリクエストに対する見積もりが得られます。APIクレジットの使用については、日常的な文章作成やメディア作業用に利用するマルチモデルワークスペースのサブスクリプションとは区別して管理してください。これにより、2つの製品が1つの課金枠を共有していると仮定することなく、予算の管理が容易になります。.
GlobalGPT API を使用した TTS ワークフローの構築
スクリプトから音声、そして動画へとつながる再現性のあるワークフローを実現するには、, GlobalGPTでスピーチを作成する そして、プロジェクトの残りの部分は同じワークスペースに保管します。その GlobalGPT API メディア生成をタスクとして明らかにする一方で、 GlobalGPT CLI お使いのターミナルや開発ツールと連携する接続機能。.
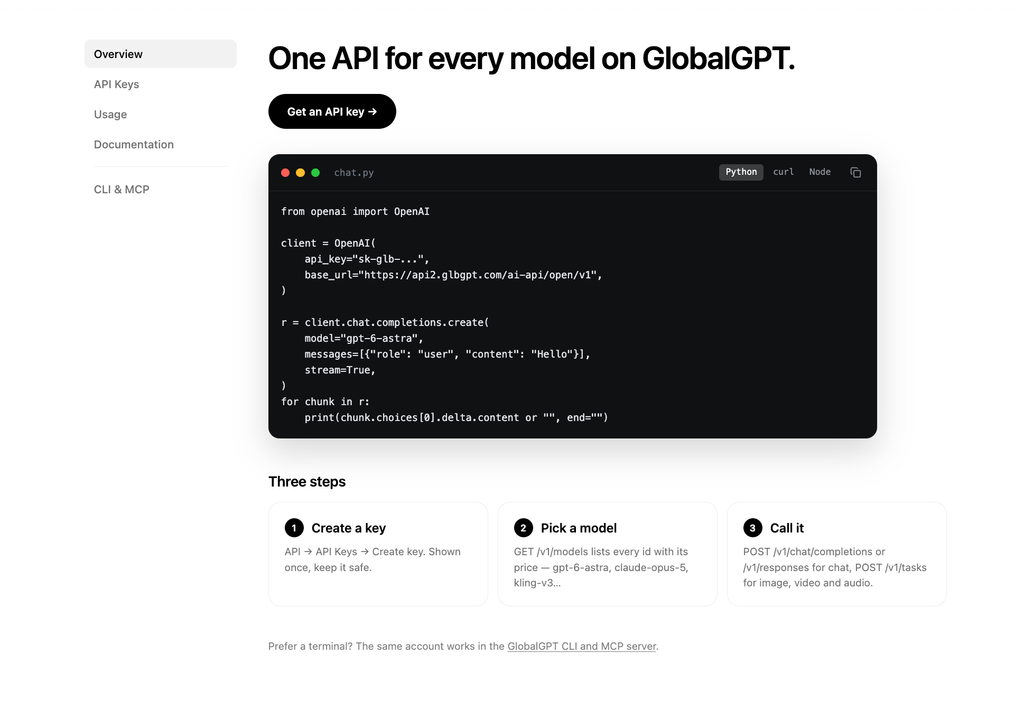
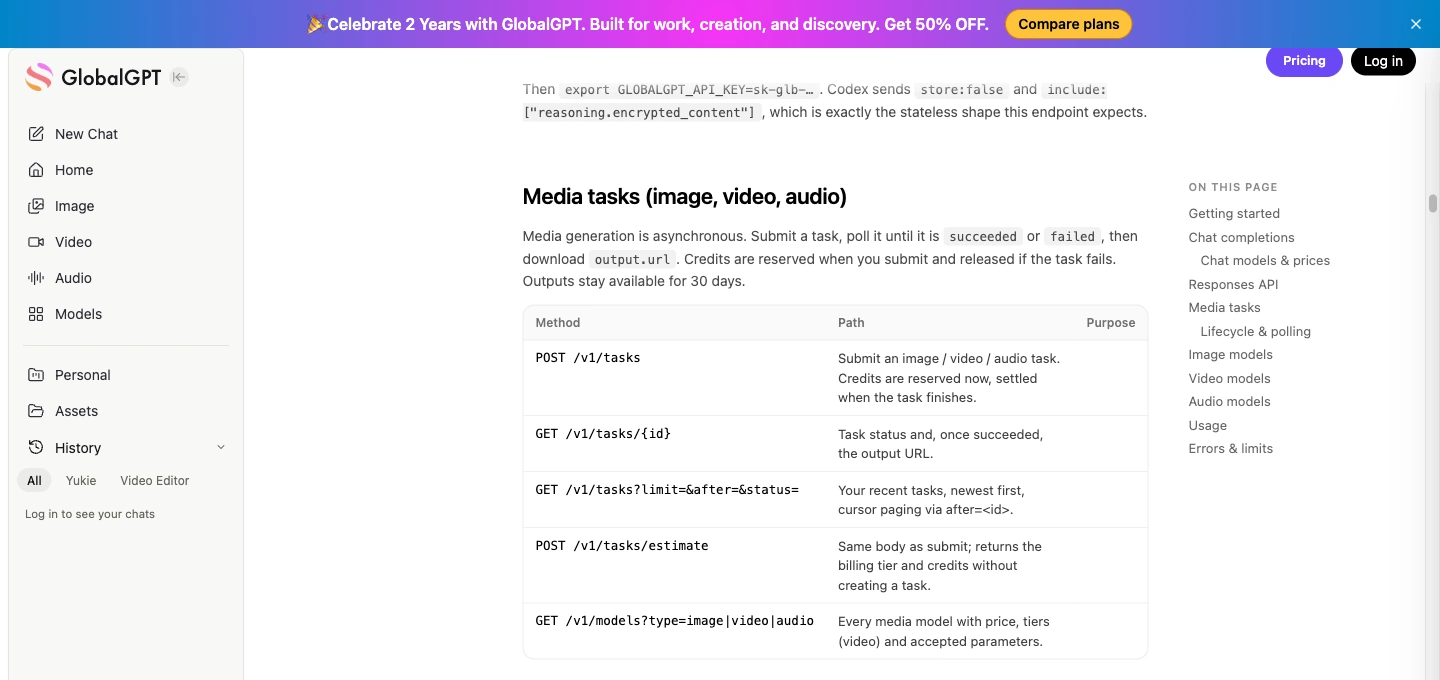
パブリックベースURLを使用する https://api2.glbgpt.com/ai-api/open/v1. TTSリクエストを以下の宛先に送信してください POST /tasks, クエリ GET /tasks/{id}, 、そしてダウンロード output.url タスクが成功した後。テキストフィールドは 迅速. このタスク契約を直接実装してください。これは、OpenAIの即時音声応答とは異なります。.
文書化されている GlobalGPT TTS モデルを1つ選んでください
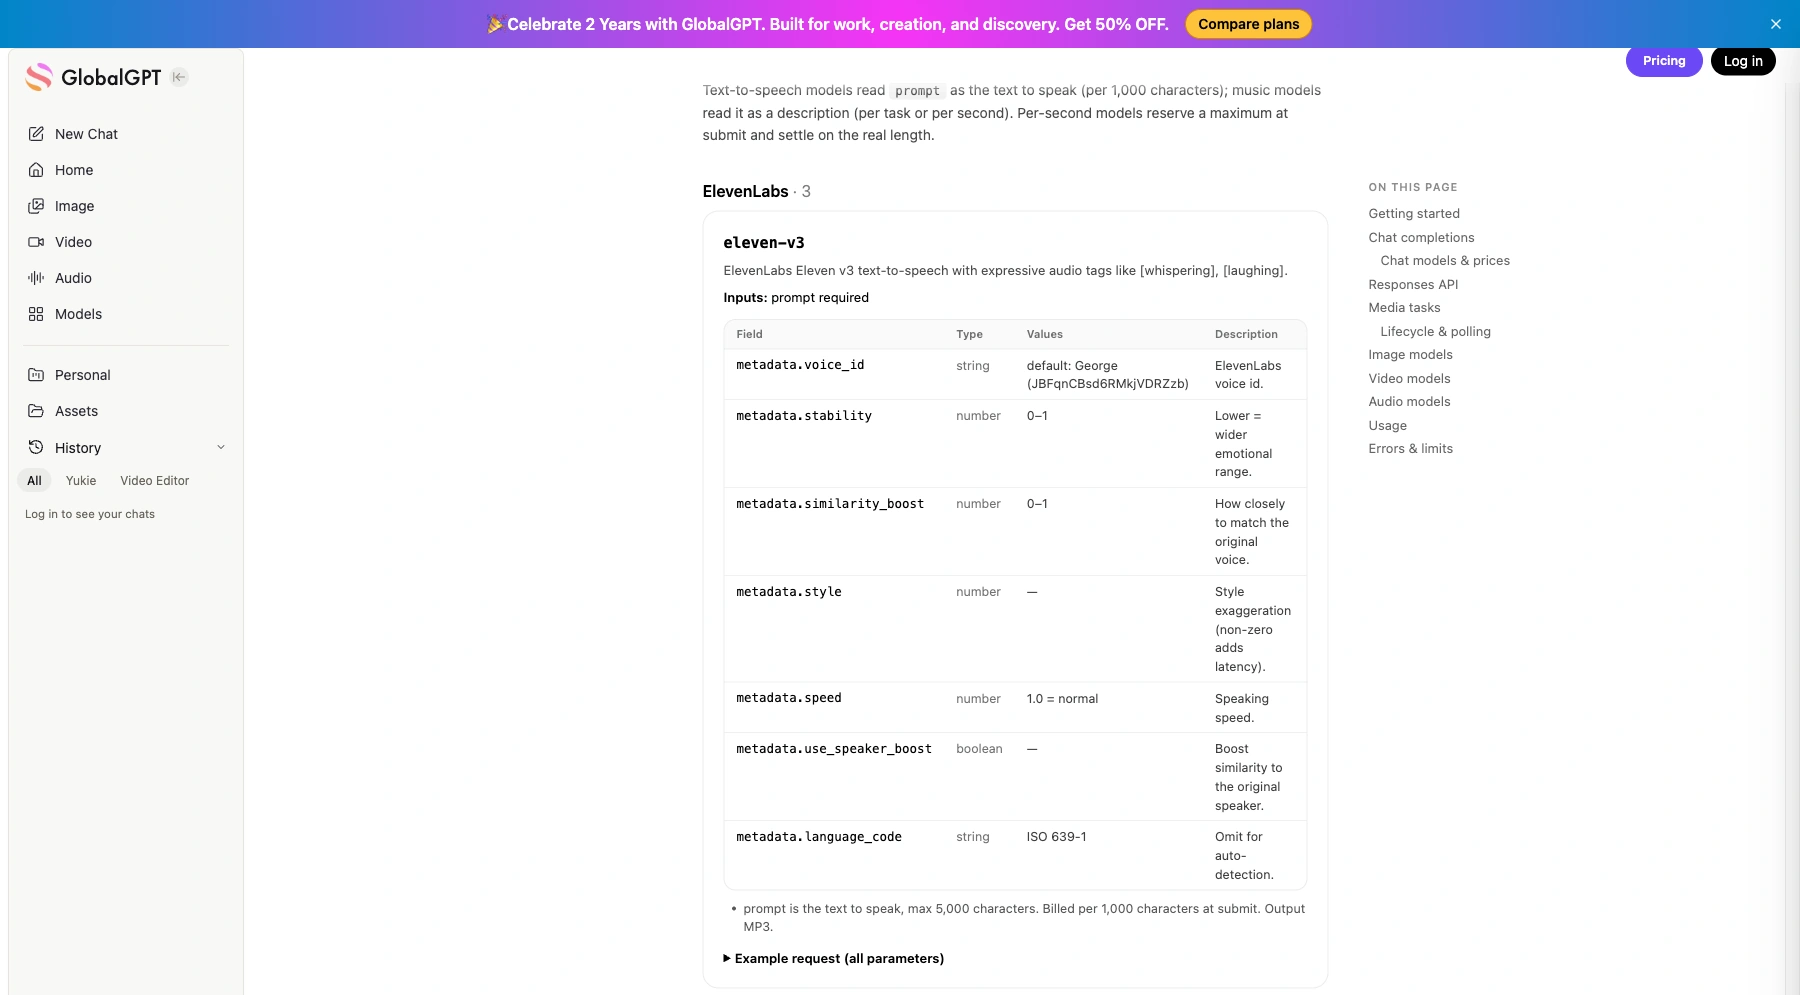
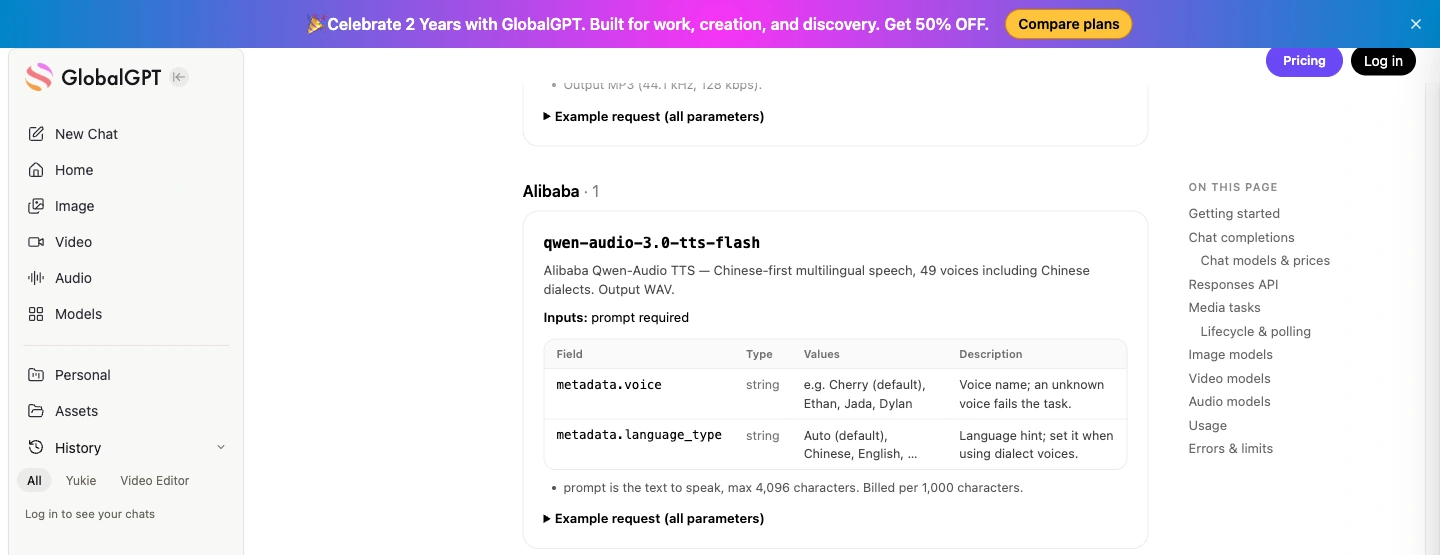
| モデルID | 入力と出力 | 有用な区別 |
|---|---|---|
eleven-v3 | 最大5,000文字;MP3 | 表現力豊かなオーディオタグに対応しています。. |
eleven-multilingual-v2 | 最大10,000文字;MP3 | 29言語;音声タグはテキストとして読み上げられます。. |
qwen-audio-3.0-tts-flash | 最大4,096文字;WAV | 49種類の音声。音声および言語の設定には、Qwen専用のフィールドが使用されます。. |
3件すべてのエントリー一覧 1,000文字につき330クレジット. .使用する POST /tasks/estimate 該当する見積もりに対する所定のリクエストボディを添付します。ドキュメントによると、これによりタスクは作成されず、クレジットも予約されません。パブリックAPIへのアクセスには有料クレジットが使用されます。.
より広範な作成ワークフローについては、以下を参照してください。 GlobalGPTにおけるテキスト読み上げワークフロー. 別の名称で知られるオープンソースの Qwen3-TTS ファミリーについて調査している場合は、以下をお読みください。 Qwen3-TTS モデルおよび API オプション; 上記の Qwen-Audio モデル ID を、Qwen3-TTS 展開と互換性があるものとして扱わないでください。.
見積もりを作成し、一度送信した後、保存されたタスクを照会する
インストール リクエスト と python -m pip install requests そして設定する GLOBALGPT_API_KEY サーバー上で。以下の例では、Eleven v3 を使用し、ドキュメントに記載されている公開ボイス ID を選択し、説明用の上限を 500 クレジットに設定しています。実行する前に、ご自身の予算に合わせてこの上限を変更してください。.
GlobalGPT パブリック TTS タスク API · Python
"""requests をインストールし、GLOBALGPT_API_KEY を設定してください。GlobalGPT のパブリックタスク API を使用します。"""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # ジョブごとの上限です。実行前に編集してください。

payload = {
    "model": "eleven-v3",
    "prompt": (
 "Acorn Studioの製品ツアーへようこそ。 3つのステップで、「
」短いスクリプトを音声ガイドに変えることができます。まず、メッセージを作成します。次に、「
」音声を選択します。最後に、音声ファイルを保存し、スマートフォンで再生テストを行います。」
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("このジョブは別の入力に属しています。新しい状態ファイル名を使用してください。")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("見積もりクレジット:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("見積もりがジョブごとの上限を超えています。")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # 永続化されたキーは、この特定のリクエストに紐付いたトランスポート再試行を保持します。
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("無視されたパラメータ:", task["ignored_parameters"])

print("タスク:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
    print("無視されたパラメータ:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("生成に失敗しました: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # 新しいリクエストを使用する:メディアホストにAPIキーを送信しない。
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("保存済み:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("タスクは未処理のままです。保存されたタスクIDをポーリングするために再実行してください。"))
ジョブファイルには、正確なリクエスト、イデポテンシーキー、およびタスクIDが保存されます。接続が切断された場合は、同じジョブを再実行することで、コードが既存のタスクを再開できるようになります。意図的に異なるオーディオを生成したい場合は、新しいジョブファイル名を使用してください。スクリプトに機密情報が含まれている場合は、ジョブファイルを非公開にしてください。.
チェック 無視されたパラメータ したがって、サポートされていない設定が、黙ってデフォルトの設定として採用されることはありません。ElevenLabs の制御項目など、 voice_id Qwenのものとは異なる 音声 そして 言語タイプ フィールド。5~10秒ごとにポーリングを行い、以下の処理を 失敗した ステータスを確認し、正常に保存されたファイルは速やかに保存してください。文書化されている結果の保存期間は 30日間.
2つの製品紹介の例を聞いてみましょう
これら2つのAI生成サンプルは、Eleven v3とQwen Audio 3.0 TTS Flashを用いて、同じ216文字の製品紹介スクリプトを使用しています。 それぞれは、デフォルトの音声設定で1回のリクエストから得られた最初の出力です。これらは、確認や試聴用の2つの短いファイルを提供するものであり、一致した音声の厳密な比較や、OpenAI音声のベンチマークではありません。.
Eleven v3:製品紹介の音声ガイド
eleven-v3 · 製品ツアーサンプル
- 出力
- MP3・モノラル・44.1 kHz
- 長さ
- 約15.6秒
- 世代
- 最初の出力 · 1件のリクエスト
設定: 以下の正確なテキスト、デフォルトの音声およびその他の設定。音声の上書きや読み上げ指示はありません。デフォルトの音声アイデンティティは録音されていませんでした。.
状況とスケジュール: 生成に成功しました。タスクのサーバータイムスタンプによると、送信から完了まで13秒かかっています。これは1回のリクエストであり、レイテンシのベンチマークではありません。.
ファイルの観察: このMP3ファイルには、44.1 kHzのモノラルストリームが含まれており、ファイルサイズは約251 kBです。ファイルの最後までフレームを読み取ることができます。.
費用の目安: 公開カタログの料金は、1,000文字あたり330クレジットです。新規のご依頼については、作業見積もりをご利用ください。この料金は、サンプルの請求額ではありません。.
実用例: 短い製品紹介を視聴するためのコンパクトなMP3ファイルです。リリースに使用する前に、対象デバイスで全文を確認し、再生テストを行ってください。.
正確な入力を確認してください · 216文字
Acorn Studioの製品ツアーへようこそ。3つのステップで、短い台本を音声ガイドに仕上げることができます。まず、メッセージを入力します。次に、声を選びます。最後に、音声ファイルを保存し、スマートフォンで再生テストを行います。.
Qwen Audio 3.0 TTS Flash:製品紹介の音声
qwen-audio-3.0-tts-flash · 製品紹介のサンプル
- 出力
- WAV・モノラル・24 kHz
- 長さ
- 15.52秒分のPCMデータ
- 世代
- 最初の出力 · 1件のリクエスト
設定: 以下の正確なテキスト、デフォルトの音声およびその他の設定。音声の上書きや読み上げ指示はありません。デフォルトの音声アイデンティティは録音されていませんでした。.
状況とスケジュール: 生成に成功しました。タスクのサーバータイムスタンプによると、送信から完了まで17秒かかっています。これは1回のリクエストであり、レイテンシのベンチマークではありません。.
ファイルの観察: このWAVファイルには、24 kHzのモノラル16ビットPCMデータが含まれており、サイズは約745 kBです。ヘッダーにはファイルに含まれるデータ量よりも多いデータが宣言されていますが、ここでは元の出力データをそのまま残しています。.
費用の目安: 公開カタログの料金は、1,000文字あたり330クレジットです。新規のご依頼については、作業見積もりをご利用ください。この料金は、サンプルの請求額ではありません。.
実用例: ナレーションのワークフローを評価するためのWAVサンプルです。制作パイプラインにおけるヘッダー長の一貫性の問題を解決し、配信前に再生が正常に行われるか確認してください。.
正確な入力を確認してください · 216文字
Acorn Studioの製品ツアーへようこそ。3つのステップで、短い台本を音声ガイドに仕上げることができます。まず、メッセージを入力します。次に、声を選びます。最後に、音声ファイルを保存し、スマートフォンで再生テストを行います。.
Qwenのサンプルは、同程度の再生時間においてElevenのサンプルの約3倍のサイズですが、これはWAVとMP3というフォーマットの違いによるものです。また、そのWAVヘッダーには、ファイルが実際に含むデータ量よりも多くのデータが宣言されています。 これは、対象のプレーヤーで確認すべきファイルパッケージング上の問題であり、それ自体では音声の品質について何ら決定的なことを示すものではありません。.
音声生成におけるよくある問題の解決
| 症状 | まず確認すべきこと |
|---|---|
| 保存したMP3が再生されません | HTTPステータスとレスポンスタイプを確認してください。APIエラーがオーディオ拡張子付きで保存されている可能性があります。. |
| このリクエストは、音声または指示を拒否します | 音声およびオプションのフィールドを、選択したモデルに合わせて設定してください。旧バージョンのOpenAI TTSモデルでは、指示を受け付けません。. |
| 長いスクリプトは却下される | ルートの文字数制限とMini TTSのトークン制限を確認し、自然な区切りで分割してください。. |
| 401または429のレスポンスが表示される | 401の場合、キー/アカウントを確認してください。429の場合、再試行する前に、レート制限とクォータ不足を区別してください。. |
| GlobalGPTのリクエストが未処理のままとなっています | 保存されたタスクIDを取得してステータスを確認してください。タイムアウトが発生したからといって、重複したジョブを送信する理由にはなりません。. |
| その声は、指定された設定と一致しません | 設定が適用されたと仮定する前に、モデル固有のメタデータと`ignored_parameters`を確認してください。. |
| 音声の再生時間やシークバーの表示がおかしいようです | ファイルのメタデータと実際のメディアペイロードを比較し、ターゲットプレイヤーでファイル全体をテストしてください。. |
OpenAIエラーについては、まずその エラーコードに関するガイダンス. GlobalGPTタスクについては、タスクIDと返されたエラーの詳細を保存してください。開発中は、転送エラー、課金エラー、および不適切な音声収録を区別して管理してください。それぞれに対処方法が異なるためです。.
ナレーションを出荷する前に、聴衆が使用する端末で録音全体を再生して確認してください。冒頭部分、名前や数字、セリフの切り替え、最後の文を確認してください。再生開始直前にAI音声である旨の告知を盛り込み、編集済みのスクリプトを意図通りに再生成できるよう、正確なテキストとモデル設定のコピーを保管しておいてください。.
よくある質問
OpenAI Audio Speech API エンドポイントとは何ですか?
https://api.openai.com/v1/audio/speech に POST リクエストを送信してください。必須のフィールドは model、input、voice です。レスポンスは生成された音声データで、デフォルトの形式は MP3 です。.
OpenAI Speech APIは無料ですか?
Speech API の料金体系は使用量に応じた課金制となっています。無料枠を前提とせず、現在の API 料金に基づいて予算を策定してください。GPT-4o Mini TTS はテキスト入力トークンと音声出力トークン単位で課金されますが、TTS-1 および TTS-1 HD は文字単位で課金されます。.
声や話し方を調整することはできますか?
お使いのモデルでサポートされている音声を選択してください。GPT-4o Mini TTSでは、「温かみのある口調」や「落ち着いた口調」といった発声に関する指示も受け付けます。なお、指示欄はTTS-1およびTTS-1 HDでは機能しません。.
Speech APIはストリーミングに対応していますか?
はい。生成された音声をチャンク単位でストリーミングすることは可能です。ただし、再生処理はアプリケーション側で行う必要があります。音声合成のストリーミングだけでは、完全なライブ音声会話を実現することはできません。.
OpenAIのベースURLを変更することで、GlobalGPTを使用することはできますか?
TTSについては、GlobalGPTのドキュメントに記載されているメディアタスクのワークフローを使用してください。具体的には、POST /tasks にリクエストを送信し、GET /tasks/{id} でステータスを確認し、成功後に output.url から出力をダウンロードします。ドキュメントに記載されている TTS カタログには、独自のモデル ID とパラメータを持つ ElevenLabs および Qwen モデルが含まれています。.
まずはどのオーディオ形式から始めればいいでしょうか?
まずは、簡単なダウンロードやWebプレーヤーで再生する場合はMP3から始めましょう。編集を行う場合は、WAVが便利です。Raw PCMはファイルヘッダーがないため、そのサンプリングレートとビット深度に対応したプレーヤーが必要です。.
まずは、短いスクリプト1つ、音声1つ、保存済みファイル1つから始めましょう。再生とコストが予測可能になったら、チャンキング、再試行、その他のメディアワークフローを追加していきます。実装にあたっては、選択したAPIのリクエスト形式、課金単位、出力処理をまとめて管理するようにしてください。.
次の脚本に命を吹き込みましょう
簡単な製品ツアーの草案を作成し、ElevenLabsまたはQwenでナレーションを作成した後、GlobalGPTのマルチモデルワークスペースで画像や動画の編集を続けます。.
GlobalGPT を使って音声を作成する








