まず、作りたい音から始めましょう。. 楽曲や構成の整ったインストゥルメンタルには「Pick Eleven Music v2」を、ナレーションや表現力豊かな音声には「Qwen Audio 3.0 TTS Flash」を、そしてセリフ、環境音、効果音を1つの完成されたシーンに融合させたい場合は「Seed Audio 1.0」をご利用ください。.
「最高の」オーディオモデルを1つだけ見つける必要はありません。BGMを作成するクリエイターには、ナレーションを録音するマーケターや、駅のシーンを制作する映像作家とは異なるものが必要です。私たちは、単なる機能一覧だけでなく、こうした実際の作業を実際にテストしました。以下では、最初の10件の出力結果をすべてお聴きいただけます。.
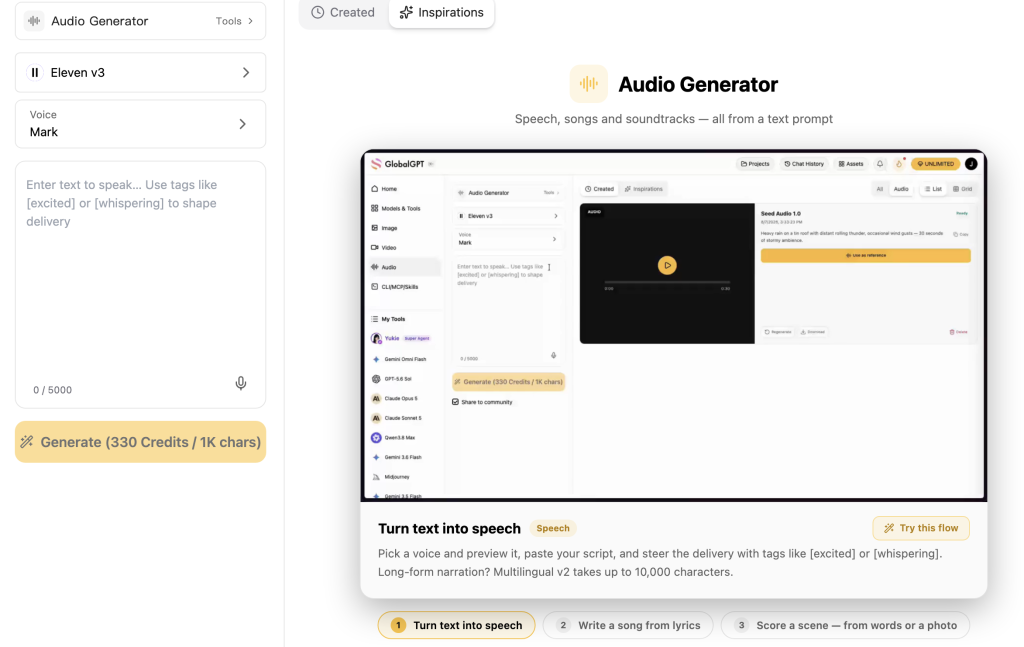
もし、自分のプロンプトで同じアイデアを試してみたい場合は、, グローバルGPT これら3つをすべて1か所で切り替えて利用できます。また、より幅広いマルチモデルワークスペースとしても機能します: 執筆やリサーチにはGPT-5.6 Sol、Claude Opus 4.8、Gemini 3.1 Proなどのモデルを使用し、プロジェクトで画像や動画が必要になった際には、GPT Image 2やSeedance 2.0に切り替えることができます。 つまり、別々のツールをいくつも組み合わせる必要なく、スクリプトの草案作成や音声の生成を行い、プロジェクトの残りの部分を継続して構築することができます。モデルへのアクセスはプランによって異なります。.
作りたいものから始めましょう
これらはあくまで参考であり、普遍的な順位付けではありません。.
手短な答え:どのモデルがどのオーディオタスクに適しているか?
判断する際の簡単な方法は、ブランドではなく、成果物に基づいて選ぶことです。最終的な成果物が音楽の場合は、Elevenが自然な出発点となります。Qwen TTS Flashはナレーションや表現力豊かな声に適しており、Seedはセリフ、環境音、効果音を組み合わせる必要があるシーンに適しています。 6つの実践的な課題を通じて、それぞれの選択肢が最も効果を発揮した場面を紹介しています。また、以下の10人のパフォーマーの音源を聴いていただければ、それぞれのトレードオフを実際にご確認いただけます。.
| モデル | 次のような場合は、ここから始めてください… | 私たちが試したこと | 以下の点にご留意ください |
|---|---|---|---|
| Eleven Music v2 | 曲か、構成の整ったインストゥルメンタルが必要です | 2つの音楽対決と、1つのボーカル曲の披露 | ナレーションには使用しませんでした |
| Qwen Audio 3.0 TTS Flash | ナレーションや表現力豊かな声が必要です | 2つの演説対決 | これらの結果は、テスト対象のFlashバージョンに適用されます |
| Seed Audio 1.0 | いくつかの種類の音が含まれた、完全なシーンが必要です | 音楽、台詞、そして駅の情景 | 柔軟な出力は、上流のすべての特徴を再現するわけではありません |
まず、これらは3種類の異なるオーディオモデルです
Eleven Music v2:音楽制作に特化したワークフロー
ElevenLabsは次のように説明しています イレブン・ミュージック ジャンル、スタイル、構成を制御できる「テキストから音楽」生成ツールです。ドキュメントには、ボーカルやインストゥルメンタルの出力、多言語生成、セクション単位または楽曲全体での編集機能についても記載されています。これらの機能により、本ツールはここで紹介する中で最も明確な音楽専用ワークフローを提供していますが、Qwenと同じ種類のTTS(テキスト読み上げ)手法であるという意味ではありません。.

Qwen Audio 3.0 TTS Flash:本テストで検証した音声出力経路
Qwen Audio 3.0 TTS Flash—「Anywhere」の正確なルートは qwen-audio-3.0-tts-flash—これは、B1およびB2で使用される音声経路です。. Alibaba Cloudの音声合成に関するドキュメント そのカスタム音声のコンテキストに、その正確なFlash名を記載しています。この記事では、他のQwen行やバリアントからの再生時間、フォーマット、または組み込み音声に関する主張は引き継がれません。.

Seed Audio 1.0:オーディオ制作ワークフローのさらなる拡充
バイトダンスの役職 Seed Audio 1.0 音声、効果音、環境音、そして統一されたオーケストレーションにわたるシーン全体の生成に活用されます。そのため、1つの出力で複数の音種を調整する必要がある場合、これが当然の選択肢となります。掲載された概要画像からは音楽的な要素が明確に読み取れないため、本記事における音楽に関する考察は、その画像ではなく、当社による実機テストに基づいています。.

別の BytePlus API ページ 特定する seed-audio-1.0 参照用オーディオまたは画像入力、タイミング制御、最大120秒の出力を備えた、ストリーミング非対応のルートとして。これらはルートの事実であり、より広範なモデルポジショニングに関する記述とは区別されています。.

3つのオーディオワークフローのテスト方法
生成前にプロンプトを固定し、10件のタスクを順次送信し、各タスクから得られた最初の有効な出力を保存しました。10件のリクエストすべてが再試行ゼロで成功しました。準備中のクリップは除外されており、以下のテスト音声は、最初の有効なメディアの未加工データです。.
- 公式な証拠: 自社製品またはAPIのドキュメント。.
- 観測された航路の証拠: このセッションにおけるフォーマット、所要時間、費用、復号、および信号チェック。.
- 聴解問題: あるユーザーによるA1、A2、B1、B2に対するブラインドのペアワイズ選好、およびC1とC3に対する意味的評価。.
- 制限: 安定性検証は実行されなかった。B1およびB2は、自動的に転記されたり、一語一語確認されたりすることはなかった。.
10回の出力における観測された合計料金は$0.4819752667でした。この数値は本セッションに関するものであり、公式の価格保証ではありません。.
音楽テスト:Eleven Music v2 対 Seed Audio 1.0
A1: ドキュメンタリーのBGM
A1: ドキュメンタリーのBGM
穏やかに盛り上がりを増し、決着のついた結末を迎える、30秒間のインストゥルメンタル・トラベルドキュメンタリー用BGM。.
凍結されたプロンプトを正確に表示する
短編の旅行ドキュメンタリー用に、30秒間のインストゥルメンタル・アンダースコアを作成してください。冒頭は、ソフトなフィンガーピッキングのアコースティックギターと温かみのあるピアノから始まり、最初の3分の1が過ぎたあたりから軽やかなハンドパーカッションを加え、徐々に盛り上がりを増し、すっきりとした解決形のリズムで締めくくってください。希望に満ち、物思いにふけるような雰囲気にしてください。ボーカル、ナレーション、効果音は一切含まないこと。.
| モデル | 正確なルート | ステータス | 実際の所要時間 | フォーマット | 実測コスト |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 最初の有効日 | 30.041秒 | MP3、44.1 kHz ステレオ | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | 最初の有効日 | 30,000s | PCM WAV、40 kHz ステレオ | $0.0700000 |
- 客観的なチェック
- どちらのファイルも正しくデコードされ、クリッピングに近い現象は見られず、クリアなフェードアウトで終了した。楽器のコンプライアンスに関する詳細な記録は残されていない。.
- リスナーの判断
- リスナーは「Eleven Music v2」を好んだ。その理由は、軽快なパートから重厚なパートへの展開がより自然で、楽器同士の連携もより調和が取れていたからである。.
- タスクの結果
- この最初の出力タスクには、Elevenが推奨されます。.
- 制限事項
- モデルごとに有効な出力が1つずつ。安定性解析は実行されませんでした。.
A1リスニング試験
A1の最初の出力音源を聴いてみてください
どちらかのカードを使って、2つのモデルを直接比較してください。.
Eleven Music v2
eleven-music-v22026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
Seed Audio 1.0
seed-audio-1.02026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
A1については、リスナーは、軽快な部分から重厚な部分への自然な流れと、より調和のとれた楽器の連携が図られているという点から、Elevenの最初の音源を選びました。.
A2: 構造化商品の発売合図
A2: 体系化された製品発売の合図
30秒間のインストゥルメンタル・キューで、3つのパートから構成され、時間制限が設けられている。ミニマルなビートから始まり、ドラムが加わりエネルギーが高まり、最後は明るく盛り上がる。.
凍結されたプロンプトを正確に表示する
30秒間のインストゥルメンタルな製品発表用キューを、3つの明確なセクションに分けて作成してください。0~8秒目はミニマルなシンセのパルス、8~22秒目はキレのある電子ドラムと高まるハーモニックなエネルギーを加え、22~30秒目は明るいフィナーレとすっきりとしたエンディングで締めくくってください。 モダンで自信に満ちた雰囲気でありながら、攻撃的ではないものにしてください。ボーカル、ナレーション、環境音は一切含まないこと。.
| モデル | 正確なルート | ステータス | 実際の所要時間 | フォーマット | 実測コスト |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 最初の有効日 | 30.041秒 | MP3、44.1 kHz ステレオ | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | 最初の有効日 | 27.704秒 | PCM WAV、40 kHz ステレオ | $0.0646436 |
- 客観的なチェック
- どちらのファイルも、クリッピングに近い現象は発生することなく正しくデコードされました。30秒のリクエストに対して、シード時間は27.704秒でした。これは経路の特性によるものであり、品質の低下によるものではありません。.
- リスナーの判断
- リスナーは、イントロがより明瞭で、音楽の重なりがより豊かであることから、Seed Audio 1.0を好んだ。一方、Elevenのオープニングは聞き取りにくかった。.
- タスクの結果
- この最初の出力タスクには「Seed」が推奨される。2つの音楽テストは分かれた。.
- 制限事項
- 各セクションの正確なタイミングについては徹底的な検証が行われておらず、安定性試験も実施されていない。.
A2リスニング試験
A2の初期出力音源を聴いてみてください
どちらかのカードを使って、2つのモデルを直接比較してください。.
Eleven Music v2
eleven-music-v22026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
Seed Audio 1.0
seed-audio-1.02026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
A2については、Seedの最初の出力結果がリスナーの支持を集めました。その理由は、イントロがより明瞭で、音の重なりがより豊かに感じられたためです。Seedでは、30秒のリクエストに対して27.704秒という結果が出ました。この差異については、品質上の問題としてではなく、別途記録しています。音楽に関するタスクでは、各モデルが1つずつ支持を集めたため、音楽カテゴリーにおける勝者は存在しません。.
音声テスト:Qwen TTS Flash 対 Seed Audio 1.0
B1:中立的なドキュメンタリーのナレーション
B1:中立的なドキュメンタリーのナレーション
穏やかで中立的な語り口、適度なペース、そして自然な間を交えた、同じ英語の港のナレーション。.
凍結されたプロンプトを正確に表示する
毎朝、港は街よりも早く目を覚ます。フェリーが水面を横切り、店の明かりが灯り、最初の通勤客が桟橋に足を踏み入れる。7時になる頃には、静かだった海岸線は一日の中心となっている。穏やかなドキュメンタリー風のナレーションを、明瞭で中立的な英語で。 適度なテンポで、自然な間を挟んでください。音楽、環境音、効果音は一切使用しないでください。.
| モデル | 正確なルート | ステータス | 実際の所要時間 | フォーマット | 実測コスト |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | 最初の有効日 | 27.507秒 | MP3、22.05 kHz モノラル | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | 最初の有効日 | 18.780秒 | PCM WAV、40 kHz ステレオ(左右チャンネル同一) | $0.0438200 |
- 客観的なチェック
- どちらのファイルも正しくデコードされ、音声のような活動や間が含まれていました。ユーザーからは、テキストに関する明らかな問題は報告されませんでした。.
- リスナーの判断
- リスナーは、Qwenの方がより自然でドキュメンタリーのような雰囲気があるとして好んだ。一方、Seedは、試験前の注意喚起のように堅苦しく感じられた。.
- タスクの結果
- この最初の出力タスクには、Qwenが推奨されます。.
- 制限事項
- 逐語的な正確性は確認されていません。安定性テストは実施されていません。.
B1リスニング試験
B1の最初の出力音源を聴いてみてください
どちらかのカードを使って、2つのモデルを直接比較してください。.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flash2026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
Seed Audio 1.0
seed-audio-1.02026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
Qwenの最初の出力音はより自然で、ドキュメンタリーのような印象でしたが、Seedの音は聴き手には硬く感じられました。ワークフローにおいて文字起こしの確認が中心となる場合は、こちらの別ガイドで詳しく説明しています。 ChatGPTがどのように音声を文字起こしできるか. B1の文章を逐語的に確認するために文字起こしは行いませんでした。.
B2:感情の展開
B2:感情の展開
ある女性の声が、緊張したささやきから、淡々とした語り口を経て、安堵に満ちた興奮へと移り変わっていく。.
凍結されたプロンプトを正確に表示する
“「やったわ」とマヤはささやいた。すると、明かりが戻った。「よし、これで祝えるわ!」 大人の女性の声で、一貫したトーンで演じてください。最初の文は静かに、緊張感を持って、中間の文は中立的な語り口で、最後の文は安堵と興奮を込めて話してください。感情の変化は明確に表現しつつも、大げさにならないようにしてください。音楽や効果音は使用しないでください。.
| モデル | 正確なルート | ステータス | 実際の所要時間 | フォーマット | 実測コスト |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | 最初の有効日 | 25.913秒 | MP3、22.05 kHz モノラル | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | 最初の有効日 | 9.180秒 | PCM WAV、40 kHz ステレオ(左右チャンネル同一) | $0.0214200 |
- 客観的なチェック
- 両方のファイルは正しくデコードされ、複数の音声領域が確認されました。再生時間の差異は品質評価の対象とはなりませんでした。.
- リスナーの判断
- リスナーは、より力強いささやきのような質感と、より説得力のある物語の雰囲気を求めて、Qwenを好んだ。.
- タスクの結果
- この最初の出力タスクには、Qwenが推奨されます。.
- 制限事項
- 逐語的な正確性は確認されていません。安定性テストは実施されていません。.
B2リスニング試験
B2の最初の出力音源を聴いてみてください
どちらかのカードを使って、2つのモデルを直接比較してください。.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flash2026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
Seed Audio 1.0
seed-audio-1.02026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
Qwenの最初の出力は、より強い「ささやき」のような特徴を持ち、物語性を強く感じさせるものでした。ユーザーはB1やB2において明らかなテキスト上の問題を感じませんでしたが、単語の正確性については依然として確認されていません。.
単一モデルのワークフロー事例
C1: Eleven Music v2 構成されたボーカル曲
C1:構成の整ったボーカル曲
楽器編成と構成が固定されており、歌詞に2行の必須フレーズが含まれる30秒のインディー・ポップ曲。.
凍結されたプロンプトを正確に表示する
女性ボーカル1人をフィーチャーし、明るいギター、ベース、手拍子を盛り込んだ、30秒のアップテンポなインディー・ポップ曲を作成してください。構成は、4秒間のインストルメンタル・イントロ、短いヴァース、コーラス、そしてすっきりとしたエンディングとします。 以下の歌詞のフレーズをそれぞれ1回ずつ使用してください:ヴァース:「Morning on the window, plans are taking flight.」 コーラス:「Start where you are, and make the moment bright.」 ナレーションや効果音は使用しないでください。.
| モデル | 正確なルート | ステータス | 実際の所要時間 | フォーマット | 実測コスト |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 最初の有効日 | 30.041秒 | MP3、44.1 kHz ステレオ | $0.0750000 |
- 客観的なチェック
- MP3は正しくデコードされました。ごくわずかな孤立したフルスケールのサンプルが検出されましたが、広範囲にわたるクリッピングは見られませんでした。.
- リスナーの判断
- リスナーは「部分的に満たされている」と判断した。声は多少不自然に聞こえ、電気ノイズのような響きがあったからだ。.
- タスクの結果
- この最初の成果物については、一部要件を満たしています。.
- 制限事項
- この観察結果は、この最初の出力にのみ当てはまります。安定性解析は実行されていません。.
C1リスニング試験
C1の最初の出力を聞いてみてください
この単一モデルのショーケースから、最初の有効な出力を再生してください。.
Eleven Music v2
eleven-music-v22026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
C1は契約を部分的に履行しました。リスナーは、その声がやや不自然であると感じ、電気ノイズのような音質が聞こえたと指摘しました。これは特定のサンプルに関する所見であり、一般的な欠陥の申し立てではありません。.
C3: Seed Audio 1.0 鉄道駅のシーン(完全版)
C3:鉄道駅のシーンを完成させる
雰囲気音、走行中の列車、チャイム、そして正確な車内アナウンスを組み合わせた、20秒間の沿線駅シーン。.
凍結されたプロンプトを正確に表示する
夜明けの海岸沿いの鉄道駅の情景を、20秒間の完全なシーンとして作成してください。最初は、穏やかな海風と遠くで鳴くカモメの鳴き声から始まります。列車が左側から近づいてきて、ホームでブレーキをかけます。 落ち着いた口調の女性駅員が、次のように正確にアナウンスします。「7時15分発の沿岸線列車が、2番ホームに到着しました。」アナウンスの前に、短く柔らかなチャイム音を挿入し、その後、列車の音と環境音を自然にフェードアウトさせてください。アナウンスは明瞭に、シーン全体の空間的な整合性を保ってください。.
| モデル | 正確なルート | ステータス | 実際の所要時間 | フォーマット | 実測コスト |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | 最初の有効日 | 20,000年代 | PCM WAV、40 kHz ステレオ | $0.0466667 |
- 客観的なチェック
- WAVファイルは正しくデコードされ、クリッピングに近い状態は見られず、技術的な観点からは、要求されたマルチパートのシーン構造が正しく含まれていました。.
- リスナーの判断
- リスナーは、列車のブレーキ音や停車音がやや不自然に聞こえたため、この基準を「部分的に満たしている」と判断した。.
- タスクの結果
- この最初の成果物については、一部要件を満たしています。.
- 制限事項
- その発表の正確な内容は独自に書き起こされておらず、安定性テストも実施されていない。.
C3リスニングテスト
C3の最初の出力を聞いてみてください
この単一モデルのショーケースから、最初の有効な出力を再生してください。.
Seed Audio 1.0
seed-audio-1.02026年8月6日に、検証済みのAnywhereルートを通じて生成されました。有効な出力が1つ得られました。安定性検証は実行されていません。.
C3も契約内容を部分的に満たしていました。リスナーからは、列車のブレーキ音や停車音がやや不自然だと指摘されました。生成された音声を映像と組み合わせる動画制作者にとっても、これは セリフ、音声、リップシンクに関するガイド 役に立つが、ここではリップシンクはテストされていない。.
コスト、出力長、および経路の挙動
観測された電荷と実際の出力持続時間
2026年8月6日、Anywhereを通じてタスクごとに1つの最初の有効な出力が得られます。料金はセッションごとの観察結果に基づくものであり、公式の料金表ではありません。2つのミニバーはそれぞれ別々の視覚的尺度を使用しており、二重軸や統合スコアは使用されていません。.
観測されたコストは、Qwen B1の$0.00513から、各Eleven出力の$0.075までの範囲にあります。 実際の所要時間は、Seed B2の9.180秒から、Elevenの音楽出力における30.041秒の範囲です。これらは測定されたセッション結果であり、定価や品質スコアではありません。.
なぜGlobalGPTでこれらのオーディオモデルを試してみるべきなのでしょうか?
音楽生成、表現力豊かなTTS、そして完成度の高いサウンドスケープはそれぞれ異なる作業であるため、この分野において「これ一つで万能」と言えるモデルは存在しません。 GlobalGPTはこの区別を実用的なものにします。トラック制作にはEleven Musicから始め、ナレーションにはQwen Audioに切り替え、構成されたシーンにはSeed Audioを使用するなど、オーディオワークフローごとに個別のプラットフォームを維持する必要がありません。.
GlobalGPTはオーディオ専用のツールではなく、マルチモデル対応のワークスペースであるため、作業はオーディオファイルの作成で終わる必要はありません。このプラットフォーム上の他のAIモデルを活用して、脚本の草案作成や推敲、トピックの調査、補助画像の作成、さらには完成した音声に合わせた動画素材の制作を行うことも可能です。.
2026年8月10日、 GlobalGPTの価格ページ 「BASIC」プランでは$5.8、「PRO」プランでは$10.8、「UNLIMITED」プランでは$25.0という月換算値が表示され、「年単位での選択」および「年単位での請求」が設定されています。 これらは当ページの年間請求額です。プランによって利用可能なモデルは異なります。.

どのモデルを選べばいいでしょうか?
6タスクの初回出力結果行列
| ワークフロー | テスト対象モデル | 結果 | 観察された理由 | 証拠の種類 | 制限 |
|---|---|---|---|---|---|
| A1・音楽 | イレブン 対 シード | 11が好ましい | より自然な展開と調和のとれた楽器編成 | 視覚障害者のリスナーの好み | それぞれ1つずつ最初の出力 |
| A2・音楽 | イレブン 対 シード | 種子優先 | より明快なイントロと、より豊かな音層 | 視覚障害者のリスナーの好み | Seedは27.704秒を返した |
| B1・スピーチ | Qwen 対 シード | Qwenが望ましい | より自然なドキュメンタリー調の語り口 | 視覚障害者のリスナーの好み | 文章は一語一語確認されていません |
| B2・スピーチ | Qwen 対 シード | Qwenが望ましい | より力強いささやきと物語性 | 視覚障害者のリスナーの好み | 文章は一語一語確認されていません |
| C1・ボーカル曲 | 11のみ | 一部満たされた | 電気ノイズのような不自然な音声が聞こえた | ユーザーによる意味的レビュー | サンプル固有の観察 |
| C3 · サウンドスケープ | 種のみ | 一部満たされた | 列車のブレーキ音や停止音が不自然に聞こえた | ユーザーによる意味的レビュー | お知らせの内容は転記されていません |
どの行も総合スコアや総合優勝者には換算されません。.
- Choose Eleven Music v2 その仕事が基本的に音楽に関わるものである場合:構成の整ったインストゥルメンタル曲、楽曲、あるいはセクション単位の音楽編集など。.
- 「Qwen Audio 3.0 TTS Flash」を選択してください ナレーションや、表現力を抑えた話し方が求められる仕事の場合。.
- 「Seed Audio 1.0」を選択してください 出力音が、環境音、効果音、セリフを組み合わせた完全なシーンのように振る舞う必要がある場合。.
これらの推奨事項は、ワークフローとの適合性に加え、最初の出力に関する6つの評価をまとめたものです。これらは、唯一の総合的な最優秀候補を決定するものではありません。.
この比較における限界
- モデルおよびタスクごとに、最初の有効な出力を1つずつ出力します。安定性による繰り返し出力はありません。.
- B1とB2は、一語一語書き写したり確認したりはしていません。.
- 聴取による判断は主観的であり、サンプルごとに異なる。.
- 「Anywhere」ルートは、アップストリーム製品のすべてではありません。.
- これらの3つのルートを、1つの手法で網羅している公正な独立系ランキングは存在しません。.
- ファイル形式、サンプリングレート、チャンネル数、ファイルサイズ、および再生時の音量は、品質の評価対象とはなりませんでした。.
よくある質問
01Eleven Music v2、Qwen Audio 3.0、Seed Audio 1.0 は、同じ種類のモデルですか?
No. Eleven Music v2は音楽専用のワークフローであり、Qwen Audio 3.0 TTS Flashは今回テストした音声生成モデル、Seed Audio 1.0はシーン全体の音声生成を目的としたものです。したがって、この比較では、画一的な総合ランキングを提示するのではなく、タスクごとに推奨するモデルを紹介しています。.
02AIによる音楽生成用に設計されているのはどのモデルですか?
Eleven Music v2は、今回の比較において、音楽制作に特化したソフトとしては最も優れた選択肢です。公式ドキュメントによると、ジャンル、スタイル、構成、ボーカルまたはインストゥルメンタルの出力、多言語対応、セクション単位または楽曲全体の編集機能などが備わっています。.
03ナレーションや表現力豊かな話し方に適しているのは、どのテスト済みルートでしょうか?
Qwen Audio 3.0 TTS Flash(ここでは「qwen-audio-3.0-tts-flash」という正確なAnywhereルートで特定されている)は、ナレーションおよび表現力豊かな発話のテストにおいて最も適していた。リスナーはB1とB2の両方でこのモデルの最初の出力を好んだが、安定性や単語の正確性についてはテストされていない。.
04音声とエフェクトを組み合わせて、完成度の高いサウンドスケープを作り出せるモデルはどれですか?
Seed Audio 1.0は、構成されたサウンドスケープに最適なワークフローです。公式の位置づけとしては、ナレーション、効果音、環境音、そして統合されたオーケストレーションを網羅していますが、C3テストでは、駅アナウンス、列車の走行音、チャイム音、そして海岸の環境音を1つの出力にまとめました。.
05これら3つすべてをGlobalGPTを通じて使用することはできますか?
はい。GlobalGPTのオーディオワークスペースでは、音楽には「Eleven Music」、完全なオーディオシーンには「Seed Audio 1.0」、音声には「Qwen Audio 3.0」をお試しいただけます。また、GlobalGPTでは、執筆、リサーチ、画像、動画のワークフローも、同じマルチモデルプラットフォームに統合されています。 モデルの利用可否はプランによって異なります。.
06この比較によって、総合的な勝者が決まるのでしょうか?
いいえ。各モデルは異なるワークフローに対応しており、実証データには、安定性を確認するための反復実行を行わずに、モデルおよびタスクごとに最初の有効な出力が1つずつ含まれています。有用な結論は条件付きです。専用音楽モデルには「Eleven」、音声には「Qwen TTS Flash」、完全なオーディオシーンには「Seed」が適しています。.
自分なりのオーディオワークフローを試してみましょう
ご自身の音楽の企画書、ナレーションの台本、またはサウンドスケープのテーマを、 GlobalGPT オーディオジェネレータ そして、その結果を、実際に仕上げなければならない仕事の内容と照らし合わせてみてください。単にモデルの名前だけで選ぶのではなく、楽曲の構成、歌唱の表現力、シーンの一貫性、そして指示への順守度などに注目してください。.
音声の方向性が決まったら、GlobalGPTの他のAIモデルを活用して、脚本作成、リサーチ、補助画像、動画のコンセプト策定など、プロジェクトを継続することができます。これにより、テストは単なる音声デモにとどまらず、実用的なコンテンツ制作ワークフローへと変わります。安定性を確認する必要がある場合にのみ、出力を繰り返し生成してください。.