

「DeepSeek V4.1 Flash」は、2026年9月10日にリリースされたDeepSeekのバージョンであり、ネイティブ画像入力の追加、キャッシュ使用量の削減、ベンダー報告によるエージェントスコアの向上、およびAPI呼び出し頻度の低減といった機能が盛り込まれています。. これは、処理量が多い、あるいは入力量の多いエージェントを運用している開発者に最適です。主な注意点として、DeepSeekは公開されているベンチマークを実行しましたが、V4 Proは依然として、選定されたフロンティア推論テストにおいてトップの成績を収めています。.

DeepSeek V4.1 フラッシュとは何ですか?
DeepSeek V4.1 Flashは、コーディング、ツールの使用、視覚的理解、および長文コンテキストを扱うエージェントのワークフロー向けに構築された、マルチモーダルでオープンウェイトのモデルです。DeepSeekは2026年9月10日にこのモデルをリリースし、重みデータを以下のように公開しています。 DeepSeek-V4.1-Flash, そして、ホストされたモデルを deepseek-flash API名。.
今回のリリースが重要なのは、ベンチマークスコア以上の変化をもたらすからです。Flashはテキストや画像の受け入れが可能になり、100万トークンのコンテキストウィンドウを提供し、キーバリューキャッシュに必要なメモリを大幅に削減しています。また、DeepSeekでは、旧V4 Pro料金プランと比較して、ホスト型APIの料金が引き下げられました。 こうした組み合わせは、プロンプト、リポジトリのコンテキスト、スクリーンショット、ツールの履歴が蓄積していく中で、長時間実行されるエージェントのコストを抑えるという、実用上のボトルネックの解消を目指しています。.
deepseek-flashデフォルトでは「思考モード」が有効になっていますが、「非思考モード」も利用可能です。JSON出力およびツール呼び出しがサポートされています。また、DeepSeekはResponses APIおよびAnthropic APIとの互換性を備えており、これらのインターフェースを基盤として構築されたアプリケーションの移行作業を軽減します。.
DeepSeek V4.1 フラッシュの新機能とは?
非対称な演算能力を備えた552B MoEバックボーン
によると DeepSeek V4.1 技術報告書, 、このモデルは、20層の因果エンコーダーと20層のデコーダーを備えた、5,520億パラメータの「ミクスチャー・オブ・エキスパート」バックボーンを採用しています。 パラメータの総数は、すべてのトークンに対して使用される量とは限りません。DeepSeekでは、プレフィル中に約80億個、デコーディング中に約160億個のアクティブパラメータが報告されています。.
この非対称な設計により、プリフィルと生成の各段階に異なる演算リソースが割り当てられます。プリフィルとは、プロンプト、ドキュメント、画像、および過去の会話を取り込む段階であり、デコーディングではトークン単位で回答を生成します。プリフィル段階でのアクティブな演算負荷が低いことは、書き込みの前に読み込みに多大なリソースを費やすリポジトリ規模のワークロードや研究用エージェントのワークロードにおいて、特に重要です。.
はるかに容量の小さいKVキャッシュ
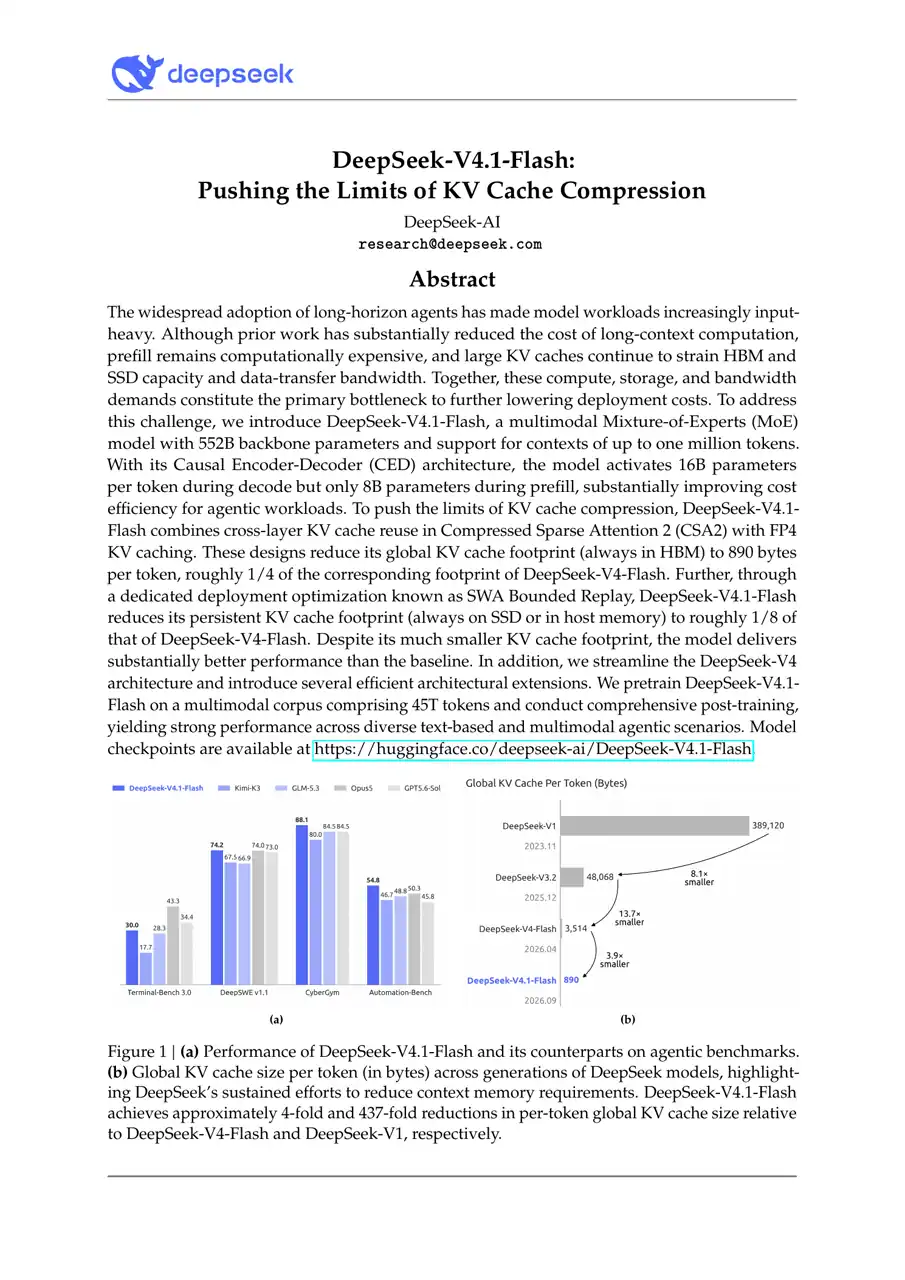
このレポートには、グローバルKVキャッシュのサイズとして トークンあたり890バイト, 、V4 Flashのハイバンド幅メモリ上のキャッシュの約4分の1に相当します。DeepSeekによると、永続キャッシュの要件は前世代の約8分の1となっています。 100万トークンのコンテキストにおいては、これは抽象的なアーキテクチャの詳細というよりも、むしろ導入上の機能となります。キャッシュサイズは、サーバーが保持できる長期セッションの数や、各セッションが消費するメモリ量に影響を与えるからです。.
ネイティブ画像入力とマルチモーダル事前学習
V4.1 Flashは、Visionブランドの別個のエンドポイントを使用する代わりに、画像をネイティブに受け入れます。DeepSeekによると、このモデルは45兆トークンのマルチモーダルコーパスで事前学習されています。 これにより、実際には、スクリーンショット、チャート、スキャンした表、インターフェースの状態、視覚的なデバッグ入力などが、コードやテキストと同様に、エージェントとの会話の一部として扱われるようになります。.
1Mトークンのコンテキストには、入力・出力の合計制限の範囲内で、大規模なリポジトリ、長大なドキュメントセット、および詳細なエージェントの履歴を格納することができます。.
JPEG、PNG、GIF、WebP形式の入力データをテキストと組み合わせて、表の抽出、スクリーンショットの分析、および視覚的質問応答に活用できます。.
ツールの呼び出し、構造化されたJSON出力、およびエージェント指向のトレーニングにより、このモデルは、状態を検査し、判断を下し、状態を変更する必要があるワークフローに適しています。.
DeepSeek V4.1 ベンチマーク:公式結果が示すもの
DeepSeekのV4.1 Flashの最大の強みは、コーディングおよびエージェントのベンチマークに集中しています。同ベンダーは、実験的な推論努力度を100とした状態でインストラクトモデルを評価し、これを「最大推論努力度」として公開しました。 temperature=1.0 そして top_p=0.95. コードエージェントのテストでは、指定されたハーネスと100万トークンのコンテキストを使用し、ビジュアルエージェントのテストでは、512Kトークンのコンテキストを持つClaude Codeを使用しました。.
| ベンチマーク | V4.1 フラッシュ | V4 Pro | V4 フラッシュ | リーダー |
|---|---|---|---|---|
| Codeforces 評価 | 3471 | 3348 | 3289 | V4.1 フラッシュ |
| ターミナル・ベンチ 2.1 Pass@1 | 90.6 | 87.9 | 82.7 | V4.1 フラッシュ |
| DeepSWE v1.1 解決済み | 74.2 | 62.7 | 54.4 | V4.1 フラッシュ |
| サイバージム Pass@1 | 88.1 | 83.3 | 76.7 | V4.1 フラッシュ |
| オートメーション・ベンチ Pass@1 | 54.8 | 43.2 | 37.7 | V4.1 フラッシュ |
| GPQAダイヤモンド Pass@1 | 90.9 | 92.4 | 89.9 | V4 Pro |
| HLE テキストのみ Pass@1 | 39.1 | 42.7 | 37.8 | V4 Pro |
出典:DeepSeek V4.1 技術報告書、表3。各行内では数値が大きいほど良い。Codeforcesはレーティングであり、その他に表示されている値は、同報告書で定義されたパーセンテージ形式の指標である。行間の数値の大きさを比較してはならない。.

この傾向は有用ですが、「より優れたモデル」という包括的な主張よりは限定的なものです。上記のコーディング、ターミナル、セキュリティ、自動化の5つの項目において、V4.1 FlashはV4 Proを上回っています。 一方、GPQA Diamondおよび「Humanity’s Last Exam」のテキストのみのサブセットでは、V4 Proが依然としてリードしています。より広範なコーディング候補リストを比較している開発者は、当社の コーディングに最適なAIモデルガイド, 、とはいえ、アプリケーションレベルでの評価は、単一のテーブルよりも依然として重要である。.
推論の労力も、コストと結果に影響を与えます。DeepSeekの報告書によると、実験の労力を25から100に増やしたところ、DeepSWE v1.1は66.0から74.2へ、Terminal-Bench 2.1は82.4から90.6へと向上しましたが、 一方で、出力トークンの消費量はおよそ2.5倍となった。また、同レポートで取り上げられた8つのエージェント構成は、同じチェックポイントから開始しても著しく異なる結果を生み出したため、フレームワークの選択も測定対象のシステムの一部となる。.
DeepSeekによると、極端な入力に対する頑健性は完全には解明されていない。同レポートでは、CSA2の選択エラーや、近似的なスライディングウィンドウ・アテンションによる状態再構成が、テストスイートの範囲外の境界ケースにおいて性能を低下させる可能性があることが指摘されている。また、最も困難なフロンティア推論やエッジケースのタスクに関しては、依然として課題が残されていることも認められている。こうした留保事項は、主要なスコアと併せて考慮されるべきである。.
V4.1 Flashを評価するための2つの再現可能なタスク
以下のタスクでは、実行されなかったプロンプトを証拠として提示することなく、具体的な挙動を評価します。記載されたプロンプトを正確に使用し、モデルと学習量の設定を記録に残した上で、記載された評価基準に基づいて回答を採点してください。1回の実行結果は、一般的なベンチマークとしてではなく、日付付きの観測結果として報告してください。.
DeepSeek V4.1 フラッシュ価格
DeepSeek APIの価格設定には2つの料金体系が採用されており、以下の数値はすべて100万トークンあたりの米ドル建てです。ピーク時間帯は 月曜日から金曜日までのUTC 01:00~04:00 および UTC 06:00~10:00. 。それ以外の時間はオフピークとなります。キャッシュされた入力、キャッシュされていない入力、および出力は、それぞれ異なる料金で課金されます。.
ホスティング型APIの最安料金
- キャッシュされた入力
- $0.003
- キャッシュされていない入力
- $0.15
- 出力
- $0.60
100万トークンあたり。平日のピーク時間帯を除く。.
オフピーク料金の2倍
- キャッシュされた入力
- $0.006
- キャッシュされていない入力
- $0.30
- 出力
- $1.20
100万トークンごとに、平日UTC 01:00~04:00および06:00~10:00。.
簡単な計算例として、キャッシュされていない入力トークンが80万個、出力トークンが2万個あるオフピーク時のリクエストの場合、そのコストは約 $0.132: 入力に $0.12、出力に $0.012。 ピークレートでの同等のトークンカウントの場合、コストは約$0.264となります。この計算はあくまで例示であり、実際のワークロードの請求額ではありません。キャッシュヒット、再試行、ツールのターン数、推論の長さによって、合計額は変動します。.
どちらの料金プランにおいても、キャッシュされた入力はキャッシュされていない入力に比べて50倍コストが低く、安定したプロンプトプレフィックスや再利用可能なコンテキストが経済的に大きな意義を持ちます。DeepSeekの公開API料金体系は、GlobalGPTへのアクセスおよび課金とは別個のものとなります。これらのトークン価格を、GlobalGPTのサブスクリプション料金やクレジット価格と解釈しないでください。.
DeepSeek V4.1 の API、ビジョン、および制限事項
DeepSeekのダイレクトAPIでは、以下を使用します deepseek-flash. 開発者は、次の標準エンドポイントにリクエストを送信できます。 https://api.deepseek.com, 、同じベースにあるResponses API、または https://api.deepseek.com/anthropic. 「Responses」では、関数ツールがサポートされています。DeepSeek では、以下の内容についても記載されています。 パッチを適用する カスタムツール;その他のレスポンスでは、組み込みのツールタイプは実行されず、無視されます。.
deepseek-flashデフォルトでは「思考」モードがオンになっています。「低」「高」「最大」の3つの努力レベルプリセットが用意されています。.
既存のアプリケーションに適合する互換性レイヤーを選択してください。.
入力と出力の合計を、1Mトークンのコンテキストウィンドウ内に収めてください。.
ビジョンのフォーマットと配置ルール
DeepSeekでは、JPEG、PNG、GIF、およびWebP形式の画像入力が規定されています。 インライン画像は最大 32 MiB、ファイル画像は最大 64 MiB まで可能です。仕様書に記載されている共有上限により、1回のリクエストで最大600枚の画像を送信できます。ただし、この上限は推奨値ではありません。画像のバッチサイズが大きくなると、プロンプトのサイズやレイテンシが増大し、どの画像が回答の根拠となったかを追跡することが困難になります。.
Responses API では、画像コンテンツはユーザーメッセージ内に配置されます。 システム または アシスタント メッセージはHTTP 400を返します。互換性レイヤーは一般的なファイル入力を入力項目として受け付けないため、アプリケーションは「OpenAIレスポンス」の機能が完全に同等であると想定するのではなく、ドキュメントに記載されているimage-inputシェイプに従う必要があります。.
コンテキスト、出力、および並行処理の制限
コンテキストの最大サイズは100万トークン、出力の最大サイズは384,000トークンです。入力と出力を合わせた量が、コンテキストウィンドウに収まる必要があります。Flashでは、1アカウントあたり2,500の同時接続が許可されています。このアカウント制限を超えるリクエストに対しては、HTTP 429が返されます。したがって、キャパシティプランニングでは、アクティブな接続数と再試行の挙動を把握しておく必要があります。.
DeepSeek V4.1 Flash 対 V4 Pro
V4.1 Flashは、大量のコーディングエージェント、視覚入力、および長文コンテキストを扱うアプリケーションにおいて、より実用的なデフォルト設定です。V4 Proは、短い移行期間中は推論のベースラインとして依然として有用ですが、視覚機能には対応しておらず、文書化されている同時実行数も少ないです。以前の当社の DeepSeek V4 Pro レビュー このチェックポイントについては、独自の基準に基づいて扱われている。その実証結果について、V4.1の根拠として再分類すべきではない。.
| 決定要因 | V4.1 フラッシュ | ルーティング変更前のV4 Pro |
|---|---|---|
| ベストフィット | エージェント、コーディング、長文入力、画像認識 | 厳選されたフロンティア推論課題 |
| 画像入力 | サポート対象 | 非対応 |
| 同時実行/アカウント | 2,500件の接続 | 500件の接続 |
| オフピーク時のキャッシュ未保存入力 | $0.15 / 1M | $0.66 / 1M |
| オフピーク時の発電量 | $0.60 / 1M | $1.98 / 1M |
| 公式の採点基準 | エージェント/コーディング行に表示されたリード | GPQA DiamondおよびHLEのテキストのみのリード |
価格はDeepSeekのAPIレートであり、GlobalGPTの価格ではありません。9月14日に発表されたルーティング変更以前は、プロレートが適用されます。.
オフピーク料金では、Flashのキャッシュ未使用の入力は、掲載されているProの料金よりも約77%安く、Flashの出力は約70%安くなります。これらのパーセンテージは、公式の料金表に基づいて算出したものであり、実際に測定された節約額ではありません。 実際のコスト削減額は、キャッシュの再利用率、出力の長さ、リトライ回数、および選択された推論行においてワークロードがProのより強力な結果を必要とするかどうかに依存します。.
より差し迫った区別は、運用上のものです。DeepSeekは、 deepseek-v4-pro その背後にあるモデルを一時的に変更しながら、API名を維持します。API名が安定しているからといって、出力の挙動が安定するとは限りません。9月14日以前に、V4 Proの代表的な応答、ツールのトレース、レイテンシ、および障害事例を保存しておき、ルーティングの変更後に同じ受け入れテストスイートを実行してください。旧式のチェックポイント比較フレームワークについては、以下を参照してください。 DeepSeek V4 Pro 対 Flash.
開発者たちの声
スループット、キャッシュ効率、エージェントのスコアについては、初期の反応は好意的ですが、その根拠はまちまちです。一部のコメントは、最終的な本番環境のチェックポイントではなくプレビュー版のエンドポイントに関するものであり、一部の報告は、対照試験ではなくデモンストレーションをまとめたものです。したがって、最も有益な公開議論は、どこでテストを行うかという点についてのものであり、発売当日の数値一つで決定が下されるかどうかという点ではありません。.
そのリリース分析では、V4 Proのベースラインを維持し、9月14日のルーティング変更前にリリースされたFlashモデルをテストすることを推奨しています。また、パフォーマンスの向上度はベンチマーク、フレームワーク、および設定によって異なる点も強調されています。.
分析を読む同誌は「World of AI」のプレビューデモを総括し、観測された最高速度が1秒あたり427トークンであったことを強調するとともに、思考が過剰になる傾向や、物理シミュレーションの挙動が不十分である点にも言及した。これは公式な速度保証ではない。.
プレビュー記事を読むリリーススレッドにおいて、あるコメント投稿者は、検証済みのProワークフローを黙って別のモデルに転送することに異議を唱え、明確な廃止期間を設けるべきだと主張しました。これはコミュニティの一つの意見であり、コンセンサスではありません。.
コメントを開く合気道のAIペネトレーションテスト責任者は、サイバーセキュリティのベンチマークにおいて、シングルランリコール、pass@3リコール、精度、およびキャッシュヒット率の向上があったと報告した。彼の投稿には有効期限が切れるプレビュー版エンドポイントが記載されているため、これは最終チェックポイントの証明とはならない。.
プレビューレポートを表示するこれらの反応から、実際の導入環境では以下の3つの検証を行う価値があることが示唆されます。すなわち、一定の労力設定での出力品質を比較すること、長い推論が出力コストを膨らませないかを確認すること、そしてエイリアスによってエンドポイントの背後にあるモデルが変更された場合に回帰テストケースを再実行することです。 スループットとセキュリティの結果のプレビューはテスト設計の指針となりますが、それらが単一の制御されたベンチマークから得られたかのように、DeepSeekの表3と組み合わせて使用すべきではありません。.
DeepSeek V4.1のフラッシュへのアクセス方法
アクセス方法には、3つの異なるルートがあります。APIによる直接制御が必要か、ウェイトを自社でホストするか、あるいはモデルの切り替えを容易にするブラウザワークスペースが必要かによって、適切なルートを選択してください。各ルートごとに、利用規約、料金、運用上の責任が異なります。.
DeepSeek API
公式の deepseek-flash ネイティブ、Responses、またはAnthropic互換の統合向けのモデル。.
オープン級
モデルカードとMITライセンスの重みデータをダウンロードしてください。導入を確定する前に、サービングスタックの対応状況とインフラ要件を確認してください。.
モデルリポジトリを開くグローバルGPT
マルチモデルワークスペース内で、専用のV4.1 Flashエントリを使用してください。GlobalGPTの課金は、DeepSeekのAPI料金体系とは別扱いとなります。.
DeepSeek V4.1 フラッシュをお試しください
プログラムによる制御、使用状況の計測、およびDeepSeekの公開インターフェースへのアクセスが必要な場合は、ダイレクトAPIが最も明確な選択肢となります。オープンウェイトは、推論のサポートを確認し、非常に大規模なMoEモデルを運用できるチーム向けです。GlobalGPTは、インタラクティブな使用や、 オールインワンAIモデルワークフロー.
DeepSeekの公式発表記事によると、同社は推論機能のサポートについてオープンソースコミュニティと協力し、さらなる導入オプションを模索していくとのことです。これはあくまでロードマップ上の表明であり、すべてのローカルサービングスタックがすでにV4.1 Flashを効率的にサポートしているという証拠ではないと理解してください。.
DeepSeek V4.1 フラッシュはどのような方に適していますか?
端末作業、リポジトリの閲覧、自動化、ツールの使用、および長いプロンプトが中心となる場合は、V4.1 Flashを優先してください。公式のエージェントスコアおよび低い入力速度を考慮すると、ワークロードに応じた試験導入を行うことが妥当です。.
画像を直接取り込めるため、スクリーンショット、グラフ、表、インターフェースの証拠などについては、V4 ProよりもFlashの方が実用的な選択肢となります。既知の正解と照らし合わせて、抽出精度を確認してください。.
V4 Proは、表示されているGPQA DiamondおよびHLEのテキストのみの行においてトップの成績を収めています。検証済みの推論ワークフローを置き換える前に、固定プロンプトとエフォート設定を比較してください。.
MITライセンスは利用の自由度が高いものの、552B MoEバックボーンは軽量なローカルモデルとは言えません。ハードウェア、キャッシュ戦略、量子化、およびサービングのサポートについて確認してください。.
より広範なモデル選択を行うには、 GPT-5.5 対 DeepSeek V4 の比較 100万トークンのコンテキストと価格ポジションを、別のフロンティア・オプションと並べて表示します。コード出力スタイルに重点を置くチームは、以下の DeepSeek 対 ChatGPT Python コードのテスト. これらの記事は関連する疑問に答えるものではありますが、本番環境で実際に使用されている正確なV4.1 Flashエンドポイントをテストする代わりにはなりません。.
エコシステム選びに迷っている一般ユーザーにとっては、より幅広い DeepSeek と ChatGPT の比較 アーキテクチャレベルのレビューよりも有用です。V4.1 Flashは、その特定の利点――長い入力に対応できること、画像の理解、ツール、そして低いトークンコスト――が実際のワークフローに活かされる場合に、最もその真価を発揮します。.
評決
API利用料の低さ、100万トークンのコンテキスト、ネイティブ画像入力、2,500接続の許容量、そしてDeepSeekで報告されたエージェントの性能向上といった点から、評価する価値は十分にある。 ただし、これはPro版の万能な代替品というわけではありません。V4 Proは依然として特定の推論項目で優位性を保っており、最大努力スコアでは出力トークンの使用量が多くなる傾向があり、エンドポイントのルーティング変更によって検証済みの動作が変化する可能性があります。.
GlobalGPTでDeepSeek V4.1のフラッシュを開くまずは小規模な受け入れテストスイートから始めましょう。具体的には、代表的なコーディングタスク1つ、画像に基づく情報抽出タスク1つ、長文コンテキストのケース1つ、ツールワークフロー1つを用意します。推論の設定を固定し、モデルのルーティングを記録した上で、失敗パターンと平均品質を比較します。そうすることで、ベンダーのベンチマークやリリース当日の反応を、アプリケーションのパフォーマンスを保証するものと見なすことなく、説得力のある判断を下すことができます。.
よくある質問
DeepSeek V4.1 フラッシュとは何ですか?
DeepSeek V4.1 Flashは、2026年9月10日にリリースされたマルチモーダルで、重みが自由なエキスパート混合モデルです。テキストおよび画像の入力、テキスト出力、100万トークンのコンテキストウィンドウ、思考モードと非思考モード、JSON出力、およびツール呼び出しに対応しています。.
DeepSeek V4.1 Flash APIの価格はいくらですか?
オフピーク時の DeepSeek API 料金は、キャッシュされた入力トークン 100 万個あたり $0.003、キャッシュされていない入力トークン 100 万個あたり $0.15、出力トークン 100 万個あたり $0.60 です。 ピーク時のレートは、それぞれ$0.006、$0.30、$1.20となります。これらはDeepSeek APIの価格であり、GlobalGPTの価格ではありません。.
DeepSeek V4.1 フラッシュには、どの API モデル名を使用すればよいですか?
用途 deepseek-flash 公式の DeepSeek API を使用します。DeepSeek では、以下の場所での Responses API 呼び出しもサポートしています。 https://api.deepseek.com および Anthropic 対応のコールは、 https://api.deepseek.com/anthropic.
コンテキスト、出力、および並行処理の制限はどのようなものですか?
DeepSeek V4.1 Flash は、100万トークンのコンテキストウィンドウを持ち、最大出力は384,000トークンです。入力と出力の合計は、このコンテキスト内に収まる必要があります。DeepSeek では、アカウントあたり2,500の同時接続がサポートされており、この制限を超えると HTTP 429 が返されます。.
DeepSeek V4.1 FlashはV4 Proより優れていますか?
タスクによって異なります。DeepSeekのベンダー別比較表によると、コーディング、端末、セキュリティ、自動化の各ベンチマークではV4.1 FlashがV4 Proを上回っていますが、GPQA DiamondおよびHLEのテキストのみのベンチマークではV4 Proがリードしています。また、Flashは価格が安く、ビジョン機能をサポートしており、同時接続数も多くなっています。.
DeepSeek V4.1 Flashは画像に対応していますか?
はい。JPEG、PNG、GIF、WebP形式の入力を受け付け、テキストを出力します。DeepSeekでは、インライン画像は最大32 MiB、ファイル画像は最大64 MiBまで対応しており、リクエストあたりの画像数は共有制限の範囲内で600枚までです。APIからの応答に含まれる画像は、ユーザーメッセージ内に配置する必要があります。.
DeepSeek V4.1のフラッシュウェイトはダウンロードできますか?
はい。DeepSeekは、MITライセンスに基づき、Hugging Face上でDeepSeek-V4.1-Flashモデルの重みデータを公開しています。この寛容なライセンスであっても、インフラストラクチャの要件が免除されるわけではありません。各チームは、互換性のあるサービングソフトウェアと、552B MoEバックボーンを処理するのに十分なハードウェアを依然として必要とします。.
GlobalGPTでDeepSeek V4.1のフラッシュを使用することはできますか?
はい。GlobalGPTには、ブラウザベースでの利用向けに専用の「DeepSeek V4.1 Flash」エントリが用意されています。そのアクセスおよび課金については、DeepSeekのダイレクトAPI料金プランとは別扱いとなっており、プラットフォームの可用性については、DeepSeekが公表しているベンチマーク結果を独自に検証するものではありません。.





