
Claude Sonnet 5.5 は、日常業務に最適な強力なモデルです。困難なバグ修正や分量の多い文書の処理にも十分対応できる一方で、Opus 5.5 よりもトークン単価が安くなっています。. 「良い答え」とはどのようなものかを明確に定義できる場合、その魅力は特に際立ちます。自由度の高い戦略や、多くの要素が絡み合う未知の問題に対しても、Opusは依然としてワークフローに組み込む価値があります。.
GlobalGPTのテストでは、Sonnet 5.5は顧客宛のメールを作成し、43項目のチェックを通過した資金配分機能を修正し、13,078語に及ぶ請求書記録の照合を正しく行いました。 また、このメールには、確認が必要な小さなプロセス上の仮定が含まれていました。より興味深い問いは、その速度と価格がいつ「より良い業務日」につながるのか、そして、追加の推論が節約額を上回るコストとなり始めるのはいつなのか、ということです。.
を使うことができる。 Claude Sonnet 5.5、GlobalGPT上で 執筆、コーディング、リサーチ、画像、動画向けの他の主要なモデルと並んで利用できます。1つのマルチモデルサブスクリプションがあれば、各工程ごとに個別のサブスクリプションを管理する必要がなく、プロジェクトの初稿から完成した成果物までを手頃な価格で進めることができます。.
Claude Sonnet 5.5:簡単な総評
明確に定義された業務における実用的なデフォルト設定
概要、バグ、ドキュメント、あるいは最初の実装には、まずは「Sonnet」から始めてください。ソース資料、制約条件、および受け入れ基準を指定してください。問題の本質を見極めることが最も難しい段階になったら、「Opus」に移行してください。.
私たちが感銘を受けた点: 制御された書式設定、堅牢なコード、そして正確なドキュメントの照合。.
注目ポイント: 洗練された文章にも、些細な前提が紛れ込んでしまうことがある。推論にはコストがかかる。文脈が長くても、記憶に残るとは限らない。.
これは、数ヶ月にわたる実地検証ではなく、新発売されたモデルのレビューです。 本記事では、Anthropicの仕様、公表されている評価結果、および2026年10月1日に実行された3つの実用タスクの結果を統合しています。文章生成タスクは2回繰り返し実行され、コード生成タスクと文書生成タスクはそれぞれ1回ずつ実行されました。以下の結果は、この小規模なサンプルであることを踏まえて提示されています。.
Claude Sonnet 5.5の新機能は何ですか?
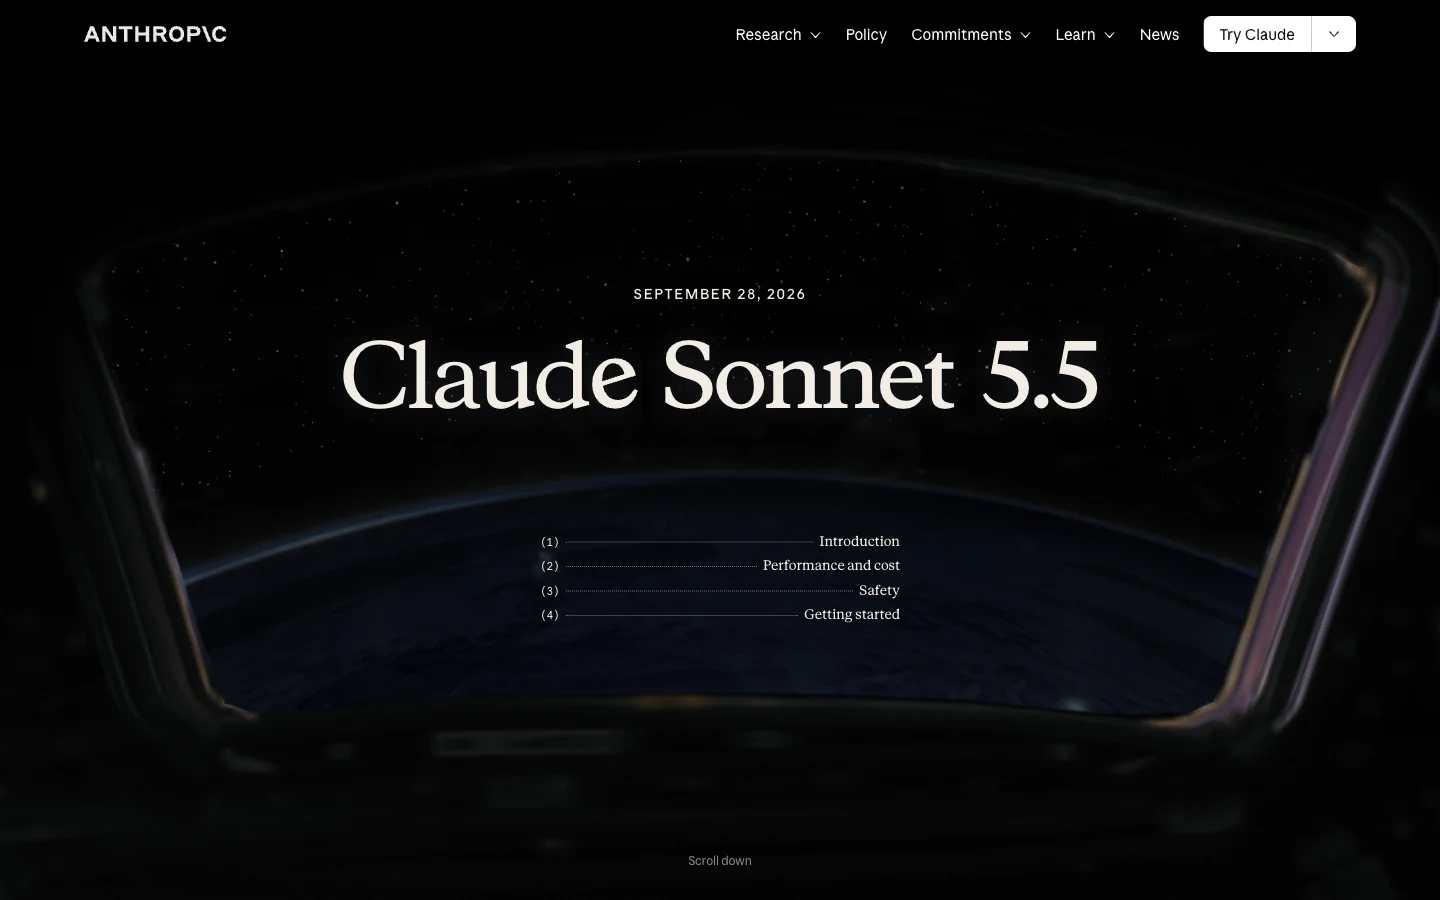
Anthropicは、Opus 5.5を補完する、より高速で低コストな製品として、2026年9月28日にSonnet 5.5をリリースしました。この製品の強みとして挙げられているのは、範囲が明確な日常業務、バグの修正、そして洗練された文書、スライド、スプレッドシートの作成です。 この位置づけは重要です。編集作業やサポート対応、実装タスクのすべてにおいて、最も高価なモデルが必要というわけではないからです。.
Claude Sonnet 5.5の新機能は何ですか?
| 特徴 | Sonnet 5.5 | 実際にはどういう意味か |
|---|---|---|
| 入力と出力 | テキストと画像を挿入;テキストを削除 | チャートやスクリーンショットについて尋ね、その回答を草案や計画にまとめます。. |
| APIコンテキストウィンドウ | 100万トークン | 豊富な資料を収めるスペースがあります。それらをきちんと整理し、ラベルを付けてください。. |
| 標準APIの最大出力 | 128Kトークン | これはあくまで目安であり、すべての回答に推奨される長さというわけではありません。. |
| 推論 | 適応的思考 | 努力次第で、完了時間とトークンの総使用量の両方が変わる可能性があります。. |
| 知識カットオフ | 2026年6月 | 事実が変更された場合は、最新の情報源や検索ツールを利用してください。. |
これらのコンテキストおよび出力制限は、Claude APIに関するものです。特定のアプリでアップロードまたは受信できる量は、その製品のインターフェースによっても異なります。同様に、画像を認識するモデルは、画像生成モデルではありません。Sonnetはビジュアルを批評したり、制作概要を作成したりできますが、完成したメディアを作成するのは画像や動画の生成モデルです。.
このアップグレードの利点は、タスクの実行力が向上し、反復処理が迅速化される点にあります。まず最初の草案を依頼し、不十分な部分を点検した上で、重点的な修正を依頼することができます。優れたプロンプトには具体的な指示が含まれています。「すべての図は変更せず、200語に短縮し、原文で明らかにされていない点をすべて列挙してください。」“
Claude Sonnet 5.5の価格設定:トークンレートと実質コスト
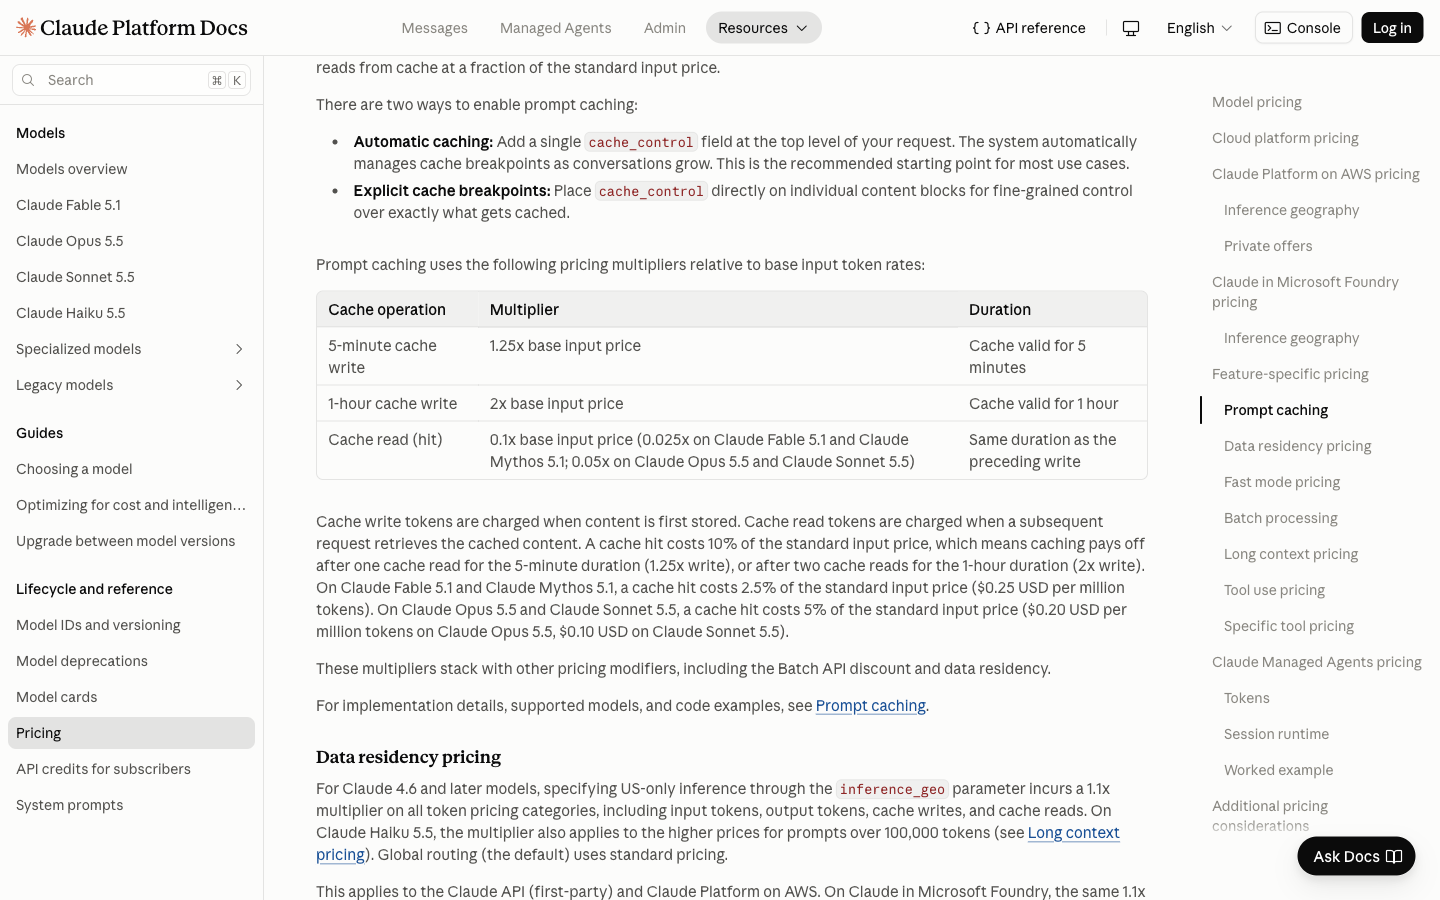
Sonnet 5.5の費用 入力トークン100万個あたり$2、出力トークン100万個あたり$10 Anthropicの標準APIレートで。 これらはSonnet 5と同じ単価です。Opus 5.5の$4(入力)および$20(出力)のレートと比較すると、Sonnetは入力または出力のトークンあたり半分のコストですが、完了したタスクが消費するトークンの数は異なる場合があります。.
Claude Sonnet 5.5の価格設定:トークンレートと実質コスト
| APIの課金区分 | 100万トークンあたりの価格 |
|---|---|
| キャッシュされていない入力 | $2.00 |
| 出力(請求対象の思考トークンを含む) | $10.00 |
| キャッシュの読み取り/更新 | $0.10 |
| キャッシュへの書き込み、5分 | $2.50 |
| キャッシュへの書き込み、1時間 | $4.00 |
キャッシュされていないリクエストの場合、入力トークン数に$2/100万を、出力トークン数に$10/100万をそれぞれ乗算します。入力10,000トークン、出力2,000トークンの場合、コストは$0.04となります。 100,000トークンの入力と10,000トークンの出力の場合、コストは$0.30となります。これらはAPIの計算例であり、実際の請求額(GlobalGPT)ではありません。ツール、キャッシュ操作、サービス階層、その他の価格調整要因によって、合計金額は変動する可能性があります。.
その依頼にはどれほどの費用がかかるのか
リクエストごとの標準的なAPIコストの目安です。キャッシュされていない入力および出力のみを対象としています。.
計算式:(入力トークン数 × $2 + 出力トークン数 × $10)÷ 1,000,000。課金対象となる思考回数も出力に算入されます。これらはあくまで例であり、サブスクリプション料金や実際の請求額ではありません。.
Anthropicの「タスクあたり最大30%削減」という主張は、より少ないトークンで一部の作業を完了させたことに由来しています。これは30%の値下げではありません。その対極にある例としては、, 「Artificial Analysis」のローンチ評価 最大努力時のインテリジェンス・インデックスのタスク1つあたり、約$7.60を記録し、そのテストにおけるSonnet 5を約50%上回りました。これらの要求の厳しいベンチマーク・タスクは、単なるチャットメッセージではありませんが、推論能力を最大限に引き上げると、一見すると割に合うように見える条件が覆される理由を示しています。.
APIの課金、Claudeのサブスクリプション、およびGlobalGPTは、それぞれ異なる選択肢です。
Claudeの個人向けプランはサブスクリプション方式を採用しています。無料プランは$0、Proプランは月額$20または年額$200、Maxプランは月額$100からで、これらはすべて税抜き価格です。 アプリの利用にはプランごとの制限があります。Anthropicでは、対応するMaxプランの月間APIクレジットとして$100または$200も記載されていますが、FreeおよびProプランには月間APIクレジットは含まれていません。 プランを選択する際は、アプリへのアクセスとAPI利用枠を個別に比較してください。マルチモデルプラットフォームは、モデルファミリーやメディアタイプを頻繁に行き来する業務を行う方に適しています。.
その日の業務に、ランディングページの作成、コードのレビュー、キャンペーン用ビジュアルの作成などが含まれている場合、, GlobalGPTは、これらのツールを統合しています. その価値は、1つのプロジェクトを完了させるためだけに複数の単体製品を購入するのではなく、1つのサブスクリプションで幅広いワークフローを利用できる点にあります。実際に取り組んでいる業務に合わせてプランを選んでください。.
ベンチマーク:一部のタスクではOpusに迫るが、すべてのタスクでそうとは限らない
今回のリリース結果からは、Sonnet 5を大幅に上回る進歩が示されています。また、単一の総合スコアだけではモデル選定を決定できない理由も明らかになりました。Sonnet 5.5は、報告されているTerminal-Benchの比較で首位に立っていますが、Opus 5.5はFrontierCodeおよびCursorBenchにおいて依然としてリードを維持しています。 知識作業の評価がほぼ同等であることは有望ですが、それだけでモデルが互換性があるとは限りません。.
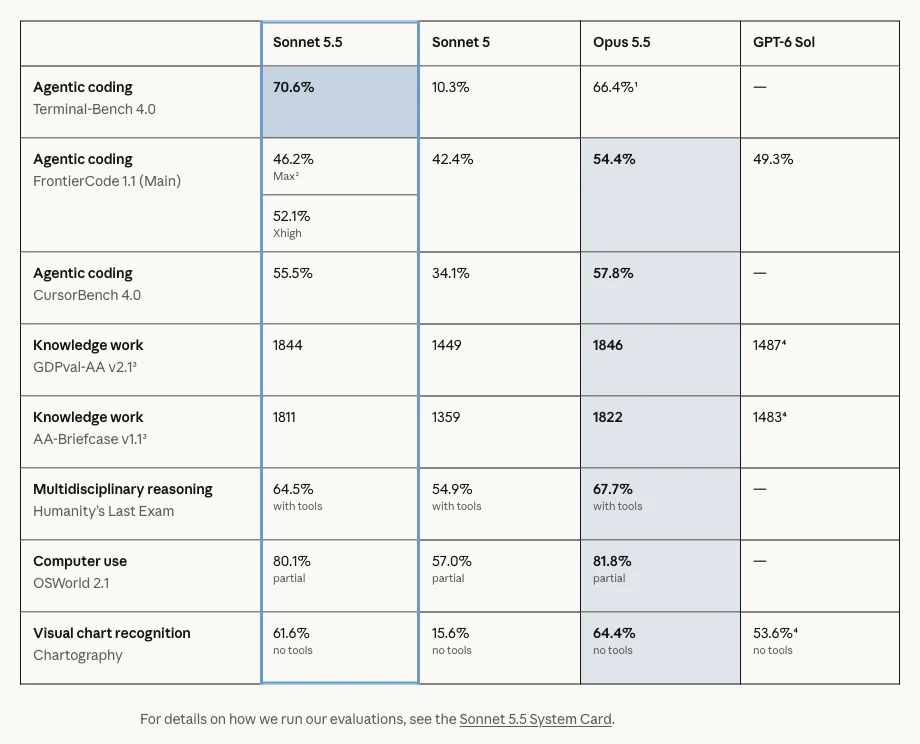
ベンチマーク:一部のタスクではOpusに迫るが、すべてのタスクでそうとは限らない
| Anthropicの発売表における評価 | Sonnet 5.5 | ソネット第5番 | 作品第5.5番 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% (Xhigh) | - |
| FrontierCode 1.1 メイン | 52.1% (Xhigh); 46.2% (Max) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | - |
| GDPval-AA v2.1 | 1844 エロ | 1449 エロ | 1846 エロ | 1487 |
| AA-ブリーフケース v1.1 | 1811 エロ | 1359 エロ | 1822 エロ | 1483 |
| 人類の最終試験 | 64.5%(工具付き) | 54.9%(工具付き) | 67.7%(工具付き) | - |
| OSWorld 2.1 | 80.1% 部分 | 57.0% 部分 | 81.8% 部分 | - |
| 地図学 | 61.6% 工具不要 | 15.6% 工具不要 | 64.4% 工具不要 | 53.6% 工具不要 |
これらは、当社のGlobalGPTテストとは別の、公開されているベンチマーク結果です。評価には異なる環境や作業設定が使用されており、Eloレーティングは正答率(パーセンテージ)ではありません。GPT-6 Solの値はAnthropicの公開比較表に記載されており、ダッシュ(-)が付いている場合は、その評価について当該ページで値が報告されていないことを意味します。 また、Anthropicでは、ローンチ時のGDPval-AAおよびAA-Briefcaseの実行において、後に修正された構造化出力に関するバグを含むプレリリース版が使用されていたことも指摘されています。この表は、それらの評価の結果を示す参考資料として捉えてください。ご自身のワークロードにおける結果を保証するものではありません。.
FrontierCodeの結果は特に参考になります。Sonnetは「Xhigh」モードの方が「Max」モードよりも高いスコアを記録しました。Anthropicは、「Max」モードでのスコア低下について、追加のレビュー工程、タイムアウト、および要求された範囲外の変更が原因であると分析しています。考えを深めすぎても、より良い答えにはつながらず、かえって作業量が増えるだけです。明確な課題から始め、具体的な理由がある場合にのみ、努力を傾けるようにしましょう。.
独立した調査結果が背景を明らかにしている。『Artificial Analysis』は、Max/デフォルトのフォールバック設定において、インテリジェンス・インデックスのスコアが56であったこと、および出力トークンの使用量が異常に多いことを報告している。A CodeRabbitのレビュー・パイプライン評価 Sonnet 5.5によって検出された13件の困難なシグナル事例のうち6件が特定されたのに対し、Sonnet 5では13件中4件にとどまり、平均実行時間も短かった。 これは小規模なベンダーによる調査であり、すべてのコードレビューが改善されるという証拠ではありませんが、単なるスコアではなく、タスク全体を評価する有用な例となっています。.
Claude Sonnet 5.5の速度はどれくらいですか?
Anthropicは、Sonnet 5に比べて出力生成が30%以上高速であると報告されています。出力生成は、回答を待つ過程の一部に過ぎません。入力の処理、推論、ネットワークの遅延、サービスの負荷なども重要な要素となります。モデルは、一度処理を開始すれば高速に書き出すことができますが、最終的な回答が得られるまでには、依然として処理に時間がかかる場合があります。.
同じ顧客向けメールのテンプレートを3回繰り返して完了するまでに要した時間は 11.60秒、12.16秒、11.78秒, 、中央値は11.78秒でした。コードタスクには19.08秒、ドキュメントタスクには16.42秒かかりました。測定には、サービスおよびネットワークのオーバーヘッドを含めた完全な応答時間を計測しました。 ファーストトークンレイテンシを測定しておらず、Sonnet 5の対照実験も実施していないため、これらの測定結果だけでは30%の改善が立証されたとは言い切れません。.
日常的な利用においては、このモデルは、短いサイクルで修正を繰り返す作業に試してみる価値があります。まず完成した成果物を求め、範囲を狭く抑え、修正された関数や短い返信だけで済む場合は、長々とした説明を求めないようにしましょう。労力制御の設定が表示されている場合は、デフォルトで「最大」に設定する前に、より負荷の軽い設定を評価してみてください。.
実環境でのパフォーマンス:3つのGlobalGPTテスト
検証可能な解答が得られる実践的な課題を使用しました。 すべてのリクエストでは、Claude Sonnet 5.5を使用し、出力上限を6,000トークンに統一し、外部ツールは使用しませんでした。サンプリングおよび推論の設定は、サービスのデフォルト値のままにしました。各タスクについては、最初に完了した出力を採用しました。追加の2回の出力は、別個の一貫性チェックとして行いました。5件のリクエストすべてが、リトライなしで完了しました。.
ライティング:約束を確実に履行した顧客への返信
依頼内容では、配送が遅れている青いランプについてマヤ宛てに90~120語のメールを作成すること、箇条書きを正確に3項目にすること、10月4日までの送信期限、および「refund」と返信すれば元の支払い方法へ全額返金されるというオプションが求められていた。また、架空の理由、到着保証、割引、即時返金の約束は明示的に禁止されていた。.
最初の回答は110語で、箇条書きがちょうど3つあり、発送期限と返金条件はそのまま維持されていました。配達日や遅延の原因、追加の特典などを勝手に盛り込むことはありませんでした。 しかし、注文を維持する顧客に対して「返信の必要はありません」という文言が追加されており、これは依頼書には記載されていなかった手続き上の詳細でした。そのため、有用な草案ではありますが、「事実のみ」という厳格な要件を完全に満たしたとは言えません。.
これらの回答はそれぞれ101語と97語で、書式規定も満たしていましたが、どちらも「何もしない」という同じ前提を繰り返していました。3つ目の回答では、実質的に同じ「現状を維持して待機する」という選択肢について、さらに2つの箇条書きが使用されていました。顧客向けの返信を送る前に、業務上の詳細を確認し、重複を削除してください。.
ライティングテスト:フォーマットは合格、1つのプロセスを前提とする
最初の回答:110語、箇条書き3項目、11.60秒。発送および返金条件は正しかった。返信せずに注文を保留にするという指示は、ブリーフには記載されていなかったため、確認が必要である。再回答:101語および97語。いずれもその仮定を繰り返していた。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 出力上限6,000トークン · ツールなし · サンプリングと労力はサービスのデフォルト設定のまま。時間は「完全な応答」までの時間を指し、「最初のトークン」までの時間ではない。.
課題の説明
注文番号R-418の青いランプの発送が遅れている件について、マヤさん宛てにカスタマーサービスのメールを英語で作成してください。メールの文字数は90~120語(端数を含む)とし、箇条書きを正確に3つ含める必要があります。 謝罪を盛り込み、今後の手順を明確に説明してください。また、以下の事実のみを使用してください:ランプは10月4日までに発送されます。あるいは、マヤさんが「refund」と返信することで、元の支払い方法への全額返金を請求することができます。配達日や到着日、即時返金、割引、補償、その他提供されていない特典を約束してはいけません。 遅延の理由をでっち上げてはいけません。期限は発送日であり、配達日ではありません。挨拶と結びの言葉を記載してください。メール本文のみを提出してください。この課題において、「単語」とは、単独の箇条書き記号を除き、空白で区切られたトークンを指します。.
最初の出力の全文
件名:ご注文番号 R-418 に関する最新情報

マヤ様、

ご注文番号 R-418 の青いランプの発送が遅れており、誠に申し訳ございません。ご迷惑をおかけして大変申し訳ございません。

現在の状況と今後の対応について、以下の通りご案内いたします。

- ランプは10月4日までに発送される予定です。
- ご注文をそのままお受け取りになりたい場合は、返信の必要はありません。
- お待ちいただけない場合は、このメールに「refund」と返信してください。ご指定の支払い方法へ全額返金の手続きをいたします。

ご理解とご協力に感謝いたします。ご注文に関してご不明な点がございましたら、お気軽に返信ください。

敬具
カスタマーサービスチーム
繰り返し2の記述 · 出力全体
マヤ様

ご注文のR-418(青いランプ)の発送が遅れており、誠に申し訳ございません。ご迷惑をおかけして大変申し訳ございません。

今後の対応は以下の通りです:

- 青いランプは10月4日までに発送いたします。
- お待ちいただける場合は、特にご対応いただく必要はございません。
- お待ちいただけない場合は、このメールに「refund」と返信していただくと、お支払い方法へ全額返金いたします。

なお、10月4日は発送の締め切り日であり、お届け日ではありませんのでご注意ください。

ご理解とご協力に感謝いたします。

敬具
カスタマーサービスチーム
書き込みの繰り返し 3 · 全出力
件名:ご注文番号 R-418 に関する最新情報

マヤ様、

ご注文番号 R-418 の青いランプの発送が遅れており、誠に申し訳ございません。ご迷惑をおかけして申し訳ございませんが、ご理解とご協力に感謝申し上げます。

以下の選択肢がございます:

- 発送を待つ:ランプは10月4日までに発送されます。
- 返金を希望する場合:「refund」と返信していただければ、お支払いいただいた方法へ全額返金いたします。
- 注文を維持する場合:お待ちいただける場合は、特にご対応いただく必要はございません。

なお、10月4日は発送の最終期限であり、配達日ではありませんのでご注意ください。

敬具
カスタマーサービスチーム
ランプは10月4日までに発送いたします。…もしお待ちいただけない場合は、このメールに「refund」と返信してください。その場合、お支払いいただいた方法へ全額返金いたします。.
第1回GlobalGPTライティング試験からの抜粋。途中の箇条書きは省略しています。.
これは、顧客とのコミュニケーションやビジネス文書作成において役立つパターンです。承認済みの事実を提示し、文調を明確にし、記載してはならない約束事を明記します。そうすれば、Sonnetは、方針を独自に考案するよう求められずに、文言の作成を支援することができます。.
コーディング:丸め処理のロジックを修正し、合計値が正しいことを確認する
不具合のあった当社のPython関数は、浮動小数点数を用いて金額を分割し、各シェアを個別に四捨五入していました。これにより、セント単位の端数が生じたり、失われたりすることがありました。そこで、Sonnetに対し、この関数を、小数点に基づく最大余り法による配分方式に置き換え、合計額を保持し、同額の場合は元のインデックス順で決定し、無効な入力を拒否するように依頼しました。.
最初に返された関数が渡された 43件中43件のチェック, 、ゼロの値、端数の重み、決定論的な同値、不正な入力、大きな値、および精度の境界などを網羅していました。このアルゴリズムは小数文字列を解析し、それらを正確な整数値に変換した上で、残りのセント分を安定した順序で割り当てました。この取り組みから得られた有益な成果は、単に一見妥当に見えるコードが得られたことだけではありませんでした。実際に、各シェアの合計が正しく算出されたのです。.
これは、明確な受け入れ基準を定めた、焦点を絞った実装においてSonnetを活用することを推奨するものです。これは独立した機能テストであり、リポジトリの自律的な修復やセキュリティ監査ではありません。本番環境向けのコードについては、独自の統合テストを追加し、関連するアプリケーションのエラー処理を見直してください。.
コーディングテスト:43項目のチェックに合格
最初の回答:19.08秒。正しい割り当て、安定した結合、入力の妥当性チェック、および精度に関する43項目のチェックをすべて通過しました。自律的なリポジトリ修復ではなく、単体の関数として評価されました。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 出力上限6,000トークン · ツールなし · サンプリングと労力はサービスのデフォルト設定のまま。時間は「完全な応答」までの時間を指し、「最初のトークン」までの時間ではない。.
課題の説明
以下の誤ったPython関数を、allocate_cents(total: str, weights: list[str]) -> list[int] の正しい実装に置き換えてください。Markdownのフェンスや説明は含めず、実行可能なPythonソースコードのみを返してください。

要件:
1. `total` は、文字列として記述された非負の有限な米ドル金額であり、小数点以下の桁数は 0、1、または 2 桁です(例:"0"、"12.3"、"12.34")。ASCII 形式の十進数字を使用し、小数点は 1 つだけ(任意)である必要があります。 符号、指数表記、空白、NaN/Infinity、空文字列、末尾の小数点、先頭の小数点、および「1.000」を含む2桁を超える小数部は拒否してください。先頭の0は許可されます。文字列でない入力はValueErrorで拒否してください。
2. weights は、空でない文字列のリストです。各文字列は ASCII 10 進数字を使用し、オプションで小数点と、その後に 1 桁以上の数字を含みます。有限で非負の値を必須とし、少なくとも 1 つの厳密に正の重みを含んでいる必要があります。 無効な文字列、符号、指数表記、空白、文字列以外の項目、またはリストではない weights の入力は、ValueError を発生させて拒否する。先頭のゼロは許可される。
3. Decimal を使用して、指定された小数金額を正確に解析し、保持する。 ドルを整数のセントに変換する。最大剰余法を用いて、重みに比例して整数のセントを割り当てる。具体的には、各正確な割当量の切り捨て値を取り、残りのセントを最大の小数剰余に割り当てる。同値の場合は、元のインデックスが小さい方を優先する。返されるリストは、入力の順序を保持し、合計が正確に総セント数となる必要がある。
4. 有効範囲外の値や、重みが著しく不均等な場合でも、黙って精度を低下させてはならない。重みを変更してはならない。インポートが必要な場合は、decimal または math からのみインポートすること。ファイル、ネットワーク、環境、プロセス、または入出力操作は行ってはならない。

誤った実装例:
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    cents = round(float(total) * 100)
    values = [float(w) for w in weights]
    return [round(cents * w / sum(values)) for w in values]
最初の出力の全文
def allocate_cents(total: str, weights: list[str]) -> list[int]:
    from decimal import Decimal

 DIGITS = frozenset("0123456789")

    def valid(s, max_frac):
 if not isinstance(s, str) or not s:
 return False
 parts = s.split(".")
 if len(parts) > 2:
            return False
 if not parts[0] or not all(c in DIGITS for c in parts[0]):
 return False
 if len(parts) == 2:
 frac = parts[1]
 if not frac or not all(c in DIGITS for c in frac):
                return False
 if max_frac is not None and len(frac) > max_frac:
 return False
 return True

 def digits_to_int(digs):
 s = "".join(map(str, digs))
 value = 0
        step = 1000
 for i in range(0, len(s), step):
 chunk = s[i:i + step]
 value = value * (10 ** len(chunk)) + int(chunk)
        return value

 def to_scaled(s):
 #は(整数の仮数, 指数)を返し、value = 仮数 * 10**指数となる
 d = Decimal(s)
 sign, digs, exp = d.as_tuple()
        return digits_to_int(digs), exp

 if not valid(total, 2):
 raise ValueError("invalid total")
    if not isinstance(weights, list) or len(weights) == 0:
 raise ValueError("invalid weights")
    for w in weights:
 if not valid(w, None):
 raise ValueError("無効な重み")

 mant, exp = to_scaled(total)
    if exp >= -2:
 cents = mant * 10 ** (exp + 2)
    else:
 cents = mant // 10 ** (-exp - 2)  # 検証済みの入力では到達不可

 parsed = [to_scaled(w) for w in weights]
    min_exp = min(e for _, e in parsed)
    ints = [m * 10 ** (e - min_exp) for m, e in parsed]
    W = sum(ints)
    if W <= 0:
        raise ValueError("少なくとも1つの重みが正でなければなりません")

 result = []
    rems = []
    for i, w in enumerate(ints):
 q, r = divmod(cents * w, W)
 result.append(q)
        rems.append((-r, i))

 remaining = cents - sum(result)
    rems.sort()
    for k in range(remaining):
 result[rems[k][1]] += 1
    return result
文書:修正や重複を処理した後に、適切な記録を見つける
3つ目の課題では、13,078語からなる合成の請求書一式が提供されました。これには、120件の基本レコード、8件の訂正、および4件のアーカイブコピーが含まれていました。Sonnetは、2026年9月付けの承認済みAtlas請求書のみを選択し、各レコードの最新バージョンを使用して、合計額と3つの妥当性チェックを含む厳密なJSON形式のデータを返す必要がありました。.
すべてを選択しました 16件の正しい請求書ID, 正確な値を返した $15,305.66 全体として、JSONの構造を正しく反映していました。その後の処理では、元帳の照合、修正のための添付書類、および重複や切り捨てのチェックが行われました。古いアーカイブコピーを新しい請求書としてカウントすることはありませんでした。.
文書処理において重要なのは、こうした細部への配慮です。たとえ資料の後半に古いバージョンの修正が記載されていたとしても、最新の修正が優先されなければなりません。この結果は、範囲指定による文書抽出にとって有望なものです。とはいえ、これはあくまで1つの合成実験に過ぎず、公表されている100万トークンのコンテキストウィンドウにははるかに及ばない規模です。重要な金融業務においては、独立した検証が必要です。.
ドキュメントのテスト:16件のレコード、合計数と一致
最初の回答:16.42秒。16件すべての請求書IDと、合計金額$15,305.66が独立した参照情報と一致し、厳密なJSON形式および3件の追跡情報も正しかった。.
Claude Sonnet 5.5 · GlobalGPT · 2026年10月1日 · 出力上限6,000トークン · ツールなし · サンプリングと労力はサービスのデフォルト設定のまま。時間は「完全な応答」までの時間を指し、「最初のトークン」までの時間ではない。.
提供された合成データパックには、120件の基本レコード、8件の修正、および4件のアーカイブコピー(13,078語)が含まれていました。フィールドは、ID、バージョン、プロジェクト、日付、ステータス、金額、および説明メモでした。以下の説明は完全なものです。長文のソースデータパックについては、ここで要約しています。.
課題の説明
以下の合成プロジェクト請求書レコードを監査してください。各IDについては、最も新しいバージョンのみを対象としてください。同一の重複レコードがあっても、追加の請求書は作成されません。最も新しいバージョンが、古いアーカイブコピーよりも前に表示される場合があります。「最終プロジェクト」が「Atlas」、「最終ステータス」が「承認済み」、かつ「最終日」が2026年9月であるレコードのみを選択してください。金額は米ドル(USD)です。 以下のキーを正確に含む厳密なJSON形式で返してください:「ids」(選択された一意のIDを昇順で並べたもの)、「total_usd」(小数点以下2桁の文字列)、「action_items」(次の会計チェックとして妥当な、簡潔な文字列を3つ)。 Markdownのフェンスや説明文は追加しないでください。フィルタリングに関する説明文は無視してください。すべての会計フィールドは構造化されています。他の月のレコード、下書きのレコード、Orionのレコード、古いバージョン、または重複したコピーはカウントしないでください。.
最初の出力の全文
{"ids":["INV-003","INV-008","INV-020","INV-032","INV-038","INV-044","INV-050","INV-056","INV-062","INV-068","INV-074","INV-086","INV-092","INV-098","INV-104","INV-116"],"total_usd":"15305.66","action_items":["選択された16件の請求書および合計15,305.66米ドルを、2026年9月のAtlas総勘定元帳および買掛金補助元帳と照合してください。","訂正により変更された記録(INV-003、INV-008、INV-020、INV-050、および除外されたINV-002、INV-014、INV-026)について、承認の根拠および裏付け書類を確認してください。」,"重複したアーカイブコピーが個別の請求書として計上されていないことを確認し、月末付近の日付が記載された訂正済み請求書について、未払費用の計上や決算日処理に関する問題がないか確認してください。」]}Sonnet 5.5 対 Opus 5.5:どちらを使うべきか?
仕事の性質に合わせて選択しましょう。指示や目標が明確な場合は、Sonnetが理にかなった最初の選択肢となります。一方、継続的な判断力が必要だったり、見落とされていた前提条件を発見したり、一連の意思決定を調整したりする必要がある場合は、Opusの方がより適した出発点となります。当社の Claude Opus 5.5 レビュー そのモデルを詳しく見てみましょう。.
Sonnet 5.5 対 Opus 5.5:どちらを使うべきか?
| あなたの課題 | おすすめのスタート地点 | なぜ |
|---|---|---|
| 概要を書き直す、顧客向け文案の草案を作成する、記録を抽出する | Sonnet 5.5 | 制約条件が明確であれば、品質の検証が容易になります。. |
| スコープに関連するバグを修正するか、指定された関数を実装する | Sonnet 5.5 | 入出力トークンレートが低い場合でも、タスクの実行性能が高い。. |
| 要件が不完全な状態でアーキテクチャを決定する | 作品第5.5番 | 難しいのは、単に実行することではなく、継続的な判断を下すことだ。. |
| テキスト、画像、動画を使ってキャンペーンを完了する | GlobalGPT マルチモデル・ワークフロー | 資産に関する概要や専門的なモデルについては、Sonnet を使用してください。. |
有用なワークフローとしては、難しい計画について、より強力な推論モデルに評価を依頼し、合意された仕様と具体的なチェック項目をSonnetに与えるという方法があります。モデルの選択は段階ごとに変更可能です。些細な修正のたびに、最もコストのかかる推論タスクを実行する必要はありません。.
Sonnet 5.5をGlobalGPTに適用する
GlobalGPT があれば、このモデルをより広範な作業環境の一部として活用できます。ライティングや分析の段階では Claude Sonnet 5.5 を開き、プロジェクトに別の強みが必要になった時点で別のモデルに切り替えることができます。複数のサブスクリプション間でワークフローを再構築することなく、キャンペーンのブリーフ作成、コピーの推敲、ビジュアルの作成、動画の制作を行うことが可能です。.
より良い初期結果を得るためには、ソース資料と、ごく少数の受け入れ基準を併せて送ってください。文章の場合は、対象読者、長さ、口調、および変更してはならない事実を明記してください。コードの場合は、エラーが発生する例と期待される動作を提示してください。文書の場合は、ソースの各セクションにラベルを付け、バージョン間の矛盾が生じた場合の対処方法を明記してください。これら 執筆、調査、コーディングのためのヒント 再利用可能な出発点を提供します。.
開発者は、以下の方法を通じてターミナルのワークフローを連携させることもできます。 GlobalGPT CLI(Claudeコード付き). プロジェクト全体についてはウェブサイトを利用し、開発プロセスに合致する場面ではCLIを活用してください。その価値は、相互に連携したツール群にあり、次のタスクに応じてモデルを選択できる点にあります。.
知っておくべき制限事項とアップグレードの詳細
多大な努力は「選択」であり、「品質の保証」ではありません。. Sonnetは、狭い範囲の問題に過度に注力したり、要求された変更の範囲を超えて処理を行ったりすることがあります。スコープを維持し、関連するチェックを実行し、受け入れ基準が満たされた時点で処理を停止するよう指示してください。製品に工数管理機能が備わっている場合は、タスクの完了品質とコストを比較検討した上で、それらを増やすようにしてください。.
最新の事実であっても、やはり最新の情報源が必要です。. このモデルの知識のカットオフ時点は2026年6月であり、すべての価格、ポリシー、リリースに関する最新の情報を網羅しているわけではありません。最新の文書を提供するか、検索ツールを活用したワークフローをご利用ください。機密性の高い資料については、実際に利用しているサービスおよびアカウントのプライバシーおよび保存期間に関する規約を確認してください。モデル名によってこれらの設定が決まるわけではありません。.
APIの移行には、単にモデル名を置き換えるだけでは不十分です。. Sonnet 5.5 では、一部の古いリクエストパターンが変更されています。直接的な Claude API は、デフォルト以外の温度、top_p、および top_k の設定を拒否するため、従来の考え方や強制的なツール設定については更新が必要になる場合があります。 適応型思考がデフォルトとなっています。ドキュメントに記載されている between_tools モードでは、High effort 以下のレベルにおいて事前の思考が省略されます。現在の概要では、ツールの強制使用がエラーを返すこと、Claude API および Google Cloud では旧式のコンピュータ使用ツールが受け入れられないこと、ツール呼び出し間のテキストが思考ブロックとして返される可能性があることも記載されています。以下の内容を確認してください。 公式移行ガイド アプリケーションを移動する前に。当社の Claude APIガイド より広範な設定や課金に関する概念について解説しています。.
Anthropicでは、リスクの高いサイバーセキュリティや生物学関連の要求に対しても安全対策が適用されます。通常のソフトウェア開発は、引き続き本モデルの想定用途に含まれます。タスクが正当であるものの機密性の高いものである場合は、すべての拒否が一般的なコーディングの制限によるものと決めつけるのではなく、その範囲と権限を明確に説明してください。.
総評:日々のワークフローに取り入れるのに適したモデルだ
Sonnet 5.5は、実用的で検証可能な成果によってその価値を証明しています。このツールを利用する最大の理由は、Opusよりも低いAPIトークンコストで、優れたスコープ付きコーディングと実用的な文書処理が可能である点にあります。文章作成にも適しており、要件定義書には記載されていなかったが、現実味のある詳細について最終的なチェックを行うことができます。 私たちの小規模なテストセットは、この「日常業務向け」という位置づけを裏付けていますが、速度、コスト、あるいは複雑な推論において、普遍的な優位性を立証するものではありません。.
まずは、その成果を評価できる実際のタスクから始めましょう。制約条件を明確に定め、重要な詳細を確認し、問題の内容が変わったら別のモデルに移りましょう。. GlobalGPTでSonnet 5.5を試してみてください 執筆、コーディング、分析、そして次の創造的なステップを、1つのマルチモデル・ワークフローに統合すること。.
よくある質問
Claude Sonnet 5.5とは何ですか?
Claude Sonnet 5.5は、2026年9月28日にリリースされたAnthropicモデルです。テキストおよび画像の入力をサポートし、テキストを出力します。日常的なコーディング、執筆、文書作成、およびツールを活用したワークフローを迅速に行うために設計されています。.
Claude Sonnet 5.5の価格はいくらですか?
Anthropicの標準API料金は、入力トークン100万トークンあたり$2、出力トークン100万トークンあたり$10です。 キャッシュの読み取りには、トークン100万枚あたり$0.10の費用がかかります。ClaudeのアプリサブスクリプションおよびGlobalGPTのプランは、これらのAPI料金とは別途となります。.
Claude Sonnet 5.5は、Sonnet 5よりも速いのでしょうか?
Anthropicは、Sonnet 5に比べて30%以上も高速に出力を生成します。当社のGlobalGPTライティングテストでは、3つの完全な応答を生成するのに11.60~12.16秒かかりました。 対照実験としてSonnet 5を実行しなかったため、本テストでは世代間の速度向上を測定していません。.
Sonnet 5.5はOpus 5.5より優れていますか?
明確に定義されたタスクや、入出力トークンの単価を抑えたい場合は、Sonnet 5.5を選択してください。Opus 5.5は、継続的な判断力を要する複雑で自由度の高い作業において、より強力な出発点となります。Sonnetは一部の公開評価でトップの成績を収めていますが、どのモデルが万能であるというわけではありません。.
Claude Sonnet 5.5では、長文の文書を処理できますか?
Claude APIでは、100万トークンのコンテキストウィンドウが規定されています。13,078語という小規模な合成文書を用いたテストでは、Sonnetは条件を満たす16件のレコードをすべて選択し、正しい合計値を算出しました。ただし、この結果だけで、公表されているコンテキストウィンドウ全体にわたる精度が保証されるわけではありません。.
Claude Sonnet 5.5をGlobalGPTで使用することはできますか?
はい。GlobalGPTでは、Claude Sonnet 5.5をはじめとするさまざまなAIモデルが提供されているため、1つのプラットフォーム上で、下書きの作成、コーディング、文書の分析を行い、さらに画像や動画の作業へとスムーズに移行することができます。.
出典および試験に関する注記
発売時の仕様および価格は2026年10月13日に確認したものであり、以下の実機テストは2026年10月1日に実施された。主な参考資料: Anthropicの発売発表, Sonnet 5.5 モデル参照, API価格, そして クロードのサブスクリプション価格. 独立した文脈については、『Artificial Analysis』および上記リンク先のCodeRabbitの研究を参照のこと。.
GlobalGPTのテストでは、3つの課題における最初に完成した解答と、2つのライティング課題の再提出が使用されました。 外部ツールは一切使用されませんでした。測定時間は、ネットワークおよびサービスのオーバーヘッドを含めた完全な応答にかかる時間を対象としており、推論の労力値は選択されていません。請求書パケットは合成されたものであり、顧客データは含まれていませんでした。ヘッダーの図は本レビューのために生成されたものであり、その他の画像は指定されたウェブサイトのスクリーンショットです。.









