
簡単な答え: GPT-6 Solは、出力上限2,400トークンの条件下で、テスト対象となった5セクションからなる要約を完了しました。一方、短いコードレビュー課題では、Claude Opus 5.5の方がより正確な診断結果を示しました。いずれの結果も、決定的な総合優勝者を決定づけるものではありません。.
この比較の意義は、単なるスコア以上のものがあります。Claude Opus 5.5とGPT-6 Solは、文章作成、調査結果の統合、コードレビュー、構造化された回答、アクセス経路、そして日々のワークフローの扱い方に違いがあります。以下のタスク結果からは、そうした違いがどこで重要になるかがわかります。.
グローバルGPT 手頃な価格のマルチモデルサブスクリプションで、これら2つのモデルに加え、その他のモデルやAI機能も利用できます。1つのダッシュボードで、プロジェクトをリサーチや執筆からコーディング、画像、動画制作まで一貫して進めることができ、そのCLIにより、同じ作業環境をターミナルや本番環境のツールと連携させることができます。.
簡単な回答
「GPT-6 Sol」を選択してください まず、ここでテストした制約付きライティングワークフローについてですが、共有された2,400トークンの出力上限の範囲内で、5つのセクションすべてを完了しました。. Claude Opus 5.5 を選択してください 診断、明確なリスク分析、厳格なJSONがより重要になる場合。1日のうちに業務の内容が変わる場合は、両方を併用してください。.
各モデルの得意分野
Claude Opus 5.5 これは、コードの変更をレビューしたり、複雑で分かりにくい要件を整理したり、リスクを特定したり、厳格な成果物契約を維持したりといった、綿密な作業に適しています。Anthropicでは、コーディング、コンピュータの使用、知識労働、安全対策、そしてより自然な長時間のコミュニケーションなどを中心に位置づけています。詳しくは Claude Opus 5.5 レビュー モデルに焦点を当てた別の視点を得るためです。手短な最初の回答よりも、入念な再検討を行う方が価値がある場合には、これが自然な選択となります。.
GPT-6 Sol 制約のある作業量に適しています:長文の要約、意思決定メモ、体系的な計画、あるいは要求された多くのセクションを含める必要がある草案などです。OpenAIは、これを、専門的な業務、事実の正確性、コーディング、コンピュータの利用、および共同作業に適した、より手頃な価格のGPT-6モデルとして位置づけています。その GPT-6 Solのレビュー このモデル自体について解説しています。ここでの長文タスクでは、最初の出力で契約を完了させました。これは、欠落しているセクションのコストが高い場合に役立ちます。.
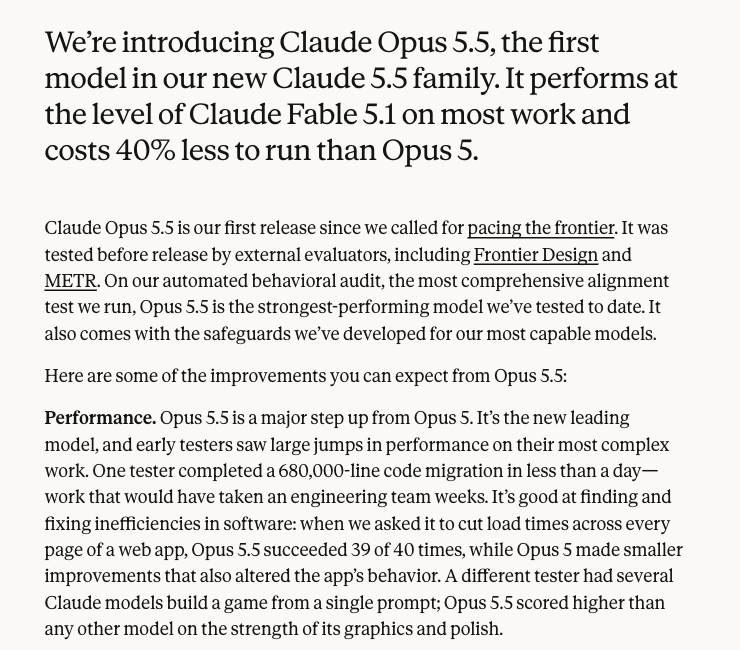
これは、初期のテスターによる事例を含め、Anthropicが独自にまとめたリリースに関する報告です。これは同製品の目指す方向性を裏付けるものであり、GPT-6 Solとの直接的な比較結果を提示するものではありません。以下に示す、両モデルに同一のプロンプトを与えた結果は、今回の実行において各モデルがどのような出力を返したかという、より限定的な問いに対するものです。.
機能・性能の比較
Claude Opus 5.5 対 GPT-6 Sol:能力マップ
| 意思決定領域 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| 長文執筆 | 慎重かつきめ細やかな文章作成と、明確な留意事項の記載に長けている | 長文で複数の制約条件を含む要件定義書を、一度の作業で完成させるのが得意 |
| 研究統合 | 詳細な照合およびリスクに関する説明 | 簡潔な要約と明確な推奨事項 |
| コーディングとレビュー | 正確な診断と体系的なリスク報告 | 実用的な最小限のパッチ;エッジケースの説明の妥当性を確認する |
| 構造化出力 | テスト対象のタスクにおける、信頼性の高い厳格なJSON | テスト対象のタスクにおいて、要求されたすべてのキーを含む有効なJSON |
| マルチモーダルとツール | 特定のタスクについて、ルートとモデルへのアクセス権限を確認してください | 特定のタスクについて、ルートとモデルへのアクセス権限を確認してください |
| 最適な働き方 | 熟考を要する検討、複雑な推論、およびリスクを考慮した業務 | 所定の出力上限の範囲内で、検証済みの制約付き要件仕様書を完成させた |
読み方: これらはワークフローの傾向であり、普遍的なランキングではありません。どちらが適切な選択かは、入念な確認を重視するか、それとも同じ出力上限内でこの密度の高いブリーフを完了させることを重視するかによって異なります。.
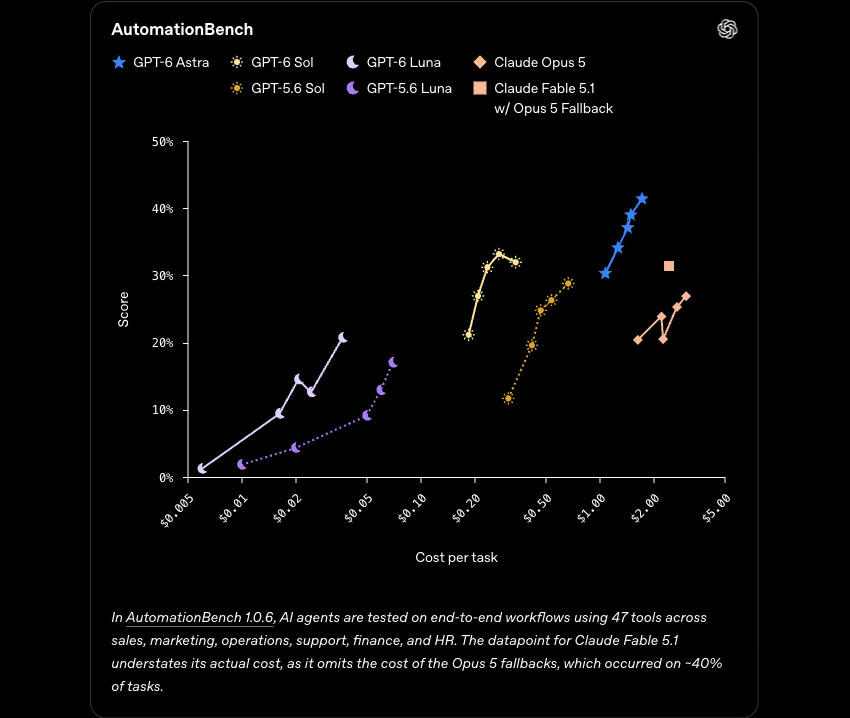
両方の軸に注目してください。上方向への移動はスコアが高いことを示し、左方向への移動はタスクあたりのコストが低いことを示しています。ここでのClaudeシリーズはOpus 5であり、Opus 5.5ではありません。この出版社が報告したグラフは、Solのコスト効率における位置づけを理解する助けにはなりますが、本記事における比較の決着をつけるものではありません。 また、脚注には、『Fable』のデータには一部のフォールバックコストが省略されているとも記載されています。.
執筆、長文の作成、および研究結果の統合
文章作成に関しては、このテストでは、固定された文字数制限下での完成度と、編集上の精査の質とを区別しています。長文の作成という課題では、GPT-6 Solの方が優れた結果を示しました。一方、診断、評価、説明を行う課題では、Claude Opus 5.5の方が優れた結果を示しました。 リサーチノートに関しては、両モデルとも実質的に同等の結論に達したため、どちらが表向きに勝ったかというよりも、依然としてソース資料の質とレビュープロセスの重要性が上回っている。.
- 制約の多い初稿の作成、意思決定メモ、または体系的なコンテンツ計画の作成には、GPT-6 Solをご利用ください。.
- Claude Opus 5.5 を使用して、前提条件を見直し、リスクを洗い出し、クライアントや本番システムに送る前に草案を練り上げましょう。.
- 事実が重要な場合は、どちらのモデルにもソース資料を提供し、人間による確認の工程を残しておくようにしてください。.
コーディング、構造化された出力、およびツール対応の作業
どちらのモデルも、要求されたすべてのキーを含む有効なJSONと、同じ最小限のパッチを返しました。Claudeは既存のフィルターを正しく説明しましたが、GPT-6 Solは「None要素があるとエラーが発生する」と誤って述べました。このことから、この特定のタスクにおける診断にはClaudeが適していることが裏付けられます。 プロンプトには risk フィールドの型が指定されていなかったため、Sol の risk 文字列は契約違反には該当しません。.
ツールで処理可能な成果物については、実際に必要な出力仕様を見極める必要があります。具体的には、有効なJSON形式、完全なフィールド、再現可能なコマンド、そして解釈を要せずに適用できるパッチなどです。どちらのモデルもそのパイプラインの一部となり得ます。その際、テストやレビューもプロセスに組み込まれます。.
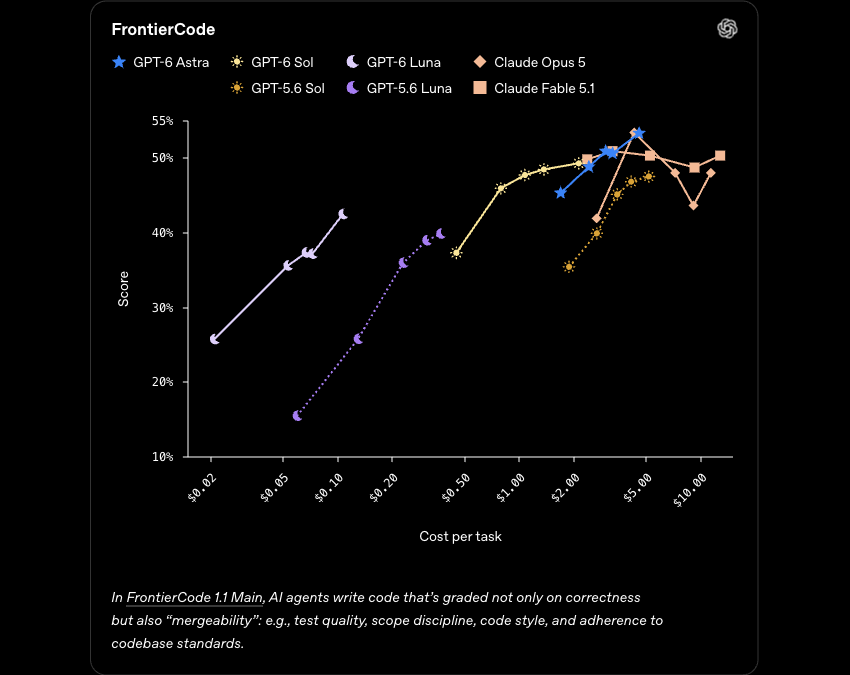
このベンチマークは、我々の短いコードレビュー用プロンプトよりも広範なエージェント的コーディングを対象としています。そのClaudeの比較対象はOpus 5であるため、これはSolがOpus 5.5を上回っているという証拠というよりは、Solのコーディングにおける位置づけを把握するための文脈として捉えるべきものです。我々のタスクにおいては、どちらのパッチも正しかったのですが、有用な違いは診断の正確性にありました。.
価格と利用方法
価格とアクセス:モデルだけでなく、ルートも比較しましょう
| ルート | お客様が支払っているもの | それが理にかなっている場合 |
|---|---|---|
| Claude Opus 5.5 API | Anthropicは、2026年9月22日付のリリースページにおいて、入力トークン100万個あたり$4、出力トークン100万個あたり$20、キャッシュ読み取りトークン100万個あたり$0.20と記載しています。 | 製品や自動化パイプラインを構築しており、トークンによる直接課金を希望しています |
| GPT-6 Sol API | OpenAIでは、入力トークン100万件あたり$2、出力トークン100万件あたり$10が設定されており、GPT-5.6 Solのプロモーション価格から50%の値引きが適用されます。また、キャッシュされた入力読み取りには90%の割引が適用されます。 | ダイレクトプロバイダーAPI契約が必要であり、継続的な作業における従量課金コストの削減を希望しています |
| グローバルGPT | 両モデルに加え、その他多数のモデルやAI機能も利用できる、手頃な価格のサブスクリプションプラン | リサーチ、執筆、コーディング、画像・動画編集の作業を1つのダッシュボードでまとめて行いたい |
これらの数値はAPIトークンの料金であり、サブスクリプション料金ではありません。 OpenAIは、GPT-6 Solを、専門業務、事実確認、コーディング、コンピュータ利用、コラボレーション向けのGPT-6ファミリーの中で低コストなモデルとして位置付けており、一方、Anthropicは、Claude Opus 5.5を、コーディング、コンピュータ利用、知識労働、安全性、コミュニケーションを中心に位置付けています。 GlobalGPTは、手頃な価格の1つのサブスクリプションを通じて、これら2つのモデルとその他のツールチェーンを利用可能にしており、そのCLIは、ターミナル、開発ワークフロー、および既存の運用ツールへのアクセスを連携させます。.
一次資料: AnthropicのClaude Opus 5.5リリースページ そして OpenAIのGPT-6 SolおよびLunaのリリースページ.
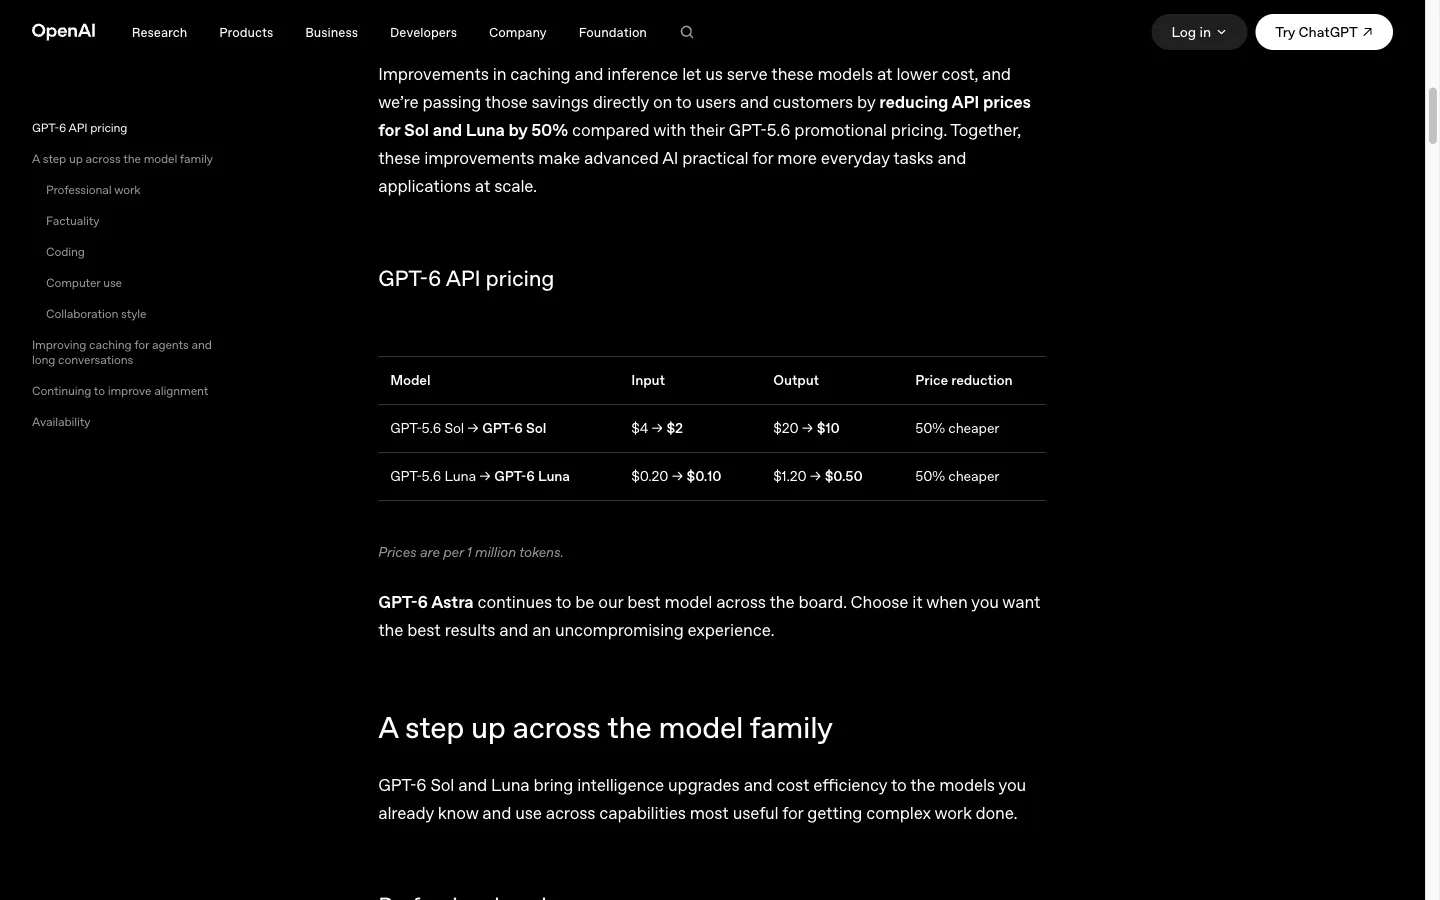
これらの料金はAPIトークンに適用されます。月額のコンシューマー向けサブスクリプションやGlobalGPTプランの料金については記載されていません。.
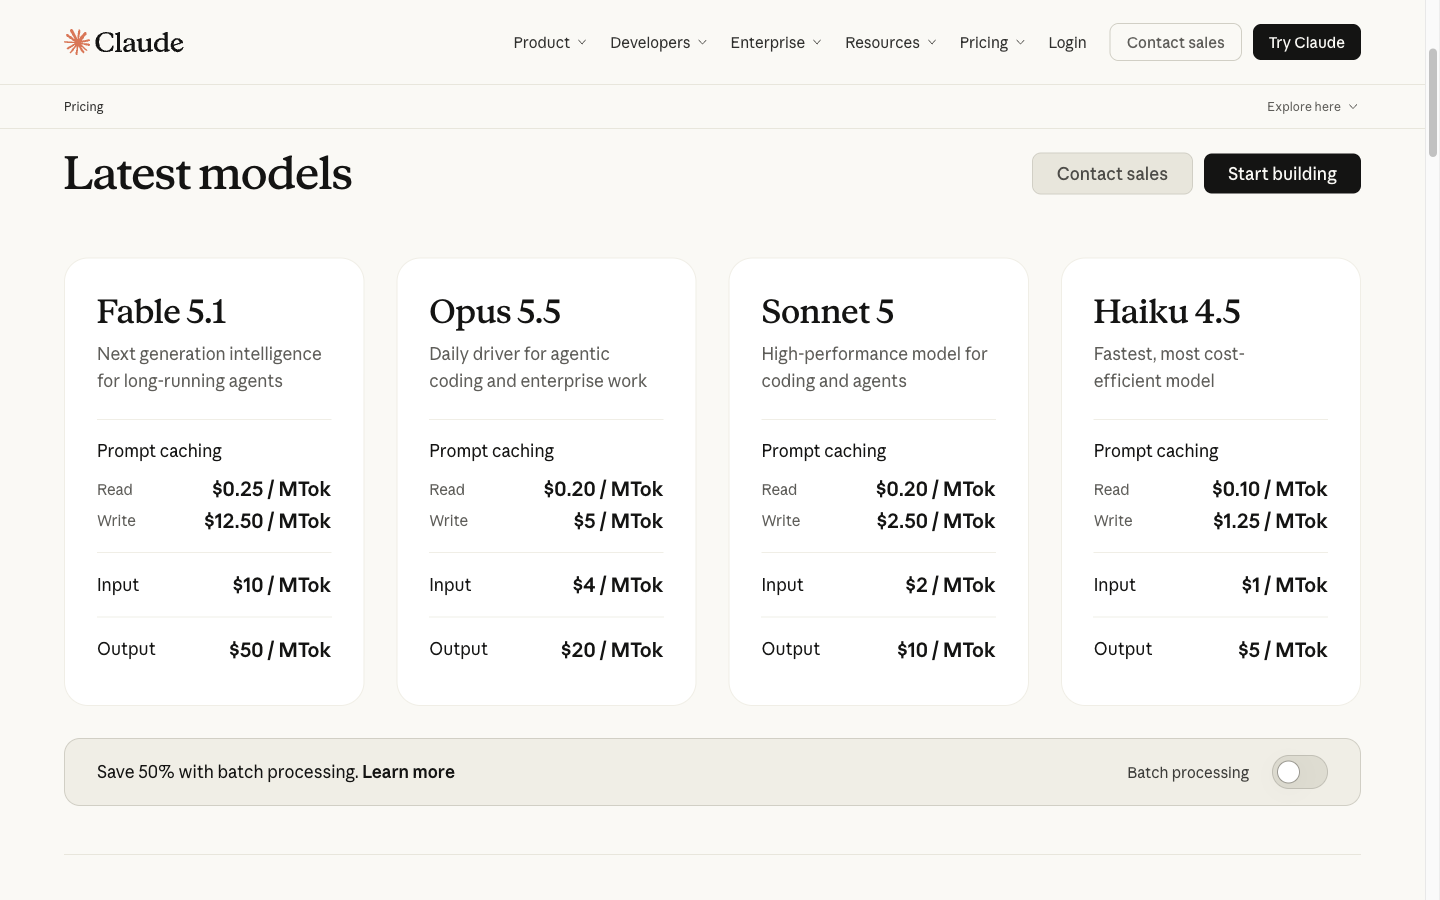
Opus 5.5の標準的な入出力レートはSolの2倍ですが、公表されているキャッシュ読み取りレートはいずれも$0.20/Mです。したがって、キャッシュを多用するワークフローとキャッシュを使用しないワークフローでは、コストの差が異なる可能性があります。価格を比較する際は、同じトークン構成で比較するようにしてください。.
同じワークロードにおいて、レート差が意味すること
計算例: キャッシュされていない入力トークン 100万個 + 出力トークン 10万個, 、標準APIレート。ティール色は投入コスト、ラスト色は産出コストです。.
このまったく同じトークン構成の場合、Solの費用は半分になります。これは料金表に基づく計算であり、完了したすべてのタスクの費用が半分になるという主張ではありません。再実行回数、出力長、キャッシュヒット率、ツール使用料、推論設定などによって、請求額は変動する可能性があります。.
出典: Anthropic APIの価格設定 そして OpenAIの発売価格, 2026年9月25日確認。.APIの直接コストを見積もる
API コスト計算ツール
送信および受信する予定のトークンを入力してください。 この見積もりでは、上記の検証済みAPIレートを使用しています:Claude Opus 5.5(入力:$4/M、出力:$20/M)、GPT-6 Sol(入力:$2/M、出力:$10/M)。.
| モデル | 入力レート | 出力率 | 推定コスト |
|---|---|---|---|
| Claude Opus 5.5 | $4 / M | $20 / M | $9.00 |
| GPT-6 Sol | $2 / M | $10 / M | $4.50 |
これは、APIを直接利用した場合のトークン課金による見積もりです。コンシューマー向けサブスクリプションやGlobalGPTプランの料金は算入されておらず、キャッシュ割引、ツール、税金、およびその他のプロバイダー固有の料金は含まれていません。.
どのモデルを選ぶべきなのは誰でしょうか?
どのモデルを選べばいいでしょうか?
| あなたの優先事項 | 先に選ぶ | なぜ |
|---|---|---|
| 多くの制約がある、洗練された長文のメモ | GPT-6 Sol | 改訂されたロングフォーム課題は、1回の出力で要求された決定ルールに達した |
| コード診断、厳格なJSON、および明示的なリスク | Claude Opus 5.5 | このコーディング作業により、より正確な診断とリスク評価が得られた。 |
| 照合が必要な研究ノート | どちらか | 制御されたソース合成課題では同点となった |
| 週ごとのワークフローの組み合わせ | GlobalGPT(両方とも) | モデルの選択、文書作成、コーディング、画像、動画を1つのダッシュボードにまとめて管理し、作業がターミナルに移行した際はCLIを使用します |
1つの完全なワークフローで両方のモデルを活用する
実用的な GlobalGPT ワークフロー
- まず調査概要から始め、あるモデルに対してその前提条件を明らかにしてもらう。.
- 整理した概要を、ドラフト作成やセカンドオピニオンのために、もう一方のモデルに移してください。.
- 実装、レビュー、および構造化された出力には、より堅牢なコーディング手法を採用してください。.
- 完成した作品を同じダッシュボードに保存し、その後、 GlobalGPT CLI ワークフロー ターミナルや本番用ツールに投入する必要がある場合。.
そのワークフローこそが、両方のモデルを利用することの最大の価値です。つまり、1つのモデルに合わせてプロセスを書き直すのではなく、タスクを適切に割り当てることができるのです。.

比較の実施方法
両モデルとも、同じシステムメッセージ、タスク入力、ソース資料を受け取り、ツールやブラウジングは一切行われませんでした。各結果には、出力制限による切り捨てを含め、最初に返された出力がそのまま反映されています。これは、ワークフローを選択するための実用的な比較であり、あらゆる機能に対する普遍的なランキングではありません。.
比較方法
この比較はどのように行われたか
| 状態 | 比較規則 |
|---|---|
| モデル | Claude Opus 5.5 および GPT-6 Sol。ライブモデルディレクトリ内で正確な ID が確認されました。 |
| プロンプトの整合性 | 同じシステムメッセージ、タスクのプロンプト、ソース資料。ツールやブラウジングはなし。 |
| タスク | T01 境界チェック、T01R 明示的な長形式比較、T02 ソース合成、T03 コード/JSON |
| 再試行 | 転送・容量・空のエンベロープに関するエラーのみ。有効な弱い出力は保持される |
| 得点 | 達成したタスクごとに10点:目標達成度4点、トレーサビリティ3点、有用性2点、形式1点 |
最初のプロンプトは、重要なコンテキストが欠落している場合にモデルが推測できるかどうかを確認するため、優勝モデルの算出とは別に行われます。直接比較では、両方のモデルを指定し、同じブリーフを与えています。安定性確認のための再実行は行われませんでした。.
なぜ最初のプロンプトでは勝者が選ばれなかったのか
コンテキストの処理
なぜ最初のプロンプトでは勝者が選ばれなかったのか
どちらのモデルも、元のプロンプトに名前が明記されていなかったため、モデルのアイデンティティを創作することを拒否しました。これは文脈が欠落している場合における適切な対応ですが、作業そのものにおいてどちらのモデルが優れているかを判断する手がかりにはなりません。.
Claude Opus 5.5 · フル入力
実用的な購入ガイドのために、2つのAIモデルを比較しています。以下のソースパケットのみを用いて、以下の見出しを正確に盛り込んだ700~900語の文章を作成してください:「決定」、「根拠」、「注意点」、「次のステップ」。 以下の事実を正確に反映させてください:「プロジェクト・ノース」の期限は12週間、移行予算は$48,000、セキュリティレビューの日程は未定です。事実が不明確な場合は、その旨を明示してください。価格、ベンチマーク、製品の機能については、架空のものを創作しないでください。

ソース資料:
プロジェクト・ノースは、40人のチームによる12週間の移行プロジェクトである。承認済みの移行予算は$48,000である。セキュリティレビューの実施時期は未定である。チームは、調査、文書作成、およびコードレビューのためのモデル推奨案を求めている。 ステークホルダーからのメモには、現在の草案が長すぎるとあるが、文字数は明記されていない。

ガイドのみを提出すること。.
Claude Opus 5.5 · フル出力
## 決定

提供された情報源のパケットからは、2つのモデルのいずれかを推奨することはできません。このパケットには、モデルの名称や価格、ベンチマーク結果、製品の機能などが一切記載されていません。現時点でどちらか一方のモデルを選択することは、本ガイドが依拠すべき根拠をでっち上げることに等しいでしょう。

現実的な判断としては、モデル選定を保留とする。次のフェーズを、以下の3つの固定された制約条件に基づいて行われる体系的な評価と位置付ける。

- プロジェクト・ノースの期限は12週間である。
- 移行予算は$48,000である。
- セキュリティレビューの日程は未定である。

採用されるモデルは、12週間の期限と$48,000の移行予算の範囲内に収まるものでなければならない。 また、セキュリティレビューに合格する必要があり、そのレビューはまだ予定に組み込まれていません。2つのモデルが特定され、チームが提示した3つの用途(調査、執筆、コードレビュー)に対して評価されるまでは、選定は未解決のままです。本ガイドは、証拠によって裏付けられない優先順位を示すのではなく、この点を率直に述べています。

## 根拠

ソースパケットには以下の事実が含まれており、本ガイドはこれらの事実のみに基づいて作成されています:

- **範囲とスケジュール:** プロジェクト・ノースは12週間の移行プロジェクトです。
- **チーム規模:** この移行は40人のチームを対象としています。
- **予算:** 承認された移行予算は$48,000である。
- **セキュリティ:** セキュリティレビューの実施時期は未定である。
- **ユースケース:** チームは、調査、文書作成、およびコードレビューに向けたモデル推奨を求めている。
- **ステークホルダーからのフィードバック:** ステークホルダーからの注記によると、現在の草案は長すぎるとのことですが、文字数については言及されていません。

この資料には、通常、比較を行う際に必要となる情報がいくつか欠けています。比較対象となる2つのモデルが特定されていません。 また、いずれのオプションについても、1 席あたり、1 トークンあたり、あるいはサブスクリプション形式の価格設定が明記されていません。ベンチマークスコアや内部テストの結果も提供されていません。さらに、研究、執筆、コードレビューにおいて、各モデルで何が可能で何が不可能かについても説明されていません。データ取り扱い条件、導入オプション、統合要件についても一切言及されていません。

これらの項目はいずれも資料に記載されていないため、本ガイドではそれらについて推定を行いません。40人のチームに対する$48,000の予算内に、いずれのモデルが収まるかは不明です。また、研究、執筆、コードレビューのいずれにおいて、どちらのモデルがより優れたパフォーマンスを発揮するかも不明です。ここに数字や機能に関する主張を追加することは、でっち上げに他なりません。

## 注意事項

この決定をどのように解釈すべきかについては、いくつかの未解決の疑問が影響を及ぼしています。

**モデルの特定は未解決です。** 比較の対象は2つのAIモデルですが、資料にはそれがどのモデルであるかは明記されていません。その後のあらゆる判断は、まずこの点を明確にすることに依存します。

**予算の範囲は未確定である。** 資料では、$48,000という数値を「承認済み移行予算」と呼んでいる。その金額がモデルのライセンス料や利用料を賄うものなのかどうかは明記されていない。あるいは、スタッフの工数、ツール、サービスといった移行作業のみを賄うものかもしれない。 もしモデル費用を同じ$48,000から捻出する必要がある場合、いずれのモデルについても、見出しの数字が示唆するよりもコストの余裕幅は狭くなります。この点については確認が必要です。

**セキュリティレビューの実施時期が未確定であり、スケジュール上のリスクとなっています。** セキュリティレビューの日程は設定されていません。 12週間という期限を考えると、スケジュール未定のレビューはタイムラインにとって現実的なリスクとなります。資料には、レビューにどれくらいの時間がかかるか、あるいはレビューに不合格となった場合に別のモデルへの切り替えが強制されるかどうかについては記載されていません。どちらの結果も、12週間のうちかなりの時間を費やす可能性があります。レビューが完了するまでは、どのモデルも承認済みと見なすべきではありません。

**ユースケースの重み付けが未確定です。** チームは、研究、執筆、コードレビューの3つの用途を挙げています。資料には、これらが同等に重要なのか、あるいはいずれかが主たるものなのかが明記されていません。ある分野で優れたモデルは、別の分野では劣っている可能性があり、重み付けがなければ、これらをトレードオフする根拠がありません。

**利用量については未解決である。** チームは40名で構成されているが、資料には何人がモデルを利用するか、またどの程度の頻度で利用するかについては記載されていない。一部の価格体系では、利用量がコストに大きな影響を与える可能性がある。価格データと利用量の推定値がなければ、これを評価することはできない。

**期間に関する指示は...
GPT-6 Sol · 入力全文
実用的な購入ガイドのために、2つのAIモデルを比較しています。以下のソースパケットのみを用いて、以下の見出しを正確に盛り込んだ700~900語の文章を作成してください:「決定」、「根拠」、「注意点」、「次のステップ」。 以下の事実を正確に反映させてください:「プロジェクト・ノース」の期限は12週間、移行予算は$48,000、セキュリティレビューの日程は未定です。事実が不明確な場合は、その旨を明示してください。価格、ベンチマーク、製品の機能については、架空のものを創作しないでください。

ソース資料:
プロジェクト・ノースは、40人のチームによる12週間の移行プロジェクトである。承認済みの移行予算は$48,000である。セキュリティレビューの実施時期は未定である。チームは、調査、文書作成、およびコードレビューのためのモデル推奨案を求めている。 ステークホルダーからのメモには、現在の草案が長すぎるとあるが、文字数は明記されていない。

ガイドのみを提出すること。.
GPT-6 Sol · 出力全文
## 決定

現時点では、最適なモデルを特定しないこと。ソースパケットでは2つのAIモデルのうちどちらを推奨すべきか尋ねているが、いずれのモデルについても具体的な説明がなく、調査・執筆・コードレビューの結果も提示されていない。したがって、どちらかが優れているという主張は根拠がない。 実用的な推奨事項としては、選定を行う前に、2つの候補モデルをチーム自身の作業内容と比較検討することです。

プロジェクト・ノースの期限は12週間です。移行予算は$48,000です。セキュリティレビューの日程は未定です。これらの事実により、決定は時間的制約を伴いますが、それだけで推測による決定を正当化することはできません。 適切な選択を行うには、そのモデルが40人のチームが実際のタスクを完了するのに役立つかどうか、その使用が承認された予算内に収まるかどうか、そしてセキュリティレビューの時期が判明するまで不確実な点が残っているかどうかを考慮する必要があります。

推奨事項は条件付きとして扱うこと:代表的な作業においてより優れたパフォーマンスを発揮し、承認された移行予算の範囲内で使用可能であり、かつ意図された用途に必要な審査をすべて通過できるモデルを選択する。いずれの候補もこれらの条件を満たさない場合、ガイドでは「現時点ではどちらも推奨できない」と明記すべきである。入手可能な資料からは、いずれの条件も満たされているとは断定できない。

## 根拠

チームは、研究、執筆、コードレビューという3種類の業務に対するモデルの推奨を求めている。これらは、想定される製品の強みではなく、明示されたニーズに基づいているため、適切な比較カテゴリーである。 提出資料には、いずれのモデルの出力例も、評価結果も、2つの候補が何を提供するかについての説明も含まれていない。また、価格やベンチマークも記載されていない。その結果、精度、速度、品質、コスト、または適合性に基づいてモデルをランク付けするための証拠基盤が存在しない。

プロジェクトの背景からは、有用な決定基準が得られる。 プロジェクト・ノースは40人のチームを対象とした移行プロジェクトであるため、比較にはそのチームのメンバーが実際に遂行するタスクが反映されるべきです。承認された移行予算は$48,000であり、モデルの導入提案は、AIツール用に架空に設定された予算枠ではなく、この金額を基準に評価されなければなりません。 セキュリティレビューの日程は未定であり、レビューの実施時期――およびそれが導入に与える影響――は未解決のままとなっている。

あるステークホルダーは、現在の草案が長すぎると述べているが、単語数は提示していない。これは簡潔さを好むという証拠であり、モデル出力の測定可能な制限ではない。 執筆サンプルを比較する際、審査員は各候補者が「簡潔にする」という要請に従い、本質的な事実を保持しているかどうかを評価できる。ステークホルダーが指定した文字数制限は提示されていないため、いずれのモデルもその制限を満たしていると主張すべきではない。

研究においては、各候補者が提示された事実と未解決の疑問を区別し、根拠のない結論を避けているかどうかが有用な評価基準となる。 文章作成においては、各モデルが制約条件を逸脱することなく、明確で適切に簡潔な草案を生成しているかどうかが有用な証拠となる。コードレビューにおいては、各モデルが提供された例題の問題点を特定し、レビュー担当者が確認できる形で説明しているかどうかが有用な証拠となる。これらは提案されたテストであり、いずれのモデルに関する結論ではない。

## 留意点

最大の留意点は、候補自体が決まっていないことです。資料にはその名称が記載されていません。また、チームがそれらにどのようにアクセスするか、費用はいくらか、あるいは意図された業務にどちらかが利用可能かについても言及されていません。 「AIモデル」という表現から、製品の機能性を推測してはなりません。たとえ綿密に設計された比較であっても、候補モデルや評価の根拠が明らかになるまでは、製品の推奨を行うことはできません。

移行予算は承認されていますが、資料にはその予算の一部がモデルの利用やテストに割り当てられているという記載はありません。 $48,000をAI購入予算として扱ってはならない。同様に、12週間という期限は、セキュリティレビューが行われる期日を確定するものではない。セキュリティレビューの日程が未定であるため、候補モデルがチームの要件の下で利用可能かどうか、またその時期については未解決のままである。

また、要求された3つの用途によって、異なる結果が生じる可能性もあります。ある候補は、あるタスクには適していても、別のタスクには適さない場合があります。この資料には、調査、執筆、コードレビューのすべてにおいて単一の最良候補が存在すると仮定する根拠は示されていません。 推奨事項では、こうしたトレードオフを全体的なラベルの中に隠すのではなく、明確に示すべきです。チームが特定のカテゴリーを他よりも重要であると判断する場合、その優先順位は本ガイドではなく、ステークホルダーから示されるべきものです。

最後に、草案が長すぎるという指摘を、モデルの性能に関する証拠と誤解してはなりません。 これは現在の草案に対するフィードバックを記述したものであり、著者を特定したり、目標の長さを示したりするものではありません。最終的な推奨事項の提示方法の参考にはなりますが、比較の決着をつけるものではありません。

## 次のステップ

2人の候補者を特定し、チームに研究、執筆、コードレビューの各タスクの代表的な例を依頼します。 各タスクについて、不確実性を明記し、事実を追加しないよう指示することを含め、各モデルに同じ資料と指示を与える。レビュー担当者に、各回答の正しい点、見落としている点、および検証が必要な主張を記録させる。優れた執筆サンプルがコードレビューに関する証拠の代わりにならないよう、タスクごとの観察結果は別々に管理する。

選定前に、$48,000の移行予算に対して、想定される利用にかかるコストを確認し、セキュリティレビューがいつ実施可能かを確定してください。その答えは資料の中に含まれていません。これらの疑問が意思決定までに解決できない場合は、暫定的な選好を承認済み選択肢として提示するのではなく、その制約を率直に報告してください。

そうすれば、最終的な購入推奨事項は簡潔かつ監査可能なものになります。候補を挙げ、3つの用途それぞれに対する根拠を述べ、トレードオフを説明し、未解決の承認や予算に関する問題を特定します。 その情報が揃うまでは、プロジェクト・ノースに対する正直な答えは「モデルA」でも「モデルB」でもありません。それは、比較がまだ証拠によって裏付けられていない、ということです。.
これは品質の順位付けではなく、文脈に応じた対応のチェックとして捉えてください。.
長文執筆
同じ2,400トークンの発行上限の下での完了
この同じ課題では、5つのセクションが求められていました。どちらのモデルも出力上限は2,400トークンでしたが、返されたメタデータを見ると、その目に見える違いが説明されています。.
Claudeは、判定ルールが適用される前に、設定された出力上限に達しました。Solはその上限の範囲内で要約を完了しました。これは、この制約付きの実行に対する推奨事項を示すものであり、執筆能力や速度の一般的な順位付けを示すものではありません。切り詰められた応答を含む、返されたテキストの全文を以下に保存しています。.
長文課題
長文執筆:GPT-6 Solが課題を完了しました
これが最初の直接比較課題です。プロンプトには、次のように明示的に記載されていました。 Claude Opus 5.5 そして GPT-6 Sol, 、両者に同じ「プロジェクト・ノース」の説明資料一式を配布し、条件付き決定メモの提出を求めました。.
| 測定 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| 可視長さ | 648語;finish_reason=長さ | 1,065語;finish_reason=stop |
| 必須項目 | 5件中4件;切り捨て後に決定ルールが欠落している | 5/5 |
| 4列のスコアカード | 現在形かつ対称形 | 現在形かつ対称形 |
| パイロットチェック/停止条件 | 開始したが、完了する前に打ち切られた | 3つのチェックと1つの停止条件 |
| スコア | 7.0 / 10 | 10.0 / 10 |
収穫だ: 出力上限を同じ2,400トークンに設定した場合、GPT-6 Solは5つのセクションすべてを出力したのに対し、Claude Opus 5.5は「Decision」ルールに到達する前に上限に達した。これは、この設定下での処理完了状況を示すものであり、いずれのモデルの最大執筆能力や一般的な処理速度を示すものではない。.
共有された完全な入力
Claude Opus 5.5 と GPT-6 Sol のどちらを採用するか検討しているチーム向けの決定メモを作成してください。モデル名は固定されており、記載された通りに正確に記載する必要があります。以下の証拠資料のみを用いて、900~1100語の文章を作成し、以下のセクションを正確に含めてください:経営陣への提言; 証拠が裏付ける内容;証拠が不足している点;30日間のパイロット運用;決定基準。

要件:(1) Claude Opus 5.5とGPT-6 Solを対称的に比較すること;(2) 観察された証拠、仮定、および未知の要素を区別すること; (3) 正確な日付、予算、チーム規模、および未解決のセキュリティ状況を維持すること;(4) 研究の統合、長文執筆、コードレビュー、構造化されたJSONを網羅した簡潔な4行のスコアカードを含めること;(5) 勝者をでっち上げるのではなく、条件付きの推奨案を示すこと; (6) 測定可能なパイロット検証項目を3つと中止条件を列挙すること;(7) 価格、ベンチマーク、コンテキストの制限、または製品の機能について、架空の数値を提示しないこと。

証拠資料
- プロジェクト・ノースは、40人のチームによる12週間の移行プロジェクトである。
- 承認済みの移行予算は$48,000である。この資料には、モデルの使用料がこの予算内に含まれるかどうかは明記されていない。
- セキュリティレビューの実施時期は未定である。
- チームには、研究結果の統合、長文作成、コードレビュー、および構造化されたJSONの抽出が必要である。
- あるステークホルダーは、現在の草案が長すぎると指摘しているが、目標となる文字数は承認されていない。
- Claude Opus 5.5またはGPT-6 Solからの管理された出力結果は、まだ提供されていない。
- チームは検証可能な選択肢を求めており、同一のプロンプトと人間によるレビューを用いた30日間のパイロット運用を実施可能です。

メモのみを返却してください。証拠資料がどちらのモデルが優れているかを証明しているとは主張しないでください。.
Claude Opus 5.5 · 出力結果の完全な一覧
## 経営陣への提言

現時点では、Claude Opus 5.5 および GPT-6 Sol を選択しないでください。証拠資料には、いずれのモデルからの制御された出力も含まれていません。したがって、4つの必須ワークロードのいずれにおいても、一方を他方より優れていると断定できる実証的な根拠はありません。

この推奨事項は条件付きである。両モデルに同一のプロンプトを与え、同じ人間によるレビューを適用する30日間のパイロット試験を実施すること。その後、以下のセキュリティおよび予算に関する問題が事前に解決されていることを条件として、パイロット試験開始前に合意された閾値を満たすモデルを選択すること。考えられる結果は以下の3つである:

- **1つのモデルが閾値を満たした場合:** そのモデルを選択する。
- **両方が閾値を満たした場合:** 決定ルールに記載された同点時の決着基準を適用する。
- **どちらも閾値を満たさない場合:** どちらのモデルも採用しない。

このアプローチにより、チームが求めていた、監査可能な選択が可能となります。

確定しているプロジェクトの事実は以下の通りです:

- プロジェクト・ノースは、40人のチームによる12週間の移行プロジェクトです。
- 承認された移行予算は$48,000です。資料には、モデルの使用料がこの予算に含まれるかどうかは記載されていません。
- セキュリティ審査のスケジュールは未定です。
- 資料には具体的な日程(プロジェクトの開始日、終了日、パイロット実施期間など)が記載されていないため、本メモではそれらを割り当てない。

## 証拠が裏付ける内容

**確認された証拠。** これらは資料に直接記載されている事実である:

- プロジェクト・ノースは、40人のチームによる12週間の移行プロジェクトである。
- 承認された移行予算は$48,000であり、モデル使用が予算に含まれるかどうかは明記されていない。
- セキュリティレビューのスケジュールは未定である。
- 必要なワークロードは、研究の統合、長文執筆、コードレビュー、および構造化されたJSONの抽出である。
- あるステークホルダーは、現在の草案が長すぎると述べているが、目標となる文字数は承認されていない。
- Claude Opus 5.5またはGPT-6 Solからの管理された出力は提供されていない。
- チームは監査可能な選択を求めており、同一のプロンプトと人間によるレビューを用いた30日間のパイロット実施が可能である。

**これが裏付けること** この証拠は、何をどのように評価すべきかを定義しているが、どのモデルが優れているかまでは定めていない。これは、構造化された並行比較パイロットの実施を正当化するものである。 いずれのモデルについても、品質、速度、コスト、文脈処理、または機能の可用性に関するいかなる主張も正当化するものではない。

**スコアカード(証拠の現状)**

| ワークロード | Claude Opus 5.5 | GPT-6 Sol | パイロット測定項目 |
|---|---|---|---|
| 研究の統合 | 制御された出力は提供されていない | 制御された出力は提供されていない | ブラインドレビューアによる評価基準スコア |
| 長文執筆 | 制御された出力は提供されていない | 制御された出力は提供されていない | 評価基準スコアに加え、承認された文字数目標への準拠度 |
| コードレビュー | 制御された出力は提供されていない | 制御された出力は提供されていない | 特定された既知の問題の割合 |
| 構造化JSON | 制御された出力は提供されていない | 制御された出力は提供されていない | スキーマ検証の合格率 |

資料では両モデルが同一に扱われているため、両モデルのすべてのセルは同一です。現時点で、いずれのモデルを優位とする行はありません。

## 証拠が欠落している箇所

**不明点。** 資料には、以下の各点について言及がありません:

- モデルの利用コストが $48,000 の移行予算内に収まるのか、それとも別途の資金が必要なのか。
- セキュリティレビューがいつ行われるか、その対象範囲は何か、そしてどちらのモデルもその基準を満たしているか。両モデルともセキュリティ状況は未確定である。
- 12週間の移行および30日間のパイロット実施の具体的な日程。
- 長文作成における承認済みの目標文字数。これがないと、ステークホルダーからの「長すぎる」というコメントを評価できない。
- Claude Opus 5.5およびGPT-6 Solの価格、ベンチマーク結果、コンテキスト制限、および製品機能。いずれも提供されておらず、本メモではこれらを前提としていない。
- 人間によるレビュー担当者の身元、人数、およびレビュー担当者間の意見の不一致をどのように解決するか。
- セキュリティレビューが完了する前に、パイロットでどのようなデータを使用できるか。

**前提条件。** これらは本メモにおける提案であり、資料に含まれる事実ではありません。また、それぞれについてチームの承認が必要です:

- セキュリティレビューにより実データの使用が許可されるまで、パイロットでは機密性のないデータまたは合成データを使用できる。
- レビュー担当者は、各出力を生成したモデルを特定できないようにすることができる。
- チームは、Project Northの実際のタスクを反映した、各ワークロード向けの固定プロンプトセットを構築できる。
- 以下で提案する合格基準は出発点であり、チームはパイロット開始前に変更できるが、実施中は変更できない。

## 30日間のパイロット

**設計**

1.
GPT-6 Sol · 返された出力全文
## 経営陣への提言

現時点では、Claude Opus 5.5 または GPT-6 Sol を選択しないでください。 プロジェクト・ノースは40名のチームを対象とした12週間の移行プロジェクトであり、提供された資料にはいずれのモデルからの管理された出力結果も含まれていない。したがって、本資料はパフォーマンスの評価ではなく、比較計画を裏付けるものである。利用可能な30日間のパイロットテストを、同一のプロンプトと人間によるレビューの下で実施し、結果を検証する前に合意された基準に基づいて、監査可能な選択を行うこと。 いずれかのモデルを選択するのは、そのレビュー済みの成果物がチームのニーズを満たし、その使用が承認された財務計画に合致し、かつ未解決のセキュリティレビューが導入を許可する場合に限る。これらの条件が満たされない場合は、不完全な比較を成功とみなすのではなく、選定を延期すること。

承認された移行予算は$48,000です。資料には、モデルの使用が当該予算内に収まるかどうかは明記されていません。セキュリティ審査のスケジュールも未定です。これらはClaude Opus 5.5とGPT-6 Solの双方に共通する意思決定上の制約であり、いずれかを優先する根拠にはなりません。

## 証拠が裏付けること

**観察結果:** チームには、研究の統合、長文作成、コードレビュー、および構造化されたJSONの抽出が必要である。チームは監査可能な選択を求めており、同一のプロンプトと人間によるレビューを用いた30日間のパイロット運用を実施できる。 あるステークホルダーは、現在の草案が長すぎると指摘しているが、目標となる文字数は承認されていない。このフィードバックは、出力文の検証すべき課題を特定するものであり、推奨されるモデルや許容可能な長さを決定づけるものではない。

現在のタスクごとのスコアカードは、意図的に順位付けされていない:

| ワークストリーム | Claude Opus 5.5 | GPT-6 Sol | 収集すべきパイロット試験の証拠 |
|---|---|---|---|
| 研究の統合 | 未検証 | 未検証 | レビューアによる精度、網羅性、およびトレーサビリティの評価 |
| 長文執筆 | 未検証 | 未検証 | 査読者による有用性、明瞭性、簡潔性の評価 |
| コードレビュー | 未検証 | 未検証 | 査読者による検証済みの所見および根拠のない主張 |
| 構造化JSON | 未検証 | 未検証 | 有効な出力および正しいフィールド抽出 |

**計画上の仮定であり、実測結果ではない:** 比較可能な作業サンプルと共通の評価基準を用いることで、Project Northに関連する差異を明らかにできる。パイロット試験では、この仮定を検証すべきである。 プロンプトが同一であるだけでは、選択の妥当性を検証することはできません。チームは、入力データ、両方の出力、レビュー基準、レビュー担当者の判断、および除外や再実行の理由もすべて記録しておく必要があります。人間によるレビューでは、各モデルに対して同じ基準を適用すべきです。

長文のライティングについては、審査員は「長すぎる」と「役に立たない」を区別すべきである。短い回答には必要な内容が欠けている可能性があり、長い回答でも明確で有用な場合がある。目標となる文字数は承認されていないため、パイロット試験では長さと審査員の判断を記録することはできるが、事後的に恣意的な文字数を合格基準として定めるべきではない。 他のタスクについても同様の原則が適用されます。審査員の好みを、モデル全体の能力に関する主張に変換するのではなく、審査員が観察した内容を記録するようにしてください。

## 証拠が欠落している点

**不明点:** この資料には、Claude Opus 5.5 または GPT-6 Sol からの制御された出力結果が含まれていない。4つのワークストリームのいずれに対しても、相対的な品質、信頼性、または適合性を立証するものではない。 また、価格、コンテキストの制限、ベンチマーク、製品機能に関する情報も一切記載されていない。したがって、このメモでは利用コストを見積もることも、プロジェクト・ノースの資料に対してどのモデルがより優れたパフォーマンスを発揮するかを推測することもできない。

購入決定を行う前に、予算の範囲を明確にする必要がある。 $48,000は承認済みの*移行*予算であり、モデルの利用料をこの予算から支払う必要があるかどうかは明記されていない。これを予算に含まれるものとみなすか、追加費用とみなすかによって、この資料では裏付けられない財務上の仮定が生じる。チームは、継続的な利用を決定する前に、その回答と適用される承認プロセスを文書化すべきである。

セキュリティについても、両候補モデルとも未解決のままです。セキュリティレビューのスケジュールは未定であり、資料にはセキュリティに関する結果も記載されていません。パイロット試験で良好な結果が得られたとしても、この状況は解消されません。チームは、誰がレビューのスケジュールを立て決定できるか、レビュー担当者がどのような情報を必要とするか、そして適用される規則の下でパイロット活動自体が許可されているかどうかを特定する必要があります。資料にはこれらの質問に対する回答が記載されていません。 移行、パイロット、およびセキュリティレビューについて、開始日や終了日の予定が示されていないため、チームは、30日間のパイロット期間内や12週間の移行期間内にセキュリティに関する決定が下されることを示唆してはならない。

## 30日間のパイロット

最初の比較を行う前に、チームは4つのワークストリームすべてについて代表的なプロンプトを選択し、各応答の期待される形式を定義し、人間によるレビューの評価基準について合意する必要があります。両方のモデルに同一のプロンプトと、同じレビュー指示を与える必要があります。 評価者は、モデルの評判ではなく、成果物そのものに対して判断を下すようにしてください。後続の読者が各判断を再現できるよう、プロンプト、出力、評価、および要求された修正内容をすべて保存してください。困難なケースを黙って除外するのではなく、標準的なプロセスからの逸脱を記録してください。

以下の3つの測定可能なチェック項目を使用してください:

1. **審査済みタスクの品質:** 研究の統合、長文執筆、コードレビューについては、審査者が指定されたタスクに対して承認した出力の割合を算出する。また、却下理由(例:網羅性の欠如、文章の不明瞭さ、検証されていないコードレビューの結果など)も別途記録する。結果を単一の統合スコアとしてではなく、ワークストリームおよびモデルごとに報告する。
2. **構造化JSONの信頼性:** 合意された構造に一致する出力と、抽出されたフィールドがレビューアによって正しいと検証された出力をカウントする。Claude Opus 5.5とGPT-6 Solの両方の率を報告すること。構造的に有効な回答であっても、単にパースできたという理由だけで正確であるとカウントしてはならない。
3. **レビューの労力とトレーサビリティ:** 各出力を確認し、必要に応じて修正するために要した人的工数を記録してください。レビュー担当者の判断を説明するのに十分な証拠が残されていないケースをカウントしてください。両方の出力が許容できないケースも含め、同じプロンプトセットについてこれらの指標を比較してください。

パイロット結果を確認する前に、合格基準および同点時の処理方法について合意しておくこと。本資料には、数値的な閾値を導き出すためのベンチマークは含まれていない。30日経過後、評価基準、集計結果、審査員の理由、および未解決の質問を公開すること。 **中止条件:** パイロットまたはその後の利用におけるセキュリティ要件を満たせない場合、あるいはチームが妥当な予算と承認プロセスを確立できない場合は、導入を一時停止すること。いずれの承認についても、良好な品質スコアを代用してはならない。

## 決定ルール

Claude Opus 5.5は、そのパイロット試験の証拠が事前に合意された基準を満たし、チームが優先するワークストリームにおいて実質的に優れており、かつセキュリティおよび財務上の条件が解決されている場合に選択する。GPT-6 Solに対しても、まったく同じルールを適用する。 両方が基準を満たし、かつ実質的かつ関連性のある差異がない場合は、パフォーマンスの優劣を主張するのではなく、文書化されたプロジェクトの優先順位と解決済みの制約条件に基づいて決定する。いずれも基準を満たさない場合、あるいは予算の枠やセキュリティ状況が未解決のままの場合は、現時点ではモデル選定を行わない。この結果により、証拠が裏付ける範囲を超えて主張することなく、40名のチームにとって監査可能な決定が維持される。.
メタデータ: Claude — HTTP 200 · 25.98秒 · finish_reason=length · prompt_tokens=598 · completion_tokens=2400
GPT — HTTP 200 · 27.763秒 · finish_reason=stop · prompt_tokens=386 · completion_tokens=1695
ソース合成
研究課題
ソース合成:引き分け
どちらのモデルも、日付の不一致を10月15日として解決し、合意された$12,000の予算を維持し、「常に正確」という主張を、根拠のない管理者の主張として扱った。その結果、このタスクでは引き分けとなった。.
| 測定 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| スコア | 9.5 / 10 | 9.5 / 10 |
| 競合の処理 | S2が締め切りを管理する | S2が締め切りを管理する |
| 根拠のない主張 | 「サポート対象外」とマークされました | 「サポート対象外」とマークされました |
| 実質的な違い | リスクに関するより詳細な説明 | よりコンパクトな提案 |
共有された完全な入力
以下の出典メモを照合してください。(1) 「主張」「参照元」「ステータス」「理由」の列を含むMarkdown形式の表と、(2) 約250語の推奨事項を提出してください。期限の重複については、日付が新しい方針メモのみを基準としてください。裏付けのない主張には「裏付けなし」と明記してください。事実を追加しないでください。

[S1 2026-09-01] パイロット事業は9月30日に終了する。予算は$12,000である。
[S2 2026-09-03] パイロット事業は10月15日に終了する。 予算は$12,000のまま。
[S3 2026-09-02] 法務部門は外部データ共有を承認していない。
[S4 2026-09-04] あるマネージャーは、モデルが「常に正確である」と述べているが、検証証拠は添付されていない。
[S5 2026-09-04] パイロットチームは8名で構成されている。
[S6 2026-09-05] 決定メモには未解決のリスクを記載しなければならない。

表と推奨事項のみを提出すること。.
Claude Opus 5.5 · 完全出力
| 主張 | 優先される情報源 | ステータス | 理由 |
|---|---|---|---|
| パイロット版は9月30日に終了 | S2 (2026-09-03) | 取り替えられた | S2と矛盾している。期限の競合については、日付が新しい注記が優先される。 |
| パイロットは10月15日に終了 | S2 (2026-09-03) | 支持(優先) | これは期限の矛盾に関する日付が新しい注記であるため、S1よりも優先される。 |
| 予算は$12,000 | S1およびS2 | 支持 | 両情報源の記述が一致しており、S2では予算が「引き続き」$12,000であると明記されている。矛盾はない。 |
| 法務部門は外部データ共有を承認していない | S3 | 裏付けあり | 直接述べられており、他の情報源による矛盾もない。 |
| モデルは「常に正確」である | S4 | 裏付けなし | これは、検証証拠が添付されていない管理者の主張である。 |
| パイロットチームは8名で構成されている | S5 | 裏付けあり | 直接述べられており、矛盾もない。単一の情報源からの情報である。 |
| 決定メモには未解決のリスクを記載しなければならない | S6 | 裏付けあり | これはメモに対する明示的な要件であり、矛盾もない。 |

**推奨事項**

決定メモでは、パイロット終了日として10月15日を使用すべきである。S2は日付が新しいメモであり、期限の競合を調整するものであり、S1に記載された9月30日の日付に優先する。日付が新しい方の優先ルールは、この競合にのみ適用される。その他の主張については、それぞれの裏付けに基づいて評価された。

予算は$12,000として記録すべきである。S1とS2はこの数値について一致しているため、調整は必要ない。8名のチーム規模も記載可能である。これはS5のみに基づくが、これに矛盾する情報源はない。

S6では、メモに未解決のリスクを列挙することが求められており、注記には少なくとも2つのリスクが裏付けられている。

- **外部データ共有:** 法務部門はこれを承認していない(S3)。メモにはこれを明確に記述すべきである。パイロット期間中に外部データ共有が許可されていると示唆してはならない。
- **モデルの精度:** 「モデルは常に正確である」という主張は裏付けがありません。S4には、テスト結果の証拠が添付されていないことが記載されており、この主張は管理者の発言としてのみ記録されています。メモでは、これを調査結果として提示したり、意思決定の根拠として依拠したりしてはなりません。裏付けとなる証拠が提供されるまでは、モデルの精度については「未検証」として記載すべきです。

最後に、メモには、S1とS2の間にパイロット終了日が変更されたことを簡潔に記すべきである。読者は他の場所で以前の9月30日という日付を目にする可能性があるため、この注記により、なぜ10月15日が採用されているのかが説明されることになる。出典となる注記には変更の理由、テスト結果、法的状況の更新に関する記述が一切含まれていないため、メモにそれらに関する説明を追加してはならない。.
GPT-6 Sol · 出力全文
| 主張 | 優先される情報源 | ステータス | 理由 |
|---|---|---|---|
| パイロット版は9月30日に終了する。 | S2 (2026-09-03) | 廃止 | 日付が新しい注記が期限の競合を優先し、10月15日を期限としている。 |
| パイロット事業は10月15日に終了する。 | S2 (2026-09-03) | 支持 | S2が優先される期限を提示している。 |
| 予算は$12,000である。 | S1およびS2 | 支持 | 両方の注記で同じ金額が示されている。 |
| 法務部門は外部データ共有を承認していない。 | S3 | 支持 | S3はこれを直接述べている。それ以降の注記でこの承認について言及しているものはない。 |
| モデルは「常に正確」である。 | S4 | 支持されない | マネージャーがこの主張をしているが、検証証拠は添付されていない。 |
| パイロットチームのメンバーは8名である。 | S5 | 裏付けあり | S5にチーム規模が明記されている。 |
| 決定メモには未解決のリスクを記載しなければならない。 | S6 | 裏付けあり | S6にこの要件が記載されている。 |

**推奨事項:** 決定メモにおけるパイロット終了日として10月15日を使用すること。S2はS1よりも後であり、両者の期限の矛盾を解決している。予算は$12,000のまま維持すること。注記ではその金額について合意が得られているため、期限の変更は予算を変更する根拠とはならない。 S5に記載されている通り、パイロットチームの規模を8名として記録すること。

S6の要件に従い、未解決のリスクを明示的に列挙すること。メモには、法務部門が外部データ共有を承認していないことを明記すべきであり、その後承認が得られたことや共有が許可されていることを示唆してはならない。また、正確性に関する管理者の発言と、確立された調査結果とを区別すべきである。 S4には、モデルが「常に正確である」という記述が記録されているが、検証証拠は示されていない。その記述を検証済みの結果として提示してはならない。

照合の範囲を狭く保つこと。S2は矛盾する終了日を管理するものであり、法務部門、正確性、チーム規模、またはメモの要件に関する個別のメモに取って代わるものではない。 注記で結論が確立されていない場合は、仮定を提示するのではなく、未解決のままにしておくこと。特に、この記録は、外部データ共有が承認されたという主張も、モデルの正確性が実証されたという主張も裏付けていない。

したがって、作成されるメモでは、10月15日の期限と$12,000の予算を使用しつつ、これらの注記に明らかな2つの証拠の欠落、すなわち外部データ共有に関する法務承認が未完了であること、および正確性に関する主張のテスト証拠が存在しないことを指摘すればよい。.
メタデータ: Claude — HTTP 200 · 12.846秒 · finish_reason=stop · prompt_tokens=338 · completion_tokens=1193
GPT — HTTP 200 · 12.322秒 · finish_reason=stop · prompt_tokens=230 · completion_tokens=714
コーディングと構造化された出力
記述の違いは説明の部分にあった
元のフィルタリング条件:もし t
None 要素は falsy であるため、このフィルタではすでにスキップされます。.
どちらのモデルも、要求された4つのキーと、同じ最小限のパッチを含む有効なJSONを返しました。Claudeは既存のフィルターを正しく説明しましたが、GPT-6 Solは「None要素があるとエラーが発生する」と誤った説明をしました。この特定の診断ミスは、レビュー担当者がパッチが実際の問題を解決しているかどうかを判断する際に重要な意味を持ちます。.
Claudeはリスクリストを提出し、Solは短いリスク文字列を提出しました。プロンプトではそのフィールドについて特定の形式を指定していなかったため、この違いは契約違反には該当しません。Solのタスクスコアは、先ほどの根拠のない0.5点の減点を修正した後、9.0/10となりましたが、事実の正確性に関する減点はそのまま残っています。.
コーディング・タスク
コーディングと構造化された出力:Claude Opus 5.5の方がより正確であった
どちらのモデルも、要求されたキーと、同じ最小限のパッチを含む有効なJSONを返しました。Claudeは、元のフィルターがすでに なし 要素。GPT-6 Solは、aについて誤って次のように述べていました。 なし この要素があるとエラーが発生します。プロンプトでは、risksフィールドに対して特定の型を指定する必要はありませんでした。.
| 測定 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| スコア | 10.0 / 10 | 9.0 / 10 |
| パッチ | 正確かつ簡潔 | 正確かつ簡潔 |
| 診断 | 両方の欠陥を正確に特定する | 「None」要素の失敗を過大評価している |
| 要求されたJSON契約 | 有効なJSONです。4つのキーがすべて存在します。 | 有効なJSONです。4つのキーがすべて存在します。 |
共有された完全な入力
「diagnosis」、「patch」、「tests」、「risks」というキーのみを含む厳密なJSONを返すようにしてください。このPython関数を診断し、3つのケースすべてがパスするように最小限の修正を加えてください。修正後は関数のシグネチャを維持する必要があります。

def normalize_tags(tags):
    return ','.join(sorted(set(t.strip().lower() for t in tags if t)))

テストケース:
1) [' AI ', 'ai', 'Code'] -> 'ai,code'
2) None -> ''
3) ['  ', None, 'SEO'] -> 'seo'

コードを実行せず、JSONの外部にMarkdownフェンスやプローズを含めないでください。.
Claude Opus 5.5 · 完全出力
{"diagnosis":"コードを読み込んだ(実行はしていない)結果、2つの不具合が確認された。(a) ケース2:tagsがNoneの場合、ジェネレータはNoneを反復処理し、''を返す代わりにTypeErrorを発生させる。(b) ケース3:filter 'if t'が、文字列の先頭削除処理の前に実行される。 空白のみのタグ ' ' は真とみなされるため、通過して ''' になります。その結果、sorted(['', 'seo']) となり、'seo' ではなく ',seo' に結合されます。 ケース 3 の None 要素は、すでに 'if t' によって除外されています。ケース 1 はすでに正常に動作しています。「AI」、「ai」、「Code」は {'ai', 'code'} に正規化され、「ai,code」となります。」,'patch':'def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))','tests':["assert normalize_tags([" AI ", "ai', 'Code"]) == "ai,code" # トレース: {"ai','code'} -> 'ai,code'','assert normalize_tags(None) == '' # トレース: (None or []) -> [] -> ''','assert normalize_tags([' ", None, "SEO']) == 'seo' # トレース: ' " は t.strip() で失敗、None は t で失敗、"SEO' は 'seo' となる'],'リスク':['123 などの文字列以外の要素は、.strip() で AttributeError を発生させます。これは元の動作から変更されていません。',''tags または []' は、偽値となる入力(例: '" や空のタプル)を空として扱います。これは、None -> "" という必須の挙動と整合しています。","タグの反復可能オブジェクトの代わりに単一の文字列が渡された場合、その文字列は文字単位で反復処理されます。これは元の挙動から変更されていません。",'内部の空白は結合されないため、「'machine learning'」と「'machine learning'」は別々のタグとして扱われます。」,'テストは指示通り、手動でのトレースによってのみ導き出され、実行はされませんでした。"]}GPT-6 Sol · 出力全文
{"diagnosis":"tags が None であるか、None を含む場合、この関数はエラーを発生させます。また、文字列の先頭と末尾の不要な文字を削除した後に空になってしまうエントリは保持されます。","patch":"def normalize_tags(tags):\n return ','.join(sorted(set(t.strip().lower() for t in (tags or []) if t and t.strip())))","tests":[{"input":[" AI ","ai","Code"],"expected":"ai,code"},{"input":null,"expected":""},{"input":[" ",null,"SEO"],"expected":"seo"}],"risks":"実行されませんでした。None 以外のエントリは文字列であるとみなされます。"}メタデータ: Claude — HTTP 200 · 10.832秒 · finish_reason=stop · prompt_tokens=244 · completion_tokens=965
GPT — HTTP 200 · 7.71秒 · finish_reason=stop · prompt_tokens=146 · completion_tokens=305
最終評決
実用的な選択
どのモデルがあなたの仕事に合っていますか?
GPT-6 Solがこの最初の小規模な出力セットで首位となっているのは、修正済みの長文契約書を完成させたのに対し、Claude Opus 5.5は共通の出力上限である2,400トークンに達したためである。コード/JSONタスクの診断精度では、Claude Opus 5.5が首位となっている。ソースコードの合成については同率である。.
選ぶ GPT-6 Sol 長い、かつ複数の制約条件を含む意思決定文書を、一度で完成させることが当面の最優先事項である場合。選択してください Claude Opus 5.5 コードレビューや構造化出力レビューにおいて、より明確な診断やリスクの洗い出しが有効な場合。両方の要素が混在する作業では、画一的な手法を強要するのではなく、各タスクに最適なモデルに割り当てるようにしてください。.
GlobalGPT を使えば、モデルとその他の AI ワークフローをすべて 1 つのダッシュボードにまとめて管理できる実用的な方法を提供します。調査、執筆、コーディング、画像、動画、そして CLI 連携による制作作業を、すべて同じ作業環境内で行うことができます。.
よくある質問
どのモデルが比較テストで優勝したのでしょうか?
元の境界タスクを除外し、JSON契約の推論を修正した後、GPT-6 Solが最初の出力セットにおいて28.5対26.5でリードしました。 このリードは、同じ2,400トークンの出力上限の下で改訂された長文契約を完了したことによるものでした。コードおよび構造化出力タスクではClaude Opus 5.5が首位となり、ソース合成タスクは同点でした。.
なぜ最初の長文テストは除外されたのですか?
元のプロンプトには、どちらのモデルの名前も明記されていませんでした。両モデルとも、欠落している身元を推測することを正しく拒否したため、この応答は、モデルが知っているふりをするのではなく、欠落している文脈を尋ねるかどうかを確認するものです。.
コーディングには、Claude Opus 5.5の方が適していますか?
このコードおよびJSONタスクにおいて、Claude Opus 5.5の方がより正確な診断結果と体系的なリスクリストを示した。1つのタスクだけでは、普遍的なコーディング順位を確立するには不十分である。.
GPT-6 Solは文章作成に適しているのでしょうか?
GPT-6 Solは、最初の出力において、要求された範囲内で改訂された長文のメモを完成させました。この結果は、このテストにおけるワークフローの推奨事項を裏付けるものであり、あらゆる執筆タスクに対する一般的な主張ではありません。.
プラットフォームを切り替えずに、両方のモデルをテストすることはできますか?
GlobalGPTは、1つのダッシュボードに複数のAI機能を統合したマルチモデルAIサブスクリプションとして設計されています。これにより、同じリサーチ、ライティング、コーディング用のプロンプトパックを複数のモデルで活用したり、ワークフローを一元管理したりするのに役立ちます。.
グローバルGPT モデルとその他のAIワークフローをすべて1か所にまとめて管理できます。まず、その場のタスクに適したモデルから始め、その後、各工程ごとに個別のサービスを開くことなく、調査、執筆、コーディング、画像、動画、あるいはCLI連携による制作工程へと作業を進めていくことができます。.









