Claude Fable 5.1 は、コーディング、ナレッジワーク、長期にわたる問題解決、および科学研究向けに、Anthropicが新たに一般提供を開始したモデルです。. 2026年9月1日にリリースされました。主な変更点は、APIの定価引き上げではありません。入力料金は100万トークンあたり$10のまま、出力料金も$50のままです。 その代わりに、Anthropicはキャッシュ読み取りの価格を100万トークンあたり$0.25に引き下げ、コンテキストを多用するワークロードのコスト削減が見込まれています。.
そのため、長文の文書や繰り返されるコンテキスト、あるいは厳密に制約された分析に依存する業務を行う場合、Fable 5.1は真剣に検討する価値があります。ただし、これによりすべてのアクセス経路が同一になるわけではなく、ベンダーのベンチマークが独立した評価となるわけでもありません。 重要な問いはもっと単純です。つまり、利用を予定しているアクセス経路が、ワークフローに必要なコンテキスト、制御機能、プライバシー条件、およびモデルの挙動を提供してくれるかどうか、ということです。
複数のモデルシリーズを一か所で比較するチームにとっては、, GlobalGPTのマルチモデルワークスペース これは、公式のルートと並んで実用的な選択肢です。同じタスクで利用可能なモデルを比較するのに役立ちます。いずれかのプラットフォームを Fable 5.1 へのアクセスパスとして扱う前に、現在のディレクトリと計画の網羅性を確認してください。.

Claude Fable 5.1とは何ですか?
Anthropicは、Mythos 5.1とともにFable 5.1を発表しました。同社はこれらを、基盤となるモデルは同じだが、セキュリティ対策やアクセスルールが異なるものとして説明しています。Fableは一般に利用可能ですが、Mythosはサイバーセキュリティやライフサイエンス分野の「トラステッド・アクセス」プログラム向けに限定されています。この区別は重要です。 Mythosの機能は、通常のFableへのアクセスと同等であると解釈すべきではありません。.
Anthropicは、コーディング、ナレッジワーク、長期にわたる問題解決、および科学研究を主な対象として位置づけられています。これらは製品の特長であり、すべてのAPIプラットフォームが同じツールや制限を提供することを約束するものではありません。.
今回のリリースが単なるモデルの名称変更よりも重要な意味を持つのは、機能、工数管理、キャッシュの経済性、そしてより明確なデプロイメント境界が組み合わさっているためです。 開発者にとっては、これは繰り返し行われるコンテキストのタスクにおいて、モデルの導入を正当化しやすくなることを意味します。研究チームにとっては、ツールへのアクセス、人間によるレビュー、およびルート固有の保存条件が依然として必要なワークフローから、ソースに強く依存した回答を分離できることを意味します。.
- 用途: コード診断、ドキュメントの統合、制約条件の多い分析、および画像からテキストへの解釈。.
- まず確認してください: 選択したルートにおけるコンテキストの制限、ツールの利用可能性、データの保持期間、リージョン、およびプランへのアクセス権限。.
- 次のように推測してはならない: クラウド専用の仕様である「Mythosアクセス」や公式ベンチマークが、自動的にあなたのアカウントに適用されるわけではありません。.
概要
Claude Fable 5.1はどこで利用できますか?
Anthropicによると、Fable 5.1は同社の各プラットフォームで利用可能であり、AWS、Google Cloud、Microsoft Azureが挙げられています。AnthropicのAPIにおいて、このモデルの識別子は claude-fable-5-1. AWS Bedrock ルートに関しては、ドキュメントに記載されているコンテキスト、出力、入力、キャッシュ、および保持ルールは AWS のドキュメントに属するものであり、他のすべてのルートについても同様であると想定すべきではありません。.
- Anthropic API: 文書に記載されているモデル識別子と、現在のプラットフォームの制限事項に従ってください。.
- AWS Bedrock: AWSは、そのルートについて、100万トークンのコンテキストウィンドウ、最大128Kの出力、テキストおよび画像の入力、およびテキストの出力を仕様として記載しています。.
- その他のクラウドルート: 移行前に、対象地域、計画、ツールの対応状況、およびデータ処理について確認してください。.
アクセス経路:乗り換えが必要なものとそうでないもの
各仕様は、ルートごとに固有のものとしてお読みください。モデル名だけでは、同じ制限、入力、ツール、またはデータ条件が保証されるわけではありません。.
モデルID:
claude-fable-5-1電流制限、適用範囲、および対応している制御機能。.
コンテキスト1M、出力128K、テキスト/画像入力、テキスト出力。.
対象地域およびアカウントの要件。.
正確なモデルID、構造化されたJSON出力、およびPNG画像の入力。.
ファイルシステムツールとエージェントの実行。.
Fable 5.1はどのような目的で開発されたのでしょうか?
公式の定義範囲は広いため、文書化されている内容と、簡単な実地確認で判明する内容を区別しておくと役立ちます。 Anywhere API を用いたクローズド入力・ファースト出力テストにおいて、Fable 5.1 は、ゼロ値を保持し、推測に頼らずにドキュメントセットの予算の矛盾を追跡し、観察結果を非因果的なものとして維持し、PNG チャートからラベル付き値を抽出する最小限の JavaScript 修正を生成しました。 これらは制約のあるタスクにとって有用な指標であり、Anthropicの長期にわたるエージェントベンチマークの再現ではありません。.
このAPIルートでは、ファイルシステムやバリデータツールは公開されていませんでした。そのため、真の自律エージェントによる結果であるとは主張しませんでした。.
機能マップ:クレーム、チェック、境界
Claude Fable 5.1 価格およびコストの変更
Anthropicでは、Fable 5.1の処理コストが、入力トークン100万件あたり$10、出力トークン100万件あたり$50と記載されており、これはFable 5と同じリストレートです。キャッシュ読み取りは、トークン100万件あたり$0.25です。 Anthropicは、一般的なワークロードでは約25%、複雑でコンテキストを多用するエージェント型ワークロードでは最大で約45%のコスト削減を見込んでいます。これらは、Anthropicが提示したワークロードの仮定に基づく推定値であり、割引が保証されるものではありません。.
重要な要素は「再利用」です。1回限りのプロンプトでは、キャッシュ読み取りの料金体系によるメリットはあまりありませんが、大規模なブリーフやコードベースの要約、ポリシーパックを繰り返し送信するワークフローでは、そのメリットを享受できます。旧世代のコンテキストについては、当社の Claude Fable 5 価格ガイド. もし、APIトークンの課金ではなく、個別のサブスクリプション同士を比較しているのであれば、, GlobalGPTのプラン 別のマルチモデル・サブスクリプション・ルートを提供します。これらは、Anthropic APIの料金体系をそのまま変換したものではありません。.
公式APIの定価一覧
月間の入力量をスライダーで調整してください。この推定値は、出力が入力の20%に相当し、入力トークンのうち50%がキャッシュ読み取りであると仮定しています。.
月間1,000万の入力トークンClaude Fable 5.1 対 Fable 5:これは有意義なアップグレードなのか?
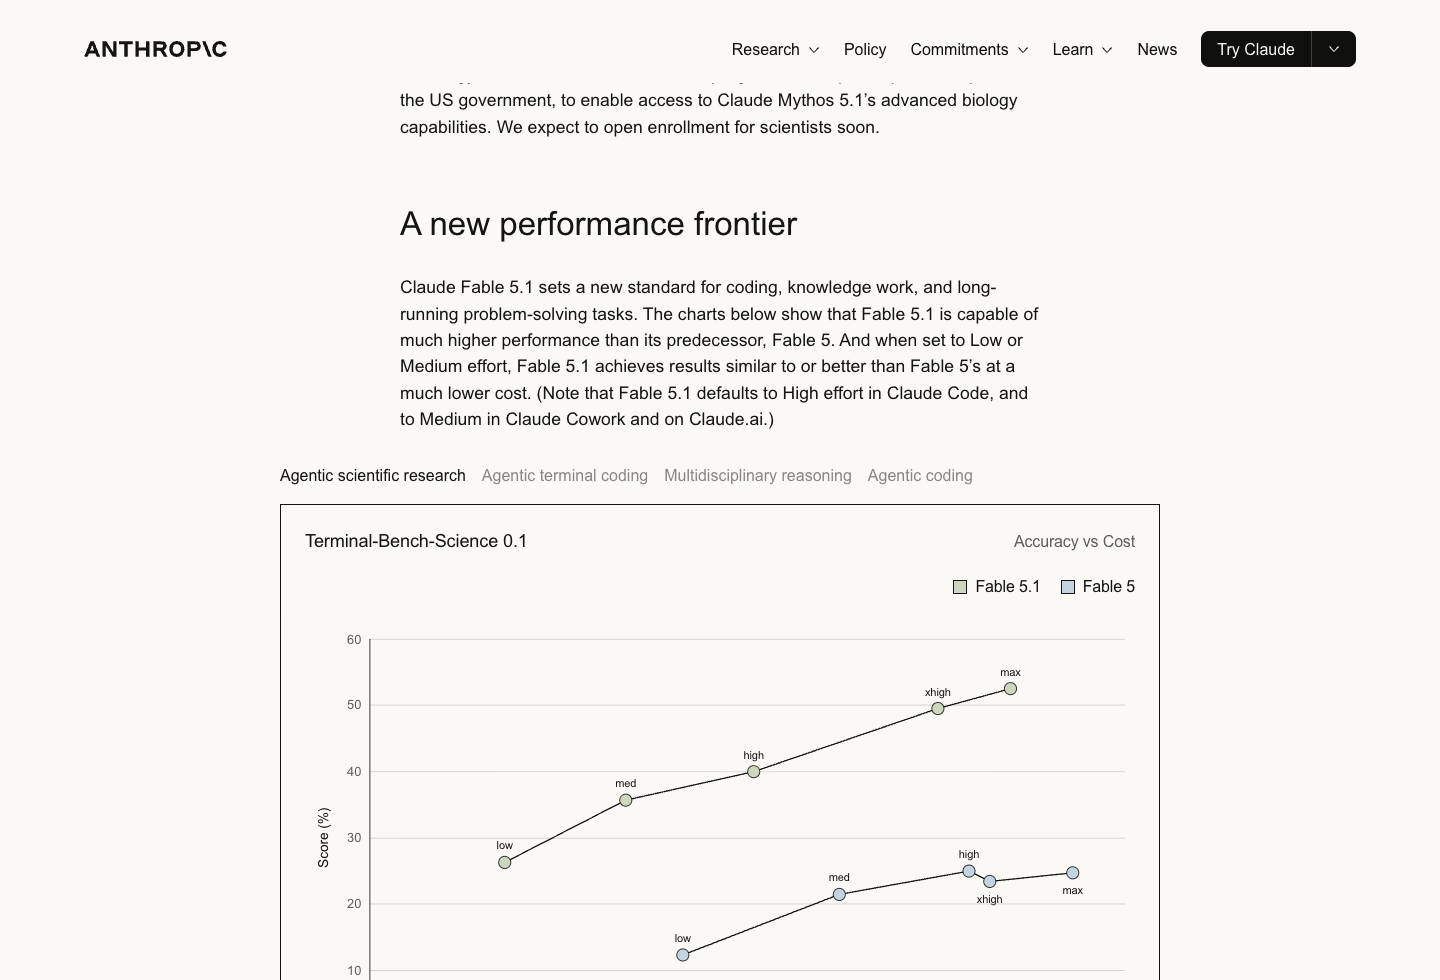
Anthropicは、Terminal-Bench-Scienceにおける52.6%対24.7%をはじめ、いくつかのタスク固有の評価において、Fable 5.1よりも高いFable 5.1スコアを記録している。 Terminal-Benchでは55.8%対42.0%、 AutomationBenchでは31.4%対17.1%、CursorBenchでは73.4%対70.5%といった結果を示しています。 そのGDPval-AA v2の結果は1853対1723です。これらはAnthropicが独自のテストスイートと条件下で報告した数値であるため、独立して再現された総合ランキングというよりは、参考となるコンテキストとして有用です。.
同じ環境でFable 5の直接的なベースラインテストは実施していません。したがって、アップグレードに関する率直な結論は条件付きとなります。公式なデータからは、タスク固有の性能向上とキャッシュ読み取りコストの低減が示唆されていますが、Fable 5.1とFable 5を比較する独立した評価は、まだ完了していません。.
もし、この1つのアップグレード以外にも選択肢がある場合は、当社の Claude Fable 5 と GPT 5.5 の比較 単一のベンチマーク行を普遍的なランキングとして扱うよりも、次に読むべき資料として適しています。.
Anthropicで報告された課題の結果
実機テスト:実際に確認した内容
Anywhere APIのルートを使用しました /v1/chat/completions 返されたモデルIDを確認した後 claude-fable-5-1 および小さな構造化出力プローブ。以下の各結果は、入力が固定された状態で実行されたタスクから得られた最初の有効な出力です。T05がモデルに到達する前にSVG入力が拒否されたため、同一のフィクスチャをPNGに変換して1回実行しました。有効な結果が置き換えられることはありませんでした。.
最初の出力データ
この回答では、ゼロ値が消えてしまった原因を特定し、最小限のコード変更を提案したほか、テスト実行については明示的に言及しなかった。.
{
  "root_cause": "scores.filter(Boolean) は、数値のスコア 0 を含むすべての falsy 値を削除するため、normalize([0, 4, null, undefined]) を実行すると 0 が除外され、[0, 4] ではなく [4] が返されます。 この述語の範囲が広すぎます。null と undefined のみを除外するようにすべきです。",
  "unified_diff": "--- a/normalize.js\n+++ b/normalize.js\n@@ -1,3 +1,3 @@\n function normalize(scores) {\n-  return scores.filter(Boolean);\n+  return scores.filter((score) => score != null);\n }",
  "expected_test_results": "normalize([0, 4, null, undefined]) は [0, 4] を返すものと予想されます。これは、score != null が false となるのは null と undefined の場合のみであるため、0 は保持されるからです。 normalize([7]) は、変更されずに [7] を返すものと予想されます。これらはコードを読んだ上での予想であり、テスト実行は行われていません。",
  "remaining_risk": "以前はフィルタリングされていた他のfalsy値(NaN、空文字列、false)が、今後は保持されるようになります。これは明示された要件(null/undefinedのみを除去する)には合致しますが、以前のフィルタリングに依存していた呼び出し元がある場合、動作の変更として表面化する可能性があります。 入力が配列以外の場合、関数は以前と同様に例外をスローします。"
}この応答は、提供されたクレームを照合し、$18,000/$20,000 の矛盾を特定し、原因をでっち上げるのではなく、未解決のままとした。.
{
  "claims": [{"claim":"このパイロット事業は3月3日に、120名の学生が登録して開始された。","source":"文書A","section":"A1","status":"記載あり"},{"claim":"出席状況は毎週記録された。","source":"文書A","section":"A2","status":"記載あり"},{"claim":"3月31日のチェックポイント時点で、登録学生120名のうち96名が少なくとも3回のセッションに出席していた。","source":"文書B","section":"B1","status":"記載あり"},{"claim":"プログラム予算は$18,000であった。","source":"文書B","section":"B2","status":"矛盾あり"},{"claim":"財務メモには、承認済みのプログラム予算として$20,000と記載されている。","source":"文書C","section":"C1","status":"矛盾"},{"claim":"当該注記には、予算の差異が修正によるものか、記録上の誤りによるものかについては明記されていない。","source":"文書C","section":"C2","status":"記載あり"}],
  "矛盾点": [{"トピック":"プログラム予算","出典":[{"出典":"文書B","セクション":"B2","値":"$18,000"},{"source":"文書C","section":"C1","value":"$20,000"}],"description":"文書Bにはプログラム予算が$18,000であると記載されている一方、文書Cには承認済みのプログラム予算として$20,000が記載されている。"}],
  "未解決": [{"問題点":"$18,000の予算(文書B、B2)と$20,000の承認済み予算 (文書C、C1)との間の$2,000の差額が、予算修正によるものか、それとも記録上の誤りによるものかを示しているか。」,"source":"文書C","section":"C2","reason":"文書Cには、注記ではこの差額の原因が明確になっていないことが明記されており、提供された他の文書にもこれに関する記載はない。"}]
}検証済みのチャットエンドポイントには、ファイル書き込み機能やバリデータツールは公開されていませんでした。そのため、このタスクはモデル品質テストとして送信されたものではなく、出力やスコアは一切報告されていません。.
この分析では、観察された差異を算出し、裏付けのない因果関係の結論を退けた。.
{
  "mean_control": {"value": 10, "units": "points"},
  "mean_treatment": {"value": 14, "units": "points"},
  "difference": {"value": 4, "units": "points", "direction": "treatment minus control"},
  "supported_conclusion": "このデータセットでは、介入群の平均スコアは対照群よりも4ポイント高かった(14ポイント対10ポイント)。",
  "unsupported_conclusion": "この4ポイントのスコア差が治療によるものであるという結論は支持されない。グループは無作為に割り当てられておらず、ベースラインスコアも収集されていないため、この差はグループ間の既存の差異を反映している可能性がある。",
  "limitations": ["グループの割り当てが非無作為であるため、選択バイアスが排除できない", "ベースラインスコアがないため、グループ間の既存の差異を評価できない", "標本サイズが非常に小さい(各グループ n=4)", "推論統計量が算出されていない; その差の統計的有意性は検証されていない", "観察研究のデザインでは因果関係の主張を裏付けることはできない"]
}このPNG実行により、4月のラベル付き値が返され、目視による推定値とラベル付き値が区別され、根拠のない外挿が行われなかった。.
{
  "april_alpha": 30,
  "april_beta": 25,
  "trend": "1月から4月にかけて、アルファとベータは毎月着実に増加しており、アルファは一貫してベータより約5時間上回っています(目視による推定:1月は約15/10、 2月~20/15、3月~25/20、4月30/25とラベル表示されている).",
  "unsupported": ["4月の値はチャート上に明示的にラベル表示されているが、 1月、2月、3月の値は目視による推定値に過ぎない", "4月以降または1月以前のデータは表示されていないため、他の月に関する主張はできない", "単位は学習時間と表記されているが、出典、サンプルサイズ、またはアルファ/ベータグループの定義は示されていない"]
}
安全性、データ、および互換性の制限
Fable 5.1はソフトウェアの脆弱性を発見するために使用できますが、Anthropicによると、これはエクスプロイト開発を目的としたものではなく、一部のデュアルユース業務はOpusに振り分けられる可能性があります。 ライフサイエンス研究とMythosへのアクセスには、それぞれ異なる制限が設けられています。データの保持期間はルートごとに異なります。例えば、AWSのドキュメントに記載されている内容は、すべてのClaudeやサードパーティAPIパスに一律に適用できるものではありません。.
Anthropicは、非常に長いコンテキスト、マルチエージェント、および不可能なタスクといった設定において、自身のアラインメントのカバー範囲に不備があることも指摘しています。これは、重要な導入案件を独自の限定的なタスクで検証すべき理由であり、モデルの文書化された改善点を無視すべき理由ではありません。.
Claude Fable 5.1はどのような方に適していますか?
慎重なコーディング支援、ソースバウンド合成、ドキュメントの矛盾チェック、または画像からテキストへの抽出が業務に役立つ場合は、ぜひお試しください。特定の地域での導入、データ保持期間ゼロの条件、ツールを使用するエージェント、またはFable 5との直接比較が必要な場合は、まずご確認ください。 API アクセスではなく、一般的な Claude プランを選択する場合は、別途 クロードAI価格ガイド 「プラン」と「API」の違いについて解説しています。.
Claude Fable 5.1 よくある質問
Claude Fable 5.1とMythos 5.1には、実際にどのような違いがあるのでしょうか?
Anthropicでは、これらは根本的には同じモデルであり、セキュリティ対策やアクセスルールが異なるものとして説明されています。Fable 5.1は、ここで論じられている一般提供ルートです。Mythos 5.1は、サイバーセキュリティおよびライフサイエンス分野の信頼性の高いアクセスプログラム専用であるため、Mythosの機能は、標準的なFableアカウントについて保証するものではありません。.
Claude Fable 5.1はClaudeアプリで使用できますか、それともAPI専用ですか?
APIやクラウドに関する発表から、コンシューマー向けアプリへのアクセスが可能であると推測しないでください。Anthropicでは、自社のプラットフォームや主要なクラウドプロバイダーをアクセス経路として挙げていますが、プラン、リージョン、クォータ、ツールセットは経路によって異なります。ワークフローを変更する前に、実際に使用するアカウントの範囲を正確に確認してください。.
Claude Fable 5.1の正しいモデルIDは何ですか?
Anthropicのリスト claude-fable-5-1 そのAPIについては。クラウドプロバイダーによっては、ルート固有の識別子を使用している場合がありますので、実際に呼び出すエンドポイントについて、プロバイダーのドキュメントからモデルIDをコピーしてください。.
Claude Fable 5.1には、1Mトークンのコンテキストウィンドウはありますか?
AWSは、Bedrockルートについて、100万トークンのコンテキストウィンドウと128Kの最大出力について記載しています。これはBedrockの計画立案には役立ちますが、各Claude API、コンシューマー、またはサードパーティのルートについて、それぞれのドキュメントを確認せずにこれを一般化すべきではありません。.
Fable 5.1は画像を受け入れ、画像を生成しますか?
AWSのドキュメントでは、Bedrockルートについて、テキストおよび画像の入力とテキストの出力が記載されています。これは、画像の理解に関する内容がそこに記載されていることを意味するものであり、そのモデルが画像生成モデルであるということや、すべてのルートが同じ形式を受け入れるということではありません。当社が行ったAPIの範囲確認テストでは、リクエスト層でSVGが拒否された後、PNGの入力は正常に動作しました。.
キャッシュ読み取り価格が安くなると、どのような場合にその効果が現れるのでしょうか?
リクエスト間で同じ大規模なコンテキストが再利用される場合、これは重要なポイントとなります。例えば、永続的なコードベースの概要、ポリシー集、あるいは長文の研究資料などが挙げられます。孤立した短いプロンプトの場合、通常の入力量と出力量がコストの大部分を占めます。上記の計算ツールを計画の目安として活用し、その後、ご自身のルートにおける実際のキャッシュ動作と比較してください。.
Fable 5.1は、単独で道具を使うエージェントを実行できるのでしょうか?
それはモデルを取り巻く環境次第です。チャット補完エンドポイントは、ファイル書き込み、バリデータ、ブラウジング、リポジトリのサンドボックスなどを公開することなく、説得力のあるテキスト回答を返すことができます。当社のテストルートではこれらのツールは公開されていなかったため、自律エージェントの実行を主張するために使用されることはありませんでした。.
Claude Fable 5.1は、Fable 5よりも間違いなく優れているのでしょうか?
Anthropicでは、特定のタスクにおけるパフォーマンス向上と、キャッシュ読み取りコストの低減が報告されています。これは、自身のワークロードに類似した作業においてアップグレードを検討する有力な理由となりますが、それ自体が「確実に成功する」という普遍的な結論を意味するものではありません。本記事では、同一環境でのFable 5のベースラインテストは実施していません。.