
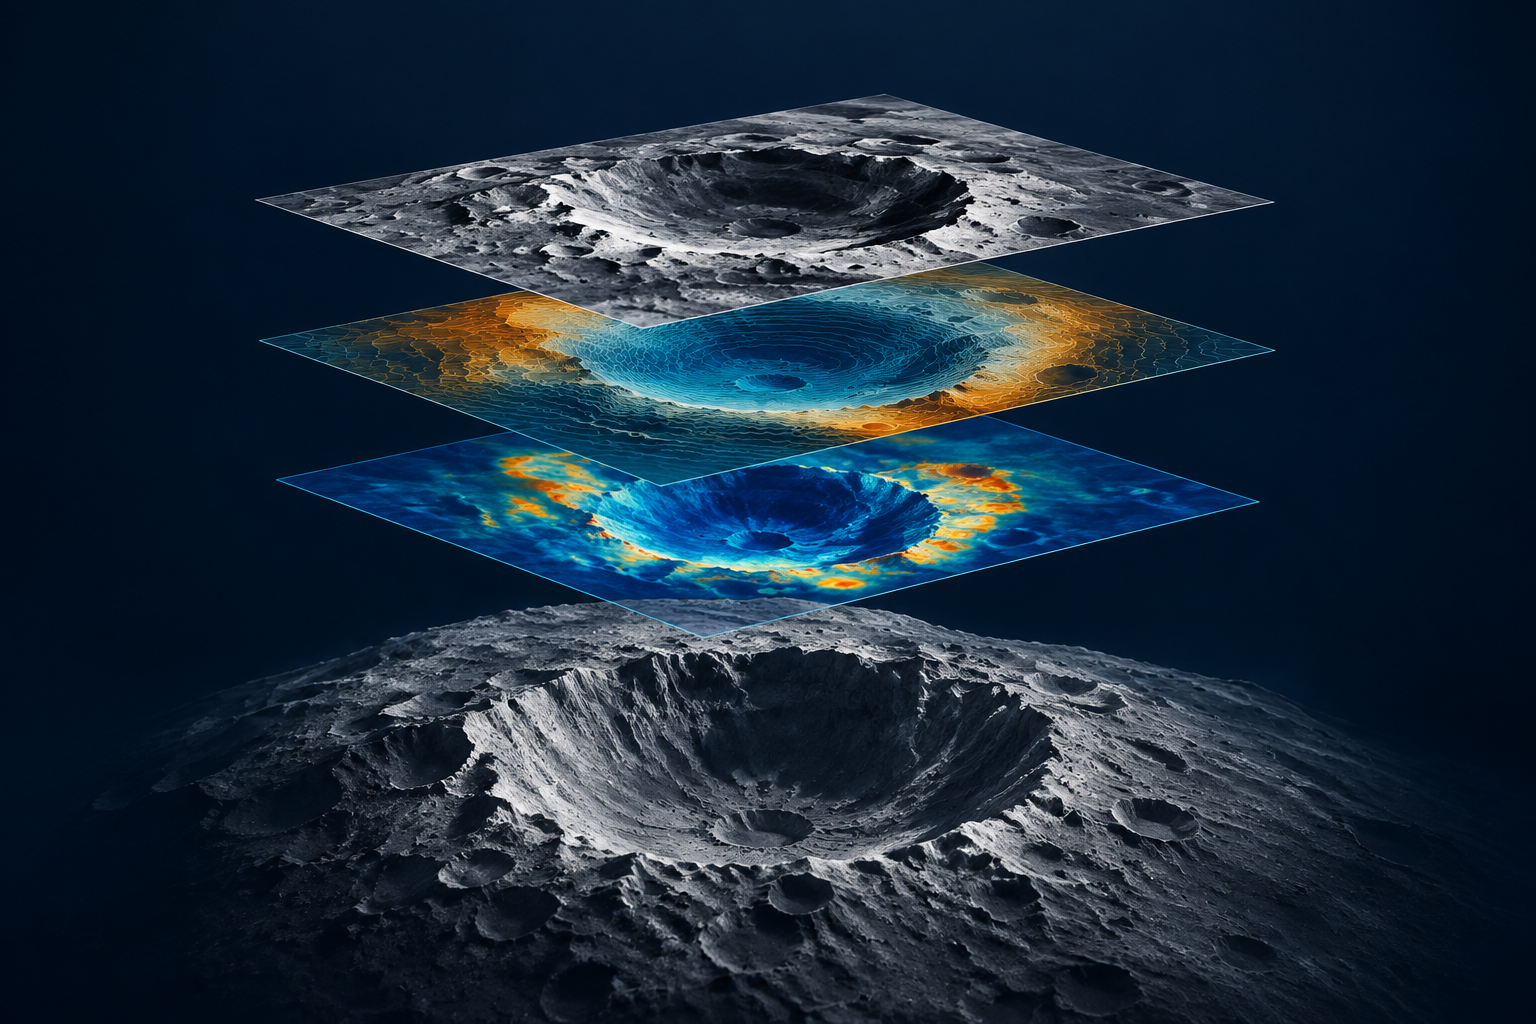
NASA-IBMの「Lunar Foundation Model」は、月面観測データを分析するためのオープンなAIモデルです。. 2026年9月10日に発表されたこの技術は、クレーターの検出、火山地形の輪郭の特定、および氷埋蔵可能性マップにおけるパターンの予測に応用することができる。 報告されている成果は特定の研究ベンチマークに関するものであり、氷に関する主な成果は、月面で22%より多くの水が発見されたことではなく、予測誤差の低減である。.
学生や研究者にとって、役立つ出発点となるのは以下のものです。 公式モデルカード, 、技術報告書、および公開されたコード。これらを合わせて読むことで、モデルが何を学習したか、どのタスクが評価されたか、そして独自の実験を構築するために何が必要かがわかります。.
もし最初の課題が研究内容を理解することであるなら、, グローバルGPT 情報収集、文献分析、推論、執筆を1つのマルチモデルワークスペースに統合します。単一のサブスクリプションを通じて、馴染みのない科学用語から明確な研究概要へと導く、手頃な価格のソリューションを提供します。.

NASA-IBM月面基礎モデルとは何ですか?
NASAの発表 このプロジェクトは、IBMと共同で開発された月科学の基盤モデルとして紹介されている。基盤モデルとは、広範なデータセットから再利用可能なパターンを学習するものであり、研究者はそのパターンをより限定的な課題に適応させる。ここでは、その対象となるデータは日常言語ではなく、月のリモートセンシングデータである。.
NASAとIBMが共同開発したLFMは、ViT-Bアーキテクチャを採用したビジョントランスフォーマーエンコーダーおよびデコーダーを使用しています。その入力には、さまざまな空間解像度の画像やその他の観測データが含まれます。科学者は、その結果として得られる表現を、検出、セグメンテーション、回帰――つまり、物体の検出、領域の輪郭抽出、数値の予測――の3つの用途に合わせて活用することができます。.
そのため、このリリースは月面地図を扱うチームや、惑星に関する機械学習を学ぶ学生にとって有用です。また、科学的なAIモデルの評価方法を理解しようとしている人にとっても、このプロジェクトを参照する価値は十分にあります。ただし、そのチェックポイントを使用することは、チャットでの会話というよりは、研究用コンピューティングのワークフローとなります。.
どのようなデータから学習するのですか?
について モデルカード SomBenchのトレーニングデータについて説明しています:広角カメラ(WAC)のタイルバンドル963,609個と、狭角カメラ(NAC)のバンドル1,000,113個です。 WACのスケールは1ピクセルあたり約100メートル、NACのスケールは1ピクセルあたり約1メートルです。これにより、モデルはおよそ200万のバンドルにわたり、より広範な地形コンテキストと、はるかに詳細な地表ディテールの両方を得ることができます。.
IBMは、より広範なデータリソースについて次のように説明している 4つのミッションにまたがる9つの観測機器から得られた、30以上の位置合わせ済みのレイヤーです。モデルカードには、11種類の入力モダリティが指定されています。これらの図は、データパイプラインのさまざまな段階、すなわちソースレイヤー、パッケージ化された学習用サンプル、およびモデルがエンコードする入力の種類を示しています。.
1つのプロジェクト、3つの異なる計数単位
IBMは、4つのミッションにまたがる9つの観測機器から収集されたデータリソースについて説明している。.
963,609セットのWAC教材と1,000,113セットのNAC教材により、2つの規模の研修教材が提供されています。.
このモデルは、画像データや地形データなど、さまざまな種類の観測データをエンコードします。.
ソースレイヤー、タイルバンドル、および入力モダリティは、それぞれ異なる要素を数えます。ソース: IBMのデータセットの説明 そして 公式モデルカード.
照明もデザインの一部です。モデルには、照明角度を含む観察ジオメトリが明示的なコンテキストとして与えられます。これにより、特定の照明条件下でのサーフェスの外観と、モデルが学習している基盤となる地形パターンを区別しやすくなります。.
地形のおよそ100メートルに相当する1ピクセルでは、およそ1メートルに相当する1ピクセルと同じような細部を捉えることはできません。そのため、WACとNACによるクレーター観測の結果については、それぞれ個別に検討する必要があります。広域画像における利点が、地表の微細な地形についても同様の利点をもたらすとは限りません。.
このプロジェクトはTerraMindの事前学習アプローチを踏襲しているが、月面データを用いてゼロから学習を行う。したがって、これは単に名称を変えただけの地球観測用チェックポイントではなく、月面観測のために構築されたモデルであると理解すべきである。重要な点は、その学習された表現が、特定の月面観測タスクにどのように役立つかということである。.
対応可能な3つのタスク
公表されている評価結果は、3つの課題群を対象としています。各課題群では異なる種類の答えが得られるため、「優れている」という意味は課題によって異なります。.
| タスク | 出力 | この結果が裏付けること |
|---|---|---|
| クレーターの検出 | WACまたはNAC画像上のクレーターを取り囲むバウンディングボックス | 検出器が標識されたクレーターをどれだけうまく発見・特定できるかを比較する。. |
| 不規則なメアパッチのセグメンテーション | 火山地表の地形をピクセル単位で示した輪郭図 | 予測された領域が、ラベル付けされた特徴境界とどの程度一致しているかを調査する。. |
| 極地の氷・探鉱可能性回帰分析 | 知識に基づく将来性マップの連続的な予測 | 氷に関連する可能性のある状況について、モデル化された目標との整合性を検討する。. |
クレーターの検出や火山地形の特徴のセグメンテーションは、研究者が画像を整理・分析する上で役立ちます。その有用性は、ラベル、スケール、評価対象領域によって異なります。定義されたテストセットで良好な性能を示すモデルであっても、新しいプロジェクトのデータや科学的課題に対して評価を行う必要があります。.
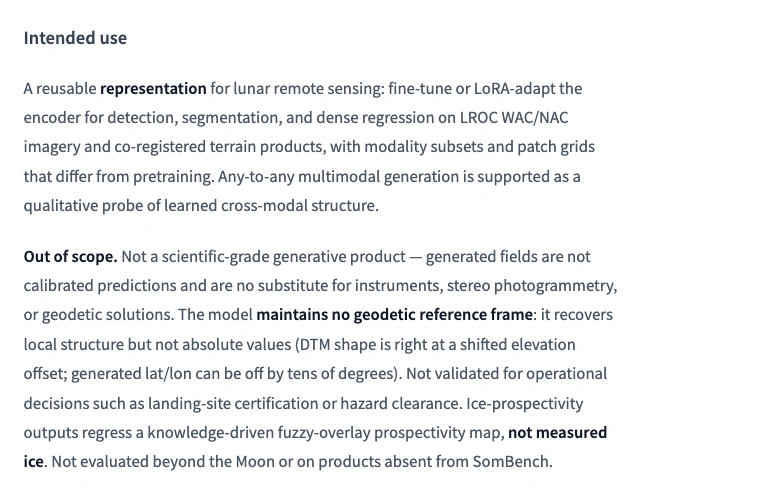
氷の存在可能性については、最も慎重な解釈が必要です。. この目標は、氷が存在しうる場所を示す知識に基づく地図を作成することであり、氷の堆積量を直接測定することではありません。その地図との一致度が高まれば、パターンや候補地域の研究に役立つでしょう。ただし、それによって追加の水量が発見されたことを示すものではありません。.
ベンチマーク結果が示すもの
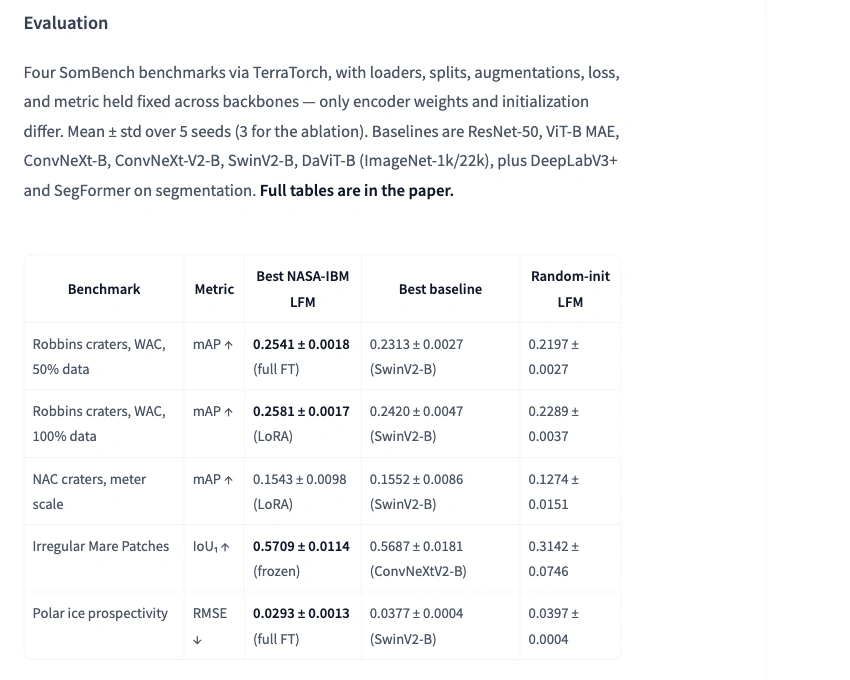
について 技術報告書 5つのランダムなシードについて、平均値と標準偏差を示している。その結果は、適応されたルナ・モデルの構成と、特定のビジョン・モデルのベースラインとの比較である。我々は公表された表を確認したが、ルナの実験を再現することはなかった。.
これらの指標は、それぞれ異なる質問に答えるものです。 平均精度(mAP)は物体検出を評価する指標であり、交差率(IoU)は予測領域とラベル付けされた領域の重なりを測定する指標であり、二乗平均平方根誤差(RMSE)は数値的な予測誤差を測定する指標です。mAPとIoUは高いほど良く、RMSEは低いほど良いです。これらを1つの精度スコアに統合すべきではありません。.
氷の探査可能性に関する誤差:報告されている中で最も明確な改善
RMSEは 0.0377 ~ 0.0293 SwinV2-Bに対する、 22.3% 相対減少率. RMSEが小さいほど、ベンチマークの氷存在可能性マップとの一致度が高いことを示す。.
RMSEは、数値が低いほど良い。棒グラフはゼロから始まっている。5回のシード実験における平均値±標準偏差。対象は、氷の測定値ではなく、モデル化された探査可能性マップである。.
| タスクとデータ | メートル法 ↑ | 月面モデル | 強固な基盤 |
|---|---|---|---|
| WACのクレーター · 50% トレーニングデータ | mAP | 0.2541 ± 0.0018 完全な微調整 | 0.2313 ± 0.0027 SwinV2-B |
| WACのクレーター · 100% トレーニングデータ | mAP | 0.2581 ± 0.0017 LoRA | 0.2420 ± 0.0047 SwinV2-B |
| NACクレーター · 100% トレーニングデータ | mAP | 0.1543 ± 0.0098 LoRA | 0.1552 ± 0.0086 SwinV2-B |
| 不規則なマレ斑 | IoU1 | 0.5709 ± 0.0114 エンコーダーの凍結 | 0.5687 ± 0.0181 ConvNeXtV2-B |
著者らは、メートル規模のクレーターや火山地形に関する分析結果を、信頼性の高い基準データと同等であると述べている。これらの結果に見られるわずかな差異については、測定ごとのばらつきと併せて解釈すべきである。.
ソース: NASA-IBM技術報告書, 、表4~7、16ページおよび18ページ。これらは著者らの結果であり、独立した再現実験の結果ではない。.
22%の氷に関する結果は、誤差の低減を示しています
氷の存在可能性に関しては、報告されている中で最も精度の高い月面構成のRMSEは0.0293であるのに対し、SwinV2-Bの場合は0.0377である。その計算式は以下の通りである。 (0.0377 − 0.0293) ÷ 0.0377 × 100 = 22.3%. RMSEは、ターゲットマップに対する予測誤差を測定する指標であり、数値が低いほど良い。このパーセンテージは、精度スコアでもなければ、月面氷の量の変化を示すものでもない。.
クレーターの結果は、測定基準とデータのスケールによって異なります
WACトレーニングデータの50%を使用した場合、月面モデルのmAPは0.2541を記録したのに対し、SwinV2-Bは0.2313であった。 この月面モデルの結果は、100%のトレーニングデータを用いたベースラインの0.2420も上回っています。最初の比較では同量のデータが使用されていますが、2番目の比較は、この特定の実験におけるラベル効率の高さを示す証拠となっています。.
IBMによる約19%の大幅な改善は、50%のトレーニングデータにおける本レポートのAP@75値(0.2213対0.1862、18.9%の相対的増加)と整合性が取れます。 AP@75は、特定のオーバーラップ閾値における検出を評価する指標である。表のmAP指標において、これを19%の増加として再ラベル付けすべきではない。.
より細かいNACスケールでは、月面モデルのmAPは0.1543、ベースラインのmAPは0.1552である。 不規則な海(Mare)パッチについては、ConvNeXtV2-B に対する報告された前景 IoU 値は 0.5709 および 0.5687 である。著者らは、これらのタスクについて、強力なベースラインと同等であると述べている。わずかな差異に加え、実行間のばらつきも報告されており、月面モデルがあらゆる場面で優れているという主張を裏付けるものではない。.
入手先と利用料金
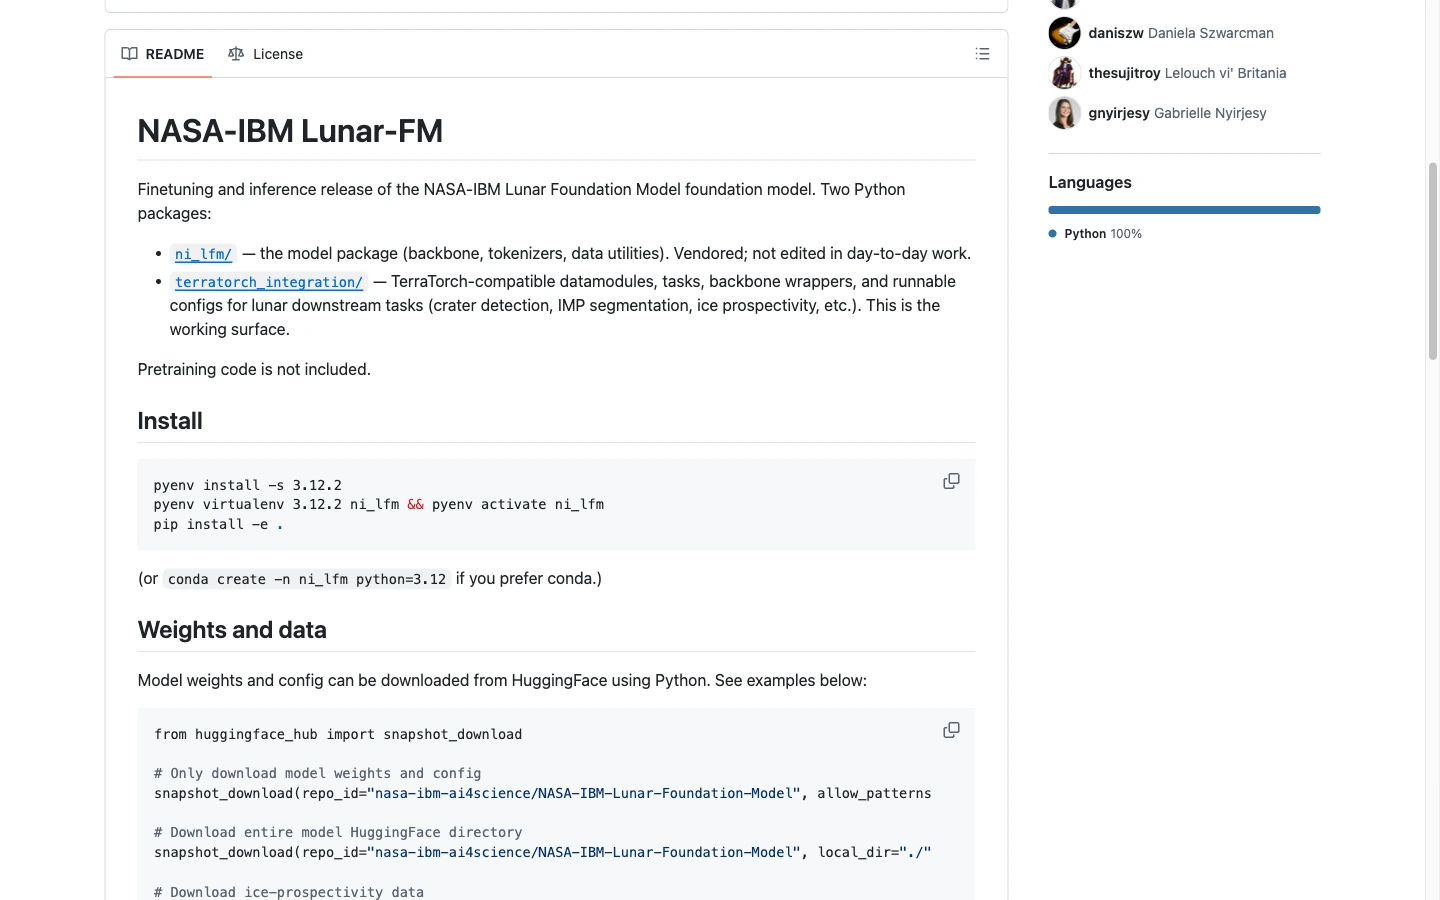
まずは以下の公式リソースから始めてください。モデルの重みとコードはApache-2.0ライセンスの下で提供されており、チェックポイントも公開されています。このリポジトリでは、具体的には 微調整および推論のリリース; プレトレーニング用のコードは明示的に除外されています。.
次のステップに進むためのリソースを選んでください
まず、用途、入力データ、ライセンス、および制限事項から始めましょう。.
[ファイル] タブには、リリースされたチェックポイントと関連ファイルが表示されます。.
READMEおよびTerraTorchのタスク設定を参照して、実験の計画を立ててください。.
公式コレクションをフォローして、関連する下流モデルやデータセットをご覧ください。.
表4~7には、タスクの結果、設定、および実行ごとのばらつきが示されている。.
このプロジェクトのデモ版をご覧ください。今回のレビューでは、生成処理は実行していません。.
2026年9月28日に確認したところ、このモデルカードにはデプロイ済みのHugging Face Inference Providerは記載されていませんでした。ダウンロード可能なチェックポイントとデモページは、それぞれ別のアクセス経路となっています。.
モデルをカスタマイズしたい場合は、実験を設定する前にダウンストリームタスクを選択してください。このリポジトリには、チェックポイント、タスク、データを連携させるTerraTorch互換のコンポーネントと設定が用意されています。TerraTorchは、その学習および評価ワークフローを構成するために使用されるソフトウェアフレームワークです。.
- モデルカードとREADMEを読み、研究課題に応じて「検出」「セグメンテーション」「回帰」のいずれかを選択してください。.
- 対応するデータと公式のチェックポイントを入手し、リポジトリのタスク設定と環境設定の指示を確認してください。.
- その構成に必要なデータを準備し、関連する微調整または推論ワークフローを実行してください。.
- 適切な基準値に対して評価を行い、結果を確認できるよう、データの分割、設定、および出力を保持しておく。.
オープンアクセスにより、初期段階でのモデルライセンスの購入は不要になりますが、実験の実施には依然としてコストがかかります。計算リソース、ストレージ、データ前処理、そして評価に要する時間が必要です。公開されたチェックポイントには、ホスト型APIや無料のGPU利用時間が自動的に付属するわけではなく、またソースコードだけでは、すべてのダウンストリームタスクに共通する最低限必要なGPU性能が定められているわけではありません。.
| あなたの目標 | 計画に盛り込むべきリソースまたはコスト |
|---|---|
| リリース内容を確認し、評価する | 告知、モデルカード、レポート、およびリポジトリ。. |
| 科学モデルを実行または適応させる | 適切な演算能力とストレージ、関連データ、環境のセットアップ、および評価作業。. |
| 論文を理解し、研究概要を作成する | GlobalGPTのような研究アシスタント向けワークスペース。1つのサブスクリプションで、モデルへのアクセスとドキュメント作成ツールを利用できます。. |
AIを活用して研究内容を理解する
有意義な最初の質問は、焦点を絞ったものであるべきだ。「報告されている『22%』の改善は、実際には何を測定しているのか?」この質問に答えるには、目標、指標、基準値、そして計算が必要となる。これら4つの項目を尋ねることは、アシスタントに「このモデルは素晴らしいか」と尋ねるよりも有益である。.
GlobalGPT を使えば、資料の探索、文書の解説、執筆といった一連の読解作業を、各ステップごとに別のツールに切り替えることなく進めることができます。再現性のある手法として、, 出典を確認した研究概要を作成する 完成度の高い要約を依頼する前に、出典リストを簡潔にまとめ、具体的な質問を明確にしておくこと。.
公式情報源から役立つ概要まで
- 一次資料を収集する。. まずNASAの発表から始め、次にモデルカード、技術報告書、READMEを追加してください。あなたは Perplexityを用いたGlobalGPTに関する研究 裏付けとなる情報源を見つけるために。.
- 的を絞った質問をしましょう。. アシスタントに、mAP、IoU、RMSEについてそれぞれ説明してもらい、各主張の後に、ターゲット、ベースライン、評価設定を列挙してください。.
- 確認して、記入してください。. 引用された表を再度開き、各数値を確認した上で、確認済みのメモを、科学的妥当性を維持した形で報告書にまとめ直してください。.
我々は、GPT-5.6 Solを用いて、このワークフローの簡易版をテストした。同システムは、4つの公式情報源から抽出された資料を受け取り、短いブリーフィングを作成し、6つの主張を分類し、RMSEの低減率を算出し、実践的な次のステップを提案することが求められた。このタスクでは、提供されたテキストを使用し、新たな証拠を検索することはなかった。.
ソースに基づくブリーフィングテスト
GPT-5.6 Solに対し、NASAの発表、公式モデルカード、技術報告書、およびGitHubのREADMEから抜粋した短い資料セットを提供しました。これをもとに、概要文書を作成し、6つの主張を検証し、RMSEの計算方法を説明する必要がありました。.
- 作業場所と日付
- GlobalGPT · 2026年9月28日
- ポリシーの実行
- 1つの課題;最初の解答で完了;再挑戦不可
- インプット
- 4つのソースIDを含む355語のソースパケット
- スコープ
- 読み込みと統合;リアルタイム検索や月面モデルの実行は行わない
- 応答設定
- 出力トークンの上限:4,096;その他のサンプリング設定はすべてサービスのデフォルト値のまま
- 使用方法と費用
- 報告されたトークンの総数は2,154個。回答には金銭的な請求は含まれていなかった。
最初の回答は、科学的根拠の範囲内に収まっていた
その回答は112語の概要となり、モデルが22%の実際の氷をさらに発見したという主張を否定し、着陸地点の認証および事前学習コードへのアクセスに関する制限を維持した。その3つの次のステップは、公式のモデルカード、チェックポイント、およびTerraTorchのリソースを参照するよう示していた。.
これは、提供された資料を用いた読解課題の一つでした。資料パックには、すでに重要な制限事項が明記されていました。この結果からは、自律的な調査能力や月面リモートセンシングによる推論能力については評価できません。.
正確なプロンプトとソースパケットを表示する
システム
あなたは、大学生向けに執筆を行う、慎重な研究編集者です。提供された資料パックのみを使用してください。インターネットで情報を検索してはいけません。報告されているベンチマーク測定値と、実際の科学的な測定値を区別してください。出典IDは角括弧で引用してください。主張が裏付けられていない場合は、その旨を明確に述べてください。 引用、価格、ハードウェア要件、実験結果をでっち上げてはいけません。隠された推論ではなく、求められている答えを提供してください。

ユーザー
資料パックを実用的な研究ノートにまとめなさい。提出物:(1) 100~130語の平易な英語による概要;(2) 提供された各主張について、「裏付けあり」または「裏付けなし」のいずれか、出典ID、および1文の説明を記載した6行の主張検証表; (3) 0.0377から0.0293まで算出した相対RMSEの低減率(小数点以下1桁に四捨五入)、計算式、およびそれが測定していない項目を説明する1文;(4) 公開されたモデルを検証または適応させたい学生のための、実用的な次の3つのステップ。 回答全体は500語以内に収めてください。

検証すべき主張:
1. NASAとIBMは2026年9月10日にこのモデルを公表した。
2. 報告された氷探査可能性のRMSEは、SwinV2-Bの0.0377から、完全に微調整された月面モデルでは0.0293に低下した。
3. このモデルにより、月面で22%分の実際の水氷が新たに発見された。
4. NASAは、着陸地点の認定および危険箇所の排除のために、このモデルの妥当性を検証した。
5. GitHubのリリースには、事前学習用のコードが含まれている。
6. オープンチェックポイントにより、GPUによる計算およびホスト型推論が無料で利用可能であることが保証されている。

出典:
[S1] NASA発表、2026年9月10日。
タイトル:NASAとIBM、月面科学向けAI基盤モデルを発表。
URL:https://science.nasa.gov/science-research/artificial-intelligence-lunar-foundation-model/
NASAは、IBMと共同で開発した月面科学向け基盤モデルを発表しました。このモデルはHugging Faceで公開されており、コードはGitHubに掲載されています。クレーターのマッピング、火山地形の特徴の識別、極域の氷の研究などに活用可能です。

[S2] NASA-IBM公式モデルカードおよび技術報告書(2026年9月28日確認)。
モデルカードURL: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
技術報告書のURL:https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model/blob/main/NI_LFM_Technical_Report.pdf
同レポートの表7(18ページ)には、氷の存在可能性回帰に関するテストセットの二乗平均平方根誤差(RMSE)が記載されている。数値が低いほど性能が良い。 5つのランダムシードにおける平均値±標準偏差:完全な微調整を施したNASA-IBM LFM、0.0293 ± 0.0013;ImageNetで事前学習されたSwinV2-B、0.0377 ± 0.0004。 目標は、知識駆動型の氷存在可能性マップである。これらは著者らが報告したベンチマーク結果であり、独立した再現実験や水氷の直接測定ではない。
表4(16ページ)、50%トレーニングデータを用いたWACクレーター: バウンディングボックスのmAPは、フルファインチューニングされたLFMで0.2541 ± 0.0018、SwinV2-Bで0.2313 ± 0.0027である。 同じ行において、AP@75はそれぞれ0.2213 ± 0.0028および0.1862 ± 0.0041である。これらの指標を混同してはならない。

[S3] 公式モデルカード、使用目的/適用範囲外/制限事項。
URL: https://huggingface.co/nasa-ibm-ai4science/NASA-IBM-Lunar-Foundation-Model
使用目的は、検出、セグメンテーション、および高密度回帰のための微調整またはLoRA適応による月面リモートセンシングです。本モデルは、着陸地点の認定や危険箇所の排除については検証されていません。氷の存在可能性に関する出力は、測定された氷ではなく、知識に基づいたマップを回帰したものです。生成されたフィールドは定性的な調査結果であり、校正済みの科学的予測ではありません。 本モデルは絶対測地座標系を維持していません。月以外の環境での評価は行われていません。記載されているライセンスはApache-2.0です。このページには、推論プロバイダーによるデプロイに関する記載はありません。このパッケージは、無料のGPU演算や無料のホスト型推論を保証するものではなく、ハードウェアの最低要件やホスト型APIの価格についても記載されていません。

[S4] 公式GitHub README、2026年9月28日確認。
URL: https://github.com/NASA-IMPACT/NASA-IBM-Lunar-Foundation-Model
このリポジトリでは、微調整および推論用のリリースについて説明されています。事前学習用のコードは含まれていません。 重みと設定は、Hugging Faceの公式モデルリポジトリからダウンロードできます。TerraTorch互換のデータモジュール、タスク、バックボーンラッパー、およびタスク設定が提供されています。微調整とテストには、関連するデータ、チェックポイント、およびタスク設定が必要です。READMEにはApache 2.0ライセンスが記載されています。.
最初の回答全文を表示する
## 1. 概要

NASAとIBMは2026年9月10日、「Lunar Foundation Model」を発表した。この公開版では、Hugging Face上で重みが提供され、GitHub上で微調整および推論用のコードが公開されており、クレーターマッピング、火山地形の特徴識別、極域の氷の研究といった月面リモートセンシングタスクを対象としている。 報告されている氷探査能力のベンチマークでは、ImageNetで事前学習されたSwinV2-BよりもRMSEが改善されているが、その対象は知識駆動型のマップであり、直接測定された月面氷ではない。この結果は著者らによって5つのランダムシードで報告されたものであり、独立した再現実験によるものではない。 このモデルは、完全な微調整またはLoRAによる適応を意図しているが、着陸地点の認定や危険箇所の除去については検証されていない。事前学習用のコードは含まれておらず、リリースでは無料のGPU計算リソースやホスト型推論の提供も約束されていない。[S1][S2][S3][S4]

## 2. 主張検証表

| 主張 | 判定 | 出典 | 説明 |
|---|---|---|---|
| 1 | 裏付けあり | [S1] | NASAの発表日は2026年9月10日であり、このモデルをNASAとIBMの共同プロジェクトとして特定している。 |
| 2 | 支持 | [S2] | 表7には、SwinV2-BのRMSE値が0.0377、完全に微調整された月面モデルのRMSE値が0.0293と報告されている。 |
| 3 | 支持されない | [S2] | これらの数値は、知識駆動型の探査可能性マップに対するベンチマーク誤差であり、実際の月面の水氷の測定値ではない。 |
| 4 | 支持されない | [S3] | モデルカードには、このモデルが着陸地点の認定や危険箇所の排除のために検証されていないことが明記されている。 |
| 5 | 未対応 | [S4] | GitHubリポジトリには微調整および推論リソースが含まれているが、事前学習コードは含まれていない。 |
| 6 | 未対応 | [S3] | パッケージには、無料のGPU計算やホスト型推論の提供は約束されておらず、Inference Providerのデプロイについても報告されていない。 |

## 3. 相対RMSE低減率

\[
\frac{0.0377-0.0293}{0.0377}\times 100 = 22.3\%
\]

これは、**著者らが報告したベンチマークRMSEに対する22.3%の相対的な低減率**であり、新たに発見された実際の水氷や、独立して検証された科学的性能を測定したものではない。[S2]

## 4. 実践的な次のステップ

1. 検出、セグメンテーション、または回帰タスクを選択する前に、モデルカードの用途、制限事項、およびApache-2.0ライセンスをよく読んでください。[S3]
2. Hugging Faceから公式のチェックポイントと設定をダウンロードし、GitHub上のバックボーンラッパーとタスク設定を確認してください。 [S4]
3. 関連する月面データセットを入手し、提供されているTerraTorch互換コンポーネントを使用して微調整とテストを行い、事前学習用コードが利用できないこと、およびベンチマーク結果は独立した評価が必要であることを明記してください。[S2][S4]
有益な成果は、以下の区別が維持されたことである。すなわち、ベンチマークエラーと発見された氷、研究用途と着陸認証、公開された適応コードと事前学習コードの欠如である。これらの制限はすでにソースパケットに含まれていたため、これは読み取り・統合タスクが成功したことを示す証拠であり、アシスタントがあらゆる留意点を独自に発見できることを証明するものではない。.
より大規模なプロジェクトの場合、, AIを活用した、より掘り下げた研究セッションを計画する データ、方法、評価、および限界に関する個別の疑問点について。下書きの横に出典表を置いておき、編集後はすべての数値を改めて確認しましょう。この習慣は、最初の要約がどれほど流暢に聞こえるかということよりも重要です。.
実務上重要な制限
モデルカードによると、月面モデルは、着陸地点の認定や危険箇所の排除といった運用上の決定については検証されていない。科学的なモデルは、探査機が特定の場所に安全に着陸できることを認定できる段階には至っていない場合でも、観測の検討に役立つ可能性がある。こうした用途には、異なるレベルの検証が必要となる。.
生成されたフィールドについても注意が必要です。このモデルは絶対測地座標系を維持しておらず、生成された値は物理的な値からずれる可能性があります。著者らは、この生成結果を、校正済みの科学的予測というよりは、定性的な探査として位置づけています。一見妥当に見える地形図や観測図であっても、測定結果として解釈すべきではありません。.
このチェックポイントは、月以外の環境では評価されていません。月面研究の範囲内でも、その評価結果はまちまちです。一部のタスクでは明らかな成果が見られる一方で、他のタスクでは同等の結果にとどまっています。ここから導き出せる妥当な教訓は、実験に合致する目標、規模、データ、およびベースラインに基づいてモデルを評価すべきだということです。.
よくある質問
NASAとIBMが共同開発した「Lunar Foundation Model」は無料で利用できますか?
公式のモデルカードおよびコードリポジトリにはApache-2.0ライセンスが記載されており、チェックポイントも一般に公開されています。実験を実行するには、依然として適切な計算リソース、データの前処理、およびタスク固有の評価が必要となります。モデルへのオープンアクセスは、無料のGPU演算やホスト型推論を保証するものではありません。.
NASAとIBMが共同開発した「Lunar Foundation Model」はチャットボットなのでしょうか?
これは、月面リモートセンシングのための基盤モデルであり、画像、地形データ、および関連する観測データと連携して動作するように構築されています。研究者たちは、このモデルを検出、セグメンテーション、回帰といったタスクに適応させています。チャットアシスタントがドキュメントの説明を手助けしてくれますが、チャットボットとのやり取りは、このモデルを実行することとは異なるワークフローとなります。.
このモデルによって、月面でさらに多くの水氷が発見されたのでしょうか?
報告された氷に関する結果は、予測が知識に基づく氷の探鉱可能性マップとどの程度一致しているかを測定したものです。 報告された最良のRMSEは、引用されたベースラインと比較して0.0377から0.0293へと低下しており、相対的な減少幅は約22%に相当します。これはベンチマークとしての改善であり、新たに発見された氷の量を測定したものではありません。.
コードを書かずに、このプロジェクトを調べてみることはできますか?
トレーニングパイプラインを構築しなくても、NASAの発表文を読んだり、モデルカードを確認したり、公開されているベンチマーク表を閲覧したり、公式のデモページにアクセスしたりすることができます。公開されているチェックポイントを科学的なタスクに適応させるには、リポジトリのコード、データ、およびTerraTorchの設定を使用し、その後、タスク固有の検証を行います。.
月のモデルは、プリトヴィとスーリヤとどのように関連しているのでしょうか?
これらは、科学分野における基盤モデルに関するNASAとIBMの広範な共同研究の一環です。NASAは、地球観測や気象用途向けの「Prithvi」モデル、太陽物理学向けの「Surya」、そして月観測向けの月モデルについて説明しています。それぞれの適用分野や目的とするタスクは異なりますが、月モデルについては、月以外の領域での評価は行われていません。.
NASAとIBMが共同開発した「Lunar Foundation Model」は、月面リモートセンシング研究のための再利用可能な出発点を提供します。公式の表を活用してその強みを理解し、モデルカードを用いてその限界を明確にし、公開されているリソースを活用して、特定の課題に合わせた実験を計画してください。当面の目標が学習や執筆である場合は、まずこれらの資料を精査済みの概要資料にまとめるところから始めてください。.
技術論文を実用的なブリーフィングに変える
GlobalGPTに公式資料を持ち込み、なじみのない概念を整理し、確認済みの調査結果を明確なメモや完成した草案にまとめ上げましょう。これらすべてを、1つのマルチモデルワークスペースで完結させることができます。.
GlobalGPTで研究を探る








